基于LangChain+ChatGLM2的本地知识库实践

基于ChatGLM2和langchain的本地知识库问答的实战方案 本文主要介绍了基于ChatGLM2和langchain的本地知识库问答的实战方案,希望对学习大语言模型的同学们有所帮助。 文章目录 1. 介绍 2. 配置环境 2.1 ChatGLM2环境搭建 2.2 进一步环境搭建 3. 修改配置文件 4. 运行代码 阅读详情

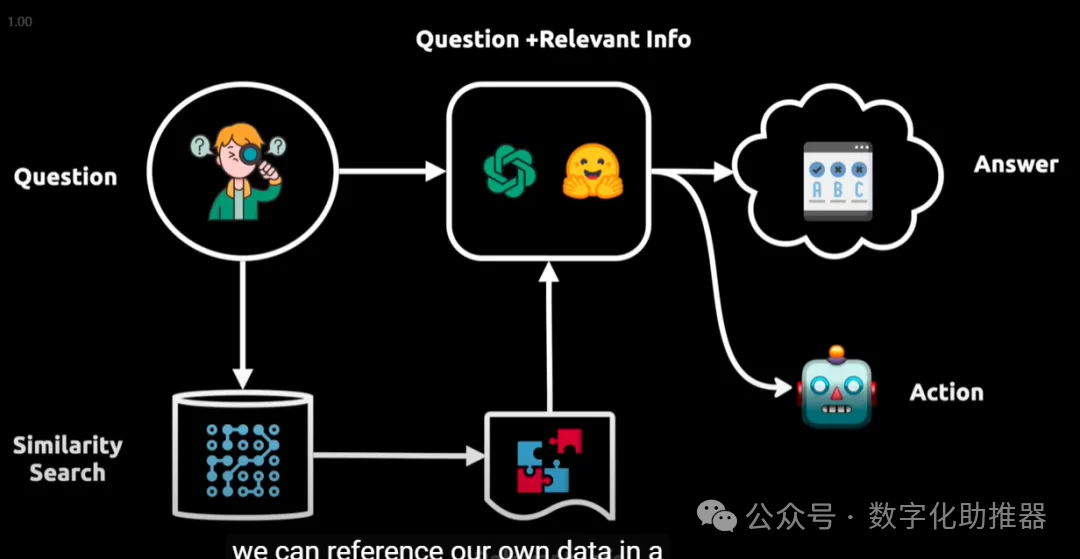
大语言模型也只是将用户提供的大规模数据集训练而来,也并非万能的什么都知道,特别是一些小众知识、内部数据或私密的个人数据等,此时ChatGLM肯定会胡乱回答,就是ChatGPT4也不一定能给出满意回答;不少公司、个人都有自己的知识库或日志等。此时如有可将这些数据以某种方式挂在大模型上,此时在知识库存在的知识可从中作答,不属于知识库中的内容还是按照大模型原来方式生成,精准度会高不少;知识库的内容包括文本、PDF、图片、视频、网页等等;

基于LLM的本地私有化知识库实现主要分为两种:
**1、模型训练微调:**将知识库的内容整理成训练数据集,拿这些整理好的数据集来训练该模型,最终让模型“学会”该知识库的内容,至于效果如何很大程度取决于该数据集的质量和训练的调参,这种方式较复杂、门槛高;
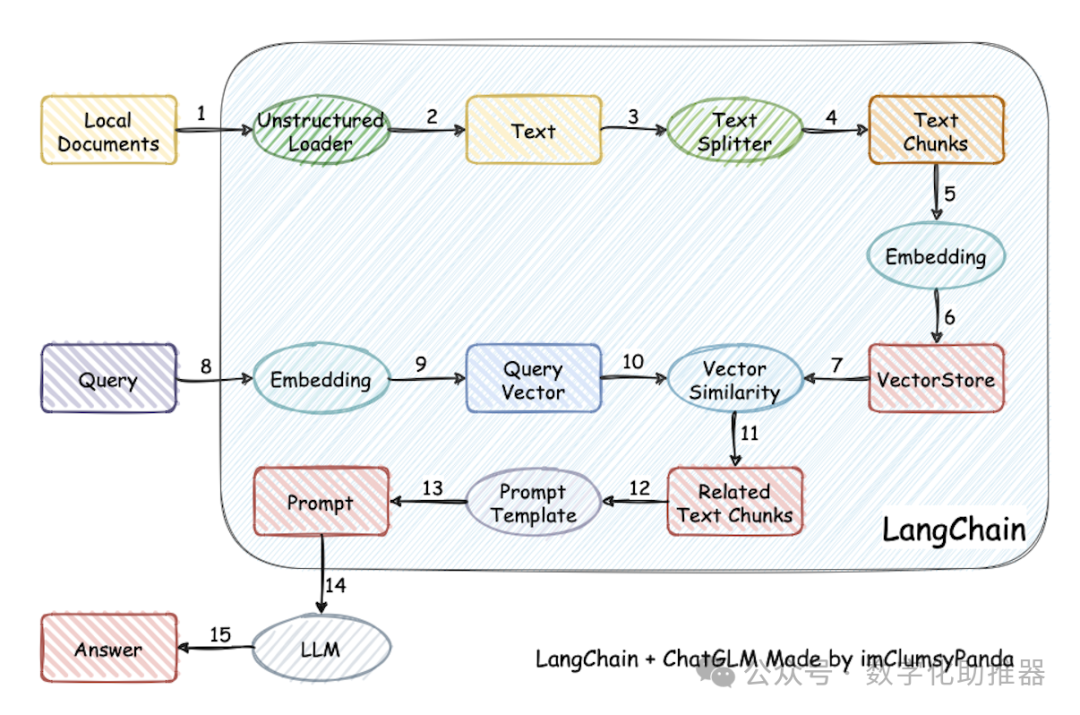
**2、外挂知识库:**在向模型提问时提供一些知识库中的内容让它在其中找到正确的答案,外挂的形式门槛相对低一点大部分的工作主要是文档的处理:加载、切分、向量化、持久化、相识度对比等以及Prompt编写。
在这里插入图片描述

知识库预处理相关概念

加载文件: 加载知识库中的文本**;
**

文本分割(TextSplitter): 按一定规则将文本分割,具体参数有: separator:分隔符、chunk_size: 文本块长度、chunk_overlap: 文本块之间重叠的长度、length_function:计算长度的方法; 文本块长度选择可能会对文本分割效果右较大的影响;

文本向量化: 将文本转换为向量,文本向量化后用于后续存储、计算相识度、检索相关文本等;

文本内嵌(Embedding): 将离散的符号或对象表示为连续的向量空间中的点;文本嵌入可用于以下功能:搜索、聚类、推荐、异常检测、多样本测量、分类;此处主要是用于查询的嵌入向量(问题向量化后)与每个文档的嵌入向量之间的余弦相似度,并返回得分最高的文档。Embedding开源模型模型有:Text2vec、Ernie-3.0、M3E等

持久化: 将向量化的数值存储到向量数据库方便后续直接使用,向量数据库有Chroma、Qdrant等;
随着人工智能技术的迅猛发展,问答机器人在多个领域中展示了广泛的应用潜力。在这个信息爆炸的时代,许多领域都面临着海量的知识和信息,人们往往需要耗费大量的时间和精力来搜索和获取他们所需的信息。

在这种情况下,垂直领域的 AI 问答机器人应运而生。OpenAI 的 GPT3.5 和 GPT4 无疑是目前最好的 LLM(大语言模型),借助 OpenAI 的 GPT 确实可以快速地打造出一个高质量的 AI 问答机器人,但是 GPT 在实际应用上存在着不少限制。比如 ChatGPT 的知识库是通用领域的,对于垂直领域的知识理解有限,而且对于不熟悉的知识还会存在幻觉的问题。因此,构建专业领域大模型应运而生。
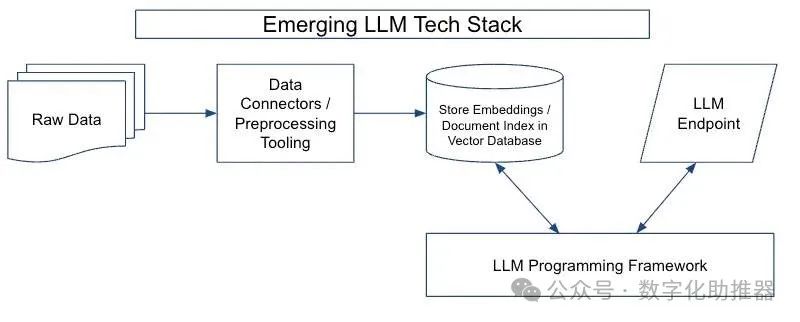
新兴 LLM 技术栈

大语言模型技术栈由四个主要部分组成:

  • 数据预处理流程(data preprocessing pipeline)

  • 嵌入端点(embeddings endpoint )+向量存储(vector store)

  • LLM 终端(LLM endpoints)

  • LLM 编程框架(LLM programming framework

如果想要在机器上跑自己部署的LLM,那么你至少需要一台配置不错的 GPU 服务器,否则推理的速度会很慢。想要拥有 GPU 服务器,你可以选择购买或者租用。建议选择显存至少为16GB显卡,因为 ChatGLM2-6B的推理需要至少 12GB 的显存,再加上 LangChain 其他模型的显存消耗,所以至少要保证 16GB 的显存才能进行后面的部署工作。
部署 ChatGLM2

ChatGLM2 是开源中英双语对话模型的第二代,对中文的处理能力要优于其他大模型,比第一代有了更强大的性能,更长的上下文,更高效的推理,更开放的协议。

克隆仓库

开始克隆仓库并安装依赖包。

1
2
3
git clone https://github.com/THUDM/ChatGLM2-6B.git
cd ChatGLM2-6B
pip install -r requirements.txt -i https://mirror.baidu.com/pypi/simple # 用百度的源

模型下载

接着是下载模型,这里我使用的是 ChatGLM2-6B 的模型,下面介绍两种下载方法。

自动下载

第一种是直接运行web_demo.py,这样程序在执行时会先检查本地是否有模型,没有的话就会自动下载模型,下载完成后再开始执行程序,下载下来的模型存放在这个目录:~/.cache/huggingface/hub/models--THUDM--chatglm2-6b/blobs,模型大小大概有 10G 左右。

手动下载

第二种是使用git clone下载模型,因为模型比较大,所以要先确认 git 的大文件下载功能是否已开启,执行命令git lfs install,如果显示Git LFS initialized.则说明已开启,否则需要先安装Git LFS,可以在这个网站查看如何安装。

然后执行git clone命令下载模型。

1
git clone https://huggingface.co/THUDM/chatglm2-6b

手动下载模型需要修改web_demo.py文件中的模型路径,将from_pretrained中的模型路径修改为下载后的模型路径。

1
2
3
4
-tokenizer = AutoTokenizer.from_pretrained("THUDM/chatglm2-6b", trust_remote_code=True)
-model = AutoModel.from_pretrained("THUDM/chatglm2-6b", trust_remote_code=True, device='cuda')
+tokenizer = AutoTokenizer.from_pretrained("/mnt/workspace/chatglm2-6b", trust_remote_code=True)
+model = AutoModel.from_pretrained("/mnt/workspace/chatglm2-6b", trust_remote_code=True).quantize(4).cuda()

部署验证

ChatGLM2 提供了一个 web 程序,启动这个程序后我们可以在浏览器中访问它的功能,web 程序的访问端口是 7860,但我们的服务器不一定会开放这个端口对外提供访问,因此我们还需要再改下web_demo.py的代码,来让它可以提供外部访问的地址。

1
2
-demo.queue().launch(share=False, inbrowser=True)
+demo.queue().launch(share=True, inbrowser=True)

将share设置为 True,这样程序启动后会生成一个对外访问地址,我们在本地浏览器直接访问这个地址就可以了。执行命令python web_demo.py启动 web 程序。

1
2
3
4
5
6
7
/mnt/workspace/ChatGLM2-6B> python web_demo.py
[2023-07-13 11:20:33,304] [INFO] [real_accelerator.py:110:get_accelerator] Setting ds_accelerator to cuda (auto detect)
Loading checkpoint shards: 100%|████████████████████████████████████████████████████████████████████████████| 7/7 [01:25<00:00, 12.25s/it]
Running on local URL: http://127.0.0.1:7860
Running on public URL: https://46841e4217313f9dbb.gradio.live

This share link expires in 72 hours. For free permanent hosting and GPU upgrades (NEW!), check out Spaces: https://huggingface.co/spaces

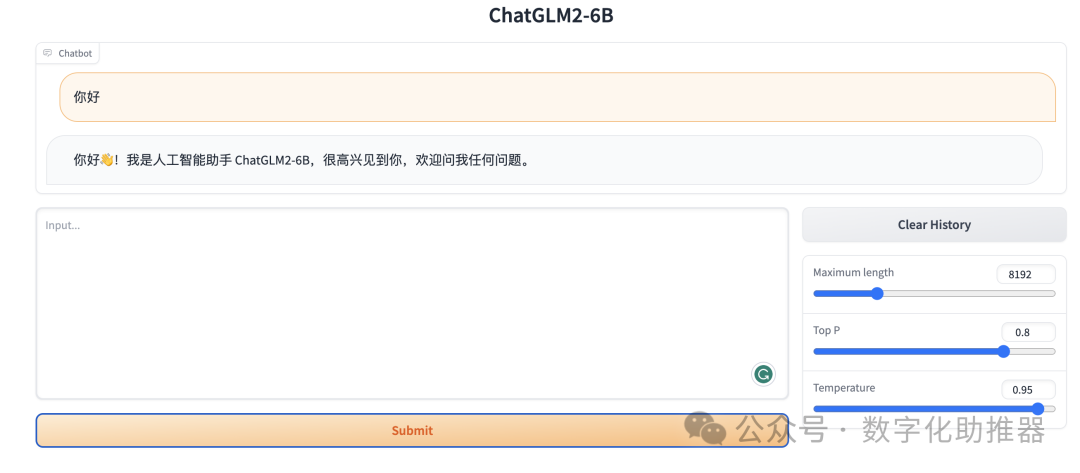
public URL就是我们要访问的地址,需要注意的是这个地址不是一成不变的,而是每次启动都会生成新的地址。下面是 web 程序的界面。

部署 LangChain-ChatGLM

LangChain是一个强大的框架,旨在帮助开发人员使用语言模型构建端到端的应用程序。它提供了一套工具、组件和接口,可简化创建由 LLM 提供支持的应用程序的过程。

Langchain-ChatGLM 是一种利用 Langchain 思想实现的基于本地知识库的问答应用,目标期望建立一套对中文场景与开源模型支持友好、可离线运行的知识库问答解决方案。它对中文文档分隔,问题加上下文拼接上都做了相应的优化。

Langchain-ChatGLM 开始是基于 ChatGLM 第一代来开发的,后面慢慢支持更多的模型,ChatGLM2 推出后,项目也很快集成了 ChatGLM2。

克隆仓库

和ChatGLM2一样,我们首先要下载项目代码并安装依赖。

1
2
3
git clone https://github.com/
imClumsyPanda/langchain-ChatGLM.git 
cd langchain-ChatGLM
pip install -r requirements.txt -i
https://mirror.baidu.com/pypi/simple

下载 Embedding 模型

Langchain-ChatGLM 除了要用到 ChatGLM2 模型外,还需要用到一个用来 Embedding 文档和 Prompt 的模型,默认是用的text2vec-large-chinese,但这个模型推理用的显存比较大,大概要 3G 多显存,我们可以使用一个小一点的模型text2vec-base-chinese。

同样地,我们只需要用git clone下载模型。

1
git clone https://huggingface.co
/shibing624/text2vec-base-chinese

修改配置文件

模型下载完成后修改配置文件config/model_config.py,将embedding_model_dict中的模型地址改为下载后的 Embedding 模型地址,同时修改默认的 Embedding 模型名称为text2vec-base。同时修改llm_model_dict中chatglm2-6b的模型地址为我们下载的 ChatGLM2 模型地址,并且修改默认的 LLM 模型为chatglm2-6b。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
 embedding_model_dict = {
"ernie-tiny": "nghuyong/ernie-3.0-nano-zh",
"ernie-base": "nghuyong/ernie-3.0-base-zh",
- "text2vec-base": "shibing624/text2vec-base-chinese",
+ "text2vec-base": "/mnt/workspace/text2vec-base-chinese",

# Embedding model name
-EMBEDDING_MODEL = "text2vec"
+EMBEDDING_MODEL = "text2vec-base"

"chatglm2-6b": {
"name": "chatglm2-6b",
- "pretrained_model_name": "THUDM/chatglm2-6b",
+ "pretrained_model_name": "/mnt/workspace/chatglm2-6b",

# LLM 名称
-LLM_MODEL = "chatglm-6b"
+LLM_MODEL = "chatglm2-6b"

针对 ChatGLM2 的修改

因为 ChatGLM2 刚推出不久,Langchain-ChatGLM 对其适配还不太完善,需要手动再修改一些代码才能让 ChatGLM2 正常运行。修改的代码主要是/models/loader/loader.py文件中的_load_model方法,修改内容如下。

1
2
3
4
5
6
7
8
9
                         LoaderClass.from_pretrained(checkpoint,
config=self.model_config,
torch_dtype=torch.bfloat16 if self.bf16 else torch.float16,
- trust_remote_code=True)
- .half()
- .cuda()
+ trust_remote_code=True, device='cuda')
+ # .half()
+ # .cuda()

部署运行

最后跟 ChatGLM2 一样,我们修改 Langchain-ChatGLM 的 web 程序,以便我们可以在浏览器中访问到这个 web 程序。修改webui.py文件,将share设置为 True。

1
2
-         share=False,
+ share=True,

修改完后执行命令python webui.py启动 web 程序。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
/mnt/workspace/langchai8”n-ChatGLM> python webui.py
INFO 2023-07-13 14:37:52,071-1d:
loading model config
llm device: cuda
embedding device: cuda
dir: /mnt/workspace/langchain-ChatGLM
flagging username: e717a58b4ce9444e82491cefeb80bf56

[2023-07-13 14:37:58,105] [INFO] [real_accelerator.py:110:get_accelerator] Setting ds_accelerator to cuda (auto detect)
Loading /mnt/workspace/chatglm2-6b...
Loading checkpoint shards: 100%|████████████████████████████████████████████████████████████████████████████| 7/7 [01:29<00:00, 12.80s/it]
Loaded the model in 91.42 seconds.
{'answer': '你好!我是人工智能助手 ChatGLM2-6B,很高兴见到你,欢迎问我任何问题。'}
Running on local URL: http://0.0.0.0:7860
Running on public URL: https://b0f2e23a9ea5b74b4a.gradio.live

This share link expires in 72 hours. For free permanent hosting and GPU upgrades (NEW!), check out Spaces: https://huggingface.co/spaces

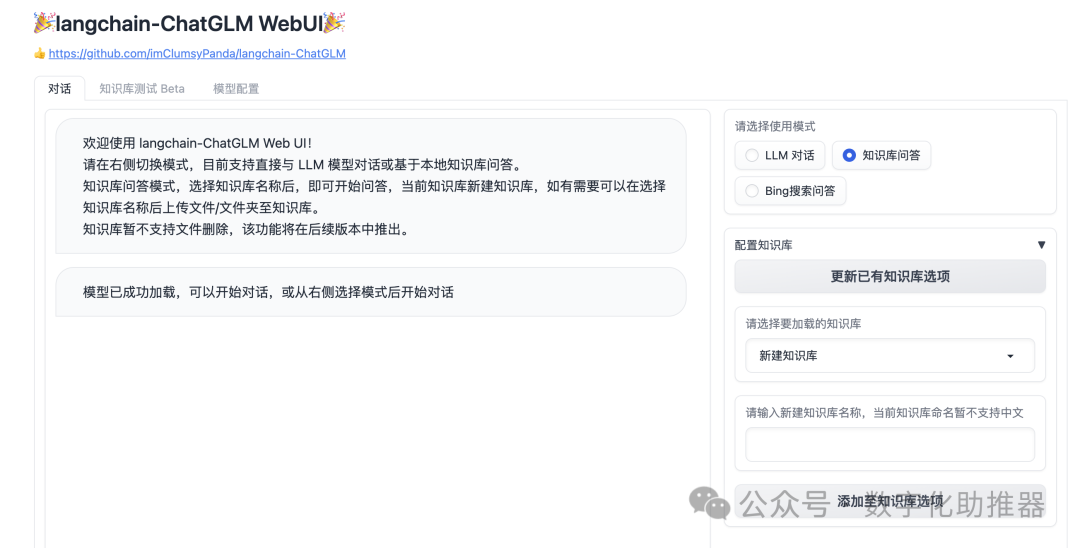
访问public URL地址就可以看到我们的 web 程序了。

系统使用介绍

添加知识库文档步骤如下:

  • 先选新建知识库

  • 输入知识库名字,点击“添加至知识选项”

  • 上传文件,完了后点击“上传文件并加载知识库”

然后就可以基于这个知识库进行问答了,操作十分简单。本文介绍了 GPU 服务器的选型,ChatGLM2 和 Langchain-ChatGLM 的部署和使用,如果想要了解更多关于 Langchain-ChatGLM 的实现原理,可以在他们 GitHub 仓库中查看更多的信息。

在这里插入图片描述

(3万字深度解析)Kaggle《房价预测:高级回归技巧》详解复现攻略 在这篇教程式文章中,我们从零开始完成了 Kaggle《房价预测:高级回归技巧》比赛的复现工作,涵盖了数据预处理、特征工程、模型训练、调优、解释和融合的完整流程。深入理解数据:阅读数据描述,结合常识对每个特征作出合理处理(如缺失值填充’None’表示无此设施 、异常值剔除 等)。对目标和偏态特征进行对数变换,使分布更平滑,从而更好满足模型假设并提升准确度。特征工程:我们创造了总面积、总浴室等新特征,整合信息提高模型可学习性。 阅读详情

相关推荐

Linux下用SquareLine Studio开发LVGL界面:从安装到实战的完整避坑指南

本文提供了一份在Linux系统下使用SquareLine Studio开发LVGL图形界面的完整实战指南。内容涵盖从SDL库安装、SquareLine Studio环境配置、界面可视化设计,到工程导出、源码编译及常见错误排查的全流程。重点解析了如何将设计界面无缝集成到Linux开发流程中,并针对嵌入式设备移植提供了关键步骤,旨在帮助开发者高效避坑,快速上手LVGL界面开发。

egg99的博客 908

【LLM_02】LangChain知识库+Lora微调chatglm2-6b模型+提示词Prompt的使用原则

Prompt是给AI的指令,引导模型生成符合业务场景的响应输出。

1万+

电商客服效率翻倍!手把手教你用影刀RPA+AI搭建智能回复系统(附实战配置)

本文详细介绍了如何利用影刀RPA+AI技术搭建电商智能客服系统,实现24小时在线回复,大幅提升客服效率。通过零代码配置、Excel词库管理和AI语义理解,系统能处理80%常规咨询,响应速度稳定在3秒内,特别适合中小电商降低成本并提升服务质量。

weixin_42520661的博客 551

基于langchain+chatGLM搭建部署本地私有化知识库系统

基于langchain+chatGLM搭建部署本地私有化知识库系统

Together_CZ的博客 1万+

编译CycloneDDS和CycloneDDS-CXX踩过的坑——CMake Error at CMakeLists.txt:227 (find_package):

最近编译CycloneDDS和CycloneDDS-CXX踩了两个坑,花了不少时间。做个简单的记录,免得以后又踩到。注意:CycloneDDS-CXX编译依赖CycloneDDS,因此必须先编译CycloneDDS需要严格按照步骤进行,否则要入坑步骤如下,1先编译CycloneDDS以上步骤完成CycloneDDS的编译和安装,生成的bin include lib等位于install目录下面。

usstmiracle的博客 1900

C#上位机与VisionPro通用框架:视觉标定、通信联动与现场排坑实战

工业自动化设备的上位机开发,往往面临流程控制、视觉检测、通信交互等环节的重复搭建。C#作为主流工业语言,配合VisionPro视觉软件,可通过通用框架设计将状态机调度、相机采集、标定算法与串口/扫码枪通信等底层能力模块化,从而大幅降低项目交付成本。其核心原理在于:将设备工艺差异封装至配置层,视觉流程通过CogToolBlock工具链与VPP模板复用,九点标定建立像素与机械坐标系的映射关系。该方案已在螺丝锁付、点胶定位等多类产线落地,尤其适用于批量交付、换型频繁的视觉设备场景。这套从实践中沉淀的框架思路,以及

weixin_31102231的博客 341

Langchain+chatGLM2实现本地知识问答平台

最近比较流行chatgpt,刚好有资源可以测试一下,为了后续不迷路,记录一下。

sydwy的专栏 1692

vivado 工程修改芯片型号

vivado工程芯片与实际板子不匹配时,需要修改工程的芯片型号,并对原工程的ip进行同步更新,之后生成新的bit文件,烧录到板子中

k7126685的博客 1万+

windows10下本地部署langChain-ChatGLM2-6B

设备配置:CPU E3-1240v3, RAM 32G, SSD 1T, GPU0 Nvidia 1080ti,GPU1 Nvidia T4。打开windows资源查看器,内存全部占满。遗留问题,默认webug.py没用gpu,纯cpu跑,速度非常慢。使用浏览器打开 http://localhost:7860/如果显示 Conda 及其内部包的列表,则说明安装成功。4.添加必要的 Conda 通道以获取更多软件包,如果报错(一般都是传输超时),则重新运行几次。没有加载到GPU,全用CPU跑了。

qq_43335960的博客 4660

RADIOML 2018.01A数据集在自动调制识别中的实战应用指南

本文提供了RADIOML 2018.01A数据集在自动调制识别(AMR)任务中的完整实战指南。内容涵盖从数据集介绍、数据获取与解包、高效预处理流程,到构建PyTorch数据管道、模型设计(如1D CNN、ResNet)以及训练调参策略。重点阐述了如何利用该数据集训练鲁棒的AI模型,以应对复杂信道环境和低信噪比挑战,并给出了详细的性能评估方法。

plant的博客 178

【图像去噪】基于加权核范数最小化算法实现图像去噪附matlab代码

1 简介 WNNM是一种约束矩阵奇异值稀疏性的低秩算法,在NNM理论基础上增加了核范数权重,有效利用了自然图像的先验信息并提高了核范数的灵活性. 2 部分代码 ​clcclear allclose allnSig = 100;O_Img = double(imread('Monarch.png'));​randn('seed', 0);N_Img = O_Img + nSig* randn(size(O_Img)); ..

qq_59747472的博客 3118

ChatGLM2+Langchain 构建本地知识库——Langchain加载

​ ChatGLM2-6B 是开源中英双语对话模型ChatGLM-6B的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上,ChatGLM2-6B 引入了更多新特性。 ​

weixin_56450431的博客 914

Linux V3H 平台开发系列讲解(串行解串篇)2.2.2 MAX9296 MAX96705 GMSL1 续篇--串行器提前配置

本文详细介绍了在Linux v3h平台上,针对Max9296解串器和解串器max96705的详解配置,验证可出图,内容包括串行器解串器介绍、链路框架、硬件连接、速率配置,以及遇到的图像异常问题及解决方法。

xian18809311584的博客 540

阿里云部署langchain+ChatGLM2-6B本地知识库实战加踩坑

2> ChatGLM2-6B 在web_demo.py和web_demo2.py中都把tokenizer和model的路径修改为本地chatlm2-6b的路径。<1> chatglm2-6b chatglm2-6b模型在目录的config.json文件中修改"_name_or_path"**注意:**此处可能会出现cuda和pytorch不匹配的问题(如下图),**例外:**当然还有遇到的上传文档显示报403的错误。修改模型的相关内容(通过WebIDE进行修改)1、白嫖阿里云的算力。

铭绵羊 1718

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

ChatGLM2+Langchain 构建本地知识库——构建本地知识库

ChatGLM2-6B 是开源中英双语对话模型ChatGLM-6B的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上,ChatGLM2-6B 引入了更多新特性。

weixin_56450431的博客 1771

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Langchain+chatglm2——基于ChatGLM2和langchain的本地知识库问答的实战方案

在某些情况下,您可能希望实现一个自定义解析器,将模型输出结构化为自定义格式。使用 LCEL 中的或– 我们强烈推荐这种方式用于大多数情况通过继承输出解析的基类之一来实现 – 这是一种较为复杂的方式这两种方法之间的区别主要是表面的,主要体现在触发哪些回调(例如vs.),以及可追踪平台(如 LangSmith)中可视化可运行 lambda 和解析器的方式。

xxue345678的博客 1071

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

LangChain-Chatchat:基于LangChain和ChatGLM2-6B构建本地离线私有化知识库

自从去年GPT模型火爆以来,降低了很多个人和企业进入人工智能领域的门槛,对于大模型尤其是开源的大模型国内应该比较受关注和期待,毕竟高额的成本也能将不少人阻挡在门外,其次,大家都希望在产品中集成LLM的能力,结合业务来落地智能化应用,提升产品的竞争力,最直接的应用就是构建知识库。

FrenzyTechAI的博客 5886

ChatGLM2+Langchain 构建本地知识库——环境部署

ChatGLM-6B 是开源中英双语对话模型的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上有着更多的新特性。

weixin_56450431的博客 1246

ChatGLM3-6B和langchain知识库阿里云部署

看了几天chatglm和langchain的部署,经过不断报错,终于试出了可以运行的方案,不过本地知识库搭建还有问题,要再看看。本文主要介绍ChatGLM3-6B的部署和实现效果,和Chatglm2-6b+langchain结合的实现效果。提示:以下是本篇文章正文内容,下面案例可供参考。

m0_52695557的博客 7720

利用langchain-ChatGLM、langchain-TigerBot实现基于本地知识库的问答应用

刷B站的时候,无意中看到吴恩达的一个langchain的教程,然后去github上搜了下,发现别人利用langchain和chatGLM做的基于本地知识库的问答应用挺好的,学习下。

C/C++、嵌入式开发、深度学习算法、模型部署与推理优化 4247

本地部署 langchain-ChatGLM

大型语言模型(LLM)正在成为一种变革性的技术,使开发者能够建立他们以前无法建立的应用程序。然而,孤立地使用这些LLM往往不足以创建一个真正强大的应用程序–当你能将它们与其他计算或知识来源相结合时,真正的力量才会出现。这个库的目的是协助开发这些类型的应用。langchain 使用 Transformer 模型,并在多个语言间建立链式结构实现翻译。比如,它可以通过英语→法语→西班牙语完成英语到西班牙语的翻译。langchain 只使用公开数据集进行训练,不需要额外的数据。WMT2014英法翻译数据集。

kuokay的博客 4582

用LLM构建基于本地知识库的智能问答应用

微调是基于一个预训练模型(通常是在大规模数据集上进行训练得到的模型,如ChatGLM2-6B、BaiChuan2-13B等),然后在一个特定任务或领域上进一步调整模型的权重,以使其适应新任务或领域的需求。

2301_77727994的博客 2218

大模型在阿里云上的私有化部署、微调、创建本地知识库(下)

本文以chatglm2-6b大模型为例讲解阿里云上大模型的部署、微调、创建本地知识库,但这里的步骤引用其他博文或官网(给出链接),不赘述,主要讲解亲自实践过程中遇到的问题和解决方法。

研究AI应用,实践AI增效。 788

搭建基于LangChain + ChatGLM2-6B 的个人知识库

采用Langchain和ChatGLM搭建本地知识库。

peter_wjj的专栏 4065

探索智能边界:LangChain-ChatGLM-Webui —— 无缝融合本地知识与大型语言模型

LangChain-ChatGLM-Webui是一款基于LangChain和ChatGLM-6B等系列LLM的针对本地知识库的自动问答工具,它能帮助用户轻松构建属于自己的智能问答系统,让大型语言模型更好地服务于个人和企业的知识管理需求。 ## 🔥 什么是LangChain-ChatGLM-Webui? LangChain-ChatGLM-Webui是一个开源项目,受[langchain-Ch

gitblog_00040的博客 484
上一篇: 大模型能力扩展之——提示词(Prompt),知识库,思维链(CoT)和Agent(代理)
下一篇: 多模态大语言模型相关论文整理
大模型应用场景
博客等级 码龄5年 7683粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值