5种常见反爬策略及解决方案

爬虫中常见的反爬手段和解决方法 了解反爬的三个方向 了解常见基于身份识别进行反爬 了解常见基于爬虫行为进行反爬 了解常见基于数据加密进行反爬 一、反爬的三个方向 基于身份识别进行反爬 基于爬虫行为进行反爬 基于数据加密进行反爬 二、常见基于身份识别进行反爬 1. 通过headers字段来反爬 headers中有很多字段,这些字段都有可能会被对方服务器拿过来判断是否为爬虫 1.1 通过headers中的user-agent字段进行反爬 反爬原理:爬虫默认情况下没有user-agent,而是使用模块默认设置 解决.. 阅读详情
AI摘要

文章介绍了互联网中常见的反爬虫技术,包括通过user-agent检测、代理IP切换、cookies管理、验证码识别以及处理动态页面的方法。针对这些反爬策略,提出了相应的解决方案,如伪装请求头、使用代理IP池、模拟登录获取cookies、处理验证码以及利用Selenium和PhantomJS抓取动态内容。

随着互联网的发展,越来越多的公司需要爬取各种数据来分析出自己公司业务的发展方向。而目前许多目标网站也有各种各样的措施来反爬虫,越是数据价值高的网站反爬做得也就越复杂。给大家列举了几个常见的反爬措施以及解决方案。

1、通过user-agent字段来反爬

最常见的反爬策略就是检测用户的请求头。这个是比较容易实现的反爬,破解起来也是比较容易的,解决方法就是伪装header,只要合理添加请求头就可以正常访问目标网站获取数据。

2、利用代理ip反爬

目前一般网站都会检测某个ip在单位时间内的请求次数,如果单位次数超过了这个阈值就会停止其请求访问。所以一般在爬取的时候我们都会用到代理ip来模拟真实用户使用不同的ip来访问目标网站。

我们通过代理的原理就能够很好地进行了解。
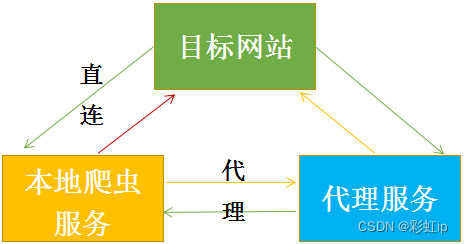
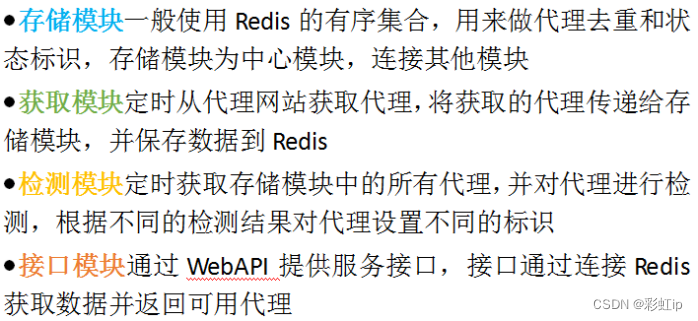
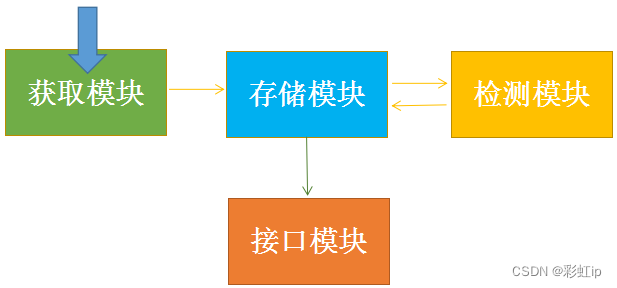
ip代理池架构
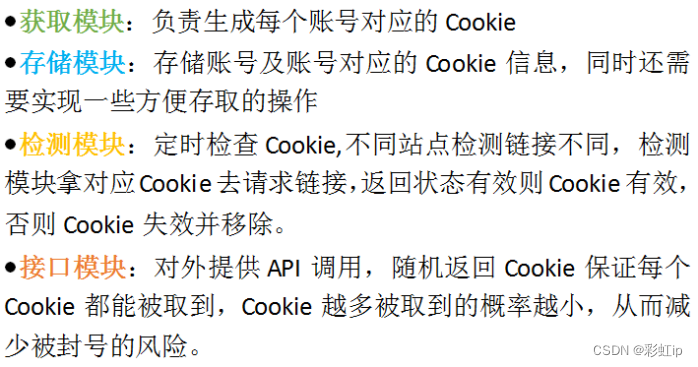
3、通过cookies反爬

cookies也是一个比较常见的反爬手段之一,可以把它和登录放在一起。这里需要注意的是,有些不需要登录的网站也会通过cookies来过滤一些没有经过伪装的爬虫。解决方案就是进行模拟登陆,成功获取cookies之后再进行数据爬取。

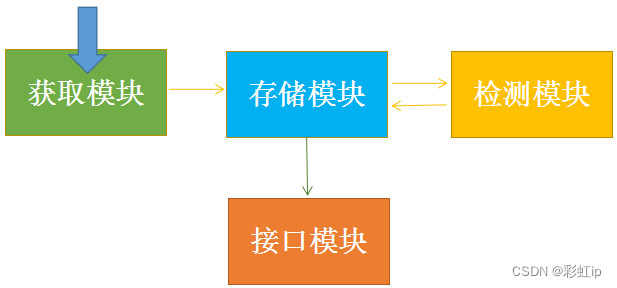
cookie代理池模块一般架构
4、通过验证码反爬

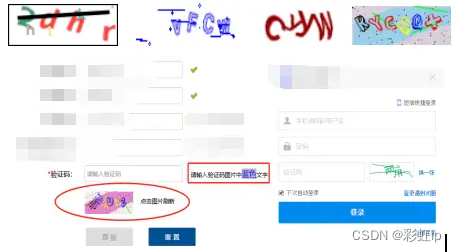
验证码也是一种比较常见的反爬方式,有的目标网站服务器在同一ip地址访问到一定数量之后,可以返回验证码让用户进行验证。我们常见的验证码形式也是非常多的,比如数字验证码、字母验证码、字符图形验证码。简单的验证码我们可以通过打码平台进行破解。复杂的话我们可以尝试模拟用户的行为绕过去,但是通常比较繁琐难度可能会比较大。
5、动态页面的反爬

有部分目标网站,我们爬取的数据是通过ajax请求得到的,或者Java生成的。

Selenium 可以做到可见即可爬。对于一些动态页面来说,此种抓取方式非常有效。

PhantomJS :一个没有图形界面的浏览器。

如果对Python感兴趣的话,可以试试我整理的这份Python全套学习资料,文末免费领取

😝朋友们如果有需要的话,可以V扫描下方二维码免费领取🆓

学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!
#### **一、Python学习路线**

image-20230619144606466

python学习路线图1

二、Python基础学习
1. 开发工具

2. 学习笔记

在这里插入图片描述

3. 学习视频

在这里插入图片描述

三、Python小白必备手册

图片

四、数据分析全套资源

在这里插入图片描述

五、Python面试集锦
1. 面试资料

在这里插入图片描述

在这里插入图片描述

2. 简历模板

在这里插入图片描述

** 因篇幅有限,仅展示部分资料,添加上方即可获取**
互联网防反爬机制的六种反爬技术大解析 目录 前言 反爬虫 仔细分析这七种反爬技术 1、user-agent 2、验证码 3、封IP 4、关联请求上下文 5、JavaScript 参与运算 6、提高数据获取成本 前言 ​ 互联网时代,无论在工作上,还是生活上都离不开网络,而网络能给我们带来什么? ​ 新闻,小说,资料,各行业的数据或者报表等等; ​ 比如:快毕业了为了论文,在各种网站上爬取需要的数据进行分析;还有一些为了兴趣爱好,爬取各种类型的图片,视频,文章,数据等。 ​ 各网站的开发人员为了约束这种行为,开始绞尽脑 阅读详情

相关推荐

python爬虫--小白篇【反反爬】

本文主要是记录了爬虫过程中的三种反反爬方法,主要是添加user-agent、使用ip代理、使用cookie。user-agent可以使用python第三方库fake-useragent随机获取,ip代理可以在网上找免费的或者付费的ip代理(可参考快代理 - 企业级HTTP代理IP云服务_专注IP代理11年),cookie可以自己登入账号后获取也可以写程序通过模拟登入后通过get_cookies()获得并保存为文件,之后在读取文件获取该cookie继续登入。

weixin_56097064的博客 3575

【道高一尺魔高一丈】7种反爬虫策略及规避手段

在进行爬虫活动时,需要遵循伦理规范和法律法规,尊重网站的隐私权和信息所有权。未经授权的爬虫活动可能涉及侵犯隐私、盗取数据等问题,违反相关法律法规可能会面临法律责任。

m0_48891301的博客 5366

避坑指南:用Requests库爬Nature官网时遇到的5个常见问题及解决方案

本文分享了使用Python Requests库爬取Nature官网数据时常见的5个问题及解决方案,涵盖请求头伪装、会话管理、反爬虫策略应对、数据解析陷阱以及数据存储与伦理规范。核心在于通过设置完整请求头、使用Session对象、添加随机延迟和采用健壮的解析方法,来高效、稳定且合规地完成学术数据爬取。

weixin_29055137的博客 349

爬虫还没写完网站先反爬了?踩过的5个深坑,第3个让我熬夜到天亮...

当年写爬虫,被反爬虐到差点还俗。今天把踩过的5个深坑一次性说透——请求头、动态加载、IP封禁、验证码、乱码,附带代码和绕路方案,看完直接避开贫僧当年走过的弯路。

qq_28906359的博客 795

爬虫反爬机制和解决方案

在这一部分中,我们会展示几个具体案例代码来演示反反爬技术,所有代码使用面向对象的思想,并为每个案例选择合适的设计模式。此文章将被分为五个主要部分,详细介绍爬虫绕过反爬机制的技术,代码采用面向对象思想,并为每个案例使用合适的设计模式。:使用Tesseract OCR识别验证码的思路,并通过策略模式实现不同类型验证码的识别策略,以提高通用性。我们还会讲解如何优化爬虫性能,并分析设计模式的优势,例如提升代码的扩展性和可维护性。类,采用工厂模式生成不同的请求代理,以实现轮换IP的需求。

闲人编程的博客 2528

Python+爬虫+反爬破解策略实战

Python网络爬虫反爬破解策略实战

陈建华的博客 1455

OpenClaw浏览器自动化:千问3.5-9B实现智能爬虫

本文介绍了如何在星图GPU平台上自动化部署千问3.5-9B镜像,实现智能爬虫功能。该方案结合OpenClaw框架与千问模型的语义理解能力,可自动处理动态加载内容、验证码识别及非结构化数据解析,适用于电商数据采集、市场调研等场景,显著提升数据获取效率。

weixin_35639680的博客 922

Python爬虫实战:反爬机制与分布式采集

本文档旨在帮助开发者系统性掌握Python爬虫开发中的反爬对抗策略与分布式采集技术,通过原理分析+代码实战的方式,提供从基础到进阶的完整解决方案。爬虫与反爬机制原理剖析常见反爬手段及破解策略分布式采集架构设计实战案例:电商数据分布式采集系统法律合规与风险规避优先遵守目标网站规则注重采集效率与资源消耗的平衡建立完善的异常处理机制持续关注反爬技术演进。

shejizuopin的博客 2281

小红书数据采集的终极解决方案:5分钟快速上手指南

你是否曾经为了获取小红书上的公开数据而烦恼?面对复杂的反爬机制和繁琐的签名验证,传统爬虫开发既耗时又容易失败。xhs项目为你提供了一个简单高效的Python SDK,让你专注于业务逻辑而不是技术细节。这个开源工具封装了小红书Web端的请求逻辑,让数据采集变得像调用普通API一样简单。 ## 🚀 为什么选择xhs而不是自己写爬虫? 在开始之前,我们先来看看xhs相比传统方法的优势: | 对比

gitblog_00443的博客 411

Xilinx HydraMini试玩教程

HydraMini是Xilinx推出的基于Pynq-Z2开发板的自动驾驶开发小车,其有着简单易学、高灵活性、高扩展性、高性能等优良特性,是研究人员和学生进入自动驾驶领域的一个平台。本教程会通过最基础的讲解和步骤带领读者熟悉这个平台的基本开发流程。

qq_25762163的博客 1773

波分复用技术原理

波分复用原理 把不同波长的光信号复用到同一根光纤中进行传送,这种方式我们把它叫做波分复用( Wavelength Division Multiplexing ) 一根光纤被划分为多个波道,多个波长以一定的间隔隔开,在光纤中独立传输。 波分复用应用演示 如果将WDM系统看作交通系统,光纤可以看作是多个车道的公用道路。 各种类型的业务就像货物一样,被打包装载到车辆中。 车辆按照分配的车道行驶至目的地,完成货物的运输。 想要提高波分复用系统的传输容量,就要增加波道数量或是提升单波传...

m0_63251770的博客 9999

常见反爬策略整理——CSS 加密

这篇文章是专栏的系列之一,主要讲解常见的CSS加密反爬策略一些特征及解决方案,看汇总版的可以移步常见反爬策略整理。

qq_38223858的博客 2232

从理论到代码:蒙特卡洛法在光学散射模拟中的应用全解析(Matlab 2014a版)

本文详细解析了蒙特卡洛法在光学散射模拟中的应用,从数学原理到Matlab 2014a实现。通过模拟光子随机游走过程,精确描述光在浑浊介质中的传输特性,提供完整的源码实现和性能优化技巧,适用于生物医学光学、大气遥感等领域。

rum55的博客 630

Python爬虫之常见的反爬手段和解决方法

常见的反爬手段和解决思路 学习目标 了解 服务器反爬的原因 了解 服务器常反什么样的爬虫 了解 反爬虫领域常见的一些概念 了解 反爬的三个方向 了解 常见基于身份识别进行反爬 了解 常见基于爬虫行为进行反爬 了解 常见基于数据加密进行反爬 1 服务器反爬的原因 爬虫占总PV(PV是指页面的访问次数,每打开或刷新一次页面,就算做一个pv)比例较高,这样浪费钱(尤其是三月份爬虫)。 三月份爬虫是个什么概念呢?每年的三月份我们会迎接一次爬虫高峰期,有大量的硕士在写论文的时候会选择爬取一些往网站,并进行舆

不一样的花朵的博客 7144

西门子Simotion运动控制

SIMOTION

rjimhcd的博客 3025

Informer:比Transformer更有效的长时间序列预测

目录 AAAI 2021最佳论文:比Transformer更有效的长时间序列预测 Background Why attention Methods:the details of Informer Solve_Challenge_1:最基本的一个思路就是降低Attention的计算量,仅计算一些非常重要的或者说有代表性的Attention即可,一些相近的思路在近期不断的提出,比如Sparse-Attention,这个方法涉及了稀疏化Attention的操作,来减少Attention计算量,然后涉及的

To be a better man 1万+

python 爬虫常见的反爬策略与反爬攻克

python 爬虫常见的反爬策略与反爬攻克 爬虫基本对所有人来说,都是又爱又恨,爱恨交织的。由于网络的开放性,只要是连上了网线,那么就没有绝对的封闭,而爬虫基本可以说是无物不爬,总会有误爬的情况,或者爬取了相对来说不希望公开或者不希望他人知道的比较私密的信息,但另一方面,网络的参与者又希望有爬虫能爬取它,进而推广它自身,好像,蚂蚁与蜂蜜的关系,甜蜜而又危险? ...

zsk_john的技术分享专用博客 1276

基于Matlab的深度学习OFDM系统信号检测

在接收端,我们首先去除循环前缀,然后对接收到的信号进行FFT变换和QAM解调。在通信系统中,正交频分复用(Orthogonal Frequency Division Multiplexing,OFDM)是一种常用的调制技术,它可以将高速数据流分成若干个低速子载波进行传输,提高了信道利用率和抗干扰性能。接下来,我们使用训练好的神经网络对QAM调制后的数据进行检测,得到估计的FFT变换结果。深度学习方法可以通过大量的训练数据来学习信号的特征,并具有一定的适应能力,在某些情况下可能能够获得更好的检测性能。

2301_79325657的博客 296

常见反爬策略整理——TLS 指纹

讲解 TLS 指纹特征以及通用解决方案

qq_38223858的博客 3690

第1章:认识OpenClaw

OpenClaw是一个开源的 AI 智能体 Gateway 网关项目名称演变:OpenClaw 原名 Clawdbot,因 Anthropic 商标顾虑在 2026年1月27日更名为 Moltbot(过渡名),最终在1月30日确定为 OpenClaw。三个名字本质是同一个项目,功能完全一致。🏠在你的电脑上运行:完全本地部署,数据隐私有保障📁访问本地文件:可以搜索、读取、编辑你电脑上的文件🔌扩展能力:通过Skills(技能)系统无限扩展功能💬多平台使用。

Maynor的博客 2836

DBC中如何实现报文传输类型属性的配置

AUTOSAR中CAN报文的传输类型主要有三种,周期型,事件型和混合型。周期型:按固定时间间隔自动发送,无需额外的触发条件。事件型:当信号值变化或满足内部条件时立即发送。混合型:默认按周期发送,但事件触发时可提前发送。

sunchengl的博客 307

常见反爬策略整理——Webpack

以实际网站为例,讲解如何应对 Webpack 打包的网站逆向。

qq_38223858的博客 1810

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Python常见的反爬手段和反反爬虫方法

常见的反爬手段和解决思路 1 服务器反爬的原因 爬虫占总PV(PV是指页面的访问次数,每打开或刷新一次页面,就算做一个pv)比例较高,这样浪费钱(尤其是三月份爬虫)。 三月份爬虫是个什么概念呢?每年的三月份我们会迎接一次爬虫高峰期,有大量的硕士在写论文的时候会选择爬取一些往网站,并进行舆情分析。因为五月份交论文,所以嘛,大家都是读过书的,你们懂的,前期各种DotA,LOL,到了三月份了,来不及了,赶紧抓数据,四月份分析一下,五月份交论文,就是这么个节奏。 公司可免费查询的资源被批量抓走,丧失竞争力,

北山啦的博客 2697

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

常见的反爬手段和解决思路(爬虫与反爬虫)

爬虫与反爬虫

吾名招财的博客 3375

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

上一篇: 7个Python实战项目(附源码),可以白嫖
下一篇: 一名优秀的数据分析师应该具备这10项关键技能
大模型应用场景
博客等级 码龄5年 7672粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值