如何优化 MySQL 慢查询问题?

MySQL 如何优化慢查询? 在日常开发中,我们往往会给表加各种索引,来提高 MySQL 的检索效率。 但我们有时会遇到明明给字段加了索引,并没有走索引的Case。 进而导致 MySQL 产生慢查询。 严重场景下,甚至出现主从延迟、数据库拖垮的极端事故。本文梳理出索引失效的几种常见场景给大家参考。只要我们在 前加上 ,就可以分析出,当前环境下 的“查询方式”以及“索引选择”。首先大致看下每个字段的含义:下面按性能从高到低的顺序介绍type类型: 以下四种类型,说明 “性能很好,一般无需优化” :以下几种类型,需要 “看具体情况,决定 阅读详情

一、前言

在日常开发中,我们往往会给表加各种索引,来提高 MySQL 的检索效率。

但我们有时会遇到明明给字段加了索引,并没有走索引的Case。 进而导致 MySQL 产生慢查询。

严重场景下,甚至出现主从延迟、数据库拖垮的极端事故。

本文梳理出索引失效的几种常见场景给大家参考。

二、技术基础

Explain 命令使用

只要我们在 SQL 前加上 explain,就可以分析出,当前环境下 MySQL 的“查询方式”以及“索引选择”。

首先大致看下每个字段的含义:

列名

含义

id

每个select操作的唯一标识

select_type

查询的类型,我们可以根据该字段判断查询的性质,包括查询是简单/复杂查询类型

table

查询访问表的别名

type

关联的类型,mysql把查询过程都视为关联,不管是单表/多表。这个字段也是衡量查询性能的关键字段之一

possible_keys

查询可能会使用哪些索引,这列是基于查询访问的列来判断的

key

mysql最终决定使用哪个索引(这个索引不一定出现在possible_keys中)

key_len

mysql在索引里使用的字节数,我们可以根据它推断具体使用了索引中的哪些字段

ref

查找所用的列/常量

rows

mysql估算的预计扫描行数,这个数字和实际扫描的行数可能相差甚远,包括limit语句对于这个估算值也是不起作用的

filtered

表里符合条件的记录数的百分比的估计,我们可以用这个字段大致估计表关联时关联的记录数

extra

包含一些额外信息,也是我们优化时需要重点关注的字段

Type(重点看)

type 列表示了 MySQL 关联的类型,它代表了mysql是如何在表里找数据的。

下面按性能从高到低的顺序介绍type类型:以下四种类型,说明 “性能很好,一般无需优化” :

  • system:表里就一条数据

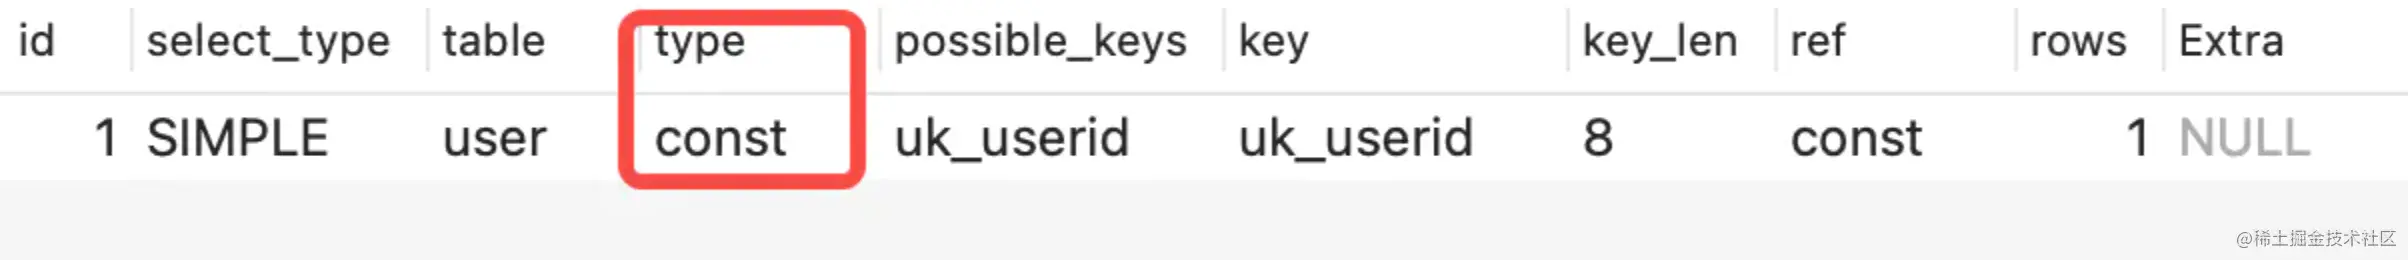
  • const:一般是针对主键/唯一键的等值查询,mysql可以把这类查询优化为一个常量表达式

  • eq_ref:一般出现在多表join时,针对主键/唯一键的等值查询,mysql知道只需要返回一条记录

  • ref:多表 join 时,针对索引字段的查询

以下几种类型,需要 “看具体情况,决定是否要优化” :

  • fulltext:关联使用了全文索引

  • ref_or_null:查询走了索引,但是除此之外还要判断字段是不是null,如果出现这种类型,可以考虑这个字段是否有为空的必要

  • index_merge:使用了索引合并优化,如果高频出现,可以考虑是不是索引设计有问题。

  • unique_subquery:in 子句中的子查询,如果只访问主键/唯一键可能会出现这种 type,并不常见

  • index_subquery:同样是 in 里的子查询,访问了索引列,并不常见

  • range:对索引字段的范围扫描,一般出现在带有比较的查询语句中,一些in和or的查询也会导致这种类型的扫描

以下两种类型,需要 “优化 & 避免出现” :

  • index:按索引进行全表扫描,如果查询不是覆盖索引的,可能会产生很大量的随机IO

  • all:全表扫描

三、准备工作

  1. 建一张 user 表

CREATETABLE `user` (
  `id` bigint(20) unsigned NOTNULL AUTO_INCREMENT COMMENT '主键',
  `user_id` bigint(20) NOTNULL COMMENT '用户uuid',
  `user_name` varchar(64) DEFAULT'' COMMENT '用户昵称',
  `email` varchar(64) DEFAULT'' COMMENT '邮箱',
  `age` tinyint(4) DEFAULT'1' COMMENT '年龄',
  `create_time` datetime NOTNULLDEFAULTCURRENT_TIMESTAMP COMMENT '创建日期',
  `update_time` datetime NOTNULLDEFAULTCURRENT_TIMESTAMPONUPDATECURRENT_TIMESTAMP COMMENT '更新日期',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_userid` (`user_id`),
  KEY `idx_username_email_age` (`user_name`,`email`,`age`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户表';
复制代码
  1. 初始化一些数据

-- 创建存储过程
delimiter $

CREATEPROCEDURE insert_user(IN limit_num int)
BEGINDECLARE i INTDEFAULT10;
    DECLARE user_id bigint(20) ;
    DECLARE username varchar(64) ;
    DECLARE email varchar(64) ;    
    DECLARE age TINYINT(4) DEFAULT1;
    WHILE i < limit_num DO
        SET user_id =FLOOR(RAND() *100000000);
        SET username = CONCAT("647-",i);
        SET email = CONCAT(username,"@163.com");
        SET age =FLOOR(RAND() *100);
        INSERTINTO `user` VALUES (NULL, user_id, username, email, age, NOW(), NOW());
        SET i = i +1;
    END WHILE;

END $
-- 调用存储过程call insert_user(100);
复制代码

四、几种常见的索引失效场景

1. 联合索引不满足最左匹配原则

  • 错误示例:

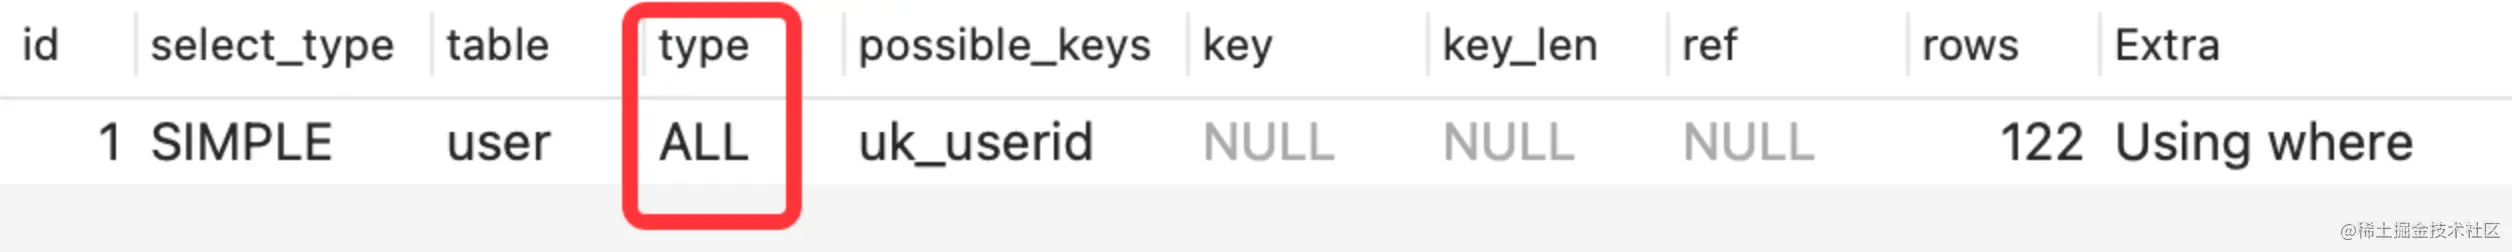
explain select*fromuserwhere age =20and email = "647@163.com";
复制代码
  • 分析结果:

  • 优化思路:

根据业务场景,合理的建立相应的联合索引。

2. 范围查询,数量级过大,默认走全表扫描

一般来说,MySQL 判断数量级返回超过全数的 10% ~ 30%(或者达到某个阈值),默认会走全表扫描。

  • 错误示例:

explain select*fromuserwhere user_id >10;
复制代码
  • 分析结果:

  • 产生原因:MySQL 优化器判断走索引&回表带来的消耗,比走全表还要多。因此,会走全表扫描。

  • 优化思路:

根据业务场景,预估返回数量级。如果数量级过大,可以分批拉取。
反之,可以加 limit 或者 force index 走索引。

3. 索引列参与运算

  • 错误示例:

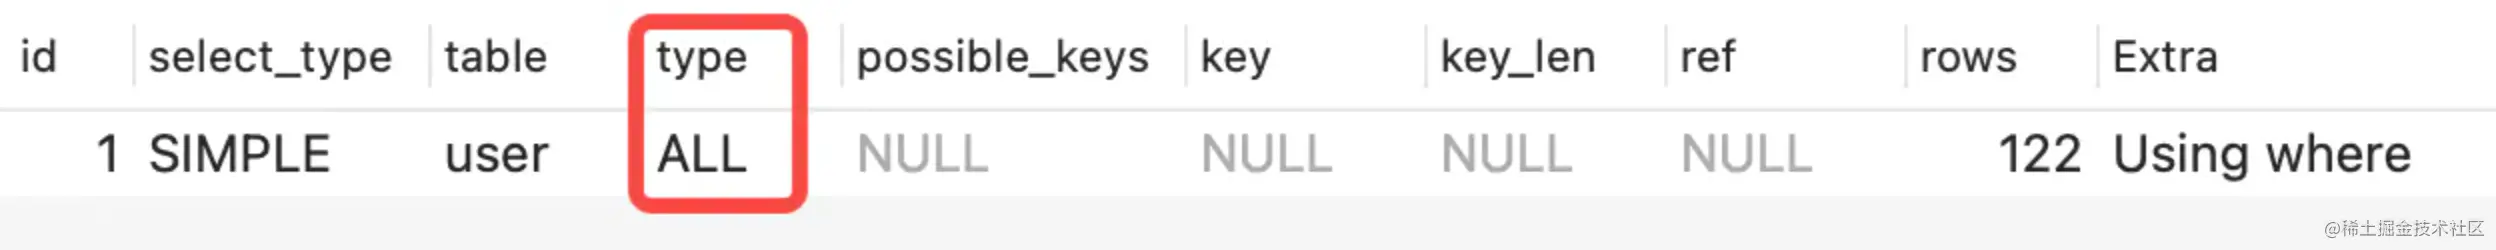
explain select*fromuserwhere id +1=2;
复制代码
  • 分析结果:

  • 优化思路:

不要用数据库做运算,不浪费宝贵的数据库资源。

4. 索引列使用了函数

  • 错误示例:

explain select*fromuserwhere SUBSTR(user_id,1,3) ='100';
复制代码
  • 分析结果:

  • 优化思路:

不要用数据库做函数运算,不浪费宝贵的数据库资源。

5. 错误的 like 使用

  • 错误示例:

explain select*fromuserwhere user_name like'%00%';
复制代码
  • 分析结果:

  • 优化思路:

严禁使用左%匹配,要用只能用右%匹配。
如果实在有业务场景,可以使用 ES 做。

6. 隐式类型转换

  • 错误示例:

explain select*fromuserwhere user_name =647;
复制代码
  • 分析结果:

user_name 是 varchar 类型,传入 INT 比较,会产生 INT -> varchar 的隐式类型转换导致索引失效。

  • 特殊 Case:

explain select*fromuserwhere user_id = "647";
复制代码
  • 分析结果:

user_id 是 bigint 类型,如果传入字符串比较。虽然产生隐式转换,但不会导致索引失效。

  • 优化思路:

注意字段类型,避免隐式转换。

7. OR 使用不当

  • 错误示例:

explain select*fromuserwhere user_name = "647" or email = "647@163.com";
复制代码
  • 分析结果:

  • 优化思路:

确保 or 的两边都要有索引。

8. 两个索引列做比较

  • 错误示例:

explain select*fromuserwhere user_id > id;
复制代码
  • 分析结果:

  • 优化思路:

不要对两个列做比较。

9. 非主键列,加上 not,索引失效

in 会走索引,not in 不会走索引exists 会走索引,not exists 不会走索引is null 会走索引,is not null 不会走索引

  • 错误示例:

explain select*fromuserwhere user_id notin (647)
复制代码
  • 分析结果:

  • 优化思路:

不要用 not。
MySQL 慢查询日志开启与问题排查指南 然而,在实际使用中,可能会遇到一些意外情况,比如执行时间很短的查询也被记录到慢查询日志中。慢查询日志是 MySQL 提供的一种日志功能,用于记录执行时间超过指定阈值的 SQL 语句。通过分析这些慢查询,我们可以发现潜在的性能瓶颈,并采取相应的优化措施。通过本文的指南,您可以轻松开启慢查询日志,并解决常见问题。如果启用了该选项,MySQL 会记录所有未使用索引的查询,即使它们的执行时间很短。设置得非常低(例如 0.001 秒),即使是执行时间很短的查询也会被记录。)可能会被记录,即使它们的执行时间很短。 阅读详情

相关推荐

【MySQL 数据量大怎么进行优化】

【MySQL 数据量大怎么进行优化】

学无止境 2672

超过1000w条数据,MySQL查询越来越慢?四种方案帮你解决!

安装和配置一个分布式数据库,如MySQL Cluster或Galera Cluster。安装和配置一个内存缓存系统,如Memcached或Redis。在查询之前,检查缓存中是否存在结果。将数据和负载分散到多个节点上。

zznn0306的博客 5838

解决MySQL慢查询问题:优化后端开发

索引是提高查询性能的关键。确保在经常被查询的列上创建索引,这样数据库可以更快地定位到需要的数据。同时,避免创建过多的索引,因为过多的索引可能会导致写操作的性能下降。MySQL提供了查询缓存功能,可以缓存查询的结果,减少数据库的访问次数。使用数据库连接池可以减少每次请求建立和释放连接的开销,并提供连接的复用。通过以上优化策略,可以显著提升MySQL数据库查询的性能,从而改善后端开发中遇到的慢查询问题。请根据具体的场景和需求选择适合的优化方法,并进行合理的测试和性能评估,以确保优化的有效性。

BbflNim的博客 128

每日一面系列之如何优化大表

大数据量的表的查询优化方案有很多,例如:创建索引、优化查询语句、缓存查询结果、提升硬件配置、数据归档和分离,以及数据分片技术(分库分表)等,而这些技术通常是一起配合使用,来共同解决大数据量表的查询速度慢的问题的,其中分库分表的实现最为复杂,所以需要根据自身业务的需要酌情使用。

mclongyi的专栏 390

C# OpenCvSharp4实战:5分钟搞定工业视觉模板匹配(附完整代码)

本文为C#开发者提供了基于OpenCvSharp4的工业视觉模板匹配实战指南。通过详细的环境搭建、核心原理解析和完整代码示例,重点介绍了如何使用`matchTemplate`函数,特别是`CCoeffNormed`方法,快速实现高精度、抗光照变化的模板匹配,并分享了多目标匹配、图像预处理等工业级优化技巧。

weixin_29053067的博客 506

利用LATX技术在龙芯安同AOCS OS上部署坚果云:跨架构文件同步实战

本文详细介绍了如何在龙芯安同AOCS OS上,利用LATX指令翻译技术部署坚果云客户端,实现跨架构文件同步。通过安装LATX环境、解压x64安装包、运行安装脚本三步,成功在loongarch64架构上运行仅支持x86_64的软件,解决了国产平台办公协同的痛点,并分享了性能实测与优化建议。

weixin_29305337的博客 458

深入解析MySQL慢查询问题:原因分析、优化策略与持续监控

在MySQL中,慢查询是指执行时间超过指定阈值的SQL语句。MySQL默认的阈值是10秒,但这个值可以根据实际业务需求进行调整。慢查询的存在会对数据库性能产生显著影响,尤其是在高并发的场景下,可能导致数据库响应缓慢,甚至引发系统崩溃。

1647

C语言设计模式全面解析:从理论到28个实战示例

本文系统介绍了23种经典设计模式在C语言中的实现方法。通过结构体、函数指针等技巧,C语言可以优雅地模拟面向对象特性,实现代码复用与解耦。文章分类详解了创建型、结构型、行为型三大类模式,并提供了28个完整代码示例,包括单例、策略、观察者等核心模式的精简实现。这些模式在嵌入式系统、操作系统内核等场景中广泛应用,如状态机、事件驱动等。学习C语言设计模式的关键在于理解模式意图,掌握函数指针和结构体组合等技巧,并在实际项目中灵活运用。本文为C语言开发者提供了全面的设计模式参考指南。

数字人生 364

【MySQL进阶-07】深入理解mysql性能优化以及解决慢查询问题

深入理解mysq的性能优化

zhenghuishengq的博客 2万+

【第41篇】ConvMAE:Masked Convolution 遇到 Masked Autoencoders

摘要 论文地址:https://arxiv.org/pdf/2205.03892 视觉转换器 (ViT) 已成为各种视觉任务广泛采用的架构。用于特征预训练的掩码自动编码 [2、1、28、55] 和多尺度混合卷积变换器架构 [12、21、49、34、57] 可以进一步释放 ViT 的潜力,从而实现最先进的图像分类、检测和语义分割的艺术表演。在本文中,我们的 ConvMAE 框架证明了多尺度混合卷积变换器可以通过掩码自动编码方案学习更多的判别表示。然而,直接使用原始掩码策略会导致计算成本和预训练-微调差异。为了

AI浩 2816

Python爬虫实战:基于最新技术栈的晋江文学城小说爬取

本文将详细介绍如何使用Python最新技术栈构建一个高效的晋江文学城小说爬虫。我们将从爬虫基础知识讲起,逐步深入到反爬机制应对、分布式爬虫设计以及数据存储优化等高级话题。文章包含完整的代码实现,使用aiohttp+asyncio实现异步爬取,Playwright处理动态渲染,并结合Redis实现分布式任务队列。本文旨在为读者提供一个全面的现代Python爬虫开发指南。网络爬虫(Web Crawler)是一种自动抓取互联网信息的程序,广泛应用于搜索引擎、数据分析和内容聚合等领域。

2201_76125261的博客 873

生产问题定位-MySQL慢查询与索引优化

@auther 张念磊 @date 2021-10-01 文章目录一、现象二、定位慢查询三、解决问题四、总结与思考 今天闲来无事,写篇文章记录下本周遇到的一个生产问题。 一、现象 有一个服务每三十秒跑批一次来统计数据,按理说数据应该是每30秒刷新一次,但用户反馈数据10多分钟才能改变一次。 登录到生产的服务器,数据库服务单个线程的CPU占用率为 400%左右,这肯定是不健康的。 且该线程为mysql,基本可以断定:出现了慢查询。 二、定位慢查询 找来我们的运维工程师,打开数据库的慢查询 打开数据库慢查询三

张念磊的博客 345

SAP 创建PO时提示“不能确定任何组件”

SAP 创建委外加工的PO时提示“不能确定任何组件” 而如果BOM已经创建了,但还是提示该错误保存。 解决办法:1. BOM selection 未配置好; 2. 由于Purchasing prosessing time的设置,如果PO中的delivery time - Purchasing prosessing time是过去的日期,那么会找不到BOM,BOM的有效期需早 于PO审批的有效期。 3. BOM未...

willieyuan的博客 6122

记一次关于 Mysql 中 text 类型和索引问题引起的慢查询的定位及优化

最近有用户反馈产品有些页面加载比较慢,刚好我在学习 Mysql 相关知识,所以先从 Mysql 慢查询日志开始定位: step1:通过慢查询日志定位具体 SQL 首先通过 SHOW VARIABLES like 查看当前 Mysql 服务器关于慢查询的具体配置信息: slow_query_log = ON # 慢查询日志处于开启状态,所以可以直接查询 slow_q...

zdplife的专栏 1万+

abapGit 安装与初始化完整指南:从 on-premise 到 SAP BTP ABAP environment 的一条龙实践

本文为ABAP开发者提供abapGit从安装到团队协作的完整指南。内容涵盖社区版ZABAPGIT的on-premise安装、Eclipse ADT插件配置、BTP环境使用及常见网络问题处理。重点包括:获取最新构建的安装步骤、EN语言环境的重要性、ADT插件安装方法、以及如何实现on-premise与BTP间的代码迁移。文中特别强调企业环境下代理设置、证书配置等注意事项,并提供实际操作案例,如将RAP业务对象迁移到BTP环境。文末附有可复用的实施清单,帮助开发者快速落地abapGit。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 420

破局KS滑块验证码:从参数加密到轨迹生成,Python逆向全流程避坑实录

快手滑块验证码破解实战:从逆向分析到自动化实现 摘要:本文详细记录了破解快手滑块验证码(KS滑块)的完整过程。通过48小时的逆向分析,揭示了KS滑块的双重校验机制:不仅需要精准定位滑块缺口位置,还需满足参数加密和轨迹特征校验。文章从反爬逻辑分析入手,介绍了工具选型与环境配置的避坑要点,重点讲解了滑块缺口距离计算方法和核心加密参数slide_sign的逆向过程。通过OpenCV边缘检测和Frida动态调试技术,成功实现了滑块验证的自动化,准确率提升至99%。文中附有Python实现代码和实际操作踩坑记录,为开

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1665

**深入剖析MySQL性能问题:架构、索引、DDL、DML及慢查询优化实践**

在理解MySQL性能问题之前,首先需要了解MySQL的整体架构。连接层:负责处理客户端连接和权限认证。服务层:提供查询解析、缓存、优化、执行等服务。MySQL的查询优化器就在这层,主要负责生成执行计划。存储引擎层:负责与物理存储进行交互,不同的存储引擎有不同的存储机制、锁机制、索引支持等。常用的存储引擎有InnoDB和MyISAM。物理存储层:与磁盘打交道,进行文件的读写操作。MySQL架构的分层设计可以帮助我们更好地理解性能问题出现的地方以及如何进行针对性的优化。

zx893404890的博客 1161

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

mysql text的问题_记一次关于 Mysql 中 text 类型和索引问题引起的慢查询的定位及优化...

最近有用户反馈产品有些页面加载比较慢,刚好我在学习 Mysql 相关知识,所以先从 Mysql 慢查询日志开始定位:step1:通过慢查询日志定位具体 SQL首先通过 SHOW VARIABLES like 查看当前 Mysql 服务器关于慢查询的具体配置信息:slow_query_log = ON # 慢查询日志处于开启状态,所以可以直接查询 slow_quer...

weixin_32254411的博客 648

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

(线上问题排查)2.深度剖析:一条MySQL慢查询的全面优化实战

MySQL性能优化案例:从5秒到0.05秒的优化之路。文章完整记录了线上核心业务API响应时间突增问题的排查过程,通过开启慢查询日志捕获问题SQL,深度分析执行计划发现索引缺失、文件排序等瓶颈。提出多维度优化方案:创建复合索引、查询重写、数据归档和分区表。最终使查询性能提升100倍,执行时间从4.8秒降至0.05秒。强调MySQL优化需要系统性方法,建议建立常态化的性能监控机制,并推荐使用Percona Toolkit等工具进行持续优化。

weixin_44385781的博客 768

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

有效解决MySQL慢查询:从问题排查到性能优化

经验教训慢SQL优化需要结合业务场景,避免盲目创建索引或调整配置。定期清理历史数据,减少查询数据量。通用建议定期审查SQL与索引设计。使用链路跟踪工具(如SkyWalking)定位问题。推荐资源《高性能MySQL》(https://www.mysql.com)慢SQL分析工具:Percona Toolkit(https://www.percona.com/software/database-tools/percona-toolkit)

weixin_43228360的博客 396

MySQL慢查询问题:诊断与优化策略

MySQL慢查询问题是一个复杂而重要的问题,需要综合运用多种诊断和优化策略来解决。通过开启慢查询日志、分析慢查询日志、使用EXPLAIN命令分析查询计划以及检查服务器负载情况等方法,可以准确地定位慢查询的瓶颈点。然后,通过优化查询语句、使用缓存机制、调整MySQL配置参数以及升级硬件资源等策略,可以有效地提升MySQL的查询性能和用户体验。

2408_88802129的博客 585

mysql优化之问题查找-慢查询日志,explain

慢查询日志 set global slow_query_log='ON' ;开启慢查询,重启失效 my.cnf 永久生效 show VARIABLES LIKE '%query%'; slow_query_log 慢查询是否开启 long_query_time 慢查询时间阈值 slow_query_log_file 慢查询日志的位置 记录的信息: 查询慢的sql,sql的执行时间,锁表时间,扫描过的行数 慢查询分析工具 mysqldumpslow mysqldumpslow –s c...

离阳的博客 283

MYSQL 慢查询和慢查询日志

慢查询和慢查询日志是数据库性能优化中重要的工具。通过记录慢查询,我们能够快速定位性能问题、优化查询语句,提高系统的响应速度和稳定性。在使用慢查询日志时,合理配置日志参数、使用专业工具进行分析,并结合系统性能监控,能够更好地发现和解决潜在的性能瓶颈,确保数据库系统的高效运。

wangxuanyang_zer的博客 1777

如何处理 MySQL 的慢查询问题?

在MySQL中,如果一条SQL语句执行时间超过了预设的时间阈值(默认为10秒),则这条SQL语句就会被视为“慢查询”。通常情况下,这些慢查询会记录在日志文件中,供数据库管理员(DBA)进行后续分析与优化。

yjq125931902的博客 931

MySQL学习笔记5——优化问题(短连接,慢查询,QPS激增)

正常的短连接模式就是连接到数据库后,执行很少的SQL语句就断开,下次需要的时候再重连。 如果使用的是短连接,在业务高峰期的时候,就可能出现连接数突然暴涨的情况。解决方法:(有损)在MySQL中,会引发性能问题的慢查询,大体有以下三种可能:1.索引设计问题 可以创建online DDL,直接执行alter table,比较理想的是能够在备库先执行。假设你现在的服务是一主一备,主库A、备库B,这个方案的 大致流程是这样的:2.语句没写好 可能的情况:解决方法: 改写SQL语句来处理。MySQL 5.7提供了查询

strive for the best 的博客 733
上一篇: 已经变了….谈谈对现在大环境的一些想法与思考
下一篇: 你的【架构设计】应用该如何分层呢?
Java_LingFeng
博客等级 码龄4年 505粉丝 259原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值