






毫无疑问,AIGC是当下最火热的领域之一,无论是语言模型ChatGPT还是图像生成模型Stable Diffusion/Midjourney,或许都将成为改变大家未来的起点,对各种创作领域也将带来极大的冲击。在AIGC繁荣发展的同时,背后的功臣——GPU,也再次成为了玩家们热议的焦点。与此同时,可以离线部署的Stable Diffusion(简称:SD)的出图性能,也让大家能从另一个维度衡量来显卡的性能。下面我们也一起来看看吧。
Stable Diffusion是如何画出想要的图片的?
说起AI绘图,除了在线生成、需要付费使用的Midjourney以外,大家肯定还会想到可以免费离线部署的Stable Diffusion。实际上,Stable Diffusion是一种算法,直译过来就是稳定(Stable)扩散(Diffusion)算法。而我们平时使用的在浏览器操作的界面,就是由 AUTOMATIC1111 开发的Stable Diffusion的WebUI,也就是图形界面。
 Stable Diffusion文生图工作流程示意图
在图像算法领域中,扩散算法是通过一定的规则正向扩散(加噪)或反向扩散(去噪)的过程。如果开启了Stable Diffusion WebUI的预览功能,大家就可以看到在生成一张图片时,图片是从最开始的一张灰色噪点图块逐渐变清晰直到成为想要的图片。
简单来说,在Stable Diffusion的文生图工作时,就是通过CLIP模型作自然语义处理,将自然语义提示词(Prompt)转化为词向量(Embedding)。然后通过UNET大模型进行分步扩散去噪,最后通过VAE变分自编码器进行压缩(Encoder)和反解(Decoder),最终解析生成我们想要的分辨率大小的图片。当然,实际的算法和流程比这个要复杂不少,限于篇幅我们不做进一步详解。
AI深度学习与显卡的共同进化史
硬件配置方面,由于Stable Diffusion需要用到Pytorch框架,而NVIDIA的CUDA生态在Pytorch上有着更好的表现,AMD显卡、Intel显卡和CPU在Windows环境下则需要使用到Pytorch-DirectML才能正常使用,在效率、易用性和兼容性方面都有一些不足。在Linux环境下,AMD显卡还可以通过ROCm来实现更高的效率,但总体而言还是不如NVIDIA的CUDA生态。所以如果想要有更好的体验Stable Diffusion,建议使用NVIDIA GPU的显卡。
其实在多年以前,游戏显卡的作用其实还是比较纯粹的,几乎就是游戏娱乐,并不能很好的用于AI深度学习计算等,或者说效率不是很高。不过这一切随着NVIDIA Volta架构的Titan V显卡上市而得到了改变。

 TensorCore的出现极大的增强了AI深度学习能力
Titan V第一次将TensorCore张量计算核心带到了用户面前,它支持FP16和FP32下的混合精度矩阵乘法,深度学习峰值性能远超Pascal架构产品,也就是从这里开始,显卡的深度学习性能有了大幅的进步。而Stable Diffusion可以使用FP16半精度和FP32单精度进行推理计算。
而让普通消费级玩家真正开始接触TensorCore张量计算核心,则是从Turing架构的RTX 20系列GPU开始。也正因此,RTX 20系列显卡可以完成光线追踪和DLSS等复杂计算。在算力提升的同时,第二代TensorCore还加入了对INT8和INT4的支持,进一步丰富了深度学习训练和推理能力。
第三代TensorCore伴随Ampere架构的RTX 30系列显卡问世,在继续提升算力的同时,还引入了BF16和TF32两种新的数据格式,同时还能够提供稀疏化加速,进一步提升TensorCore的性能。
当下主流的Ada Lovelace 架构RTX 40系列显卡搭载了最新的第四代TensorCore,新增了Hopper FP8 Transformer Engine。FP8低精度浮点数特性能够让近年来火热的AI框架Transformer获得极大的收益,让深度学习性能得到了巨大的飞跃。对于游戏玩家来说,新的架构所支持的全新的DLSS3,同样也是基于深度学习神经网络完成的。
回到Stable Diffusion上,目前主流的Stable Diffusion 1.5可以使用FP16和FP32。FP32相比FP16有着更高的精度,不过RTX 20系列的FP32性能只有FP16的一半,而RTX 30和RTX 40系列虽然FP32和FP16性能一致,但FP32占用的显存是FP16的两倍,使用起来不是很划算。所以在实际使用中,为了追求更高的速度和更小的显存占用,通常大家更优先考虑使用FP16。
也就是说,使用Stable Diffusion进行AI绘图,我们需要关注显卡的FP16/FP32性能(重点关注FP16)。当然,绘图性能是一个综合考量,和显卡的架构、频率也有着一定的关系,在进行高分辨绘制时,还要留意显存容量的大小。性能决定了绘图的速度,而显存容量则决定了能不能画。
另外值得一提的是,最新的SDXL大模型还可以使用BF16进行训练,对于不支持BF16的显卡来说,未来的应用范围可能会越来越窄。
AI绘图性能测试,不同场景不同表现
Stable Diffusion的发展非常迅速,短短不到一年的时间,它能实现的功能也是越来越多,国内社区的发展也是越来越成熟,国内模型作者带来的底模和Lora等数量也是越发丰富。我们也可以更全面的分析不同显卡在不同工况下的AI绘图性能对比。
这次我们给大家带来了从RTX 2060 Super到RTX 4090一共17款显卡的Stable Diffusion AI绘图性能测试。由于目前SDXL还不够成熟,模型数量和插件支持相对也较少,且对硬件配置的要求进一步提升,所以暂时依旧使用SD1.5进行测试。测试环境方面,我们使用国内作者秋葉最新版整合包,模拟了3种应用场景进行测试。
**测试环境:
**Stable Diffusion WebUI:1.5.1
Xformers:0.0.20
python:3.10.11
torch:2.0.1+cu118
ControlNet:v1.1.237
**测试平台:
**CPU:Intel酷睿i9 13900K
显卡:NVIDIA RTX 20/RTX 30/RTX 40共17款
主板:ROG MAXIMUS Z790 HERO
内存:十铨DDR5 7200 16GB×2
硬盘:WD_BLACK SN850X 2TB
电源:ROG雷神2代 1000W
测试一:大模型直接生成图片/“Tag抽卡”
模型:StableSRv2
Lora:无
外挂VAE模型:无
采样方法:Euler a
迭代步数:50
分辨率:768×768
总批次数:10
单批数量:2
正向提示词:beautiful render of a Tudor style house near the water at sunset, fantasy forest. photorealistic, cinematic composition, cinematic high detail, ultra realistic, cinematic lighting, Depth of Field, hyper-detailed, beautifully color-coded, 8k, many details, chiaroscuro lighting, ++dreamlike, vignette
 测试一通过提示词生成类似这样的房屋与环境图片
第一个测试来自英伟达测试指南提供的模型和提示词,生成分辨率为768×768的图片,这个测试基本就是使用底模纯Tag抽卡,没有加载Lora,甚至连反向提示词也没有,整体压力相对比较小。

从测试结果来看,RTX 4090的出图速度以压倒性的优势排在第一,每分钟可以生成19.73张图,也就是差不多3秒就可以画好一张。出图速度达到了上代旗舰RTX 3090 Ti的1.76倍,RTX 3090 Ti是没有跑赢RTX 4080的。而RTX 4070 Ti略微超过RTX 3090,RTX 4070也能跑赢RTX 3080。总体来看,在中高端产品线上,RTX 40系列还是有着比较大的优势的。
在这17张显卡中,RTX 3060的表现稍微有些欠佳,基本上只能和RTX 2060 Super差不多,当然,RTX 4060也没有快多少。
虽然这套测试标准比较简单粗暴,但是还是能比较直观的反映出图性能表现的。毕竟现在很多国内大神训练的底模,通过提示词直接抽卡也能获得比较不错的图片了。
测试二:人物大模型+Lora+高分辨率修复
模型:墨幽人造人
Lora:4个
外挂VAE模型:无
采样方法:DDIM
迭代步数:50
原生分辨率:512×768
高分辨率修复:1024×1536(迭代0步/重绘0.2/放大倍数2)
放大算法:8X_NMKD-Superscale_150000_G
总批次数:10
单批数量:1
正向提示词:1girl,eye contact,sunlight,<lora:jk uniform:0.5>,(JK_suit),(JK_shirt),JK_style,(dark blue JK_skirt),standing,arms behind back, white thighhighs,3d,unity 8k wallpaper, ultra detailed, beautiful and aesthetic,cherry blossoms,(depth of field:1.5),lora:jkheisi_1.0:0.5,black pantyhose,lora:FilmGirl_3.0:0.4,<lora:tutu face_V2.0:0.8>
 测试二通过提示词生成类似这样的人物图片
目前Stable Diffusion模型中最受欢迎数量最多的便是各种人物模型。在第二个测试中我们将大模型换成了国内作者训练的真人风格模型,同时给人物使用了4个Lora,分别控制服装、脸部和画面风格。为了得到更高清的图像,同时也给显卡更大的压力,这次还加入了高分辨率修复(HiresFix),将图片分辨率从初始的512768放大2倍到10241536。

这一次的算力需求明显变高,即使强如RTX 4090,每分钟也只能画出3.75张图,也就是差不多16秒才能画出一张图了。和上一个测试不同的是,这次RTX 3060终于是跑赢了RTX 2060 Super,RT 4060也跑赢了RTX 2070 Super。从这个测试来看,在这样负载稍高一点的情况下,最近两代的优势会显得更加明显一些。这大概是两方面的原因导致的,一是在加入了高分辨率修复后,显存压力变大,有更大显存的显卡,如RTX 3060,虽然FP16算力略低于RTX 2060 Super,但凭借显存容量优势获得了更好的表现。而且,新版本的CUDA深度神经网络库(cuDNN)对RTX 30和RTX 40系列的优化显然更好,在相对复杂的场景中有着更高的生成效率。
测试三:ControlNet Tile高清修复
模型:MajicMix_nwsj
Lora:1个
外挂VAE模型:无
采样方法:DPM++ 2M SDE Karras
迭代步数:30
原生分辨率:512×512
输出分辨率:1280×1280
ControlNet:Control_v11f1e_sd15_tile_fp16
控制模式:均衡
缩放模式:仅调整大小
正向提示词:(fluorescent colors:1.4),(translucent:1.4),(retro filters:1.4), (fantasy:1.4), candy world Disney land ethereal soft fluffy soft landscape forest snowavatar Pastel pink sky green blue sparkle ethereal light pastel whimsical light rainbow stars diamonds sparkle gemstone background hyper realistic Ultra quality cinematic lighting immense detail Full hd painting Well lit,diagonal bangs, .ball gown dress,rabbit pose.masterpiece, best quality,realskin,(portrait:1.5), 1girl, blunt bangs, long hair lora:OC:0.5.
ControlNet可以说是Stable Diffusion中必不可少的插件,为Stable Diffusion带来了更多的玩法和更强大的画面控制能力。其中Tile模型也是凭借强大的功能广受大家喜爱,它的功能之一就是高清修复模糊图片。我们这里用之前生成的一张512×512的图片,可以看到因为分辨率的限制,细节方面还是有些不足。放入ControlNet Tile修复,并将分辨率提升至1280×1280,可以看到修复后的细节确实好了不少。

在这个测试中,RTX 4090每分钟出图5.45张,也就是每11秒就可以出一张图,相对于其他显卡依旧是压倒性的优势。而其他显卡的性能排名又有了一些细微的变化,大致来看的话,RTX 40系列的表现比前一个测试要好一些,RTX 4060Ti跑赢了RTX 3070 Ti,RTX 4070 Ti也略微超过了3090 Ti,看来在ControlNet Tile模型应用下,新版CUDA深度神经网络库(cuDNN)对于RTX 40系列有着更好的优化。
 测试三高清修复后可以看到细节明显增多
因为测试分辨率的提高,显存占用也更大,根据Stable Diffusion系统信息的反馈,显存最高占用大概是9.1GB左右,也就是说稍微超出了8GB显存容量,所以我们也可以看到,在这个测试中,有着更大容量显存的卡表现会更好一些,从有着12GB显存的RTX 4070开始,性能有着比较明显的提升。
从以上三个测试来看,测试中最低端的显卡RTX 2060 Super的出图效率,差不多刚好是最高端的RTX 4090的五分之一左右。所以大家常说的生产力就上RTX 4090,确实是没错的。因为以上测试条件也是尽量控制了不超出或者不过多的超出8GB显存这个范围,所以这时GPU本身的性能是要比显存容量更为重要的。
如果以当前全新显卡的售价为准,将出图数量除以价格,得到的每块钱出图效率的话,其实低端的RTX 2060 Spuer和RTX 3060 12GB是有着很高的性价比的。在新的RTX 40系列中,则是RTX 4060 Ti和RTX 4070有着较高的性价比。当然,这是在完全不考虑效率的情况下,如果你是作为生产力工具来使用的话,还是建议购买更高端的产品。比如算成24小时连续不断出图数量的话,RTX 4090要比RTX 2060 Super多出4000张左右了(以测试二为基准),绝对数量的差距还是非常大了,这还是在不考虑显存容量提升能带来更多应用场景的前提下。
因为在生成高分辨率图片时会占用大量显存,而显存耗尽后,即使通过设置或插件实现不爆显存的操作,也是要调用内存进行处理的。因为内存带宽远低于显存,还要通过PCIe总线交换数据,所以会大幅增加出图时间。
比如我们使用测试二的方法,将原始分辨率提升到720×1024并使用高分辨率修复2倍到1440×2048,单批数量改为2。此时的显存最高占用将会达到16.4GB左右,也就是说这次参加测试的显卡除了RTX 4090、RTX 3090 Ti和RTX 3090之外都会超出显存范围。

如果以RTX 4090的性能为100%的话,在这种情况下,参测的大部分显卡相对RTX 4090的性能比例都有所下降(对比测试二),而其中8GB显存显卡的下降幅度要明显多于12GB/16GB显存的显卡,比较直观的是,在这里RTX 4060已经跑不赢RTX 3060 12GB了, RTX 20系列更是几乎是成倍的下降。
总结:根据需求选显卡,显存容量要注意
如果你只是偶尔画几张图玩一玩或者学习下使用方法,其实大概率不是随时都能用得到这么大的显存的,8GB显存的显卡其实已经能够满足很多需求了。因为SD1.5大模型自身的原因,很多都无法实现高分辨率图片直出。直接生成1000×1000以上分辨率的图片大概率会出现“三头六臂”或者细节模糊等情况,而相比占用显存较高的高分辨率修复,玩家也可以通过Tiled Diffusion+Tiled VAE的方式来实现图片放大。
当然,随着目前SDXL大模型的演进,绘图分辨率得到进一步提升,显存需求也有着明显的提高,如果你想在这个领域深耕下去,并将其转换为生产力工具,那么更大显存容量的显卡或许是你优先考虑的目标,毕竟显存容量决定了能不能跑,显卡性能才能再决定跑得快不快。这个时候再回过头去看NVIDIA低调上线的RTX 4060 Ti 16GB,用意或许就很明显了。如果你在生成的同时,还有训练模型的需求,那么大显存容量的显卡,可以说几乎是必备了。
不管你是支持还是反对,以Stable Diffusion为代表的AI终将会对我们未来的工作生活带来一些影响,各位玩家觉得该如何面对呢?
关于AI绘画技术储备
学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!
对于0基础小白入门:
如果你是零基础小白,想快速入门AI绘画是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以找到适合自己的学习方案
包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!
需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

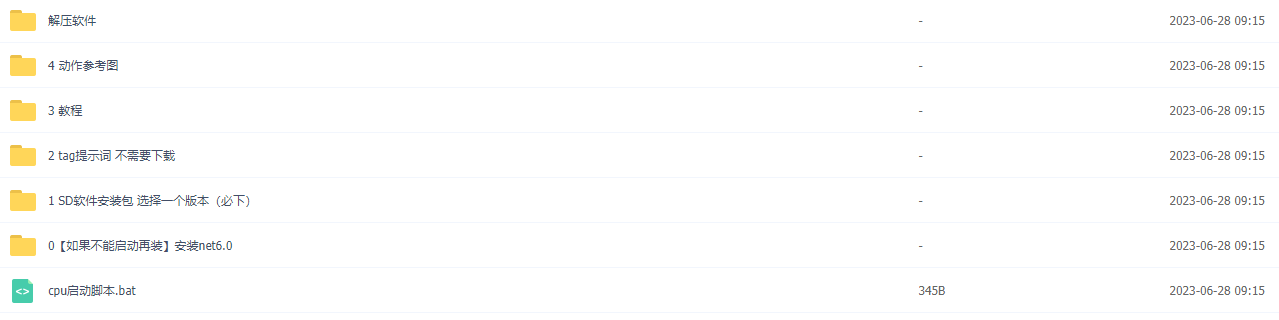
1.stable diffusion安装包 (全套教程文末领取哈)
随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。
最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
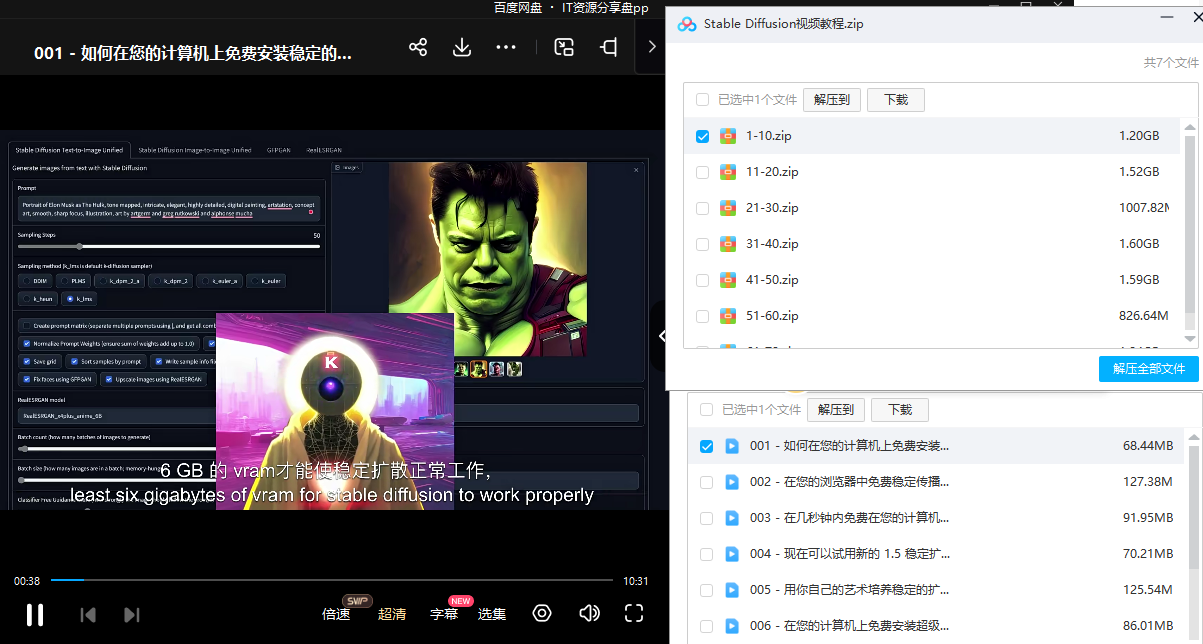
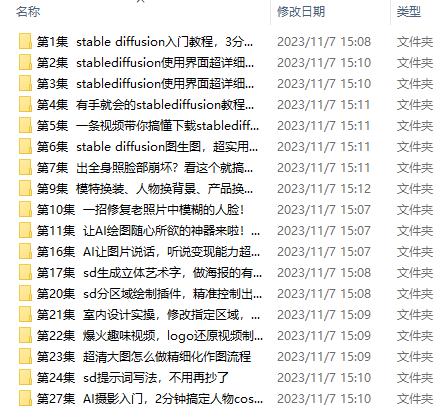
2.stable diffusion视频合集
我们在学习的时候,往往书籍代码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入门stable diffusion,科学有趣才能更方便的学习下去。
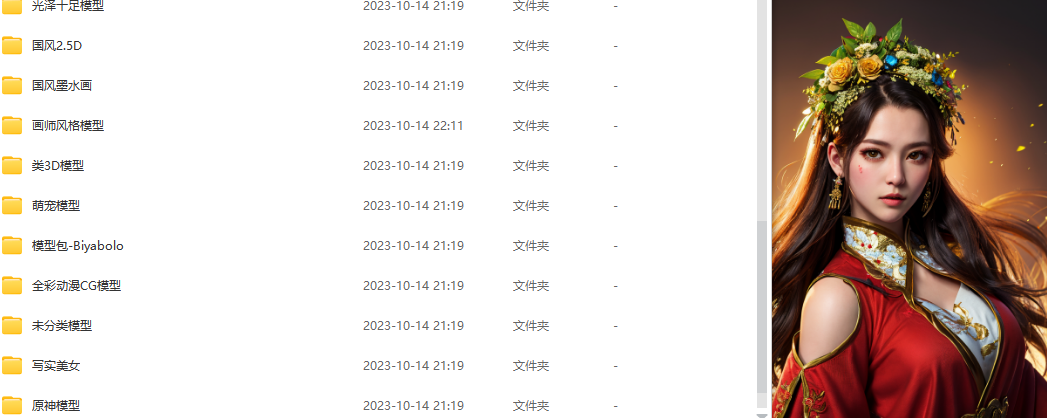
3.stable diffusion模型下载
stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
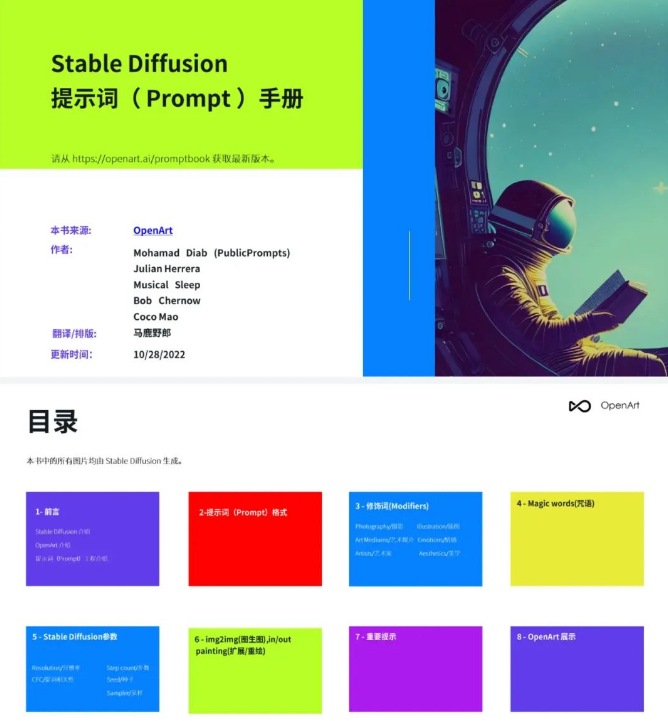
4.stable diffusion提示词
提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
5.AIGC视频教程合集
观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
实战案例
纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 279


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


