【stable diffusion模型】Stable Diffusion 3.5 能力挽狂澜吗?

AI绘画扛把子sd新升级!stablediffusion 3.5版本使用指南 如果你已经在使用Flux 或 MidJourney,转到SD 3.5 并不会带来巨大的不同,但它的性价比和可操作性依然使它成为一个不错的选择。它可以生成非常精美的艺术画作,尤其是对一些细节的把控更为细腻,生成的画面有着更强的艺术感。Flux 更擅长创意发散,生成的图像在创意性和风格多样性上有着不错的表现,尤其是在一些实验性风格或者复杂的艺术风格上,表现得更加出色。简单来说,Large 适合需要高质量图像的专业用户,Turbo 是追求速度的理想选择,而 Medium 则是小配置设备的福音。 阅读详情

前言

大家好,我是每天分享AI应用的小南!

前几天 Stability AI 发布了 Stable Diffusion 3.5,相比之前的 SD3 发布,这次 Stable Diffusion 3.5 学乖了很多,对社区友好了很多:研究或非商业用途、以及年总收入不足100万美元的组织或个人的商业用途都可以免费使用。这个效果还是很明显的,huggingface 上很快出现了很多基于 SD3.5 的衍生模型。

Stable Diffusion 3.5 大模型是一款多模态扩散变换器(MMDiT)文本到图像模型,其特点是在图像质量、排版、复杂提示理解和资源效率方面具有改进的性能。

目前还是 ComfyUI 对 SD3.5 的支持更好,Stable Diffusion WebUI 还不支持3.5,SD WebUI 的衍生版本 SD WebUI Forge 好像已经支持 SD3.5,不过我还没有测试。最近一年 AUTOMATIC1111慢了很多,SD WebUI的社区有点沉寂了,不知道敏神的 stable-diffusion-webui-forge 能否接过WebUI的衣钵,让这个工具再次活跃起来。

下面我们就来详细了解下这个模型。

所有的AI设计工具,安装包、模型和插件,都已经整理好了,👇获取~

在这里插入图片描述

效果

废话不多说,先看看效果。

模型

基础模型

这次 Stability AI 一连发布了三个大模型SD 3.5 Large、SD 3.5 Large Turbo 和 SD 3.5 Medium 。

1、SD 3.5 Large

完整模型需要20个采样步骤。每张图片处理时间为20秒。

仓库地址:https://huggingface.co/stabilityai/stable-diffusion-3.5-large

2、SD 3.5 Large Turbo

这是SD 3.5 Large的蒸馏版,模型生成图片只需要4个采样步骤。每张图片处理时间为10秒。

仓库地址:https://huggingface.co/stabilityai/stable-diffusion-3.5-large-turbo

3、SD 3.5 Medium

这是 SD 3.5 Large 的一个较小的检查点,使用的是MMDiT的一个改进模型,在变换器的前13层引入自注意力模块,增强多分辨率生成和整体图像的一致性。SD 3.5 Medium也内置了文本编码器/CLIP。

仓库地址:https://huggingface.co/Comfy-Org/stable-diffusion-3.5-fp8

模型下载后通常的存放路径是:ComfyUI > models > checkpoints,就是基础模型的路径,具体的路径可能和你的设置有关。

如果你访问 huggingface 不方便,也可以使用我整了的模型集合,下载方式见文末。

文本编码器模型

SD 3.5 支持多个文本编码器,这和SD3、Flux等使用文本编码器的方式差不多。

  • clip_l.safetensors

  • clip_g.safetensors

  • t5xxl_fp16.safetensors 或者使用更小尺寸的 t5xxl_fp8_e4m3fn.safetensors 代替

仓库地址:

https://huggingface.co/stabilityai/stable-diffusion-3.5-large/tree/main/text_encoders

如果你访问 huggingface 不方便,也可以使用我整了的模型集合,下载方式见文末。

显存需求

最少也要12G显存,多多益善,24G最佳,当然32G更好。

本地没有合适显卡的同学,可以试试我制作的ComfyUI云镜像,内置大量工作流,开局就送体验金,可以免费用几个小时:https://www.haoee.com/applicationMarket/applicationDetails?appId=27&IC=XLZLpI7Q

图片尺寸

标准的图片分辨率是 1024×1024。就像 SDXL 和 Flux,你也可以使用其它比例的尺寸,只要大概在1M像素就可以。推荐图片尺寸:

  • 1:1 – 1024 x 1024

  • 5:4 – 1152 x 896

  • 3:2 – 1216 x 832

  • 16:9 – 1344 x 768

使用SD3.5

升级到最新版本(至少要10月26日的版本)。

下边是一个最基础的SD3.5的工作流,包括:SD3.5基础模型、CLIP模型、提示词、Latent潜空间、采样器等。

如果你选择的是SD3.5官方发布的原版Large或者Medium模型,CLIP模型需要单独加载。

使用LoRA模型也很简单,串联一个LoRA模型就可以了。

与前几代模型的对比

这里做个简单的对比。

基础模型依次是:SDXL Base 1.0 -> SD3 Medium -> SD 3.5 Large

提示词:masterpiece, best quality, 1girl, long hair, brown hair, looking at viewer, smiling, blue and white clothes, upper body, flower garden, photorealistic,

从上图可以看出,SDXL的塑料感比较强,SD3有些用力过度,SD3.5的真实感更强。从这个简单的对比上看SD3.5确实在进步。

与Flux.1模型的对比

大家先自己对比下看看,左侧是Flux.1生成的,右侧是SD3.5生成的。

提示词1:

Black and white photo, a 1930s celebrity, a sensuous young woman, looking at the viewer, a little smile, close up to the face, perfect lighting, dark background

提示词2:

Vibrant Colorful Realistic analog photo, very detailed, hyper detailed, photorealistic, hyperdetailed, uhd, 4k, the focus of the image is on the witch, extreme closeup Face Portrait, extreme face closeup, head focus, Realistic analog photo, awesome, high Quality, photorealistic, atmospheric lighting, volumetric lighting, cinematic, Epic Film Quality, dense Sand storm, dust, floating Sand,

Capture the essence of medieval valor in this close-up shot: a weathered knight with spiked hair in high collar armor bearing a bold text crafted masterfully from its metal “buzz”. Positioned in a morning dueling arena, he awaits his opponent with a stance of readiness. Let the fluttering banners and flags in the wind tell the story of anticipation and honor on the battlefield.

提示词3:

A high-resolution, waist up portrait of a young woman in her early twenties with a soft, innocent expression, exuding a sense of Victorian elegance. She has fair, porcelain skin and wide, doe-like eyes that sparkle with a hint of mystery. Her lips are painted a gentle rose shade, slightly parted. Her dark, wavy hair is styled in an elegant Victorian updo adorned with a lace ribbon. She wears a vintage, dress with intricate lace details and a cameo brooch at her neck, evoking both innocence and old-world charm. The background is dimly lit, with shadows that seem to subtly encroach, adding an eerie, gothic atmosphere to the scene. Soft, diffused lighting highlights her delicate features, casting a gentle glow over her pale complexion, giving her an ethereal, haunting beauty that feels both inviting and unsettling

glow effects, godrays, Hand drawn, render, 8k, octane render, cinema 4d, blender, dark, atmospheric 4k ultra detailed, cinematic, Sharp focus, big depth of field, Masterpiece, colors, 3d octane render, 4k, concept art, trending on artstation, hyperrealistic, Vivid colors, extremely detailed CG unity 8k wallpaper, trending on CGSociety, Intricate, High Detail, dramatic intricate, detailed . magnificent, celestial, ethereal, painterly, epic, majestic, magical, fantasy art, cover art, dreamy

说说我的看法,整体上Flux.1 的人像更加真实,也难怪很多人用它来生成虚拟IP,SD3.5对环境的渲染似乎更为丰富一些,可以直出更重风格的图片,但是画手还是不太行,对长提示词的处理也不太好,这与Flux.1有比较大的差距。

资源下载

文章中使用的SD模型、LoRA模型、工作流、示例图片等,都已经上传到我整理的AI绘画资源中,最新下载地址可给公/众\号 yinghuo6ai 发消息:SD,即可获取。


这里直接将该软件分享出来给大家吧~

1.stable diffusion安装包

随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。

最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
在这里插入图片描述

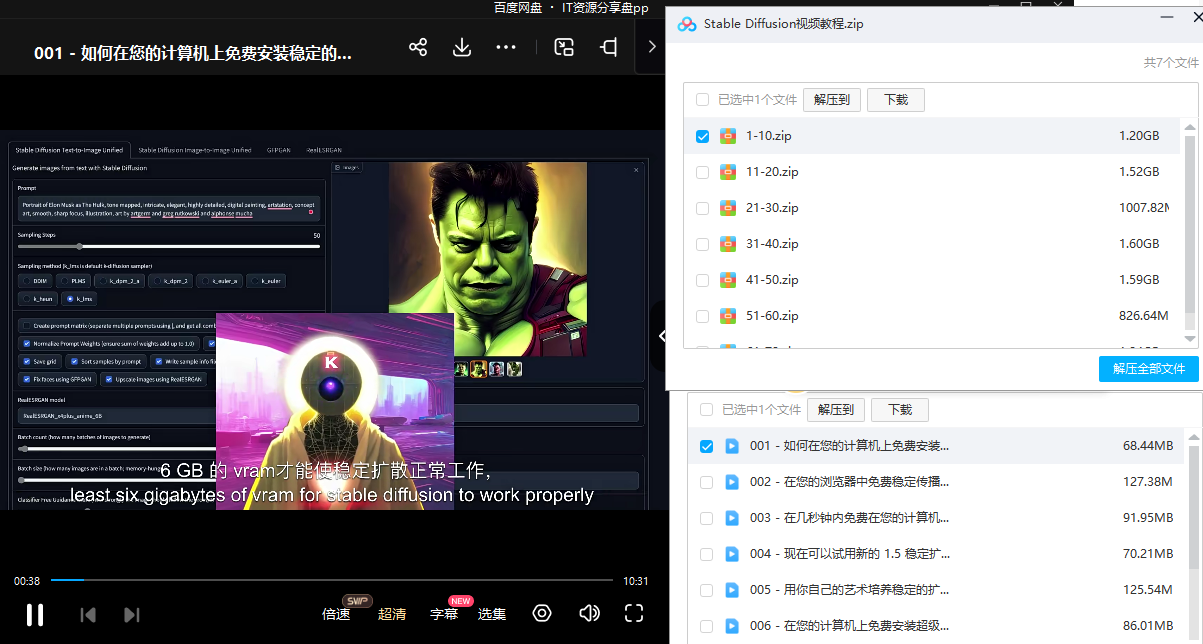
2.stable diffusion视频合集

我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入坑stable diffusion,科学有趣才能更方便的学习下去。
在这里插入图片描述

3.stable diffusion模型下载

stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
在这里插入图片描述

4.stable diffusion提示词

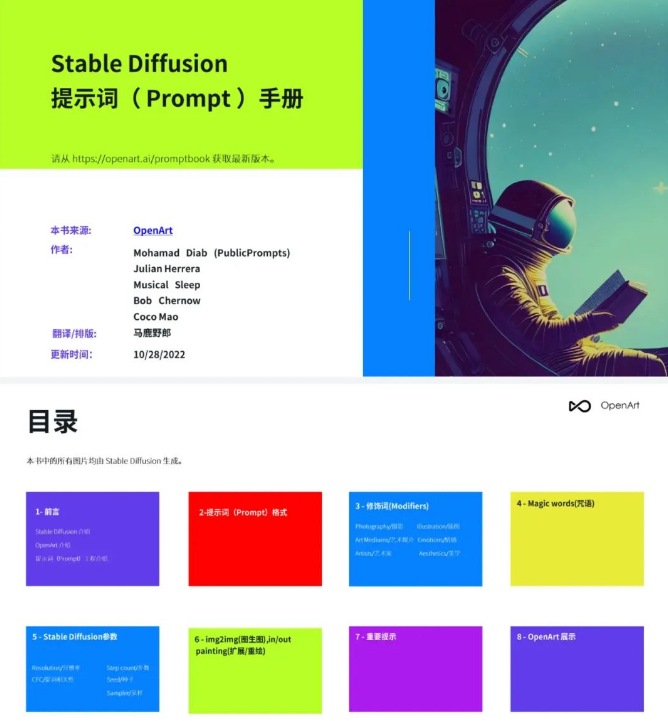
提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
在这里插入图片描述

5.SD从0到落地实战演练

在这里插入图片描述

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名SD大神的正确特征了。

这份完整版的stable diffusion资料我已经打包好,需要的点击下方插件,即可前往免费领取!

在这里插入图片描述

【论文精读】Latent Diffusion Latent Diffusion 阅读详情

相关推荐

crazyswarm无人机集群搭建笔记(一)资料索引

crazyswarm无人机搭建笔记:资料收集

Coco_range的博客 808

本地部署SD3.5大模型与cpolar内网穿透远程生成AI图片实战操作

本篇文章介绍如何在Windows系统电脑本地部署Stable Diffusion 3.5,并结合cpolar内网穿透工具实现公网环境远程访问制作AI图片,无需公网IP也不用重复部署那么麻烦。Stable Diffusion 3.5(简称SD 3.5)是 Stability AI 的最新力作,是对之前3.0版本的一次革命性升级!这次更新不仅大幅提升了图像质量,还显著优化了运行速度,尤其是在本地部署和硬件要求上展现了更高的灵活性。

2301_79855962的博客 1589

数学建模--十大经典常用算法

数学建模十大算法:灰色预测,蒙特卡洛,遗传算法,模拟退火法,组合算法,神经网络,动态规划,聚类算法,类比法,概率算法,Floyd算法

qq_51533426的博客 5647

AI绘画:SD3.5来了,Flux又不行了?

在开篇前想先说明一下,SD3.5-Large的图像质量和美学表现不如Flux1.0-dev,无论是从审美角度、构图合理性还是色彩运用上都显得一般。但,这次SD3.5-Large的亮点在于它是完全开源的,几乎可以无条件用于商业化(尤其是最近许可证改了之后)。最关键的是,它没有经过蒸馏处理,这意味着开源社区有机会进一步提升它的上限,而且像Controlnet这种模型也能很好地支持它,就像之前的开源SDXL一样,一句话总结:可扩展性非常强。

z19981的博客 4073

Informer:比Transformer更有效的长时间序列预测

目录 AAAI 2021最佳论文:比Transformer更有效的长时间序列预测 Background Why attention Methods:the details of Informer Solve_Challenge_1:最基本的一个思路就是降低Attention的计算量,仅计算一些非常重要的或者说有代表性的Attention即可,一些相近的思路在近期不断的提出,比如Sparse-Attention,这个方法涉及了稀疏化Attention的操作,来减少Attention计算量,然后涉及的

To be a better man 1万+

血管分割中的直径平衡难题:从clDice到cbDice的演进与实践

本文探讨了血管分割中的直径平衡难题,详细分析了从clDice到cbDice的技术演进与实践。通过引入半径感知权重和边界对齐惩罚,cbDice在保持拓扑完整性的同时提升了几何敏感度,显著改善了细小血管的分割效果。文章还分享了在nnU-Net中实现cbDice的工程细节,包括GPU加速骨架提取和多任务损失组合策略,为医学影像分析提供了重要参考。

weixin_29170327的博客 243

2025最新如何在本地部署 Stable Diffusion3.5超详细完整教程

摘要 本教程详细介绍了如何在本地部署Stable Diffusion 3.5 AI绘图工具,解决默认仅限局域网使用的问题。主要内容包括:1)下载并配置ComfyUI免安装版,设置中文界面;2)下载Stable Diffusion 3.5 Large Turbo模型及相关Clip编码器文件;3)加载示例工作流并测试图像生成功能。整个过程从环境准备到最终图像生成共分三步完成,使AI绘图操作更加灵活便捷,特别适合设计师和创作者使用。教程还提供了各步骤的详细截图和资源链接,帮助用户顺利完成部署。

猫头虎技术团队:授渔优于赠鱼,兴趣引领智慧,探索之乐尤显珍贵。商务合作+:Libin9iOak ,万粉变现+:优快云WF,猫头虎承诺每年免费为100名C站创作者做账号流量诊断服务!全网搜:猫头虎技术团队,点击文章底部名片或直接私信我一切皆可谈,快找虎哥! 2702

DESeq2差异分析结果不会看?用这个R脚本5分钟生成发表级火山图和热图

本文详细介绍了如何使用R语言快速可视化DESeq2差异分析结果,5分钟内生成可直接用于论文发表的火山图和热图。通过解析DESeq2数据结构、展示ggplot2和EnhancedVolcano包的绘图技巧,以及pheatmap包的热图定制方法,帮助研究者高效呈现差异表达基因分析结果。

weixin_30326515的博客 340

stable-diffusion3.5正式发布,如何在本地部署和使用?附本地一键整合包!

就在2024年10月22日,**Stablity公司正式推出他们的第三代stable-diffuison产品,stable-diffuison3.5,**相比于前两代的stable-diffuison产品有了巨大提升

m0_59236602的博客 2265

HarmonyOS应用开发者基础认证

B. 自定义组件:可复用的 UI 单元,可组合其它组件。D. 内置组件:ArkTS中默认内置的基本组件和布局组件,开发者可以直接调用,如Column、Text、Divider、Button等。E. 属性方法:用于组件属性的配置,统一通过属性方法进行设置,如fontSize()、width()、height()、color() 等。在Column和Row容器组件中,justifyContent用于设置子组件在主轴方向上的对齐格式,alignItems用于设置子组件在交叉轴方向上的对齐格式。

牛肉胡辣汤 3818

logisim中,如何设计一个位于十字路口的交通信号灯控制系统?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值。

**My Coding Family** 1345

Stable Diffusion 3.5 能力挽狂澜吗?

Stable Diffusion 3.5 大模型是一款多模态扩散变换器(MMDiT)文本到图像模型,其特点是在图像质量、排版、复杂提示理解和资源效率方面具有改进的性能。

2401_84830464的博客 1434

数据结构之博弈树搜索(深度优先搜索)

数据结构之博弈树搜索(深度优先搜索)

LucianaiB的博客 1524

【AI绘画】Stable Diffusion 3.5 能力挽狂澜吗?

前几天 Stability AI 发布了 Stable Diffusion 3.5,相比之前的 SD3 发布,这次 Stable Diffusion 3.5 学乖了很多,对社区友好了很多:研究或非商业用途、以及年总收入不足100万美元的组织或个人的商业用途都可以免费使用。这个效果还是很明显的,huggingface 上很快出现了很多基于 SD3.5 的衍生模型。

2401_84760322的博客 1100

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Stable Diffusion 3.0技术论文解读

赋予了Stable Diffusion 3惊人的能力。Stable Diffusion的强项在于。作为基准,它轻松碾压了所有竞品。固然能生成让人叹为观止的画面。而无需事后大动干戈地修修补补。的采购和租赁往往是最大的一块。真正让人惊喜的是SD3的。这正是他们将新架构命名为。在一定程度上实现了这一点。AI绘画领域扔出了一颗。造成这种局面的根本原因。对于从文本到图像的生成。割裂开来是件很头疼的事。对噪声的处理上别有心得。换言之,这项技术不仅能。但作为我们吃瓜读者而言。官方放出了一篇详尽的。这篇论文本质上是介绍。

浪漫韫秋 1473

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【AI学习】Stable Diffusion 3.5介绍原文+中文翻译

Stable Diffusion 3.5介绍原文+中文翻译

2401_84830464的博客 1473

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

内网穿透的应用-摆脱局域网!Stable Diffusion3.5 结合cpolar使用更方便

Stable Diffusion3.5 主要用于 AI 图像生成,支持文生图等功能,能满足从日常创意设计到专业图像制作的需求。作为经常用它做设计的人,我觉得它生成速度快、效果可控,调整参数就能得到不同风格的图像,很适合快速出稿。以前只能在本地用,出门门时想改个设计就得等回家,用了 cpolar 后,在外面也能随时登录操作,比如在咖啡馆就能修改图像参数,和团队实时同步进度,工作效率提高不少,再也不用被局域网捆住了。

微学AI的博客 1612

如何从 Stable Diffusion3.5 中获得最佳结果

全面解析 Stable Diffusion3.5 的最佳实践,涵盖模型选择、提示词技巧、参数设置与常见问题,助力 AI 爱好者高效生成高质量图像……

让企业不再为算力成本焦虑,让每分钱都花在刀刃上 1960

最新stable-diffusion3.5正式发布,如何在本地部署和使用?附本地一键整合包!

这种构架结合了扩散型和Transformer技术,提升了文本理解和图像生成的质量,使得生成的图像在细节和布局上更为精确,从800万像素到80亿不等,这使得图像分辨率上限从第二代的768x768提升到2048x2048,显著改善了图像的质量和细节表现;,且在保证高质量输出的同时更加节省计算资源。这一改进对需要快速生成大量高质量图像的用户特别有用;,可以准确地渲染图像中的文字内容,减少文字生成中的对称性问题和错误。这使得新版本在提示词的准确性和一致性方面有了显著提升;。

weixin_55154866的博客 1365

ComfyUI 系列(11):SD 3.5 工作流

ComfyUI 系列(11):SD 3.5 工作流引言Stable Diffusion 3.5(SD 3.5)是当前最先进的文本到图像生成模型之一,具备更强的文本理解能力、更高的图像细节以及更好的一致性。相比于 SDXL 和 SD 1.5,SD 3.5 在复杂场景生成、文字嵌入、角色一致性等方面都有显著提升。SD 3.5 模型是最近新出的,以后所有工作流都以3.5模型为基础。

2401_84760527的博客 2584

SD 3.5发布:Stability AI的反击,Flux的王位还稳吗?

Stability AI 在 10 月 22 日美国西部时间晚上 7 点,即北京时间 10 月 23 日凌晨 0 点,推出了其最新模型 SD3.5 的「large」版本,该版本拥有高达 8B 的参数量。

m0_59236602的博客 1602

Stable Diffusion 3.5 开发指南(一):模型获取与调用

StableDiffusion3.5(SD3.5)是StabilityAI于2024年10月发布的新一代开源文生图扩散模型。该模型采用多模态扩散Transformer架构(MMDiT-X),通过3个文本编码器(CLIP+T5)实现多粒度文本理解,并采用整流流技术将采样步数压缩至4-8步。文章详细介绍了SD3.5的模型架构、环境配置方法(Python3.10+、Torch2.6+)、模型下载途径(推荐国内模态社区),以及API调用和手动调用的完整流程,包括文本编码、VAE组件、Transformer模块、噪声

2511_93768618的博客 1110

AI绘图的场景应用:文生图、图生图

AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。感兴趣的小伙伴,赠送全套AIGC学习资料和安装工具,包含AI绘画、AI人工智能等前沿科技教程,模型插件,具体看下方。

qq_41314882的博客 7654

Stable Diffusion 4.8.7升级版更新,Ai绘画风口已来!(无需部署,解压即用)

2024可以称得上是Ai技术大爆发的元年,目前两款Ai神器大火,一款是大名鼎鼎的Chat GPT。 另外一款大火的是本期社长介绍的Ai绘图软件—Stable Diffusion。

weixin_55154866的博客 2481

【Dive Into Stable Diffusion v3.5】2:Stable Diffusion v3.5原理介绍

我们先用最通俗易懂的语言结合源码详细介绍扩散模型的原理,再详细介绍StableDiffusion3和3.5的原理。

https://github.com/Donvink,专注于计算机视觉、目标检测、目标跟踪等方向 2905
上一篇: 【comfyui教程】ComfyUI | 手把手教你在MAC端安装部署ComfyUI
下一篇: 【stable diffusion部署】AI原画绘画软件 Stable Diffusion 解压即用 汉化版 手把手教你从0基础入门Stable Diffusion
壹只小小码农
博客等级 码龄5年 8101粉丝 1334原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值