


-
xpath爬取58二手房实例
-
xpath图片解析下载实例
-
xpath爬取全国城市名称实例
-
xpath爬取简历模板实例
=================================================================================================================================================================================================================
文章目录
-
xpath基本概念
-
xpath解析原理
-
环境安装
-
如何实例化一个etree对象:
-
xpath(‘xpath表达式’)
-
xpath爬取58二手房实例
-
爬取网址
-
完整代码
-
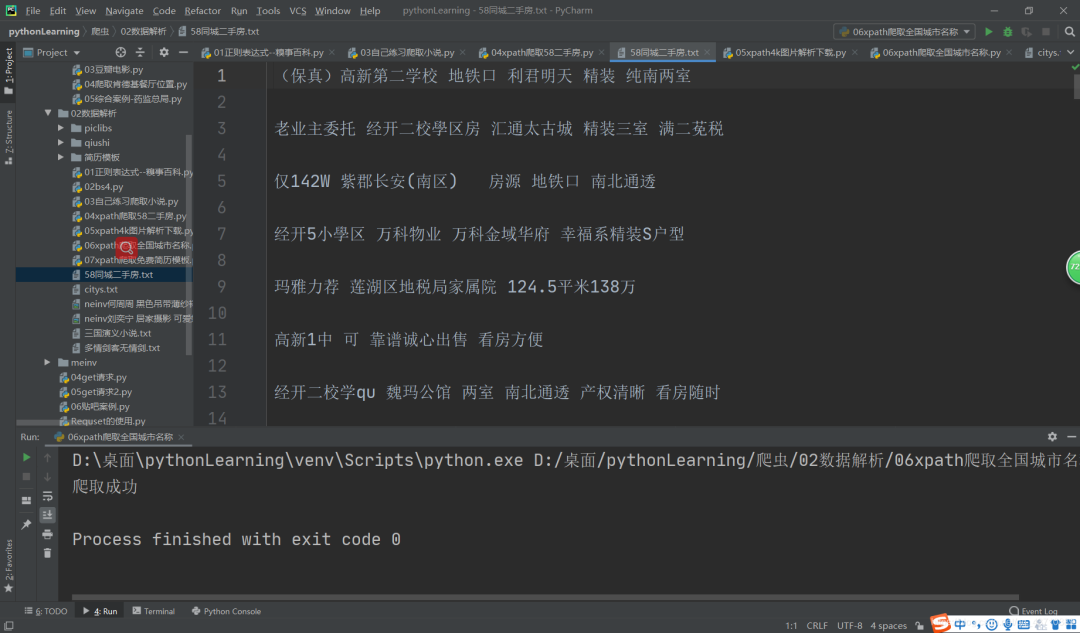
效果图
-
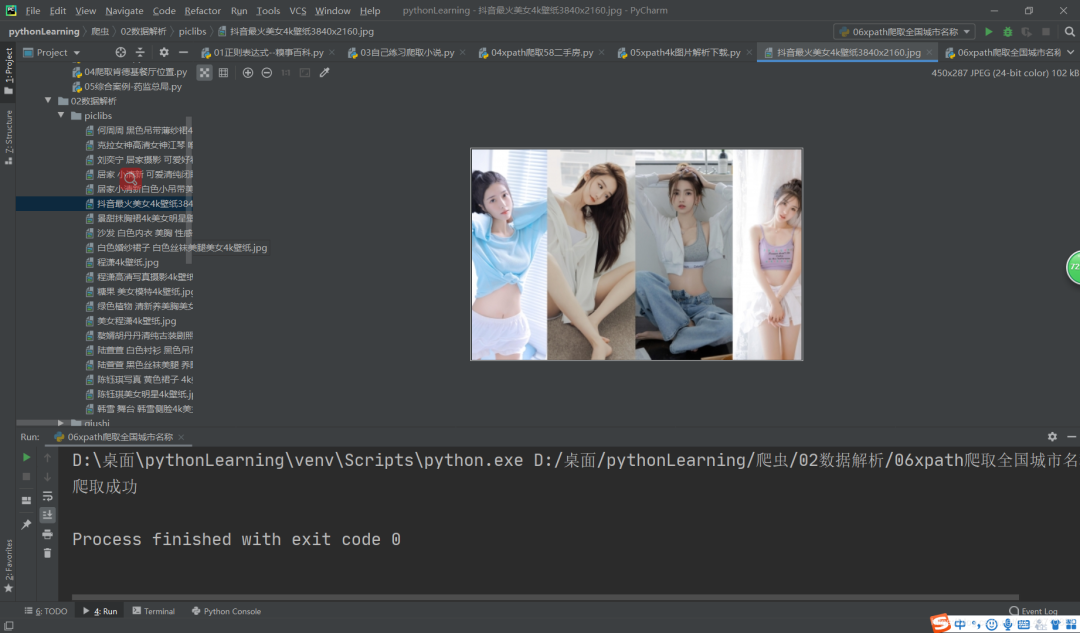
xpath图片解析下载实例
-
爬取网址
-
完整代码
-
效果图
-
xpath爬取全国城市名称实例
-
爬取网址
-
完整代码
-
效果图
-
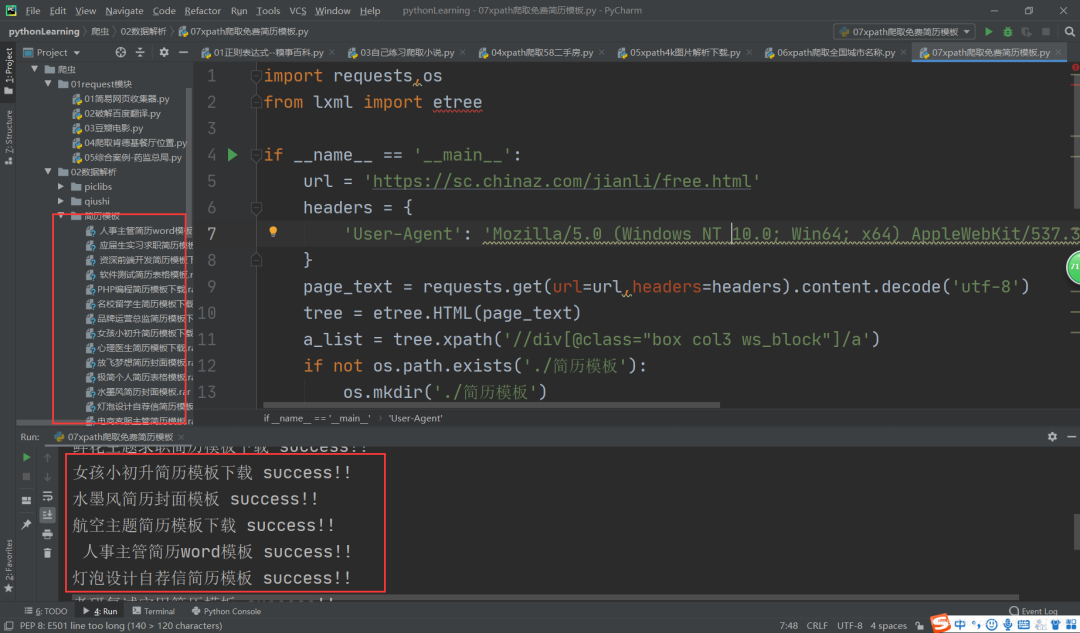
xpath爬取简历模板实例
-
爬取网址
-
完整代码
-
效果图
xpath基本概念
xpath解析:最常用且最便捷高效的一种解析方式。通用性强。
xpath解析原理
1.实例化一个etree的对象,且需要将被解析的页面源码数据加载到该对象中
2.调用etree对象中的xpath方法结合xpath表达式实现标签的定位和内容的捕获。
环境安装
pip install lxml
如何实例化一个etree对象:
from lxml import etree
1.将本地的html文件中的远吗数据加载到etree对象中:
etree.parse(filePath)
2.可以将从互联网上获取的原码数据加载到该对象中:
etree.HTML(‘page_text’)
xpath(‘xpath表达式’)
-
/:表示的是从根节点开始定位。表示一个层级
-
//:表示多个层级。可以表示从任意位置开始定位
-
属性定位://div[@class=‘song’] tag[@attrName=‘attrValue’]
-
索引定位://div[@class=‘song’]/p[3] 索引从1开始的
-
取文本:
-
/text()获取的是标签中直系的文本内容
-
//text()标签中非直系的文本内容(所有文本内容)
-
取属性:/@attrName ==>img/src
xpath爬取58二手房实例
爬取网址
https://xa.58.com/ershoufang/完整代码
from lxml import etree
import requests

if __name__ == '__main__':
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'
    }
    url = 'https://xa.58.com/ershoufang/'
    page_text = requests.get(url=url,headers=headers).text
    tree = etree.HTML(page_text)
    div_list = tree.xpath('//section[@class="list"]/div')
    fp = open('./58同城二手房.txt','w',encoding='utf-8')
    for div in div_list:
        title = div.xpath('.//div[@class="property-content-title"]/h3/text()')[0]
        print(title)
        fp.write(title+'\n'+'\n')
xpath图片解析下载实例
爬取网址
https://pic.netbian.com/4kmeinv/完整代码
import requests,os
from lxml import etree

if __name__ == '__main__':
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'
    }
    url = 'https://pic.netbian.com/4kmeinv/'
    page_text = requests.get(url=url,headers=headers).text
    tree = etree.HTML(page_text)
    li_list = tree.xpath('//div[@class="slist"]/ul/li/a')
    if not os.path.exists('./piclibs'):
        os.mkdir('./piclibs')
    for li in li_list:
        detail_url ='https://pic.netbian.com' + li.xpath('./img/@src')[0]
        detail_name = li.xpath('./img/@alt')[0]+'.jpg'
        detail_name = detail_name.encode('iso-8859-1').decode('GBK')
        detail_path = './piclibs/' + detail_name
        detail_data = requests.get(url=detail_url, headers=headers).content
        with open(detail_path,'wb') as fp:
            fp.write(detail_data)
            print(detail_name,'seccess!!')
xpath爬取全国城市名称实例
爬取网址
https://www.aqistudy.cn/historydata/完整代码
import requests
from lxml import etree

if __name__ == '__main__':
    url = 'https://www.aqistudy.cn/historydata/'
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.141 Safari/537.36',
    }
    page_text = requests.get(url=url,headers=headers).content.decode('utf-8')
    tree = etree.HTML(page_text)
    #热门城市   //div[@class="bottom"]/ul/li
    #全部城市   //div[@class="bottom"]/ul/div[2]/li
    a_list = tree.xpath('//div[@class="bottom"]/ul/li | //div[@class="bottom"]/ul/div[2]/li')
    fp = open('./citys.txt','w',encoding='utf-8')
    i = 0
    for a in a_list:
        city_name = a.xpath('.//a/text()')[0]
        fp.write(city_name+'\t')
        i=i+1
        if i == 6:
            i = 0
            fp.write('\n')
    print('爬取成功')

xpath爬取简历模板实例
爬取网址
https://sc.chinaz.com/jianli/free.html完整代码
import requests,os
from lxml import etree

if __name__ == '__main__':
    url = 'https://sc.chinaz.com/jianli/free.html'
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.141 Safari/537.36',
    }
    page_text = requests.get(url=url,headers=headers).content.decode('utf-8')
    tree = etree.HTML(page_text)
    a_list = tree.xpath('//div[@class="box col3 ws_block"]/a')
    if not os.path.exists('./简历模板'):
        os.mkdir('./简历模板')
    for a in a_list:
        detail_url = 'https:'+a.xpath('./@href')[0]
        detail_page_text = requests.get(url=detail_url,headers=headers).content.decode('utf-8')
        detail_tree = etree.HTML(detail_page_text)
        detail_a_list = detail_tree.xpath('//div[@class="clearfix mt20 downlist"]/ul/li[1]/a')
        for a in detail_a_list:
            download_name = detail_tree.xpath('//div[@class="ppt_tit clearfix"]/h1/text()')[0]
            download_url = a.xpath('./@href')[0]
            download_data = requests.get(url=download_url,headers=headers).content
            download_path = './简历模板/'+download_name+'.rar'
            with open(download_path,'wb') as fp:
                fp.write(download_data)
                print(download_name,'success!!')
以上就是“四个Python爬虫案例,带你掌握xpath数据解析方法!”的全部内容,希望对你有所帮助。
关于Python技术储备
学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!
一、Python所有方向的学习路线
Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

二、Python必备开发工具

三、Python视频合集
观看零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

四、实战案例
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

五、Python练习题
检查学习结果。

六、面试资料
我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。

最后祝大家天天进步!!
上面这份完整版的Python全套学习资料已经上传至优快云官方,朋友如果需要可以直接微信扫描下方优快云官方认证二维码免费领取【保证100%免费】。

 2700


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


