大道至简:大规模复杂业务下的 PostgreSQL 运维减法与治理哲学

Linkerd:Kubernetes原生服务网格与流量治理默认方案 服务网格是现代云原生架构中保障服务间通信可靠性、可观测性与安全性的核心基础设施。其本质是在Kubernetes网络层之上构建可编程的流量控制平面,解决Pod可达但请求不可靠的根本矛盾。Linkerd作为轻量级、Kubernetes原生的服务网格实现,以极简设计提供自动mTLS、细粒度指标、重试熔断等能力,显著降低控制平面复杂度与资源开销。相比Istio等重型方案,Linkerd更强调‘安装即生效’与‘零代码侵入’,天然适配GitOps与企业级合规要求。本文聚焦Linkerd在Kubernetes环境中的部署 阅读详情

本文整理于 HOW 2026 演讲内容,演讲者:阎书利,《快速掌握 PostgreSQL 版本新特性》副主编、云和恩墨技术顾问、PG ACE。

引言

当数据库实例从几套扩展到成百上千套,节点数从几个增长到几十上百个,运维的复杂度并非线性增加,而是呈指数级上升。在 PostgreSQL 大规模运维实践中,我们面临着诸多集体焦虑:监控告警海啸、参数配置迷宫、对象规模雪崩、执行计划突变、被动扩容滞后、备份恢复黑洞……这些问题不仅仅是技术层面的挑战,更是一场关于运维理念与治理哲学的深度思考。

今天,我将从​PG 运维的复杂性困局​、​运维减法理念​、治理五把刀以及监控预测与 AI 智能四个维度,分享我们在大规模 PG 运维实践中的思考与探索。

一、PG 运维的复杂性困局:从监控海啸到插件丛林

随着业务体量的增长,原本人工运维的模式变得难以为继。以下是生产环境中常见的七大困局:

1. 监控告警海啸 · 信噪比失衡

几百个指标堆叠,几百条告警刷屏。运维人员凌晨被告警吵醒却发现是假告警,久而久之形成告警疲劳,导致真正的故障被淹没在噪音之中。核心问题在于:告警多 ≠ 有效,指标全 ≠ 可控。

2. 参数配置迷宫 · 环境一致性缺失

PostgreSQL 拥有数百个 GUC 参数,不同 DBA 有不同调优习惯。同一个 SQL 在不同库表现各异,配置漂移导致故障不可复现,批量排查隐患时难以快速定位问题环境。

3. 规模对象雪崩 · 运维边界失控

实例、表、索引、分区越堆越多,上亿条历史数据积累下,数据库管理复杂度呈指数级上升。如果初期架构设计未预留扩展空间,后期极易出现系统性瓶颈。

4. SQL 计划突变 · 性能抖动频发

执行计划打印长达数页,昨天运行正常的 SQL 今天突然变慢。统计信息过期、长事务阻塞、锁竞争等问题相互叠加,性能问题排查链路复杂,根因定位困难。

5. 被动扩容滞后 · 容量规划缺失

业务增长量未知,磁盘水位难以预测。永远是问题发生后(如磁盘写满)才"拍大腿"紧急处理,缺乏基于趋势的主动规划能力。

6. 备份恢复黑洞 · 防线形同虚设

备份任务每天执行,但从未做过恢复演练。日志显示"Success"不等于文件完整,静默错误难以发现。真正出故障时,无人敢对备份可用性打包票。

7. 插件依赖丛林 · 升级困难重重

官方插件与自研插件版本冲突,升级顺序混乱,稍有不慎便会触发"依赖地狱",导致业务受阻。

分布式架构下的特殊挑战

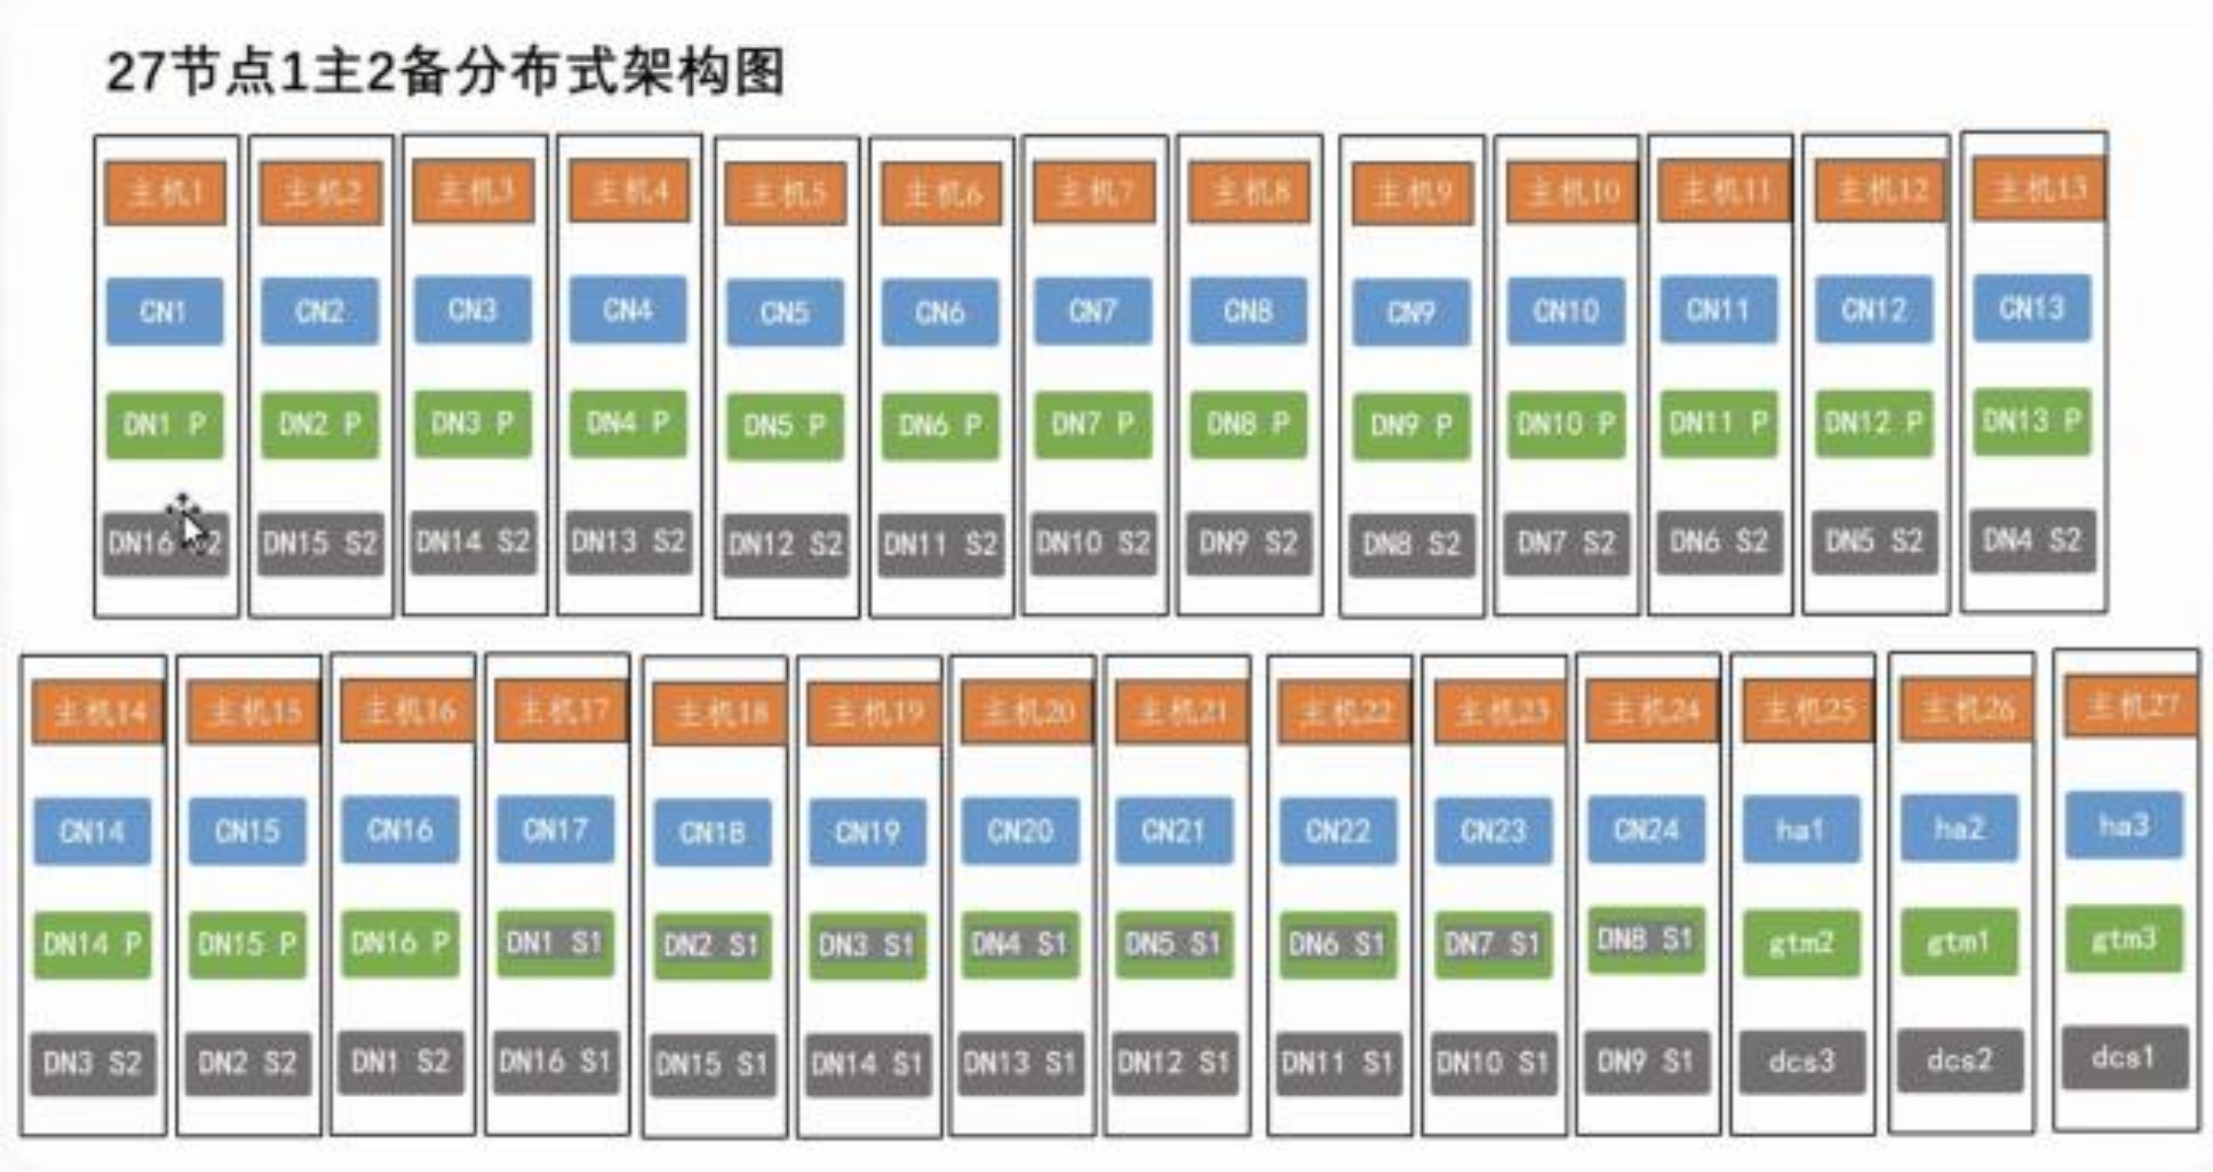
在分布式环境中,一套业务动辄涉及几十上百个节点,且组件往往存在混部情况——一个服务器上可能同时运行着不同角色的组件(如数据节点、协调节点、监控节点等),资源负载不均且节点规格不一。这种复杂拓扑进一步放大了监控、资源管理和故障定位的难度。
1.png

故障传导链的核心认知

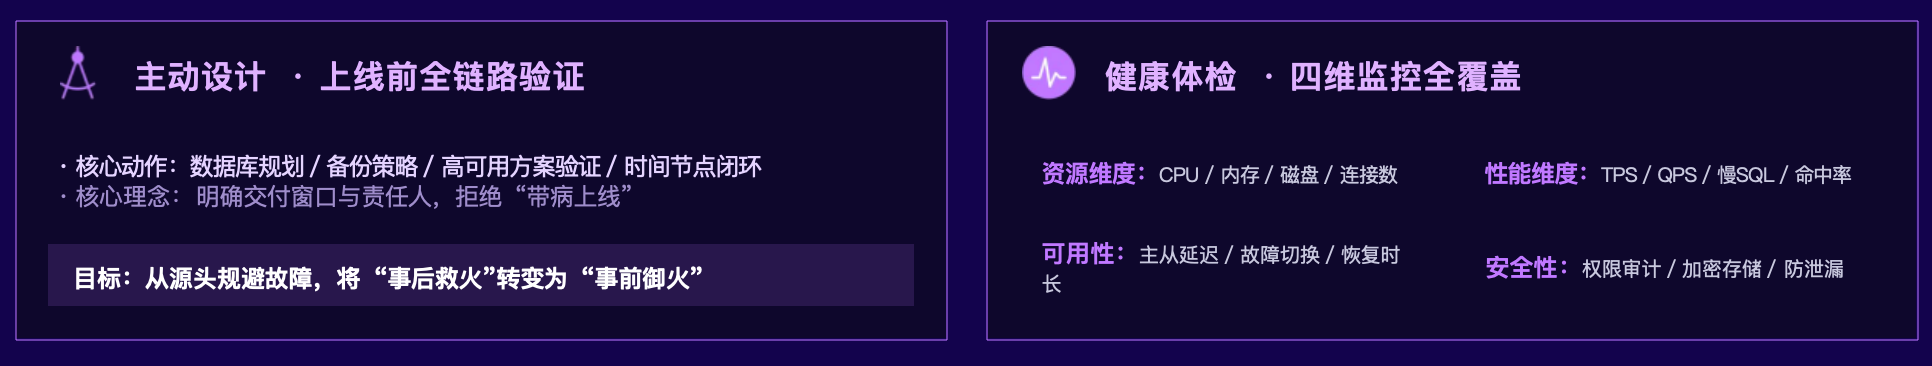
所有技术问题的终点都是故障,所有系统故障的终点都是业务。 任何技术异常终将传导至业务层,最终导致用户体验受损、业务连续性受威胁。如果 DBA 长期处于被动救火状态,服务稳定性将无法得到根本保障。理想的模式应当是:DBA 在业务设计最前期即介入,从数据库设计、表结构逻辑等源头进行风险评估与隐患规避,将问题消灭在上线之前。

二、典型故障案例深度复盘

案例一:SQL 语法误用引发的生产灾难

事件回顾

业务发版时,一批 SQL 中混入了一条问题语句,未被 SQL 审核工具发现,且在测试环境未充分验证,导致线上亿级核心表数据被错误覆盖。

错误写法:

UPDATE table SET a='xxx' AND b='xxx' WHERE a='xxx';

此处误用了 AND 逻辑运算符,数据库将 a='xxx' AND b='xxx' 整体解析为布尔表达式,导致 a 列被赋值为布尔值(0 或 1),而非预期的字符串。

正确写法:

UPDATE table SET a='xxx', b='xxx' WHERE a='xxx';

恢复方案

通过备份执行 PITR 时间点恢复,在额外环境恢复数据至误操作前状态,再将对应数据导出并恢复至生产环境,最大程度降低数据损失。

事故教训

  • ​备份​:是核心数据的最后防线,需保证可恢复性
  • ​审核​:是 SQL 上线的第一道闸门,必须借助自动化规则校验
  • ​验证​:测试环境需全覆盖演练,提前暴露潜在问题
  • ​规范​:建立标准化变更流程,强化 SQL 自动化审核

案例二:表膨胀背后的长事务隐患

故障现象

表死元组无法清理导致表体积暴增,手动执行 VACUUM 无效。对应 SQL 执行耗时翻倍,最终引发业务接口 504 超时。

根本原因​

数据库中存在未提交的长事务,持有旧快照,阻止了 MVCC 机制对旧版本元组的回收,导致表膨胀无法缓解。

解决方案

定位并终止/提交阻塞的长事务。事务结束后,VACUUM 即可正常回收空间,SQL 性能恢复正常。

认知转变

表膨胀只是"症状",而非"病根"。排查时需建立​链路思维​:现象 → 中间指标(长事务)→ 根因。监控体系需要从"单点指标监控"延伸到"业务因果链条监控",才能防患于未然。

告警优化建议

单一指标易误报。可设计组合条件告警规则,例如:表膨胀率 >30% AND 最长事务 >30min 同时满足时,触发严重告警。

三、什么是"运维减法"?

"运维减法"并非消极削减工作,而是​做更少但更正确的事​。核心理念可概括为:

从被动救火转向主动设计,从人工操作演进为闭环验证。

2.png

具体包含三个演进阶段:

第一阶段:标准化

统一环境配置与操作流程,消除环境差异,建立唯一标准路径。在环境规划、业务上线前期下足功夫,从源头扼杀潜在隐患。

  • ​硬件配置​:统一 SSD 磁盘类型,分大/中/小三档规格,容量预留 3-6 个月
  • ​操作系统​:内核参数基线化,所有机器保持一致,统一时区与 NTP 同步
  • ​数据库​:统一大版本,按场景预设参数模板(OLTP/OLAP),目录端口统一

第二阶段:自动化

用代码脚本替代人工重复操作,实现平台一键运维,将人力从繁琐的日常维护中释放出来。但需注意,自动化应按照固定流程走,而非让系统完全自主决策。

第三阶段:智能化

基于 AI 持续分析负载特征,主动辅助决策优化。但在数据库领域,需保持审慎态度——数据库中的数据至关重要,AI 即使有 99% 的成功率,那 1% 的失败可能造成的损失也难以承受。正确的定位是:利用 AI 作为工具,但最终决策权保留在人类手中。

四、治理的五把刀

第一刀:参数基线与索引治理

标准化管理与场景化适配

基于主机硬件资源(CPU/内存)设定固定比例,为 OLTP、OLAP、混合负载三种核心场景预设参数模板。新集群初始化时自动匹配并套用,实现"上线即最优"的交付标准。

​核心提示​:基线是管理的基准,不可为了"统一"而忽略业务差异。必要时结合实际场景做定制化微调,并做好标记。

索引智能评分体系

自动扫描全量索引,精准识别四类问题索引:

  • ⚠️ 超过 90 天未使用的索引
  • 🔄 重复索引
  • 📉 选择性过低的索引
  • 📊 高写入/存储成本索引

结合表结构与查询场景,对索引进行多维健康度评分(命中率/写入放大/空间占用),自动标记问题索引并生成删除/合并/重建建议。通过统一看板展示治理状态,实现从"被动救火"到"主动治理"的转变。

第二刀:监控告警精炼

从"看海量仪表盘"到"看核心业务 KPI"

聚焦四大黄金指标,剔除 90% 冗余指标:

  • 延迟(Latency)
  • 错误(Error)
  • 吞吐(Throughput)
  • 饱和度(Saturation)

告警治理与去噪

目标:让"告警即风险"。对重复、抖动、无修复动作的噪音坚决说"不":

  • 合并重复告警
  • 抑制瞬时抖动
  • 移除无明确 Action 的无效告警

阈值动态调优

基于历史基线数据动态调整,拒绝"一刀切"的固定阈值。例如:连接数阈值从固定的 80% 调整为基于业务特征的 85%,有效降低非必要的频繁告警。

分层采集策略

区分两类监控模式:

  • ​持续采集​:实时感知资源状态(如 CPU、内存、连接数)
  • ​周期性检查​:主动发现隐患(如备份状态、表膨胀趋势)

将周期性检查项单独梳理,避免高频采集对主机资源造成不必要的消耗。

第三刀:变更审核与 SQL 审核

自动化变更闭环

痛点:加索引、改参数需 DBA 半夜手动执行,人工操作失误率高,变更风险不可控。

解法:业务提单 → 自动生成 SQL → 语法校验 → DBA 审核 → 自动执行。实现全流程闭环,零手工命令。

SQL 审核规则硬防线

挑战:单条"魔鬼查询"(如全表扫描)即可拖垮生产库。

防线:上线前拦截全表扫描、笛卡尔积、超大结果集。基于语法树深度解析,精准识别并拦截各类性能隐患 SQL,自动拦截加人工复核,确保问题 SQL 无法进入生产。

第四刀:上线前性能压测与风险评估

业务上线前,通过模拟真实高并发场景,对核心链路 SQL 执行时长进行量化预估。这一步能够提前识别系统性能瓶颈,将潜在问题消灭在上线之前。

​核心原则​:充分压测 + 风险评估 = 平稳上线 · 业务连续运行

第五刀:拒绝"薛定谔的备份"

痛点与误区:

  • 日志显示"Success" ≠ 文件完整,静默错误难以发现
  • 备份运行半年从未验证,灾难发生时才发现不可用
  • 恢复耗时(RTO)是承诺值,数据量增长后易超时

​核心理念​:只有被成功恢复过的备份,才算真正存在过。

关键恢复指标可视化(8 项核心) :

  • 全量传输耗时
  • WAL 日志速率
  • 数据解压时间
  • 全量恢复执行
  • 日志回放耗时
  • PITR 点精度
  • 系统启动校验
  • RTO 总耗时

建议定期自动化执行备份恢复验证流程,确保备份不仅"成功执行",更能"成功恢复"。

五、监控预测与 AI 智能

智能运维架构核心要素

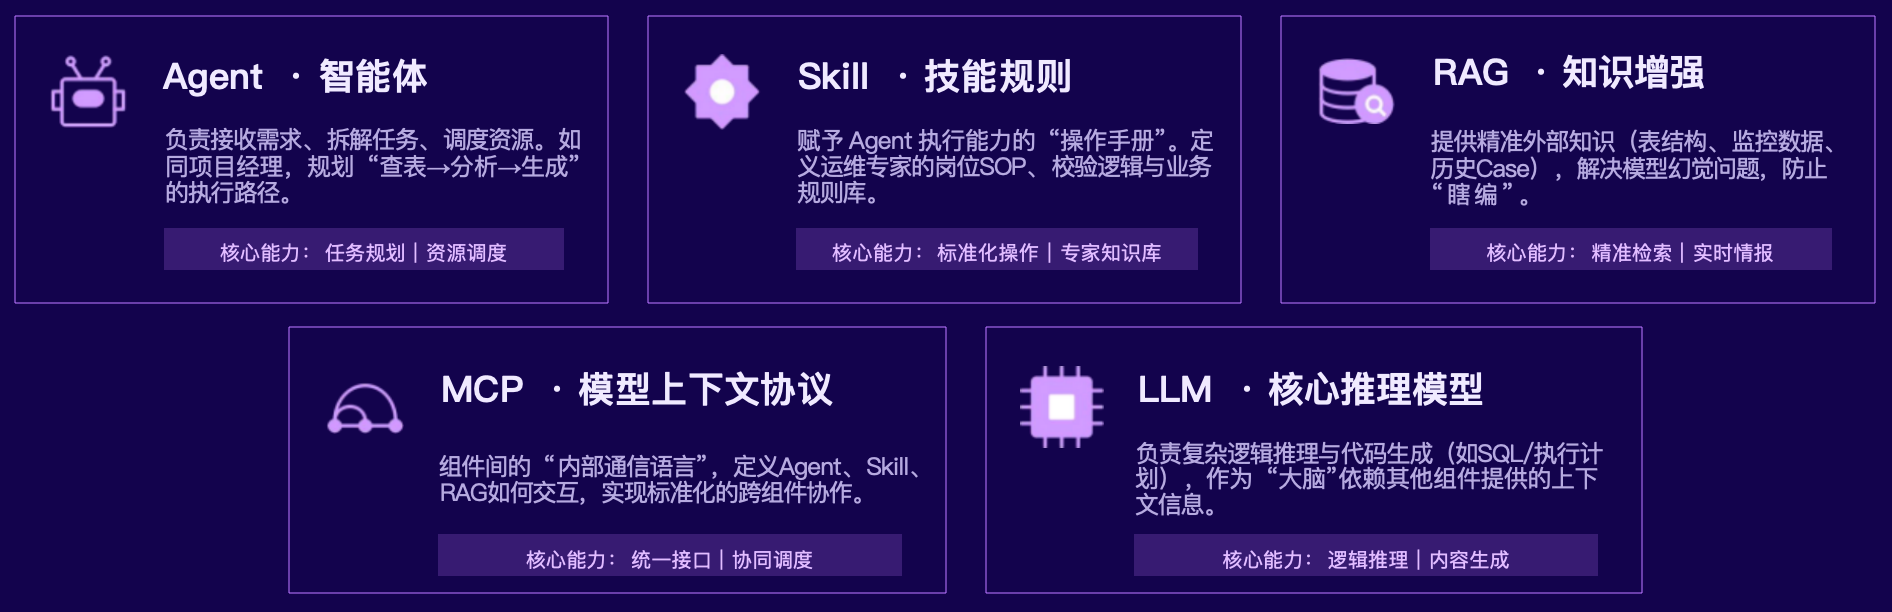
基于大模型技术构建智能运维体系,五大核心组件协同工作:

组件角色定位核心能力
LLM核心推理模型负责复杂逻辑推理与代码生成(如 SQL/执行计划分析)
Agent智能体接收需求、拆解任务、调度资源,如同项目经理规划执行路径
RAG知识增强提供精准外部知识(表结构、监控数据、历史 Case),解决模型幻觉
Skill技能规则定义运维专家的岗位 SOP、校验逻辑与业务规则库
MCP模型上下文协议定义组件间的交互方式,实现标准化跨组件协作

3.png

五大智能运维场景

  1. ​深度 SQL 性能调优​:解析执行计划与索引建议,精准定位慢查询根因
  2. ​实时状态智能诊断​:基于多维监控指标,实时解答状态疑问,自动识别性能瓶颈
  3. ​容量趋势预测分析​:预测存储与负载增长趋势,提前预警容量风险
  4. ​日志隐患深度挖掘​:自动分析海量日志,精准识别错误日志、锁竞争及配置参数风险点
  5. ​专业知识即时问答​:7×24 小时智能问答赋能运维决策

向量检索与智能关联分析

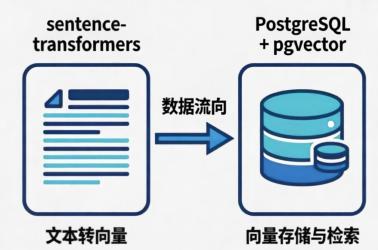
借助 PostgreSQL 的 pgvector 扩展,将运维产生的非结构化数据(日志、告警)转化为高维向量并存储,打破传统关键字检索的局限。

​实现流程​:

  1. ​模板化清洗​:过滤原始日志中的时间戳、ID 等变量噪音,统一数据口径
  2. ​语义向量化​:将清洗后的文本通过预训练模型生成高维语义向量,存入 pgvector
  3. ​智能告警关联​:新告警产生时,实时检索时间窗口内的相似向量,自动聚合关联告警

​核心价值​:从传统的"关键字模糊搜索"升级为"基于语义的向量相似度分析",实现跨系统告警自动关联,秒级定位根因,打破信息孤岛。
4.jpeg

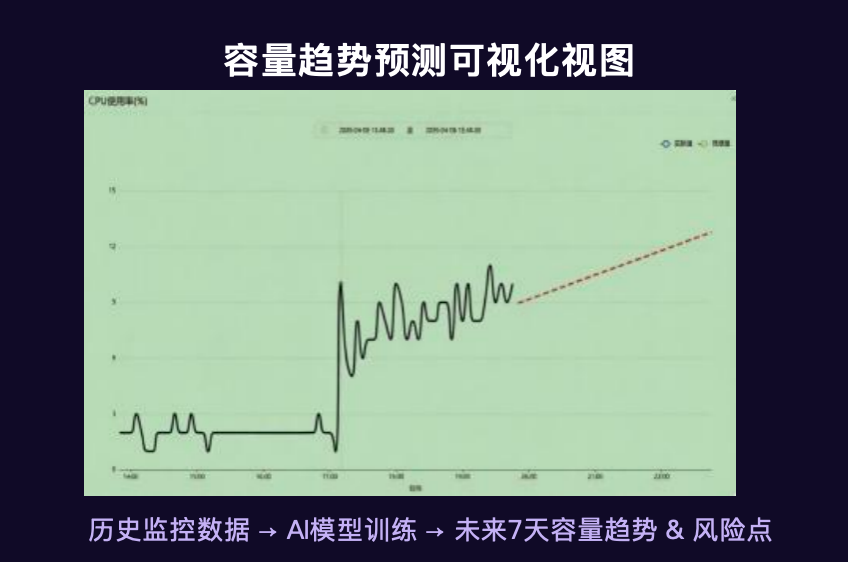
容量趋势预测

基于资源增长率历史数据,训练多维容量预测模型,综合分析资源使用规律,实现比传统阈值更精准的提前预警。
5.png

​预测方法选择​:

  • ​线性回归​:适用于有明显周期性(如早晚高峰)和趋势性的指标(连接数、CPU),计算简单、可解释性强
  • 时间序列预测(ARIMA/Holt-Winters) :适合处理复杂波动、无明显周期或需要中长期预测的业务场景
  • 机器学习(LSTM) :精准捕捉非线性关系、长距离依赖和多变量耦合,但需大量历史数据和算力支撑

​磁盘剩余天数计算公式​:

T = (Disk_total × 90% - Disk_now) / R

其中:

  • Disk_total = 总容量(按 90% 警戒线计算)
  • Disk_now = 当前使用量
  • R = 预测日均增长量

RAG 落地实践的核心原则

在 AI 辅助运维的落地过程中,需特别注意以下约束:

  1. ​优先引用最新来源​:在 Prompt 中加入规则或代码按时间过滤,确保检索质量
  2. ​检索失败的优雅降级​:上下文不足时,禁止 LLM 编造答案,应明确告知"知识库中未找到相关信息"
  3. ​全链路可观测性追踪​:实时监控"检索精度"与"答案准确率",指标异常时能快速定位问题环节
  4. ​结构化测试用例驱动​:通过 TestCase 驱动 RAG 迭代,定义必须包含和必须禁止的关键词,持续优化模型表现

​核心原则​:让系统在信息拿不准的时候,诚实地回答"不知道",而非强行编造一个看似合理实则错误的答案。

总结

PostgreSQL 大规模运维的本质是一场从"人力堆砌"到"体系化治理"的范式转变。通过标准化建立基线,通过自动化释放人力,通过智能化辅助决策,我们能够在复杂业务场景下构建高韧性的数据库运维体系。

治理的五把刀——参数基线、索引治理、告警精炼、变更审核、备份验证——构成了从日常运维到应急响应的完整闭环。而 AI 技术的引入,则为这个闭环注入了主动预测与智能诊断的能力,让运维从"救火"走向"防火",从"被动响应"走向"主动设计"。

大道至简,知易行难。愿每一次思考都能让我们离高效、可靠、省心的数据库运维更近一步。

text-to-SQL工程化落地:六层上下文与闭环验证实战 text-to-SQL(文本生成SQL)是AI驱动数据自助分析的核心能力,其本质并非自然语言理解问题,而是融合数据库语义、业务规则、权限治理与数据分布感知的系统工程。传统方法依赖大模型单点突破,但生产环境要求结果可验证、可审计、可演进。本文聚焦text-to-SQL的工业化落地路径,基于OpenAI实践提炼出分层注入语义、逐级收缩错误空间的设计范式,并详解L0-L5六层上下文如何协同工作——从Schema元数据语义化解析,到业务规则动态注入;从权限谓词主动声明,到统计特征引导阈值生成;再到历史纠错与人类反馈 阅读详情

相关推荐

VSAN数据救援实战:当26个虚拟机突然不可访问时我们做了什么?

本文深度复盘了一次由运维操作失误引发的VMware vSAN存储危机,导致26个虚拟机数据不可访问的实战救援过程。文章详细剖析了vSAN脑裂状态的诊断方法,分享了在官方支持受限时,如何结合社区智慧与自主分析,通过精准的底层命令干预和状态推理,最终成功恢复全部数据的破局思路与操作细节,为vSAN数据救援提供了宝贵经验。

weixin_35749786的博客 239

Agent记忆系统三层架构设计与落地实践

Agent记忆不是简单缓存,而是支撑连续对话与个性化服务的核心基础设施。其本质是将传统LLM的临时上下文窗口,升级为具备分层存储、语义检索与生命周期管理的独立认知组件。技术原理上需解耦工作记忆(短期)、会话记忆(中期)和长期记忆(用户画像/业务知识),依托混合存储(Redis+PostgreSQL+pgvector+S3)与轻量LLM协同实现高效存取。工程价值在于显著降低重复提问率、提升会话深度与NPS,并支撑金融、电商、工业等高要求场景的合规性与稳定性。当前开发者普遍卡在LangChain Memory局

weixin_33754065的博客 354

Oracle EBS MRP 模块测试记录

MRP 模块测试记录        构思:创建Shirt成品物料,它由Cloth和Button组成。1*Shirt=1*Cloth+8*Button。        首先创建这三个物料(复制模板创建),并分配给T02。        创建BOM,将这三个物料关联起来。        分别创建资源(人工和设备)制造Cloth和Button。        分别创建两个部门(HumanDep和Mach

NetSuite 张老师 8168

轻量级分布式配置中心实战:5分钟部署,Spring Boot集成指南

在微服务架构和云原生环境中,配置管理是保障应用灵活性与可维护性的基础技术。其核心原理在于将应用配置从代码中分离,实现集中存储、统一管理和动态更新,从而解决环境差异、安全敏感信息泄露和配置变更效率低下等工程痛点。传统方案如Spring Cloud Config或Apollo虽功能全面,但架构复杂、运维成本高,常存在过度设计问题。本文聚焦于一种新兴的轻量化解决方案,它通过极简的单进程服务端和高效的长轮询机制,实现了开箱即用和秒级动态刷新,特别适合中小团队快速落地。文中将结合配置中心与Spring Boot集成等

weixin_34059951的博客 374

ERA5气象数据下载与解压全攻略:Python脚本一键搞定(附错误处理技巧)

本文提供了一套完整的ERA5气象数据自动化处理方案,涵盖从CDS API配置、智能批量下载到高效解压与数据验证的全流程。重点介绍了如何通过Python脚本实现一键式数据下载与批量解压,并分享了实用的错误处理技巧与性能优化策略,帮助科研人员高效获取和处理大规模气象数据。

k8l9m0n的博客 340

ABAP 大规模数据并行处理实战,六套 Parallel Processing Framework 如何选,性能调优真正该盯住什么

如果今天真的面对那份执行 14 个小时的生产报表,我不会马上把原来的 Loop 改成 50 个aRFC。我会先用 SAT、ST12、SQL Monitor 和 HANA 侧工具确认时间到底花在哪里。如果 90% 时间其实消耗在一条低效 SQL 上,Parallel Processing 只是让 50 个 Worker 同时执行那条低效 SQL,数据库会比原来更痛苦。应该先把串行逻辑本身优化到合理水平。该做 Set-based Processing 的地方先交给 HANA。该避免SELECT。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 153

linux学习

sudo make install:组装好的家具(编译好的库文件),原本放在你的临时工作区。坏处是,你的程序体积会变大。于是,他会根据你的计划书,结合你电脑的当前情况(比如装了什么编译器,库在哪),生成一本极度详细的《施工进度表》。很多大牌的第三方库(比如你刚装的 libevent)为了照顾不同的需求,会同时提供动态库(.so)和静态库(.a),但并不是所有库都这样。只有动态库:常见于系统的核心库(比如你系统的底层 C 库),或者一些商业闭源软件(厂商只给你一个黑盒子,不让你直接把代码打包进你的程序)。

d_mail的博客 194

Spring AI Alibaba实战训练营-28 手把手教你用SAA+ Nacos 构建分布式 MCP 应用

本文介绍如何使用Spring AI Alibaba和Nacos构建分布式MCP应用,实现AI模型与工具服务的动态发现和调用。主要内容包括:1) 项目架构设计,包含MCP Server、Nacos注册中心和MCP Client三个核心组件;2) 环境准备要求,如Java 17+、Maven 3.6+、Nacos 3.1.0+等;3) 详细实施步骤:启动Nacos服务、注册MCP服务端、配置MCP网关聚合服务、设置MCP客户端发现机制。通过这种架构,开发者可以轻松扩展新工具服务,无需修改客户端代码,实现服务动态

program哲学 311

ubuntu 偶发启动失败问题分析

ubuntu 系统启动偶发异常问题分析

平面到立体 196

Matplotlib之bar3d画3D柱状图

3D柱状图通常用于展示数据集中不同分类项的数据大小或数量。与普通的柱状图相比,3D柱状图更适合展示数据的三个维度 3D 柱状图 按行/列涂颜色 柱加阴影、描黑边 自定义座标轴名、刻度标签、范围

我走的每一步都算数 1123

Open3D 计算点云的倒角距离(Chamfer Distance)【2025最新版】

;Chamfer Distance距离可以计算生成点云数据与标签点云数据之间的平均最短点距离。Open3D可以直接用来计算点云的Chamfer Distance距离。博客长期更新,本文最近一次更新时间为:2025年2月18日。

点云侠的博客 3254

数据不出域的企业级智能体平台有哪些推荐

按阿里云 PAI-EAS 部署 Dify 的官方文档描述,Dify 的服务组件包括 Web 界面、API 后端、异步任务 Worker 与插件沙箱,依赖 PostgreSQL(用户、对话、知识库、工作流与插件配置)、Redis(缓存、会话状态、异步任务分发)、Elasticsearch(兼作向量库与全文检索)、对象存储(插件与知识库文件)四类外部服务。按公开信息,常见的有开源自部署的 Dify、云厂商的阿里云百炼、腾讯云 ADP、华为云 AgentArts、百度千帆,以及走本地化交付路线的领铄智能。

lanren_45的博客 226

【LLM评估篇】Ceval | GAIA | MMLU benchmarks

- 一些大模型的评估模型: - 多轮:MTBench - 关注评估:agent bench - 长文本评估:longbench,longeval - 工具调用评估:toolbench - 安全评估:cvalue,safetyprompt等 本文还介绍了其他主流的大模型评估指标等及其使用

发现问题,并解决问题,批判性思维 6951

高校5G专网部署方案:打造智慧校园新一代数字底座

随着智慧校园建设持续深化,传统校园网络已难以适配高校多元化的教学、科研与校园管理需求。WiFi、有线网络等传统组网方式,在超高并发接入、超低时延交互、广域稳定覆盖、业务安全隔离等方面存在明显短板,无法支撑沉浸式教学、科研算力调度、校园智能安防、无人设备巡检等新型智慧校园场景落地。在此背景下,凭借专用带宽、独立组网、超低时延、高可靠、强隔离的核心优势,成为高校数字化转型的核心基础设施,为现代化智慧校园建设提供全新解决方案。

爱浦路 IPLOOK 171

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Docker Compose:搭建本地多服务开发环境

从一个 Java API、PostgreSQL 和 Redis 开始,配置服务名、端口、环境变量、健康检查、数据卷和依赖关系。理解 Compose 文件如何被解析、项目如何隔离,以及哪些数据不能依赖“重建容器”保留,能够把个人开发环境整理成团队可复用的启动入口。

m0_62221377的博客 477

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

给openlab搭建web网站

此时输入song 账号 即可登录。

ytdbc的博客 112

本地化部署会议视频软件如何替换旧平台?账号迁移、历史数据与用户培训怎么安排?

账号先映射:身份与权限验证通过,再开放使用。资料分级处理:能查、能读、权限正确,比“全部搬完”更重要。切换可恢复:入口、增量数据和业务通知都要纳入回退方案。培训按岗位落地:让用户完成真实任务,而不是只听功能介绍。这套方法适合政企、集团及医疗等具有长期资料留存、多终端接入和业务集成需求的组织。小规模替换可以简化批次与流程,但不应省略权限验证、备份恢复和关键会议演练。

hz56789的博客 292

锅炉房已经有PLC,还需要IoT吗?从安全控制到全局能效的智能化升级

无论是工业蒸汽锅炉房,还是酒店、医院等商业热水场景,改造都可以从现有条件出发:先梳理控制系统、仪表和通信情况,再明确安全边界与数据需求;盈电物联网的云边协同思路,是在尽量保留原有控制与仪表设备的基础上,通过IOT控制器补齐数据接入和边缘处理能力,再与云端平台协同,逐步建立运行、能耗与运维之间的数据闭环。锅炉房智能化,不是用IoT取代PLC,也不是简单增加一块远程大屏,而是在保障安全控制独立可靠的基础上,让分散的数据真正服务于运行管理。将告警、排查、处理、复核和维修记录串联起来,形成可追溯的设备档案。

olzorange的博客 289

信创环境下OA文档控件技术选型方案对比

在国产 OA 的开发与实施中,文档编辑往往是返工较集中的一个环节。问题通常不出在产品本身,而是选型时没有先把约束写清楚:公文打印必须与本地 WPS 一致、文档不能出内网、一套代码要同时覆盖 Windows 与国产终端。这三条一旦成为验收项,可选的路线会迅速收窄。本文按“约束—对象—路线—实施—验收”的顺序,把目前市面上的四条技术路线的原理、能力和代价拆开对比,并给出实施阶段容易忽略的几个点。

zi_wu_xian的专栏 205

中科热备备份一体机选型技术剖析:安全厂商跨界后的能力边界与实测数据对比

灾备与数据保护技术实战:CDP持续保护、数据库备份、异地容灾架构等核心技术深度解析。

weixin_70618949的博客 303

LNMP 容器化实战:基于 Harbor 私有仓库部署 ECShop,吃透 Docker 底层机制

优势:同一网络内部支持容器 DNS 解析,直接写容器名字访问服务,不用硬编码 IP。网络层面:多容器 LNMP 架构,优先自建自定义 bridge 网络,利用容器名 DNS 解析,避免写死 IP,方便环境迁移;持久化思想:镜像保存程序代码;配置、数据库数据、日志全部 volume 挂载宿主机目录,删除容器业务数据不丢失;镜像管理:生产环境建议部署 Harbor 私有仓库,业务镜像统一内网托管;PHP 镜像构建:php‑fpm 容器补齐业务需要全部扩展;商城上传、缓存目录读写权限是高频故障点;

Wzh5452830的博客 163

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 302

宝塔装在服务器上,极目装在本机,差别到底在哪

宝塔 极目 装服务器 装本机 区别,不是比谁好用,是比"软件落在谁的账上"。宝塔的端口、资源、维护都记在服务器;极目这些都落在你电脑,服务器保持和纯 SSH 管理一样的干净。想保护服务器资源和安全面,选装本机的方案;想浏览器点就完事,装服务器的面板也行。

AI_Lab01的博客 348

Linux配置网络

前两天配好的网络配置消失了,不知道怎么回事,没想太多又重新配了一遍,正好把详细流程完整记录下来。呃,不过重启发现配置又没了,折腾了半天才发现,配置文件其实一直都在,只是没有开自动启用,把对应设置开开就OK了。现代 Linux 使用管理网络,日常操作统一使用nmcli命令。(新格式)。注意不要在 Rocky 9 的下手动新建ifcfg文件,老格式会导致系统读取混乱。强烈建议只用nmcli修改,不要手动vim编辑配置文件。

Yisitelz的博客 207

航空航天与高端装备的孪生运维与预测性维护

发射窗口、航线、载荷配置等决策影响任务成败,孪生可在镜像中预演多种方案,评估风险与资源消耗,辅助择优。连续档案把"用过即忘"变为"越用越懂",使每一次运维都沉淀为组织知识。认证过程虽慢,却是孪生获得运行授权的门票,也区分了"能演示"与"敢托付"两套标准,行业对此格外审慎。把"人始终是决策者"写入流程,既是对安全的尊重,也让孪生在失误时仍有缓冲,而非把命运完全交给一个尚未完美的镜像。视情维修压缩无效维护,也降低突发失效概率,对昂贵且稀缺的装备尤具价值,使有限保障资源投向最该修的地方,提升整体就绪水平。

renhongxia1的博客 245

Docker部署linkding:HTTPS与数据备份

部署私人书签库,除了让页面能够打开,还需要考虑几个实际问题:重建容器后数据是否保留、登录和保存是否正常、升级前怎样备份,以及出现 502 或 CSRF 错误时从哪里检查。本文使用 Docker Compose 部署 linkding,采用默认 SQLite 数据库,通过 Caddy 提供 HTTPS,并完成账户创建、数据持久化验证和备份。如果重建后账户或书签消失,应先检查是否换了项目目录、改了挂载路径,或者启动了另一套实例,不要急着重新初始化。遇到权限问题,应根据日志确认具体目录和运行用户,再调整权限。

tedcloud123的博客 170
上一篇: PostgreSQL 日报 | relcache 引用泄漏修复(8 月 19 日)
下一篇: PostgreSQL 日报| Checkpointer 写合并补丁更新(8 月 20 日)
IvorySQL
博客等级 码龄5年 745粉丝 566原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值