PostgreSQL逻辑复制的未来演进

数据库架构演进与高可用实践:MySQL主从复制、读写分离与PostgreSQL高可用方案深度解析 摘要:本文系统探讨数据库高可用架构设计,重点分析MySQL主从复制与PostgreSQL高可用方案。MySQL通过binlog实现主从复制,配合ShardingSphere等中间件实现读写分离;PostgreSQL则采用WAL流复制,结合repmgr/Patroni等工具构建高可用集群。文章对比了两者在复制机制、工具生态和适用场景的差异,建议读密集型业务选择MySQL,强一致性需求采用PostgreSQL。展望未来,云原生、自动化运维和跨地域容灾将成为数据库架构的发展方向。 阅读详情

本文整理于 HOW 2026 演讲内容,演讲者:侯志杰,PostgreSQL Major Contributor。

逻辑复制概述

逻辑复制是PostgreSQL在PG 10版本正式引入的核心功能,其基本原理是将发布端部分表的数据同步到订阅端。最简单的使用方式如下:

-- 发布端:创建表并发布
CREATE TABLE users(id int);
CREATE PUBLICATION mypub FOR TABLE users;

-- 订阅端:创建相同表结构并订阅
CREATE TABLE users(id int);
CREATE SUBSCRIPTION mysub 
CONNECTION 'host=192.168.1.100 dbname=postgres user=repuser password=rep123' 
PUBLICATION mypub;

执行上述命令后,两个PostgreSQL实例之间会自动建立连接,持续将发布端的数据修改复制到订阅端。

内部模块与数据流

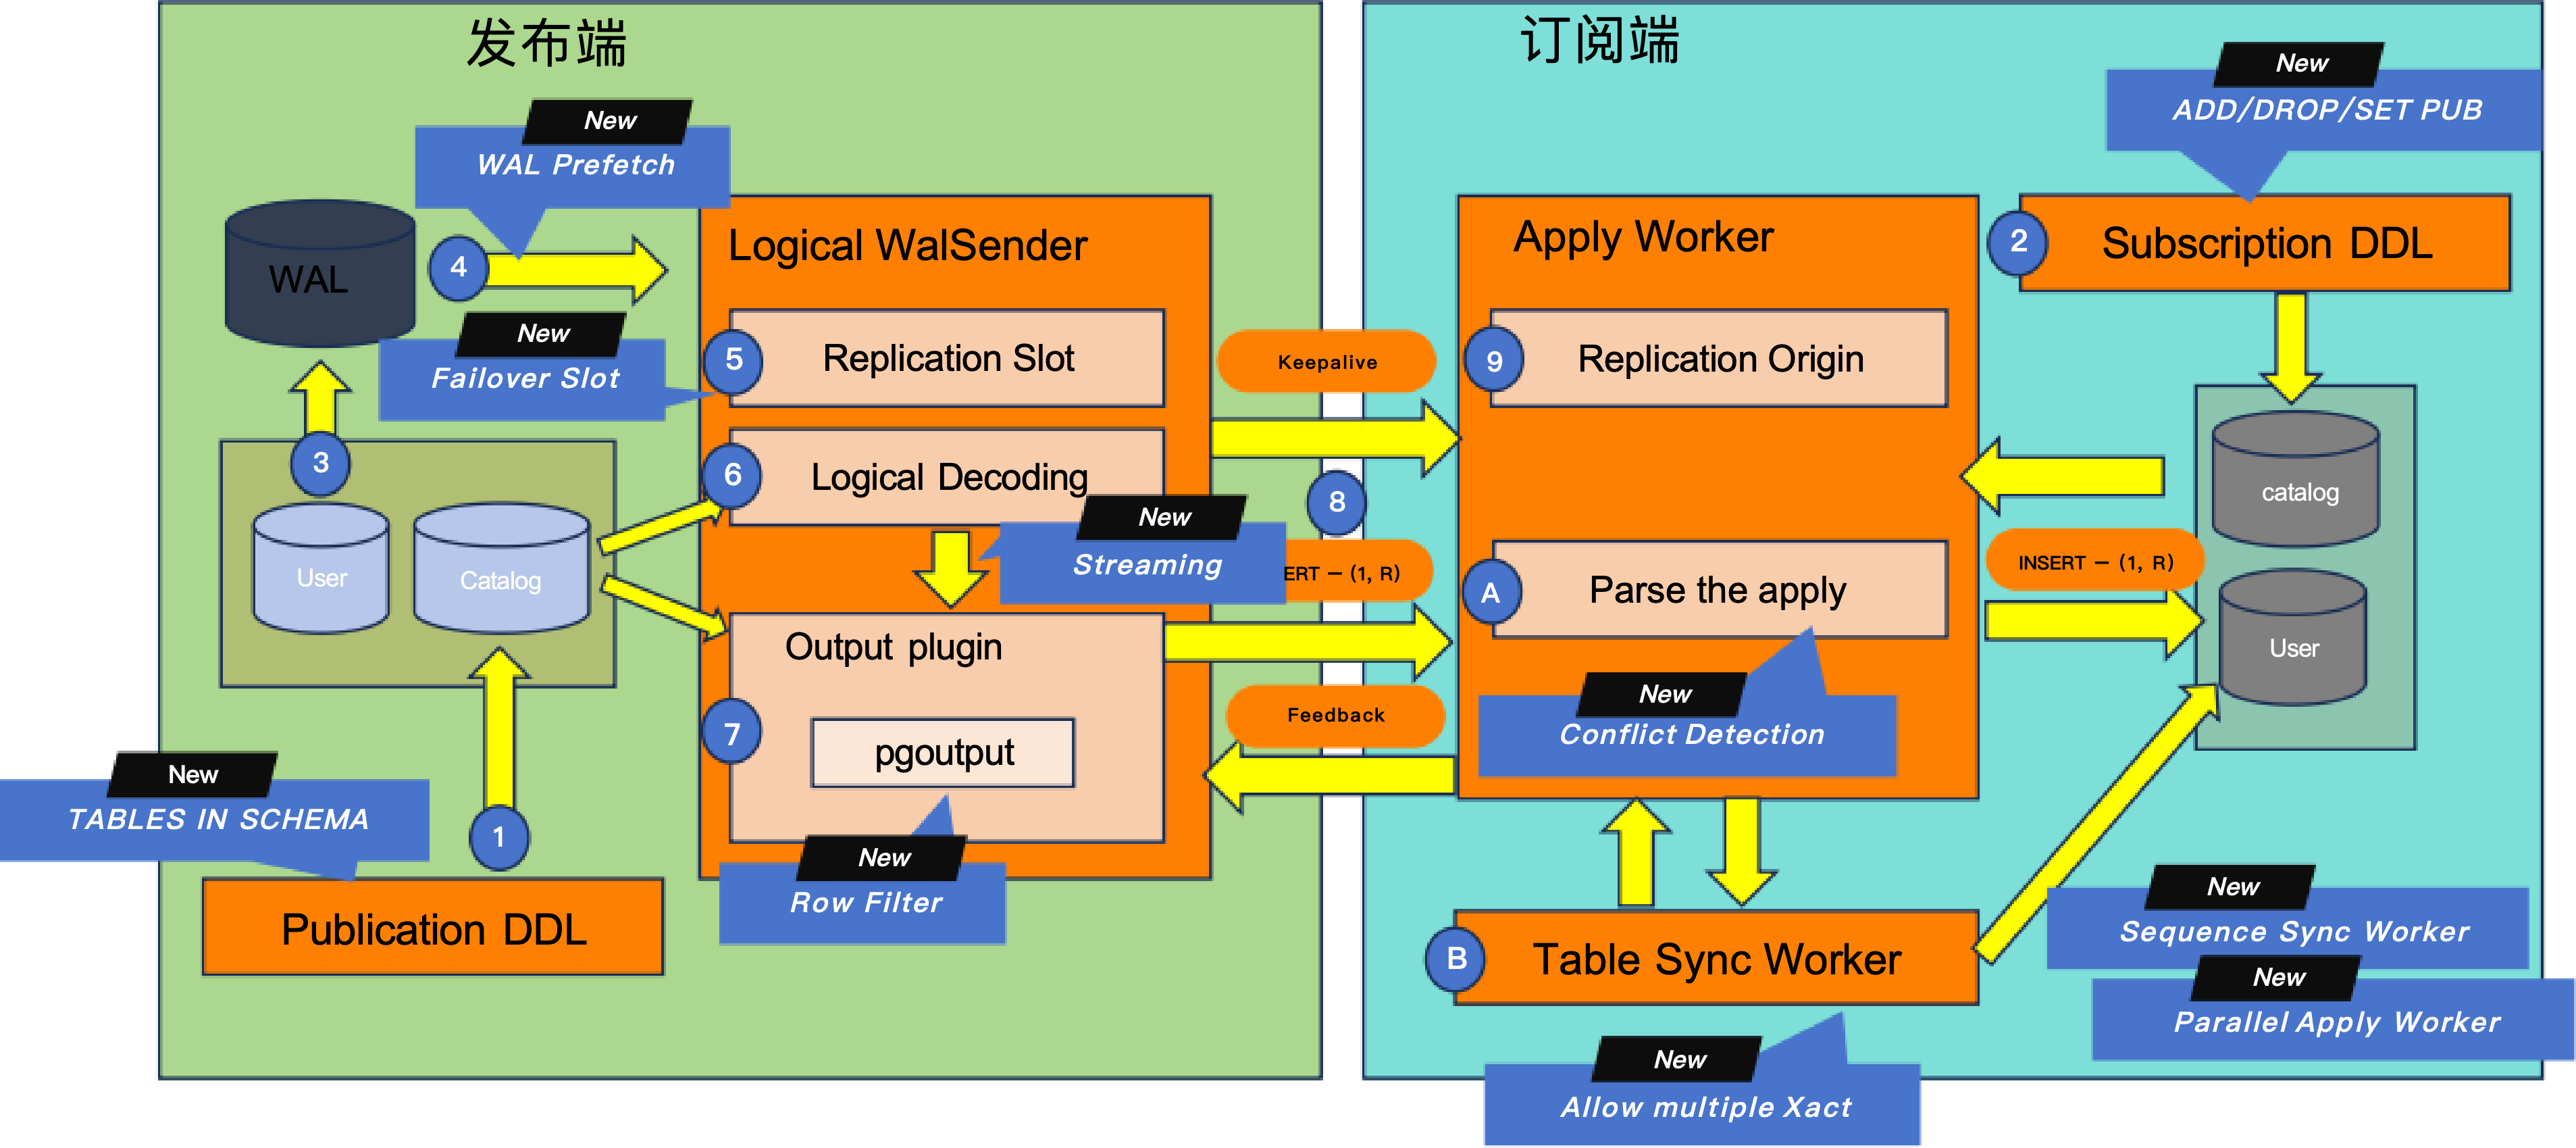
逻辑复制的内部流程涉及发布端与订阅端多个模块的协作:

  1. 用户在发布端写入数据,产生WAL日志
  2. logical decoder读取WAL日志,replication slot保护未被消费的日志不被清理
  3. 逻辑解码将二进制日志转化为可操作的具体数据
  4. Output Plugin(输出插件)获取解码后的数据,开发者可在此实现自定义逻辑
  5. 数据发送至订阅端,由apply worker接收并解析为SQL命令(INSERT/UPDATE/DELETE),应用到订阅端数据库
  6. application origin记录复制进度,确保订阅端重启后能从正确位置继续,避免重复或遗漏
  7. table sync worker负责全量初始数据的拷贝,完成后由apply worker接管增量同步
1.png

历史演进

自PostgreSQL 10以来,逻辑复制每年都有新功能加入:

  • DDL扩展:发布端和订阅端的SQL命令持续增强易用性
  • WAL预取:提升日志读取性能
  • Streaming模式:支持大事务实时传输,无需等待事务结束即可边读边传
  • Row Filter:支持按行过滤,只复制满足条件的数据
  • Sequence同步:引入sequence sync worker复制序列数据
  • 冲突检测:为双向复制场景提供基础

尽管如此,逻辑复制仍存在两个明显的潜力空间:多主一致性和性能。目前逻辑复制虽支持多节点同时写入且无回环问题,但双向写入时的数据冲突无法自动处理;性能方面,逻辑复制比物理复制慢一个数量级以上,单进程Apply Worker在高并发写入下延迟持续增大。

以下三个新功能正是针对这些痛点设计的。

多主冲突检测与自动解决

冲突的产生

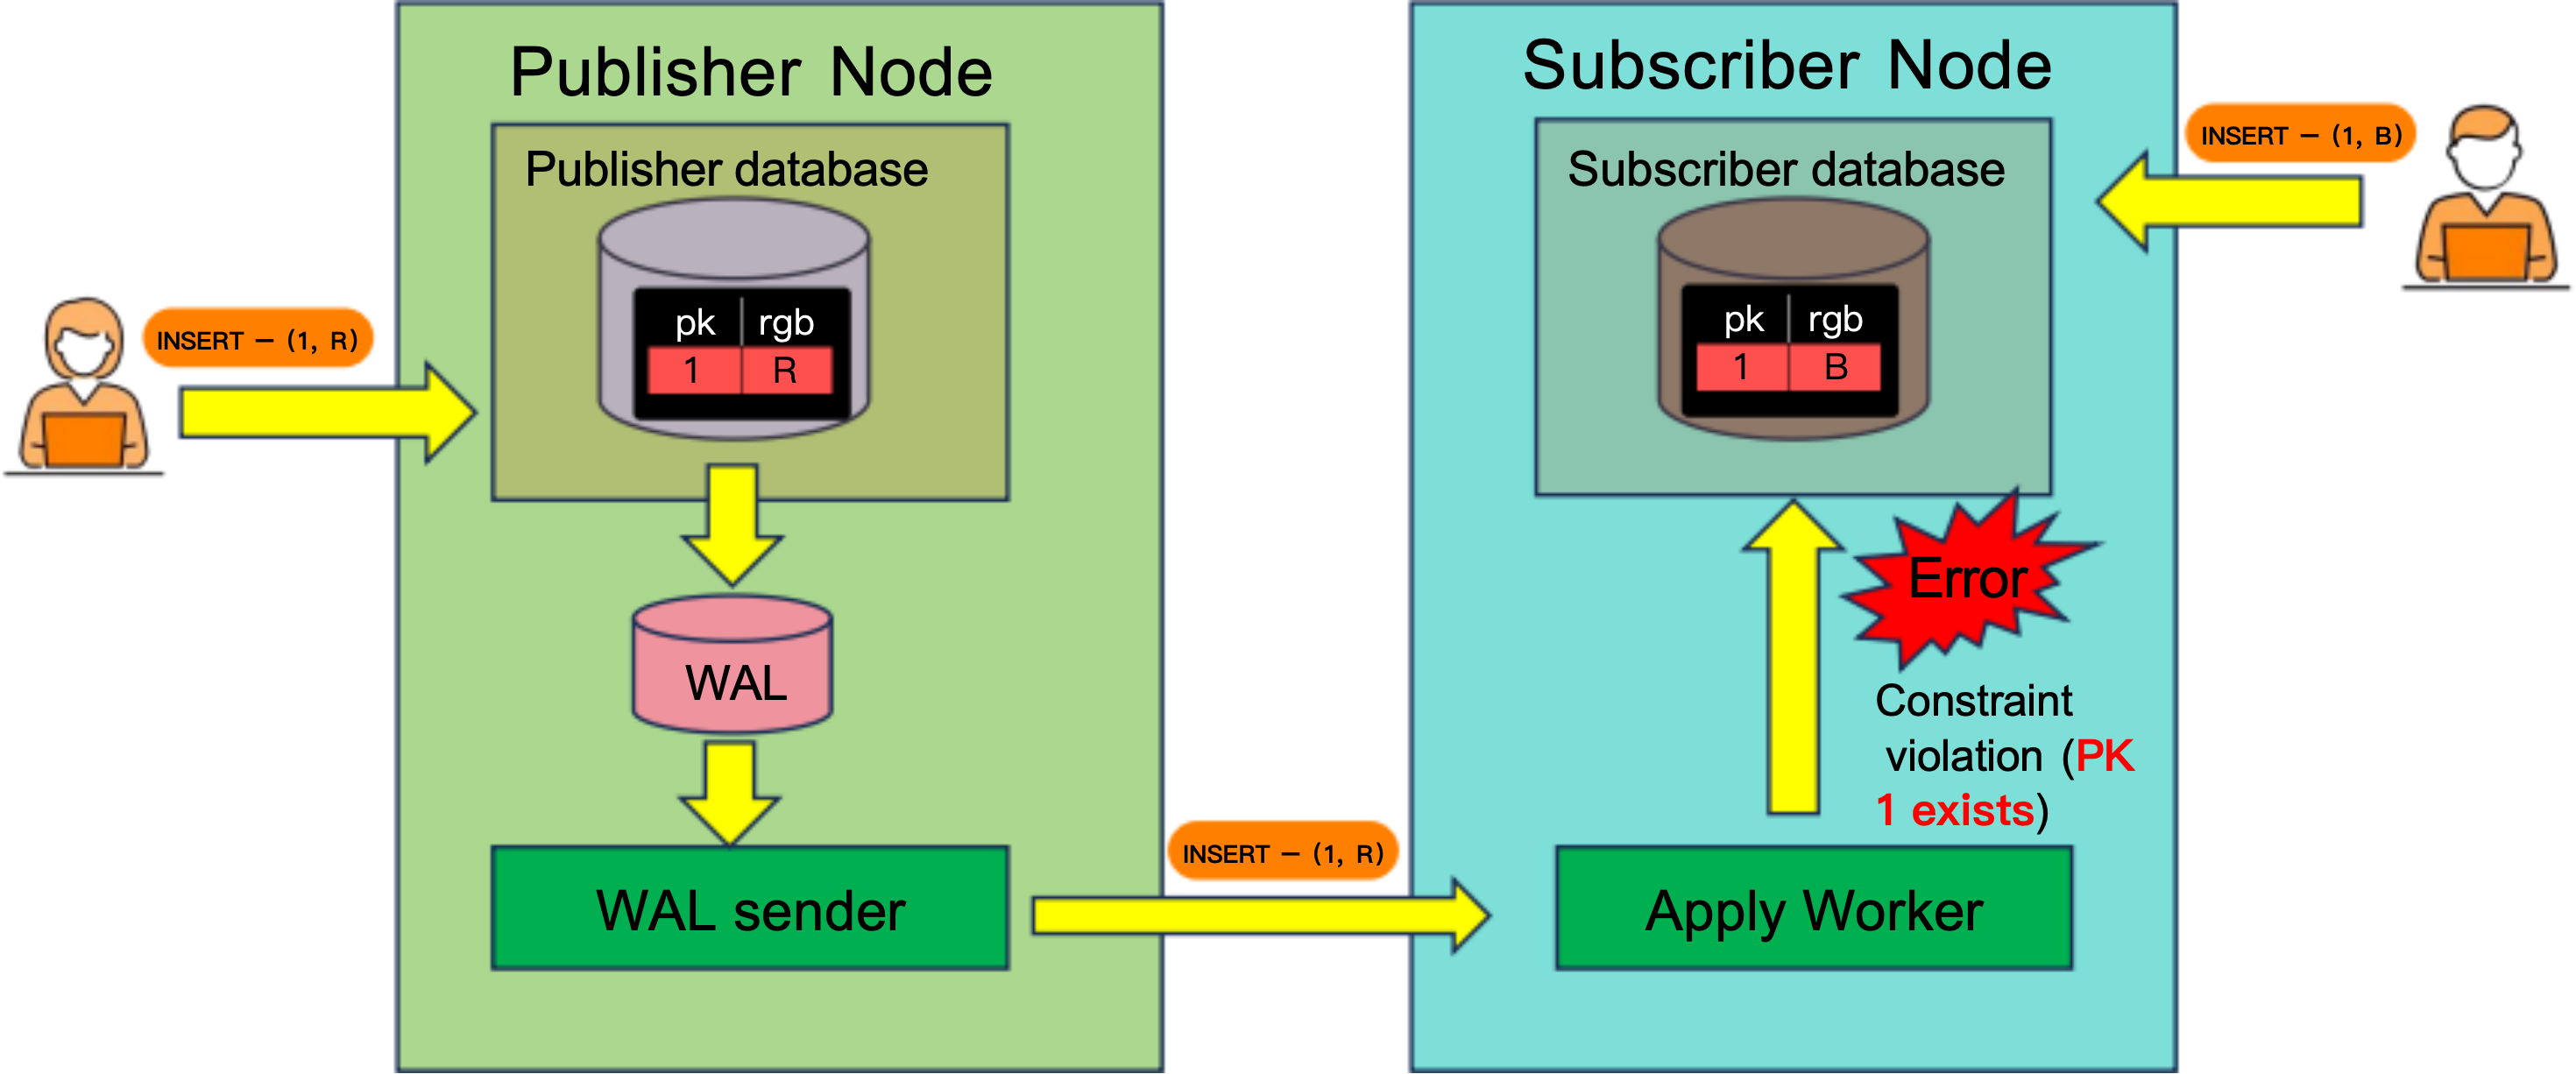
在多主写入场景下,若两个节点同时修改同一行数据,会产生冲突。以下图为例:发布端插入(1, R),订阅端同时插入(1, B),主键均为1。当发布端的修改到达订阅端时,发现主键已存在,Apply Worker报错停止,逻辑复制中断。
2.png

可检测的冲突类型

PostgreSQL目前已能在日志中识别以下冲突类型:

冲突类型说明
insert_exists插入的行违反不可延迟的唯一约束(主键冲突)
update_origin_differs待更新的行之前被其他来源修改过
update_deleted待更新的元组已被其他来源并发删除

日志会输出类似信息:

ERROR: conflict detected on relation "public.test": conflict=insert_exists
DETAIL: Could not apply remote change: remote row (1, 'remote'). 
Key already exists in unique index "test_pkey"

现有的手动解决方法

当前PostgreSQL提供了几种手动处理冲突的方式:

方法一:disable_on_error
订阅端设置此选项后,发生冲突时订阅端会停止而非持续报错,给用户介入分析的机会。

方法二:SKIP LSN

ALTER SUBSCRIPTION mysub SKIP (lsn = '0/1566D10');

跳过指定LSN对应的事务,但会丢失该事务的数据,需手动恢复。

方法三:自定义Trigger
用户自行编写Trigger,在Apply Worker写入前判断并处理冲突。

CREATE TRIGGER trg_ignore_duplicate_insert BEFORE INSERT ON my_table
FOR EACH ROW EXECUTE FUNCTION ignore_duplicate_insert();
ALTER TABLE my_table ENABLE REPLICA TRIGGER ignore_duplicate_insert;

方法四:Advance Origin
通过pg_replication_origin_advance向前推进复制进度,跳过部分日志,同样会丢失数据。

未来的自动化方案

冲突日志表
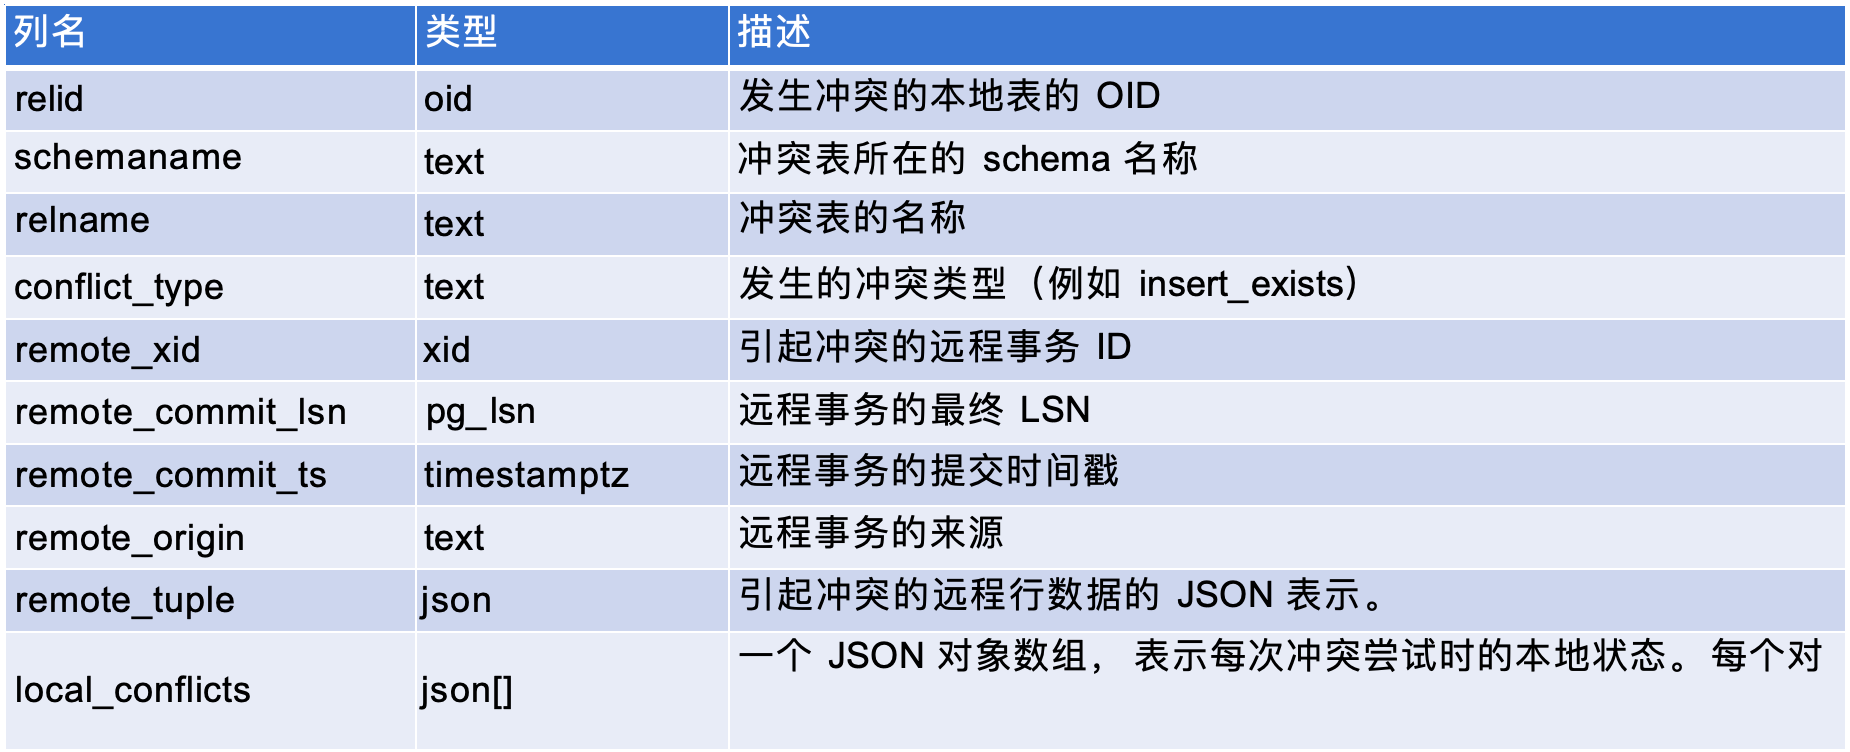
新增系统表专门存储冲突历史数据,用户可直接通过SQL查询获取冲突的元组、事务类型等信息,无需自行解析日志。
3.png

自动冲突解决策略
在创建或修改订阅时指定冲突解决策略:

CREATE SUBSCRIPTION mysub CONNECTION '...' PUBLICATION mypub 
CONFLICT RESOLVER (insert_exists = apply_remote, ...);

ALTER SUBSCRIPTION mysub CONFLICT RESOLVER (insert_exists = skip, ...);

内置的冲突解决方法包括:

解决策略行为
apply_remote优先应用发布端修改(如删除订阅端冲突行后插入新数据)
skip仅跳过冲突的行修改,事务其他部分正常应用
error遇到冲突直接报错
last_update_win应用时间戳最新的修改,保持最终一致性

死元组保留
为正确检测update_deleted等冲突,需确保被删除的元组在冲突检测完成前不被Vacuum清理。新增订阅选项retain_dead_tuples可动态保留死元组,在确认不再需要后允许回收。

并行复制

性能瓶颈

逻辑复制在订阅端默认只有一个apply worker进程。在发布端有大量客户端并发写入时,单进程无法及时处理所有变更,复制延迟持续增大,这是逻辑复制性能远低于物理复制的核心原因。

现有方法的局限

Streaming Parallel(PG 16+):仅对未提交的大事务有效,对小事务无优化,不适用于普通场景。

多订阅端划分:按表划分时,外键关联的两张表复制顺序无法保证,可能导致数据不一致;按行划分时,提交顺序无法与发布端保持一致。

新方案设计

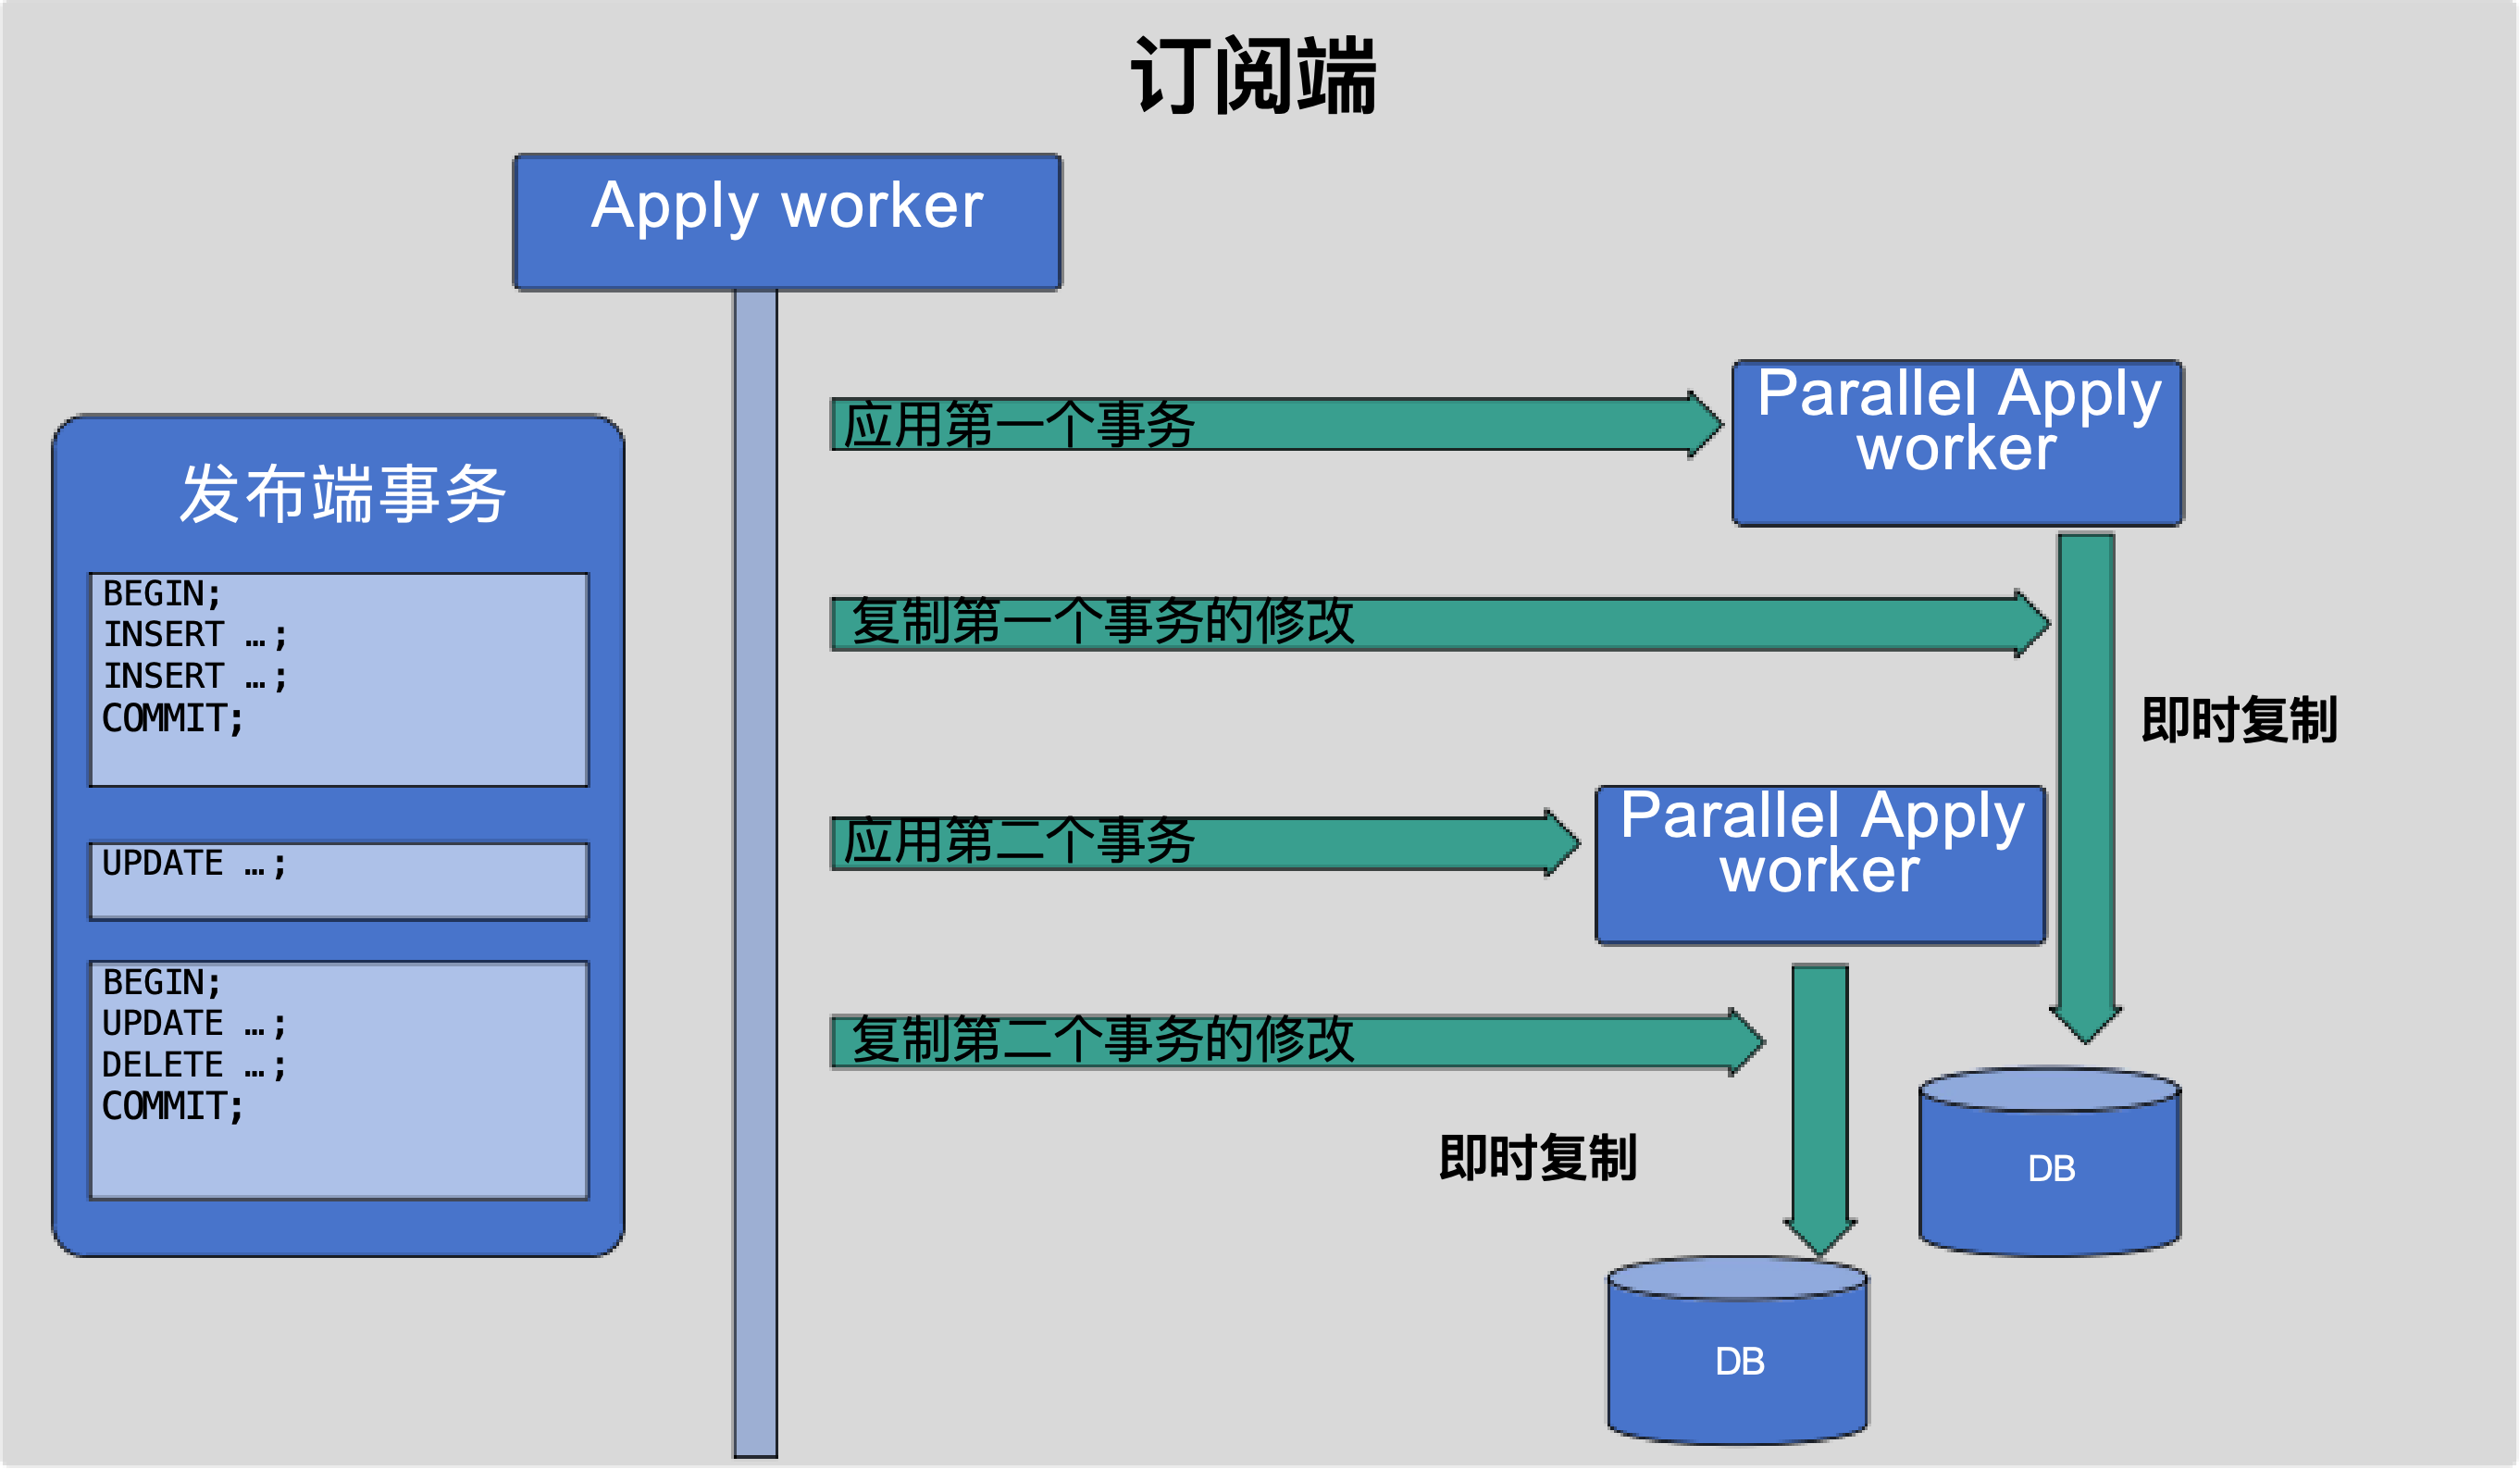
为每个事务独立开启进程进行并行应用,核心机制如下:

依赖检测:Leader Worker在分发变更时计算事务间的依赖关系。如果两个事务修改了同一行或可能破坏唯一约束,则认为存在依赖,后一个事务需等待前一个完成后再执行。

提交顺序保证:即使事务间无数据依赖,提交阶段仍需严格遵循发布端的提交顺序,确保数据一致性。

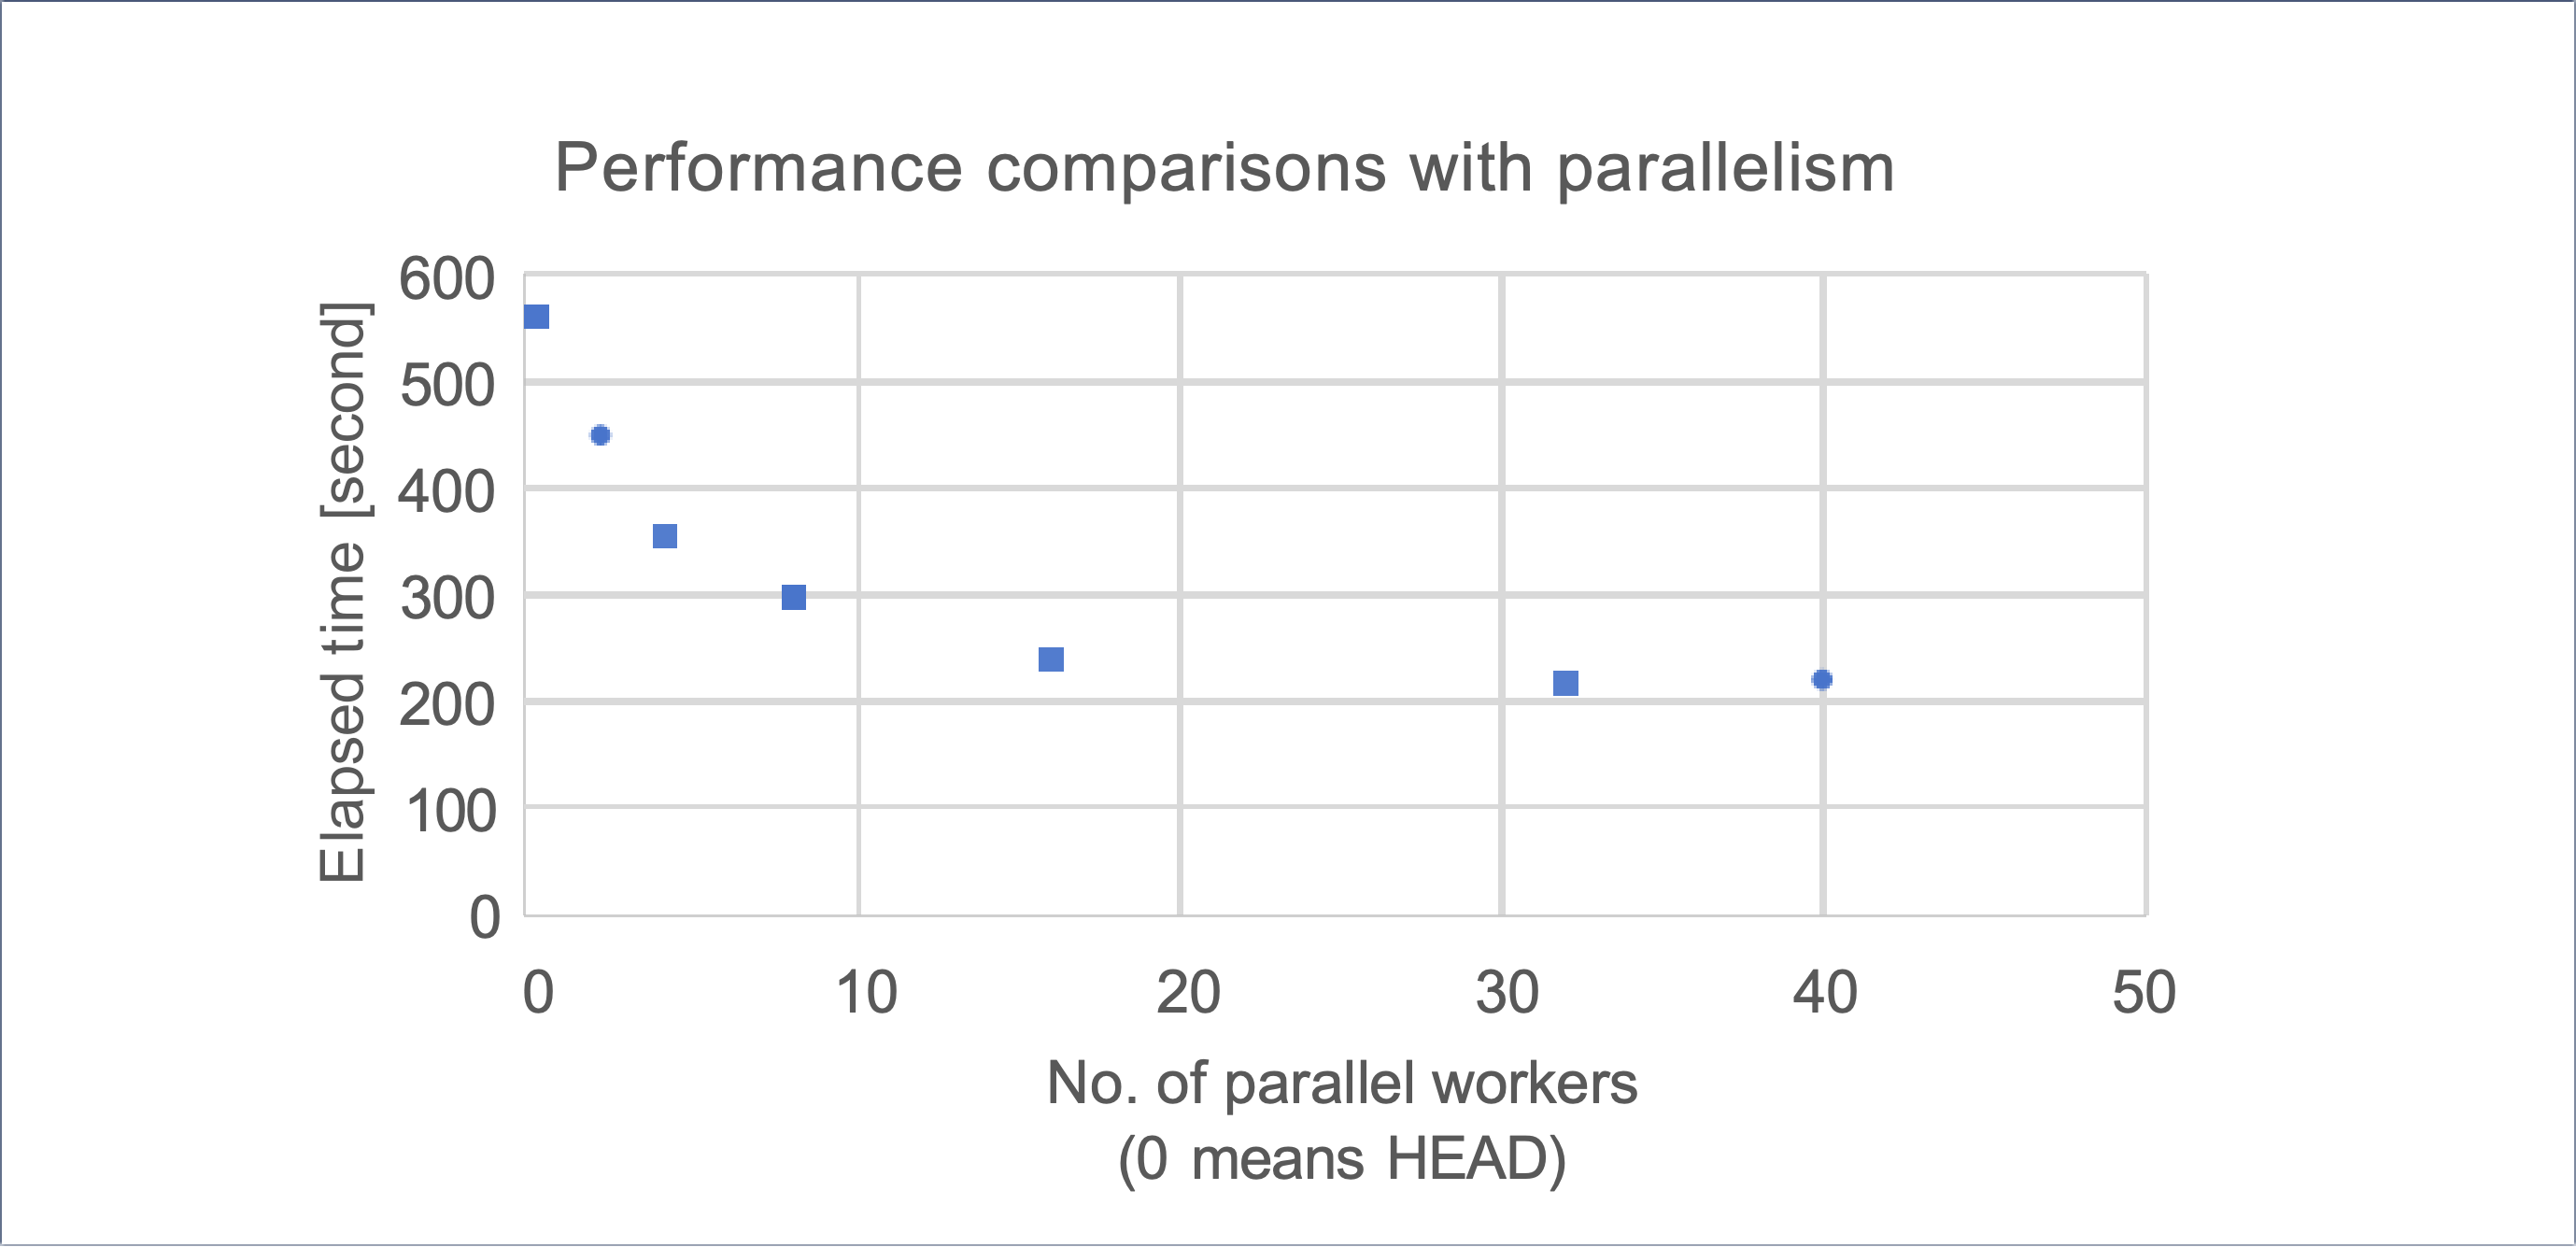
性能数据:基准测试显示,增加Worker数量可提升约3倍的复制吞吐量。受限于提交顺序协调的开销,性能提升有上限,但已能显著改善高并发场景下的延迟问题。
4.png

5.png

集中式逻辑解码

问题:重复解码

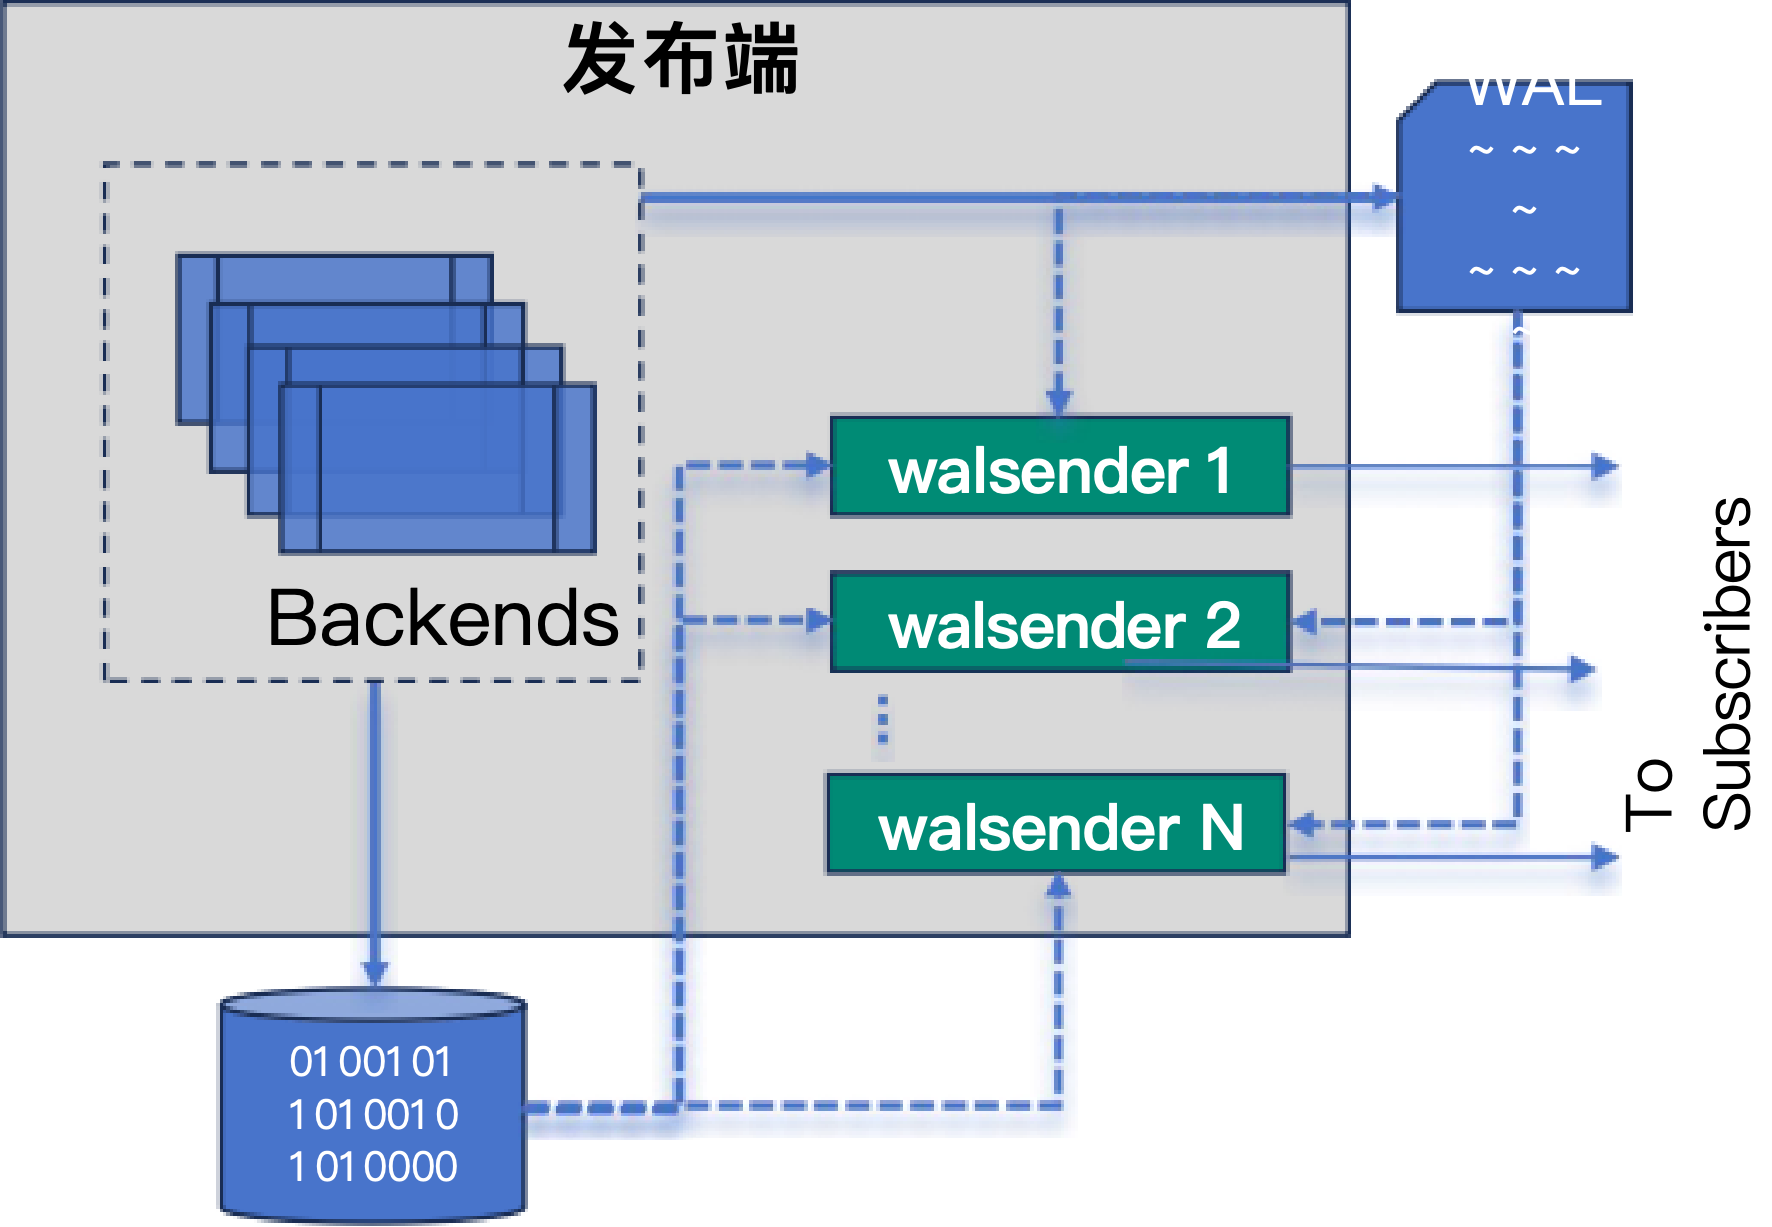
在多订阅端场景下,每个订阅端对应一个独立的WALSender进程,每个进程都要对相同的WAL日志进行独立的逻辑解码。这种重复解码造成:

  • CPU开销随订阅数线性增长
  • 解码工作重复执行,扩展性差
  • 延迟升高,高写入负载下问题加剧

解决方案

引入专用进程统一解码WAL日志,解码结果在所有WALSender之间共享复用。每个订阅端直接消费已解码的数据,无需重复解析。这本质上是一种Pipeline化的处理机制,将解码从N次降为1次。
6.png

总结

本文介绍了PostgreSQL逻辑复制未来演进中的三个核心方向:

  1. 多主冲突检测与自动解决:通过冲突日志表和可配置的自动解决策略,将当前需要手工介入的冲突处理流程化、自动化,提升多主架构的可用性。
  2. 并行复制:通过依赖感知的事务分发和提交顺序保证,突破单进程Apply Worker的性能天花板,实测可提升约3倍吞吐量。
  3. 集中式解码:消除多订阅端场景下的重复解码开销,将解码次数从O(n)降为O(1)。

上述功能预计将在PostgreSQL 20、PostgreSQL 21或PostgreSQL 22版本中陆续实装。此外,除了技术演进,苹果公司近期也已决定组建团队并投入资源参与社区开发,成为继微软、亚马逊、谷歌之后又一家反哺PostgreSQL社区的国际大厂,这对整个生态的发展是积极的信号。

PostgreSQL 10逻辑复制部署全指南:Ubuntu 18.04四层配置详解 逻辑复制是 PostgreSQL 实现数据分发与解耦的核心机制,其本质是基于 WAL 的逻辑变更捕获与传输。它依赖 wal_level=logical 参数开启逻辑解码能力,并通过复制槽(replication slot)保障变更不丢失。技术价值在于支持跨版本、跨库、按表粒度的灵活同步,适用于读写分离、微服务数据分发和异构系统集成等场景。但 PostgreSQL 10 原生逻辑复制并非开箱即用,需协同配置系统层(如 Ubuntu 18.04 的 systemd socket、UFW 防火墙、listen_a 阅读详情

相关推荐

PostgreSQL 12逻辑复制实战:从发布订阅到排障全流程

数据库同步是运维与架构中的常见需求,物理复制虽稳定但只能整实例复制,无法满足按表、跨版本同步。逻辑复制基于发布/订阅模型,通过解析WAL将变更转换为中间格式,可实现表级粒度、跨大版本同步,并能在订阅端定制结构。PostgreSQL 12的逻辑复制功能已趋成熟,常用于订单库到分析库的近实时同步、分库分表汇聚等场景。实际落地时需重点关注发布订阅的配置、复制标识的设置、账号权限与参数调优,并处理好DDL手工同步和序列同步等细节。本文以PostgreSQL 12为对象,完整介绍了逻辑复制从原理、部署到日常监控排障的

weixin_29973493的博客 173

PostgreSQL 技术日报 (4月8日)|PG 内核开发新看点

Heikki提出了关于API设计的基本问题,质疑为什么只限制在末尾调整大小而不支持打洞功能,并询问超出Linux之外的跨平台兼容性。随后引入了包含五个补丁的新补丁集:两个实现重试机制以减少测试失败(而非串行运行测试),一个修复 Alexander Lakhin 报告的 tablesample 扫描问题(当 Sample Scan 出现在连接下方时会导致问题),一个解决缺失的 Makefile 条目,以及一个修复生成建议时与子查询相关的错误。他指出,当前的模型缺乏产生可靠输出所需的企业环境信息。

IvorySQL的博客 286

PostgreSQL 9.3实战元年:JSONB、FDW与逻辑复制生产落地指南

关系型数据库正从单一存储走向混合数据中枢,其核心演进体现在对半结构化数据、跨源联邦查询与变更数据捕获(CDC)的原生支持能力上。PostgreSQL 9.3作为首个全面支撑OLTP+OLAP混合负载的稳定版本,通过JSONB二进制格式实现高性能路径索引与运算符优化,借助Foreign Data Wrapper(FDW)达成SQL级异构数据源透明关联,并以WAL日志解析为基础构建逻辑复制雏形——这三大能力共同构成了现代云原生数据架构的底层契约。技术价值不仅在于功能本身,更在于其可灰度、可审计、可运维的工程就绪

cneo2012的博客 416

PostgreSQL未来版本前瞻:逻辑复制并行、异步I/O、向量检索与增量备份

数据库作为基础软件,其功能从社区提案到生产可用往往需要以年计的周期。理解当前补丁与讨论的方向,就能提前预判未来版本的能力边界。在PostgreSQL社区三月动态中,逻辑复制订阅端的并发回放机制正试图打破大事务串行应用的性能瓶颈,通过事务分组与提交屏障设计,在保证一致性的前提下显著降低主备延迟;异步I/O抽象层则推动存储访问路径从阻塞式向异步化演进,为NVMe SSD时代的高吞吐场景重构基础架构。同时,向量检索能力正从扩展生态向内核接口渗透,AI应用与结构化查询的融合路径日趋清晰;增量备份与校验机制的补强则补

weixin_31960565的博客 247

PostgreSQL复制功能的历史漫谈

随着PostgreSQL版本的演进,流复制(Streaming Replication)成为了PostgreSQL复制功能的一个重要里程碑。流复制通过在主数据库上创建一个持续的、基于流的连接,将事务日志实时地传输到备用数据库。最初,PostgreSQL使用简单的日志复制方法,称为基于日志的复制(log shipping)。在这种方法中,主数据库将修改记录写入到事务日志(WAL)中,而备用数据库则通过复制主数据库的WAL日志来保持数据的一致性。最后,启动备用数据库,它将开始从主数据库接收逻辑复制数据。

XwlyVue的博客 116

地平线天工开物AI开发平台实战:从量化训练到模型部署的完整指南

本文提供了地平线天工开物(OpenExplorer)AI开发平台的实战指南,详细解析了从量化训练到模型部署的完整流程。文章重点对比了量化感知训练(QAT)与训练后量化(PTQ)两条核心路径的优劣与适用场景,并分享了图像分类模型PTQ部署的实战经验与常见问题调试技巧,旨在帮助开发者高效地将AI模型部署到地平线AI芯片上。

weixin_29046035的博客 456

从PGConf.dev 2026日程前瞻PostgreSQL技术趋势与社区生态

数据库作为现代应用的核心基础设施,其技术演进深刻影响着系统架构与开发实践。开源数据库PostgreSQL以其强大的扩展性和活跃的社区生态著称,其技术发展方向往往通过核心开发者会议议题集中呈现。深入分析这类会议日程,不仅能揭示查询优化器、存储引擎、逻辑复制等内核模块的演进原理,更能把握高可用架构、云原生运维等工程实践的前沿动态。对于数据库工程师和架构师而言,这提供了前瞻性的学习路径和社区参与指南。通过解读PGConf.dev这类深度技术会议的远期日程,从业者可以系统性地规划技术储备,洞察如并行查询优化、扩展插

weixin_26938645的博客 233

ERPS协议原理

目录 1、ERPS概述: 2、ERPS名词概念解释: 3、ERPS协议报文: 4、ERPS单环基本原理: 5、单环多实例原理: 6、多环原理: 1、ERPS概述: ERPS(Ethernet Ring Protection Switching),即以太网多环保护技术,是ITU-T定义的一种二层破环协议标准,标准号为ITU-T G.8032/Y1344,因此又称为G.8032。它定义了RAPS(Ring Auto Protection Switching)协议报文和保护倒换机制。 ERPS目前支持v1和v2两

weixin_44880796的博客 1万+

PostgreSQL复制技术全解析:从物理复制到逻辑复制的实践指南

PostgreSQL作为企业级数据库的核心组件,其复制技术是构建高可用架构和数据同步解决方案的基础。本文深入剖析PostgreSQL两大复制技术——物理复制与逻辑复制的实现原理、配置方法和应用场景。通过对比分析两者的技术特点,帮助读者根据业务需求选择合适的复制方案。文章包含详细的配置示例、性能优化建议和实际应用案例,为数据库管理员和架构师提供全面的实践指导。

neweastsun的专栏 1414

AI 推理与服务(AI Inference and Serving)

AI 推理和服务是现代分布式系统中的重要组成部分。通过合理应用 AI 推理和服务的最佳实践,可以显著提高系统的智能性和用户体验。本章介绍了 AI 推理和服务的核心概念、最佳实践以及在分布式系统中的应用,希望这些内容能帮助您构建更智能、更高效的分布式系统。

蜗牛沐雨 1382

Nvidia Isaac Sim安装与配置 入门教程 2024(2)

Isaac Sim 安装和配置教程将指导用户完成从下载软件到设置和运行仿真的全过程。教程内容包括安装必要的依赖项、配置系统环境、配置Omniverse环境以及调试和优化仿真环境的步骤。通过详细的操作步骤和图文并茂的说明,用户可以快速上手 Isaac Sim,构建出高质量的机器人仿真环境,实现其研究和应用目标。

m0_56661101的博客 2万+

PostgreSQL 逻辑复制解密

在数字化时代的今天,我们都认同数据会创造价值。为了最大化数据的价值,我们不停的建立着数据迁移的管道,从同构到异构,从关系型到非关系型,从云下到云上,从数仓到数据湖,试图在各种场景挖掘数据的价值。而在这纵横交错的数据网络中,逻辑复制扮演着及其重要的角色。让我们将视角从复杂的网络拉回其中的一个端点,从 PostgreSQL 出发,对其逻辑复制的原理进行解密。

weixin_43770745的博客 780

《计算机网络》课程大作业- 《小区局域网的设计和规划》

8.1首先,在满足用户需求方面,通过详细的需求分析,充分考虑了居民和物业管理的不同业务需求。对于居民,无论是日常的高清视频播放、在线游戏、远程办公还是智能家居设备的连接,网络都能提供稳定的高速带宽支持。从有线网络的千兆以太网技术保障稳定的有线连接,到无线网络采用 Wi - Fi 6 技术确保无线覆盖区域的高速和低延迟,满足了居民多样化的娱乐和生活需求。对于物业管理,安防监控系统的实时数据传输、物业办公自动化系统的流畅运行以及社区信息的及时发布等业务,都有针对性的网络设计。

lisangsimida的博客 2598

PostgreSQL逻辑复制解密

在数字化时代的今天,我们都认同数据会创造价值。为了最大化数据的价值,我们不停的建立着数据迁移的管道,从同构到异构,从关系型到非关系型,从云下到云上,从数仓到数据湖,试图在各种场景挖掘数据的价值。而在这纵横交错的数据网络中,逻辑复制扮演着及其重要的角色。 让我们将视角从复杂的网络拉回其中的一个端点,从PostgreSQL出发,对其逻辑复制的原理进行解密。

京东科技开发者 747

0 基础学前端:100 天拿 offer 实战课(第 16 天)—— JS 数组高级方法:数据处理效率翻倍,代码更简洁

方法名核心作用回调函数返回值返回结果适用场景map数据转换转换后的新元素新数组(长度与原数组一致)格式转换、新增字段、生成 DOM 字符串filter数据筛选true(保留)/false(过滤)新数组(符合条件的元素)筛选符合条件的元素(如未完成计划、今天的评论)reduce数据汇总新的累加值任意类型(数字、对象等)求和、计数、分组、多数据汇总find查找元素true(匹配)/false(不匹配)第一个匹配的元素 /undefined。

苏打水.X的博客 132

从 ABAP 后端到 AEX,Local Integration Engine 下的 Business System 配置全景

本文围绕SAP PI AEX配置中ABAP后端系统与AEX的连接问题,梳理了关键概念和技术脉络。重点指出基于ABAP 6.20及更高版本的业务系统内置了本地集成引擎(Local Integration Engine),负责与AEX的消息交互。配置要点包括:1)在SM59中创建HTTP类型RFC目标连接AEX;2)配置SAP_PROXY_ESR供设计时代理生成;3)通过SXMB_ADM设置业务系统角色为应用系统;4)确保SLD注册和SICF服务激活。文章特别强调运行时代理消息传递与设计时代理生成的区分,以及H

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 97

TDSQL | DTS for PostgreSQL 逻辑复制详解

逻辑复制概念 逻辑复制是 PG 数据库基于数据对象的复制标志,也就是 Replica Identity 来复制数据对象及数据变化的方法。它最初是在 2014 年 12 月份的 PG9.4.0 引入,称为逻辑解码,后来在 2017 年 10 月 PG10.0 版本中又引入了基于发布订阅的逻辑复制概念。之所以称为逻辑复制是为了和更早引入的物理复制加以区分。逻辑复制规律和物理复制这两种复制机制有比较大的区别,物理复制是使用准确的块地质遗迹逐字节的复制方式,而逻辑复制则允许在数据层面复制,并在安全性上提供..

Wandssss的博客 2882

OpenClaw实战系列·进阶特辑02:多智能体协同——打造企业级AI中台

**企业级AI中台面临多Agent协同的挑战,本文提出基于多智能体协同的解决方案。通过分析单Agent的局限性(上下文溢出、专业度稀释等)和多Agent的核心优势(任务专注度、故障隔离等),提出三种协作架构模式(指挥型、联邦型、点对点型),并强调人格化设计的重要性。文章详细介绍Agent间通讯机制(同步/异步会话、文件系统协作)和"身脑分离"的解耦架构设计,提供可落地的企业级AI中台实施方案。

PeterPan的博客 493

Spock vs 原生逻辑复制 vs BDR:PostgreSQL 多主复制方案怎么选?(2026 最新对比)

PostgreSQL 多主复制一直是数据库选型中的经典难题:既想让多个节点同时读写,又怕数据冲突、脑裂和运维失控。目前主流的三条技术路线——PostgreSQL 原生逻辑复制、商业化的 BDR,以及开源的多主复制扩展 Spock——各有权衡。本文将从架构原理、冲突处理、功能特性和部署成本四个维度,为你做一次完整的 PostgreSQL 多主复制方案对比,帮你快速锁定最适合自己业务的答案。🚀 #

gitblog_00125的博客 366

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【PostgreSQL从零到精通】第46篇:Slony-I逻辑复制——传统的主从复制方案

摘要:本文详细介绍了Slony-I逻辑复制工具在PostgreSQL中的实现原理与配置方法。作为PostgreSQL 10之前的主流复制方案,Slony-I基于触发器捕获变更并通过dblink同步数据。文章首先解析了其核心架构概念(集群、节点、复制集合),然后分步骤演示了安装部署过程,包括环境准备、集群初始化、复制集创建和订阅配置。虽然现代PostgreSQL已内置逻辑复制,但理解Slony-I的工作机制对维护遗留系统仍有重要价值,特别是在需要处理复杂复制拓扑或特定历史场景时。

xyghehehehe的专栏 347

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

PostgreSQL Server Exporter未来展望:路线图与新特性预览

PostgreSQL Server Exporter作为Prometheus生态中重要的数据库监控组件,正持续演进以适应不断变化的监控需求。本文将深入探讨其未来发展路线图及潜在新特性,帮助用户提前了解这一工具的技术走向。 ## 一、版本演进与兼容性规划 PostgreSQL Server Exporter始终保持对主流数据库版本的支持。目前CI测试已覆盖PostgreSQL `13`至`18`版

gitblog_00852的博客 1120

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

PostgreSQL 中的物理复制与逻辑复制:机制、差异与选型

PostgreSQL 中的物理复制与逻辑复制:机制、差异与选型

To learn, to engage. 447

Ubuntu 12.04下PostgreSQL 9.1主从复制实战指南

PostgreSQL主从复制是保障数据库高可用与读写分离的核心机制,其底层依赖WAL日志流式同步与物理复制原理,具备事务强一致、低延迟、零应用侵入等技术价值。在资源受限或系统固化场景中,如老旧ERP、工业控制中间件所依赖的Ubuntu 12.04(Linux 3.2内核+OpenSSL 1.0.1)环境,必须采用兼容PostgreSQL 9.1的物理复制方案,而非现代逻辑复制;该方案通过streaming replication实现毫秒级同步,并借助hot_standby开启从库只读服务能力,从而支撑报表查

dbp5156的博客 424

PostgreSQL复制管理技术栈版本适配:从兼容性到最优架构选择

PostgreSQL作为企业级关系数据库的标杆,其高可用架构的技术兼容性直接决定了系统的稳定性和可扩展性。repmgr作为PostgreSQL生态中成熟的复制管理工具,其技术栈版本适配策略体现了对多版本支持策略的深度思考。最新repmgr 5.5版本全面支持PostgreSQL 13至17版本,这种向后兼容性设计确保了企业在技术演进过程中的平滑过渡,为架构师提供了灵活的技术栈匹配方案。 ## 多

gitblog_00975的博客 312

PostgreSQL高可用架构设计:repmgr分布式复制管理最佳实践

repmgr作为PostgreSQL生态系统中成熟的开源复制管理工具,为企业级数据库高可用架构提供了完整的技术解决方案。作为一款轻量级但功能强大的复制管理器,repmgr通过自动化故障转移、集群监控和节点管理,显著提升了PostgreSQL生产环境的可靠性和运维效率。本文将从技术架构、部署策略到性能优化,全面解析repmgr在PostgreSQL高可用场景中的最佳实践。 ## 技术背景与挑战分析

gitblog_00100的博客 910
上一篇: PostgreSQL 日报|备份截断检测修复(8 月 11 日)
下一篇: PostgreSQL 日报|PG18.5 回归测试崩溃问题(8 月 12 日)
IvorySQL
博客等级 码龄5年 745粉丝 557原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值