pg_stats:Postgres 内部统计机制详解

Postgres MCP集群慢查询调优实战:从统计偏差到分布式执行闭环 Postgres作为主流关系型数据库,其性能优化常聚焦于SQL写法、索引设计与单机统计信息。但在MCP(Multi-Cluster Protocol)架构下,数据库演变为跨节点协同系统,传统调优方法失效。MCP本质是Postgres的分布式协调层,不存储数据,却深度影响查询规划——因各节点pg_statistic统计偏差(如ndistinct低估)、WSS传输延迟、协调层元数据不同步,导致同一SQL在不同节点执行耗时差异巨大。技术价值在于将‘单机优化思维’升级为‘协同面治理能力’,支撑Supabase、Ne 阅读详情

概述

本文梳理 PostgreSQL 内部统计的核心原理与 pg_stats 视图运行机制,内容源自 POSETTE 2026 技术分享。文章系统性讲解 pg_stats 的定义、生成逻辑,以及其对 Postgres 查询规划器决策的核心影响,帮助读者全面掌握数据库统计数据驱动 SQL 执行计划的底层逻辑。

本文以业务常用的 customers 数据表作为演示案例:

CREATE TABLE customers (
    id          bigserial PRIMARY KEY,
    city        text NOT NULL,
    state       text NOT NULL,
    signup_date date NOT NULL
);
-- Insert 1,000,000 rows

以下是日常业务中高频使用的筛选查询语句:

SELECT * FROM customers WHERE state = 'CA';

该表已为 state 和 city 字段分别创建独立索引。常规认知中,数据库会优先走 state 字段的索引扫描,但 EXPLAIN ANALYZE 的实际执行结果却截然不同:

QUERY PLAN
-----------------------------------------------------------------
 Seq Scan on customers  (cost=0.00..19682.66 rows=173829 width=26)
                        (actual time=0.025..120.574 rows=172001 loops=1)
   Filter: (state = 'CA'::text)
   Rows Removed by Filter: 827972
   Buffers: shared hit=4601 read=2582
 Planning:   Buffers: shared hit=139
 Planning Time: 0.371 ms
 Execution Time: 128.136 ms

数据表存在有效索引的前提下,数据库最终选择了顺序扫描。本文将深入解析这一现象背后的统计机制原理。

查询计划由查询规划器生成

Postgres 接收 SQL 查询请求后,会通过内置查询规划器生成执行计划。规划器不会直接读取、解析数据表原始数据,所有执行决策均依托于系统表 pg_statistic中存储的数据汇总信息。

pg_statistic 存储的汇总数据,包含规划器判定执行计划所需的各类核心维度信息:

  • 数据表中各个字段的唯一值数量
  • 字段的高频取值及其出现频率
  • 字段数值在取值区间内的整体分布规律
  • 数据在磁盘上的物理存储顺序与字段逻辑排序顺序的匹配度

pg_statistic 的原始数据为机器优化格式,可读性极差。为方便人工查询与使用,Postgres 封装了 pg_stats 视图,以标准化、易读的形式展示所有统计信息。

ANALYZE:统计数据的生成与更新机制

pg_statistic 中的汇总数据无法自动生成,所有统计指标均通过 ANALYZE 命令生成并刷新。

ANALYZE customers;

ANALYZE 会对目标表执行全表扫描或抽样扫描,计算每个字段的多维统计指标,并将结果写入 pg_statistic 系统表。Postgres 的自动真空清理机制会在后台自动执行 ANALYZE,但大批量数据载入、数据迁移等场景下,需手动执行该命令更新实时统计数据。
针对 customers 表执行统计查询,查看核心字段指标:

SELECT attname, n_distinct, null_frac, correlation
FROM pg_stats
WHERE tablename = 'customers'
ORDER BY attname;
  attname    | n_distinct | null_frac |  correlation
--------------+------------+-----------+--------------
city         |      10106 |         0 |  0.0021338463
id           |         -1 |         0 |             1
signup_date  |       1822 |         0 |             1
state        |         50 |         0 |    0.06440461
(4 rows)

核心指标释义如下:

  • n_distinct:字段唯一值的估算数量。state 字段恰好有 50 个唯一值,与美国州的数量匹配;city 字段存在 10106 个唯一值,符合美国城市数据分布特征。主键 id 取值为 -1,是字段唯一无重复的固定标识。
  • null_frac:字段空值占总行数的比例。示例中所有字段均定义为非空,因此该指标全部为 0。
  • correlation:取值范围为 -1 至 +1,用于衡量数据磁盘物理存储顺序与字段逻辑排序顺序的匹配程度。取值 +1 代表数据在磁盘上完全有序(自增 ID、增量日期字段均符合该特征);取值趋近于 0 代表数据存储顺序相对字段值随机;取值趋近于 ±1 时,数据库更倾向于走索引扫描;取值趋近于 0 时,索引扫描成本更高,更易触发顺序扫描。该指标会作为系数参与规划器的成本计算。

高频值统计(MCV)

ANALYZE 会采集字段的高频取值及对应出现频率,两类数据分别存储在 pg_stats 的 most_common_vals 和 most_common_freqs 平行数组中。

以 state 字段为例,查询其高频值分布数据:

SELECT
   unnest(most_common_vals::text::text[]) AS state,
   unnest(most_common_freqs)              AS frequency
FROM pg_stats
WHERE tablename = 'customers' AND attname = 'state'
LIMIT 5;
state |  frequency
-------+-------------
CA    |  0.17403333
TX    |      0.1165
NY    |  0.08586667
FL    |      0.0666
IL    |      0.0474
(5 rows)

统计结果显示,state=CA 的数据占比约 17.4%,state=TX 占比约 11.6%。高频值的频率数据是规划器估算扫描行数、选择执行扫描方式的核心依据。

成本机制:规划器的计划选择逻辑

查询规划器基于成本计算结果筛选最优执行计划,影响计划选择的三大核心成本参数如下:

  • random_page_cost:随机读取磁盘页的成本,对应索引扫描+回表查询场景
  • seq_page_cost:顺序读取磁盘页的成本,对应全表顺序扫描场景
  • cpu_tuple_cost:处理单行数据的 CPU 计算成本

结合 pg_statistic 生成的行数估算数据,上述成本参数共同决定规划器的两类核心执行选择:

扫描类型

  • 顺序扫描(Sequential Scan)
  • 索引扫描(Index Scan)
  • 位图堆扫描(Bitmap Heap Scan)

连接类型

  • 嵌套循环连接(Nested Loop)
  • 哈希连接(Hash Join)
  • 合并连接(Merge Join)

规划器会生成多个候选执行计划,计算各计划的总成本,最终选取成本最低的方案执行。失真或过期的统计数据会导致行数估算错误,进而引发执行计划不合理、SQL 性能下降。精准的统计数据是高效查询执行的核心前提。

两类取值的查询计划差异解析

对比查询 state 字段高频值 CA 与低频值 WY 的执行计划:

EXPLAIN ANALYZE SELECT * FROM customers WHERE state = 'CA';
-- Seq Scan on customers  (cost=0.00..19682.66 rows=174029 ...)
--                        (actual time=0.042..50.257 rows=172001 loops=1)

EXPLAIN ANALYZE SELECT * FROM customers WHERE state = 'WY';
-- Index Scan using customers_state_idx on customers
--    (cost=0.42..13116.39 rows=4233 ...)
--    (actual time=0.045..21.238 rows=4300 loops=1)

state=CA 的数据占全表约 18%,近 18 万行。针对大规模匹配数据,索引扫描需要反复执行索引检索与磁盘页读取,综合成本远高于全表顺序扫描,因此规划器优先选择顺序扫描。

state=WY 的匹配数据仅约 4000 行,数据选择性极低,索引扫描的效率优势显著,因此规划器触发索引扫描。

可通过手动关闭顺序扫描功能,验证成本判定逻辑的合理性:

SET enable_seqscan = off;

EXPLAIN ANALYZE SELECT * FROM customers WHERE state = 'CA';
--  Index Scan using customers_state_idx on customers
--    (cost=0.42..32172.73 rows=170529 width=26)
--    (actual time=0.053..75.656 rows=172001 loops=1)

强制走索引扫描后,执行成本从 19682 升至 32172,验证了原顺序扫描计划为最优选择。高频值统计数据精准识别了 CA 的高占比特征,帮助规划器规避低效的索引扫描,充分体现了高频值统计在倾斜数据场景下的核心价值。

直方图:适配非等值范围查询

高频值统计仅适用于等值查询场景。针对时间范围筛选、数值区间对比等范围查询,ANALYZE 会生成字段直方图统计数据,辅助规划器完成计划判定。

Postgres 默认生成 100 个等深直方图桶,每个桶承载的数据行数基本一致。查询 signup_date 字段的直方图边界数据:

SELECT (unnest(histogram_bounds::text::date[]))::date AS bucket_bound
FROM pg_stats
WHERE tablename = 'customers' AND attname = 'signup_date'
LIMIT 8;
 bucket_bound
--------------
 2018-01-01
 2018-03-01
 2018-04-28
 2018-07-04
 2018-09-05
 2018-10-28
 2018-12-27
 2019-02-14
(8 rows)

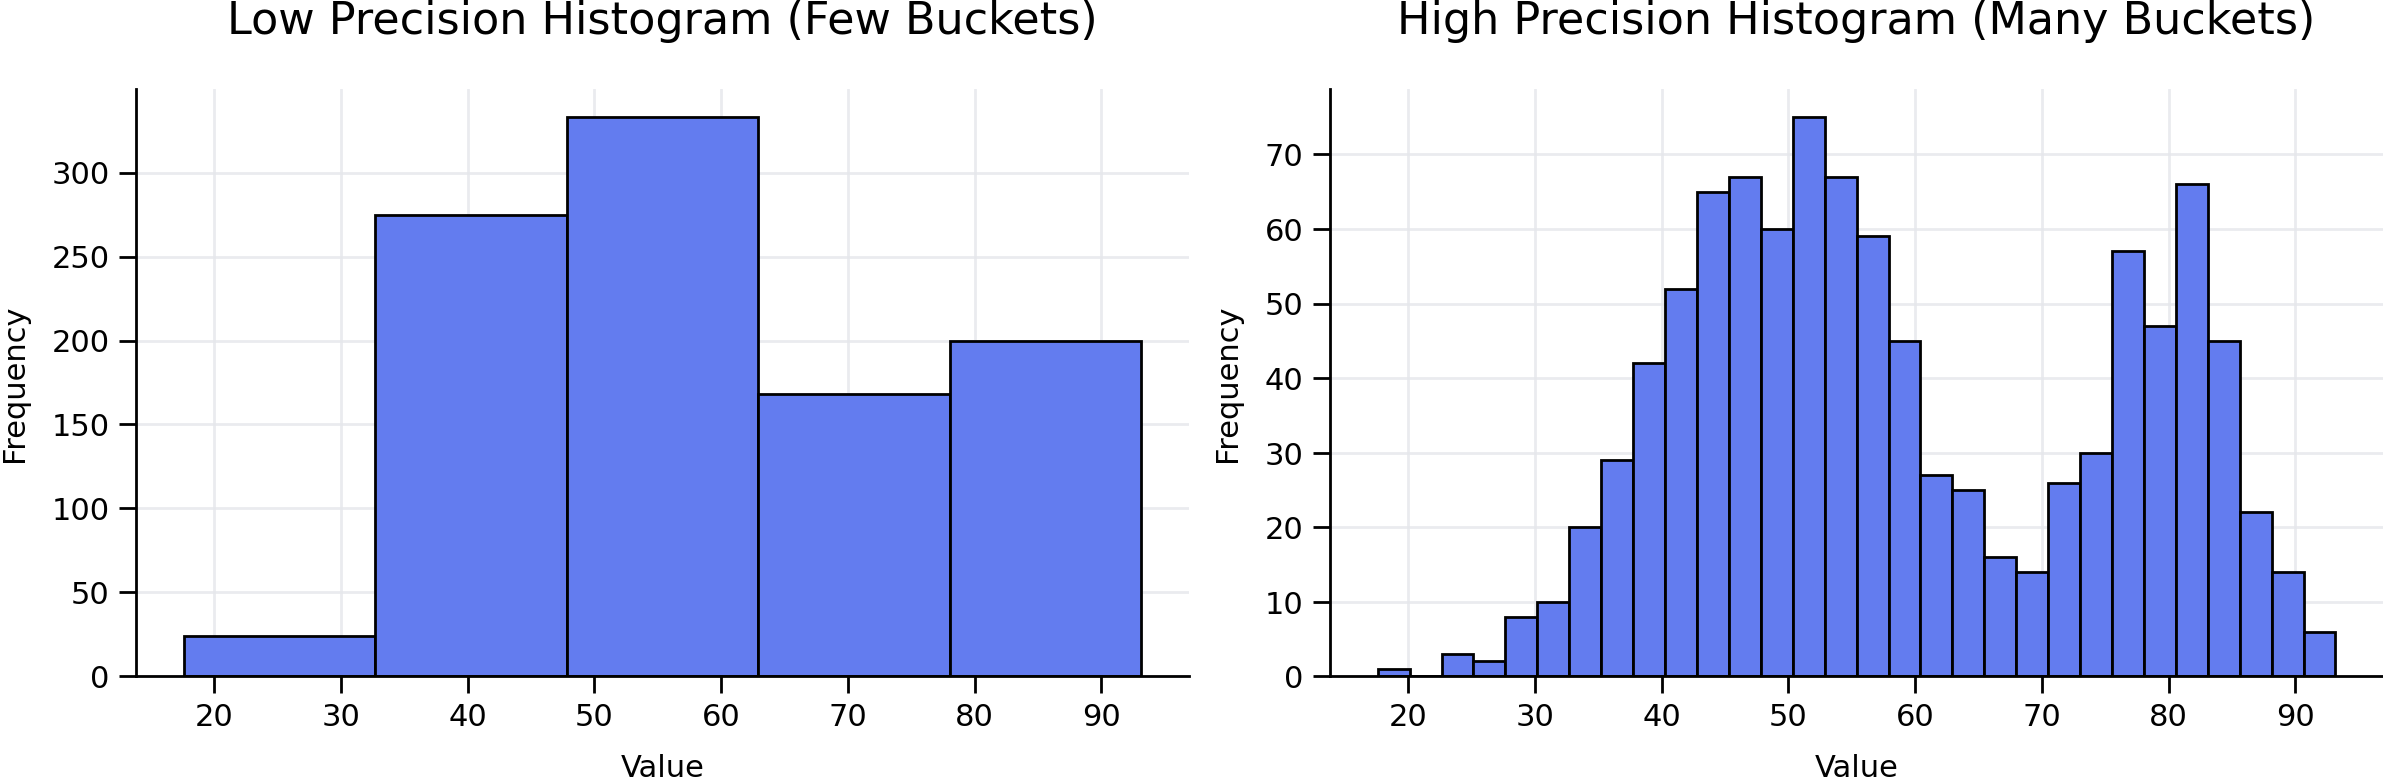
默认直方图桶的粒度覆盖约两个月数据,可满足常规查询估算需求。对于时间、数值分布倾斜的大表,增加直方图桶数量可大幅提升范围查询的行数估算精度。
histogram_precision_comparison.png

直方图精度直接影响规划器判定效果:低精度桶仅能判断数据大致分布区间,高精度桶可精准识别数据峰值、谷值及细分分布规律,为精细化范围查询的计划选择提供精准依据。

支持自定义单字段统计精度、增加直方图桶数量:

ALTER TABLE customers
    ALTER COLUMN signup_date SET STATISTICS 1000;
ANALYZE customers;

调整精度并重新采集统计数据后,signup_date 字段的直方图桶粒度缩短至约两天,数据分布识别精度大幅提升:

bucket_bound
--------------
 2018-01-01
 2018-01-03
 2018-01-05
 2018-01-07
 2018-01-10
 2018-01-12
 2018-01-14
 2018-01-16
(8 rows)

精度与性能需平衡取舍:直方图桶数量越多,估算精度越高,但会增加 ANALYZE 计算开销与 SQL 规划开销。不建议修改全局默认统计精度,仅针对估算异常的业务字段做定向优化。

字段关联统计

单字段统计可满足绝大多数单条件查询场景,多字段联合筛选场景下,规划器默认的字段独立统计逻辑会产生严重估算偏差。

执行 city 与 state 双字段联合筛选查询:

EXPLAIN ANALYZE
SELECT * FROM customers
WHERE city = 'Cheyenne' AND state = 'WY';

-- Index Scan on customers  (cost=... rows=8 width=...)
--                          (actual rows=4012)

规划器估算返回 8 行数据,实际查询结果为 4012 行,估算偏差达 500 倍。

问题核心在于,规划器默认所有字段统计相互独立,通过多字段独立概率的乘积计算匹配数据量:

[P(\text{city} = \text{Cheyenne} ;\wedge; \text{state} = \text{WY}) = P(\text{city}) \times P(\text{state})]

实际业务数据中,city 与 state 字段存在强关联关系,city = 'Cheyenne' 绝大多数隶属于 state = 'WY' 。默认的独立统计逻辑无法识别该关联特征,最终导致严重估算偏差。

Postgres 10 及以上版本支持自定义扩展统计,用于识别字段关联关系:

CREATE STATISTICS customers_city_state (dependencies, ndistinct)
ON city, state FROM customers;

ANALYZE customers;

dependencies 与 ndistinct 参数分别用于采集字段间关联关系、唯一值关联信息。重新执行 ANALYZE 更新统计数据后,查询计划估算精度大幅优化:

EXPLAIN ANALYZE
SELECT * FROM customers
WHERE city = 'Cheyenne' AND state = 'WY';

-- Index Scan on customers  (cost=... rows=4087 width=...)
--                          (actual rows=4012)

优化后估算行数 4087 与实际行数 4012 基本吻合。精准的底层行数估算,可避免上层关联、聚合逻辑产生连锁错误。底层统计偏差会在多层执行计划中持续放大,最终导致复杂查询整体性能劣化。

注意:扩展统计会轻微增加 ANALYZE 执行开销与查询规划开销,仅建议为确认存在字段关联、且存在估算偏差的字段组合创建扩展统计。

查询性能快速排查清单

当出现异常执行计划、查询效率低下问题时,可按照以下固定流程排查优化:

  1. 对比 EXPLAIN ANALYZE 执行计划中的估算行数与实际行数,定位偏差最深的执行节点,该节点通常为计划异常的根源。
  2. 查询目标字段的 pg_stats 统计指标,校验 n_distinct 唯一值数量、高频值列表是否贴合实际数据特征。
  3. 大批量数据载入、数据迁移、分区切换后,统计数据易过期,需手动执行 ANALYZE 更新实时统计(自动真空机制无法及时感知瞬时大批量数据变更)。
  4. 单字段查询存在估算误差时,调高字段统计采集精度,重新执行 ANALYZE 刷新统计数据,提升数据分布识别准确度。
  5. 多字段联合查询因字段关联导致估算异常时,为对应字段组合创建扩展统计,优化跨字段统计精度。
  6. 彻底排查并修复统计异常问题后,再考虑优化 SQL 语句或采用其他调优方案。

总结

Postgres 查询规划器具备优秀的自动优化能力,但所有执行决策均依托系统统计数据,而非真实数据表数据。执行计划的精准度,完全取决于pg_stats 统计信息的质量。

pg_stats 是洞悉规划器数据判定逻辑的核心窗口,绝大多数异常执行计划、SQL 性能问题,均源于统计数据与实际业务数据的偏差。

遇到不符合预期的 EXPLAIN ANALYZE 执行结果时,需优先排查优化 pg_stats统计问题,而非强行修改计划参数、盲目重写 SQL。

查询规划器的智能程度,完全取决于输入的统计数据质量。

作者:Richard Yen

原文链接:

https://richyen.com/postgres/2026/06/22/pg_stats_how_postgres_internal_stats_work.html

【PostgreSQL】PostgreSQL 15移除了Stats Collector PostgreSQL跟踪每个进程的所有活动以获得累积统计信息,例如扫描表或索引的次数,或者最后一次vacuum或autovacuum在表上运行的时间,或者autovacuum在表上运行的次数等。因此,我们不需要pg_stat_tmp目录,该目录是在数据目录(或其他位置)中,在该目录生成和读取所有统计文件。由于会话的每个后端都是PostgreSQL中的一个单独进程,因此收集统计信息并传输并不是一件容易的事。在许多系统上,它将是数据目录中的pg_stat_tmp。通常,如果是crash了,统计信息就丢失了。.. 阅读详情

相关推荐

【0215】stats collector(统计信息收集器)工作原理之资源初始化(1)

最终于stats collector相关的文章数量不少于六篇。本文的重点是详细讲解stats collector进程的资源初始化过程,初始化了哪些资源?完成stats collector进程的相关资源初始化,也是本文即将讲解、分享的函数功能实现。创建统计信息收集器进程所需的资源。函数将fork() stats collector 进程,并启动其相关服务。进程的作用,接下来将结合源码方式,详细讲解PG数据库内核中是如何完成。头文件声明了相关的函数接口、数据类型、全局变量定义等。进程的资源初始化过程。

Postgres 数据库内核开发工程师 891

PostgreSQL系统表 pg_stats

pg_stats是由pg_statistic系统表扩展而来的系统视图,记录的是每个表每个字段的统计信息,用于PostgreSQL优化器做执行计划选择的时候提供参考。 名字 类型 引用 描述 schemaname name pg_namespace.nspname 包含此表的模式名字 tablename name pg_class.relname 表的名字

luojinbai的专栏 8228

恶意代码实验3:Word宏病毒实验

只要下次打开这个word文档,就会执行以上代码,并将自身复制到Normal.dot(word文档的公共模板)和当前文档的ThisDocument中,同时改变函数名(模板中为Document_Close,当前文档为Document_Open),此时所有的word文档打开和关闭时,都将运行以上的病毒代码,可以加入适当的恶意代码,影响word的正常使用,本例中只是简单的跳出一个提示框。回答不正确三次,即可自动跳出病毒程序,但那时已经出现几十个文档。1、打开的宏编辑器如图所示,即可编写病毒代码。

qq_63949327的博客 6506

PgHero Query Stats 完整指南:基于 pg_stat_statements 的查询统计采集、安装与故障排查

PgHero 的 Query Stats(查询统计)功能建立在 PostgreSQL 官方扩展 `pg_stat_statements` 之上,用于采集数据库中每条 SQL 的执行次数、总耗时、平均耗时等核心性能指标,从而支撑 PgHero 仪表盘的慢查询、高频查询与索引建议分析。本文以 [guides/Query-Stats.md](https://link.gitcode.com/i/5f21

gitblog_00365的博客 859

Ubuntu20.04实时内核补丁PREEMPT_RT编译与安装全流程解析

本文详细解析了在Ubuntu20.04系统上编译与安装实时内核补丁PREEMPT_RT的全流程。从内核与补丁版本匹配、编译环境准备,到内核配置、编译排错,再到最终安装、验证与进阶优化,提供了手把手的实战指南,旨在帮助机器人、工业控制等对实时性有苛刻要求的开发者构建低延迟、高确定性的Linux系统。

weixin_29213827的博客 188

麒麟V10桌面操作系统安装Qt5.12.3

在虚拟机中如何安装麒麟V10桌面系统,以及在麒麟系统中安装Qt框架,并正常编译运行Qt程序

阿龙的思考 3600

PostgreSQL的扩展pg_dbms_stats

是一个强大的 PostgreSQL 扩展,提供了类似于 OracleDBMS_STATS的功能。通过使用,数据库管理员可以更好地管理和优化数据库的统计信息,进而提升查询性能。通过收集、导出、导入和删除统计信息功能,管理员可以更灵活地控制数据库的优化行为。然而,在使用过程中需要注意权限管理、性能开销和存储空间等问题,确保系统运行的可靠性和效率。

文牧之的博客 1099

STK轨道仿真环境搭建实战:从地月系到多天体场景

本文详细介绍了STK轨道仿真环境搭建的实战指南,从基础的地月系统到复杂的多天体场景。通过逐步操作说明和实用技巧,帮助用户快速掌握STK软件的使用方法,提升轨道仿真效率,适用于航天任务设计和教学演示。

weixin_30312563的博客 399

Postgres统计信息的配置和校准

pg_class中统计有每个表和索引中含有的总记录数量——reltuples字段,以及每个表和索引对象在磁盘中占用的数据块数量——relpages字段。(5 rows)relkind表示对象类型,r表示表,i表示索引。出于效率考虑,reltuples和relpages字段并不会实时更新,会有一定的延迟。VACUUM(包括auto acuum后台任务)和ANALYZE操作可以更新表的统计信息。

snowyar的专栏 1216

华为OD机试 - 末世分配资源包 - 二分查找 + 贪心(Python/JS/C/C++ 新系统 100分)

本专栏收录于《华为OD机试真题(Python/JS/C/C++)》。刷的越多,抽中的概率越大,私信哪吒,备注华为OD,加入华为OD刷题交流群,每一题都有详细的答题思路、详细的代码注释、3个测试用例、为什么这道题采用XX算法、XX算法的适用场景,发现新题目,随时更新。末世时代,政府为各地方配资源,现有资源分配表 nums[n],要求按如下规则分配给 k 个营地:在最优平均分配情况下,得到最大团队所获得的资源数4,3,6,9,7 216最佳划分之一:[4,3,6] -> 13 [9,7] -> 16最大

学Java,找哪吒 224

【YOLO11改进 - 注意力机制】SCSA通过结合空间注意力和通道注意力,提高各种下游视觉任务的性能。

【YOLO11改进 - 注意力机制】SCSA通过结合空间注意力和通道注意力,提高各种下游视觉任务的性能。

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 477

[译]Postgres15-新特性-利用pg_walinspect对WAL事件进行debug

利用pg_walinspect对WAL事件进行debugWrite Ahead Log即WAL是Postgres的核心部件,存储着写操作,帮助实现其事务的原子性、一致性和持久性。因为是二进制格式存储,如果需要调试写入活动,不借助工具仅靠肉眼很难读取。幸运的是,从9.3版本开始出现了“人类可读”的格式显示WAL记录的工具pg_xlogdump/pg_waldump。该工具可解析WAL日志,解读出人们...

帅的数说 558

AE-扭曲-变形-弧

一些AE效果的着色器实现记录

What_can_you_do的博客 1176

pg中多值列_PostgreSQL 快速返回表上某列的唯一值(枚举值) - pg_stats.most_common_vals-阿里云开发者社区...

标签PostgreSQL , 统计信息 , 唯一值 , 枚举值背景PostgreSQL的列统计信息中包含一项高频词,同时包含一项唯一值个数。pg_stats.n_distinctpg_stats.most_common_vals同时PostgreSQL允许用户自定义统计信息柱状图BUCKET的个数。alter table ALTER [ COLUMN ] column_name SET S...

weixin_39756445的博客 413

PDF格式分析(一)简介

概述 PDF文件是一种编程形式的文档格式,它所有显示的内容,都是通过相应的操作符进行绘制的。 PDF基本显示单元包括:文字,图片,矢量图,图片 PDF扩展单元包括:水印,电子署名,注释,表单,多媒体,3D PDF动作单元:书签,超链接(初学者可以简单这么理解,对于研究比较深入的人员来说,拥有动作的单元有很多个,包括电子署名,多媒体,3D等等) 优势 一致性: 在所有可以打开PDF的机...

steve_cui的博客 2万+

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

PostgreSQL 15 stats collector 在取消后是如何实现的原有功能的

开头还是介绍一下群,如果感兴趣polardb ,mongodb ,mysql ,postgresql ,redis 等有问题,有需求都可以加群群内有各大数据库行业大咖,CTO,可以解决你的问题。加群请联系 liuaustin3 ,在新加的朋友会分到2群。在POSTGRESQL 15 有一个重要的功能去掉了stats collector 在说为什么去掉这个stats collector 的问题前,我...

sql server的专栏 319

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

PostgreSQL 16性能监控利器pg_stat_io详解

数据库性能监控是优化系统效率的关键环节,其核心在于精准捕获I/O操作指标。PostgreSQL 16引入的pg_stat_io视图通过原生统计功能,实现了从操作系统层到数据库层的监控闭环。该视图以微秒级精度记录读写次数、传输字节等核心指标,并按照表I/O、WAL等上下文分类,为诊断热点表、写入瓶颈等典型性能问题提供数据支撑。结合pg_stat_statements等扩展,开发者可以快速定位慢查询的I/O瓶颈,并通过调整checkpoint_timeout等参数实现存储层优化。在数据库监控领域,这种开箱即用的

weixin_34268843的博客 412

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

PostgreSQL运维利器:pg_enterprise_views 核心功能与实战指南

在数据库管理与运维领域,性能监控与诊断是保障系统稳定高效运行的核心环节。PostgreSQL 作为主流开源关系型数据库,其内置的系统视图提供了丰富的运行时信息,但原始数据分散、关联复杂,增加了运维人员的认知负担。通过数据整合与语义封装的技术原理,可以将这些底层信息转化为直观、可操作的监控指标,从而显著提升诊断效率与运维体验。这种技术价值在高并发、大数据量的生产环境中尤为突出,能够帮助 DBA 快速定位锁等待、慢查询、IO 热点等常见性能瓶颈。pg_enterprise_views 正是基于这一理念构建的开源

weixin_34342207的博客 371

pgrust 监控指南:pg_stat_statements 与性能观测实战

数据库跑得再快,如果不知道瓶颈在哪里,性能优化就无从下手。pgrust 作为一款用 Rust 重写 PostgreSQL 的开源数据库,在基准测试中展现出超越原生 Postgres 甚至 ClickHouse 的惊人性能,而要让这份性能红利真正落地,一套可靠的可观测手段必不可少。这篇 pgrust 监控指南,将带你从零上手 pg_stat_statements,掌握 SQL 级性能观测的核心方法,

gitblog_00789的博客 1079

PgHero 建议索引(Suggested Indexes)算法详解:从慢查询自动生成 PostgreSQL 最优索引

PgHero 的“建议索引(Suggested Indexes)”功能可以从 `pg_stat_statements` 中最耗时的查询出发,解析查询结构、读取 PostgreSQL 列统计,并最终产出一份可直接执行的 `CREATE INDEX CONCURRENTLY` 建议清单。本指南以项目官方文档 [guides/Suggested-Indexes.md](https://link.gitc

gitblog_00489的博客 350

PgHero 版本演进全解析:从 0.0.1 到 4.0 的 Postgres 性能监控功能全景

本文基于 PgHero 仓库的 [CHANGELOG.md](https://link.gitcode.com/i/c30f3d23dbedd205f107e4a6457cd8ca) 完整梳理该项目从 2014 年首个发布(0.0.1)到 2026 年 4.0.x 系列的全部版本轨迹,结合 [lib/pghero/methods/](https://link.gitcode.com/i/6c148

gitblog_00556的博客 426

postgresql存储过程问题(关于变量表名)_PostgreSql 数据库统计信息 why when what

以下文章来源于AustinDatabases ,作者carol11统计信息,没有数据是没有的,但统计信息怎么收集,标准是什么,怎么使用,就值得去看看了。要说统计信息,首先说一个表 pg_statistic ,这个表本身是存储数据库的状态信息,其中信息通过analyze 命令来获得,并存在在这个表里面,并且这个表被用于查询计划中。既然是统计,那就造成这个表里面的存储的值并不是当时当刻最准确的情况,而...

weixin_39745013的博客 1145

PostgreSQL跨库查询实战:postgres_fdw与dblink方案对比与性能调优

在分布式系统与微服务架构中,数据常分散于不同数据库,形成数据孤岛。跨库查询技术通过逻辑关联物理隔离的数据源,实现统一数据视图,其核心价值在于提升数据分析效率、支持实时业务决策,并减少复杂ETL流程。实现原理上,数据库通过外部数据包装器或连接函数建立远程映射,将查询操作下推至源端执行,仅传输必要结果集,从而优化网络与计算资源。PostgreSQL生态中,postgres_fdw扩展支持声明式外部表创建与智能谓词下推,是处理常规跨库联查的首选方案;而dblink模块则提供更灵活的临时查询与数据同步能力。在电商、

weixin_34354173的博客 582

PostgreSQL模式管理完全指南:django-postgres-extra多租户架构实现

在现代Web应用开发中,多租户架构已成为处理大量用户数据隔离的关键方案。**django-postgres-extra**作为PostgreSQL增强工具,为Django开发者提供了强大的模式(Schema)管理能力,使多租户系统的实现变得简单高效。本文将详细介绍如何利用该工具构建安全、可扩展的多租户应用,从基础概念到实战操作,帮助开发者快速掌握PostgreSQL模式管理的核心技巧。 ## 一

gitblog_00376的博客 445

PostgreSQL的stats collector进程

在 PostgreSQL 数据库中,进程(统计信息收集器进程)是一个重要的后台进程,负责收集和报告数据库操作的统计信息。这些统计信息对于查询优化和性能监控至关重要。

文牧之的博客 861

PgHero 本地开发环境搭建与贡献指南:参与 PostgreSQL 性能仪表盘开源项目的完整路径

> 本文面向希望为 PgHero 贡献代码、调试其源码或深入理解其工作原理的开发者,基于仓库中 [guides/Contributing.md](https://link.gitcode.com/i/efc97adefeaef4e4c614c64918463092) 的官方开发指引展开,并结合本仓库的生成器、Rake 任务与配置模板源码,完整还原从克隆代码、准备开发数据库、生成统计表结构到启动本地

gitblog_00239的博客 1075
上一篇: Postgres_fdw 优化实战:GUC 参数控制 Join Pushdown
下一篇: PG 日报|大版本升级迎来更新,支持迁移提交时间戳目录
IvorySQL
博客等级 码龄5年 745粉丝 565原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值