极简主义者的PostgreSQL AI指南

基于MCP协议实现AI自然语言查询PostgreSQL数据库的实践指南 自然语言处理(NLP)技术正逐步改变人机交互方式,其核心原理是通过机器学习模型理解人类语言意图并转化为机器可执行的指令。在数据库查询领域,这一技术价值在于大幅降低数据访问门槛,使非技术用户也能通过自然语言直接获取所需信息。应用场景广泛覆盖数据分析、业务监控和开发调试等环节。本文聚焦PostgreSQL数据库,探讨如何利用Model Context Protocol(MCP)这一新兴开放协议,构建安全可靠的AI自然语言查询接口。通过PGMCP项目的实践,展示了如何实现Schema智能理解、SQL安全审查和流式 阅读详情

本文整理自 IvorySQL 2025 生态大会暨 PostgreSQL 高峰论坛的演讲分享,演讲嘉宾:Florents Tselai。

引言

从 SQL 到 AI,从数据库操作到大模型推理,技术在不断进化。本文将探讨如何在保持稳定性的前提下,利用 SQL 与 AI 接口实现高效、可靠的数据处理。

关于作者

Florents Tselai 拥有数据分析与数据工程背景,早年就读于商学院,随后逐步转向数据工程领域,专注于 PostgreSQL 扩展开发与 AI 数据处理。

曾为欧洲及美国多家企业提供数据咨询服务,目前担任 希腊政府 AI 孵化计划的技术顾问。其研究方向涵盖 PostgreSQL 可扩展性、ETL 工具设计与 AI 数据接口优化。

代表作品:

  • PostgreSQL 扩展
  • 统计类:pgxicor, vasco
  • ETL 工具:pgPDE, pgJQ

创新项目:

  • spat:让 PostgreSQL 像 Redis 一样使用共享内存的高性能存储扩展
  • pghaicker:基于 AI 的 pgsql-hackers 邮件摘要工具

背景:从复杂中回归极简

极简主义 = 经验 + 麻烦。

复杂的运维流程与多系统环境常使开发过程面临协作障碍与效率损耗。长期的项目实践与问题积累,逐渐催生出一种“极简主义”技术理念——在复杂中求简,以最少且最可靠的工具应对最多的场景。

SQL、Bash 与 Python 成为跨环境开发的核心支撑,体现了高稳定性、高效率与强可移植性的技术哲学。

接口的演进:从 SQL 到 AI

在软件开发与数据分析中,接口(Interface)是核心概念。

SQL:可靠的数据接口

SQL 是数据操作中最稳定、最可靠的核心工具,自 1970 年代以来,它通过标准化方式将人类需求转化为数据库执行计划,实现从查询到报表的完整流程。

SQL 的接口特性:

  • 描述“想要什么”,而非“如何实现”。
  • 数据表提供直观可视化表示。
  • 标准化操作(尽力而为)。
  • 从查询到报表完整流程。
  • 隐藏底层复杂性。
  • EXPLAIN PLAN 提供有限洞察。

AI:自然语言与推理的新接口

AI 接口是 SQL 接口理念的延伸与升级。与 SQL 类似,AI 将人类意图转化为可执行操作,但能够理解自然语言,进一步降低操作门槛。

AI 的接口特性:

  • 理解自然语言描述:可生成查询或执行计划,实现直观的人机交互。
  • 执行与智能推理:除了生成执行计划,还可处理复杂数据和逻辑推理。
  • 延续 SQL 接口哲学:只需描述需求,系统负责实现,但方式更自然、更智能。

从 SQL 到 AI,这一演进体现了接口的核心理念:让人类与系统交互更直观、高效,同时隐藏底层复杂性。AI 接口不仅延伸了 SQL 的能力,也为未来的数据分析与应用开发提供了新的可能。

核心转变:从执行计划到推理计划

在高级用户操作 AI 的实践中,可以观察到执行计划与推理计划的一一对应关系。用户通过一个提示词得到结果,再将结果组合或优化,这本质上是在编排推理逻辑,而不仅是执行操作。这些结果可以作为缓冲或中间状态,实现更高效的任务管理。

现状批判:LLM 框架的陷阱

复杂的生态与过度抽象

  • 对普通用户而言,AI 操作像魔法,简化了复杂任务。
  • 对数据工程师或开发者而言,部署和操作仍然复杂,需要理解系统底层逻辑。

这一差异反映了用户体验的便利性与开发者实际操作复杂性之间的落差。

当前大模型生态尚未稳定,技术迭代速度过快,主要表现为:

  • 行业仍缺乏统一标准与稳定范式。
  • 经验方法更新频率高,难以长期复用。
  • HOW-TO 类资料常因工具与版本更新而被替代。
  • 各模型都声称性能领先,但实际效果依赖具体场景。
  • 不同 LLM 框架试图定义自己的标准路径,却往往引入更高的复杂度和学习成本。

历史的押韵:LLM Frameworks = ORMs

LLM 框架类似 80 年代的 ORM(对象关系映射):

  • ORM 虽提供了 SQL 的抽象封装,但底层执行原理仍需掌握。
  • LLM 框架提供抽象化接口,但早期依赖可能掩盖底层逻辑。
  • 当前框架过度封装、复杂化流程,使开发者容易迷失。

LLM 框架虽便利,但存在显著问题:

  • 过度自信与复杂化 —— 框架自认为万能,却增加不必要的复杂性;
  • 死板抽象 —— 多层封装让问题难以理解;
  • Java 式设计泛化 —— 流程被强制框架化,增加学习成本;
  • “想要香蕉?先建宇宙” —— 为完成简单任务,需要经历冗长复杂步骤;
  • 强制流程 —— 框架规定操作步骤,限制灵活性;
  • 阻碍学习 —— 用户依赖框架而非理解底层逻辑;
  • 产生挫败感 —— 框架让用户觉得无法掌控,体验不佳。

整体结论:LLM 框架目前仍是辅助工具,开发者不应盲目依赖,应理解底层原理并培养核心技能。

SQL 依然是最稳定的答案

面对快速发展的 AI 技术生态,开发者常常需要寻找稳定可靠的解决方案。尽管出现了各种新兴工具和框架,SQL 依然被证明是数据访问和处理的核心接口。

SQL 自诞生以来数十年,始终保持其核心价值。尽管有人宣称 SQL 已过时,每隔十年总有新论断出现,但 SQL 的基础地位从未动摇,其声明式语法和标准化特性使其在复杂系统中长期可靠。

SQL 不仅仅是查询语言,更可以视作系统的编排者。在处理复杂数据流程时,SQL 能将不同任务和操作整合为清晰的执行计划,从而简化系统协调和资源管理的复杂性。

在 AI 应用中,模型的推理流程与 SQL 的执行计划存在对应关系。通过 SQL 的结构化操作,可以对 AI 推理过程进行有效映射与管理,使数据处理和推理逻辑保持一致性。

回归本质:AI 即相似度搜索

当前大模型(LLM)及各类 AI 应用,从底层机制来看,核心都可以归结为“相似度搜索”。其基本流程是:

  1. 将输入文本切分成 tokens;
  2. 通过向量化模型生成向量表达;
  3. 存储的数据向量进行相似度比对,
  4. 最终根据得分返回结果。

这一过程并不神秘,模型能力的差异主要取决于数据规模与训练质量。

在实际应用中,系统会在数据库内存储多种信息片段,并不断围绕“向量—相似度—检索”循环工作。从业务角度看,AI 的执行流程更像是“声明—比对—迭代”的模式:给定输入,不断检索最接近语义结果,再多轮迭代优化。

核心机制

当前 AI 技术生态中最常见的术语如 tokens、vectors、documents,均围绕相似度检索机制展开。

  • tokens:文本最小单元
  • vectors:语义向量表示
  • documents:文档或数据片段

Postgres 早已具备的能力

尽管今天的向量检索听起来前沿,但对于数据库从业者而言,这一思想并非全新。PostgreSQL 在十余年前就已经通过全文检索(Full Text Search)实现了类似能力。例如:

SELECT 'a fat cat sat on a mat'::tsvector @@ 'cat & rat'::tsquery;

全文检索的流程同样依赖文本分词、构建词典、生成向量化表示,并在查询时根据词项匹配进行判定。不同之处仅在于:

  • 过去依赖的是本地语料构建的词典与向量;
  • 现在依托的是规模更大的语言模型语料与向量空间。

从技术原理上看,这两者在语义表达与匹配流程上的一致性非常明显。因此,LLM 并不是完全改变数据库世界的“新物种”,而是将“相似度检索”做到规模更大、语义更丰富、泛化能力更强。

AI 实战:上下文即一切

多层封装的体系结构

现代 AI 应用普遍构建在大模型框架之上,外层工具与平台不断叠加新的包装与接口,形成“套娃式”的技术结构。绝大多数产品并非从零实现,而是围绕底层模型进行 API 封装、功能抽象与产品化组合。

底层核心:llama.cpp

在这些封装层的最底部,llama.cpp 等核心实现承担模型推理的基础执行职责。其高性能、轻量化与良好兼容性,使其成为大量应用的实际运行基础。围绕相关代码库,社区生态与开源许可问题也构成技术讨论的重点。

上下文的重要性

在实际使用中,影响模型效果的关键因素依然是上下文处理能力。上下文长度决定了模型能够加载的数据量,也直接影响推理结果的完整性与连续性。在早期上下文窗口有限的阶段,复杂的数据裁剪与拼接流程不可避免;而随着上下文上限不断提升,数据组织方式与调用策略也随之调整。

构建提示词 = 数据连接的艺术

在大模型应用中,上下文构建已成为决定模型效果的核心环节。模型能够输出高质量结果的前提,是输入数据经过精确筛选、裁剪与组织。实际业务中,这一过程本质上是数据 Join 的组合工程。

在客户服务、电商等常见场景中,约 80% 的工作是从数据库中挑选关键字段,包括商品描述、用户属性、业务要点等,并剔除无关内容。通过将这些信息压缩为清晰的文本表示后,即可形成模型的输入上下文。该过程强调数据组织能力,而非复杂算法。

基于字符串的模板化构建方式

上下文的构建主要依赖字符串拼接与模板化处理。SQL 的格式化函数、标准的字符串模板引擎等工具即可完成大部分处理需求。相比构建复杂脚本或 Notebook 环境,这种方式更直接、更高效,并满足绝大多数生产实践场景。

将复杂度交给模型处理

在设计提示词或业务流时,不必在应用层堆叠大量逻辑判断或格式规约。大模型具备强大的推理与补全能力,适合承担复杂推断工作。应用层应主要聚焦于准备精简、准确的输入数据,将复杂度交由模型处理,从而提升系统整体效率与可维护性。

Everything in PostgreSQL:减少链路

通过 PostgreSQL 的扩展生态,可以将多种形态的数据处理直接集成到数据库内部,从而减少跨系统的数据搬运、降低额外的同步压力,并提升整体系统稳定性。

解析 PDF:非结构化数据提取

借助 pgPDF 扩展,PostgreSQL 能够直接读取本地或远端 PDF 文件并将其解析为文本。示例如下:

github.com/Florents-Tselai/pgPDF

CREATE EXTENSION pgpdf;

SELECT '/path/to/my.pdf'::pdf;

执行 HTTP 请求:获取外部数据

利用 http 扩展,可以在 PostgreSQL 内直接发起 API 请求,例如:

CREATE EXTENSION http;

SELECT http_post('http://myprovider');

这一能力使数据库能够直接完成部分外部数据的获取流程,从而减少应用端的多次 I/O 往返,降低数据链路的复杂性。需要注意的是,HTTP 请求存在阻塞和失败的可能,因此更适合在非核心业务节点或离线库中使用。

将文本解析、外部 API 请求等操作整合到数据库内部,可以减少:

  • 数据在系统间传输带来的延迟
  • 应用层的额外逻辑与依赖
  • 由于链路增长导致的失败点

从而提升整个数据链路的可靠性与可维护性。

Unix 哲学在现代数据处理中的价值

Unix Philosophy

Unix 哲学强调以最小单元构建工具,通过清晰的接口协同完成复杂任务。这一思想在当下依然具有实践意义,特别是在数据密集型场景中。

“Do One Thing Well” 与文本接口

Unix 哲学的核心原则包括:

  • 工具专注于单一功能
  • 文本作为通用接口

在 LLM 与数据库协作的场景中,文本仍然是最稳定、最易组合的接口形式。这也使得传统工具链在新的技术背景下依然适用。

管道化的工具组合

遵循 Unix 的方式,小工具之间通过管道组合,能够以极低的复杂度完成高效的数据处理流程。

常见工具组合方式

在实际工程中,以下工具链可以覆盖大量数据拉取、处理与写入场景:

  • curl:用于获取本地或远程 API 数据
  • jq:处理 JSON 结构
  • xargs(含并行执行):用于批量或并行处理
  • psql:直接与 PostgreSQL 交互

这些工具组合后,可以在极少代码量的前提下实现高效的流水线式处理。

示例:真实项目示例

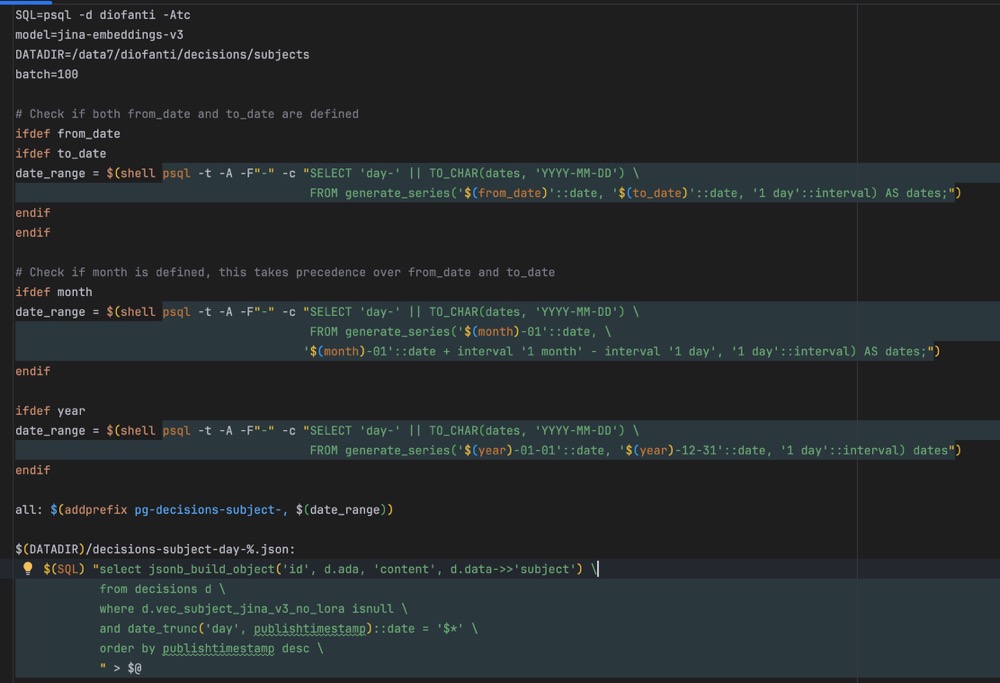
以下示例来自实际项目,通过 Makefile 驱动整套数据处理流程:

  1. 生成时间区间;
  2. 拉取与分组数据;
  3. 构建 JSON 数据;
  4. 向量化处理(如使用某 embedding 模型);
  5. 将结果写回 PostgreSQL。

1.jpg

整个流程以 JSON 作为中间格式,以 PostgreSQL 作为状态与结果的统一存储,避免了额外的数据搬移与逻辑分散。

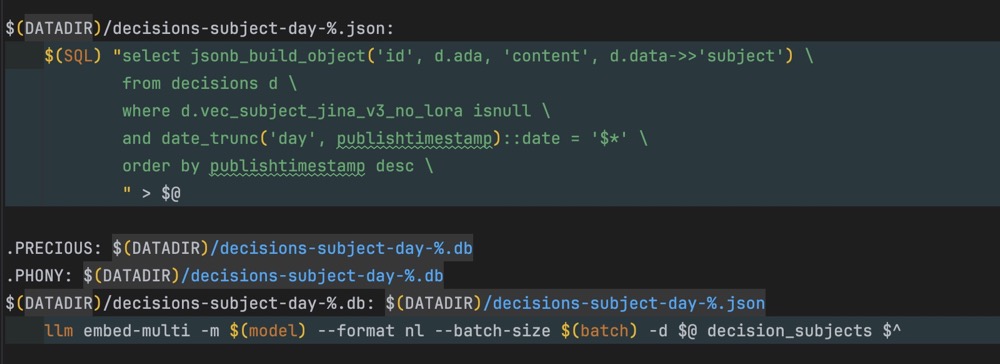
示例:命令行操作 PostgreSQL 实现数据流水线
2.jpg

在实际项目中,通过命令行工具直接操作 PostgreSQL,实现数据处理自动化:

  1. 使用 % 通配符灵活查询数据。
  2. 本地 LLM 对数据进行处理,如生成每日聚合结果。
  3. 为每一天生成独立 PostgreSQL 数据库,将结果写入数据库。
  4. 利用命令行管道直接写回数据库,实现数据流闭环,无需额外搬移。

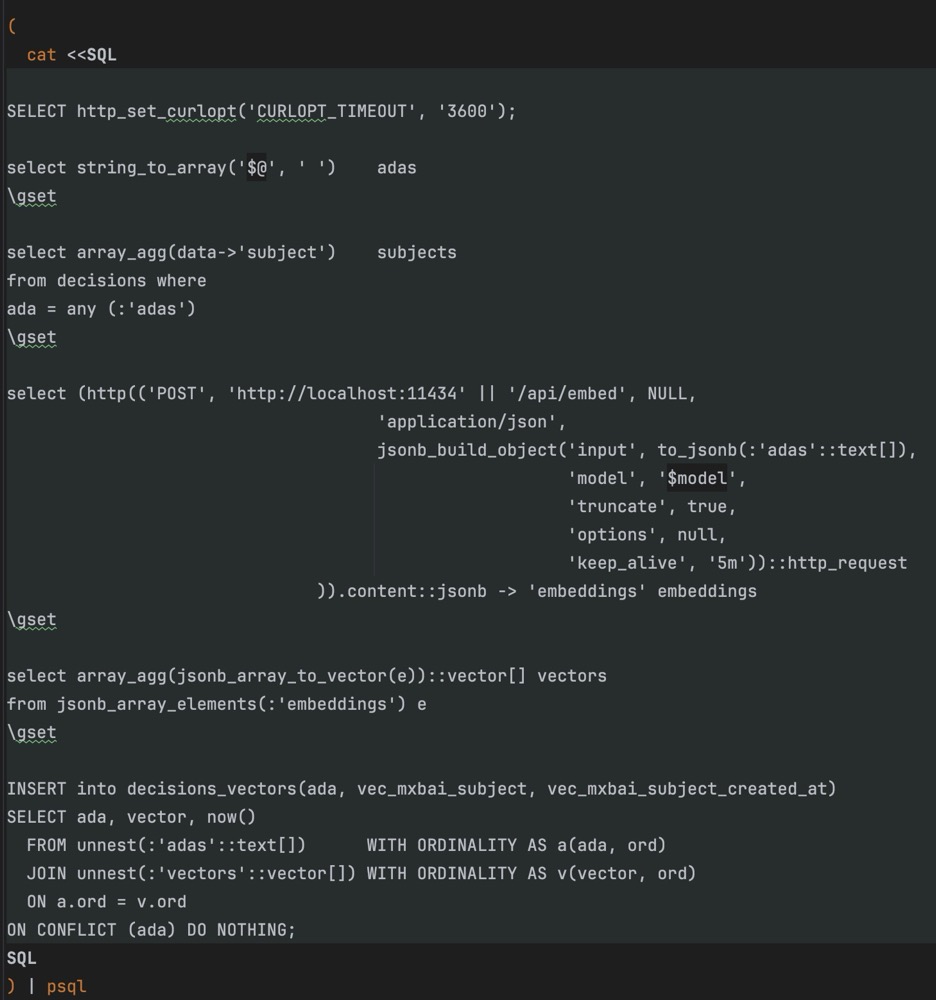
示例:LLM 结合的处理逻辑
3.jpg

本地 LLM 对文本、集合或结构化数据进行处理和聚合,生成有用信息并向量化,结果直接写入 PostgreSQL。利用数据库索引和聚合能力完成优化,实现从数据处理到存储的自动化闭环。

结语

SQL 与 AI 的结合展示了简化复杂、提升效率的价值。理解底层原理并合理运用工具,才能在快速变化的技术生态中保持掌控与高效。

Rust与人工智能(AI)技术 Rust语言凭借其高性能、内存安全和并发特性,正在成为机器学习领域的新选择。文中介绍了多个Rust机器学习框架:类似scikit-learn的Linfa、高性能的Neuronika、HuggingFace开发的Candle以及深度学习框架Burn。这些框架展现了Rust在数据预处理、模型构建和部署方面的优势。文章还探讨了Rust在所有权系统、智能指针等核心特性上的独特设计,以及如何利用这些特性构建安全高效的AI应用。随着生态发展,Rust有望成为AI开发的重要语言,为机器学习领域带来新的技术可能。 阅读详情

相关推荐

AGENTS.md极简起步:随仓库生长的AI编程助手上下文维护指南

在AI辅助编程日益普及的今天,如何让编程助手真正理解项目上下文成为工程效率的关键。AGENTS.md作为面向AI助手的仓库说明文件,其作用类似于人类开发者的项目手册,却常因写法不当沦为无人维护的僵尸文档。本文从上下文管理的基本概念出发,阐述AI助手如何通过文档获取项目结构、命令规范与架构约束,并深入分析极简起步、随仓库生长这一反直觉维护策略的技术价值。针对中小型仓库与快速迭代团队,文章提供了从最小结构到目录级拆分的完整落地路径,涵盖命令沉淀、过期标记、变更记录等工程实践,并给出常见问题排查清单。通过将文档视

weixin_30851867的博客 282

PostgreSQL与AI大模型I:使用 Llama 3.1 和 pgvector 构建 RAG 应用程序

RAG,即检索增强生成[2],是一种将大型语言模型 (LLM) 的功能与外部知识检索相结合的 AI 技术。其理念是解决 LLM 的一个关键限制:无法在训练后访问或更新知识。在 RAG 系统中,当收到查询时,它首先会经过检索步骤。此步骤会搜索知识库以查找相关信息。检索到相关信息后,它会与原始查询一起输入到 LLM 中。这使得模型不仅能够根据其预先训练的知识生成响应,还能根据外部知识库中最新和最相关的信息生成响应。有几种方法可以做到这一点,但目前最常见的技术是使用嵌入[3]。嵌入是知识库中文本的数学表示。

Z4400840的博客 1192

《从0到1:CTFer成长之路》书籍配套题目-[第二章 web进阶]文件上传

[第二章 web进阶]文件上传开始行动绕过第1个限制绕过第2个限制 介绍:记录一下笔记,方便以后迅速回忆使用。 《从0到1:CTFer成长之路》书籍配套题目,来源网站:《从0到1:CTFer成长之路》 先看一下题目源码: <?php header("Content-Type:text/html; charset=utf-8"); // 每5分钟会清除一次目录下上传的文件 require_once('pclzip.lib.php'); if(!$_FILES){ echo '

weixin_46703850的博客 3410

PostgresML - PostgreSQL的生成式AI扩展

摘要涉及创建文档的压缩版本,其中包含重要信息,同时减少其长度。不同的模型可以用于此任务,一些模型从原始文档中提取最相关的文本,而其他模型生成全新的文本,捕捉原始内容的本质。}'::JSONB,你可以通过将 min_length 和 max_length 作为参数传递给 SQL 查询来控制 summary_text 的长度。

新缸中之脑 2105

第二十六届中国机器人及人工智能大赛CRAIC决赛小型桌面级-立体仓储代码分享

国二奖,精度还有不少问题,没有视觉模块,单线程,比起其他大佬写的确实还有欠缺,继续加油吧。

qq_68232259的博客 691

STM32CubeMx+stm32f407+FreeRTOS+LAN8720实现LWIP以太网UDP TCP数据收发功能

单片机实现LWIP的调试

qq_40600203的博客 3068

前端玩Postgres数据库:Ai大法一把梭

小程序名为”这个b班上的值不值”,欢迎网友们来踩。

qq_45472813的博客 1156

完美解决 mysql 报错ERROR 1524 (HY000): Plugin ‘mysql_native_password‘ is not loaded

mysql 报错ERROR 1524 (HY000): Plugin 'mysql_native_password' is not loaded

xiaohua616的博客 4万+

使Postgres为AI应用程序加速:探索Postgres Embedding的向量搜索技巧

Postgres Embedding是一个开源的Postgres扩展,能高效地进行向量相似度搜索。它支持精确和近似最近邻居搜索,并使用HNSW算法进行近似搜索,从而显著提高搜索速度。HNSW算法通过构建一个小的多层级导航世界来实现这一点,使得它在处理高维向量时仍然保持高效。Postgres Embedding为Postgres数据库增添了一项强大的功能,通过向量相似度搜索可以大幅提升AI应用的处理能力。(假设有GitHub仓库)HNSW算法论文。

qq_29929123的博客 532

IC 时钟设计核心问题与高质量系统设计指南(附源码)

本文深入探讨了IC时钟设计的核心问题与高质量系统设计方法。时钟系统作为IC的"心脏",其性能直接影响时序稳定性、功耗效率和可靠性。文章从五个维度展开分析:时钟源选择与性能匹配、时钟分配网络设计、抖动抑制、多时钟域管理和功耗优化。针对高质量时钟系统设计,提出了时钟源优化、时钟树结构优化、干扰抑制与仿真验证等具体方法。同时,系统阐述了时钟与复位的协同设计关系,强调异步复位同步释放等技术的重要性。文章还总结了高质量IC系统设计的综合要点,包括电源/信号完整性、时序功耗平衡、可靠性设计及全流程验

Open 1060

交通仿真软件:SUMO_(13).Python脚本与TraCI接口

通过TraCI接口,用户可以实现与SUMO仿真器的实时交互,获取和控制交通数据。本文档详细介绍了如何使用Python脚本与TraCI接口进行交互,包括基本的设置、数据获取和控制方法。此外,还展示了几个高级应用示例,如交通流优化、多代理系统、车辆路径规划和车辆行为模拟。这些示例可以帮助用户更好地理解如何利用TraCI接口进行复杂的交通仿真和分析。希望这些内容对您有所帮助,如果您有任何问题或需要进一步的帮助,请参考SUMO的官方文档或社区支持。

kkchenjj的博客 992

小白必看:PostgreSQL最简安装指南(附AI助手)

整个过程比看文档自学快很多,特别是遇到错误时,把报错信息粘贴到AI对话框,马上就能得到针对性解决方案,完全不用到处搜索。作为一名刚接触数据库的小白,最近在学习PostgreSQL时踩了不少坑。今天把最简安装流程和常见问题整理成笔记,配合。安装过程其实并不复杂,关键是要有耐心。建议新手边操作边记录,遇到问题随时用。的AI指导功能,希望能帮到同样入门的朋友们。取消勾选不必要的组件(初学者用不到)的AI助手查询,能节省大量排查时间。可视化工具推荐pgAdmin4。

RubyLion28的博客 872

分子动力学仿真软件:LAMMPS_(16).应用案例分析

通过以上四个应用案例,我们详细介绍了如何使用LAMMPS进行不同系统的分子动力学仿真。从简单的液体水仿真到复杂的纳米管仿真,每个案例都包含了详细的步骤说明和代码示例。读者可以通过这些示例实际操作并验证结果,从而更好地理解LAMMPS的功能和使用方法。希望这些案例能够为读者在分子动力学仿真领域的研究和应用提供帮助。

kkchenjj的博客 836

Flowise+Docker极简部署:快速构建企业级AI应用接口

本文介绍了如何在星图GPU平台上自动化部署Flowise镜像,快速构建企业级AI应用接口。通过可视化拖拽方式,用户可零代码搭建RAG工作流,将PDF文档、数据库等内部知识源转化为可调用的REST问答API,广泛应用于智能客服、员工自助支持等典型场景。

weixin_42168902的博客 436

龙芯2K1000 OTG双模驱动深度解析

是Synopsys公司开发的USB 2.0 OTG控制器IP核,龙芯2K1000内置该IP,作为唯一的OTG控制器(PCI Dev4 Func0),物理基地址0x40000000。核心能力:同时支持Host主机模式(接U盘/键盘)、Device设备模式(虚拟串口ttyGS0)、OTG双模自动切换速率驱动路径:内核源码PMON:启用otg0设备树内核:开启HOSTPERIPHERALG_SERIAL启动参数脚本:sysfs角色切换+开机自启Host按以上配置,龙芯2K1000 DWC2 OTG可完美实现。

weixin_44932366的博客 375

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Rowboat:专为AI对话应用设计的极简状态管理引擎

在AI应用开发领域,状态管理是构建复杂、有记忆的对话系统的核心挑战。它涉及会话历史、用户偏好、任务上下文等信息的持久化存储与高效检索。传统方案需要开发者自行设计数据库与CRUD逻辑,不仅开发效率低,还容易在并发与一致性上出错。Rowboat框架正是为解决这一痛点而生,它将状态管理抽象为底层原语,提供高性能的键值存储接口,并自动处理持久化、并发安全与上下文窗口优化。其技术价值在于让开发者能专注于业务逻辑,快速构建具备长期记忆能力的智能体(Agent)和聊天机器人。无论是客服助手、多轮任务向导还是个性化知识库问

weixin_30681615的博客 695

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

极简 MVP 本地环境:一个命令启动必要服务

极简 MVP 的本地环境只启动完成核心任务所需的服务。锁定工具版本、提供样例数据和健康检查后,一条命令就能暴露真正缺失的依赖。

weixin_63764436的博客 4948

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

极狐GitLab 如何管理 PostgreSQL 扩展?

极狐GitLab 如何管理 PostgreSQL 扩展?

GitLab 中国发行版 1263

【教程】用 NocoBase 2.0 搭建一个极简的 IT 工单系统

本教程将带你从零开始,用 NocoBase 2.0 搭建一个极简的 IT 工单系统(HelpDesk)。整个系统只需要 2 张数据表,不写一行代码,即可实现工单提交、分类管理、变更追踪、权限控制和数据仪表盘。

NocoBase 的博客 494

PostgreSQL向量库pgvector实战指南

Entity@Id// OpenAI嵌入向量(1536维)// 原生SQL实现余弦相似度查询@Param("embedding") String embedding, // 向量字符串如"[0.1,0.2,...]"pgvector作为PostgreSQL的向量扩展,为Java开发者提供了一条低门槛集成AI能力的路径。生态复用:直接使用现有PostgreSQL基础设施,无需额外管理向量数据库开发便捷:通过Spring Data、JPA等熟悉的API即可操作向量数据企业级特性。

果果 5240

实战指南:用pgvector在PostgreSQL中搭建AI推荐系统(附Python代码)

本文提供了一份实战指南,详细介绍了如何在PostgreSQL数据库中利用pgvector扩展搭建AI推荐系统。内容涵盖环境部署、数据向量化、向量索引构建及混合查询实现,并附有完整的Python代码示例,帮助开发者高效构建个性化推荐服务。

a3b4c5的博客 1028

每个月钱花哪了?在极空间NAS部署记米粒让AI帮你自动记账分析

记米粒对于想要私有化部署记账工具的用户来说,是一个蛮不错的选择。

panda9955的博客 406

批流一体,从 Lambda 到 Domino|YMatrix 亮相 PGConf.Russia 2026,重构 PostgreSQL 极简实时架构

纵观大会两日的议题,无论是关于 Postgres Pro Shardman 的分布式新进展 ,还是针对 On-prem AI-agent 的落地实践,如何在不依赖复杂“外挂”架构的前提下,利用数据库原生内核提升实时响应能力,已成为社区共同关注的演进方向。通过本次交流,YMatrix 不仅展示了其在内核原生流处理的探索成果,更向国际技术社区证明:基于 PostgreSQL 架构,完全可以构建出满足 AI 和实时分析需求的高性能超融合系统。

weixin_57459958的博客 287

MySQL 和 PostgreSQL 谁更适合AI时代?

以进一步展开其Data+ AI愿景。然而MySQL的源头公司,Monty 的 MySQL AB于2008年1月被Sun公司以10亿美元收购,随后,2009年4月,Oracle公司以74亿美元收购Sun公司,顺理成章的将MySQL纳入囊中。打造的产品特性意外的契合了智能体场景,他们随后专注于面向智能体的开发,几个月内,Neon平台上超过80%的数据库都由AI智能体而非人类创建。只不过 PostgreSQL 领域二次开发的创新产品生态活跃而丰富,MySQL领域的二次开发多少受到了 GPL 开源协议的左右。

Enmotech的博客 1317

PostgreSQL 从参数调优到 AI 诊断的实战指南

本文整理自 IvorySQL 2025 生态大会暨 PostgreSQL 高峰论坛中的演讲,演讲嘉宾:王丁丁,工业互联网数据库专家,PostgreSQL ACE。

IvorySQL的博客 515

如何在5分钟内为PostgreSQL安装pgvector扩展:AI时代的向量搜索终极指南

在人工智能和机器学习飞速发展的今天,向量搜索已成为现代应用的核心技术。无论是智能推荐系统、语义搜索还是图像识别,都需要高效处理高维向量数据。pgvector作为PostgreSQL的开源向量相似度搜索扩展,让您能够将向量数据与关系型数据完美结合,享受PostgreSQL的强大功能同时获得向量搜索能力。本文将为您提供完整的pgvector安装配置指南,让您快速掌握这一AI时代的关键技术。 ## ?

gitblog_00213的博客 355
上一篇: IvorySQL 5.0 发布:基于 PG 18.0,Oracle 兼容、生态组件、云原生与易用性全面进化!
下一篇: 第八届中国PostgreSQL数据库生态大会圆满收官,IvorySQL 荣获产品创新奖
IvorySQL
博客等级 码龄5年 745粉丝 557原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值