person ReID(行人重识别)2018CVPR paper阅读笔记

(Re-ID论文精读)PASS: Part-Aware Self-Supervised Pre-Training for Person Re-Identification 提出问题(挖坑):文章一开始直接表明,现有的reid的backone都是直接在imageNet的数据集进行SSL(此处挖个坑,后面讲什么是ssl)的预训练,而ImageNet,是一个主要是以分类任务的数据集不适合Person reid 领域,因此设计了一个PASS这个网络填坑:这个PASS就是为了解决这个问题的,但是有人问了,那我构造一个关于RE-id的大规模数据集在这个上面预训练就行了呗,还需要其他东西吗。 阅读详情

引言:
最近开始学习Person ReID(行人重识别)有关的内容,于是便读了几篇2018CVPR论文。来记录学习的经历。如果有讲得不到位或者您有什么想要补充的话,欢迎留言哦~


接下里将列举3篇论文:

  1. Pose Transferrable Person Re-Identification
  2. Deep Spatial Feature Reconstruction for Partial Person Re-identification: Alignment-free Approach
  3. Adversarially Occluded Samples for Person Re-identification

使用的数据集介绍

Market1501: It consists
of 12,936 images for training, and each person has
17.2 images on average in the train set.

DukeMTMC-reID: a subset of the DukeMTMC for image-based ReID.
Its train set contains 16522 images of 702 identities.

CUHK03: contains 14,096 images of 1,467 identities which are captured from two cameras in the CUHK campus.

MARS: a large video-based person ReID dataset. It consists of 20,478 tracklets and 1,191,003 bounding boxes of 1,261 identities and contains rich pose variations.

Partial-REID: a specially designed partial
person dataset that includes 600 images from 60 people,
with 5 full-body images and 5 partial images per person.

Partial-iLIDs: contains a total of 476 images of 119 people captured
by multiple non-overlapping cameras. Some images
in the dataset contain people occluded by other individuals
or luggages.


CVRP2018

1. Pose Transferrable Person Re-Identification

a) Methods strategy:

Data Augumention

b) 实施细节:

首先在目标数据集上训练一个Re-ID model.

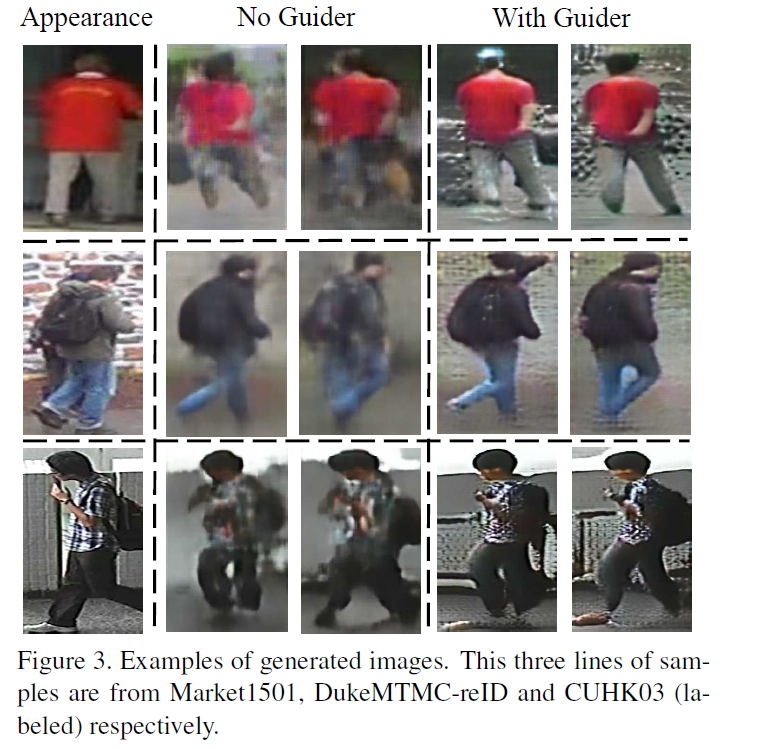
然后使用上面pre-train model作为一个guider,来指导GAN对skeleton-to-image的训练,其目的是生成更多的姿态.

最后将上面生成的结果来产生更多的labeled pose-varied samples,通过这种数据增强的方法来增强Re-ID的训练model.

c) 效果展示:

可以看出,加入guider指导后,GAN生成的图片具有更多的辨识信息,对于模型训练帮助会更好。

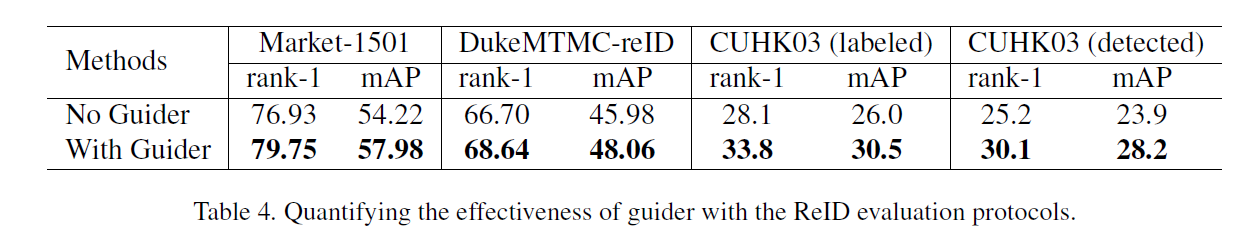
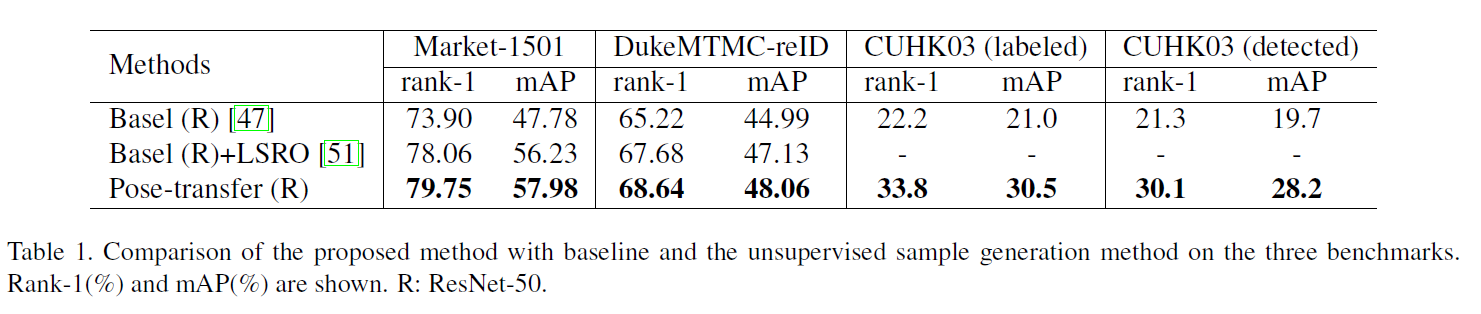
d) 实验结果:

可以看到,在多个数据集上都有提升。

e) 优点:

该文的方法不仅可以增强基于feature learning,而且也能增强基于metric
learning的Re-ID model性能


2. Deep Spatial Feature Reconstruction for Partial Person Re-identification: Alignment-free Approach

a) Methods strategy:

deep feature learning method

b) 采用的方法:

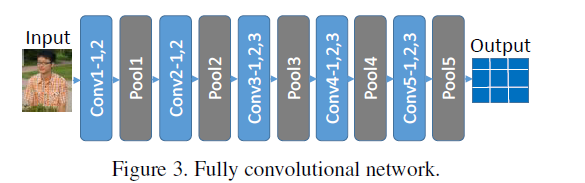
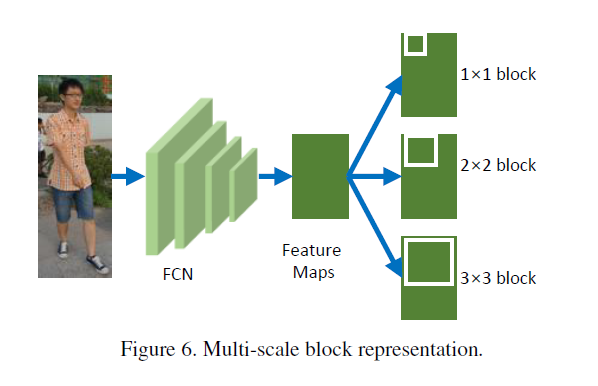
Fully Convolutional Network

该方法可以解除输入尺寸必须限定的约束(因为没有全连接层)

且能保留spatial coordinate information

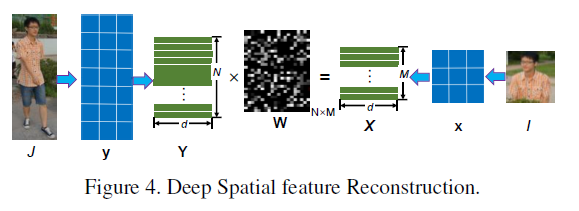
Deep Spatial Feature Reconstruction

主要用于衡量一个人不同尺寸图片之间的相似度


Multiscale Block Representation

Figure 4采用的singleScale-blocks 鲁棒性不够,因此采用MutiScale-blocks来提升性能


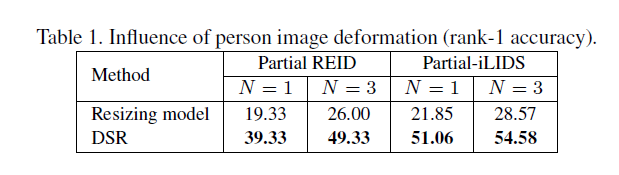
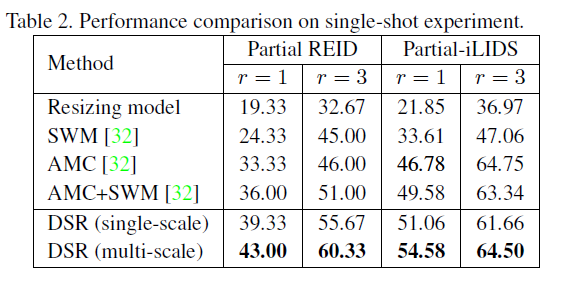
c) 结果分析:

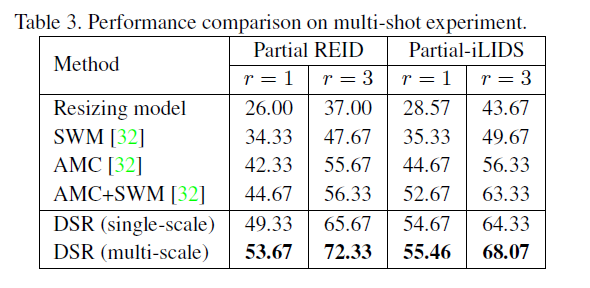
可以看出,相比于直接暴力Resize图片而言,DSR采用的方法性能大大优于前者


相比于其他算法,提升效果明显

d) 优点:

为了摆脱固定的输入尺寸,本文提出的空间特征重构方法提供了一种可行的方案,该方法将探测空间特征图中的每个通道由空间图像映射的通道线性重构,同时避免了繁琐的无对齐匹配。此外,我们将DSR嵌入到FCN中,以学习更多的鉴别特征,从而使来自同一个人的图像对的重构误差最小


3. Adversarially Occluded Samples for Person Re-identification

a) Methods strategy:

Data Augumention

b) 采用的方法:

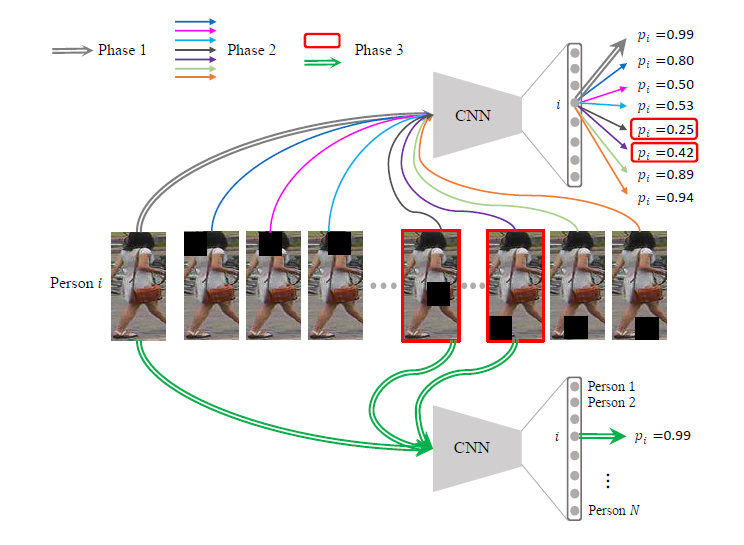
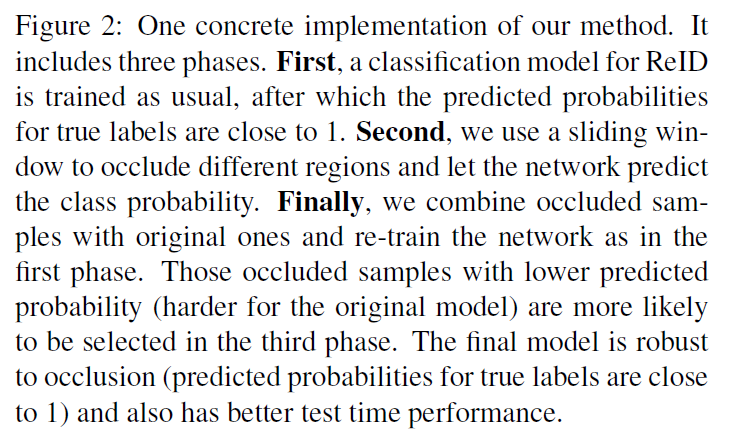
首先训练一个Re-ID model直到收敛。

然后利用网络可视化工具去探索哪些region是用来做最终决策的。

最后对这些region采用全黑Mask部分遮挡或者加入真实世界场景的noise重新作为训练集,re-train model。

c) 思路来源:

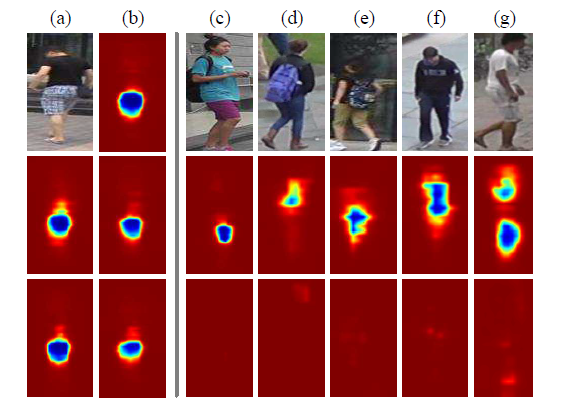
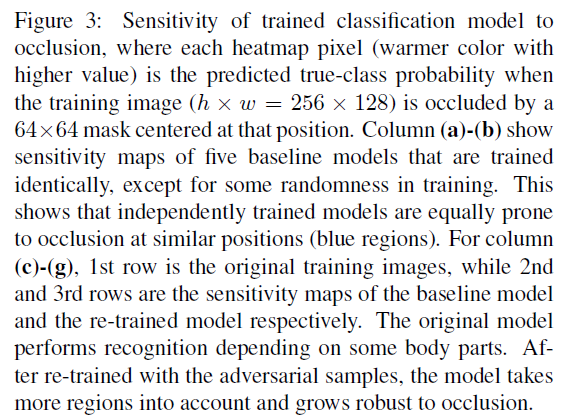
左列中(a)(b)中5张heatmap是采用不同的baseline,但对其可视化结果可以看出大致相同。因此网络在进行决策时,主要是依赖的图像特征是相近的。所以为了对数据进行有效地增强,可以考虑在这些起决策作用的region进行遮掩或者添加噪声,来获取更好的泛化能力。

由于不同图片的决策region是不相同的,因此可以本文采用上图的方法去寻找对决策起比较大负面影响的Mask位置来做为对抗训练的样本。

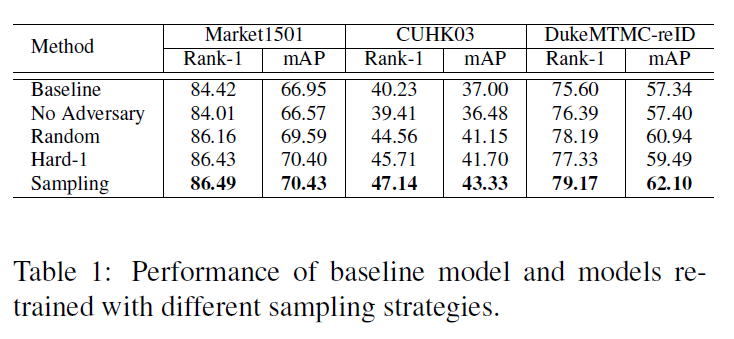
d) 实验结果:

可以看出本文所采用的的方法,无论是Hard-1策略还是Sampling策略,在前两个数据集上都能产生积极效果,然后在第三个数据集上,Hard-1策略表现不如Random。

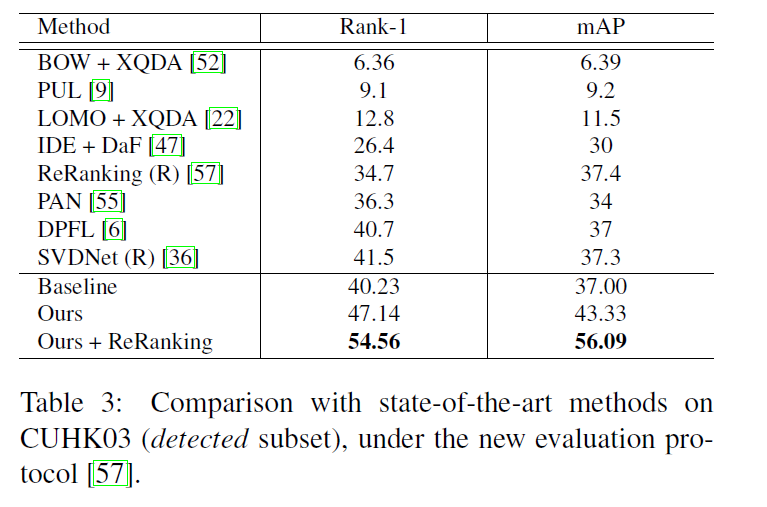
此外,作者还发现,本文提出的方法+ReRanking可以大大提高模型的性能。

e) 优点:

由于本文采用的是Data Augumention,因此可以与其他模型进行融合。


如果觉得我有地方讲的不好的或者有错误的欢迎给我留言,谢谢大家阅读(点个赞我可是会很开心的哦)~

Re-ID: Person Re-identification by Local Maximal Occurrence Representation and Metric Learning 论文解析 注: 刚刚看完了这篇论文,顺便整理了一下这篇论文的思路,对论文的方法表示666项目主页:http://www.cbsr.ia.ac.cn/users/scliao/projects/lomo_xqda/论文解析 行人重识别有两个特别重要的问题: Feature representation Metric learning 在这篇论文中,作者采用的是LOMO的特征表示方法,以及XQDA的度量学习方法 阅读详情

相关推荐

Person Re-Identification(ReID行人重识别)

ReID? ReID是图像检索的子任务,它主要的目的是:利用计算机视觉技术对特定行人进行跨视域匹配和检索。所谓跨视域即是图片来自于不同的摄像头,这样可以用于智能视频监控(如无人超市)、刑侦(追捕嫌疑人)、交管(追踪车辆等)等等应用场景。如上图,需要检索到同一个人(查询图像query)在各个摄像头下图片集(候选行人库gallery)的相关图片。 困难点 困难点主要在于ReID任务的跨视域特性有: 摄像头分辨率不同 拍摄角度不一 致 光照条件不同 背景变化大 人体属于非刚性目标,外观会因姿态、遮挡、光照、.

nakaizura 7171

泛读论文:Person-reID 行人重识别合集

2017CVPR、ICCV和NIPS在Person Reidentification方向的相关工作小结 基于融合特征的行人再识别方法 模式识别与人工智能 2017.3 问题 目前常用的行人再识别方法主要集中在行人外形特征的描述和同一行人对应的 2 幅图像之间距离的学习度量.由于行人图像的亮度和相机角度的变化等,提取行人的外形特征的不变性较难,因此在各个图像库上行人再识别的识别率较低 ...

汪汪汪的博客 1万+

在occluded Person Re-ID中,选择clip还是ViT作为backbone?

CLIP是OpenAI提出的一种模型,旨在通过对大规模的图像和文本数据进行对比学习,实现图像和文本的相互理解。CLIP模型包含了一个图像编码器和一个文本编码器,通过对比学习(contrastive learning)方法训练,使得图像和文本在同一个向量空间中能够很好地对应。

weixin_51678401的博客 1020

行人重识别ReID

目录 AlignedReID PCB: Beyond part models: person retrieval with refined part pooling (and A strong convolutional baseline) ECCV2018 Good appearance feature for multi-target-camera tracking CVPR20...

别说话写代码的博客 5339

ViT在行人重识别中的应用

"ViT在行人重识别中的应用" 作者:禅与计算机程序设计艺术 1. 背景介绍 1.1 行人重识别 (Person Re-Identification) 的概念和意义

AI天才研究院 806

行人重识别数据集: Person Re-ID dataset Collection

转载自https://blog.youkuaiyun.com/carson2005/article/details/11636673

AI炼丹师 2194

Occluded-REID 行人重识别中的遮挡数据集

Occluded-REID dataset 在这篇论文中《OCCLUDED PERSON RE-IDENTIFICATION》首次制作的行人遮挡数据集。由移动相机拍摄的200个遮挡行人的2000张图像组成。每个ID由5张全身图片和5张遮挡图片组成。行人图像都被reseize成 128 × 64的大小。 P-DukeMTMC-reID dataset 该遮挡行人数据集是从DukeMTMC-reID dataset数据集人工挑选出来的,该数据集有1299个ID总共24143张图片。 P-ETHZ ...

qq_43589560的博客 5732

什么是plm系统?-数字化转型网

当今世界,产品研发能力是企业在激烈的市场竞争中保持战略优势的核心竞争力之一。如何有效地缩短产品研发周期、改善产品服务的设计迭代流程、有效降低产品的研发成本,也是企业面临的主要问题之一。PLM(Product Lifecycle Management,产品生命周期管理)在优化产品研发的全管理流程、增强企业产品的市场竞争力方面具有关键的作用。

cxo17757154043的博客 882

行人重识别论文阅读3-行人重识别中的部分对部分的对应学习(PPCL)

Partial Person Re-identification with Part-Part Correspondence Learning 行人重识别中的部分对部分的对应学习 论文地址:Paper 解决的问题 将重点放在识别部分(有缺陷的)输入,借助部分-部分对应学习(PPCL),这是以种自监督学习框架,无需任何额外的部分级监督即可学习图像块之间的对应关系。同时将本文的模型应用于人脸识别中,效果也能提高。 文章概述 本文提出一个部分-部分对应学习(PPCL)解决部分行人重识别问题。提出门控布局整流器

qq_33977080的博客 1090

如何使你的直流电机闭环?(PID讲解)

看了看很多大佬写的PID讲解很全面也很复杂,实在是不适合很多萌新入坑,所以想按自己的理解写一篇通俗易懂的PID算法讲解

a2001444的博客 1万+

图像识别火灾检测系统实战:从火焰特征到YOLO部署全解析

计算机视觉技术正深入改变传统消防的感知方式。图像识别火灾检测利用摄像头采集的视频流,通过颜色、动态和形态特征分析,实现早期火情的自动发现与定位。其核心原理在于,火焰在视觉上具有独特的颜色分布、闪烁特性和轮廓变化,借助目标检测模型如YOLO,可在复杂场景中区分真实火焰与干扰物。这项技术广泛应用于仓库、园区、隧道等大空间场所,是智慧消防的重要支撑。本文从火焰视觉特征、数据集构建、模型选型与系统架构设计出发,结合部署实践中的误报与算力优化经验,为开发者提供一套可落地的视频火焰检测方案。

weixin_42533751的博客 244

Person ReID相关术语及评测指标解读

     最近在研究person re-id相关的算法,在不少论文中遇到相关的评测指标,例如mAP、CMC、ROC等,这里做一下总结。同时补充下行人重识别相关术语及常用数据集。Person ReID行人重识别(Person Re-identification)也称行人再识别,本文简称为ReID,是利用计算机视觉技术判断图像或者视频序列中是否存在特定行人的技术。广泛被认为是一个图像检索的子问题。给定...

Gavinmiaoc的博客 9577

树莓派4B:控制步进电机

文章目录准备阶段接线阶段树莓派程序 准备阶段 准备以下物品,淘宝都可以买到: 57步进电机 电源开关(220v转24v,3A,72W) 步进电机驱动器 电源线 电线 杜邦线 树莓派4B一套 具体型号如下: 接线阶段 整体:接线效果如下图 电源开关起220v转24v作用,很好接线,输出24v接入步进电机驱动器 步进电机驱动器的 A+ A- B+ B- 按提示接步进电机四线,步进电机上就会有说...

学习路上的鸭子的博客 1万+

【计算机视觉】基于行为的ReID演示

帮老师做了一个简单的基于行为(主要是步态)的ReID问题的Demo,效果如下图:下面是提取的集中特征,前三个都是GEI系的,后几个是基于光流场的。然后右边是识别出的几个对象的排序,因为没有角度和衣服,书包等协变量改变的问题,所以识别比较准确,排第一的就是对的。其实特征是之前提好的,因为对象也不多,识别序列对也是一次性计算的。右边识别出的几个人是显示的动态行走的序列图,所以预先把每个人resize的

小魏的修行路 8474

基于BEV(鸟瞰图)的3D检测:PointPillars与CenterPoint

基于BEV(鸟瞰图)的3D检测:PointPillars与CenterPoint​ ,人工智能,计算机视觉,大模型,AI,本文围绕基于BEV的3D检测,解析了PointPillars与CenterPoint两种算法。PointPillars用点柱特征编码网络处理点云,通过2D卷积网络提取特征,检测头为解耦头;CenterPoint将三维物体表为点,分两阶段检测,先找中心点及属性,再细化预测。两者都可借特定骨干网生成BEV特征图且基于BEV检测,但检测头设计和物体表示方式不同。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 27万+

YOLOv8改进 | 卷积模块 | 用DWConv卷积替换Conv【轻量化网络】

YOLOv8改进,yolov8,yolov8创新,yolov8涨点

kay_545 7155

行人重识别简介(Person ReID)

一、简介 行人重识别,也被称为 ReID(Person Re-identification),是希望能够利用计算机视觉的算法来进行跨摄像头的追踪,也就是找到不同摄像头下的同一个人,这也是图像检索的一个子问题 多个摄像头下拍摄行人的角度不同,图像中的行人可能72变。所以要正确判断的话,就要找到行人上的局部不变的part(比如:衣服颜色,衣服纹理,手提包,背包等等)下图为 DukeMTMC-reI...

Man 1万+

解锁机器人动态平衡算法:从原理到实践

机器人的动态平衡,是指机器人在运动过程中,面对各种复杂的动态变化和外界干扰,依然能够维持稳定状态,不发生倾倒或失去控制的能力。它就像是一位技艺精湛的舞者,在舞台上翩翩起舞时,无论做出多么复杂的动作,都能巧妙地调整身体姿态,始终保持平衡,展现出优美的舞姿。在实际应用中,机器人的动态平衡对于其稳定运行起着至关重要的作用。以双足机器人为例,当它行走在不平整的地面上时,地面的起伏会使机器人的重心不断发生变化。如果没有良好的动态平衡能力,机器人就很容易因为重心偏移而摔倒,无法完成行走任务。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 3837

深度学习系列11:ReID概述和资源

1. ReID算法介绍 综述相关资料:https://zhuanlan.zhihu.com/p/31921944 综述文章:https://arxiv.org/pdf/1610.02984.pdf 2005的论文提出了ReID的概念,并使用基本的图像特征和时空特征,通过贝叶斯网来推断是否同一个人;2014年ReID开始引入深度学习的方法。 1.1 定义 行人重识别(Person Re-identification)也称行人再识别,简称为ReID,给定一个监控行人图像,检索跨设备下的该行人图像。一个区域有多个

kittyzc的博客 9854

【通信协议】GATT 与 BLE HID 工作原理详解

详细介绍BLE HID 跟GATT工作原理与两者的交互关系

以实战经验介绍行业知识 842

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

CVPR 2020 | 旷视研究院提出新方法,优化解决遮挡行人重识别问题

IEEE国际计算机视觉与模式识别会议 CVPR 2020 (IEEE Conference on Computer Vision and Pattern...

旷视开发者技术社区 5364

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

2018_cvpr 行人重识别文章

前戏今天Amusi很荣幸邀请linolzhang大佬分享关于深度学习的行人重识别方向相关论文整理的文章。文中介绍的论文都来自于CVPR(计算机视觉顶级会议)。首先简单介绍一下,什么叫行人重识别?行人重识别(Person re-identification)也称行人再识别,是利用计算机视觉技术判断图像或者视频序列中是否存在特定行人的技术。广泛被认为是一个图像检索的子问题。给定一个监控行人图像,检索跨...

weixin_36608043的博客 3467

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

CVPR 2020 | 旷视新方法优化解决遮挡行人重识别

CVPR 2020 | 旷视新方法优化解决遮挡行人重识别 为了获得遮挡ReID更加鲁棒的对齐能力,本文提出了一种新的框架,来学习具有判别力特征和人体拓扑信息的高阶关系。 论文名称:High-Order Information Matters: Learning Relation and Topology for Occluded Person Re-Identification 论文链接:https://arxiv.org/abs/2003.08177 导语 行人重.

胭脂草的ABC博客 2046

Perceive Where to Focus: Learning Visibility-aware Part-level Features for Partial Person Re-id

行人重识别之局部识别(CVPR2019) Perceive Where to Focus: Learning Visibility-aware Part-level Features for Partial Person Re-identification 原文链接:https://arxiv.org/abs/1904.00537 这篇文章的核心思想是: 如下图(a),两幅图的空间位置失配。如图(...

嘻嘻哈哈yjy的博客 4246

partial的使用

partial用于将原函数声明的参数值固定。 使用规则: 要遵循形参的顺序规则:位置参数 -&gt; 默认值参数 -&gt; 关键字参数 具体用法: 将前面连续的参数固定,就可以直接继续按照原来的参数继续调用。如 from functools import partial def test(a,b,c,d): return a,b,c,d ...

厚积而后薄发 1300

【ReID】【代码注释】读数据/吐数据 deep-person-reid/dataset_loader.py

源码URL: https://github.com/michuanhaohao/deep-person-reid/blob/master/dataset_loader.py 读数据/吐数据,读前39行源码并注释 from __future__ import print_function, absolute_import import os from PIL import Image import ...

锥栗的博客 1294
上一篇: [Python] numpy中运算符* @ mutiply dot的用法分析
下一篇: Adversary Attack(对抗攻击)论文阅读笔记
大鲨鱼冲鸭
博客等级 码龄9年 249粉丝 185原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值