



📺 B站:博主个人介绍
📘 博主书籍-京东购买链接*:Yocto项目实战教程
📘 加博主微信,进技术交流群: jerrydev
一文吃透 TensorRT 实战:从 ONNX 到 Engine,再到高性能推理落地
这篇文章我想用“实战 + 原理 + 工程经验”的方式,把 TensorRT 讲清楚。很多人第一次接触 TensorRT,会把它理解成“ONNX 转换工具”;但真正上手后会发现,它更像一个面向 NVIDIA GPU 的推理编译器 + 运行时系统。如果只记接口,很快会乱;如果把它放回“构建阶段”和“运行阶段”去理解,很多 API、性能现象和报错就都能串起来了。TensorRT 官方也明确把它定义为一个用于优化已训练模型、并执行高性能推理的 SDK,核心由 inference optimizer 和 runtime 两部分组成。(NVIDIA Docs)
一、为什么我要单独写 TensorRT
我在真正开始用 TensorRT 之前,最困惑的不是“某个 API 怎么写”,而是这几个问题:
- TensorRT 到底是做模型转换,还是做模型执行?
- ONNX、Engine、Runtime、ExecutionContext 之间到底是什么关系?
- FP32、FP16、INT8 到底差在哪,什么时候值得开?
- 动态 shape、plugin、workspace、timing cache 这些工程概念到底该怎么理解?
这些问题如果不先理顺,后面就会出现一种非常常见的现象:代码能抄出来,但不知道为什么这么写,也不知道什么时候该改。 而 TensorRT 的官方文档其实已经把主线讲得很清楚:它分成 build phase 和 runtime phase 两部分,前者负责把模型优化成 plan/engine,后者负责把 engine 真的跑起来。(NVIDIA Docs)
二、TensorRT 到底是什么
先给一句我认为最准确的定义:
TensorRT 不是训练框架,而是 NVIDIA 面向推理部署的优化器和运行时。
也就是说,它不是拿来训练模型的,而是把已经训练好的模型进一步优化,让它在 NVIDIA GPU 上跑得更快、延迟更低、吞吐更高。官方 quick start 也是这么定义的:TensorRT 在训练之后介入,把模型优化成适合目标硬件执行的形式,再由 runtime 执行推理。(NVIDIA Docs)
我现在更愿意把 TensorRT 理解成三层:
| 层次 | 作用 | 我怎么理解 |
|---|---|---|
| 模型输入层 | ONNX / 手工 Network Definition | “我要推理什么模型” |
| 编译优化层 | Builder / Config / Parser | “怎么把它编译成适合当前 GPU 的 Engine” |
| 运行执行层 | Runtime / Engine / Context | “怎么把这个 Engine 真正跑起来” |
上面这张表,是我对官方能力模型的工程化总结:TensorRT 接受模型定义,在构建阶段做优化并生成序列化的 plan;运行阶段反序列化 plan,创建 execution context 执行推理。(NVIDIA Docs)
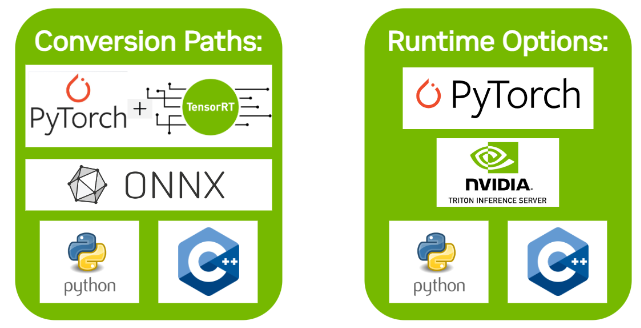
三、先建立最重要的心智模型:Build Phase 和 Runtime Phase
这是我认为学习 TensorRT 最关键的一步。
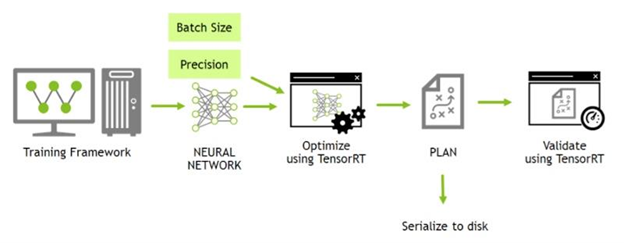
1. Build Phase:离线编译模型
构建阶段通常是离线做的。你把 ONNX 或者 Network Definition 交给 TensorRT,TensorRT 会为目标 GPU 选择合适的 tactic、kernel、布局和执行方案,然后生成一个序列化产物,也就是 plan / engine 文件。官方明确说明 builder 会在构建过程中为层实现做计时,因此构建阶段本质上很像一次“面向硬件的推理编译”。(NVIDIA Docs)
2. Runtime Phase:在线执行推理
运行阶段则很纯粹:把 plan 反序列化成 engine,从 engine 创建 execution context,把输入输出地址绑定进去,然后执行推理。官方 Python 文档对应的是 execute_async_v3(),C++ 文档对应的是 enqueueV3()。(NVIDIA Docs)
3. 一张流程图看懂主链路
[PyTorch / TensorFlow / 其他训练框架]
                |
                v
         [导出 ONNX 模型]
                |
                v
   [TensorRT Build Phase / Builder]
      - Parser 解析模型
      - Config 设置策略
      - tactic/kernel 选择
      - 生成 serialized engine(plan)
                |
                v
      [保存 .plan / .engine 文件]
                |
                v
    [TensorRT Runtime Phase / Runner]
      - Runtime 反序列化 engine
      - Engine 创建 ExecutionContext
      - 绑定输入输出 GPU 地址
      - execute_async_v3 / enqueueV3
                |
                v
             [推理输出]
这条链路对应的就是官方 programming model:第一阶段优化,第二阶段执行。(NVIDIA Docs)
四、ONNX、Engine、输入数据,到底是什么关系
这也是实战中最容易混淆的一件事。
1. ONNX 解决的是“模型是什么”
ONNX 文件里保存的是模型图、算子、权重、输入输出规格。TensorRT 的 ONNX Parser 会把这些内容导入到 TensorRT 的 network definition 里。(NVIDIA Docs)
2. Engine 解决的是“这个模型如何在当前 GPU 上高效执行”
Builder 会读取 network definition 和 config,然后生成一个优化后的 engine。这个 engine 可以立刻反序列化,也可以存盘以后部署。默认情况下,TensorRT engine 同时依赖 TensorRT 版本和构建它的 GPU/兼容策略;官方 support matrix 也明确说明,序列化 engine 默认并不是跨平台、跨 GPU、跨版本完全可移植的。(NVIDIA Docs)
3. 输入数据解决的是“这次我要算什么”
这里很多人会误会,以为 ONNX 转 Engine 的时候必须有真实图片。其实正常 FP32 / FP16 构建并不需要真实输入样本,输入数据是在运行阶段才真正参与推理的。例外是 INT8 校准这类量化流程,才可能需要有代表性的真实数据分布。官方量化文档明确提到,显式量化是推荐方向,而隐式 INT8/校准是另一条历史路径。(NVIDIA Docs)
我自己的记忆方式是:
- ONNX:描述模型
- Engine:描述如何高效执行模型
- 输入张量 x:描述这次实际要计算的内容
五、Builder 这套 API,到底固定到什么程度
如果只看 ONNX -> Engine 这一段,主骨架基本是固定的。Python 和 C++ 的 API 名称虽然不同,但职责是一一对应的。
1. Python / C++ 构建 API 对照表
| 阶段 | Python API | C++ API | 作用 |
|---|---|---|---|
| 日志器 | trt.Logger(...) | 自定义 ILogger | 打印解析和构建日志 |
| 创建 Builder | trt.Builder(logger) | createInferBuilder(logger) | 创建构建器 |
| 创建 Network | builder.create_network(0) | builder->createNetworkV2(0U) | 创建 TensorRT 网络定义 |
| 解析 ONNX | trt.OnnxParser(...).parse_from_file(...) | createParser(...)->parseFromFile(...) | 把 ONNX 导入 network |
| 创建 Config | builder.create_builder_config() | builder->createBuilderConfig() | 设置构建参数 |
| 设置 workspace | config.set_memory_pool_limit(...) | config->setMemoryPoolLimit(...) | 限制构建时内存池 |
| 构建 plan | build_serialized_network(...) | buildSerializedNetwork(...) | 生成序列化 engine |
| 反序列化 engine | runtime.deserialize_cuda_engine(...) | runtime->deserializeCudaEngine(...) | 生成可运行 engine |
表中的主干 API 都来自官方 Python/C++ 文档。值得注意的是,TensorRT 10 中网络已经总是 explicit batch,因此老教程里常见的 EXPLICIT_BATCH 在 10.x 中已被标记为 deprecated/ignored。(NVIDIA Docs)
2. 真正会变化的,是配置而不是骨架
也就是说,代码结构通常不怎么变,变化的是:
- 是否使用动态 shape profile
- 是否启用 FP16 / INT8 或强类型网络
- 是否需要 plugin
- workspace 和 tactic 相关设置
- 是否需要版本兼容 / 硬件兼容
这也是为什么很多工程代码看起来像“模板”:主流程几乎一样,区别都在 config 和附加能力上。官方 capabilities、advanced、dynamic shapes、plugins 文档都在围绕这些可变点展开。(NVIDIA Docs)
六、Runner 这套 API,才是真正的推理执行链路
很多人学 TensorRT 只盯着 builder,结果到了真正执行阶段就乱了。其实 runtime 部分的主线更清晰。
1. Runner 的三大核心对象
| 对象 | 作用 | 我的理解 |
|---|---|---|
Runtime | 反序列化 plan | “加载器” |
ICudaEngine | 优化好的模型 | “编译产物” |
ExecutionContext | 执行一次推理 | “真正的 runner” |
官方明确说明 execution context 是调用 inference 的主接口,一个 engine 可以创建多个 context。(NVIDIA Docs)
2. Runner 的核心调用链
| 阶段 | Python API | C++ API | 作用 |
|---|---|---|---|
| 加载 engine | deserialize_cuda_engine() | deserializeCudaEngine() | 从 plan 反序列化 |
| 创建 context | create_execution_context() | createExecutionContext() | 创建执行环境 |
| 设置动态 shape | set_input_shape() | setInputShape() | 指定本次输入 shape |
| 绑定地址 | set_tensor_address() | setTensorAddress() | 绑定输入输出显存 |
| 启动推理 | execute_async_v3() | enqueueV3() | 提交 CUDA stream 上执行 |
这张表总结自官方 Python/C++ runtime 文档和 dynamic shape 文档。(NVIDIA Docs)
3. 我对 runner 的一句话理解
Builder 负责把模型“编译好”,Runner 负责把编译结果“跑起来”。
这句话虽然简单,但能帮我把很多 API 自动归类:凡是 builder、parser、config 一类的,大概率属于构建期;凡是 runtime、engine、context、tensor address 一类的,大概率属于运行期。
七、FP32、FP16、INT8:到底该怎么理解
这一块如果讲得不清楚,很容易要么“盲目开 INT8”,要么“完全不敢碰量化”。
1. 先说结论
- FP32:最稳,通常也是原始模型默认精度。
- FP16:通常是 TensorRT 实战里最常见、最稳妥的第一步。
- INT8:常常能进一步提高吞吐、降低延迟和带宽占用,但有一定精度风险,必须做验证。
TensorRT 的高级主题和量化文档都强调,降低精度是为了提升性能,但会引入准确率风险;不同层也不一定都会真的用低精度执行。(NVIDIA Docs)
2. 这三种精度在 API 上有什么不同
如果是传统写法,差异主要体现在 BuilderConfig 上;但从 TensorRT 10.12 开始,weak typing 已经 deprecated,官方推荐 strong typing 和 explicit quantization。在 strongly typed network 下,很多旧式的 builder precision flags 本身就是不允许的。(NVIDIA Docs)
| 精度模式 | 典型作用 | 主要变化位置 | 需要注意什么 |
|---|---|---|---|
| FP32 | 基线精度 | 基本无额外精度配置 | 稳,但通常性能不是最优 |
| FP16 | 常见加速选项 | 传统写法在 BuilderConfig 上启用 | 现代版本更推荐走强类型路径 |
| INT8 | 更激进的优化 | 量化模型 / QDQ / 或历史校准链路 | 需要做精度验证 |
这张表是基于官方 advanced、quantized types、strong typing 文档的工程总结。(NVIDIA Docs)
3. INT8 到底值不值得开
我的建议很明确:
- 如果你追求极致吞吐、低延迟、低显存和带宽成本,INT8 值得测。
- 如果你对精度特别敏感,先把 FP16 跑通,再决定要不要往 INT8 走。
- 如果你的模型已经有 Q/DQ,或者做过 QAT,那么 INT8 更值得认真做。
原因也很直接:官方明确建议未来优先采用显式量化,并指出隐式量化已经弃用;同时低精度通常能带来更好的推理性能,但不是没有精度代价。(NVIDIA Docs)
八、动态 Shape:为什么它很重要,但又很容易踩坑
动态 shape 的本质,就是把某些维度延迟到运行时再指定。官方定义里,这些运行时维度通常在构建时用 -1 占位,然后通过 optimization profile 告诉 builder 允许哪些 shape 范围,运行阶段再给 execution context 设置这次实际 shape。(NVIDIA Docs)
1. 动态 shape 的工作流
[ONNX 输入维度含 -1]
        |
        v
[Build 阶段创建 Optimization Profile]
  - min shape
  - opt shape
  - max shape
        |
        v
[生成支持该范围的 Engine]
        |
        v
[Runtime 阶段]
  - 选择合适 profile
  - context.set_input_shape(...)
  - 查询输出 shape
  - 执行推理
这就是官方 dynamic shapes 文档的标准流程。(NVIDIA Docs)
2. 我在工程上怎么理解 profile
min / opt / max 不是随便填的。
min:你允许的最小输入max:你允许的最大输入opt:你最常见、最想优化的输入
很多人把 profile 理解成“随便给个范围就行”,结果构建能过,但性能不理想。实际上 builder 会围绕 profile 和 tactic 选择做优化,因此 opt 的设置会直接影响常用场景性能。这个结论是对官方 build/动态 shape 机制的工程化理解。(NVIDIA Docs)
九、一个真正能落地的 Python 实战模板
这一节我给一个最小但清晰的思路:ONNX -> TensorRT Engine -> 推理执行。
1. 构建阶段:ONNX 转 Engine
import tensorrt as trt

TRT_LOGGER = trt.Logger(trt.Logger.WARNING)

def build_engine_from_onnx(onnx_path: str):
    builder = trt.Builder(TRT_LOGGER)
    network = builder.create_network(0)  # TensorRT 10.x 中显式 batch 已默认化
    parser = trt.OnnxParser(network, TRT_LOGGER)

    ok = parser.parse_from_file(onnx_path)
    if not ok:
        for i in range(parser.num_errors):
            print(parser.get_error(i))
        raise RuntimeError("Failed to parse ONNX")

    config = builder.create_builder_config()
    config.set_memory_pool_limit(trt.MemoryPoolType.WORKSPACE, 1 << 30)  # 1GB

    serialized_engine = builder.build_serialized_network(network, config)
    if serialized_engine is None:
        raise RuntimeError("Failed to build engine")

    runtime = trt.Runtime(TRT_LOGGER)
    engine = runtime.deserialize_cuda_engine(serialized_engine)
    return engine
这段代码对应的就是官方 Python 构建主链路:Builder -> Network -> Parser -> BuilderConfig -> build_serialized_network -> Runtime.deserialize_cuda_engine。其中 workspace 内存池会影响构建时可用的 tactic 空间;官方也说明,如果 workspace 限制过小,会间接限制可选实现。(NVIDIA Docs)
2. 运行阶段:Engine 执行推理
def run_inference(engine, input_name, output_name, d_input, d_output, stream_ptr):
    context = engine.create_execution_context()

    # 动态 shape 模型时,先设置 shape
    # context.set_input_shape(input_name, (1, 3, 224, 224))

    context.set_tensor_address(input_name, int(d_input))
    context.set_tensor_address(output_name, int(d_output))

    context.execute_async_v3(stream_ptr)
这就是官方 Python runtime 的核心执行形态。需要注意的是,这里绑定的是 GPU 显存地址,不是 NumPy 数组本身;真正的数据搬运通常要靠 CUDA Python、PyCUDA、PyTorch、CuPy 等去管理。官方 Python 文档也明确提到,GPU 内存分配可以来自多种 Python CUDA 生态工具。(NVIDIA Docs)
3. 这个例子最重要的学习点
我觉得这段代码里最值得学的不是“怎么复制”,而是下面两句话:
build_engine_from_onnx()只负责模型构建run_inference()才负责模型执行
这正好对应 TensorRT 的 build/runtime 两阶段设计。只要这个边界一清楚,很多问题都不容易混淆。(NVIDIA Docs)
十、trtexec:我最推荐先会用的命令行工具
如果是工程落地,我很建议先把 trtexec 学会。因为它能帮我们快速做三件事:
- 验证 ONNX 是否能被 TensorRT 正常解析
- 快速生成 engine
- 做基础 benchmark 和 profiling
官方 best practices 和 command-line 文档都把 trtexec 作为重要工具来介绍。(NVIDIA Docs)
1. 最基础的构建命令
trtexec --onnx=model.onnx --saveEngine=model.plan
这条命令本质就是把 ONNX 编译成 TensorRT plan。(NVIDIA Docs)
2. 动态 shape 的常见写法
trtexec \
  --onnx=model.onnx \
  --minShapes=input:1x3x224x224 \
  --optShapes=input:4x3x224x224 \
  --maxShapes=input:8x3x224x224 \
  --saveEngine=model.plan
官方命令行文档明确支持 --minShapes / --optShapes / --maxShapes 这组参数来描述输入 shape 范围。(NVIDIA Docs)
3. benchmark 的意义
我自己的建议是:先用 trtexec 跑出一个可信基线,再上业务代码。
因为如果 trtexec 都跑不顺,问题大概率还在模型、算子支持、shape 或环境层面;如果 trtexec 很快,业务代码却很慢,那就多半是你自己的数据搬运、预处理、后处理、同步方式、stream 使用或 batch 策略有问题。官方 best practices 也是围绕 benchmark、profile、分析瓶颈来展开。(NVIDIA Docs)
十一、性能优化时,我会优先看哪些点
1. 不要把构建时间和运行时间混为一谈
Builder 在构建时要做 tactic 计时,所以 build 慢并不代表 runtime 慢;反过来,构建得很快也不代表 runtime 就一定快。官方 how TensorRT works 文档明确解释了构建阶段会进行实现计时,并可能消耗相当多的临时显存。(NVIDIA Docs)
2. workspace 不是越小越好
workspace 太小会限制某些高性能 tactic 的选择,导致最终 engine 性能下降;但也不是盲目越大越好,尤其在资源受限环境里需要折中。官方文档对 workspace 的作用和默认行为有明确说明。(NVIDIA Docs)
3. 先做 FP16,再考虑 INT8
这是我最推荐的实践顺序。FP16 往往能带来不错的性能提升,同时精度风险通常比 INT8 更容易控制;INT8 则更适合在有明确收益目标、且能做严谨验证的时候再上。这个顺序并不是官方硬性要求,但与官方对量化收益/风险和平衡方式的描述是一致的。(NVIDIA Docs)
4. 动态 shape 的 profile 要贴近真实业务
如果 opt shape 和线上常用输入偏差很大,engine 很可能“理论支持你的输入”,但并没有为你的主流场景做到最佳优化。这个点官方虽然不会用我的话表述,但从 optimization profile 的设计目的就能推导出来。(NVIDIA Docs)
5. 真正复杂的模型,要准备 plugin 方案
TensorRT 支持非常多的层,但并不是所有模型结构都能无缝原生落地。官方专门提供了 custom layers / plugins 机制,当前推荐使用 IPluginV3 和对应的 plugin creator 体系。(NVIDIA Docs)
十二、几个非常容易踩的坑
坑 1:把 TensorRT 当成“万能模型转换器”
TensorRT 的强项不是“把格式改掉”,而是“在 NVIDIA GPU 上做高性能推理”。如果只看格式转换,就低估了它真正的价值。官方 quick start 和 capabilities 都强调它是 optimizer + runtime,而不只是 parser。(NVIDIA Docs)
坑 2:以为 Engine 一次构建,到处都能跑
默认不是。官方 support matrix 明确指出:序列化 engine 默认不跨平台,也不天然跨 GPU 架构;版本兼容和硬件兼容需要额外配置,而且兼容模式可能带来一定性能损失。(NVIDIA Docs)
坑 3:只看能不能跑,不看精度
这在 INT8 上尤其危险。低精度推理最怕“速度很好,但结果已经不可用”。官方量化和 accuracy/performance 资料都强调,精度验证是必要步骤。(NVIDIA Docs)
坑 4:还在照搬很老的教程
TensorRT 10.x 已经对很多旧概念做了现代化调整,比如 explicit batch 总是开启、weak typing 在 10.12 被弃用、官方推荐 explicit quantization、plugin 方向转向 IPluginV3。如果还照抄很老的 7.x/8.x 文章,后面碰到 API 过时是必然的。(NVIDIA Docs)
十三、我会怎么规划一条 TensorRT 学习路线
如果让我重新学一次 TensorRT,我会按下面这个顺序来:
| 阶段 | 学什么 | 为什么这么排 |
|---|---|---|
| 第 1 步 | Quick Start + trtexec | 先跑通全流程,建立直觉 |
| 第 2 步 | Build / Runtime 主链路 | 搞清 Builder 和 Runner 分工 |
| 第 3 步 | 动态 shape | 实际部署几乎绕不开 |
| 第 4 步 | FP16 / INT8 / 显式量化 | 决定性能上限 |
| 第 5 步 | Profiling / Best Practices | 做真实优化 |
| 第 6 步 | Plugin / 兼容性 / 排障 | 面对复杂模型和生产问题 |
这个顺序和官方文档组织方式是吻合的:quick start、capabilities、dynamic shapes、quantized types、best practices、custom layers、troubleshooting 本来就是一条由浅入深的路线。(NVIDIA Docs)
十四、全文总结:把 TensorRT 归结为一句话
如果我只用一句话总结 TensorRT,我会写成这样:
TensorRT 是一个把训练好的模型,面向 NVIDIA GPU 编译成高性能推理 Engine,并通过 Runtime 高效执行的系统。
再拆开一点,就是下面这 8 个知识点:
- TensorRT 只做推理,不做训练。(NVIDIA Docs)
- 它分成 build phase 和 runtime phase。(NVIDIA Docs)
- ONNX 是模型定义,Engine 是优化后的执行产物。(NVIDIA Docs)
- Builder 是“编译器”,ExecutionContext 是“runner”。(NVIDIA Docs)
- 动态 shape 需要 profile,运行时还要设置 input shape。(NVIDIA Docs)
- FP16 是很常见的第一步优化,INT8 更激进但要做精度验证。(NVIDIA Docs)
- 新版本更推荐 strong typing、explicit quantization、
IPluginV3。(NVIDIA Docs) trtexec是最值得先掌握的工程工具之一。(NVIDIA Docs)
十五、适合放在文末的实战 Checklist
[ ] 我已经明确模型是推理部署,不是训练流程
[ ] 我知道 ONNX、Engine、Runtime、Context 的区别
[ ] 我能独立跑通 ONNX -> TensorRT Engine
[ ] 我知道 Builder 和 Runner 是两套不同职责的 API
[ ] 我知道动态 shape 要配 profile
[ ] 我知道 FP32 / FP16 / INT8 的收益和风险
[ ] 我知道 INT8 不是“必然更好”,必须验证精度
[ ] 我知道 trtexec 可以先做基线 benchmark
[ ] 我知道 engine 默认不天然跨平台、跨 GPU、跨版本
[ ] 我知道复杂模型可能需要 plugin
如果上面这份 checklist 你已经能全部解释清楚,那么 TensorRT 这条主线,基本就算真正入门了。(NVIDIA Docs)
推荐标签: TensorRT 深度学习部署 ONNX CUDA GPU推理优化 模型加速
如果你要继续把这篇文章做成系列,下一篇最自然的主题就是:“TensorRT Python 实战:从 ResNet50 到动态 Shape,再到 FP16/INT8 对比测试”。
📺 B站:博主个人介绍
📘 博主书籍-京东购买链接*:Yocto项目实战教程
📘 加博主微信,进技术交流群: jerrydev

 2901


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


