



Hadoop安装及zookeeper命令
一、zookeeper命令及API
1.zookeeper的数据模型
- ZooKeeper 的数据模型,在结构上和标准文件系统的非常相似,拥有一个层次的命名空间,都是采用树形层次结构.

- ZooKeeper 树中的每个节点被称为—个Znode。和文件系统的目录树一样,ZooKeeper 树中的每个节点可以拥有子节点。
但也有不同之处:
- Znode 兼具文件和目录两种特点。既像文件一样维护着数据、元信息、ACL、 时间戳等数据结构,又像目录一样可以作为路径标识的一部分,并可以具有 子 Znode。用户对 Znode 具有增、删、改、查等操作(权限允许的情况下)。
- Znode 存储数据大小有限制。ZooKeeper 虽然可以关联一些数据,但并没有 被设计为常规的数据库或者大数据存储,相反的是,它用来管理调度数据, 比如分布式应用中的配置文件信息、状态信息、汇集位置等等。这些数据的 共同特性就是它们都是很小的数据,通常以 KB 为大小单位。ZooKeeper 的服 务器和客户端都被设计为严格检查并限制每个 Znode 的数据大小至多 1M,常规使用中应该远小于此值。
- Znode 通过路径引用,如同 Unix 中的文件路径。路径必须是绝对的,因此他 们必须由斜杠字符来开头。除此以外,他们必须是唯一的,也就是说每一个 路径只有一个表示,因此这些路径不能改变。在 ZooKeeper 中,路径由 Unicode 字符串组成,并且有一些限制。字符串"/zookeeper"用以保存管理 信息,比如关键配额信息。
- 每个 Znode 由 3 部分组成:
2.Znode节点类型
2.1 Znode 有两种,分别为临时节点和永久节点。节点的类型在创建时即被确定,并且不能改变。
- 临时节点:该节点的生命周期依赖于创建它们的会话。一旦会话结束,临时 节点将被自动删除,当然可以也可以手动删除。临时节点不允许拥有子节点。
- 永久节点:该节点的生命周期不依赖于会话,并且只有在客户端显示执行删除操作的时候,他们才能被删除。
2.2 Znode 还有一个序列化的特性(FIFO),如果创建的时候指定的话,该 Znode 的名字后面会自动追加一个不断增加的序列号。序列号对于此节点的父节点来说是唯一的,这样便会记录每个子节点创建的先后顺序。它的格式为“%10d”(10 位数字,没有数值的数位用 0 补充,例如“0000000001”)。
2.3 这样便会存在四种类型的 Znode 节点,分别对应:
- PERSISTENT:永久节点
- EPHEMERAL:临时节点
- PERSISTENT_SEQUENTIAL:永久节点、序列化
- EPHEMERAL_SEQUENTIAL:临时节点、序列化
3.Zookeeper的Shell 客户端操作
3.1 登录Zookeeper客户端
bin/zkCli.sh -server node01:2181
3.2 Zookeeper客户端操作命令
| 命令 | 说明 | 参数 |
|---|---|---|
create [-s] [-e] path data acl | 创建Znode | -s 指定是顺序节点(永久、序列化) -e 指定是临时节点 |
ls path [watch] | 列出Path下所有子Znode | |
get path [watch] | 获取Path对应的Znode的数据和属性 | |
ls2 path [watch] | 查看Path下所有子Znode以及子Znode的属性 | |
set path data [version] | 更新节点 | version 数据版本 |
delete path [version] | 删除节点, 如果要删除的节点有子Znode则无法删除 | version 数据版本 |
rmr path | 删除节点, 如果有子Znode则递归删除 | |
setquota -n|-b val path | 修改Znode配额 | -n 设置子节点最大个数 -b 设置节点数据最大长度 |
history | 列出历史记录 |
3.3 操作实例
ls /
create /hello world
create -e /abc 123
create -s /zhangsan boy
create -e -s /lisi boy
set /hello zookeeper
delete /hello
rmr /abc
history
3.4 节点属性
每个 znode 都包含了一系列的属性,通过命令 get,可以获得节点的属性。

dataVersion:数据版本号,每次对节点进行 set 操作,dataVersion 的值都会增加 1(即使设置的是相同的数据),可有效避免了数据更新时出现的先后顺序问题。
cversion :子节点的版本号。当 znode 的子节点有变化时,cversion 的值就会增加 1。
aclVersion :ACL 的版本号。
cZxid :Znode 创建的事务 id。create
mZxid :Znode 被修改的事务 id,即每次对 znode 的修改都会更新 mZxid。
- 对于 zk 来说,每次的变化都会产生一个唯一的事务 id,zxid(ZooKeeper Transaction Id)。通过 zxid,可以确定更新操作的先后顺序。例如,如果 zxid1
- 小于 zxid2,说明 zxid1 操作先于 zxid2 发生,zxid 对于整个 zk 都是唯一的,
ctime:节点创建时的时间戳.
mtime:节点最新一次更新发生时的时间戳.
ephemeralOwner:如果该节点为临时节点, ephemeralOwner 值表示与该节点绑定的 session id. 如果不 是,ephemeralOwner 值为 0.
3.5 Zookeeper的watch机制
- 通知类似于数据库中的触发器, 对某个Znode设置
Watcher, 当Znode发生变化的时候,WatchManager会调用对应的Watcher - 当Znode发生删除, 修改, 创建, 子节点修改的时候, 对应的
Watcher会得到通知 Watcher的特点- 一次性触发 一个
Watcher只会被触发一次, 如果需要继续监听, 则需要再次添加Watcher - 事件封装:
Watcher得到的事件是被封装过的, 包括三个内容keeperState, eventType, path
- 一次性触发 一个
| KeeperState | EventType | 触发条件 | 说明 |
|---|---|---|---|
| None | 连接成功 | ||
| SyncConnected | NodeCreated | Znode被创建 | 此时处于连接状态 |
| SyncConnected | NodeDeleted | Znode被删除 | 此时处于连接状态 |
| SyncConnected | NodeDataChanged | Znode数据被改变 | 此时处于连接状态 |
| SyncConnected | NodeChildChanged | Znode的子Znode数据被改变 | 此时处于连接状态 |
| Disconnected | None | 客户端和服务端断开连接 | 此时客户端和服务器处于断开连接状态 |
| Expired | None | 会话超时 | 会收到一个SessionExpiredExceptio |
| AuthFailed | None | 权限验证失败 | 会收到一个AuthFailedException |
4.zookeeper的JavaAPI操作
这里操作Zookeeper的JavaAPI使用的是一套zookeeper客户端框架 Curator ,解决了很多Zookeeper客户端非常底层的细节开发工作 。
Curator包含了几个包:
- curator-framework:对zookeeper的底层api的一些封装
- curator-recipes:封装了一些高级特性,如:Cache事件监听、选举、分布式锁、分布式计数器等
Maven依赖(使用curator的版本:2.12.0,对应Zookeeper的版本为:3.4.x,如果跨版本会有兼容性问题,很有可能导致节点操作失败):
4.1创建java工程,导入jar包
创建maven java工程,导入jar包
<!-- <repositories>
        <repository>
          <id>cloudera</id>
          <url>https://repository.cloudera.com/artifactory/cloudera-repos/</url>
        </repository>
      </repositories> -->
<dependencies>
    <dependency>
        <groupId>org.apache.curator</groupId>
        <artifactId>curator-framework</artifactId>
        <version>2.12.0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.curator</groupId>
        <artifactId>curator-recipes</artifactId>
        <version>2.12.0</version>
    </dependency>
    <dependency>
        <groupId>com.google.collections</groupId>
        <artifactId>google-collections</artifactId>
        <version>1.0</version>
    </dependency>
    <dependency>
        <groupId>junit</groupId>
        <artifactId>junit</artifactId>
        <version>RELEASE</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-simple</artifactId>
        <version>1.7.25</version>
    </dependency>
</dependencies>

<build>
    <plugins>
        <!-- java编译插件 -->
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-compiler-plugin</artifactId>
            <version>3.2</version>
            <configuration>
                <source>1.8</source>
                <target>1.8</target>
                <encoding>UTF-8</encoding>
            </configuration>
        </plugin>
    </plugins>
</build>
4.2 节点的操作
创建永久节点
@Test
public void createNode() throws Exception {
   	/**
   	*param1:重试的间隔时间
   	*param2:重试的最大次数
   	*/
    RetryPolicy retryPolicy = new  ExponentialBackoffRetry(1000, 1);
    //获取客户端对象
    /**
    *param1:要连接的zookeeper服务器列表
    *param2:会话的超时时间
    *param3:链接超时时间
    *param4:重试策略
    */
    CuratorFramework client =     CuratorFrameworkFactory.newClient("192.168.174.100:2181,192.168.174.110:2181,192.168.174.120:2181", 1000, 1000, retryPolicy);
    //调用start开启客户端操作
    client.start();

    //通过create来进行创建节点,并且需要指定节点类型
  client.create().creatingParentsIfNeeded().withMode(CreateMode.PERSISTENT).forPath("/hello3/world");

    client.close();
}
创建临时节点
public void createNode2() throws Exception {
    RetryPolicy retryPolicy = new  ExponentialBackoffRetry(3000, 1);
    CuratorFramework client = CuratorFrameworkFactory.newClient("node01:2181,node02:2181,node03:2181", 3000, 3000, retryPolicy);
    client.start();    client.create().creatingParentsIfNeeded().withMode(CreateMode.EPHEMERAL).forPath("/hello5/world");
    Thread.sleep(5000);
    client.close();
}
修改节点数据
/**
 * 节点下面添加数据与修改是类似的,一个节点下面会有一个数据,新的数据会覆盖旧的数据
 * @throws Exception
 */

@Test
public void nodeData() throws Exception {
    RetryPolicy retryPolicy = new  ExponentialBackoffRetry(3000, 1);
    CuratorFramework client = CuratorFrameworkFactory.newClient("node01:2181,node02:2181,node03:2181", 3000, 3000, retryPolicy);
    client.start();
    client.setData().forPath("/hello5", "hello7".getBytes());
    client.close();
}
节点数据查询
/**
 * 数据查询
 */

@Test

public void updateNode() throws Exception {
    RetryPolicy retryPolicy = new  ExponentialBackoffRetry(3000, 1);
    CuratorFramework client = CuratorFrameworkFactory.newClient("node01:2181,node02:2181,node03:2181", 3000, 3000, retryPolicy);
    client.start();
    byte[] forPath = client.getData().forPath("/hello5");
    System.out.println(new String(forPath));
    client.close();
}
节点watch机制
/**
 * zookeeper的watch机制
 * @throws Exception
 */
@Test
public void watchNode() throws Exception {

    RetryPolicy policy = new ExponentialBackoffRetry(3000, 3);

    CuratorFramework client = CuratorFrameworkFactory.newClient("node01:2181,node02:2181,node03:2181", policy);

    client.start();

    // ExecutorService pool = Executors.newCachedThreadPool();

    //设置节点的cache
    TreeCache treeCache = new TreeCache(client, "/hello5");

    //设置监听器和处理过程
    treeCache.getListenable().addListener(new TreeCacheListener() {

        @Override
        public void childEvent(CuratorFramework client, TreeCacheEvent event) throws Exception {
            ChildData data = event.getData();
            if(data !=null){
                switch (event.getType()) {
                    case NODE_ADDED:
                        System.out.println("NODE_ADDED : "+ data.getPath() +"  数据:"+ new String(data.getData()));
                        break;
                    case NODE_REMOVED:
                        System.out.println("NODE_REMOVED : "+ data.getPath() +"  数据:"+ new String(data.getData()));
                        break;
                    case NODE_UPDATED:
                        System.out.println("NODE_UPDATED : "+ data.getPath() +"  数据:"+ new String(data.getData()));
                        break;
                    default:
                        break;
                }
            }else{
                System.out.println( "data is null : "+ event.getType());
            }
        }
    });
    //开始监听
    treeCache.start();
    Thread.sleep(50000000);
}
5.Zookeeper以及分布式环境中的假死脑裂
- 参考链接https://blog.youkuaiyun.com/u010185262/article/details/49910301
- 假死脑裂
- 在一个大的集群中往往会有一个master的存在,在长期运行过程中不可避免会出现宕机等等的问题导致master不可用,在出现这样的情况以后往往会对系统产生很大的影响,所以一般的分布式集群中的master都采用了高可用的解决方案来避免这样的情况发生。 master-slaver方式,存在一个master的节点,平时对外服务,同时有一个slaver节点来监控master,监控的同时有某种方式来进行数据同步。假如现在master挂掉了,slaver能很快获知并且迅速切换为新的master。但是在这种方式中,监控切换是一个很大的难题,但是现在Zookeeper的watch和分布式锁机制能比较好的解决这个问题。虽然Zookeeper很好的解决了这个问题,但是它的使用也存在其他的问题,比如脑裂。 导致脑裂的一个根源问题就是假死。
- 什么叫假死呢?
- 有一个很重要的问题,就是到底是根据一个什么样的情况来判断一个节点死亡down掉了。在分布式系统中这些都是有监控者来判断的,但是监控者也很难判定其他的节点的状态,唯一一个可靠的途径就是心跳,包括Zookeeper也是使用心跳来判断客户端是否仍然活着。 使用ZooKeeper来做master HA基本都是同样的方式,每个节点都尝试注册一个象征master的临时节点其他没有注册成功的则成为slaver,并且通过watch机制监控着master所创建的临时节点,Zookeeper通过内部心跳机制来确定master的状态,一旦master出现意外Zookeeper能很快获悉并且通知其他的slaver,其他slaver在之后作出相关反应。这样就完成了一个切换。这种模式也是比较通用的模式,基本大部分都是这样实现的,
- 但是这里面有个很严重的问题,如果注意不到会导致短暂的时间内系统出现脑裂,因为心跳出现超时可能是master挂了,但是也可能是master,zookeeper之间网络出现了问题,也同样可能导致。这种情况就是假死,master并未死掉,但是与ZooKeeper之间的网络出现问题导致Zookeeper认为其挂掉了然后通知其他节点进行切换,这样slaver中就有一个成为了master,但是原本的master并未死掉,这时候client也获得master切换的消息,但是仍然会有一些延时,zookeeper需要通讯需要一个一个通知,这时候整个系统就很混乱可能有一部分client已经通知到了连接到新的master上去了,有的client仍然连接在老的master上如果同时有两个client需要对master的同一个数据更新并且刚好这两个client此刻分别连接在新老的master上,就会出现很严重问题。
- 是什么原因导致这样情况的出现呢?
- 主要原因是Zookeeper集群和Zookeeper client判断超时并不能做到完全同步,也就是说可能一前一后,如果是集群先于client发现那就会出现上面的情况。同时,在发现并切换后通知各个客户端也有先后快慢。一般出现这种情况的几率很小,需要master与Zookeeper集群网络断开但是与其他集群角色之间的网络没有问题,还要满足上面那些情况,但是一旦出现就会引起很严重的后果,数据不一致。
- 如何避免?
- 在slaver切换的时候不在检查到老的master出现问题后马上切换,而是在休眠一段足够的时间,确保老的master已经获知变更并且做了相关的shutdown清理工作了然后再注册成为master就能避免这类问题了,这个休眠时间一般定义为与Zookeeper定义的超时时间就够了,但是这段时间内系统不可用了
二、hadoop安装
1.Hadoop的介绍
-
Hadoop最早起源于Nutch。Nutch的设计目标是构建一个大型的全网搜索引擎,包括网页抓取、索引、查询等功能,但随着抓取网页数量的增加,遇到了严重的可扩展性问题——如何解决数十亿网页的存储和索引问题。
-
2003年、2004年谷歌发表的两篇论文为该问题提供了可行的解决方案。
——分布式文件系统(GFS),可用于处理海量网页的存储
——分布式计算框架MAPREDUCE,可用于处理海量网页的索引计算问题。
-
Nutch的开发人员完成了相应的开源实现HDFS和MAPREDUCE,并从Nutch中剥离成为独立项目HADOOP,到2008年1月,HADOOP成为Apache顶级项目.
狭义上来说,hadoop就是单独指代hadoop这个软件,
- HDFS:分布式文件系统
- MapReduce:分布式计算系统
- Yarn:分布式样集群资源管理
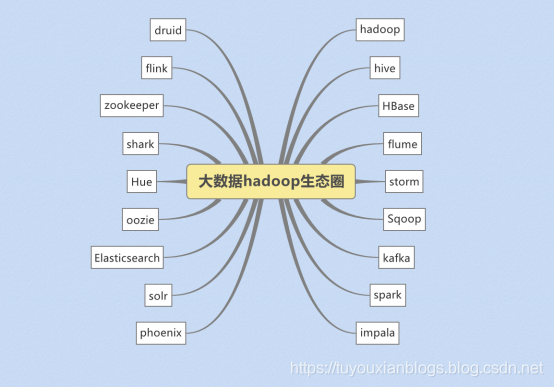
广义上来说,hadoop指代大数据的一个生态圈,包括很多其他的软件
-
道格 卡丁 Nutch 通用爬虫
-
luncene ES
-
存储
- GFS 谷歌的分布式文件系统 --HDFS
- MAPREDUCE 分布式处理 --mapReduce
- BigTable --hbase(可修改)
-
分而治之
-
2.Hadoop的历史版本和发行版公司
2.1 Hadoop历史版本
1.x版本系列:hadoop版本当中的第二代开源版本,主要修复0.x版本的一些bug等
2.x版本系列:架构产生重大变化,引入了yarn平台等许多新特性
3.x版本系列:加入多namenoode新特性
2.2 Hadoop三大发行版公司
-
免费开源版本apache:
优点:拥有全世界的开源贡献者,代码更新迭代版本比较快,
缺点:版本的升级,版本的维护,版本的兼容性,版本的补丁都可能考虑不太周到,
apache所有软件的下载地址(包括各种历史版本):
-
免费开源版本hortonWorks:
hortonworks主要是雅虎主导Hadoop开发的副总裁,带领二十几个核心成员成立Hortonworks,核心产品软件HDP(ambari),HDF免费开源,并且提供一整套的web管理界面,供我们可以通过web界面管理我们的集群状态,web管理界面软件HDF网址(http://ambari.apache.org/)
-
软件收费版本ClouderaManager:
cloudera主要是美国一家大数据公司在apache开源hadoop的版本上,通过自己公司内部的各种补丁,实现版本之间的稳定运行,大数据生态圈的各个版本的软件都提供了对应的版本,解决了版本的升级困难,版本兼容性等各种问题
3.hadoop的架构模型
1.x的版本架构模型介绍
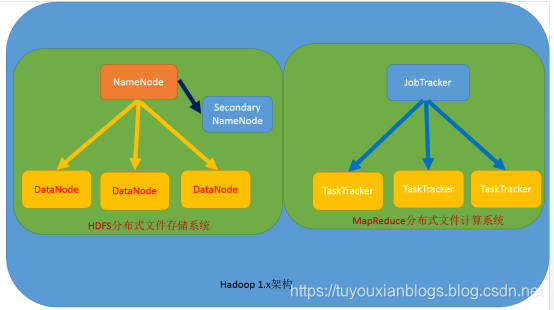
文件系统核心模块:
- NameNode:集群当中的主节点,管理元数据(文件的大小,文件的位置,文件的权限),主要用于管理集群当中的各种数据(只能有一个,会出现单机故障)
- secondaryNameNode:主要能用于hadoop当中元数据信息的辅助管理(不存储元数据)
- DataNode:集群当中的从节点,主要用于存储集群当中的各种数据
数据计算核心模块:
- JobTracker:接收用户的计算请求任务,并分配任务给从节点(任务的接收和任务的分配)
- TaskTracker:负责执行主节点JobTracker分配的任务(执行任务)
2.x的版本架构模型介绍
第一种:NameNode与ResourceManager单节点架构模型
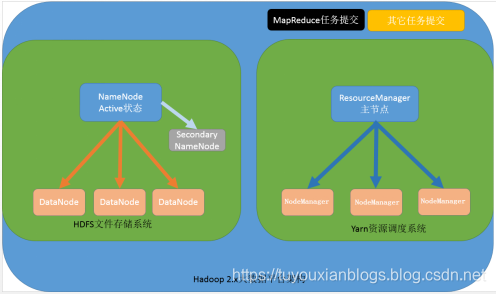
文件系统核心模块:
- NameNode:集群当中的主节点,主要用于管理集群当中的各种数据
- secondaryNameNode:主要能用于hadoop当中元数据信息的辅助管理
- DataNode:集群当中的从节点,主要用于存储集群当中的各种数据
数据计算核心模块:
-
ResourceManager:接收用户的计算请求任务,并负责集群的资源分配
- AppMaster:负责任务的分配
-
NodeManager:负责执行主节点APPmaster分配的任务
第二种:NameNode单节点与ResourceManager高可用架构模型
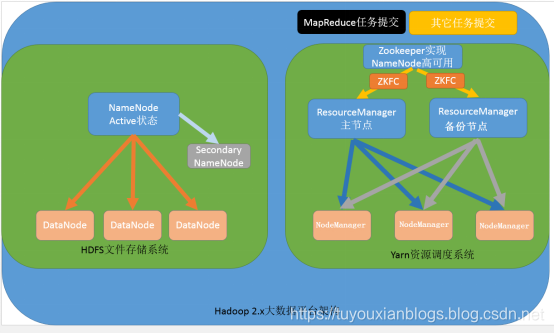
文件系统核心模块:
- NameNode:集群当中的主节点,主要用于管理集群当中的各种数据
- secondaryNameNode:主要能用于hadoop当中元数据信息的辅助管理
- DataNode:集群当中的从节点,主要用于存储集群当中的各种数据
数据计算核心模块:
- ResourceManager:接收用户的计算请求任务,并负责集群的资源分配,以及计算任务的划分,通过zookeeper实现ResourceManager的高可用(资源:内存、cpu)
- NodeManager:负责执行主节点ResourceManager分配的任务
ZKFailoverController(ZKFC)
- 是一个新的组件,它是一个ZooKeeper客户端,它还监视和管理NameNode的状态。运行NameNode的每台机器也运行ZKFC,他们之间是一对一的关系。
- 健康监测-
ZKFC定期使用健康检查命令调用其本地NameNode。只要NameNode以健康的状态及时响应,ZKFC就会认为节点是健康的。
如果节点已崩溃、冻结或以其他方式进入不健康状态,则健康监视器将将其标记为不健康。 - ZooKeeper会话管理
当本地NameNode健康时,ZKFC在ZooKeeper中举行一个开放的会话。
如果本地NameNode是活动的,它也持有一个特殊的“锁”。此锁使用ZooKeeptor对“临时”节点的支持;如果会话过期,则将自动删除锁节点。 - 基于ZooKeeper的选举
如果本地NameNode是健康的,而ZKFC认为目前没有其他节点持有锁,
它本身就会尝试获取锁。如果它成功了,那么它已经“赢得了选举”,并负责运行故障转移以使其本地NameNode活动。故障转移过程类似于上面描述的手动故障转移:首先,如果需要,对前一个活动进行隔离,然后本地NameNode转换到活动状态。
- 健康监测-
第三种:NameNode高可用与ResourceManager单节点架构模型
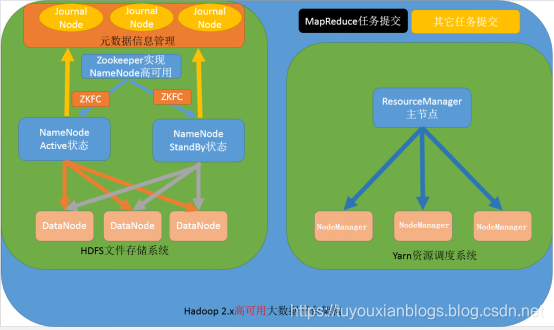
文件系统核心模块-HDFS:
- NameNode:集群当中的主节点,主要用于管理集群当中的各种数据,其中nameNode可以有两个,形成高可用状态
- DataNode:集群当中的从节点,主要用于存储集群当中的各种数据
- JournalNode:文件系统元数据信息管理
数据计算核心模块-MapReduce:
- ResourceManager:接收用户的计算请求任务,并负责集群的资源分配,以及计算任务的划分
- NodeManager:负责执行主节点ResourceManager分配的任务
第四种:NameNode与ResourceManager高可用架构模型
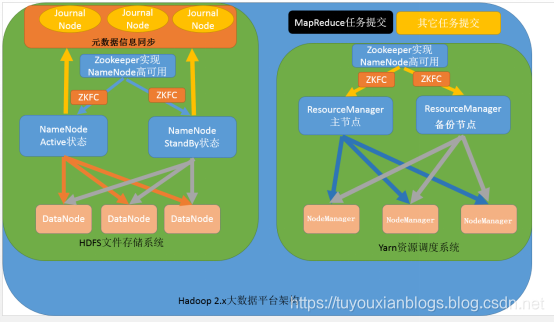
文件系统核心模块-HDFS:
- NameNode:集群当中的主节点,主要用于管理集群当中的各种数据,一般都是使用两个,实现HA高可用
- 没有secondaryNameNode
- JournalNode:元数据信息管理进程,一般都是奇数个
- zookeeper可以防止脑裂情况(两个namenode元数据不一致,主namenode写,副namenode读)
- DataNode:从节点,用于数据的存储
数据计算核心模块-MapReduce:
-
ResourceManager:Yarn平台的主节点,主要用于接收各种任务,通过两个,构建成高可用
-
NodeManager:Yarn平台的从节点,主要用于处理ResourceManager分配的任务
4.apache版本hadoop重新编译
4.1为什么要编译hadoop
由于appache给出的hadoop的安装包没有提供带C程序访问的接口,所以我们在使用本地库(本地库可以用来做压缩,以及支持C程序等等)的时候就会出问题,需要对Hadoop源码包进行重新编译.
4.2编译环境的准备
4.2.1:准备linux环境
准备一台linux环境,内存4G或以上,硬盘40G或以上,我这里使用的是Centos6.9 64位的操作系统(注意:一定要使用64位的操作系统)
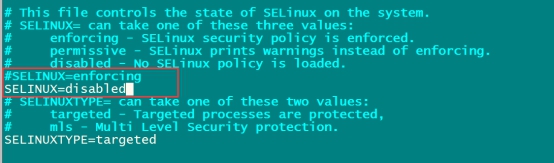
4.2.2:虚拟机联网,关闭防火墙,关闭selinux
关闭防火墙命令:
service  iptables   stop
chkconfig   iptables  off
关闭selinux
vim /etc/selinux/config
4.2.3:安装jdk1.7
注意hadoop-2.7.5 这个版本的编译,只能使用jdk1.7,如果使用jdk1.8那么就会报错
查看centos6.9自带的openjdk
rpm -qa | grep java
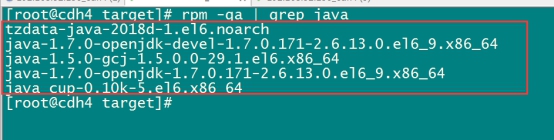
将所有这些openjdk全部卸载掉
rpm -e java-1.6.0-openjdk-1.6.0.41-1.13.13.1.el6_8.x86_64 tzdata-java-2016j-1.el6.noarch java-1.7.0-openjdk-1.7.0.131-2.6.9.0.el6_8.x86_64
注意:这里一定不要使用jdk1.8,亲测jdk1.8会出现错误
将我们jdk的安装包上传到/export/softwares(我这里使用的是jdk1.7.0_71这个版本)
解压我们的jdk压缩包
统一两个路径
mkdir -p /export/servers
mkdir -p /export/softwares
cd /export/softwares
tar -zxvf jdk-7u71-linux-x64.tar.gz -C ../servers/
配置环境变量
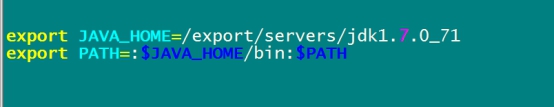
vim /etc/profile
export JAVA_HOME=/export/servers/jdk1.7.0_75
export PATH=:$JAVA_HOME/bin:$PATH
让修改立即生效
source /etc/profile
4.2.4:安装maven
这里使用maven3.x以上的版本应该都可以,不建议使用太高的版本,强烈建议使用3.0.5的版本即可
将maven的安装包上传到/export/softwares
然后解压maven的安装包到/export/servers
cd /export/softwares/
tar -zxvf apache-maven-3.0.5-bin.tar.gz -C ../servers/
配置maven的环境变量
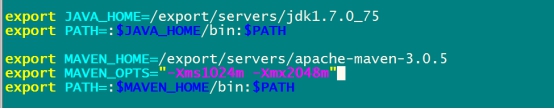
vim /etc/profile
export MAVEN_HOME=/export/servers/apache-maven-3.0.5
export MAVEN_OPTS="-Xms4096m -Xmx4096m"
export PATH=:$MAVEN_HOME/bin:$PATH
让修改立即生效
source /etc/profile
解压maven的仓库
tar -zxvf mvnrepository.tar.gz -C /export/servers/
修改maven的配置文件
cd  /export/servers/apache-maven-3.0.5/conf
vim settings.xml
<localRepository>/export/servers/mvnrepository/</localRepository>
指定我们本地仓库存放的路径

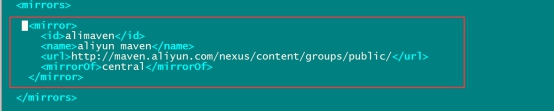
添加一个我们阿里云的镜像地址,会让我们下载jar包更快
 <mirror>
      <id>alimaven</id>
      <name>aliyun maven</name>
      <url>http://maven.aliyun.com/nexus/content/groups/public/</url>
      <mirrorOf>central</mirrorOf>
    </mirror>
4.2.5:安装findbugs
解压findbugs
tar -zxvf findbugs-1.3.9.tar.gz -C ../servers/
配置findbugs的环境变量
vim /etc/profile
export FINDBUGS_HOME=/export/servers/findbugs-1.3.9
export PATH=:$FINDBUGS_HOME/bin:$PATH

让修改立即生效
source /etc/profile
4.2.6:在线安装一些依赖包
yum install autoconf automake libtool cmake
yum install ncurses-devel
yum install openssl-devel
yum install lzo-devel zlib-devel gcc gcc-c++
bzip2压缩需要的依赖包
yum install -y bzip2-devel
4.2.7:安装protobuf
解压protobuf并进行编译
cd  /export/softwares
tar -zxvf protobuf-2.5.0.tar.gz -C ../servers/
cd   /export/servers/protobuf-2.5.0
./configure
make && make install
4.2.8、安装snappy
cd /export/softwares/
tar -zxf snappy-1.1.1.tar.gz  -C ../servers/
cd ../servers/snappy-1.1.1/
./configure
make && make install
4.2.9:编译hadoop源码
对源码进行编译
cd  /export/softwares
tar -zxvf hadoop-2.7.5-src.tar.gz  -C ../servers/
#tar -zxvf hadoop-2.7.5.tar.gz  -C ../servers/
cd  /export/servers/hadoop-2.7.5
编译支持snappy压缩:
mvn package -DskipTests -Pdist,native -Dtar -Drequire.snappy -e -X
编译完成之后我们需要的压缩包就在下面这个路径里面
/export/servers/hadoop-2.7.5/hadoop-dist/target
5、Hadoop安装
集群规划
| 服务器IP | 192.168.174.100 | 192.168.174.110 | 192.168.174.120 |
|---|---|---|---|
| 主机名 | node01 | node02 | node03 |
| NameNode | 是 | 否 | 否 |
| SecondaryNameNode | 是 | 否 | 否 |
| dataNode | 是 | 是 | 是 |
| ResourceManager | 是 | 否 | 否 |
| NodeManager | 是 | 是 | 是 |
第一步:上传apache hadoop包并解压
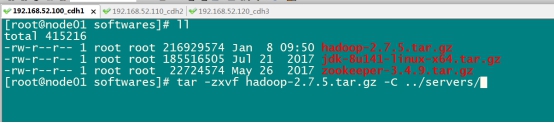
解压命令
cd /export/softwares
tar -zxvf hadoop-2.7.5.tar.gz -C ../servers/
cd /export/servers/hadoop-2.7.5/
bin/hadoop.sh checknative
第二步:修改配置文件
修改core-site.xml
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim  core-site.xml
<configuration>

    <!--  指定集群的文件系统类型:分布式文件系统 -->
	<property>
		<name>fs.default.name</name>
		<value>hdfs://node01:8020</value>
	</property>
    <!--  指定临时文件缓存地址 -->
	<property>
		<name>hadoop.tmp.dir</name>
		<value>/export/servers/hadoop-2.7.5/hadoopDatas/tempDatas</value>

	</property>

	<!--  缓冲区大小,实际工作中根据服务器性能动态调整 -->

	<property>
		<name>io.file.buffer.size</name>
		<value>4096</value>
	</property>

	<!--  开启hdfs的垃圾桶机制,删除掉的数据可以从垃圾桶中回收,单位分钟;0代表禁用垃圾桶机制 -->
	<property>
		<name>fs.trash.interval</name>
		<value>10080</value>
	</property>
</configuration>
修改hdfs-site.xml
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim hdfs-site.xml
<configuration>
    <!--  负责日志和快照 -->
	 <property>
			<name>dfs.namenode.secondary.http-address</name>
			<value>node01:50090</value>
	</property>
	<!--  指定namenode的访问地址和端口;高可用配置格式node01:50070,node02:50070 -->
	<property>
		<name>dfs.namenode.http-address</name>
		<value>node01:50070</value>
	</property>
    <!--  指定namenode元数据的存储位置 -->
	<property>
		<name>dfs.namenode.name.dir</name>
		<value>file:///export/servers/hadoop-2.7.5/hadoopDatas/namenodeDatas,file:///export/servers/hadoop-2.7.5/hadoopDatas/namenodeDatas2</value>
	</property>
	<!--  定义dataNode数据存储的节点位置,实际工作中,一般先确定磁盘的挂载目录,然后多个目录用,进行分割,不同目录放在不同磁盘下  -->
	<!-- 这里挂载两个磁盘,其实是磁盘的重用,比如linux磁盘40G,那么显示总内存就会有80G,但是实际能存放只要40G-->
	<property>
		<name>dfs.datanode.data.dir</name>
		<value>file:///export/servers/hadoop-2.7.5/hadoopDatas/datanodeDatas,file:///export/servers/hadoop-2.7.5/hadoopDatas/datanodeDatas2</value>
	</property>

    <!--  指定namenode日志文件的存放位置 -->
	<property>
		<name>dfs.namenode.edits.dir</name>
		<value>file:///export/servers/hadoop-2.7.5/hadoopDatas/nn/edits</value>
	</property>

    <!--  快照 -->
	<property>
		<name>dfs.namenode.checkpoint.dir</name>
		<value>file:///export/servers/hadoop-2.7.5/hadoopDatas/snn/name</value>
	</property>

	<property>
		<name>dfs.namenode.checkpoint.edits.dir</name>
		<value>file:///export/servers/hadoop-2.7.5/hadoopDatas/dfs/snn/edits</value>
	</property>

    <!--  文件切片的副本个数 -->
	<property>
		<name>dfs.replication</name>
		<value>3</value>
	</property>

	<!--  设置HDFS的文件权限 false关闭-->
	<property>
		<name>dfs.permissions</name>
		<value>false</value>
	</property>
	<!--  设置一个文件切片的大小:128M -->
    <property>
		<value>134217728</value>
	</property>

</configuration>
修改hadoop-env.sh
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim  hadoop-env.sh
export JAVA_HOME=/export/servers/jdk1.8.0_141
修改mapred-site.xml
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim  mapred-site.xml
<configuration>
    <!--  MapReduce的运行环境指定为yarn,这个缺少,history的日志中不会出现job的信息 -->
    <property>
    	<name>mapreduce.framework.name</name>
    	<value>yarn</value>
	</property>
    <!--  开启MapReduce小任务模式  Uber模式是Hadoop2.0针对MR小作业的优化机制。通过mapreduce.job.ubertask.enable来设置是否开启小作业优化,默认为false。https://blog.youkuaiyun.com/qianshangding0708/article/details/47702057-->
	<property>
		<name>mapreduce.job.ubertask.enable</name>
		<value>true</value>
	</property>

	<!--  设置历史任务的主机和端口 -->
	<property>
		<name>mapreduce.jobhistory.address</name>
		<value>node01:10020</value>
	</property>
 	<!--  设置网页访问历史任务的主机和端口 -->
	<property>
		<name>mapreduce.jobhistory.webapp.address</name>
		<value>node01:19888</value>
	</property>

</configuration>
修改yarn-site.xml
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim  yarn-site.xml
<configuration>
    <!--  配置yarn主节点的位置 -->
	<property>
		<name>yarn.resourcemanager.hostname</name>
		<value>node01</value>
	</property>
	<property>
		<name>yarn.nodemanager.aux-services</name>
		<value>mapreduce_shuffle</value>
	</property>
	<!--  开启日志聚合功能,将日志聚合在一起显示 -->
	<property>
		<name>yarn.log-aggregation-enable</name>
		<value>true</value>
	</property>
    <!--  设置聚合日志在hdfs上的保存时间 -->
	<property>
		<name>yarn.log-aggregation.retain-seconds</name>
		<value>604800</value>
	</property>
    <!--  设置yarn集群的内存分配方案 -->
	<property>
		<name>yarn.nodemanager.resource.memory-mb</name>
		<value>20480</value>
	</property>
	<property>
        	 <name>yarn.scheduler.minimum-allocation-mb</name>
         	<value>2048</value>
	</property>
	<property>
		<name>yarn.nodemanager.vmem-pmem-ratio</name>
		<value>2.1</value>
	</property>

</configuration>
修改mapred-env.sh
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim  mapred-env.sh
export JAVA_HOME=/export/servers/jdk1.8.0_141
修改slaves
修改slaves文件,然后将安装包发送到其他机器,重新启动集群即可
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/etc/hadoop
vim slaves
#配置从机
node01
node02
node03
第一台机器执行以下命令
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/tempDatas
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/namenodeDatas
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/namenodeDatas2
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/datanodeDatas
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/datanodeDatas2
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/nn/edits
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/snn/name
mkdir -p /export/servers/hadoop-2.7.5/hadoopDatas/dfs/snn/edits
安装包的分发
第一台机器执行以下命令
cd  /export/servers/
scp -r hadoop-2.7.5 node02:$PWD
scp -r hadoop-2.7.5 node03:$PWD
第三步:配置hadoop的环境变量
三台机器都要进行配置hadoop的环境变量
三台机器执行以下命令
vim /etc/profile
export HADOOP_HOME=/export/servers/hadoop-2.7.5
export PATH=:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH
配置完成之后生效
source /etc/profile
第四步:启动集群
要启动 Hadoop 集群,需要启动 HDFS 和 YARN 两个模块。
注意: 首次启动 HDFS 时,必须对其进行格式化操作。 本质上是一些清理和
准备工作,因为此时的 HDFS 在物理上还是不存在的。
hdfs namenode -format 或者 hadoop namenode –format
准备启动
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/
bin/hdfs namenode -format
sbin/start-dfs.sh
sbin/start-yarn.sh
sbin/mr-jobhistory-daemon.sh start historyserver
三个端口查看界面
http://node01:50070/explorer.html#/ 查看hdfs
http://node01:8088/cluster 查看yarn集群
http://node01:19888/jobhistory 查看历史完成的任务
- core-site.xml 集群的核心配置,namenode高可用
- hdfs-site.xml HDFS分布式文件系统的相关配置
- hadoop-env.sh jdk hdfs相关日志
- mapred-site.xml mapreduce相关设置
- yarn-site.xml yarn 资源平台设置
- mapred-env.sh jdk MR日志
安装包的分发
第一台机器执行以下命令
cd  /export/servers/
scp -r hadoop-2.7.5 node02:$PWD
scp -r hadoop-2.7.5 node03:$PWD
第三步:配置hadoop的环境变量
三台机器都要进行配置hadoop的环境变量
三台机器执行以下命令
vim /etc/profile
export HADOOP_HOME=/export/servers/hadoop-2.7.5
export PATH=:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH
配置完成之后生效
source /etc/profile
第四步:启动集群
要启动 Hadoop 集群,需要启动 HDFS 和 YARN 两个模块。
注意: 首次启动 HDFS 时,必须对其进行格式化操作。 本质上是一些清理和
准备工作,因为此时的 HDFS 在物理上还是不存在的。
hdfs namenode -format 或者 hadoop namenode –format
准备启动
第一台机器执行以下命令
cd  /export/servers/hadoop-2.7.5/
bin/hdfs namenode -format
sbin/start-dfs.sh
sbin/start-yarn.sh
sbin/mr-jobhistory-daemon.sh start historyserver
三个端口查看界面
http://node01:50070/explorer.html#/ 查看hdfs
http://node01:8088/cluster 查看yarn集群
http://node01:19888/jobhistory 查看历史完成的任务
- core-site.xml 集群的核心配置,namenode高可用
- hdfs-site.xml HDFS分布式文件系统的相关配置
- hadoop-env.sh jdk hdfs相关日志
- mapred-site.xml mapreduce相关设置
- yarn-site.xml yarn 资源平台设置
- mapred-env.sh jdk MR日志
- slaves 结点

 1778


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


