数据集汇总丨AI Agent 评测数据集,Microsoft/北大/港大/上海交大等发布 10 个数据集,从长程记忆到真实环境任务执行全覆盖

Memory Graph 实战:从零构建 AI 记忆系统并搭建 Benchmark 评测 在 AI Agent 与个人知识库应用中,如何让系统真正“记住”信息并精准召回,是长期记忆能力的核心挑战。向量数据库通常依赖文本语义相似度实现检索,而 memory graph(记忆图)则将实体与关系组织为结构化图结构,更贴近人类关联记忆,尤其适合多跳推理与复杂关系问答。理解其原理,从实体抽取、关系建边到多跳扩展检索,一套可复现的 benchmark 流程能让不同记忆方案的对比不再凭感觉。本文基于 Python 实现一个最小 memory graph 系统,详细讲解节点、边的数据结构与图检索策略,并设计测试 阅读详情

在大模型能力不断扩展的当下,AI Agent 正从「对话工具」快速走向「任务执行者」,并开始在自动化办公、代码生成、数据分析与复杂流程处理等场景中被广泛应用。相比传统的问答式大语言模型(LLM),Agent 的核心变化在于:它不再只是回答问题,而是能够拆解任务、调用工具,并自主推进直至完成目标。

随着 Agent 能力边界的扩展,用于训练与评测的数据集变得尤为关键。不同于传统的单轮问答或静态任务数据,Agent 相关数据集更强调「过程能力」,例如长程规划、多步推理、工具使用以及记忆能力。这些数据决定了模型能否在真实复杂的任务中稳定运行,也直接影响 Agent 系统的可靠性与上限。

本文整理的 10 个相关数据集,覆盖了当前 Agent 研究中的几个核心能力方向:长上下文理解与记忆评估、复杂任务规划与多步推理、工具调用与交互式执行能力,以及真实或模拟环境下的任务完成能力。这些数据共同构成了对 AI Agent 能力的系统性刻画。

从这些数据集的构成方式也可以看出,评测与训练数据本身正在发生转变:从静态的问答标注,逐渐走向对交互过程与行为轨迹的建模,更强调数据对模型「做事」能力的支撑,而不只是「回答」能力。

以下数据集支持在 HyperAI 在线使用,旨在加速研究人员与开发者在相关领域的研究探索。

更多优质数据集:

Datasets | HyperAI

数据集推荐

1.RHELM 长程记忆评估数据集

* 在线使用:

RHELM 长程记忆评估数据集 | 数据集 | HyperAI超神经

RHELM 是由 Microsoft 于 2026 年发布的长程记忆能力评估数据集,相关论文成果为Beyond Static Dialogues: Benchmarking Realistic, Heterogeneous, and Evolving Long-Term Memory,旨在提升大模型在复杂动态场景中的长期记忆、多跳推理与时序信息合成能力,广泛应用于大语言模型长时序记忆评测、 AI 助手长期交互能力验证、大模型多跳推理、时序信息融合与幻觉检测等研究场景。

该数据集包含 10 组虚拟角色人设、 1,305 组问答对、 629 个 JSON 格式对话会话、 625 个 TXT 格式邮件线程以及 1,053 个 MD 、 HTML 格式附件文档,配套问题涵盖附件引用、混合推理、事实查询、幻觉检测、信息聚合、时序分析及误导性问题七大核心类型。

2.MemLens 多模态长上下文基准数据集

* 在线使用:

MemLens 多模态长上下文基准数据集 | 数据集 | HyperAI超神经

MemLens 是一个用于评估视觉语言模型长程对话记忆的基准数据集,旨在测试模型在 32K 、 64K 、 128K 及 256K 上下文窗口中,检索、回忆、更新及推理跨多会话对话中嵌入的视觉与文本信息的能力。 该数据集共包含 789 道题目,涵盖 5 种评估类型:信息提取、知识更新、时序推理、多会话推理与拒绝回答(Abstention),并提供 4 个上下文长度配置(32K / 64K / 128K / 256K)。

该数据集额外提供一份 195 道题的固定分层采样子集,专门用于内存增强智能体(Memory-augmented Agents)的评估,以平衡推理成本。

3.LongBlocks  长上下文多语言问答数据集

* 在线使用:

LongBlocks 长上下文多语言问答数据集 | 数据集 | HyperAI超神经

LongBlocks 是由里斯本大学、 Instituto de Telecomunicações 联合 TransPerfect 等机构于 2026 年发布的一个长上下文多语言合成数据集。 该数据集包含约 19.4 万条长上下文问答示例,涵盖书籍、网页文本、 Wiki 百科、 arXiv 论文、编程代码及社区问答等长文档语料。

4.AgentTrove 智能体交互轨迹数据集

* 在线使用:

AgentTrove 智能体交互轨迹数据集 | 数据集 | HyperAI超神经

AgentTrove 是由 OpenThoughts-Agent 团队发布的大规模开源智能体交互轨迹数据集。 该数据集包含 1,696,847 行数据,源自 219 个数据集,涵盖代码修复、 Shell 脚本编写、数学问题解决、编程竞赛及通用计算机使用等任务领域。所有轨迹均基于开源 Harbor 智能体评估与数据生成框架采集,并统一采用 terminus-2 harness 格式(类 ShareGPT 对话布局)发布。

5.Claw-Eval 真实世界评测基准数据集

* 在线使用:
https://go.hyper.ai/es8w6

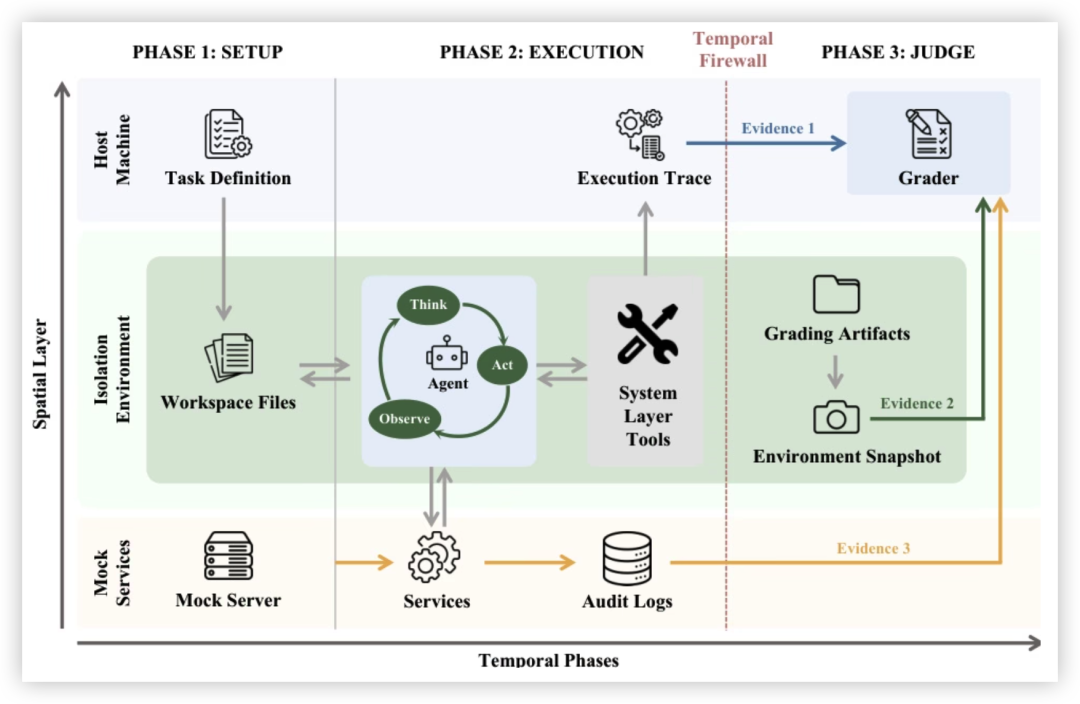
Claw-Eval 是由北京大学联合香港大学于 2026 年发布的一个面向 AI Agent 真实世界任务评测的端到端透明评测基准数据集,相关论文成果为 Claw-Eval: Toward Trustworthy Evaluation of Autonomous Agents,旨在评估自主智能体在真实环境中的任务执行、工具调用、多模态理解及多轮交互能力,广泛应用于 Agent 系统评测、自动化任务执行、多模态智能体研究及大模型能力分析等方向。

该数据集支持英文与中文两种语言,包含 General 、 Multimodal 与 Multi-turn 三个核心任务组,共覆盖通信、金融、办公、生产力工具等 24 个任务类别。

6.OpenMementos 上下文记忆压缩数据集

* 在线使用:

https://go.hyper.ai/tKykx

OpenMementos 是由 Microsoft 于 2026 年发布的一个上下文记忆压缩数据集,面向大模型长链推理与上下文管理能力建模。该数据集旨在训练模型进行上下文压缩与持续推理,从而支持在有限上下文窗口下完成复杂多步推理任务,广泛适用于长链推理建模、记忆增强模型训练及高效生成等研究场景。

该数据集基于 OpenThoughts 推理数据构建,包含 228,557 条结构化推理轨迹,其中数学 123,333 条,科学 61,485 条,编程 43,739 条,每条数据的平均句子数为 187 句。

7.MIA 多步推理与决策轨迹数据集

* 在线使用:

https://go.hyper.ai/LZ4yR

MIA 是由华东师范大学、上海创新研究院和哈尔滨工业大学于 2026 年 4 月联合发布的一个用于训练和评估具备长期记忆与任务执行能力的智能体的数据集,相关论文成果为 Memory Intelligence Agent,旨在提升智能体的长期记忆利用与多步决策能力。 该数据集包含约 2.1 万条推理轨迹数据,涵盖问题、规划、搜索与执行全过程,适用于 Agent 推理与强化学习研究。

8.ToolACE 复杂工具学习对话数据集

* 在线使用:

https://go.hyper.ai/TkOp8

ToolACE 是由上海交通大学联合中国科学技术大学、华为诺亚方舟实验室等机构于 2024 年发布的一个面向工具学习任务的自动化代理管道数据集,相关论文成果为 ToolACE: Winning the Points of LLM Function Calling,旨在生成准确、复杂且多样化的工具学习数据,尤其针对工具学习中数据质量不足、场景单一等现实问题进行设计。

该数据集包含多步骤会话示例,共调用 26,507 个多样化 API 。样本通过多智能体交互生成,并经过规则检查 + 模型验证的双层质量保证。每条对话都是多步骤、多来源的信息检索与分析任务,真实模拟工具调用场景,为 LLM 提供高价值训练数据。

9.Creative Professionals 创意任务指令数据集

* 在线使用:

https://go.hyper.ai/0vYFw

Creative Professionals Agentic Tasks 是一个大规模、高保真合成任务数据集,专为多模态 AI 代理的训练、评估和微调设计,包含 1,070,917 个智能体代理命令操作,涵盖 36 种创意、技术和工程软件环境。数据集旨在探索复杂软件交互和多步推理。

10.AgentNet 桌面操作任务数据集

* 在线使用:

https://go.hyper.ai/v6xOG

AgentNet 是由香港大学 XLANG 实验室,联合 Moonshot AI 、斯坦福大学等机构,于 2025 年发布的首个大规模桌面计算机使用智能体轨迹数据集,相关论文成果为「OPENCUA: Open Foundations for Computer-Use Agents」,旨在支持与评测跨平台的 GUI 操作智能体与视觉-语言-动作(VLA)模型。

数据集包含 22.6K 条人工标注的电脑使用任务轨迹,覆盖 Windows / macOS / Ubuntu 三大系统与 200+ 个应用/网站,场景涉及办公、专业、日常、系统四类。适用于桌面自动化、多应用流程与跨平台代理的训练与评估。

以上就是本期推荐的所有数据集,快来一键下载使用吧~

10大开源AI Agent平台深度评测:从部署到实战全指南 这次我们来看一个关于开源 AI Agent 开发平台的深度盘点。如果你正在寻找一个能让业务真正跑起来的 AI Agent 方案,无论是想快速搭建一个智能客服,还是想实现一个能自主完成复杂任务的多智能体系统,这篇文章会给你一个清晰的答案。市面上各种平台眼花缭乱,但真正能落地、能部署、能根据自己需求深度定制的,往往还是那些活跃在 GitHub 上的开源项目。 本文不会空谈概念,而是直接聚焦于 10 个顶级的开源 AI Agent 平台,从它们的核心能力、部署门槛、适用场景到实际选型,为你提供一份可以直接上手操作 阅读详情

相关推荐

AI Agent开源项目实战指南:10大框架深度解析

AI Agent(智能代理)作为人工智能领域的重要分支,通过自主决策和环境交互能力实现复杂任务自动化。其核心技术包括任务分解、记忆管理和多智能体协作等机制,在自动化流程、智能客服和快速原型开发等场景展现巨大价值。以AutoGPT为代表的自主智能体框架支持目标导向型任务处理,而LangChain等工具链提供了模块化开发能力。企业级平台如Dify通过可视化编排降低开发门槛,MetaGPT则展示了多角色协同的软件开发新模式。这些开源项目覆盖从入门到进阶的全场景需求,结合RAG检索、向量数据库等热门技术,为开发者构

weixin_29192365的博客 285

AI Agent记忆革命:17篇前沿论文速览,带你掌握大模型智能体核心技术与趋势

AI Agent前沿研究速览:17篇论文揭示四大趋势 本文精选AI Agent领域17篇最新论文,系统梳理了记忆架构、多智能体协作等五大热点方向。重点解析了MAGMA多图记忆架构的创新设计(四维度信息存储)和Nalar框架的工程突破(工作流响应速度提升2.9倍)。研究显示AI Agent正呈现四大发展态势:记忆系统强化(从MAGMA到CaveAgent)、多智能体协作模式成熟、工程化落地加速(如Orchestral AI统一API),以及负责任AI日益受重视(多语言公平性研究)。这些进展为开发者提供了从理论

libaiup的博客 1214

AI Agent工程化:记忆、Skills与本地轻量模型实战

人工智能正从简单问答迈向自主协作的Agent形态,而让Agent真正可靠工作的关键,已不再是模型参数大小,而是围绕记忆、技能与部署方式展开的工程化能力。Agent记忆解决了多轮任务中的状态持续问题,通过分层存储与精准检索,使AI从无状态工具变为有状态的协作者;Skills机制则以标准化的任务模板,让模型快速调用专业技能,大幅提升特定场景的执行效率。与此同时,本地优先与轻量模型的结合,为数据隐私和推理成本提供了全新解法,使Agent在普通设备上也能高效运行。这些技术已在个人助理、代码生成、文档处理等场景中落地

weixin_34320724的博客 360

【珍藏】李飞飞80页Agent巨作:定义AI智能体新范式,大模型+环境交互构建未来AGI路径

尽管前景广阔,但这篇综述也清醒地认识到,Agent AI 仍处于早期阶段,面临着跨越模态、领域和现实的多重鸿沟。例如,如何让 Agent 真正实现视觉、语言、听觉、动作等模态的深度融合,而不只是浅层拼接,是未来的核心研究方向。以及如何训练一个能在游戏、机器人和医疗等截然不同领域都能高效工作的“通用 Agent”,而不是为每个领域定制一个模型,是通往 AGI 的关键一步。并且在评测与基准方面,如何科学地评测一个 Agent 的智能水平也是关键。

qq_46094651的博客 2003

AI Agent测试数据集:MMLU,HumanEval,SRDD,CommonGen

AI Agent测试数据集:MMLU,HumanEval,SRDD,CommonGen MMLU侧重于多领域知识理解,HumanEval聚焦代码生成,SRDD用于特定任务或领域评估,CommonGen专注文本生成,它们从不同维度对模型或多智能体系统进行评估。

ZhangJiqun&191cm&85kg 843

Agent性能评测基准深度调研:AgentBench、WebArena及其局限

2023年至今,通用AI Agent的热度从学术实验室烧到了工业落地端:从能自动订机票、写Python脚本、协调团队任务的「超级数字助理」Demo,到集成在企业OA、客服、研发工具链里的垂直Agent产品,一时间「万物皆可Agent」的口号甚嚣尘上。然而,当开发者试图从琳琅满目的Demo/论文里挑出适合自己的Agent框架,或者从自家打磨了三个月的「看起来能用」的Agent里抠出真正的落地价值时,,以及卡内基梅隆大学、微软研究院、斯坦福大学等机构于2023年8月联合发布的。阅读本文需要具备以下。

AI天才研究院 137

10月13日AI真正的大事:个人Agent开始办事了,但“怎么评、怎么管”也一起来了

今天别只记“Muse Wonder 登榜”“千问 Go!能退钱”“Step 5 进 WorkBuddy”。更该记的是:个人Agent终于从“建议你退货”走到“帮你把货退了”,但 Anthropic 的Agent还在给警察局发假线索,国内已经把全产业链评测尺子立起来。AI 从“我问问它”走到“我让它去办”已经发生了。它帮你拿到70元理赔款的时候,规则、权限和审计,必须和它一起进场。📌 如果千问 Go!

2601_95059317的博客 240

电子纸价签实战:基于SSD1680的墨水屏驱动开发与优化

本文详细介绍了基于SSD1680驱动芯片的电子纸价签开发实战,涵盖硬件连接、驱动框架搭建、核心流程解析及性能优化。重点剖析了初始化配置、波形文件加载、图像数据写入与刷新触发等关键步骤,并提供了功耗优化、显示效果提升及代码健壮性等实用避坑指南,帮助开发者高效实现稳定低功耗的墨水屏驱动。

weixin_28278377的博客 230

10大开源AI Agent平台深度测评:从Demo到生产的实战选型指南

AI Agent 这个概念火了快两年,从最初的“自动写周报”到现在的“模拟软件公司”,听起来越来越酷。但很多开发者,包括我自己,都踩过这样的坑:兴致勃勃地选了一个明星平台,照着教程跑通了Demo,感觉未来已来。可一旦想把Agent集成到自己的业务系统里,或者处理点真实、复杂、带点脏数据的任务,立刻就发现不对劲了——要么是API调用成本高得吓人,要么是私有化部署文档像天书,再不然就是逻辑稍微复杂点,调试起来就像在漆黑的迷宫里找出口。 问题出在哪?很多时候,我们被平台华丽的宣传和简单的Demo迷惑了,忽略了**

weixin_30312563的博客 386

给jetson nano 安装AX200网卡驱动

几经波折,因为在网上看到的基本都是amd版本而非arm版,然后最终选定V5.5是因为更新的几个版本的arm版本是false的(在https://kernel.ubuntu.com/~kernel-ppa/mainline/处选择版本时,得看在arm64上是false还是build succeeded,之前没经验呀刚刚才顿悟的) 1,参考文章https://blog.youkuaiyun.com/MIRANA0/article/details/106696334 学到了得下载如下四个: wget https://k

发嘎嘎的博客 2345

java实现自动发送微信QQ消息(可发图片)

自动发送微信/QQ/微博等消息 一:功能:实现发送QQ/微信/微博消息,程序控制。 效果演示(实现自动发生QQ微信消息给女友,发微博信息也可以就不演示了) 二:原理讲解:将剪贴板的内容给发送到QQ微信中去,复制粘贴发送。 模拟真实操作进行发送信息。 三:前期准备,软件安装,及初步测试。...

XURUNFA950827的博客 1万+

AI 日报|新闻版权诉讼再添两家媒体,AI 评测换上新考题

AI 的竞争正在延伸到模型之外:新闻内容能否用于训练,要接受法律检验;排行榜能否反映真实工作,也需要更新考题。与此同时,本地模型和智能体记忆工具,正把使用门槛往下压。

yu_ban_ai的博客 211

DTW Barycenter Averaging(DBA)——平均序列求法

DBA该算法是用来求序列数据集SS的一致序列(平均序列)。由Franc-ois Petitjean提出的。目前,该方法求得的平均序列是最准确的。 假设一元组为S={s1,s2,⋯,sn}S={s1,s2,\cdots,sn},当SS中的元素为实数时,很容易求的SS的平均值: avg=s1+s2+⋯+snn(1) avg = \dfrac{s1 +s2+\cdots+sn}{n} \qquad\q

光怪陆离 1万+

2026 年 - AI 开发者必备:Agent 开源生态图谱

2026年AI开源项目全景概览 GitHub最新数据显示,AI领域呈现爆发式增长,Agent框架成为最热门赛道,AutoGPT以18.4万星位居榜首。个人AI助手OpenClaw以37.5万星成为现象级项目,RAG、推理部署等工具也蓬勃发展。Python仍是主导语言,微软、阿里等企业及开源社区贡献显著。技术趋势显示:多Agent协作、轻量化部署、结构化输出成为关键方向,AI正加速渗透编程、图像生成等各领域。

爱学习的程序员 1139

STK12与Python联合仿真(一):环境搭建

STK仿真python接口,安装与测试

qq_42635142的博客 1万+

SAP传输请求全流程详解:从SE10创建到STMS跨环境部署(附常见错误排查)

本文详细解析了SAP传输请求的全流程,从SE10创建到STMS跨环境部署,并提供了常见错误排查方法。涵盖工作台请求、定制请求等类型,以及STMS传输原理和实战操作技巧,帮助用户高效管理SAP系统变更。

weixin_29214335的博客 143

27-260411 AI 科技日报 (Agent终于长出五官:MiniMax推全模态CLI)

共收录条资讯。

qq_41862844的博客 925

【网络协议】【TSN】精讲TSN工作原理!图解超赞超详细!!!

TSN有一个服务等级(class of service,CoS)的概念。对TSN网络而言,不同优先级的服务对应图3中的PCP码。3位PCP码定义了0(最低)~7(最高)这8个优先级,传输类型分别对应基础、最大努力、卓越努力、严苛应用、延时和抖动小于100 ms的视频、延时和抖动小于10 ms的音频、内部网络控制、网络控制。其会对网络场景进行不同的匹配,是后续调度、配置设计中会考虑到的数据流调度因素。

风云说通信 2632

AI Agent 竞争焦点转向工程化:技能化、记忆工程与 MCP 工具化的技术栈拆解

AI Agent 竞争焦点转向工程化:技能化、记忆工程与 MCP 工具化的技术栈拆解在过去两周的开源生态观察中,一个不太显眼但方向一致的变化正在发生:GitHub 上最活跃的 AI 项目,越来越多地不是新的基础模型,而是围绕模型构建的工程组件——可复用的技能包、可持久化的记忆系统、可被标准化接入的工具调用层。2026 年第 36 周的趋势周报给出的判断是"AI 已经脱离单纯大模型、聊天机器人范畴,演进为可复用技能包、可编排 Agent、可对接真实上下文的工程体系"[2];

m0_74899094的博客 226

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

从 MCP 工具化到记忆工程:GitHub 两周趋势数据揭示 AI Agent 工程化拐点

2026-10-18 周榜摘要中,wordcraft 条目给出的链接指向 filmcraft 仓库、lightcraft 条目给出的链接指向另一个仓库[3]。这意味着凡引用具体仓库地址,都必须逐条打开确认;本文因此只引用摘要中的项目名称与 star 数,不直接给出有疑问的仓库 URL。

m0_74899094的博客 292

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

AI 日报 · 2026-10-02

今日 AI Coding 与具身智能同频收敛——竞争焦点正从"谁模型更强"切换到"谁能把 agent 安全、可靠地规模部署",平台化运行时、离机安全桥与长程评测已取代单纯参数,成为压过模型性能的新护城河,也直接决定具身估值的兑现与上游订单的能见度。

能源星球的博客 376

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

2026 年 AI Agent 框架选型指南:10 大主流框架横评

AI Agent 框架多到让人眼花缭乱。LangChain、AutoGen、CrewAI、n8n……每个都说自己是"最佳选择"。这篇文章帮你理清思路:10 个框架各是什么定位,适合什么场景,怎么选。

m0_59235945的博客 553

AI Agent 学习路线全解:Agent Learning Hub 从最小 Agent Loop 到生产级 Harness 的实战清单

> 本文以 Agent Learning Hub 仓库的 [README.md](https://link.gitcode.com/i/15f0f425aa27d154b7dad2276299c687) 为骨架,系统拆解一份"可以照着执行"的 AI Agent 学习 todo list:从区分 chatbot 与 agent 的 Stage 0 出发,途经最小 Agent Loop、工具调用与 R

gitblog_00867的博客 1028

GMI Cloud@AI 周报 | MiniMax 发布 Agent 2.0;智谱发布 Flash 轻量模型;Anthropic 10 天发布 Cowork 智能体

本周AI圈有什么大事发生?

GMICLOUD的博客 1007

AI Agent技术突破:Handoff模型如何实现97.7分在线任务执行能力

AI Agent作为人工智能领域的重要分支,其核心在于通过感知、规划、执行、评估的闭环工作流,实现对数字环境的自主操作。这一技术原理使得AI能够像人类一样与图形界面交互,完成从简单点击到复杂多步任务的操作。其技术价值在于将传统需要人工或固定脚本处理的线上流程自动化,显著提升效率并降低操作门槛。在应用场景上,AI Agent特别适用于处理网页数据录入、跨系统信息同步、自动化报告生成等重复性线上任务。本文聚焦的Handoff模型,正是在Online-Mind2Web这一权威评测基准中取得了突破性进展,其97.7

weixin_30571465的博客 366
上一篇: emoji 也能控制语音生成?Irodori-TTS 基于 RF-DiT 架构的日语 TTS;Eczema and Tinea Skin Disease 数据集:支持医学图像分类与迁移学习
下一篇: OpenAI发布GeneBench-Pro,在129个问题/10个领域内评估AI科研能力
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值