从K-mer到自适应词元:厦门大学林琛团队让AI自动学习「基因功能边界」

DNA启动子预测:k-mer编码与XGBoost实战指南 DNA启动子是调控基因表达的关键非编码区域,其序列识别本质上是面向短寡核苷酸模式(k-mer)的分类问题。原理上,转录因子结合具有长度特异性(通常6–12bp),因此k-mer频次能有效捕获进化保守的基序信号,如TATA box;相比one-hot编码,它保留了局部序列上下文,显著提升模型对生物学功能的感知能力。该方法兼具可解释性与小样本鲁棒性,特别适合标注严格但规模有限的实验验证数据集。在临床肿瘤早筛、合成生物学元件设计及NGS数据注释等场景中,已成为连接湿实验与干实验的轻量级落地范式。本文以UCI经典启 阅读详情

在生命科学与生物医学领域,高通量测序技术使基因组数据指数增长。当海量序列远超传统方法解析能力时,人工智能,尤其是深度学习和语言模型,正成为解读基因组「天书」的核心工具。AI 不仅能高效处理巨量数据、挖掘非编码区的调控语法,还在基因功能预测、疾病标志物、蛋白质结构和药物靶点等方面展现巨大潜力。AI 的持续创新正推动基因组学从「数据读取」走向「功能理解」。

在 2026 年第八届北京智源大会上,厦门大学林琛教授在「AI+健康 & 医疗」论坛中,以《用自适应「词元」解读基因组语言》为题,从基因组序列的本质出发,系统阐述了如何将 DNA 序列视为一种有待解读的「生命语言」,并创新性地引入自适应「词元(token)」机制。报告深入探讨了如何通过构建可动态调整的基因组「词典」,使AI模型能够更精准地捕捉 DNA 序列中不同尺度的功能单元与调控语法,从而实现对基因组语言的高效解读与功能理解。

图片

HyperAI 在不违原意的前提下,对林琛老师的演讲分享进行了整理汇总,以下为演讲实录。

基因组基础模型的发展、分词困境与核心挑战

基础模型的概念已为大家所熟知。它起源于自然语言处理领域,核心特征在于大规模预训练结合下游任务微调。在 NLP 中,由于语言天然存在词序列,典型的流程是:分词形成词序列,输入 Transformer 等序列模型,通过 Next Token Prediction 或 Mask Token Prediction 等预训练任务,学习适用于各类任务的通用表征。这一范式在自然语言处理中取得了巨大成功,也启发了其他领域的研究者——如果将 DNA 序列视为「生命的语言」,那么是否可以将 NLP 中成熟的方法论迁移至基因组学?

沿着这一思路,近年来涌现出许多面向 DNA 序列的基因组基础模型。从 2020 年基于 Transformer 的 BigBird,到 2026 年发表于 Nature 的 Evo 2(其初代工作曾于 2024 年发表于 Science),学界关注的焦点主要集中在如何通过改进模型架构以获得更长的上下文——从 2020 年的 4K 长度提升至 Evo 2 的 1M 长度,提升幅度达 250 倍。

然而,我们课题组前期的回溯分析发现,在相同架构下,预训练长度并非越长越好;同时,分词策略对长序列建模能力的影响同样显著。有时,某种分词策略在短序列上的表现甚至优于另一种策略在长序列上的效果,这提示我们:模型能力的提升不能仅依赖架构和上下文窗口的扩展,分词这一基础环节可能才是真正的瓶颈所在。

既然如此,现有分词策略的表现如何?我们对 Kmer 与 BPE 这两种当前经典的分词策略进行了系统评估,发现二者并不存在绝对的全面优势。更为关键的是,这些策略在应用于 DNA 序列时存在根本性的方法论缺陷。自然语言的词间有天然分隔符(如空格),而 DNA 序列缺乏此类显性分隔符,且其语法规则隐晦,难以直观理解。

具体来看,现有工作的局限各有不同:以单核苷酸为词元的方案,好比逐字阅读,效率受限且计算开销大;Kmer 分词(无论重叠与否)则可能破坏真实的生物语义,如同机械地三字或五字一读,完全无视基因组中功能元件的天然边界;另有一些工作借鉴 NLP 中的 BPE 方法,基于统计频率进行分词,虽然数据驱动,但其所得词元的生物学意义尚未得到充分验证。

由此可见,现有分词方法普遍割裂了生物语法,限制了模型泛化性。我们希望能在无监督条件下,自动发掘具有生物学意义的「词源」,使其能对应真实的生物功能元件。但这一目标面临双重挑战:若引入监督信号,虽能引导分词,但依赖昂贵标注且易过拟合,难以发现未知规律;若无监督,则需在海量组合空间中搜索,且离散分词会给梯度回传带来困难。这些正是本工作试图解决的核心问题。那么,我们如何突破这些障碍?接下来介绍我们的解决方案。

GenArt模型:自适应变长分词架构与专家导向微调框架

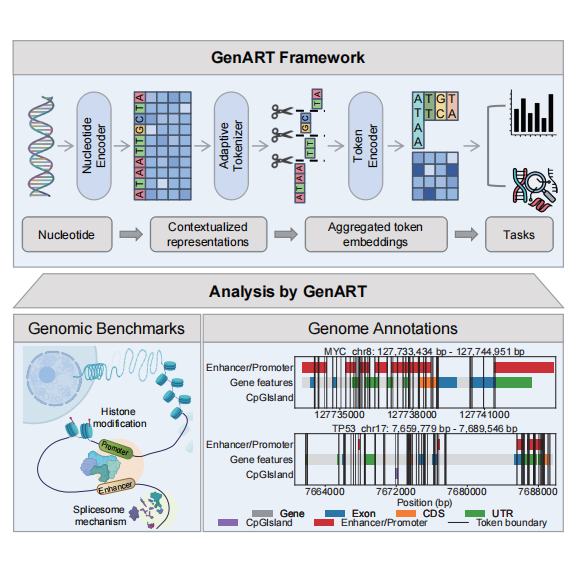
为解决上述问题,我们训练了名为 GenArt(Genome Art,基因组艺术)的模型,在涵盖 15,000 余个物种、总计 530 亿个碱基的预训练数据上完成训练,并发布了 3.5 亿和 10 亿参数量的两个版本。其核心特点在于支持自适应变长分词,能够在无监督条件下自动发掘具有生物学意义的词源边界。

模型架构主要包含三个层次:前端采用基于 Transformer 的单核苷酸编码层,将原始 DNA 序列映射为上下文感知的连续表示;中间嵌入自适应分词层,利用多尺度卷积提取局部特征,并通过 Gumbel Softmax 在相邻碱基位置判断是否切分,实现梯度可导的离散分词决策;后端采用 Encoder-only 的 Transformer 主干,对分词后的词元序列进行全局建模。整个模型端到端可微,使得分词决策能够根据预训练损失进行优化,而无需依赖任何外部标注信息。
图片

整体上下文窗口虽非极长(设计为 4K,与早期 BigBird 相当),但我们进一步引入了可选的专家导向微调框架。其设计灵感来源于阅读时的「精读」与「泛读」策略:允许领域专家根据任务特性控制分词粒度,例如转录因子的结合位点呈尖峰信号,宜采用更精细的分词以捕捉单碱基分辨率信息;而组蛋白修饰则呈现广谱信号,适当放粗粒度反而有助于捕获宏观模式。这一框架通过在微调阶段引入可调的分词超参数,实现了通用模型与领域先验知识的有机融合,且不改变预训练模型的主体结构。

全面超越、消融分析、物种多样性及缩放规律

我们在 9 大类共 33 个下游任务上对标了 Evo 2。结果显示,GenArt 仅使用了 Evo 2 约 5% 的参数量和 0.3% 的训练数据,GPU 开销与训练时间降低了数百倍,却在各项任务上均实现了性能超越。尤为值得关注的是,在长序列任务上 GenArt 表现稳定,优于专门的 SPICE 模型,表明其分词策略并未因上下文窗口较短而损失长程建模能力。

消融实验表明,移除自适应分词模块、改用单核苷酸输入会导致性能显著下降,这直接验证了自适应分词的有效性。通过对词元表征的 t-SNE 可视化可见,GenArt 学到的表征在不同任务间界限清晰——即便在未微调的预训练模型中,这种区分性已然存在,微调后则更为显著。特别地,对于最难区分的增强子预测与剪切位点预测任务,其他模型,即使同样支持变长分词,学到的词元边界高度相似,而 GenArt 能为这两项任务学习到截然不同的词源表征。这一差异表明,GenArt 并非简单地学习统一的「最优」分词边界,而是能够根据任务需求自适应调整词源的语义粒度。

关于预训练物种多样性的影响,我们通过控制变量实验发现:增加预训练物种数虽略微降低模型在人类基因组任务上的性能,但显著提升了在酵母、小鼠及病毒等非人类任务上的表现,并大幅降低了跨任务性能的标准差(降低 3%),说明物种多样性增强了模型的泛化能力。关于模型缩放,随着参数量从 1 亿增至 10 亿,模型性能稳步提升,注意力分布的变异系数下降,表明模型具备了更宏观的「注意力视野」。值得注意的是,平均词元长度随参数量增加而递减,说明模型并非依赖更长的词元来提升性能,而是通过全局注意力动态拼装长距离语义,这是一个反直觉但颇具启发性的发现。

引入专家导向微调策略后,各任务 MCC 指标均获得一致提升,且不同任务(如尖峰模式的 H3K4me3 与广谱模式的其他表观遗传标记)呈现出显著不同的分词参数偏好,验证了定制化词源的有效性。这些实验从多个维度证明了 GenArt 在性能、泛化能力和灵活性上的优势。

生物学功能边界验证

最后,我们验证了模型自动捕获功能元件边界的能力。对于需要单碱基精度的甲基化位点,召回率达 0.8;对于多碱基的功能元件(如 CDS、增强子、CpG 岛等),平均召回率达 0.629。在无监督方法中,这一精度提升了 10 倍,且词元长度多集中在 3-8 个碱基,高度符合生物学 Motif 的规律。全基因组范围内的召回率稳定在 0.5-0.7 之间,表明分词边界与真实注释高度吻合,而这一切均来自无监督学习,模型从未接触过任何功能元件的标注信息。

总结而言,本工作证明了在无显式监督下,可通过生物学驱动的方式学习生物元件的真实功能边界,填补了强监督分割与纯统计语言模型之间的空白。我们提出的通过分词超参数桥接通用大模型与领域专家模型的范式,对于基因组学以外的其他序列建模任务也具有普遍参考意义。

但当前工作的局限性在于:第一,虽发现了高特异性新词元,但仍需湿实验验证其功能;第二,受限于 Transformer 架构,上下文窗口仍有扩展空间,后续可探索线性注意力或状态空间模型以突破该瓶颈;第三,表征依赖下游微调,零样本泛化能力有待提升。

关于林琛教授及其团队

林琛教授是人工智能与数据科学领域的杰出学者,目前为厦门大学教授、博士生导师。她的研究工作主要聚焦于人工智能、数据挖掘及其在交叉学科的应用,尤其以「AI for Science」为鲜明特色,致力于将最前沿的人工智能方法应用于生物医学领域。

在学术成就方面,林琛教授以通讯作者在Nature Machine Intelligence、 Nature Communications 和人工智能的旗舰会议和期刊上发表论文超过 100 篇,以通讯作者身份获得 NeurIPS 2024 最佳论文奖亚军和 ICIC 2024 最佳论文奖,并获IEEE青年科学家奖和河南省科技进步一等奖。她主持了包括国家自然科学基金重点项目在内的多项国家级科研项目,同时获得腾讯、华为、百度、阿里巴巴、蚂蚁集团等头部科技企业的科研基金支持。

在科研落地方面,林琛教授团队研发的算法在支付宝、手机淘宝,蚂蚁在线诊疗、OceanBase数据库系统,OpenGauss数据库系统、福建电网数据系统实际部署,产生直接经济效益数十亿元。

参考链接:

1.厦大信息学院林琛加盟同济-网大论坛 - Powered by Discuz!

2.同济大学主页平台管理系统 林琛--中文主页--首页

3.林琛团队在自动化生物医学研究领域取得新进展-厦门大学健康医疗大数据国家研究院

肺癌多肽活性预测:AAIndex与k-mer融合建模实战 多肽序列分类是生物信息学中典型的序列到标签映射任务,其核心在于将离散氨基酸字符串转化为可计算的数值特征。原理上需兼顾物化属性的生物学意义与局部序列模式的统计判别力,技术价值体现在降低抗癌先导化合物实验筛选成本、提升早期发现效率。典型应用场景包括药物虚拟筛选、靶向肽设计验证及教学级可复现AI项目开发。本文基于真实膜裂解型抗癌多肽数据集,系统实践AAIndex编码与k-mer频次统计的融合特征工程,并在Python与Weka双平台完成SVM建模、SHAP可解释性分析及轻量API部署,为小样本医疗序列建模提供端到 阅读详情

相关推荐

AI驱动mRNA翻译效率优化:9个关键位点突变提升60%蛋白质产量

大家好,我是专注于生物信息学与AI交叉领域的技术博主。在疫苗研发和mRNA疗法中,一个核心瓶颈是mRNA序列的翻译效率——即使设计出完美的抗原编码序列,如果mRNA本身不稳定、二级结构复杂或密码子使用不佳,其在细胞内的蛋白质产量也会大打折扣,导致大量精心设计的序列沦为“无用RNA”。最近,斯坦福大学等机构的一项研究带来了突破性思路:他们利用人工智能模型,仅通过修改mRNA序列中9个关键位点的核苷酸,就成功将超过60%的低翻译效率序列“复活”,大幅提升了蛋白质产量。这不仅是生物技术的进步,更是AI驱动生命科学

weixin_29031057的博客 319

机器学习识别DNA启动子:k-mer特征与SVM/RF实战

启动子是基因转录调控的核心DNA元件,其精准识别是理解基因表达、支撑合成生物学与疾病研究的基础任务。其本质是将离散的ATCG序列转化为可建模的数值特征,并在小样本约束下构建高泛化、可解释的二分类模型。k-mer频次统计因其生物可解释性、对短序列鲁棒性及计算高效性,成为启动子预测中最常用且最可靠的手工特征工程方法;而SVM(RBF核)与随机森林则凭借对小样本的良好适应性、抗过拟合能力及特征重要性输出,在该任务中显著优于XGBoost等复杂模型。本方案适用于大肠杆菌等原核系统,亦可迁移至真核启动子初筛、CRIS

weixin_29038155的博客 365

AI破解RNA翻译瓶颈:深度学习优化疫苗研发效率

在疫苗研发和生物制药领域,一个长期存在的瓶颈是:许多设计精良的RNA序列,在进入细胞后却无法被高效地“翻译”成蛋白质,导致疫苗或药物的效力大打折扣。传统方法往往需要大量试错,耗时耗力。近期,一项由斯坦福大学等机构主导的研究,通过人工智能(AI)技术,仅对RNA序列进行9个关键位点的微小修改,就成功让超过60%原本“无用”的RNA序列恢复了翻译活性,为突破疫苗研发的翻译瓶颈提供了革命性的新思路。 本文将深入解析这项研究背后的技术原理,并探讨如何利用深度学习模型来理解和优化RNA的翻译效率。无论你是对AI在生物

weixin_29035147的博客 223

AI+生命科学如何落地?从序列解析到蛋白质模型的最小工具链

人工智能技术在生命科学领域的渗透,正从辅助工具走向自主科研助手。面对DNA、蛋白质、结构数据与文本等多模态信息,传统生物信息学处理方式逐渐遇到瓶颈,而大模型与基础模型为跨类型推理提供了新路径。理解序列编码、K-mer切分、蛋白质语言模型与检索增强生成(RAG)等核心概念,是构建AI生物信息学工程能力的基础。实践中,通过BioPython解析FASTA、调用ProtBERT生成序列嵌入、利用向量检索实现文献知识召回,即可搭建一条覆盖数据采集、模型推理与知识查询的最小验证闭环。该链路不仅可复现,还能支撑基因变异

weixin_33912246的博客 671

OMG宏基因组数据集解析与DNA大模型训练实战

宏基因组学作为生物信息学的重要分支,通过高通量测序技术解析微生物群落遗传信息。其核心挑战在于海量数据的获取与标准化处理,而开源数据库如OMG(Open Microbial Genome)通过整合全球20万+环境与宿主样本,为研究者提供经过统一质控的标准化数据集。在深度学习领域,这类结构化生物数据特别适合训练DNA大模型,需要经过k-mer特征编码、螺旋位置编码等特殊处理。工程实践中,采用TFRecord格式打包小文件、RAMDisk缓存等技巧可显著提升GPU利用率。该技术方案在微生物功能预测、跨域迁移学习等

weixin_33309048的博客 367

ASP.NET三层架构进销存系统实战:从职责划分到事务边界

三层架构是软件工程中经典的职责分离模型,将界面、业务逻辑与数据访问解耦,广泛应用于企业级Web系统开发。在进销存管理系统中,其核心价值在于通过UI、BLL、DAL的分层协作,清晰实现采购、销售、库存等复杂业务闭环。本文从三层架构的基本原理出发,结合ASP.NET与SQL Server技术栈,深入讲解层间职责分配、数据库表设计、参数化SQL及事务控制等关键技术实践,并针对源码包部署中常见的连接配置、程序集引用、库存扣减异常等真实问题给出可落地的排查方案。无论你是正在完成课程设计的学生,还是希望搭建内部小系统的

weixin_33767813的博客 305

英辰朗迪AI获客每日AI精选(2026.08.09)

英辰朗迪AI获客每日AI精选(2026.08.09)

336

【日常小结】项目Modbus RTU 协议

Modbus RTU(远程终端) 协议 一、前言 最近因为码跺宽度测量项目推广升级,更换了摄像头(换成了基恩士摄像头)和光栅(换成了施莱格05LCM系列光栅),导致原来的程序用不了了,然而这个软件升级的任务落到了我身上,作为机械非科班出身的我要学习TCP和Modbus RTU通信协议,也算是自我突破了。本文只对Modbus/RTU/HEX 进行简单的小结。 二、Modbus Modbus是一种串行通信协议,是Modicon公司(现在的施耐德电气Schneider Electric)于1979年为使用可编程逻

weixin_39681471的博客 831

DNABERT vs 传统方法:为什么Transformer模型是基因组学的未来?

在基因组学研究的快速演进中,DNABERT作为首个基于Transformer架构的DNA语言预训练模型,正在彻底改变我们对基因序列分析的理解方式。这篇文章将深入探讨DNABERT如何超越传统基因组学方法,以及为什么Transformer模型代表了基因组学的未来发展方向。 ## 🧬 DNABERT:基因组学领域的革命性突破 DNABERT(DNA Bidirectional Encoder R

gitblog_00036的博客 1014

MATLAB机械臂轨迹规划:在关节空间中生成多项式轨迹以及 jtraj函数(内容超详细讲解)

matlab机器人仿真,关节空间多项式轨迹生成

qq_40969179的博客 1万+

保姆级教程:在摩尔线程MTT S80上快速部署Ollama运行DeepSeek R1模型(附性能测试)

本文提供了一份详细的保姆级教程,指导用户在摩尔线程MTT S80显卡上部署Ollama并运行DeepSeek R1模型。内容涵盖从驱动安装、Docker环境配置到模型拉取、性能测试的全流程,并分享了实测数据与优化技巧,旨在帮助开发者快速在国产GPU平台上实现高效的大语言模型推理。

weixin_29091837的博客 525

受DeepSeek Engram启发,基因组基础模型「外挂大脑」Gengram最高实现22.6%性能提升

华大生命科学研究院与浙江之江实验室组成的 Genos 团队在 DeepSeek 新模式的启发下,推出了一款基因组专用「外挂大脑」插件——Gengram(Genomic Engram)。仅约 2,000 万参数,即刷新了多项基因组任务的 SOTA 记录,为破解基因组建模瓶颈提供了革命性方案。

HyperAI超神经 971

java实现mavlink协议解析与封包上传数据,实现mavlink数据交互,附带代码、详解

本篇文章介绍了使用java来进行mavlink协议解析,封包与解包的过程,并附带源码供大家使用。MAVLink(Micro Air Vehicle Link,微型空中飞行器链路通讯协议)是无人飞行器与地面站(Ground Control Station ,GCS)或云端服务器之间通讯,以及无人飞行器之间通讯最常用的协议。它已经在PX4、APM、PIXHAWK和Parrot AR.Drone飞控平台上进行了大量测试。

qq_30279827的博客 1449

AI生成病毒序列?拆解技术链路与生物安全边界

人工智能在生物技术领域的应用日益深入,从蛋白质结构预测到基因序列设计,AI正成为科研人员的得力工具。然而,“AI创造新病毒”的报道往往省略了关键环节:模型输出的只是序列候选,真正形成病毒还需要湿实验验证、生物安全审查和伦理评估。理解序列生成与实体构建的区别,是评估技术风险的基础。生成模型、大语言模型等AI方法在病毒进化分析、疫苗抗原优化和药物筛选中发挥防御性价值,而非鼓励病原体制造。对于AI工程师来说,进入这一交叉领域需要关注数据合规、模型选择、避免数据泄漏和类别不平衡等工程问题。文章还提供了评估项目是否值

weixin_34006965的博客 413

机器学习笔记:估算模型训练所需的样本量的方法

相反,如果训练得分高而交叉验证得分低,那么模型可能存在过拟合问题,需要更多的样本来提高泛化能力。本文将介绍一些常用的方法来估算模型训练所需的样本量,并提供相应的源代码。除了经验法则和学习曲线法,还有一些统计学方法可以用于估算模型训练所需的样本量。学习曲线是一种通过绘制模型性能与样本量之间的关系曲线来估算样本量的方法。需要注意的是,这些方法仅提供了估算样本量的指导,具体的样本量仍然需要根据实际情况进行调整和优化。通过合理估算样本量,可以提高机器学习模型的性能和泛化能力,从而更好地应用于实际问题中。

HnrzLinux的博客 2732

国科大《人工智能原理与算法》2021年期末试题+2024经验(2025指南)

2021年期末试题+24年复习指南

MatsumotoChrikk 2927

OMG数据集:构建宏基因组AI的ImageNet级多模态基准

在计算生物学与人工智能交叉领域,高质量、标准化的基准数据集是推动模型从研究走向应用的关键基础设施。其核心价值在于提供统一的评估框架,使不同算法能在公平环境下进行比较与迭代,从而加速技术发展。这类数据集通常通过整合多源异构数据,并对其进行严格的清洗、对齐与标注来构建,其技术原理涉及数据工程、特征表示学习及多模态融合。从技术价值看,一个设计良好的基准不仅能降低研究门槛,促进跨学科合作,更能驱动模型架构的创新,例如探索如何有效融合序列、结构、功能等多维度信息。在应用场景上,此类数据集尤其适用于宏基因组学这类数据密

weixin_33858336的博客 585

重回童年的经典系列☀️| 【坦克大战3D版】游戏制作+解析

带你重回童年的经典系列——坦克大战3D版制作,感兴趣的可以看看呀~

努力前行,总会成为自己心中的那道光 5万+

GenoJEPA:基因组AI的高效计算与特征优化

基因组AI技术通过深度学习模型处理DNA序列数据,其核心挑战在于计算效率与特征表示的优化。传统方法常面临计算资源消耗大、模型调参复杂等问题。GenoJEPA框架创新性地将DNA序列视为自然图像处理,通过连续分块策略和联合嵌入预测架构,显著提升了计算效率并优化了特征表示。这一技术不仅降低了基因组AI的应用门槛,还使其在增强子预测、启动子识别等任务中表现优异。结合Transformer架构和对比学习原理,GenoJEPA为生物信息学研究提供了高效、稳定的解决方案,特别适合临床诊断和罕见病研究等实际应用场景。

weixin_28223453的博客 261

使用Spring Cloud实现银行核心系统的案例示例

以下是一个基于Spring Cloud的银行核心业务系统实现方案,涵盖架构设计、关键模块实现与生产级部署方案。该系统设计满足金融级高可用、强一致性和监管合规要求。

银行信息系统应用架构详解 1173

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Transformer模型在海洋微生物基因序列挖掘与天然产物发现中的应用

Transformer架构作为自然语言处理领域的核心模型,凭借其强大的序列建模和长程依赖捕捉能力,已成为处理复杂序列数据的通用框架。其自注意力机制能有效建模序列中任意位置间的关联,这一原理使其从文本处理成功迁移至生物信息学领域。在基因序列分析中,这种技术价值尤为突出,它能将DNA序列视为由碱基构成的“语言”,通过学习其内在模式来解读功能信息。应用场景广泛,尤其在挖掘宏基因组数据中的生物合成基因簇(BGCs)以发现新型天然产物(如抗生素、抗癌药)方面潜力巨大。本文探讨的DeepSeMS模型正是这一思路的实践,

weixin_30561177的博客 304

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

AI生成完整噬菌体基因组:从设计到验证的突破

人工智能正在深刻改变生命科学的研究范式,尤其在生物序列生成与设计领域,DNA开始被当作一种可学习的“语言”来对待。借助自然语言处理中的Transformer架构与生成模型,AI能够从海量基因组数据中学习序列的内在规律,并生成全新的功能序列。这一技术路径的价值在于突破传统生物实验的试错成本,让研究人员得以在计算机中快速完成基因组的初步设计、筛选与优化,进而服务于合成生物学、医疗健康和农业环保等应用场景。近期,AI首次生成了完整的噬菌体基因组,并通过湿实验验证其具备存活和抑制细菌的能力,这标志着“AI设计生命”

weixin_34301132的博客 498

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

DNABERT在基因调控研究中的创新应用:3个真实案例分析

DNABERT是一款基于Transformer架构的DNA语言预训练模型,专为基因组序列分析设计。通过将DNA序列转化为计算机可理解的"语言",DNABERT为基因调控研究提供了强大的AI工具,帮助科研人员更高效地揭示基因组中的隐藏规律。本文将通过3个真实应用案例,展示DNABERT如何在基因调控研究中发挥关键作用。 ## 案例一:SNP致病性预测——精准识别疾病相关基因突变 单核苷酸多态性(

gitblog_00148的博客 346

51c大模型~合集18

2024 年被很多圈内人士称为 AIGC 应用元年,大家关注的焦点不再只是拼参数和基础能力了。在由模型层向应用层转移的趋势下,率先在垂类领域和场景落地 AI 才能赢得更多用户和市场。尤其是面向 C 端赛道的人机交互,更天然地需要围绕用户需求做文章。这一点在社交领域有着很好的体现。此前 AlienChat 等多款恋爱 App 停服,「第一批和 AI 恋爱的年轻人失恋」讨论话题上了热搜。在这背后,功能同质化是一部分原因,还在于体验上没有从助手 / NPC 角色转变为真正提供情绪支持的陪伴者。

whaosoft~aiotの开发板商城 2188

基因组语言模型:从读取序列到生成新型噬菌体

在AI for Science的浪潮中,语言模型不再局限于理解生物序列,而是开始尝试“写”出全新基因组。基因组语言模型通过学习海量噬菌体序列的上下文依赖和模块组合规律,能够生成统计上合理的候选序列。这项技术的核心价值并非一次生成完整基因组,而是构建了“生成-过滤-湿实验验证”的闭环:数字层面过滤长度、GC含量、编码能力,再通过合成与噬菌斑实验验证真实功能。相比传统基因工程依赖天然骨架,生成式设计扩大了序列搜索空间,有望应用于耐药菌感染的噬菌体治疗,以及合成生物学中的模块重排与序列优化。理解其原理与评估边界,

weixin_32501329的博客 311

AI设计病毒并非造出病毒:从序列生成到生物安全工程治理

人工智能生成式模型正加速进入生物序列设计领域,从结构预测、功能注释到序列生成,技术路线日益成熟。生成式模型通过学习海量序列数据,可以输出训练集中不存在的新序列,为蛋白设计、抗体改造和基因线路构建带来新机遇,但也使得“AI设计病毒”这类议题受到关注。事实上,AI真正完成的只是候选序列的生成,距离获得具有完整感染能力的病毒仍隔着合成、组装与湿实验验证等漫长链条。从安全视角看,核心风险并不在于模型是否聪明,而在于能力门槛被显著降低,双重用途研究与能力扩散由此成为治理重点。工程层面需要构建覆盖数据分级、输出安全筛查

weixin_33857230的博客 395
上一篇: 活动预告|智源/TileRT/腾讯/华为/智元创新同台,共探 AI 编译的多层级协同优化
下一篇: emoji 也能控制语音生成?Irodori-TTS 基于 RF-DiT 架构的日语 TTS;Eczema and Tinea Skin Disease 数据集:支持医学图像分类与迁移学习
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值