在线教程丨支持600+语言,小米开源OmniVoice:仅需3-10秒参考音频实现语音克隆

小米OmniVoice语音克隆技术解析:600+语言支持与3秒极速克隆实战 语音克隆技术作为语音合成领域的重要分支,其核心原理是通过深度学习模型提取说话人的声纹特征,并将其迁移到新的文本内容上,实现个性化语音生成。这项技术的价值在于能够大幅降低高质量语音内容的制作门槛,提升人机交互的自然度与包容性。在实际应用中,它广泛服务于无障碍沟通、多语种内容创作、虚拟数字人交互等场景。本文聚焦于小米开源的OmniVoice项目,该项目在**多语言支持**与**短音频克隆**方面实现了显著突破,通过统一的音素空间表示和高效的说话人编码技术,仅需3-10秒参考音频即可支持超过600种语言的语音克隆 阅读详情

随着 AI 语音技术快速发展,文本转语音(TTS)模型正从「能说话」迈向「像真人一样自然交流」,但在多语言覆盖、零样本语音克隆以及复杂口音与方言支持等方面,现有系统仍普遍面临生成链路复杂、训练成本高、跨语言泛化能力有限等问题。

在这一背景下,OmniVoice 的发布,为多语言语音生成带来了新的突破。该模型由 Xiaomi AI Lab Next-gen Kaldi 团队推出,支持超过 600 种语言,并同时具备 Voice Clone、Voice Design 与 Auto Voice 等能力。相比传统 TTS 模型普遍采用的「文本→语义→声学」两阶段生成流程,OmniVoice 采用了一种类似扩散语言模型的离散非自回归(NAR)架构,可直接将文本映射为多码本声学 token,大幅简化了语音生成链路。

这种架构上的变化,不仅降低了传统离散 NAR 模型在复杂流程中的性能瓶颈,也让 OmniVoice 在语音自然度、可懂度以及跨语言一致性上取得了更好的表现。与此同时,模型还引入全码本随机掩码训练策略,并基于预训练大语言模型进行初始化,在提升训练效率的同时,进一步增强了语音生成质量。

更重要的是,OmniVoice 并不只是一个「支持多语言」的 TTS 模型。它不仅覆盖中文、英文、日文、韩文等主流语言,还支持河南话、四川话、东北话等中文方言,以及美式、英式、澳式、印度口音等多种英语变体。配合仅需数秒参考音频即可完成的零样本语音克隆能力,使其在 AI 配音、数字人、跨语言内容生成以及全球化语音交互等场景中展现出极强的应用潜力。

目前,HyperAI 官网(hyper.ai)的教程版块已经上线了「OmniVoice:支持 600+ 语言的高质量 TTS」,一键即可启动,低门槛部署。

在线运行:

https://go.hyper.ai/oxpij
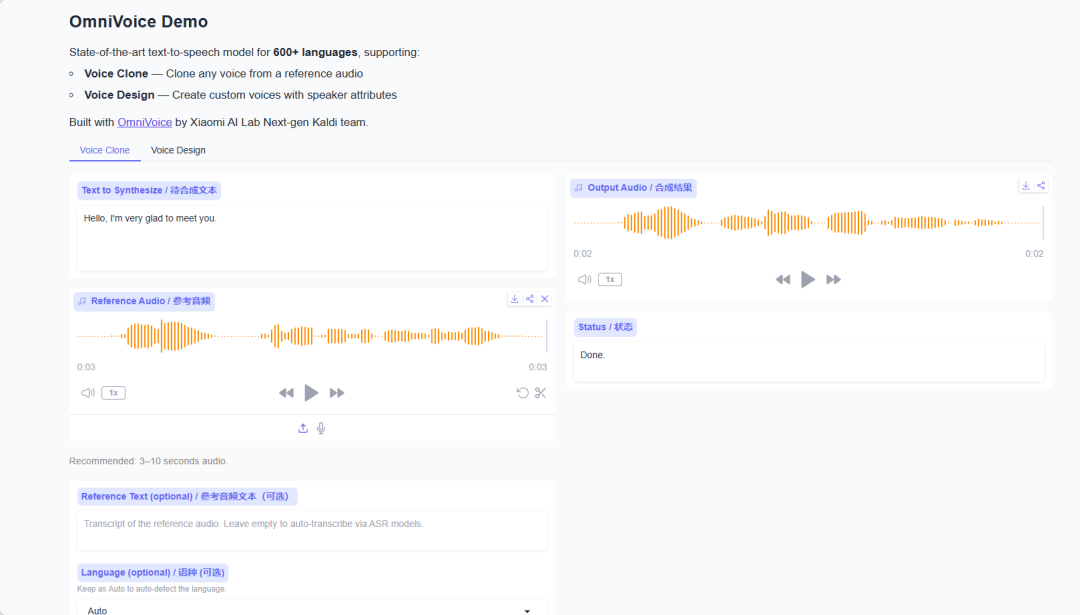
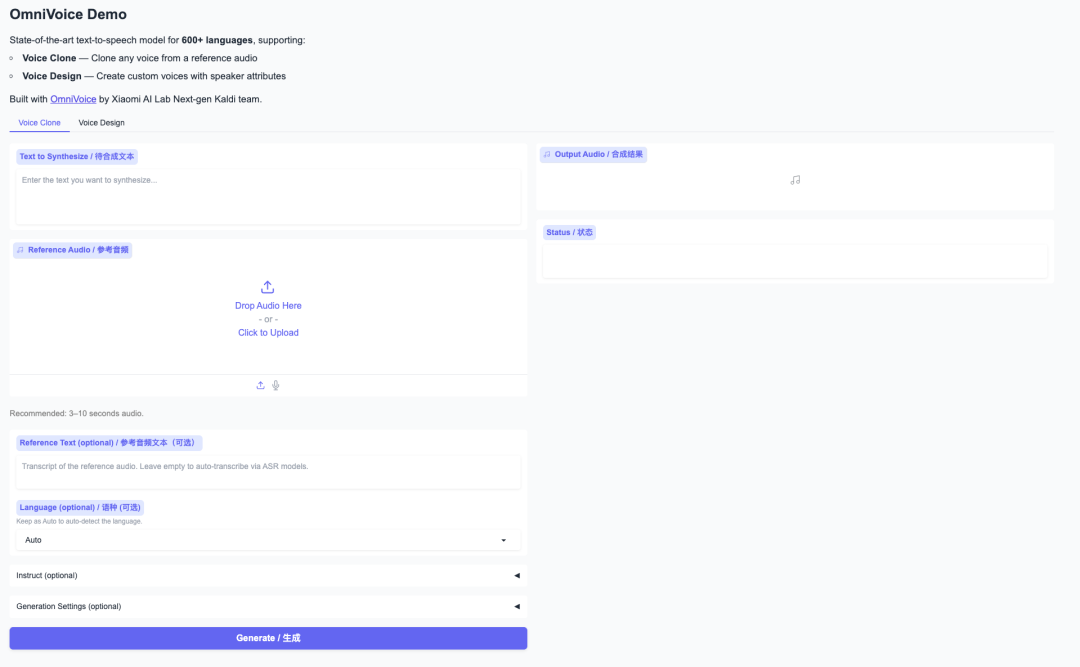
图片

demo 示例

更多在线教程:

https://hyper.ai/notebooks

欢迎登录官网查看更多内容:

https://hyper.ai/

Demo 运行

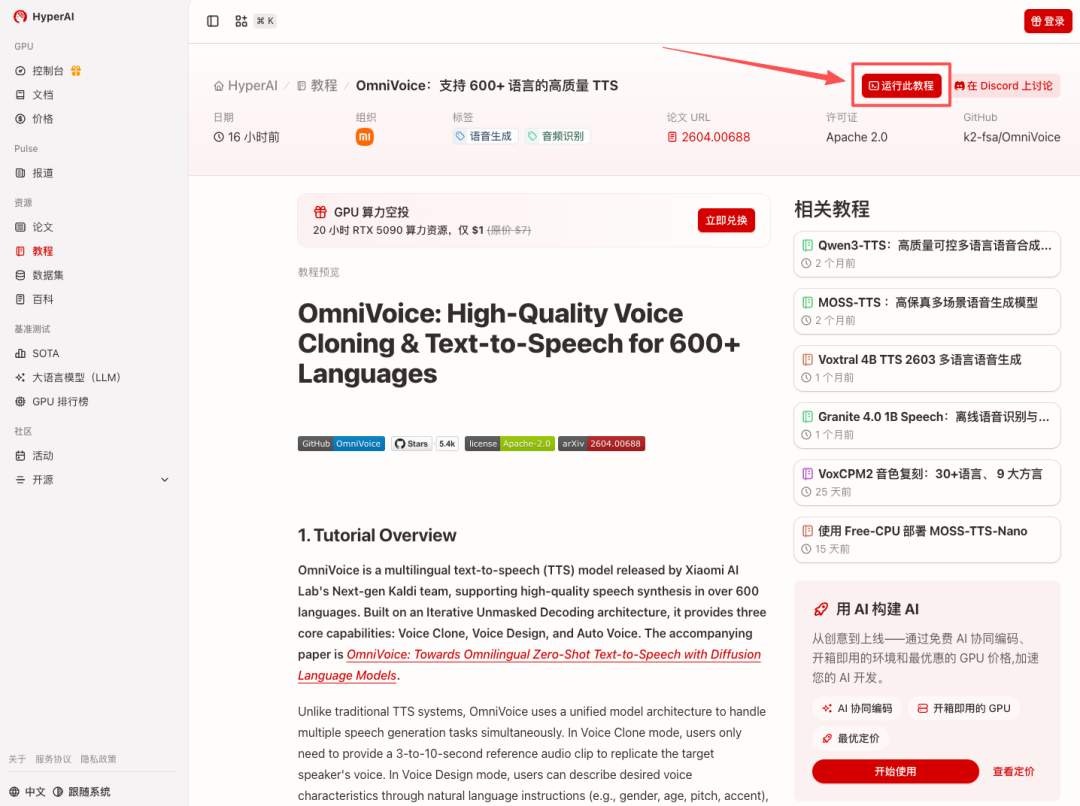
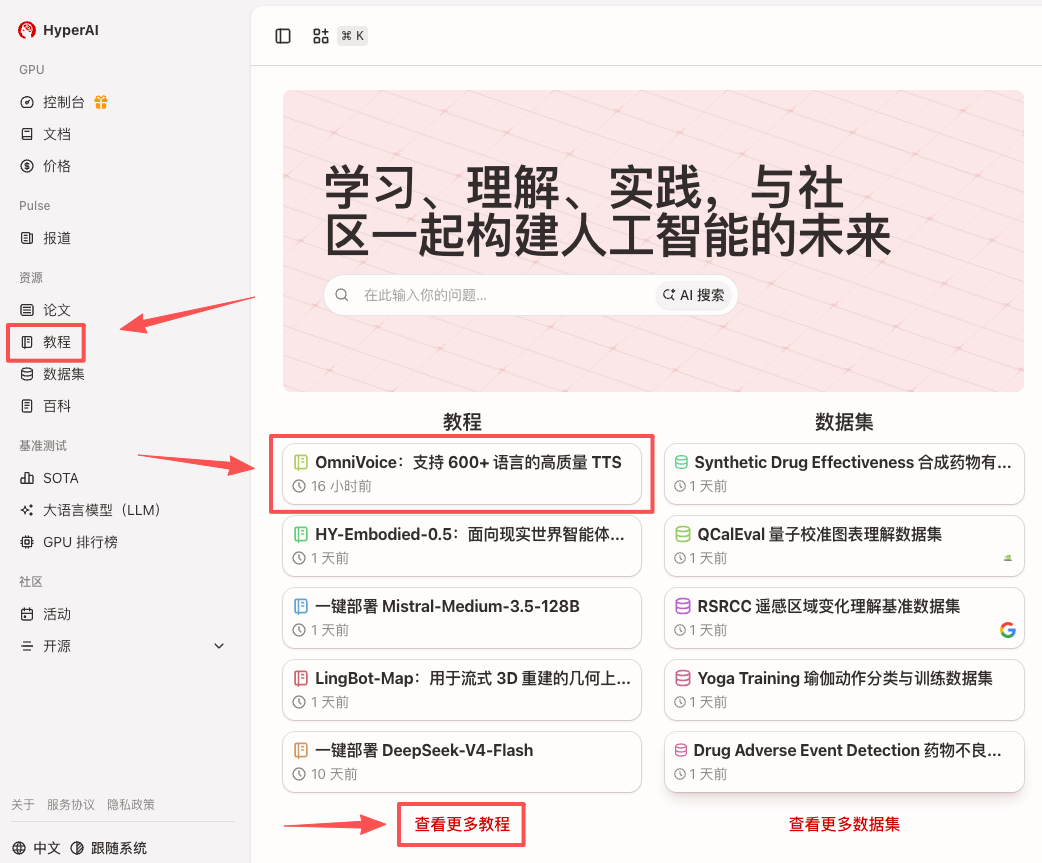
1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「OmniVoice:支持 600+ 语言的高质量 TTS」,点击「运行此教程」。
图片

图片

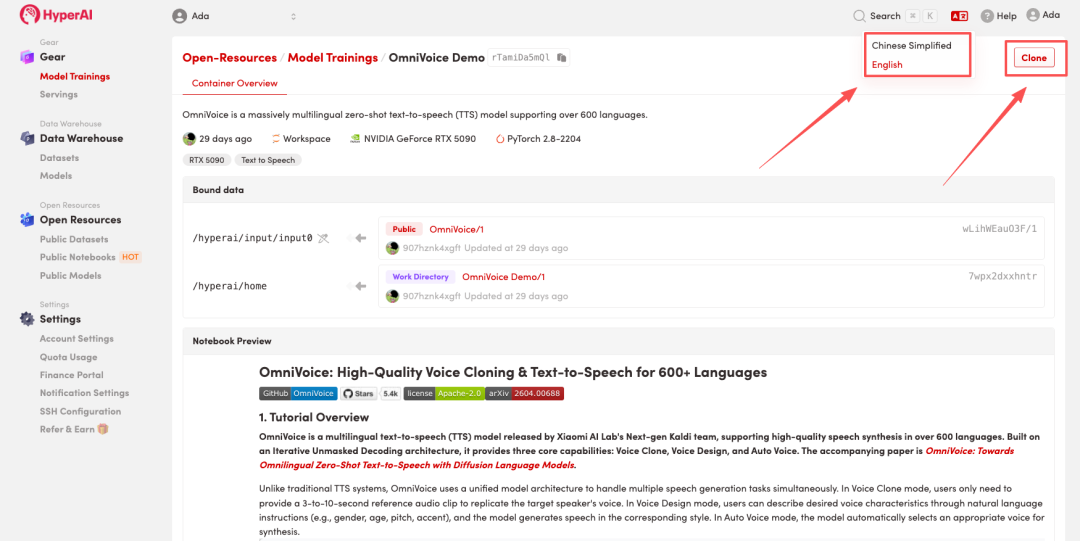
2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。

注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。
图片

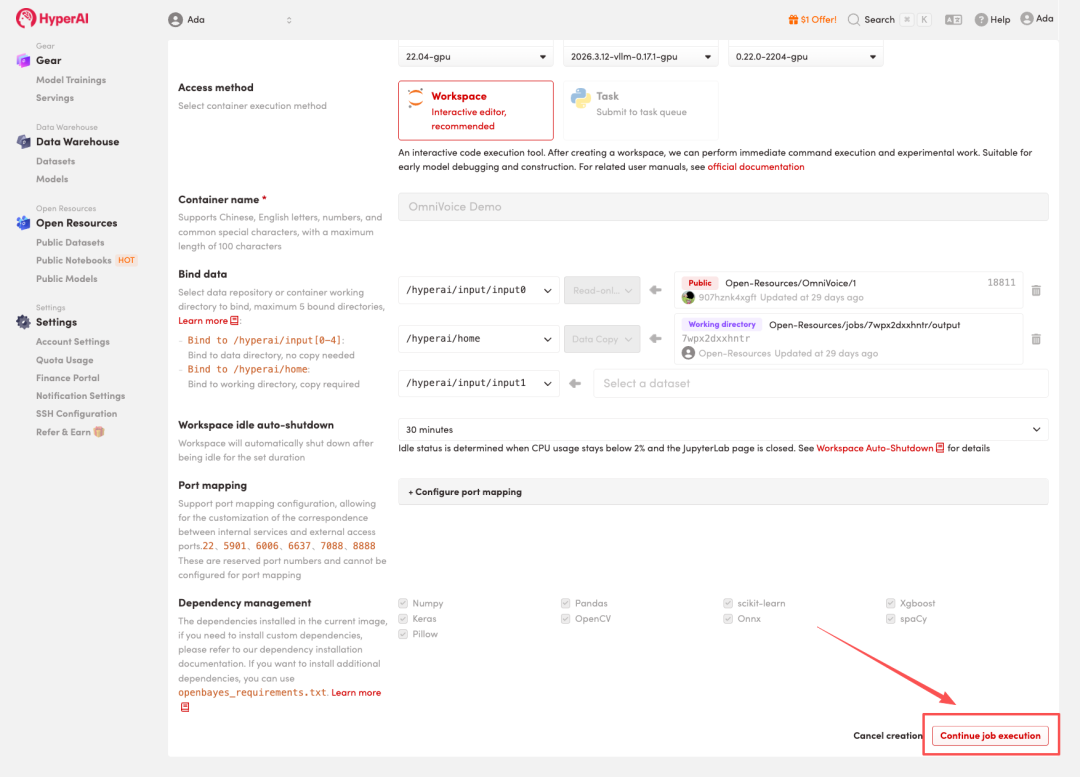
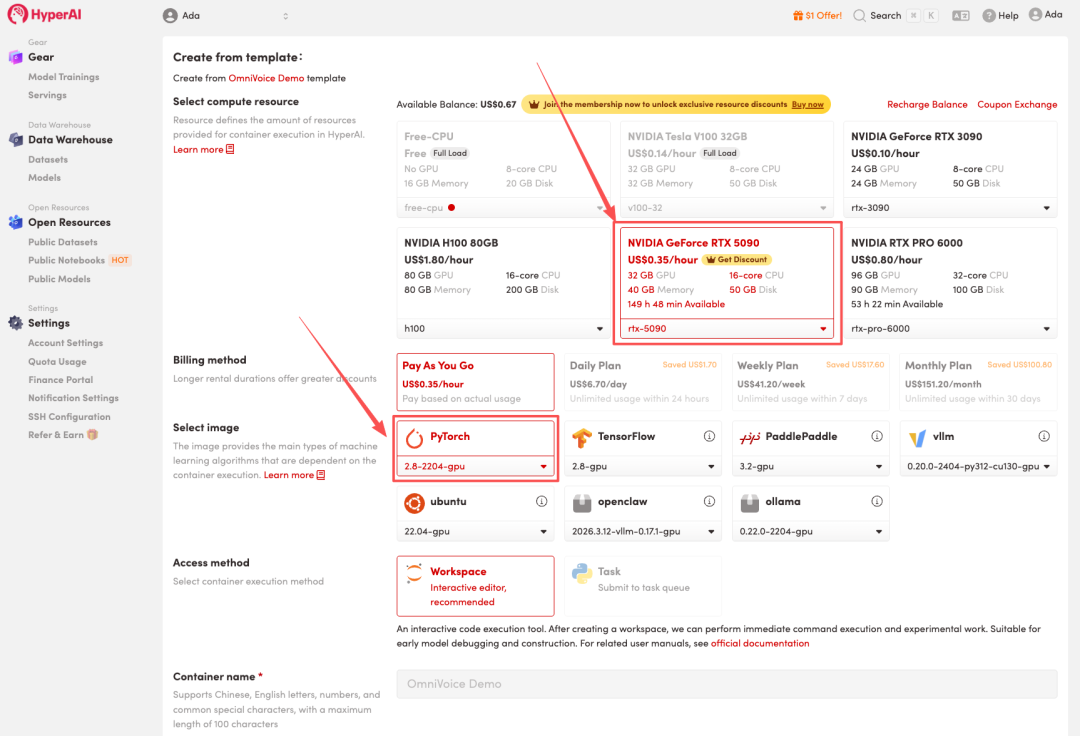
3.选择「NVIDIA RTX 5090」以及「PyTorch」镜像,点击「Continue job execution(继续执行)」。

HyperAI 为新用户准备了注册福利,仅需 $1,即可获得 20 小时 RTX 5090 算力(原价 $7),资源永久有效。
图片

图片

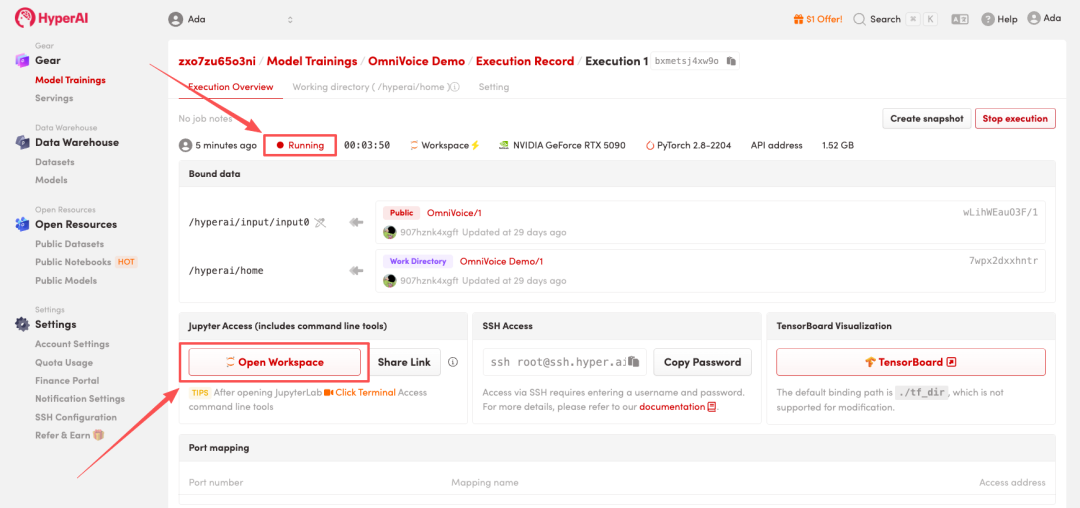
4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。
图片

效果展示

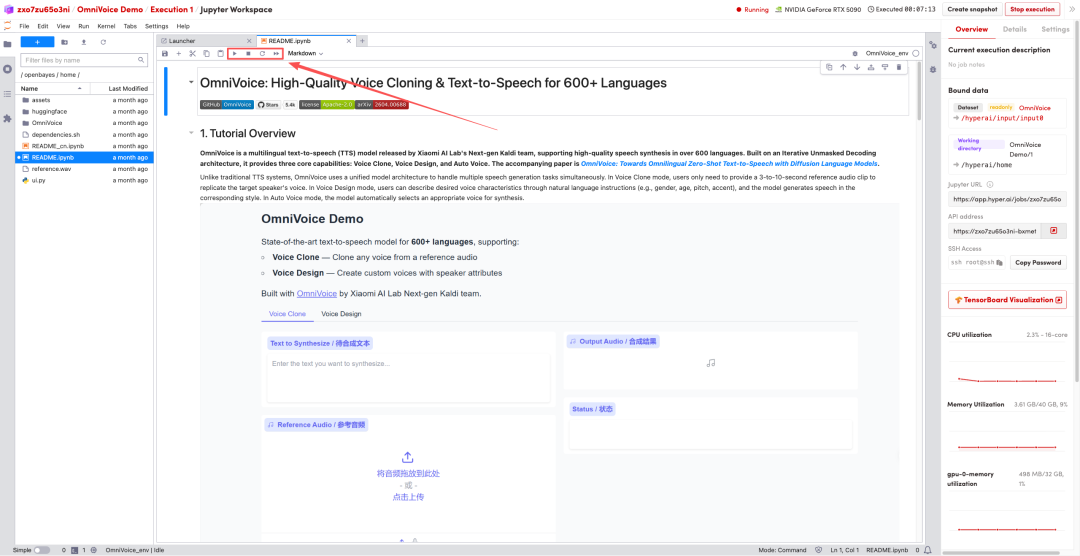
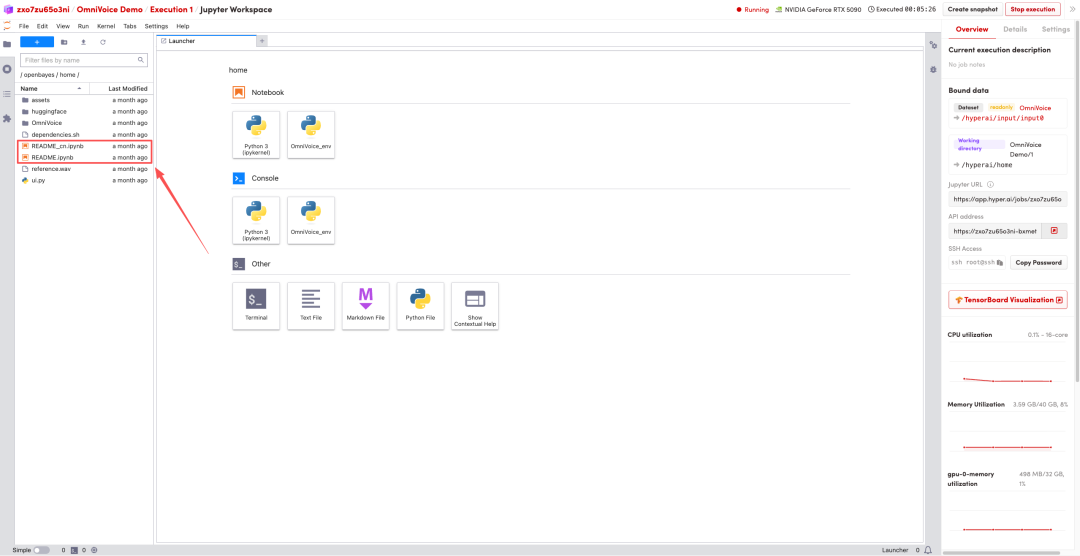
1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。
图片

图片

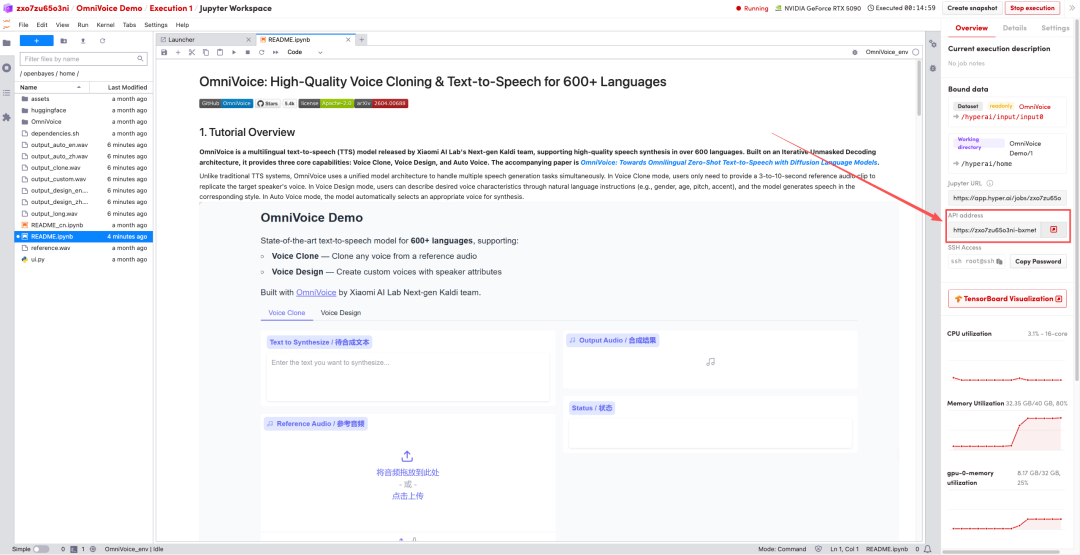
2.待运行完成后,即可点击右侧 API 地址跳转至 demo 页面。

图片

图片

小米开源OmniVoice与VoxCPM2:零样本语音克隆与600+语言TTS实战解析 语音合成(TTS)技术旨在将文本转换为自然流畅的语音,其核心原理通常基于深度学习模型,如VITS架构,通过编码文本信息并解码为声学特征,再经声码器生成波形。这项技术的价值在于极大地降低了语音内容的生产门槛,提升了信息获取的无障碍性。其应用场景广泛,涵盖智能助手、有声内容创作、多语言服务与辅助技术等领域。本文聚焦于近期引发关注的**OmniVoice**与**VoxCPM2**开源项目,它们分别作为支持超600种语言的TTS基础模型和仅需单段音频即可实现高保真声音复刻的框架,代表了当前**零样本语音克隆**与 阅读详情

相关推荐

Win10安装OmniVoice 部署本地TTS服务

OmniVoice 是小米 AI 实验室开源的多语言文本转语音模型,支持 600 多种语言和语音克隆功能。本文提供 Windows 系统完整安装指南:需 Python 3.11+、10-14GB 空间,推荐 NVIDIA GPU 加速。安装步骤包括设置 Python 环境、安装 Git、配置 PyTorch(支持 CUDA 或 CPU 模式),并通过 PIP 安装 OmniVoice 包。支持命令行和 Python API 两种使用方式,可实现基础 TTS、语音克隆(3-10秒参考音频)、语音设计和情感控制

bellus 441

OmniVoice:支持600+语言的AI语音合成新突破

**导语**:OmniVoice——一款突破性的多语言文本转语音(TTS)模型正式亮相,其支持超过600种语言的零样本语音合成能力,为全球信息无障碍和跨文化交流带来革命性变化。 **行业现状**:全球约7000种语言中,仅有不到10%拥有成熟的语音合成技术支持。随着AI技术的飞速发展,多语言TTS模型逐渐成为打破语言壁垒的关键工具。然而,现有解决方案普遍存在语言覆盖范围有限、小语种支持不足、语音

gitblog_00929的博客 1109

Comsol 弧形声学换能器声聚焦仿真

1. 弧度和曲率半径:弧形声学换能器的形状和曲率半径对声聚焦效果有重要影响。通常,较小的曲率半径和较大的弧度可以实现更强的声聚焦效果。弧形声学换能器声聚焦是指将声波能量集中在弧形声学换能器的特定区域内,以实现更强的声场强度和分辨率。4. 数值仿真和优化:使用声学仿真软件进行数值仿真可以帮助设计和优化弧形声学换能器的声聚焦效果。通过调整几何参数、材料特性和激励信号等参数,可以模拟和优化声聚焦效果。2. 激励信号:通过调整激励信号的频率和幅值,可以实现声波在弧形声学换能器中的聚焦效果。

声学黑洞仿真工作室 1617

OmniVoice 中文便携版发布:600+语言语音克隆,解压即用,无需配环境!

OmniVoice中文便携版发布,这是一款开箱即用的开源TTS语音克隆工具。该版本内置完整运行环境、预下载模型和全中文界面,支持600+种语言的声音克隆与设计。用户只需解压即可使用,无需配置Python、PyTorch等复杂环境。便携版提供CPU/GPU双版本,包含声音克隆、声音设计(可调节性别/年龄/方言等参数)和批量推理功能。解压后双击启动脚本即可运行,适合中文用户快速体验AI语音技术。下载链接已提供,包含详细使用说明和常见问题解答。

更多:qianchilang.com 1276

别再只跑memtester了!嵌入式Linux内存压力测试,这5个参数和场景你试过吗?

本文深入探讨了嵌入式Linux内存压力测试的高级技巧,重点解析了memtester工具的5个关键参数和实战场景。通过物理地址测试、迭代控制、内存分配策略等调优方法,帮助开发者有效检测内存稳定性问题,适用于长期运行设备、特定故障重现等复杂场景,提升嵌入式系统可靠性。

weixin_30838873的博客 424

数据预处理的分箱操作

数据分箱 介绍 我们在建立模型前,一般需要对特征变量进行离散化,特征离散化后,模型会更稳定,降低模型过拟合的风险。尤其是采用 logsitic 建立评分卡模型时,必须对连续变量进行离散化。而特征离散化处理通常采用的就是分箱法,数据分箱(也称为离散分箱或分段)是一种数据预处理技术,用于减少次要观察误差的影响,提高泛化性。 数据分箱又分为有监督分箱和无监督分箱,是否使用标签进行离散化(分箱)决定了有监督还是无监督的离散化方法。 知识点 无监督分箱 split 分箱 merge 分箱 无监督分箱 这里为了

随笔记 5334

效果炸裂!OmniVoice-TTS 语音克隆来袭:600+ 语言/方言、声音设计、长文本、多音字一网打尽,克隆效果惊艳全场!

语言覆盖:支持全球600多种语言,几乎覆盖所有语种工作流类型:四合一功能集成(标准克隆/长文本/语音设计/多人对话)

2601_95544990的博客 610

晶圆测试厂wafer map管理建议

按照Recipe设定bin定义 应有版本管理概念,一般使用最新版本做为活动版本即可 Bin明细中应包含 BinID、BinCode、BinName、BinType、BinColor、Description BinID可使用数字类型 BinCode可参照实际机台的Bin,用于匹配 有些公司也将BinID、BinCode理解为SBin和HBin 即 Software Bin & Hardware Bin 一般也将BinID对应到客户的Bin BinType

凯神做开发 1万+

声音克隆 小米大模型 OmniVoice 完整使用指南|3 秒克隆人声|支持 600 多种语言和中文方言详细安装教程

小米开源声音克隆大模型OmniVoice,支持600多种语言,3秒即可克隆人声。该模型采用单阶段扩散语言模型,参数0.8B,训练数据达58.1万小时,Apache-2.0协议可免费商用。核心功能包括语音克隆、语音设计、情绪控制和发音纠正。相比主流工具,OmniVoice在语言覆盖、中文准确率和速度方面表现突出。提供整合包和源码两种安装方式,推荐配置需NVIDIA显卡6GB显存以上。使用时需注意参考音频时长3-10秒,路径不含中文,商用需合法授权。

qq_30501863的博客 779

C++笔试题整理

目录 1. 笔试题1 1.1 链表反转 1.2 String 2. 笔试题2 2.1 求下面函数的返回值(微软) 2.2 什么是“引用”?申明和使用“引用”要注意哪些问题? 2.3 将“引用”作为函数参数有哪些特点? 2.4 在什么时候需要使用“常引用”?  2.5 将“引用”作为函数返回值类型的格式、好处和需要遵守的规则? 2.6 “引用”与多态的关系? 2.7 “引用”与指针的区别是什么? 2.8 什么时候需要“引用”? 2.9 结构与联合有和区别? 2.10 下面关于.

星月相随的专栏 2484

订餐平台餐厅信息抓取:使用Python爬虫获取商家信息和用户评价

在这篇博客中,我们展示了如何使用Python爬虫抓取订餐平台上的餐厅信息和用户评价数据。通过使用requests和Selenium,我们能够有效地从静态和动态网页中提取数据,并使用pandas和matplotlib对数据进行存储和分析。未来,您可以根据需求进一步扩展功能,例如增加错误处理、增加抓取多个页面的能力,或者使用高级技术如分布式爬虫来抓取更大规模的数据。

2201_76125261的博客 1651

如何在5分钟内上手OmniVoice?小白友好的语音合成入门教程

想要快速掌握OmniVoice这个强大的语音合成工具吗?本文为你提供完整的5分钟快速入门指南,让你轻松上手这个支持600多种语言的零样本语音合成模型。OmniVoice是一个基于扩散语言模型架构的多语言文本转语音系统,支持语音克隆和语音设计功能,推理速度极快。 ## 🚀 OmniVoice是什么? OmniVoice是一个革命性的**多语言零样本文本转语音**模型,支持超过600种语言,是目

gitblog_00239的博客 588

STM32CubeIDE下载程序报错:Failed to execute MI command: load G:\\Cube_IDE_EXP\\00_FIRST\\Debug\\00...如何解决??

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值 。

**My Coding Family** 2600

教程上新丨支持 600+ 语言,小米开源 OmniVoice:仅需 3-10 秒参考音频实现语音克隆

在这一背景下,OmniVoice 的发布,为多语言语音生成带来了新的突破。相比传统 TTS 模型普遍采用的「文本→语义→声学」两阶段生成流程,OmniVoice 采用了一种类似扩散语言模型的离散非自回归(NAR)架构,可直接将文本映射为多码本声学 token,大幅简化了语音生成链路。随着 AI 语音技术快速发展,文本转语音(TTS)模型正从「能说话」迈向「像真人一样自然交流」,但在多语言覆盖、零样本语音克隆以及复杂口音与方言支持等方面,现有系统仍普遍面临生成链路复杂、训练成本高、跨语言泛化能力有限等问题。

OpenBayes的博客 217

【瑞芯微px30】【RTL8363】【一】驱动移植-网卡驱动概述

linux rtl8363驱动移植

weixin_34799243的博客 1180

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

小米开源声音克隆大模型 OmniVoice 完整使用指南|3 秒克隆人声|支持 600 多种语言和中文方言|Apache-2.0 免费商用|整合包一键启动无需配环境|附详细安装

小米开源声音克隆模型OmniVoice,支持3秒快速克隆人声,覆盖600多种语言,采用Apache-2.0协议可免费商用。该模型由小米AI实验室开发,基于58.1万小时语音数据训练,无需专门训练即可通过3-10秒参考音频克隆音色。核心功能包括语音克隆、语音设计、情绪控制和发音纠正,支持本地部署,推荐使用NVIDIA显卡运行。相比同类产品,OmniVoice在语言覆盖、中文准确率和生成速度方面表现突出,且完全开源免费。提供整合包和源码两种安装方式,适合不同用户需求。使用时需注意参考音频质量和路径规范,商业用途

忧云 1617

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

小米放大招!OmniVoice语音克隆神器开源,600+语言随便说,3秒克隆你的声音!

小米开源语音合成神器OmniVoice,支持零样本声音克隆、方言定制和情感表达。只需3-10秒录音即可克隆声音,还能通过文本指令设计音色。该工具完全开源,支持多角色对话合成,适用于短视频配音、有声书制作等场景。相比竞品,OmniVoice在中文识别错误率、推理速度等方面表现优异,且完全免费。开发者可通过GitHub获取这一工具,体验高质量的AI语音合成技术。

qq_37871846的博客 584

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

小米OmniVoice开源600+语种TTS模型,中文准确率吊打ElevenLabs?

小米开源OmniVoice语音合成模型实现技术突破,支持600多种语言并达到SOTA水平。该模型采用创新架构,合成速度达实时40倍,中文识别准确率WER仅0.84%,超越主流商用产品。其零样本克隆功能仅需3秒音频即可复制声音,并支持个性化调整。特别值得一提的是,该技术为小语种数字化保护提供可能。项目完全开源,将大幅降低语音合成技术门槛,推动有声书、虚拟主播等应用发展。

F15348422570的博客 1150

小米开源 OmniVoice:3 秒克隆人声、600 种语言、中文吊打 ElevenLabs,免费商用!

ElevenLabs 能做的,OmniVoice 都能做。它免费、开源、支持本地部署,并覆盖 600+ 语言。600+ 语言Apache-2.0中文 WER 0.84%3 秒音频克隆人声。

谢白羽 1225

小米开源OmniVoice与VoxCPM2:从多语言TTS到单样本音色克隆实战

语音合成技术旨在将文本转换为自然流畅的语音,其核心原理涉及声学建模与波形生成。随着深度学习发展,基于Transformer的端到端模型显著提升了合成质量与效率,其技术价值在于降低高质量语音生成门槛,推动个性化音频内容创作。该技术广泛应用于有声读物、虚拟助手、游戏配音及媒体内容制作等场景。本文聚焦小米最新开源的OmniVoice与VoxCPM2模型,其中OmniVoice凭借58万小时多语言数据集支持超600种语言,而VoxCPM2则实现了仅需单段参考音频的精准音色克隆,为开发者提供了强大的开源工具链。

weixin_29053067的博客 318

600 + 语言背后:OmniVoice 如何重塑 AI 语音生成

AI语音技术已从基础语音合成进阶到跨语言音色克隆新阶段。小米 AILab 开源的 OmniVoice 模型突破传统 TTS 限制,支持600+语言统一建模,实现三大创新:1)3-10 秒音频即可克隆音色;2)通过自然语言指令自定义音色特征;3)跨语言语音克隆,保留原声说多国语言。该技术还支持方言、口音及长文本处理,适用于数字人、有声书等场景,推动 AI 语音跨越语言边界。用户可通过 OpenBayes 平台快速部署体验该模型。

XLionXxxx的博客 229

零抽样 TTS 新突破!几秒参考音频,OmniVoice 助你轻松克隆数百种语言;17 种语言一网打尽:MDPBench 解决低资源文字系统解析难的「心头大患」

Simple Voice Questions 是由 Google 发布的一个简短音频数据集,该数据集为多语言语音数据集,包含 26 个地区的 17 种语言下的简短音频问题,共计约 700 名说话者,每人最多提供 250 条语音样本,涵盖阿拉伯语、英语、日语、韩语、印地语等多种语言,并包含安静环境、背景人声及交通噪声等多样化录音条件。该项目包含一个生产大规模配音数据集的端到端数据集管道,和一个基于多模态大模型(Large Multimodal Model, LMM)的配音模型,专为多样的电影场景而设计。

HyperAI超神经 515

小米开源声音克隆大模型OmniVoice完整使用指南|3秒克隆人声|支持600多种语言和中文方言|比ElevenLabs还准的词错率|Apache-2.0免费商用|整合包一键启动无需配环境|附详细安装

前段时间在群里看到有人分享小米开源了一个声音克隆的大模型,叫OmniVoice,说是3秒就能克隆别人的声音,还支持600多种语言。当时没太当回事,后来下下来试了一下,效果确实不差,就整理了一下相关信息分享给大家。

2401_88055648的博客 6173

小米开源OmniVoice与VoxCPM2:多语言与个性化TTS技术实战解析

文本转语音(TTS)技术是语音合成领域的核心,其原理是将文本序列转换为可理解的语音波形。传统TTS系统通常基于参数合成或拼接合成,而现代端到端神经TTS模型则通过深度学习架构(如Transformer)直接学习文本到声学特征的映射,显著提升了自然度和流畅度。这项技术的价值在于极大拓展了人机交互的维度,广泛应用于智能助手、无障碍阅读、有声内容创作等场景。近期,小米开源的OmniVoice和VoxCPM2模型,将TTS能力推向了新的高度。OmniVoice通过统一建模支持超600种语言,解决了全球化产品中的多语

weixin_29046611的博客 315

超600种语言,一个模型全搞定! 小米开源 OmniVoice 多语言语音克隆 TTS

数秒克隆语音早已不是新鲜事,但能覆盖600+语种的语音克隆 TTS 模型,你见过吗!它仅用一个双向 Transformer 网络,就能直接实现文本到语音的转化,省去了多余的结构和环节:没有文本的单独建模,没有复杂的混合结构,也没有多层级的 token 预测,是目前最简单的非自回归。语音克隆模型的核心功能就是模仿参考音频(prompt)的音色和情感生成以假乱真的音频,这自不消多说,OmniVoice 轻松搞定,OmniVoice 另一大特色是跨语言克隆能力,真正做到了只要能说一种语言,就能说万国语言!

小米云技术 240
上一篇: 在线教程丨指令遵循/推理/编码三合一,Mistral Medium 3.5把Coding Agent搬上云端
下一篇: Token使用量降低30%,以「阿凡达」为灵感的异构智能体框架Eywa,高效结合语言模型与领域专用基础模型
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值