周董下次发新歌,可以请 AI 来作词吗?

CV:计算机视觉领域(图像分类、目标检测、姿态估计、语义分割)基于各种benchmark数据集及其对应Top算法概述 ​ CV:计算机视觉领域(图像分类、目标检测、姿态估计、语义分割)基于各种benchmark数据集及其对应Top算法概述 目录 简介 使用方法 简介 您是否曾经想要快速了解哪篇论文在标准数据集X上提供了最佳结果?不用再等待,只需点击下面,发现当前的前沿技术。受到看到太多论文省略最佳方法的挫败感以及受到Hao Wooi Lim博客的启发,在这里,您可以找到一份众包列表,其中包含一些“主要”视觉分类、检测和姿态估计数据集上已知结果。 根 阅读详情
By 超神经


场景描述:周董终于发了新歌,立刻在各个平台刷屏。这首新歌《说好不哭》,上线两小时,销售额就破了两千万。方文山回归、阿信助唱等因素都让这首歌火爆的一塌糊涂。方文山的作词水平一般人可能难以企及,但如果让 AI 学习训练之后,会不会作出同样水平的歌词呢?


关键词: AI 作词  序列建模  文本生成


周杰伦的一首新歌《说好不哭》,引发了全民围观的热潮,从新歌发布当晚 11 点到昨天中午,周杰伦都一直牢牢占据着微博热搜。毕竟距离周董上一次发布歌曲,已经过去了 489  天。

听到这首新歌,很多人都哭了,但也引来了不少口水。虽有争议,但不妨碍它在朋友圈刷屏,社交平台霸榜,甚至导致 QQ 音乐一度崩溃,因为这首歌勾起了无数人的青春记忆。

640?wx_fmt=gif
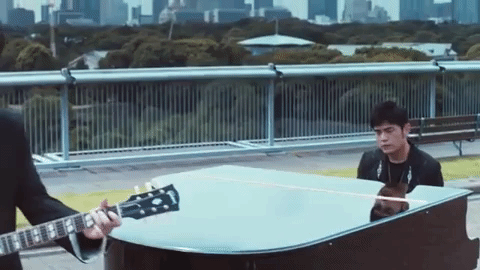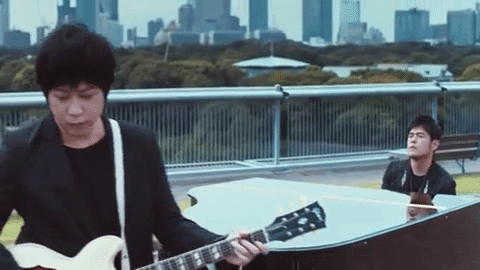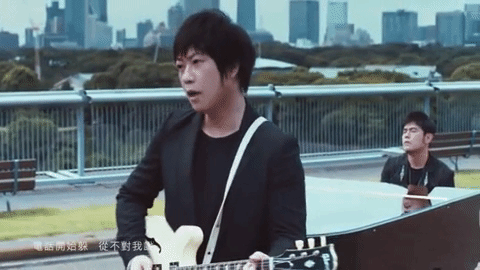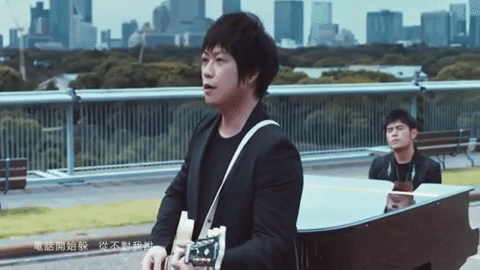
「周五」组合出镜新歌 MV

此外,这首新歌也因为方文山的回归,令无数粉丝倍加期待。

方文山的作词与周董的作曲配可谓天衣无缝,在早期的合作中,创作出许多经典作品,《爱在西元前》、《东风破》等等,都因绝美的歌词让人印象深刻。

640?wx_fmt=png

方文山在微博自评《说好不哭》歌词

少了方文山写的词,周董的歌好像总少了那么一些意境。周杰伦自己也曾说:「我的曲如果没有方文山的词,不会中(受欢迎)。」

那么除了这位周董的御用作词人之外,还有谁能写出方文山笔下风格多变、颇具诗意的歌词呢?无处不在人工智能已经做出尝试。


在 GitHub 上,有几个有趣的项目,用机器学习生成了周董风格(准确说是方文山风格)的歌词,它们到底是怎么实现的呢?

本文跟随其中一个项目,详细了解 AI 作词的过程。


原理回顾


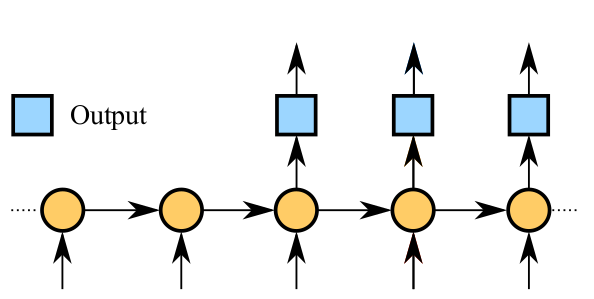
机器作词是序列建模(以下用 seq2seq )的典型应用,其基本思想就是给定序列 A ,机器负责产生序列 B ,并且再将序列 B 作为输入,机器负责生成序列 C...如此循环下去即可生成无限长度的序列。
640?wx_fmt=png
seq2seq模型图,左边是编码器,右边是解码器
假设问题是从序列 A 到序列 B 之间的映射,那么 seq2seq 模型的工作流程如下:
  • 序列 A 中的每一个单词通过 word_embedding 操作以后,作为 input 进入编码器,编码器可以是一个多层 RNN 结构,编码器输出一个向量;

  • 训练时,解码器的输入跟编码器的输入是一样的,然后解码器的输出与序列 B 之间的交叉熵作为模型的目标函数;

  • 生成的时候,首先给定一个种子序列作为编码器的输入,并且解码器的上一时刻的输出作为下一时刻的输入,如此循环往复,直到生成给定数量的序列。


本文建立的模型就是基于以上原理。


模型代码设计


要完成自动生成歌词需要一个生成模型,而生成模型一般都是无监督问题,但在此需要将它转化成有监督问题,以发现数据内在的关联性,比如上下文的衔接,然后用预测学习来代替无监督学习。


就有监督学习而言,通常需要准备好具有映射关系的数据集:X 和 Y。虽然歌词是一个整体,但是这个整体是序列组成的,序列与序列之间会有一定的时序关系。比如
天青色等烟雨  而我在等你
就可以把「天青色等烟雨」看作 X ,把「而我在等你」看作 Y ,如果我们将 X 作为输入,而网络输出的是 Y ,那就能说明模型具备了写词的能力。
以此为依据,建立了数据集。
 
数据预处理后,接下来是建立模型,主要是围绕 seq2seq 模型构建,而在编码器和解码器部分,可以自由构造,如选择不同的 rnn_cell ,或者选择不同的层数、神经元个数。
另一个重要的部分是目标函数,要确保目标函数对于所有要训练的参数是可微的,这样就可以构建端对端的基于后向误差更新的深度学习系统。


当有监督学习训练的模型的误差满足要求后,就可以把参数保存下来,用此模型去生成歌词。
模型构建其实就是一个抽样的过程,给定种子序列,选好特定的抽样方法,即可生成无限多个汉字组成的序列。


为了了解训练过程中的误差更新趋势,还需要建立日志记录以及日志可视化的部分,这样以便于我们做后期的模型性能分析,本文中会粗略提及。


本项目的文件结构如下图所示:
.
├── analysis
│   └── plot.py
├── data
│   ├── context.npy
│   ├── lyrics.txt
│   ├── origin.txt
│   ├── parse.py
│   └── vocab.pkl
├── log
│   ├── 2016-12-1022:11:22.txt
│   └── 2016-12-1022:11:22.txt.png
├── preprocess.py
├── README.md
├── result
│   └── sequence
├── sample.py
├── save
│   ├── checkpoint
│   ├── config.pkl
│   ├── model.ckpt-223
│   ├── model.ckpt-223.meta
│   └── words_vocab.pkl
├── seq2seq_rnn.py
├── train.py
└── utils.py
它们的功能分别如下:
  • 主目录下面的 utils.py 是公共函数库,preprocess.py 是数据预处理代码, seq2seq_rnn.py 是模型代码,sample.py 是抽样生成过程,train.py 是训练过程;

  • log 目录中存储的是训练过程中的日志文件;

  • save 目录中存储的是训练过程中的模型存储文件;

  • data 目录中存放的是原始歌词数据库以及处理过的数据库;

  • result 目录中存放的是生成的序列;

  • analysis 目录中存放的是用于可视化的代码文件;


数据预处理


原始歌词文件是从百度文库中下载的,其中包括了一些不必要的文本,在此过滤了全部非中文字符,并使用空格分隔相邻句子。
下面这段代码,就是剔除源歌词文件中的多余空格以及非中文字符:
reg = re.compile(ur"[\s+]")
c = reg.sub(' ',unicode(c))
reg = re.compile(ur"[^\u4e00-\u9fa5\s]")
c = reg.sub('',unicode(c))
c = c.strip()
将源歌词文件处理成连续的句子文件以后,还需要将句子划分成很多对训练样本。
首先需要统计歌词中所有不同汉字的总数(包括一个空格),并且对这些汉字进行索引,可将原文由汉字变成整型数组,这样训练的时候读取数组即可;
另外,索引可用来进行 word_embedding ,即将每个单词映射成一个特征向量。下面一段代码就是建立词典以及上下文的过程:
def build_dataset(self):
   ''' parse all sentences to build a vocabulary
       dictionary and vocabulary list
   '''
   with codecs.open(self.input_file, "r",encoding='utf-8') as f:
       data = f.read()
   wordCounts = collections.Counter(data)
   self.vocab_list = [x[0] for x in wordCounts.most_common()]
   self.vocab_size = len(self.vocab_list)
   self.vocab_dict = {x: i for i, x in enumerate(self.vocab_list)}    
   with codecs.open(self.vocab_file, 'wb',encoding='utf-8') as f:
       cPickle.dump(self.vocab_list, f)
   self.context = np.array(list(map(self.vocab_dict.get, data)))
   np.save(self.context_file, self.context)
然后确定出要建立的每对样本长度,以及训练时候的 batch_size 大小,进而把数据集分成很多个 mini-batch,可以在训练时依次读取。
为了预处理方便,我们选择了固定的样本序列长度,并且让 X 和 Y 的长度一致,从数据集中选取 X 和 Y 的时候每次滑动步长为 1 ,间隔也为 1 ,如下代码所示:
def init_batches(self):
   '''
       Split the dataset into mini-batches,
       xdata and ydata should be the same length here
       we add a space before the context to make sense.
   '''
   self.num_batches = int(self.context.size / (self.batch_size * self.seq_length))
   self.context = self.context[:self.num_batches * self.batch_size * self.seq_length]
   xdata = self.context
   ydata = np.copy(self.context)
   ydata[:-1] = xdata[1:]
   ydata[-1] = xdata[0]
   self.x_batches = np.split(xdata.reshape(self.batch_size, -1), self.num_batches, 1)
   self.y_batches = np.split(ydata.reshape(self.batch_size, -1), self.num_batches, 1)
   self.pointer = 0
可以看到 Y 的最后一个数是设置为 X 的第一个数,因此我们在数据集的开头插入了一个空格使得整体连贯。
pointer 作为标记使用,标记当前训练的是哪一个 mini-batch,如果所有 mini-batch 都训练过了,即完成了一个 Epoch, pointer 将置零,如下面代码所示:
def next_batch(self):
   ''' pointer for outputing mini-batches when training
   '''
   x, y = self.x_batches[self.pointer], self.y_batches[self.pointer]
   self.pointer += 1
   if self.pointer == self.num_batches:
       self.pointer = 0
   return x, y
 

编写基于 LSTM 的 seq2seq 模型


数据预处理完成以后,接下来是建立 seq2seq 模型。主要分为三步:
  • 确定编码器和解码器中 cell 的结构,即采用什么循环单元,多少个神经元以及多少个循环层;

  • 将输入数据转化成 TensorFlow 的 seq2seq.rnn_decoder 需要的格式,并得到最终的输出以及最后一个隐含状态;

  • 将输出数据经过 softmax 层得到概率分布,并且得到误差函数,确定梯度下降优化器;


TensorFlow 提供的 rnncell 共有三种,分别是 RNN、GRU、LSTM,因此这里也提供三种选择,并且每一种都可以使用多层结构,即 MultiRNNCell ,如下代码所示:
if args.rnncell == 'rnn':
   cell_fn = rnn_cell.BasicRNNCell
elif args.rnncell == 'gru':
   cell_fn = rnn_cell.GRUCell
elif args.rnncell == 'lstm':
   cell_fn = rnn_cell.BasicLSTMCell
else:    
   raise Exception("rnncell type error: {}".format(args.rnncell))
cell = cell_fn(args.rnn_size)
self.cell = rnn_cell.MultiRNNCell([cell] * args.num_layers)
选择好了 cell 的结构以后,接下来就是将输入数据传递的 seq2seq 模型中去。
TensorFlow 的 seq2seq.py 文件中提供了多个用于建立 seq2seq 的函数,这里选择出了两个,分别是 rnn_decoder 以及 attention_decoder,下面以 rnn_decoder 为例。
从 tensorflow 源码中可以看到, rnn_decoder 函数主要有四个参数,它们的注释如下:
decoder_inputs: A list of 2D Tensors [batch_size x input_size].
initial_state: 2D Tensor with shape [batch_size x cell.state_size].

cell: rnn_cell.RNNCell defining the cell function and size.

loop_function: If not None, this function will be applied to the i-th output
in order to generate the i+1-st input, and decoder_inputs will be ignored,
except for the first element ("GO" symbol). This can be used for decoding,
but also for training to emulate http://arxiv.org/abs/1506.03099.
Signature -- loop_function(prev, i) = next
* prev is a 2D Tensor of shape [batch_size x output_size],
* i is an integer, the step number (when advanced control is needed),
* next is a 2D Tensor of shape [batch_size x input_size].

可以看到,decoder_inputs 其实就是输入的数据,要求的格式为一个 list,并且 list 中的 tensor 大小应该为 [batch_size,input_size],换句话说这个 list 的长度就是 seq_length ;
但我们原始的输入数据的维度为 [args.batch_size, args.seq_length],看起来缺少了一个 input_size 维度,其实就是 word_embedding 的维度,或者说 word2vec 的大小。

这里需要手动进行手动 word_embedding ,并且这个 embedding 矩阵是一个可以学习的参数:
self.input_data = tf.placeholder(tf.int32, [args.batch_size, args.seq_length])with tf.variable_scope('rnnlm'):
softmax_w = build_weight([args.rnn_size, args.vocab_size],name='soft_w')
softmax_b = build_weight([args.vocab_size],name='soft_b')
word_embedding = build_weight([args.vocab_size, args.embedding_size],name='word_embedding')
inputs_list = tf.split(1, args.seq_length, tf.nn.embedding_lookup(word_embedding, self.input_data))
inputs_list = [tf.squeeze(input_, [1]) for input_ in inputs_list]
initial_state 是 cell 的初始状态,其维度是 [batch_size,cell.state_size],由于 rnn_cell 模块提供了对状态的初始化函数,因此我们可以直接调用:
self.initial_state = self.cell.zero_state(args.batch_size, tf.float32)
cell 就是我们要构建的解码器和编码器的 cell ,上面已经提过了。
最后一个参数是 loop_function ,其作用是在生成的时候,把解码器上一时刻的输出作为下一时刻的输入,并且这个 loop_function 需要自己建立,如下所示:
def loop(prev, _):
   prev = tf.matmul(prev, softmax_w) + softmax_b
   prev_symbol = tf.stop_gradient(tf.argmax(prev, 1))
   return tf.nn.embedding_lookup(embedding, prev_symbol)
最后,在构建好 seq2seq 的模型后,将上面参数传入 rnn_decoder 函数即可:
outputs, last_state = seq2seq.rnn_decoder(inputs_list, self.initial_state, self.cell, loop_function=loop if infer else None, scope='rnnlm')
其中 outputs 是与 decoder_inputs 同样维度的量,即每一时刻的输出;last_state 的维度是 [batch_size,cell.state_size],即最后时刻的所有 cell 的状态。
接下来需要 outputs 来确定目标函数,而 last-state 的作用是作为抽样生成函数下一时刻的状态。


TensorFlow 中提供了 sequence_loss_by_example 函数用于按照权重来计算整个序列中每个单词的交叉熵,返回的是每个序列的 log-perplexity 。

为了使用 sequence_loss_by_example 函数,我们首先需要将 outputs 通过一个前向层,同时需要一个 softmax 概率分布,这个在生成中会用到:
output = tf.reshape(tf.concat(1, outputs), [-1, args.rnn_size])
self.logits = tf.matmul(output, softmax_w) + softmax_b
self.probs = tf.nn.softmax(self.logits)
loss = seq2seq.sequence_loss_by_example([self.logits],
      [tf.reshape(self.targets, [-1])],
      [tf.ones([args.batch_size * args.seq_length])],
      args.vocab_size)    
# average loss for each word of each timestepself.cost = tf.reduce_sum(loss) / args.batch_size / args.seq_length
最后就是建立一个 op,以便训练,例如 var_op、var_trainable_op、train_op、initial_op、saver:
self.lr = tf.Variable(0.0, trainable=False)
self.var_trainable_op = tf.trainable_variables()
grads, _ = tf.clip_by_global_norm(tf.gradients(self.cost, self.var_trainable_op),
           args.grad_clip)
optimizer = tf.train.AdamOptimizer(self.lr)
self.train_op = optimizer.apply_gradients(zip(grads, self.var_trainable_op))
self.initial_op = tf.initialize_all_variables()
self.saver = tf.train.Saver(tf.all_variables(),max_to_keep=5,keep_checkpoint_every_n_hours=1)
self.logfile = args.log_dir+str(datetime.datetime.strftime(datetime.datetime.now(),'%Y-%m-%d %H:%M:%S')+'.txt').replace(' ','').replace('/','')
self.var_op = tf.all_variables()
train_op 即为训练时需要运行的。


编写抽样生成函数


如上所述,在抽样生成的时候,我们首先需要一个种子序列,同时在第一步的时候,我们需要向网络传入一个 0 的初始状态,并通过种子序列的第一个字得到下一个隐含状态,然后再结合种子的第二个字传入下一个隐含状态,直到种子序列传入完毕:
state = sess.run(self.cell.zero_state(1, tf.float32))        
for word in start:
   x = np.zeros((1, 1))
   x[0, 0] = words[word]
   feed = {self.input_data: x, self.initial_state:state}
    [probs, state] = sess.run([self.probs, self.final_state], feed)
种子序列运行完毕以后,接下来就进入真正的抽样过程了,即拿上一时刻的 state 以及上一时刻输出 probs 中的最佳单词作为下一时刻的输入,那么给定了一个所有单词的概率分布 probs ,该时刻的最佳单词如何定义呢?这里我列举了三种情况:
  • argmax 型:即找出 probs 中最大值所对应的索引,然后去单词表中找到该索引对应的单词即为最佳单词;

  • weighted 型:即随机取样,其工作流程如下:首先,计算此 probs 的累加总和 S ;其次,随机生成一个 0~1 之间的随机数,并将其与 probs 的总和相乘得到 R;最后,将 R 依次减去 probs 中每个数,直到 R 变成负数的那个 probs 的索引,即为我们要挑选的最佳单词;

  • combined 型:这里我把 argmax 和 weighted 结合起来了,即每次遇到一个空格(相当于一句歌词的结尾),就使用 weighted 型,而其他时候都使用 argmax 型;

这三种的实现方式如下所示:
def random_pick(p,word,sampling_type):
   def weighted_pick(weights):
       t = np.cumsum(weights)
       s = np.sum(weights)
       return(int(np.searchsorted(t, np.random.rand(1)*s)))    
   if sampling_type == 'argmax':
       sample = np.argmax(p)    
   elif sampling_type == 'weighted':
       sample = weighted_pick(p)
   elif sampling_type == 'combined':        
       if word == ' ':
           sample = weighted_pick(p)
       else:
           sample = np.argmax(p)
   return sample
最后,抽样生成过程的具体代码如下所示,其中 start 是种子序列, attention 是判断是否加入了注意力机制。
word = start[-1]
for n in range(num):
   x = np.zeros((1, 1))
   x[0, 0] = words[word]
   if not self.args.attention:
       feed = {self.input_data: [x], self.initial_state:state}
       [probs, state] = sess.run([self.probs, self.final_state], feed)
   else:
       feed = {self.input_data: x, self.initial_state:state,self.attention_states:attention_states}
       [probs, state] = sess.run([self.probs, self.final_state], feed)
   p = probs[0]
   sample = random_pick(p,word,sampling_type)
   pred = vocab[sample]
   ret += pred
   word = pred
  ret 数组即为最终的生成序列。


编写训练函数


训练函数需要完成的功能主要有:提供用户可设置的超参数、读取配置文件、按照 mini-batch 进行批训练、使用 saver 保存模型参数、记录训练误差等等,下面将列举部分代码进行说明。


首先,我们使用 argparse.ArgumentParser 对象进行解析命令行参数,或者设置默认参数,例如:
parser.add_argument('--rnn_size', type=int, default=128,
            help='set size of RNN hidden state')
设置了 rnn_size 默认大小为 128 ,而用户也可以在命令行使用类似于以下这种方式来指定参数大小:
python train.py --rnn_size 256
其次,我们需要提供是否继续训练的判断,也就说是从头开始训练还是导入一个已经训练过的模型继续训练,即下面的语句:
if args.keep is True:
   print('Restoring')
   model.saver.restore(sess, ckpt.model_checkpoint_path)        
else:
   print('Initializing')
   sess.run(model.initial_op)
然后就是将 X 和 Y 数据 ,feed 到模型中去运行 op 并得到误差值:
x, y = text_parser.next_batch()
feed = {model.input_data: x, model.targets: y, model.initial_state: state}
train_loss, state, _ = sess.run([model.cost, model.final_state, model.train_op], feed)
训练过程比较简单,基本上就是设置参数-导入数据-导入模型-运行 op  -得到误差-下一个 Epoch 继续训练,直到满足要求为止。


编写日志


这里说的日志可以理解为保存参数、保存训练过程中的误差以及训练时间等等,仅作抛砖引玉的说明。
为了使得每一次训练都不会白白浪费,我们需要设置好参数保存,如可以设置训练了多少个样本就保存一次参数、训练了多少个 Epoch 就保存一次:
if (e*text_parser.num_batches+b)%args.save_every==0 、
       or (e==args.num_epochs-1 and b==text_parser.num_batches-1):
   checkpoint_path = os.path.join(args.save_dir, 'model.ckpt')
   model.saver.save(sess, checkpoint_path, global_step = e)
   print("model has been saved in:"+str(checkpoint_path))
记录训练误差也是很重要的一步,很多时候我们需要分析 cost 曲线随时间或者是迭代次数的变化趋势。

因此这里我们建立了一个 logging 函数(在utils.py文件中),并且在每一个 Epoch 训练结束的时候就记录一次该 Epoch 的平均误差、运行时间等等:
delta_time = end - start
ave_loss = np.array(total_loss).mean()
logging(model,ave_loss,e,delta_time,mode='train')
 

编写可视化函数


由于时间的关系,这里仅对日志文件做了初步的可视化,即提取日志文件中的 Epoch 以及对应的误差,从而得到一条 Cost-Epoch 曲线,可视化的函数的部分代码如下:
if line.startswith('Epoch'):        
   if 'validate' in line:
       index2 = index2 + 1
       cost = line.split(':')[2]
       indexValidateList.append(index2)
       validateCostList.append(float(cost))
   elif 'train error rate' in line:
       index1 = index1+1
       cost = line.split(':')[2]
       indexCostList.append(index1)
       costList.append(float(cost))
然后使用 matplotlib 库进行作图:
def plot(self):
   title,indexCostList,costList = self.parse()
   p1 = plt.plot(indexCostList,costList,marker='o',color='b',label='train cost')
   plt.xlabel('Epoch')
   plt.ylabel('Cost')
   plt.legend()
   plt.title(title)    
   if self.saveFig:
       plt.savefig(self.logFile+'.png',dpi=100)
       #plt.savefig(self.logFile+'.eps',dpi=100)
   if self.showFig:
       plt.show()
 

设置训练超参


超参的选择一直是训练深度学习的一个难点,无论是循环神经元的个数、层数还是训练样本批处理的大小,都没有一个固定的判断准则,超参设置因问题而已,而且很多时候论文中使用的经验规则,而本文也只能根经验设置参数。
最终选择了两层 LSTM,每层包含 128 个神经元作为 seq2seq 模型的 cell,词向量 word_embedding 的大小为 100,批处理大小设置为 32 ,序列长度为16,并且使用了 Adam 随机梯度下降算法,学习率设置为 0.001 ,一共训练了 230 个周期。


结果展示


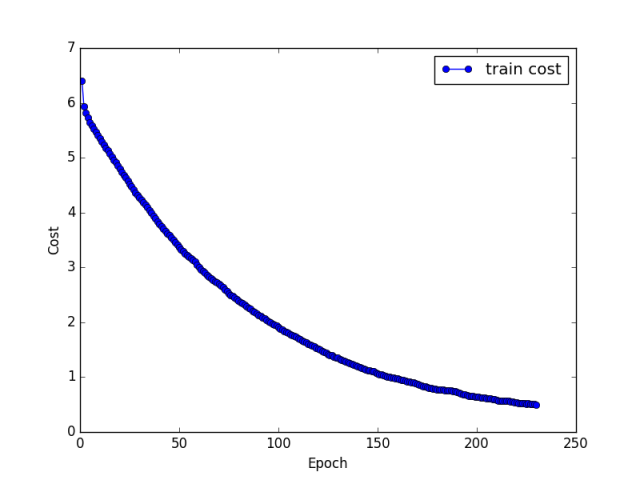
在训练完所有 Epoch 以后,运用可视化函数作出了误差随训练周期的变化图像:
640?wx_fmt=png
并且使用 weighted 的抽样生成方法,选择了「从前」作为种子序列,然后让机器生成了长度为 200 的歌词。
如下所示,其中有几句看起来似乎有押韵的意思,整体上看起来不知道要表达什么。


640?wx_fmt=png
《机器作词》
                                                                                                                                                                               从前笑 爱说走 晚到
为什么我都会开错记忆不多 
幸福搁抽勾 
我只为大参城真 说越没有
简单一个音 最后的秘密
大人情了解境 
再继续永远都不会痛 
不知道很感 但它怕开地后想念你
怕你身边 把那一天 
你最好了 鸣债不手切最后走的生活
好拥有 你想的兵水停 
有什么回吻你都懂不到 
谁说没有结果 我是不是多提醒你
好多永远隔着对 会心碎你走罪你
谁说用手语 想要随时想能打开
想要当然魅力太强被曾人迷人蛋
哈哈哈


为了使生成的歌词更加通顺,作者又加入了十多部近代中文小说、散文以及林夕的所有歌词作为语言模型的预训练语料。

通过训练好基于 LSTM-seqseq 的语言模型之后,使用周杰伦的歌词来在此模型上接着训练了40个 Epoch,同样以「从前」作为种子序列,生成了长度为 200 的周杰伦风格的歌词。

640?wx_fmt=png
《机器作词》
                                                                                                                                                                      
从前进开封 出水芙蓉加了星
在狂风叫我的爱情 让你更暖
心上人在脑海别让人的感觉
想哭 是加了糖果
船舱小屋上的锈却现有没有在这感觉
你的美 没有在
我却很专心分化
还记得
原来我怕你不在 我不是别人
要怎么证明我没力气 我不用 三个马蹄
生命潦草我在蓝脸喜欢笑
中古世界的青春的我
而她被芒草割伤
我等月光落在黑蝴蝶
外婆她却很想多笑对你不懂 我走也绝不会比较多
反方向左右都逢源不恐 只能永远读着对白


总结 & 后续 

机器生成歌词跟机器作曲一样,都是序列建模的运用,本文使用了周杰伦早期的所有歌词。

虽然训练样本较少,数据预处理较为粗糙,但是基本上把整个建模过程都认真介绍了一遍,模型超参设置仅供参考,完整代码可以访问 github ,可以去 fork 一下。后续将考虑使用外部动态网络或强化学习进行持续优化。

Github 地址:
https://github.com/hundred06/jaylyrics_generation_tensorflow


除了本项目,在 GitHub 上,还有几个类似的工作。


比如其中一个是使用字符级别的 RNN 进行文本生成,利用了 MXNet-Gluon 框架,并基于 PyTorch 实现了如下创作:


我们的爱
持纵的微银 
我路茫未望
象对躲睡被仁消 整虹伪沙
乡月裂续武深面到
身壁许达道 
用移照叫生


GitHub 地址:
https://github.com/L1aoXingyu/Char-RNN-Gluon

说回周董,在去年他担任评委的《中国好声音》上,其麾下的战将,就有一位使用 AI 作词的清华学霸,凭借机器改编的 Rap,技惊四座。

也许周董下次的歌曲,也可以考虑下由 AI 来作词。当然,就目前效果来看,AI 还需继续努力。

640?wx_fmt=gif


注:本文介绍的工作完成于 2016 年,训练的环境是 Ubuntu 16.04 操作系统,使用的 tensorflow 版本是 r0.11 ,所使用的 python 版本为 2.7,所用的 GPU 是 Nvidia GeForce GTX 960M。

本文转载自公众号:深度学习每日摘要,内容有部分改动;原作者:张泽旺。二次转载请联系原文作者。

—— 完 ——

扫描二维码,加入讨论群

获得优质数据集

回复「读者」自动入群

更多精彩内容(点击图片阅读)
640?wx_fmt=gif
lyricai:人工智能的歌曲歌词创作 抒情诗 用于歌曲歌词创作的人工智能。 立即下载

相关推荐

具有PWM控制VSC-HVDC链路的IEEE30总线传输系统(Simulink仿真实现)

内容概要:本文构建了一个包含PWM控制VSC-HVDC链路的IEEE30节点电力传输系统,并基于Simulink平台完成了系统的建模仿真。该模型聚焦于高压直流输电(HVDC)技术在区域电网互联中的应用,采用电压源型换流器(VSC)与脉宽调制(PWM)技术实现高效、灵活的电能传输。研究重点在于分析VSC-HVDC链路在复杂多节点电网中对潮流分布、系统稳定性及电能质量的调控能力,特别关注其在区域电网互联、新能源大规模接入以及跨区域电力交换等场景下的动态响应特性与控制性能,为现代智能电网的发展提供技术支撑与仿真验证手段。; 适合人群:具备电力系统、电气工程或自动化等相关专业背景的研究生、科研人员及工程技术人员。; 使用场景及目标:①用于研究VSC-HVDC在多节点电网(如IEEE30节点)中的建模与仿真方法;②分析PWM控制策略下HVDC链路对电网潮流分布、电压稳定性和故障穿越能力的影响;③为区域电网互联、新能源并网及智能电网调度等课题提供仿真基础和技术验证。; 阅读建议:此资源以Simulink仿真实现为核心,建议读者在掌握电力电子技术和电力系统分析基础知识的前提下,结合仿真模型深入理解VSC-HVDC的工作原理与控制策略。在学习过程中,应着重关注模型参数设置、控制环路设计及仿真结果的分析,以达到理论与实践相结合的目的。

十大优秀AI人工智能作词软件有哪些?

1、妙笔生词:国内专业智能作词工具,是一款非常优秀的国内作词软件,它可以选择语言,风格,韵脚一键生成歌词,也可以仿写歌词,可以续写歌词,可以智能取歌名,找优秀词句,优化歌词,解读歌词等等。目前处于公测阶段,功能和风格免费使用。5、QuillBot:独特的人工智能文本工具,融合了写作和释义功能,可以改进和更改现有文本,为内容带来新鲜感,适合想要改进文本并避免抄袭的人。8、Writer:强调品牌一致性,可提供为企业量身定制的顶级、可定制内容,适用于企业,但对于个人自由职业者来说,可能因其业务中心化而有所限制。

haitunhaoma的博客 5683

Voxel Hashing技术解析:如何解决TSDF内存爆炸问题?

本文深入解析Voxel Hashing技术如何有效解决TSDF内存爆炸问题。通过动态内存分配和空间哈希函数设计,该技术将内存占用降低96.6%,同时保持高精度重建。文章详细介绍了GPU加速实现、现代系统演进及实践指南,为实时3D重建提供工程解决方案。

m2n3b4v5c6的博客 715

作词家下岗系列:教你用 AI 做一个写歌词的软件!

作者 |李秋键责编 | Carol出品 | AI科技大本营(ID:rgznai100)自然语言处理作为人工智能的一个重要分支,在我们的生活中得到了广泛应用。其中RNN算法作为自然语言处...

AI科技大本营 4493

告别复杂配置!5分钟在Vue/React项目中集成讯飞语音听写WebSocket API

本文详细介绍了如何在Vue/React项目中快速集成讯飞语音听写WebSocket API,实现高效语音识别功能。通过对比不同通信方案,突出WebSocket在实时语音交互中的优势,并提供框架适配、音频处理及性能优化等关键技术点,帮助开发者5分钟内完成专业级语音听写功能集成。

weixin_28730353的博客 274

vivado 编译ADI AD9361 TCL脚本生成hdl工程

(4)输入"source ../../scripts/adi_make.tcl"命令(仅双引号内部命令,不包含双引号),个人理解:该命令用来加载当前所需要编译工程所需要各功能模块的信息,因为每个工程需要不同的功能模块,比如有的需要gpio模块,有的不需要gpio模块,这些模块上前面路径的library也同样以TCL脚本形式存在,当有需要时才进行编译,怎么知道当前工程需要什么模块呢就是通过"source ../../scripts/adi_make.tcl"(仅双引号内部命令,不包含双引号)命令实现。

weixin_40586423的博客 809

ai人工智能写歌词app,ai写歌词网站,ai作词软件创作版,作词人的辅助工具,押韵助手

早在2019年,AI机器人小芝(aixiegeci)就出现在音乐创作创作领域,作为一个AI人工智能写歌词app,在歌词创作领域辅助音乐人写歌词的应用。在软件上输入三句话作为关键词引导句子,选择歌词风格,30秒就能完成一首歌词的创作,根据主题来写一首原创歌词给音乐人作为歌词创作词穷时作为参考借鉴。同时,该应用软件还可以选择歌词的韵脚(十三韵)和每句歌词末尾押韵的字数。...

veve188的博客 3521

用V E S C 6-M K V I 第六代调速控制器给VESC电调刷固件

文章摘要:本文介绍了一款先进的电机控制器,具备多项创新技术。核心亮点包括三相电流/电压检测、四象限无缝运行、多模式兼容等先进电机控制技术,以及智能感知与安全保护、高效能电源管理、多样化连接与扩展功能。此外,该控制器支持实时数据监测与用户交互,具备开源生态和工业级可靠性,适用于电动载具、机器人及工业领域。用户需注意散热要求和兼容性提示,可通过VESC-Tool软件进行灵活配置。产品可在常竹科技淘宝店购买,并加入技术交流群获取支持。

2403_89422757的博客 1367

新潮科技:人工智能歌词创作软件app,在线ai作词押韵写歌词,可以自己写歌词的软件

AI机器人小芝(aixiegeci)是一款帮音乐人快速创作歌词的软件app。它不仅实现了传统常有的写歌词押韵功能,还引入了大量AI人工智能算法来辅助创作,根据你自己输入的关键词句子作为引导语作为创作的指引方向,不断写出原创歌词句子给你做参考,降低了创作歌词的难度,提高了创作歌词的乐趣和效率。该软件有两个创新功能模块:AI智能写歌词和AI智能填词。这个歌词创作工具对于想要进一步改善歌词写作效果和写歌词没有灵感思路的音乐人来说是及时的帮助。 歌词的创作质量和速度一直是AI人工智能写歌词的研究重点。在原创歌词创

veve188的博客 3472

R语言实战:三因素方差分析(ANOVA)从入门到精通(附完整代码解析)

本文详细介绍了如何使用R语言进行三因素方差分析(ANOVA),从数据准备、模型构建到结果解读与可视化,提供完整代码解析。通过实战案例,帮助读者掌握复杂交互效应的分析方法,适用于科研、教育等多个领域的数据分析需求。

weixin_29081101的博客 244

SV--对象拷贝、参数化的类

对象拷贝,参数化的类

创芯人--fly的博客 1571

AI人工智能在自动写歌词软件的最新应用,AI机器人小芝

如今是音乐潮流火热的时代,随着抖音、快手的火爆,没有什么门槛,谁都可以成为主播唱歌,但是谁都唱那些常见的歌曲是没有新意和吸引力的。这个时候想与众不同,脱颖而出,那就需要创作属于自己的音乐。但是想创作出来一首高质量的原创歌词还是需要有一定的知识功底的,那么问题就来了,有没有能自动写歌词的软件来帮助我们人工智能写歌词呢? 笔者最近了解到在这个领域有一款软件产品的出现,叫AI机器人小芝,它采用最前沿的AI人工智能科技,模仿人类的思维方式,自动深度学习海量歌词,形成自己独特的创作能力。它能帮助广大的音...

m0_48123373的博客 1万+

095、PCIE物理层测试模式:从信号眼图到误码率实战

本文介绍了PCIe物理层测试模式的调试方法和实战经验。重点解析了环回测试、合规性测试和静默模式的应用场景及配置要点,分享了信号眼图分析、误码率测试和接收端验证的实用技巧。作者结合自身调试经历,强调物理层测试对排查信号完整性问题的重要性,建议在量产前进行基础测试,并提醒注意芯片勘误和测试模式切换等易错点。通过合理使用测试模式,可显著提高PCIe链路调试效率,确保物理层稳定可靠。

z534437748的博客 62

一代偶像终将老去,总有AI正在年轻

Jay迷编辑部发自 凹非寺量子位 报道 | 公众号 QbitAI你今早被周杰伦刷屏了吗?新专辑单曲《说好不哭》昨晚23点上线,迅速火遍社交网络,刷屏朋友圈,27分钟上热...

量子位 680

【AI编程】Qoder AI 编程工具从部署到深度使用实战详解

Qoder AI 编程工具从部署到深度使用实战详解

congge 8346

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

【今天聊聊AI】AI歌手会取代流行歌手吗

随着科技的发展,AI歌手注定会有更多地方可以超越人类,比如音域,比如咬字、速度、语言掌握能力等,比如,或高级,或精致,或搞怪,会为演唱带来更多的可能,AI歌手在未来也可能会成为一种流行趋势,但是成为主流还需要时间。但从效果上而言,其实目前市场上大部分的AI歌姬目前还是可以被人耳分辨出来的,想要完全使用AI歌手达到人声演绎的效果(即让人单纯从耳机里听的时候,完全区分不出来是AI演唱),还需要做大量的预期设计,以及精调精修。音色、力度、响度、气声比例、气口、混响、性别,以及语言、音高、时值、转音。

綦枫Maple的博客 1040

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

Suno AI 使用原创音频生成自己喜欢的音乐

把明星的声音进行上传,并自己编一首歌词,设定自己想要的歌曲风格与创作元素,例如:我上传周董的声音,并把自己创作的歌词上传 进行创作,你就会发现 你得到一首周董唱的,你作词编曲的歌。然后试听了一下,理解了,你可以理解为,suno AI 会根据你唱的声音训练,并把你的声音作为唱该歌曲声音,可以理解声音克隆训练,并生成你自己声音的一样以及指定的歌词曲风的歌曲。第一个:我感觉某首歌的音乐和旋律好听,例如 周董的双截棍,然后我把音乐进行创意改编,重新写歌词,进行创作,你就会得到你自己歌词的 双截棍。

AiPlayerShow的博客 6013

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

节日福利 | 6 个圣诞相关的高质量数据集+算力

By 超神经场景描述:又是一年一度的平安夜 + 圣诞节,除了苹果和圣诞树,还有什么新鲜花样吗?为了让 21 世纪 20 年代的最后一个圣诞节有所不同,超神经今天特地给大家带来了多个圣诞节...

HyperAI超神经 1437

一次吐血微调

经过这次折腾,我算是彻底活明白了。如果是做垂直领域的信息查询千万别上来就搞微调!微调像是把孩子关起来背字典,背错了还容易瞎编(幻觉),字典更新了还得重新背。RAG像是允许孩子带字典进考场(开卷考试),哪里不会翻哪里,又快又准。想让AI学周杰伦说话的语气?你去微调。想让AI查周杰伦的资料?请老老实实选 RAG。简单粗暴的“翻书找答案”,才是最香的。

之之为知知 610

DL之CharRNN:人工智能为你写英语小说短文/中文写诗/中文写歌词/写代码——基于TF利用RNN算法训练数据集(比如Coriolanus等)、训练&测试过程全记录

​ DL之CharRNN:人工智能为你写英语小说短文/中文写诗/中文写歌词/写代码——基于TF利用RNN算法训练数据集(比如Coriolanus等)、训练&测试过程全记录 目录 人工智能为你写小说——基于TF利用RNN算法训练数据集(William Shakespeare的《Coriolanus》)替代你写英语小说短文、训练&测试过程全记录 人工智能为你写诗——基于TF利用RNN算法实现【机器为你写诗】、训练&测试过程全记录 人工智能为你写周董歌词——基于TF利用RNN算法实现【机器

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

不用叫方文山!AI 能拯救杰伦的土味歌词


 硅谷Live / 实地探访 / 热点探秘 / 深度探讨前两天,当小探第一次听到周杰伦的《不爱我就拉倒...

硅谷密探 5862

Tensorflow2.0之用循环神经网络生成周杰伦歌词

文章目录1、导入需要的库2、加载数据集3、相邻采样4、定义模型4.1 定义循环神经网络层4.2 定义循环神经网络5、定义预测函数6、裁剪梯度7、定义模型训练函数7.1 困惑度7.2 初始化优化器7.3 定义梯度下降函数7.4 定义训练函数7.5 训练 在Tensorflow2.0之从零开始实现循环神经网络中,我们介绍了循环神经网络的原理以及如何使用低级API来实现循环神经网络,在这篇文章中,我们将...

cocofisher的博客 6205

语言模型数据集 (周杰伦专辑歌词)

文章目录引入1 原始数据处理2 时序数据的采样2.1 随机采样2.2 相邻采样 引入   该数据集收集了杰伦第一张专辑《Jay》到第十张专辑《跨时代》中的歌词。   下载地址:https://codechina.youkuaiyun.com/mirrors/shusentang/dive-into-dl-pytorch/-/blob/master/data/jaychou_lyrics.txt.zip 参考文献: 【1】李沐、Aston Zhang等老师,动手学深度学习 1 原始数据处理   函数参数包括数据集的路

因吉的博客 4797

Datawhale 组对学习打卡营 任务9:循环神经网络进阶

载入数据 import os os.listdir('/home/kesci/input') output: ['d2lzh1981', 'houseprices2807', 'jaychou_lyrics4703', 'd2l_jay9460'] import numpy as np import torch from torch import nn, optim import torch...

wjl__ai__的博客 185

Tensorflow2.0之从零开始实现循环神经网络

文章目录循环神经网络介绍代码实现1、导入需要的库2、加载周杰伦歌词数据集3、定义采样函数3.1 随机采样3.2 相邻采样4、one-hot向量5、初始化模型参数6、定义模型6.1 初始化隐藏状态6.2 在一个时间步里计算隐藏状态和输出7、定义预测函数8、裁剪梯度9、定义模型训练函数9.1 困惑度9.2 初始化优化器9.3 定义梯度下降函数9.4 定义训练函数9.5 训练 循环神经网络介绍 在循环神...

cocofisher的博客 6130

AI写诗

引言:自然语言处理是计算机科学领域与人工智能领域中的一个重要方向。它研究能实现人与计算机之间用自然语言进行有效通信的各种理论和方法。自然语言处理是一门融语言学、计算机科学、数学于一体的科学。因此,这一领域的研究将涉及自然语言,即人们日常使用的语言,所以它与语言学的研究有着密切的联系,但又有重要的区别。自然语言处理并不是一般地研究自然语言,而在于研制能有效地实现自然语言通信的计算机系统,特别是其中的...

water的博客 7702
上一篇: 他用科技复活传统艺术:发现甲骨文的终极浪漫
下一篇: 高清彩色开国典礼将上映:技术加持之下,历史不会褪色
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值