


Datawhale 社区成员 / AI 算法工程师、架构师
2026 年 9 月 20 日,千问团队开源了 Qwen-Image-2.1——一个统一支持文生图与图像编辑的模型。它的视觉生成模块为 7B 参数、32 层 Single-Stream DiT,文本与条件图像编码由 Qwen3-VL-8B 完成。官方将其定位为结构紧凑、兼顾效率与通用性的图像模型。
我们来看一下官方与社区实测给出的关键规格:
| 属性 | 数值 |
|---|---|
| 定位 | 统一文生图 + 图像编辑模型 |
| 视觉生成模块 | 7B 参数,32 层 Single-Stream DiT(Block-Causal 注意力) |
| 文本/条件编码器 | Qwen3-VL-8B(文字指令与参考图走同一条编码路径) |
| 核心链路参数 | 约 16B(ModelScope 仓库标注 16.22B) |
| VAE | 64 通道 RGBA 自编码器,空间压缩倍率 16× |
| 分辨率 | 原生 2K,默认 2048×2048,7 种宽高比最大到 2752×1536 |
| 推理配置 | Flow Matching + Euler 调度,建议 40 步;服务默认值可能不同 |
| 参考图 | 模型最多支持 10 张;vLLM-Omni 当前配方每次最多 4 张 |
| 透明图像 | 原生 RGBA 输出,透明通道在 latent 空间直接生成 |
| 权重体积 | 约 33 GB(ModelScope 仓库) |
| 开源协议 | Qwen Research License(限非商业与研究用途) |
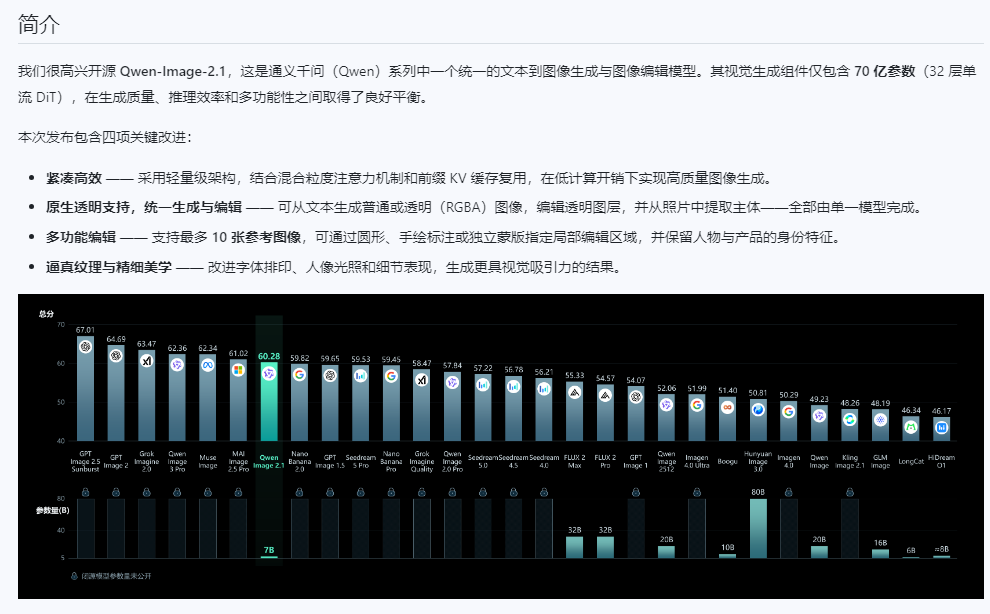
四项官方主打的升级:更紧凑高效的模型结构(DiT 从上一代 20.4B 瘦到 7B)、原生透明图像(RGBA 图层可直接生成与编辑)、更灵活的多图与局部编辑(模型最多支持 10 张参考图,实际数量受推理后端限制)、文字与人物光影细节改善。其中透明图这一项,ComfyUI 官方博客的原话是 “No other major open model does this”。
一、在 GPUStack 上部署 Qwen-Image-2.1
Qwen-Image-2.1 是扩散(DiT)模型,不是自回归 LLM,因此不能直接用常规 vLLM 跑。它走的是 vLLM-Omni 这条线——这是 vLLM 项目专门为扩散 / 多模态生成模型做的运行时,在发布当天(Day 0)就提供了对 Qwen-Image-2.1 的支持。
在 GPUStack 里的思路和部署 LLM 一样:先在「推理后端」为 vLLM 加一个指向 vLLM-Omni 的版本,剩下的部署流程仍然是 Web 界面几步完成。
笔者的 GPU 环境:NVIDIA A800-SXM4-80GB;驱动版本:570.172.08;CUDA 版本:12.8。
① 进入「推理后端」,先为 vLLM 添加一个 vLLM-Omni 版本
关键顺序:必须先在「推理后端」里加好这个镜像版本,部署页面的「后端版本」下拉框才能选到它。
左侧菜单进入 推理后端,找到 vLLM 卡片点「编辑」,在「版本配置」里点「添加版本」。
- 版本号:填
qwen-image21 - 镜像名称:填
vllm/vllm-omni:qwen-image21(本文使用的镜像标签)。请确认该镜像是包含 Qwen-Image-2.1 适配代码的构建。截至本文核对时,vLLM 官方配方说明该模型支持尚未进入带版本的发布包,需按配方使用相应分支构建;不能仅凭镜像名称判断它是官方发布标签。 - 框架:选择 CUDA。
- 覆盖镜像入口命令(ENTRYPOINT):保持默认的
vllm serve。执行命令需在默认参数模板中加入--omni,例如:{{model_path}} --omni --host {{worker_ip}} --port {{port}} --served-model-name {{model_name}}。
保存后即可在部署页面选择 qwen-image21 版本。
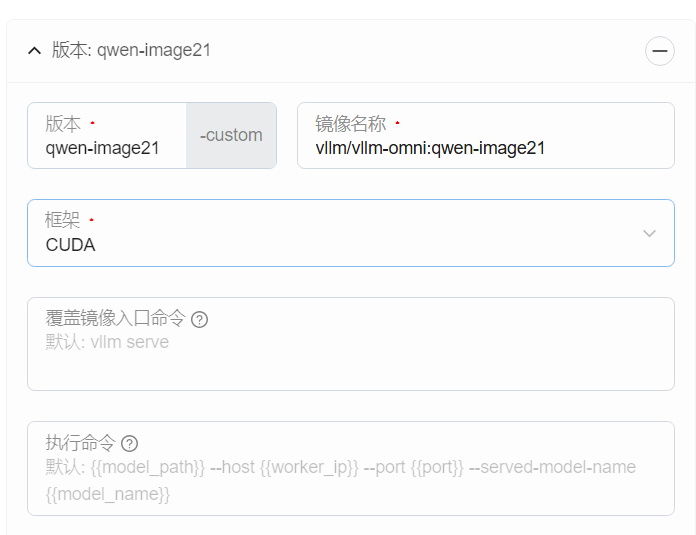
⚠️ 关于镜像与启动参数:Qwen-Image-2.1 需要 vLLM-Omni 的扩散推理实现,并通过
vllm serve <模型名> --omni启动。请确保镜像中包含对应模型代码,并确认 GPUStack 的启动配置实际传入了--omni;普通 vLLM 镜像或未带此参数的配置无法按本文示例运行。
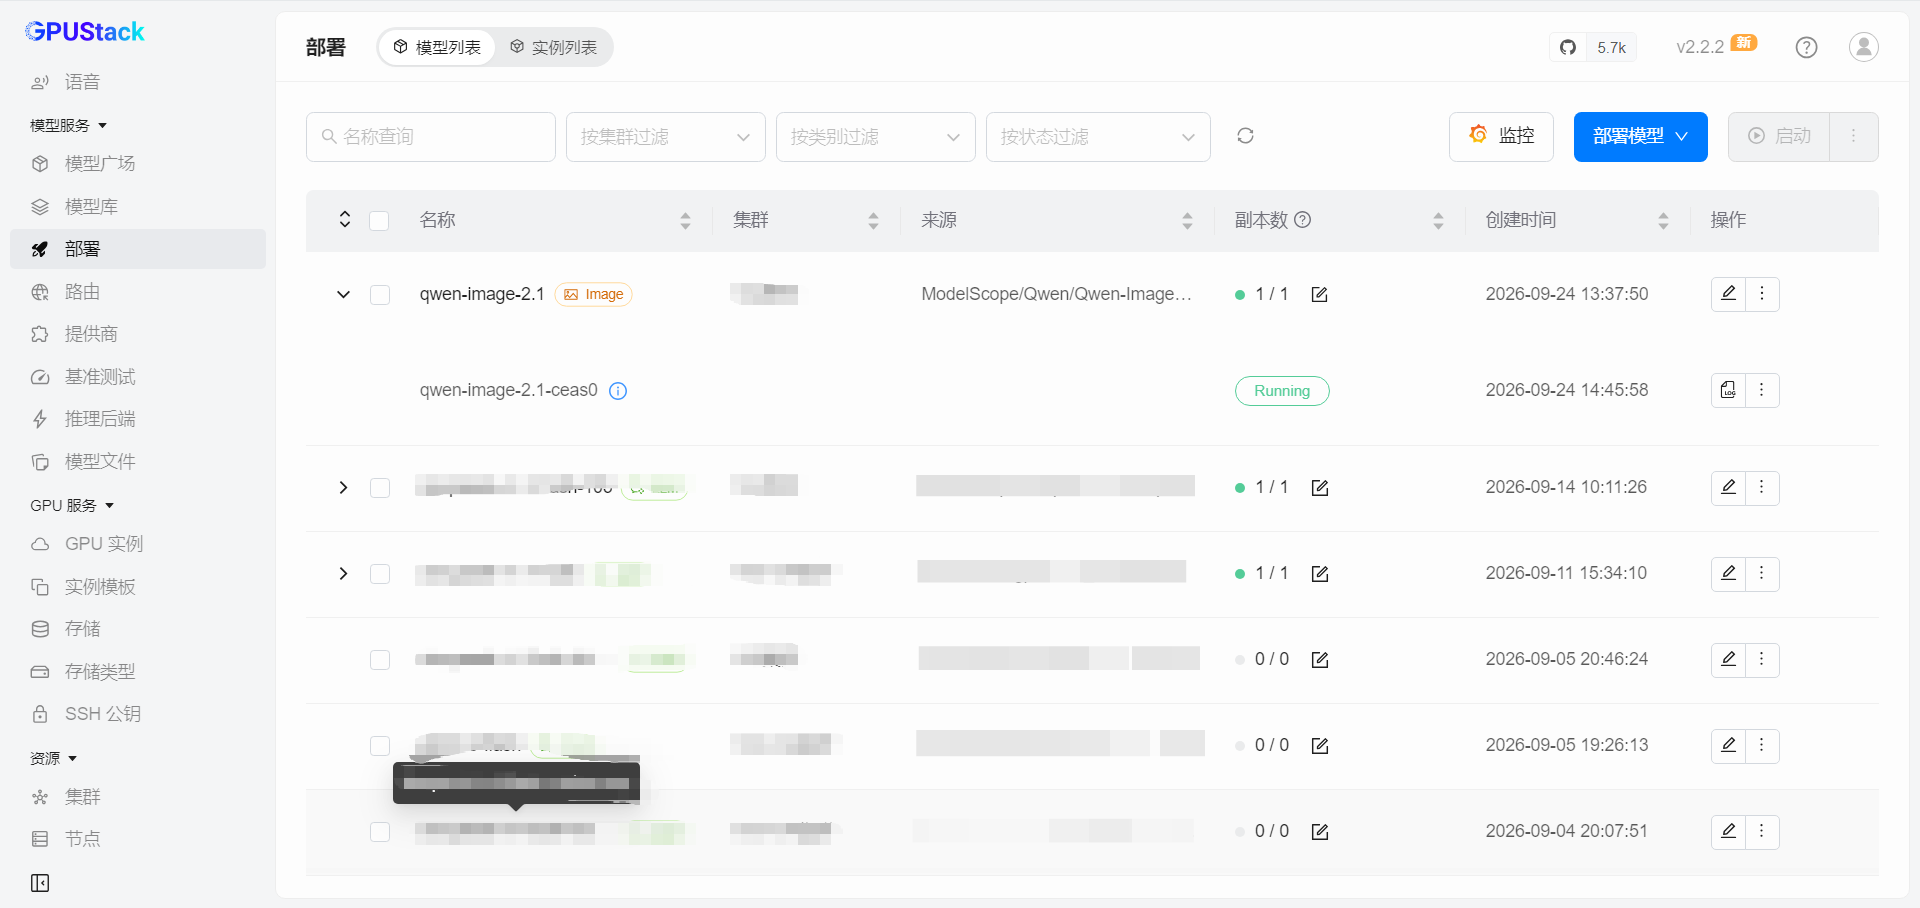
② 新建部署,选模型与后端
回到 部署 页面,点右上角「部署模型」,按下图填写基本信息:
- 来源:选择 ModelScope(本文示例使用 ModelScope;也可根据网络环境选择模型来源),仓库 ID 填
Qwen/Qwen-Image-2.1。 - 后端:选择 vLLM。
- 后端版本:选择刚才添加的
qwen-image21版本。
提交后,等待实例进入 Running。如果模型无法加载,先检查镜像版本、--omni 启动参数及模型仓库访问权限。
二、验证与调用
1. 通过 OpenAI 兼容接口出图
vLLM-Omni 在 --omni 模式下同时注册了两个端点,都兼容 OpenAI 规范:
/v1/images/generations:标准的图像生成接口/v1/chat/completions:对话接口,支持多模态输入
/v1/chat/completions 使用多模态消息结构:messages[].content 是数组,文字放在 text 分片中。调用图像生成时还要在请求体中指定 modalities: ["image"]:
curl -s http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <API_KEY>" \
  -d '{
    "model": "qwen-image-2.1",
    "messages": [
      {
        "role": "user",
        "content": [
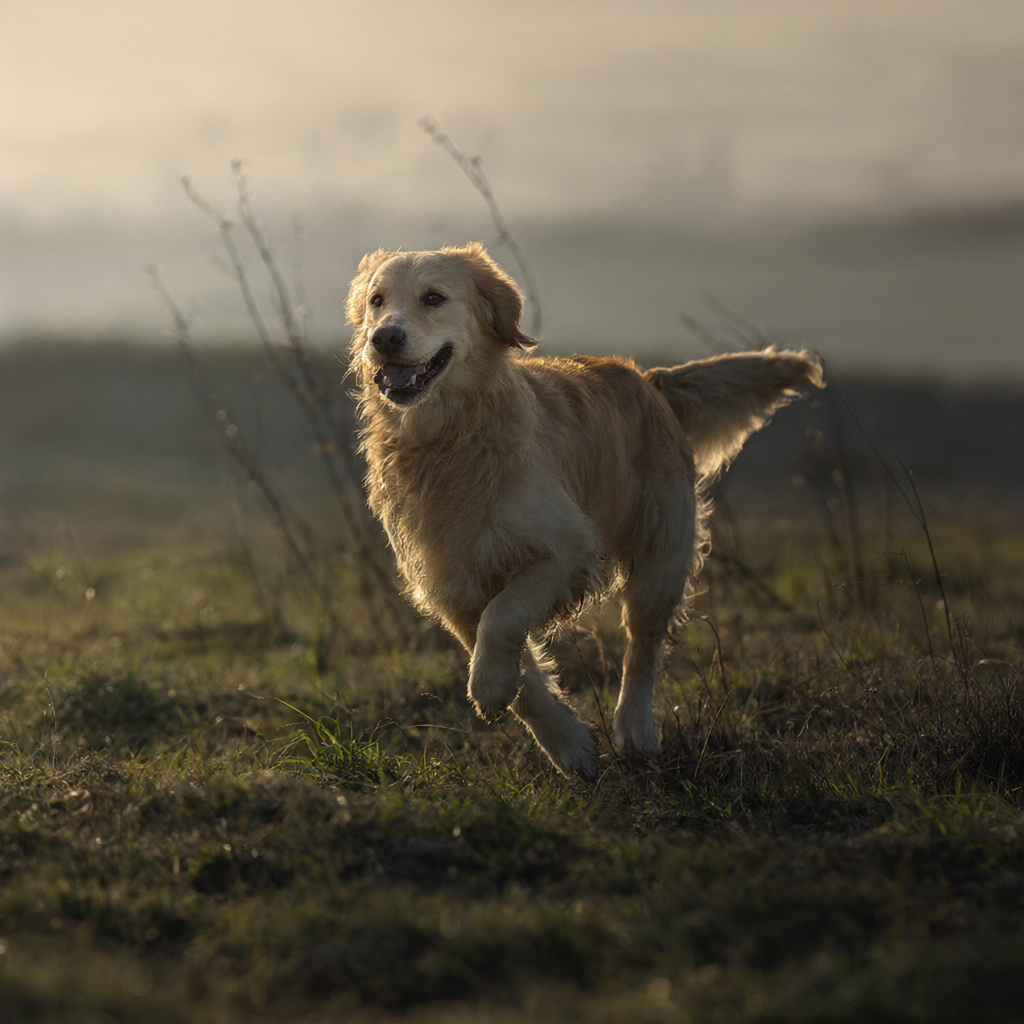
          {"type": "text", "text": "一只在草地上奔跑的金毛犬,逆光,电影感"}
        ]
      }
    ],
    "modalities": ["image"],
    "extra_body": {
      "size": "1024x1024",
      "num_inference_steps": 40,
      "true_cfg_scale": 1.0,
      "seed": 42
    }
  }'
需要带参考图做图像编辑时,在 content 中追加 image_url 分片,并保留 modalities: ["image"] 与图像生成参数:
    "content": [
      {"type": "text", "text": "把参考图中的主体提取为透明背景图层"},
      {"type": "image_url", "image_url": {"url": "data:image/png;base64,<参考图 base64>"}}
    ]
请求参数说明:
model:与部署时填写的模型名保持一致。messages[].content:使用数组结构,text分片放提示词,image_url分片放参考图。image_url.url:可使用data:image/png;base64,<内容>形式的 data URI。vLLM-Omni 当前配方对 data URI 有 1 MiB 的单部分大小限制;较大的参考图建议使用/v1/images/edits文件上传接口。
响应中的图片位于 choices[0].message.content[0].image_url.url。文生图接口 /v1/images/generations 的图片则位于 data[0].b64_json。
而对于 /v1/images/generations,分辨率、步数、引导强度这些生成参数直接放在请求体里传:
curl -s http://localhost:8000/v1/images/generations \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <API_KEY>" \
  -d '{
    "model": "qwen-image-2.1",
    "prompt": "一只戴着毛线帽的柯基,坐在窗边的木桌上,旁边有一杯冒热气的咖啡",
    "size": "2048x2048",
    "num_inference_steps": 40,
    "true_cfg_scale": 1.0,
    "seed": 42
  }'
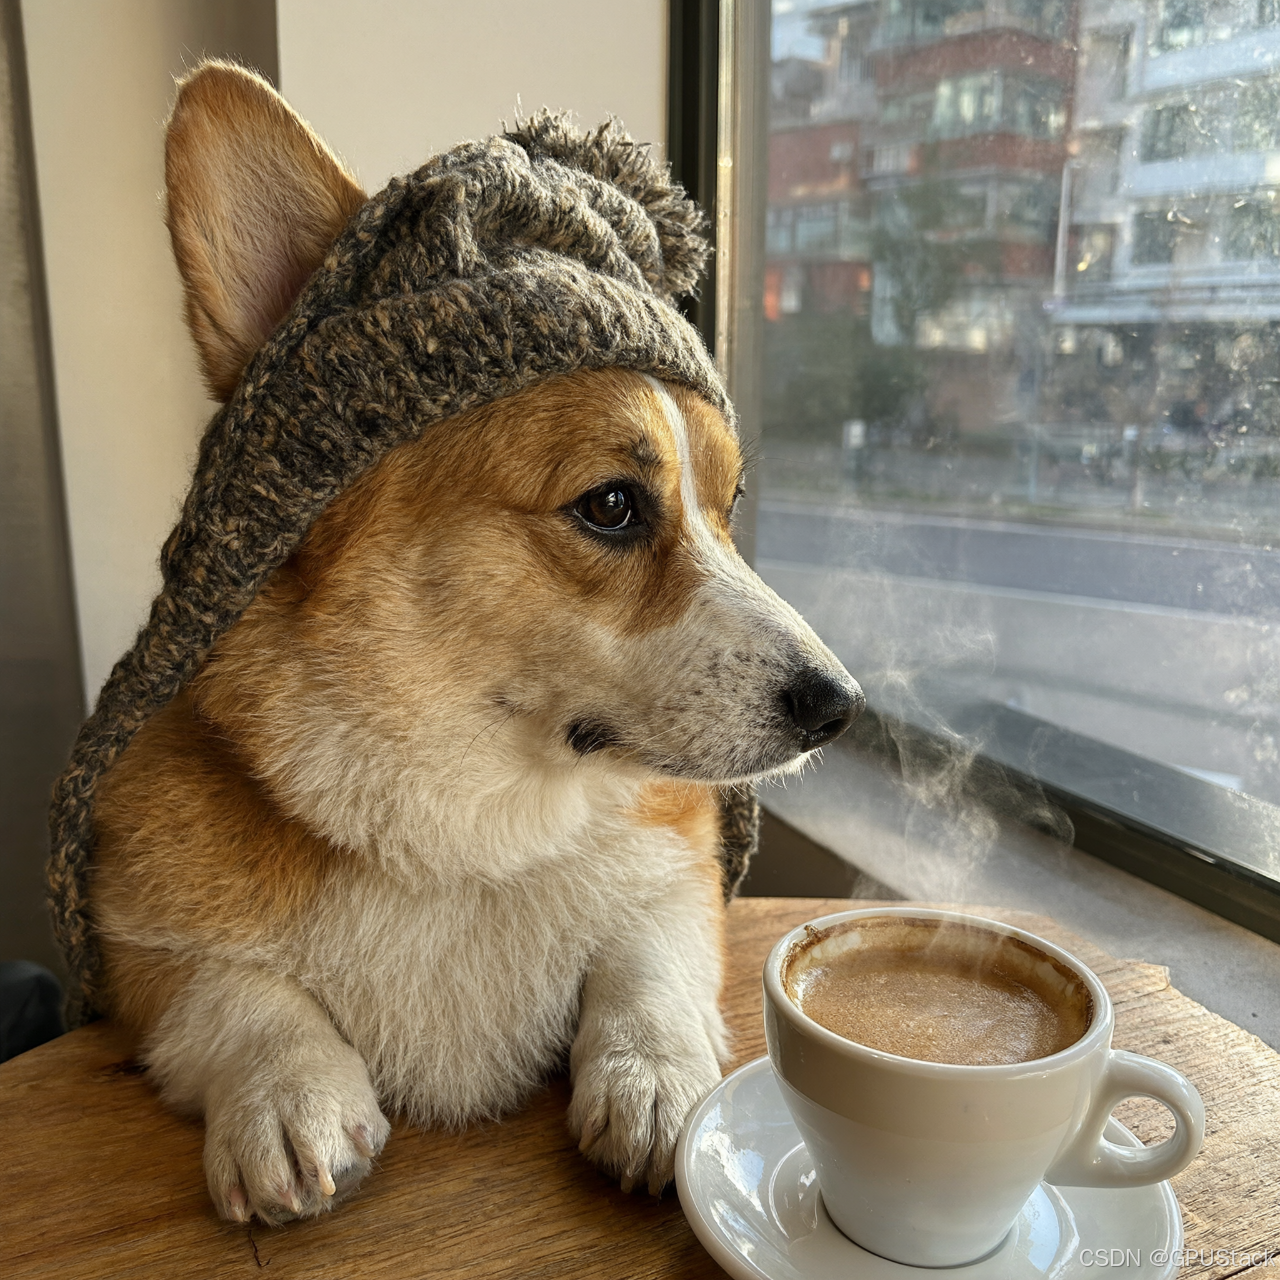
需要留意的参数:
num_inference_steps:建议显式设置为 40。步数增加通常会延长生成时间,效果也受提示词和采样设置影响。seed:想要可复现的编辑结果时固定它。true_cfg_scale:本文示例设为1.0。不要与guidance_scale混用;若同时传入负向提示词,需留意引导设置对耗时和结果的影响。
2. 图像编辑与多图融合
这是 2.1 相比纯文生图模型的重要能力之一:把参考图一起传入,模型可以在理解既有素材的基础上重新组织画面,并尽量保持人物身份和商品外观。官方展示的典型场景包括:
- 6 张人像合成合影:单人肖像分别输入,合成到同一张多人合照
- 5 件单品合成穿搭:模特、服装、鞋子、包、帽子,直接出虚拟试穿效果
- 10 张家具图排室内布置:一次输入全套家具,重新组合出一个完整空间
参考图数量:以实际推理后端支持为准。模型规格最多支持 10 张,但 vLLM-Omni 当前配方限制为每次最多 4 张。局部编辑的圈选、涂画和独立 mask 等控制方式,也应先确认所用 API 与部署版本是否支持。
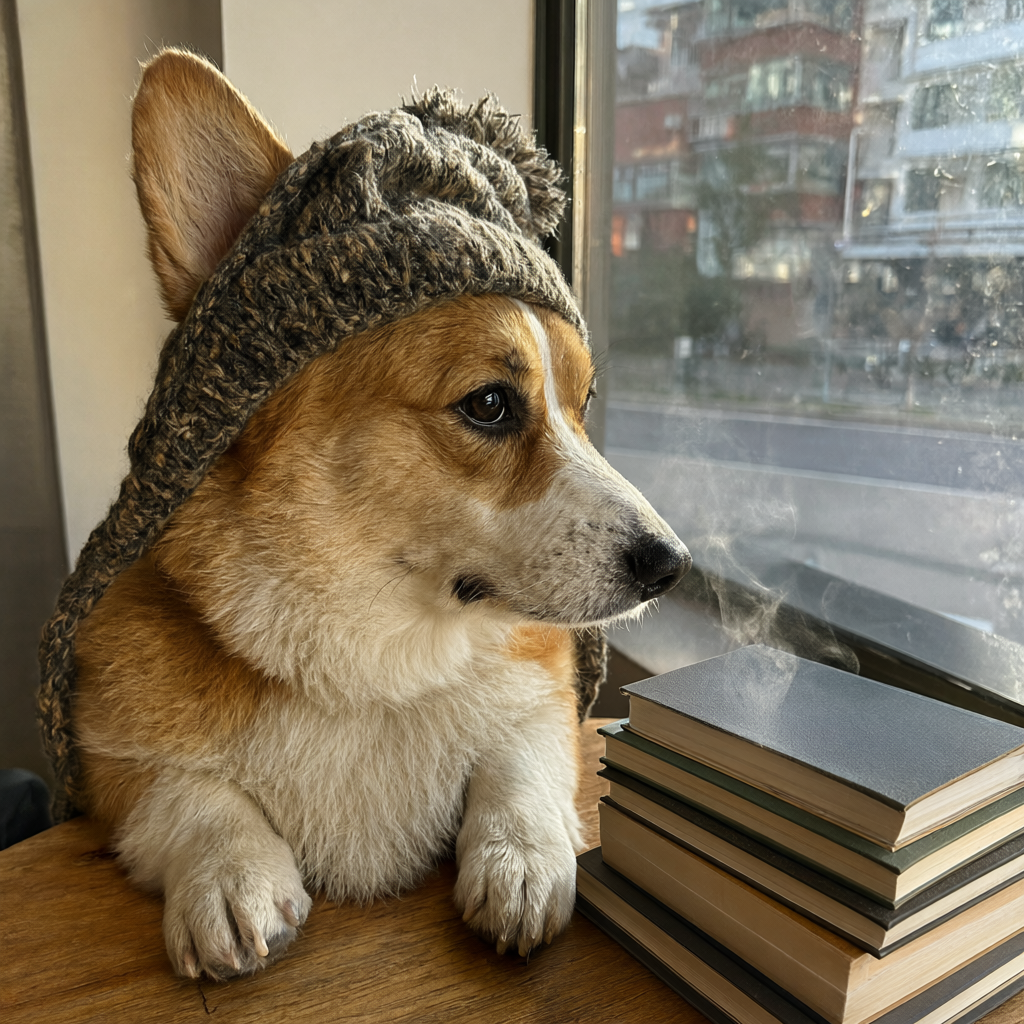
下面直接对前面生成的图片做一次编辑:把参考图作为 image_url 分片传进 /v1/chat/completions,让模型在保留原图结构的基础上只改指定内容。
curl -s http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <API_KEY>" \
  -d '{
    "model": "qwen-image-2.1",
    "messages": [
      {
        "role": "user",
        "content": [
          {"type": "text", "text": "把参考图桌上那杯咖啡换成一摞书"},
          {"type": "image_url", "image_url": {"url": "data:image/png;base64,<IMG_B64>"}}
        ]
      }
    ],
    "modalities": ["image"],
    "extra_body": {
      "size": "1024x1024",
      "num_inference_steps": 40,
      "true_cfg_scale": 1.0,
      "seed": 42
    }
  }'
返回图片位于 choices[0].message.content[0].image_url.url。如果该字段是 data URI,可提取其中的 Base64 内容并解码为 edited.png。较大的参考图片请使用 /v1/images/edits 文件上传接口,避免 data URI 超过大小限制。
3. 原生透明图
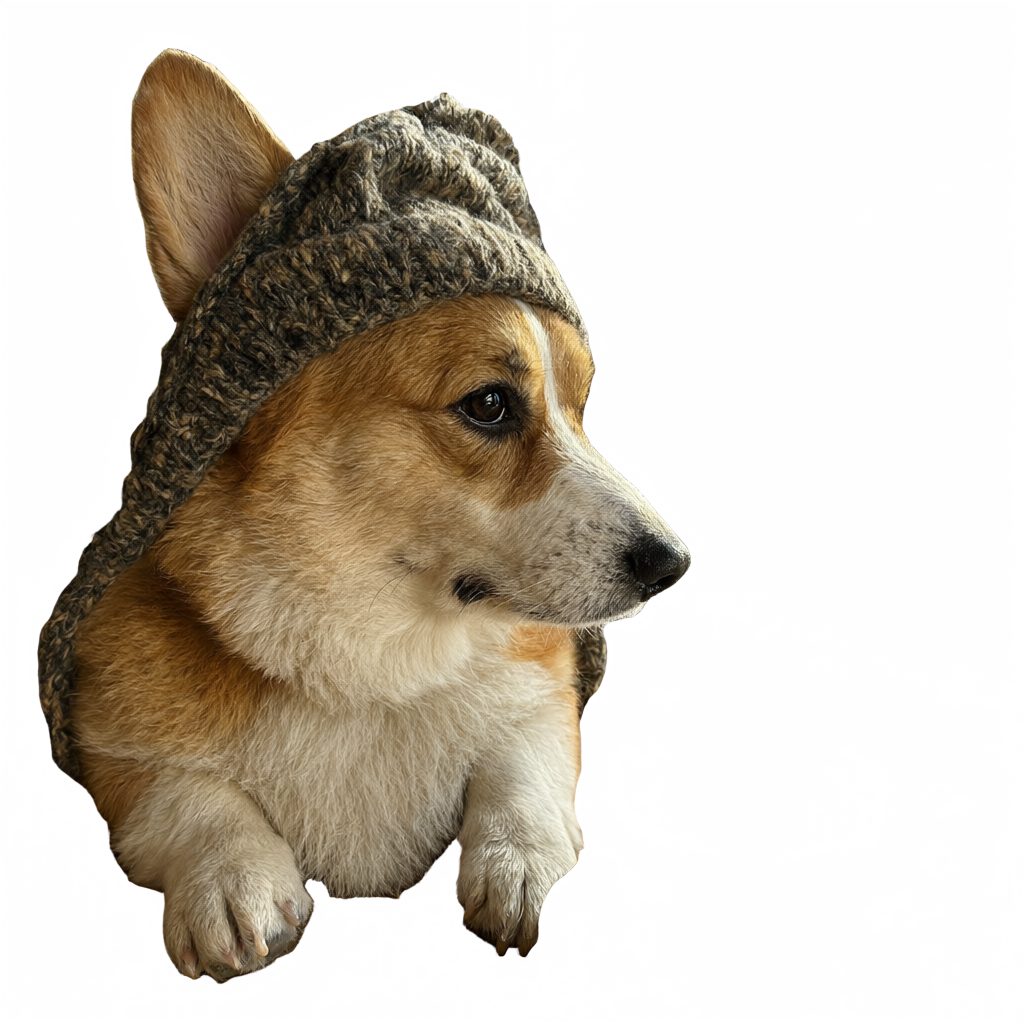
透明通道是在 latent 空间里直接生成的,不是后期抠图。这意味着输出的 PNG 拿去做信息图、分镜、贴纸、Logo 时,不需要再串一个背景移除 / 分割模型。同一套能力也能反向用:把普通照片里的主体提取成透明图层,或者只改透明图层里的文字而保住背景。
把已有图片作为 image_url 分片传进 /v1/chat/completions,让模型把主体抠成透明图层。请先确认当前服务配置会以 RGBA 格式输出;模型具备透明通道能力,不代表所有服务配置都会默认保留 Alpha 通道。
curl -s http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <API_KEY>" \
  -d '{
    "model": "qwen-image-2.1",
    "messages": [
      {
        "role": "user",
        "content": [
          {"type": "text", "text": "把参考图中的主体提取为透明背景图层"},
          {"type": "image_url", "image_url": {"url": "data:image/png;base64,<IMG_B64>"}}
        ]
      }
    ],
    "modalities": ["image"],
    "extra_body": {
      "size": "1024x1024",
      "num_inference_steps": 40,
      "true_cfg_scale": 1.0,
      "seed": 42
    }
  }'
返回图片位于 choices[0].message.content[0].image_url.url。解码后可得到带 Alpha 通道的 PNG;请检查实际输出文件确实保留透明通道。
三、需要注意的事项
-
许可证不是 Apache-2.0。Qwen-Image-2.1 使用 Qwen Research License,授权范围为非商业研究或评估用途。商业用途需先取得单独授权,并应以许可证原文为准。
-
榜单分数受评测方法影响。引用 Qwen-Image-Bench 时,建议注明评测版本、数据日期和来源,并说明该榜单由 Qwen 团队发布;不能将其结果等同于第三方独立评测。
-
社区体验不等于统一结论。编辑、多图参考合成和透明图是官方重点展示的能力;写实效果、伪影和多人一致性等表现会随提示词、分辨率及推理配置而变化。引用社区反馈时建议补充具体来源和测试条件。
资料来源
- Qwen-Image-2.1 官方仓库与模型说明
- Qwen Research License
- vLLM Recipes:Qwen-Image-2.1
- vLLM-Omni Qwen-Image-2.1 适配 PR
总结
Qwen-Image-2.1 做的事情很清晰:把上一代 20.4B 的 DiT 压到 7B,把文生图、图像编辑、透明图三条原本分散的产线合并进一个 checkpoint,再用 Qwen3-VL 统一文本与条件图的编码路径。配合 Block-Causal 注意力带来的 prefix KV 复用,多图编辑场景的推理开销被明显压下来。
借助 GPUStack 可插拔的 vLLM 后端,可以先配置包含 Qwen-Image-2.1 适配代码的 vLLM-Omni 镜像,再选择 ModelScope 仓库 Qwen/Qwen-Image-2.1,并确认启动命令包含 --omni。镜像需与所用 vLLM-Omni 代码版本匹配;图像生成和编辑接口的参数、输入格式及参考图数量也应以该版本的官方配方为准。
实测参考环境:NVIDIA A800-SXM4-80GB | 驱动版本:570.172.08 | CUDA 版本:12.8 | GPUStack v2.2.2
 179


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


