


vLLM 最近新增了 --performance-mode {balanced, interactivity, throughput}。从命名上看,这像是一个直接面向用户的性能选项:交互优先、吞吐优先,或者保持平衡。
这类参数很容易让人产生一种直觉:
既然已经明确区分了交互和吞吐,那实际部署时是不是只要选对 mode,性能就会自然往正确方向走。
但真正把实验跑完之后,会发现问题没有这么简单。
有些场景下,单独打开 performance-mode 并没有直接带来收益;有些场景下,它要和量化、prefix cache、speculative decoding 叠在一起看,才能看出价值。
真正值得关注的,可能不是“它能不能单独提速”,而是 vLLM 正在把推理调优从“逐个猜参数”往“先按目标收敛方向”推进。
这篇文章主要回答三个问题:
performance-mode当前到底解决了什么问题- 在真实 workload 下,它单独使用时效果如何
- 它和 backend、量化、prefix cache、speculative decoding 这些常见优化手段相比,应该放在什么位置看
实验数据来自两组测试:
- Qwen3.5-9B on NVIDIA H100 80GB HBM3
- Qwen3.5-35B-A3B on NVIDIA H200
Performance-mode 到底是什么
截至 2026 年 3 月 30 日,performance-mode 来自 vLLM PR
https://github.com/vllm-project/vllm/pull/34936 ,并已于 2026 年 2 月 26 日合并进主分支,该功能从 v0.17.0 开始提供。
当前 vLLM 文档中,这个参数提供三个选项:
balancedinteractivitythroughput
官方文档对它的说明比较明确:
interactivity偏向小 batch 下更低的端到端请求延迟throughput偏向高并发下更高的 aggregate tokens/secbalanced保持默认行为
从 PR 描述来看,这一版实现主要体现为:
interactivity使用更细粒度的 CUDA graph 捕获,偏向低延迟场景throughput使用更激进的 batch 上限,偏向高吞吐场景
因此,当前更适合把它看成一个:
“性能目标入口”,而不是一个独立完成优化的参数。
这轮实验想回答什么
如果只问一句“performance-mode 有没有用”,结论很容易过于简单。
更实际的问题是:
- 单独启用某个 mode 时,效果如何
- 它和 backend、量化、prefix cache、speculative decoding 相比,优先级在哪里
- 它带来的主要变化,是不是更多体现在“缩小调优范围”,而不是直接决定最终性能
本文主要基于以下实验文档整理:
- Qwen3.5-9B on H100 吞吐优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-9b/h100/ - Qwen3.5-9B on H100 时延优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-9b/h100-latency/ - Qwen3.5-35B-A3B on H200 吞吐优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-35b-a3b/h200/ - Qwen3.5-35B-A3B on H200 时延优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-35b-a3b/h200-latency/
给当前 performance-mode 一个更准确的定位
如果要给当前的 performance-mode 一个比较准确的定位,可以概括为一句话:
它不是替代实验的性能开关,而是一个把调优从“猜参数”推进到“按目标调优”的入口。
这背后主要是三点:
-
它能提供一个更合理的起点
偏交互场景,可以先从interactivity开始;偏吞吐场景,可以先从throughput开始。 -
它不能替代完整实验
单开某个 mode 不一定直接带来收益,很多情况下仍然要结合 engine、量化、cache 和 speculative decoding 一起看。 -
它缩短的是调优空间
以前往往需要先从很多底层参数里反复试;现在至少可以先把问题收敛成一句话:
当前是在优化交互,还是在优化吞吐。
Throughput:throughput 模式更像组合优化的一部分
Qwen3.5-9B / H100
backend 基线
Profile: ShareGPT
| Backend | Total TPS | Mean Latency | Mean TTFT | Mean TPOT |
|---|---|---|---|---|
| vLLM | 11527.14 | 24.11s | 1604.23ms | 15.12ms |
| SGLang | 6499.41 | 39.08s | 26217.15ms | 138.86ms |
这组结果说明,在这套实验里,后续的 performance-mode 调优是建立在“先选定 vLLM 作为更优 backend”的基础上的。
调优过程
| 调优步骤 | 配置特征 | Total TPS | 相对基线 |
|---|---|---|---|
| 基线 | vLLM 默认配置 | 11527.14 | 1.00x |
| Prefix Cache | --enable-prefix-caching | 11224.70 | 0.97x |
| Speculative Decoding | speculative decoding | 15059.89 | 成功率 51.5%,未纳入最终方案 |
只开 throughput | --performance-mode=throughput | 11496.39 | 0.997x |
调 max-num-seqs | 更高并发窗口 | 11532.64 | 1.0005x |
throughput + batched tokens | 更大 batch token | 11672.72 | 1.013x |
throughput + max-num-seqs=512 | 最终推荐配置 | 11768.22 | 1.021x |
这组结果比较清楚地说明:
- 单独启用
throughput,并没有直接带来收益 - 收益主要出现在它和
max-num-seqs、max-batched-tokens等参数联动之后
最终结果
推荐配置:
vllm serve Qwen/Qwen3.5-9B \
  --reasoning-parser=qwen3 \
  --performance-mode=throughput \
  --max-model-len=32768 \
  --max-num-seqs=512
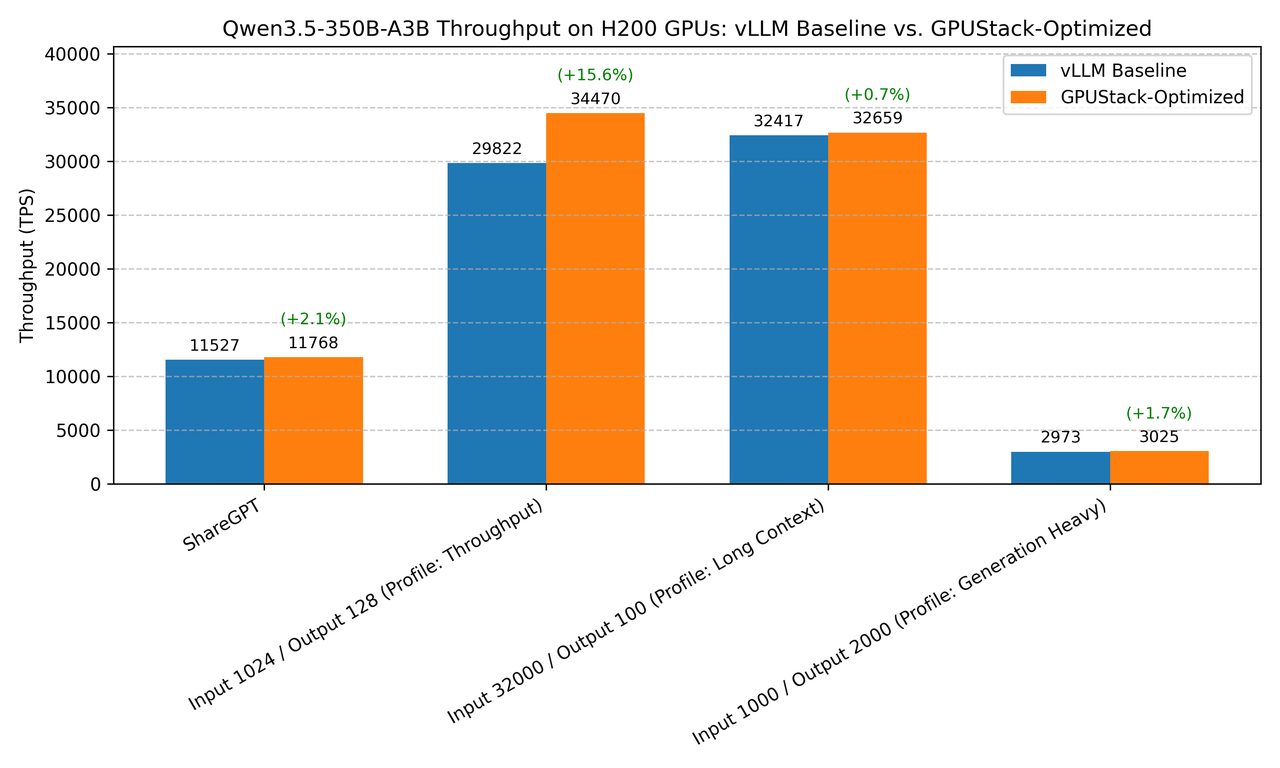
不同 profile 下的结果如下:
| Profile | 基线 | 优化后 | 变化 |
|---|---|---|---|
| ShareGPT Profile | Total TPS: 11527.14 / Mean TPOT: 15.12ms | Total TPS: 11768.22 / Mean TPOT: 15.85ms | +2.09% |
| Throughput Profile | Total TPS: 29822.16 / Mean TPOT: 34.63ms | Total TPS: 34470.14 / Mean TPOT: 36.97ms | +15.59% |
| Long Context Profile | Total TPS: 32416.84 / Mean TPOT: 10.21ms | Total TPS: 32658.73 / Mean TPOT: 9.97ms | +0.75% |
| Generation Heavy Profile | Total TPS: 2973.42 / Mean TPOT: 0.33ms | Total TPS: 3025.11 / Mean TPOT: 0.12ms | +1.74% |
Qwen3.5-35B-A3B / H200
backend 基线
Profile: ShareGPT
| Backend | Total TPS | Mean Latency | Mean TTFT | Mean TPOT |
|---|---|---|---|---|
| vLLM | 9632.01 | 30.19s | 4072.64ms | 25.89ms |
| SGLang | 4995.66 | 50.86s | 34359.37ms | 180.73ms |
调优过程
| 调优步骤 | 配置特征 | Total TPS | 相对基线 |
|---|---|---|---|
| 基线 | vLLM 默认配置 | 9632.01 | 1.00x |
| Quantization | FP8 | 9942.93 | 1.032x |
| Prefix Cache + Quantization | prefix cache + FP8 | 10338.96 | 1.073x |
throughput + Prefix Cache + Quantization | 最终主路径 | 10570.88 | 1.097x |
| KV Cache Dtype + 上述组合 | 更复杂组合 | 10363.77 | 1.076x |
| Speculative Decoding + Quantization | speculative decoding + FP8 | 15514.15 | 成功率 51.6%,未纳入最终方案 |
这一组更适合用来说明 throughput 的真实位置:
- 第一层收益来自量化
- 第二层收益来自 prefix cache
- 第三层才是 throughput
也就是说,它的作用更接近“在合理配置基础上继续往吞吐方向收敛”。
最终结果
推荐配置:
vllm serve Qwen/Qwen3.5-35B-A3B-FP8 \
  --reasoning-parser=qwen3 \
  --performance-mode=throughput \
  --max-model-len=32768 \
  --enable-prefix-caching
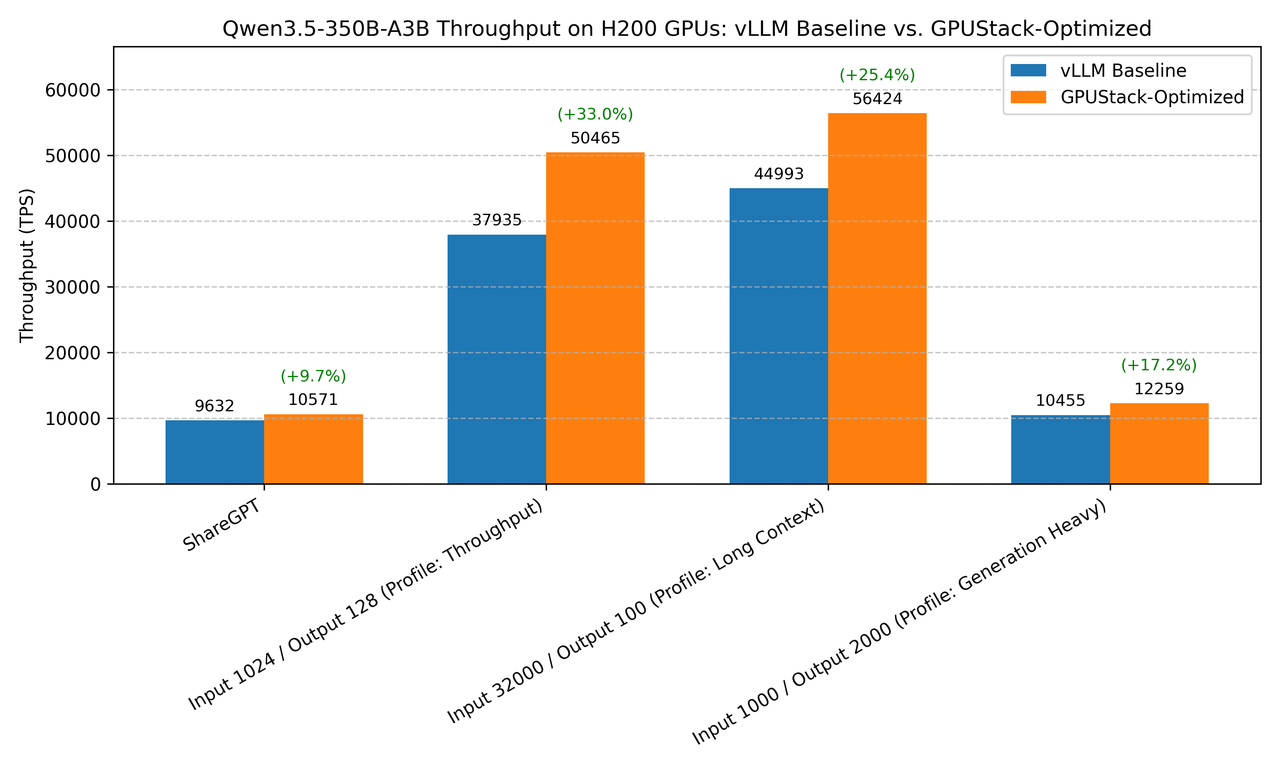
不同 profile 下的结果如下:
| Profile | 基线 | 优化后 | 变化 |
|---|---|---|---|
| ShareGPT Profile | Total TPS: 9632.01 / Mean TPOT: 25.89ms | Total TPS: 10570.88 / Mean TPOT: 24.71ms | +9.75% |
| Throughput Profile | Total TPS: 37934.72 / Mean TPOT: 45.39ms | Total TPS: 50464.84 / Mean TPOT: 41.12ms | +33.03% |
| Long Context Profile | Total TPS: 44993.20 / Mean TPOT: 319.79ms | Total TPS: 56424.42 / Mean TPOT: 227.43ms | +25.41% |
| Generation Heavy Profile | Total TPS: 10455.38 / Mean TPOT: 2.48ms | Total TPS: 12258.79 / Mean TPOT: 2.92ms | +17.25% |
Latency:interactivity 有帮助,但通常不是最先起效的变量
Qwen3.5-9B / H100
backend 基线
Profile: ShareGPT 8RPS
| Backend | Mean Latency | Mean TTFT | Mean TPOT | Total TPS |
|---|---|---|---|---|
| vLLM | 2.62s | 41.12ms | 1.34ms | 4867.84 |
| SGLang | 8.13s | 98.72ms | 28.88ms | 4754.13 |
调优过程
| 调优步骤 | 配置特征 | Mean Latency | 相对基线 |
|---|---|---|---|
| 基线 | vLLM 默认配置 | 2.62s | 1.00x |
| Prefix Cache | --enable-prefix-caching | 2.69s | 0.97x |
| Max Batch Token | 调 batch token | 2.64s | 0.99x |
| Max Num Seqs | 调 seqs | 2.64s | 0.99x |
| Speculative Decoding | speculative decoding | 2.39s | 1.09x |
Speculative + interactivity | 加 --performance-mode=interactivity | 2.38s | 1.10x |
Speculative + interactivity + --language-model-only | 最终推荐配置 | 2.32s | 1.13x |
这组数据说明,interactivity 的作用更多是进一步细调,而不是单独决定低延迟结果。
最终结果
vllm serve Qwen/Qwen3.5-9B \
  --reasoning-parser=qwen3 \
  --max-model-len=32768 \
  --speculative-config={"method":"mtp","num_speculative_tokens":1} \
  --language-model-only \
  --performance-mode=interactivity
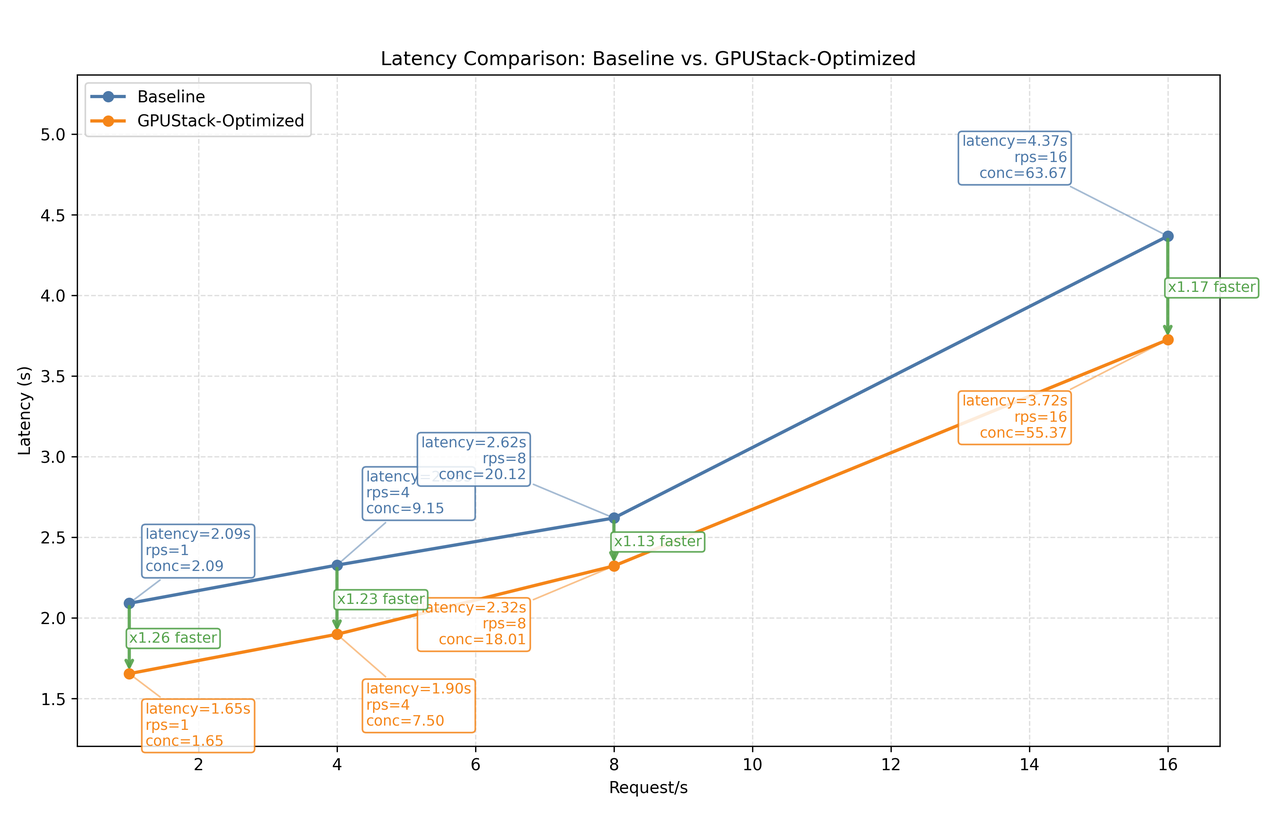
| Profile | 基线 | 优化后 | 变化 |
|---|---|---|---|
| Rate 1 | Mean latency: 2.09s | Mean latency: 1.65s | 1.26x faster |
| Rate 4 | Mean latency: 2.33s | Mean latency: 1.90s | 1.23x faster |
| Rate 8 | Mean latency: 2.62s | Mean latency: 2.32s | 1.13x faster |
| Rate 16 | Mean latency: 4.37s | Mean latency: 3.72s | 1.17x faster |
Qwen3.5-35B-A3B / H200
backend 基线
Profile: ShareGPT 8RPS
| Backend | Mean Latency | Mean TTFT | Mean TPOT | Total TPS |
|---|---|---|---|---|
| vLLM | 5.32s | 68.48ms | 2.35ms | 4734.87 |
| SGLang | 25.15s | 6456.42ms | 89.37ms | 4201.01 |
调优过程
| 调优步骤 | 配置特征 | Mean Latency | 相对基线 |
|---|---|---|---|
| 基线 | vLLM 默认配置 | 5.32s | 1.00x |
| Quantization | FP8 | 3.53s | 1.51x |
| CUDA Graph + Quantization | 调 graph capture + FP8 | 3.54s | 1.50x |
| Max Batch Token + Quantization | batch token + FP8 | 3.82s | 1.39x |
interactivity + Quantization | performance-mode=interactivity + FP8 | 3.67s | 1.45x |
| Prefix Cache + Quantization | prefix cache + FP8 | 3.70s | 1.44x |
| Speculative Decoding + Quantization | speculative decoding + FP8 | 3.28s | 1.63x |
这组数据更适合说明另一点:在大模型低延迟场景里,更先起效的往往是量化和 speculative decoding,而不是 interactivity 本身。
最终结果
vllm serve Qwen/Qwen3.5-35B-A3B-FP8 \
  --reasoning-parser=qwen3 \
  --speculative-config={"method":"mtp","num_speculative_tokens":1} \
  --max-model-len=32768
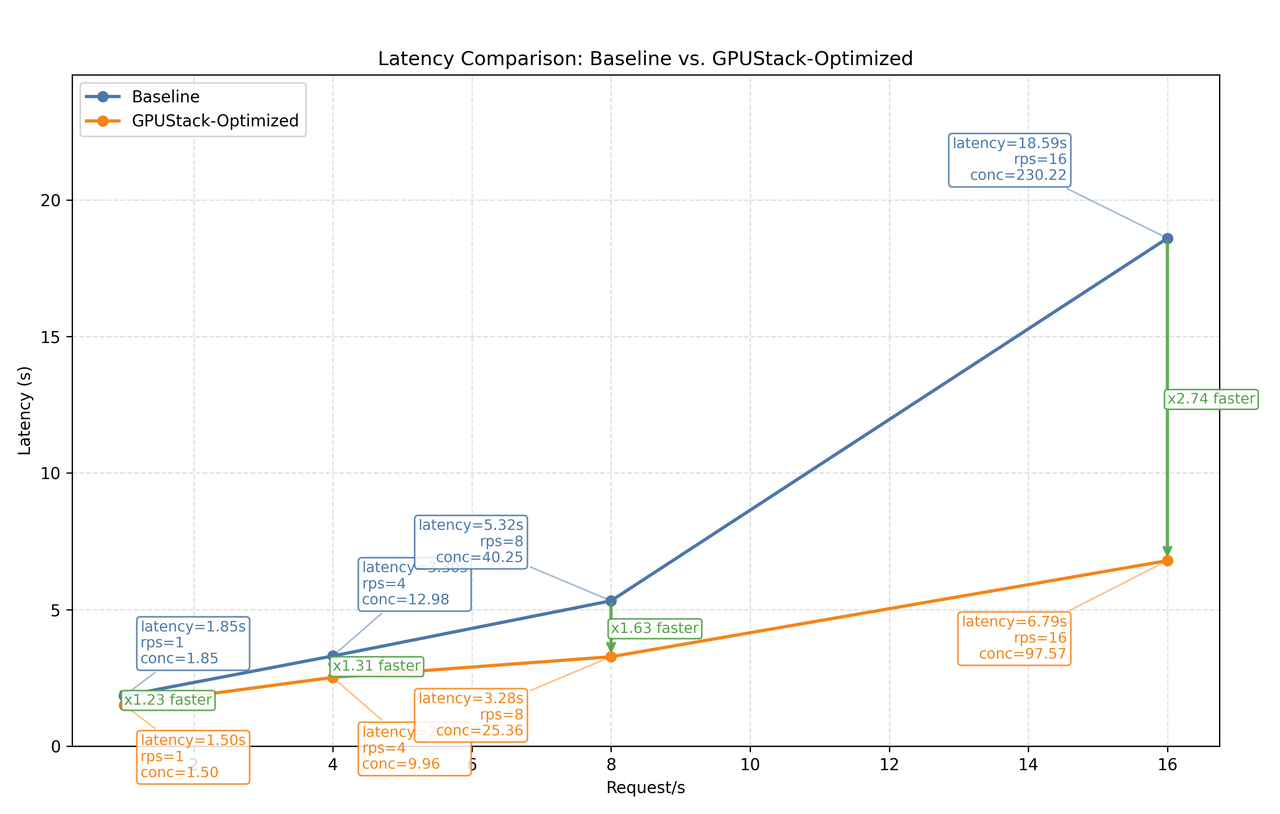
| Profile | 基线 | 优化后 | 变化 |
|---|---|---|---|
| Rate 1 | Mean latency: 1.85s | Mean latency: 1.50s | 1.23x faster |
| Rate 4 | Mean latency: 3.30s | Mean latency: 2.52s | 1.31x faster |
| Rate 8 | Mean latency: 5.32s | Mean latency: 3.28s | 1.63x faster |
| Rate 16 | Mean latency: 18.59s | Mean latency: 6.79s | 2.74x faster |
benchmark 真正解决的,是结果能不能回到上下文里看
推理优化里,真正消耗时间的通常不是想到一个优化点,而是把它稳定地跑完、比完,再确认结论是否只在某个 profile 下成立。
一个完整 benchmark 过程通常需要反复处理这些事情:
- 部署不同 backend
- 切换不同模型配置
- 提交不同 benchmark profile
- 收集结果
- 回看详细指标
- 对照模型配置和运行环境确认结果边界
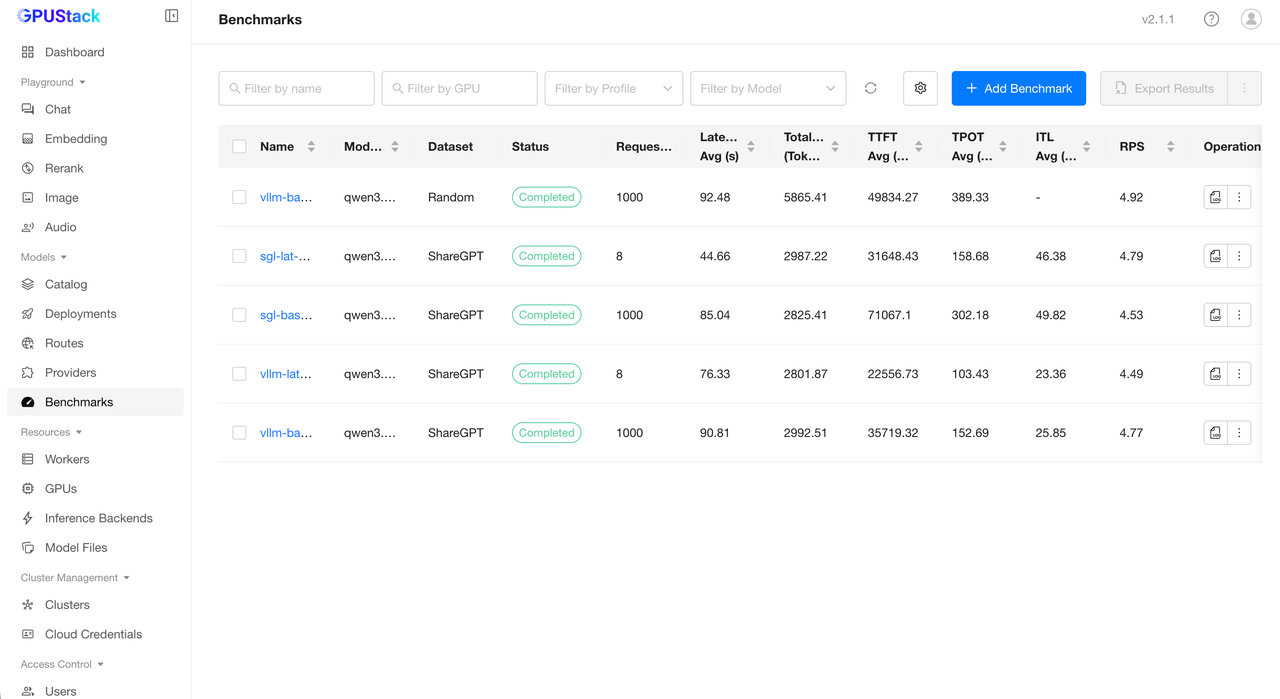
所以 benchmark 工具的重要性,更多在于两点:
1. 快速横向比较不同实验
不同 profile、不同 backend、不同配置之间的快速比较。
2. 完整保留实验细节
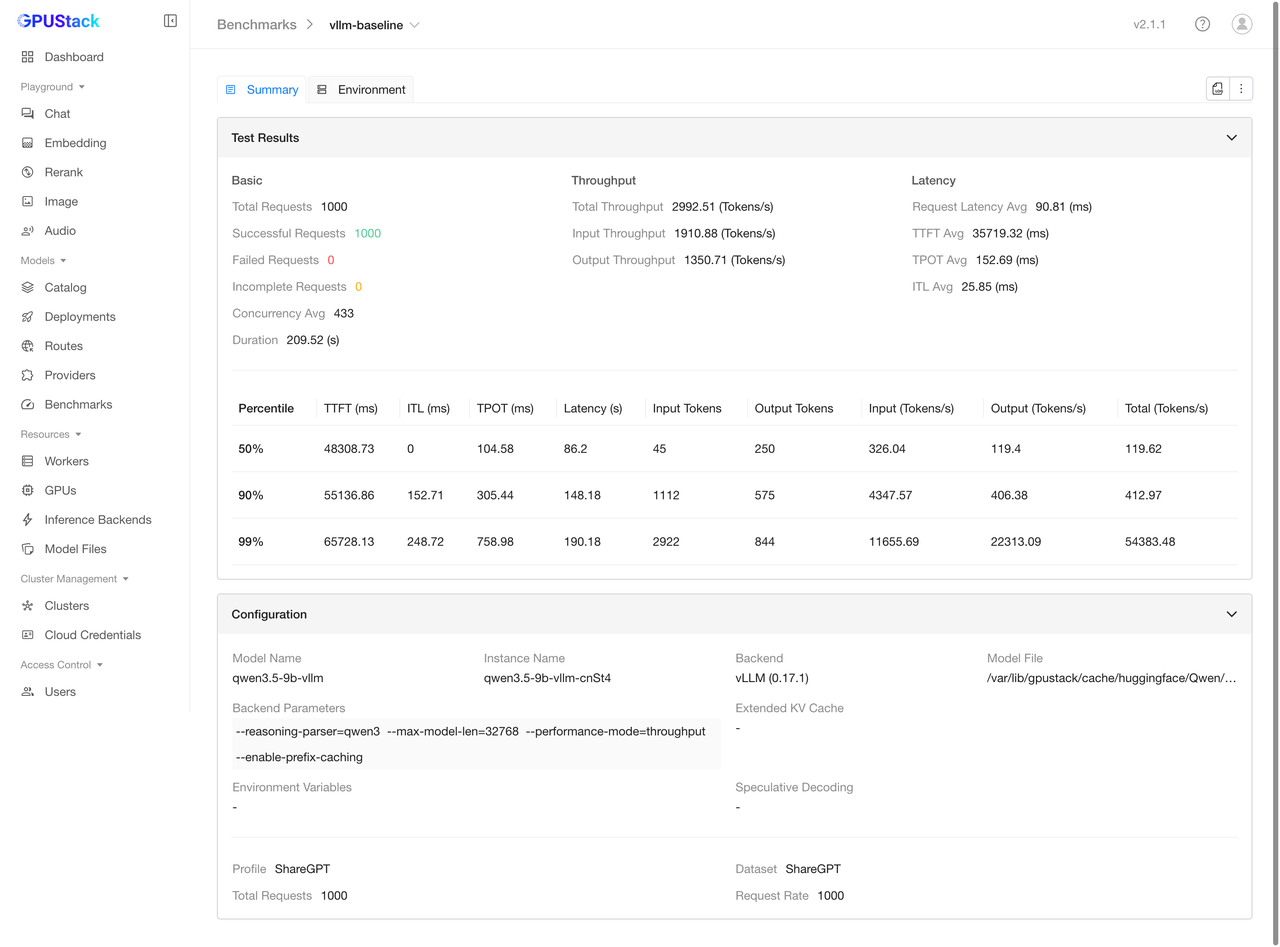
这些信息是否完整,直接决定后面的性能结论能不能复盘。
为什么实验方法比单次结果更重要
这次把整套实验串起来之后,一个比较直观的感受是:真正麻烦的不是“有没有优化点”,而是“实验过程能不能组织清楚”。
尤其是在同时比较这些维度的时候:
- 不同 backend
- 不同量化方式
- 不同 speculative decoding 配置
- 不同 benchmark profile
- 不同运行环境
如果这些信息是分散的,最后很容易只留下一个模糊印象,比如“某个参数好像有效”,但不容易回到具体实验上下文里确认它到底在什么条件下有效。
从这个角度看,GPUStack 更像是把部署、benchmark、结果查看和配置记录放在了一条链路里。这样做的意义,不是替实验下结论,而是让结论更容易回到原始实验里核对。
对这类性能调优工作来说,这一点往往比单次结果更重要。
结论
这轮实验看下来,performance-mode 的位置已经比较清楚:
它不是一个单独决定性能结果的参数,但它确实提供了一个更明确的调优起点。对于交互和吞吐这两类目标,这种“先按目标收敛方向,再进入具体实验”的方式,比直接从一堆底层参数开始尝试要更有效率。
把前面的实验步骤串起来看,GPUStack 承接的其实不是某一个单独参数,而是一整条从模型部署、模型调优到结果回顾的流程。
-
模型部署
先把模型以可测试、可切换的方式部署起来,为后续 backend 对比和 benchmark 实验建立统一起点。 -
模型调优
在同一套 benchmark 流程里比较 backend、量化、缓存策略、投机解码和performance-mode等不同优化手段,判断哪种组合在当前模型与负载下更有效。 -
结果回顾
不只是看一次跑分结果,还可以结合成功率、稳定性、配置和运行环境,把实验结果放回上下文里复盘,确认哪些结论值得保留。 -
快速 benchmark
把原本漫长、零散、手工化的试错流程,尽量收敛成一个可重复、可比较、可回看的实验过程。
参考资料
- vLLM PR: https://github.com/vllm-project/vllm/pull/34936
- vLLM 文档: Engine Arguments
https://docs.vllm.ai/en/latest/configuration/engine_args/ - 实验数据: Qwen3.5-9B on H100 吞吐优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-9b/h100/ - 实验数据: Qwen3.5-9B on H100 时延优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-9b/h100-latency/ - 实验数据: Qwen3.5-35B-A3B on H200 吞吐优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-35b-a3b/h200/ - 实验数据: Qwen3.5-35B-A3B on H200 时延优化实验
https://docs.gpustack.ai/latest/performance-lab/qwen3.5-35b-a3b/h200-latency/
加入 GPUStack 社区
GPUStack 社区聚焦 AI 基础设施与大模型实践。
社区中持续分享真实环境下的部署经验、问题排查案例,以及推理引擎、算力管理和系统架构相关讨论。
欢迎扫码加入 GPUStack 社区,与更多关注 AI Infra 与大模型推理实践的伙伴一起交流、学习与分享。

若群聊已满或二维码失效,请访问以下页面查看最新群二维码:
https://github.com/gpustack/gpustack/blob/main/docs/assets/wechat-group-qrcode.jpg
 320


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


