
MLP-Mixer详解

【MLP-Mixer】核心方法解读 我们提出MLP-Mixer架构(或简称“Mixer”),这是一个具有竞争力但在概念和技术上都很简单的替代方案,它不使用卷积或自关注。相反,Mixer的架构完全基于多层感知器(mlp),这些感知器可以在空间位置或特征通道上重复应用。Mixer仅依赖于基本的矩阵乘法例程、对数据布局的更改(重塑和换位)以及标量非线性。intro:图1描述了Mixer的宏观结构。它接受一系列线性投影图像补丁(也称为令牌),形状为“patches x channels”表,作为输入,并保持该维度。 阅读详情
AI摘要

MLP-Mixer是Google提出的一种新的计算机视觉框架,用多层感知机替换传统CNN的卷积和Transformer的自注意力机制。模型包括Per-patch Fully-connected、Mixer Layer,通过MLP进行空间域和通道域的信息融合。虽然其结构简单,但在ImageNet上的性能接近SOTA。然而,MLP-Mixer的Per-patch Fully-connected可视为卷积操作,Mixer Layer则类似深度可分离卷积,引发是否真正摒弃卷积的争议。

MLP-Mixer详解

论文《MLP-Mixer: An all-MLP Architecture for Vision》

1 主要思想

作为Google ViT团队最近刚提出的一种的CV框架,MLP-Mixer使用多层感知机(MLP)来代替传统CNN中的卷积操作(Conv)和Transformer中的自注意力机制(Self-Attention)。

MLP-Mixer整体设计简单,在ImageNet上的表现接近于近年最新的几个SOTA模型。

2 模型结构

MLP-Mixer主要包括三部分:Per-patch Fully-connected、Mixer Layer、分类器。

其中分类器部分采用传统的全局平均池化(GAP)+全连接层(FC)+Softmax的方式构成,故不进行更多介绍,下面主要针对前两部分进行解释。

2.1 Per-patch Fully-connected

FC相较于Conv,并不能获取局部区域间的信息,为了解决这个问题,MLP-Mixer通过Per-patch Fully-connected将输入图像转化为2D的Table,方便在后面进行局部区域间的信息融合。

具体来说,MLP-Mixer将输入图像相邻无重叠地划分为S个Patch,每个Patch通过MLP映射为一维特征向量,其中一维向量长度为C,最后将每个Patch得到的特征向量组合得到大小为S*C的2D Table。需要注意的时,每个Patch使用的映射矩阵相同,即使用的MLP参数相同。

实际上,Per-patch Fully-connected实现了**(W,H,C)的向量空间到(S,C)的向量空间**的映射。

例如,假设输入图像大小为240*240*3,模型选取的Patch为16*16,那么一张图片可以划分为(240*240)/(16*16)= 225个Patch。结合图片的通道数,每个Patch包含了16*16*3 = 768个值,把这768个值做Flatten作为MLP的输入,其中MLP的输出层神经元个数为128。这样,每个Patch就可以得到长度的128的特征向量,组合得到225*128的Table。MLP-Mixer中Patch大小和MLP输出单元个数为超参数。

2.2 Mixer Layer

观察Per-patch Fully-connected得到的Table会发现,Table的行代表了同一空间位置在不同通道上的信息,列代表了不同空间位置在同一通道上的信息。换句话说,对Table的每一行进行操作可以实现通道域的信息融合,对Table的每一列进行操作可以实现空间域的信息融合。

在传统CNN中,可以通过1*1 Conv来实现通道域的信息融合,如果使用更大一点的卷积核,可以同时实现空间域和通道域的信息融合。

在Transformer中,通过Self-Attention实现空间域的信息融合,通过MLP同时实现空间域和通道域的信息融合。

而在MLP-Mixer中,通过Mixer Layer使用MLP先后对列、行进行映射,实现空间域和通道域的信息融合。与传统卷积不同的是,Mixer Layer将空间域和通道域分开操作,这种思想与Xception和MobileNet中的深度可分离卷积相似。

在这里插入图片描述

根据上述内容,MLP-Mixer在Mixer Layer中使用分别使用**token-mixing MLPs(图中MLP1)和channel-mixing MLPs(图中MLP2)**对Table的列和行进行映射,与Per-patch Fully-connected相同,MLP1和MLP2在不同列、行中的映射过程中共享权重。除此之外,Mixer Layer还加入了LN和跳接来提高模型性能。

另外,MLP1和MLP2都采用了相同的结构,如下图。

在这里插入图片描述

2.3 整体结构

在这里插入图片描述

3 模型性能

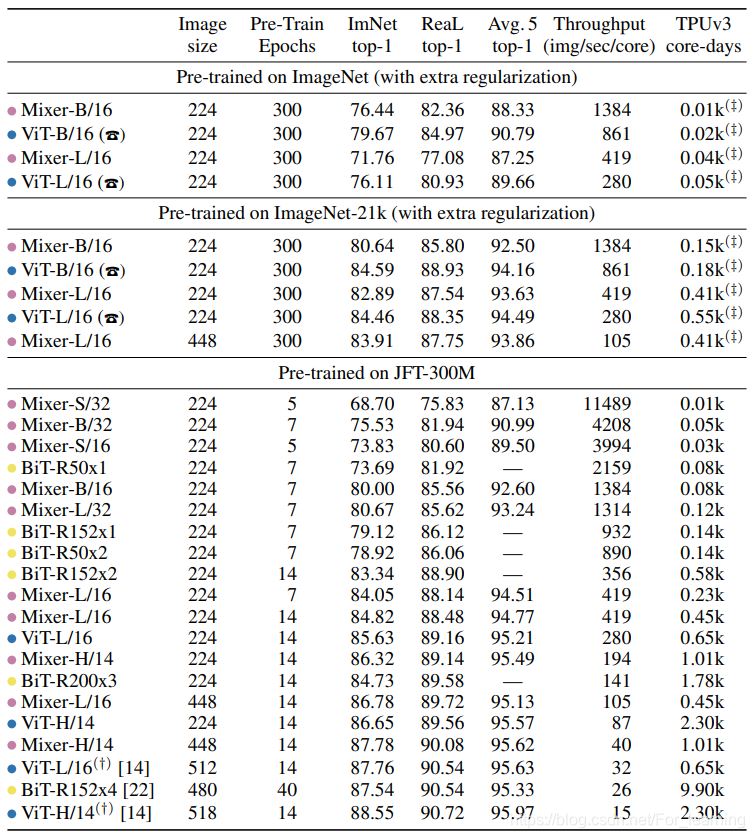
文中使用MLP Mixer进行预训练,然后在ImageNet上进行fine-tune,性能较ViT略差。

具体调参过程和性能比较,可参考原文。
在这里插入图片描述

4 存在的争议

个人认为,MLP-Mixer的创新点在于使用了MLP代替了Conv和Self-Attention,这表明使用最基础的MLP的拟合能力足以构建一个相对性能较好的CV模型。

实际上,如果熟悉Conv操作的话会发现,MLP-Mixer中并非不存在Conv。

MLP-Mixer的第一步Per-patch Fully-connected实际上完全等价于对输入图像做了一个kenel为16*16、stride为16的卷积操作。

tf.keras.layers.Conv2D(C, (16, 16), stride=16, padding='vaild')

MLP-Mixer的Mixer Layer为共享权重的深度可分离卷积。

# 传统的深度可分离卷积,各通道卷积时不共享权重
tf.keras.layers.SperableConv2D()

这样看来,MLP-Mixer中的MLP可以看作是卷积操作的等价形式。

附代码 MLP-Mixer: An all-MLP Architecture for Vision论文解读 MLP-Mixer: An all-MLP Architecture for Vision论文解读 参考连接:https://blog.youkuaiyun.com/weixin_44855366/article/details/120796804 摘要: 在不使用卷积或自我注意情况下,我们提出了MLP-Mixer,一个专门基于多层感知器(MLPs)的架构。MLP-Mixer包含两种类型的层:一种是将MLPs独立应用于image patch(即“混合”位置特征),另一种是跨patch应用的MLPs(即“混合”空间信息) 阅读详情

相关推荐

告别Transformer和CNN:手把手带你用PyTorch复现Google的MLP-Mixer(附完整代码)

本文详细介绍了如何使用PyTorch从零实现Google Research提出的MLP-Mixer模型,该模型在NeurIPS 2021上发表,完全基于MLP层处理视觉任务,无需卷积或注意力机制。通过代码实践解析token-mixing和channel-mixing MLP的核心设计,帮助开发者理解这一创新架构的工作原理和实现细节。

weixin_30825581的博客 496

【MLP】——MLP-Mixer理解

LP-Mixer使用多层感知机(MLP)来代替传统CNN中的卷积操作(Conv)和Transformer中的自注意力机制(Self-Attention)。实现特征之间的融合。其主要有两种融合结构。空间融合,通道融合结构。

怡宝2号 3029

MLP-Mixer实战:在自定义图像数据集上微调Google的‘全MLP’模型

本文详细介绍了如何在自定义图像数据集上微调Google的MLP-Mixer模型,这一全MLP架构在NeurIPS大会上首次亮相便引起广泛关注。通过Hugging Face的timm库,开发者可以快速部署MLP-Mixer,实现高效迁移学习,适用于中等规模专有数据集。文章涵盖环境配置、数据增强、模型微调策略及部署优化技巧,帮助读者在医疗影像分类等场景中快速应用。

weixin_26821003的博客 214

深度学习之图像分类(二十一)-- MLP-Mixer网络详解

深度学习之图像分类(二十一)MLP-Mixer网络详解 目录深度学习之图像分类(二十一)MLP-Mixer网络详解1. 前言2. MLP-Mixer 网络结构3. 总结4. 代码 继 Transformer 之后,我们开启了一个新篇章,即无关卷积和注意力机制的最原始形态,全连接网络。在本章中我们学习全连接构成的 MLP-Mixer。(仔细发现,这个团队其实就是 ViT 团队…),作为一种“开创性”的工作,挖了很多很多的新坑,也引发了后续一系列工作。也许之后是 CNN、Transformer、MLP 三分天下

木卯_THU的博客 1万+

DL-Paper精读:MLP-Mixer

MLP-Mixer: An all-MLP Architecture for Vision Paper (大厂论文总是不走寻常路,这篇总结暂且不遵循以往的阅读模式) 近期,谷歌新发布了一篇论文《MLP-Mixer》,号称使用纯MLP结构,便能在ImageNet上达到sota的结果。一石激起千层浪,很快清华、牛津、facebook等也相继发布了类似的工作,虽然没有像谷歌一样号称纯MLP取代CNN和Transformer。但也不由得让业界惊呼,MLP的时代又回来了?CV领域的发展历程,MLP -> CNN

星月野的博客 469

第54步 深度学习图像识别:MLP-Mixer建模(Pytorch)

第54步 深度学习图像识别:MLP-Mixer建模(Pytorch)

Jet4505的博客 2167

告别Transformer!用PyTorch从零实现MLP-Mixer图像分类(附完整代码与调参技巧)

本文详细介绍了如何使用PyTorch从零实现MLP-Mixer图像分类模型,包括核心原理、代码实现及调参技巧。MLP-Mixer通过通道混合MLP和空间混合MLP交替处理图像特征,在ImageNet上达到与ViT相当的精度,同时计算效率提升3倍。文章还提供了CIFAR-10等小型数据集上的优化方案和部署技巧。

weixin_29062963的博客 227

嵌入式SD/TF卡通用协议-SDIO协议

为了驱动SD卡,首先的第一步就是观察SD卡引脚接线情况,通常我们在画原理图时,都是使用的SD卡卡槽与MCU进行接线。SD卡可以使用SDIO协议和SPI协议进行通信,这里我们主要介绍SDIO协议。下图中的TF卡只是容量小一点的SD卡。以F1C100S为例,接线图如下所示:我们发现上图中的TF卡使用的协议为SDIO协议,主要有4根数据线,1根命令线,1根时钟线组合而成。为了驱动这个SD/TF卡我们就需要去了解SDIO协议的时序。

qq_1033275663的博客 3052

annotated_deep_learning_paper_implementations 中的 MLP-Mixer:用序列混合 MLP 替换自注意力,训练 Masked Language Model

本文基于仓库中 [MLP-Mixer 模块](https://link.gitcode.com/i/adbf973b8ea6be0eb1995d7f2b1fc43d) 的文档与源码,讲解如何用十几行 PyTorch 代码实现论文《MLP-Mixer: An all-MLP Architecture for Vision》的核心思想:把 Transformer 的自注意力层替换为沿序列维度(toke

gitblog_00854的博客 895

基于PLC的全自动洗衣机控制系统+控制程序

本设计使用PLC控制系统替换了传统的继电器控制系统,实现了全自动洗衣机在硬件方面的提升,丰富了全自动洗衣机在软件方面的功能,提高了全自动洗衣机的洗衣效率,基本可以满足用户的洗衣需求。

zzzz114231的博客 8956

nRF52840 低功耗蓝牙开发指南:从硬件架构到物联网应用实战

本文深入解析nRF52840低功耗蓝牙芯片的硬件架构与开发实践,涵盖从开发环境搭建到BLE协议栈开发的详细指南。通过实战案例分享低功耗优化技巧,帮助开发者高效实现物联网应用,特别适合智能家居和工业场景。

d3e4f的博客 417

告别CNN和Transformer?手把手带你用PyTorch复现Google的MLP-Mixer模型

本文详细介绍了如何使用PyTorch复现Google Research提出的MLP-Mixer模型,该模型完全摒弃了CNN和Transformer,仅通过多层感知机(MLP)实现高效视觉处理。文章包含核心设计解析、代码实现步骤及训练技巧,帮助开发者掌握这一创新架构。

weixin_30485379的博客 465

寒武纪AI芯片业务解析:从云端到边缘,如何布局智能计算未来?

本文深入解析了寒武纪在AI芯片领域的业务布局,重点探讨了其从云端到边缘的智能计算战略。文章分析了寒武纪云端“思元”系列芯片如何作为数据中心的高性能计算基石,以及思元220等边缘芯片如何满足碎片化场景的低功耗实时处理需求。同时,也阐述了其IP授权业务模式与技术生态构建,揭示了寒武纪在激烈市场竞争中,通过软硬件全栈方案布局智能计算未来的核心路径。

weixin_29271053的博客 404

MLP-Mixer:从论文到实践,剖析谷歌如何用纯MLP重塑视觉架构

本文深入剖析了谷歌在NeurIPS 2021上提出的MLP-Mixer架构,该模型仅使用多层感知机(MLP)重塑了视觉任务的处理范式。文章从颠覆性思想入手,详解了其核心的Token Mixing与Channel Mixing机制,并通过代码实战拆解了维度变换过程,最后探讨了其在大规模预训练下的表现与实用部署策略。

year5的博客 380

【PDN仿真笔记9-使用Sigrity PowerDC进行IR Drop仿真的方法】

使用Sigrity PowerDC进行IR Drop进行仿真的方法

qq_42682826的博客 8004

Python爬虫实战:构建药监局药品批准信息本地查询系统

在医药信息化时代,药品批准信息的快速查询对于医药从业者、研究人员和普通消费者都具有重要意义。国家药品监督管理局(NMPA)提供了官方的药品查询系统,但有时我们需要建立本地数据库以便批量分析或离线查询。本文将详细介绍如何使用Python爬虫技术,结合最新的异步爬虫框架和技术栈,构建一个完整的药监局药品信息本地查询系统。本系统将实现以下功能:自动化爬取药监局官网的药品批准信息数据清洗和结构化存储建立本地查询接口数据定期更新机制pythonimport os"""药品类型枚举"""

2201_76125261的博客 728

Mlp-Mixer简介及paddle复现

Mlp-Mixer简介及pytoch代码Mlp-Mixer网络结构TIPS总结参考 Mlp-Mixer 论文: MLP-Mixer: An all-MLP Architecture for Vision. pytorch 代码: MLP-Mixer. Mlp-mixer是谷歌最近提出的基于纯mlp结构的cv框架,用来替代卷积和Transformer里的注意力操作。Mixer的架构如下所示: 网络结构 Mlp-Mixer包含如下三个部分: 1.嵌入层(per-patch linear embedding:

weixin_43312063的博客 2785

【论文复现】——基于改进FPFH特征提取的点云模板匹配方法

基于改进FPFH特征提取的点云模板匹配方法 [J]. 应用激光, 2024, 44 (04): 196-204.

点云侠的博客 611

浅谈 Mlp-Mixer(pytorch and keras)

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录前言一、pandas是什么?二、使用步骤1.引入库2.读入数据总结 前言 提示:这里可以添加本文要记录的大概内容: 例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。 提示:以下是本篇文章正文内容,下面案例可供参考 一、pandas是什么? 示例:pandas 是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。 二、使用步骤 1.引入库 代码

__不想写代码__的博客 4322

AI Agent驱动的多模态情感分析方法:从BERT到Vision Transformer的探索

情感分析(Sentiment Analysis)是自然语言处理(NLP)与计算机视觉(CV)中一项重要任务。传统的情感分析主要依赖于文本数据,但在现实应用中,情感往往通过 语言、语音、表情、姿态 等多模态信号共同传达。因此,结合 多模态深度学习 的 AI Agent 在情感理解中具有广阔的前景。

一键难忘的博客 738

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

如何快速掌握Vision Transformer:从零开始的开源项目实战指南

Vision Transformer(ViT)是近年来计算机视觉领域的革命性技术,它将Transformer架构成功应用于图像识别任务,开创了视觉深度学习的新范式。本教程将带你全面了解Vision Transformer开源项目的核心功能、架构原理和实际应用,帮助你快速上手这一强大的视觉模型。 ## 📌 Vision Transformer核心架构解析 Vision Transformer通

gitblog_00587的博客 1041

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

【模块缝合】【NIPS 2021】MLP-Mixer: An all-MLP Architecture for Vision

这个转置 是什么操作?

py今天刷题了吗 501

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

如何快速掌握MLP-Mixer:革命性视觉架构的完整指南

MLP-Mixer是一种突破性的视觉架构,它彻底改变了传统计算机视觉模型依赖卷积神经网络(CNN)的局面。作为GitHub加速计划中的vi/vision_transformer项目重要组成部分,MLP-Mixer仅使用多层感知器(MLP)就实现了与视觉Transformer(ViT)相媲美的性能,为计算机视觉领域带来了全新的思路。 ## MLP-Mixer架构解析:告别卷积的视觉革命 🚀 M

gitblog_01027的博客 722

深度学习之图像分类(二十二)-- MLP-Mixer实战:从零构建与性能调优

本文详细介绍了MLP-Mixer架构在图像分类任务中的实战应用与性能调优。通过从零构建MLP-Mixer模型,探讨了数据预处理、核心组件实现及超参数优化等关键环节,帮助开发者在资源有限的情况下高效实现图像分类任务。文章还提供了学习率调整、正则化策略及显存优化等实用技巧,助力模型性能提升。

weixin_30919571的博客 423

告别注意力机制:MLP-Mixer如何用全MLP架构颠覆视觉识别?

你是否还在为Transformer模型的复杂注意力机制感到困扰?是否想过用简单的多层感知机(MLP)就能实现媲美Transformer的视觉识别效果?本文将带你深入探索MLP-Mixer架构的工作原理,通过具体代码示例和配置参数,展示如何从零开始构建这一革命性的视觉模型。读完本文,你将能够理解MLP-Mixer的核心设计思想,掌握其实现细节,并了解如何在实际项目中应用这一架构。 ## MLP-M...

gitblog_00076的博客 977
上一篇: BP算法实现 Python
下一篇: ShuffleNet详解
今生有幸.~
博客等级 码龄9年 26粉丝 36原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值