Python - 读Excel数据落库 - 手把手教学

日志异步落库:可靠性、吞吐与解耦的工程平衡术 日志异步落库是现代高并发系统可观测性基建的核心环节,其本质是在数据可靠性、系统吞吐和业务解耦之间构建稳健平衡。它源于对同步写库‘阻塞争抢’‘故障传播’‘语义污染’三重风险的系统性规避,技术原理涵盖无锁队列(如Disruptor)、本地磁盘缓冲(mmap)、序列化优化(Protobuf)及降级容错机制。该方案显著提升Java后端在金融、IoT、SaaS等场景下的日志处理能力,支撑百万级QPS稳定写入,同时保障核心交易链路零干扰。本文聚焦生产级落地细节,覆盖RingBuffer容量设计、fsync策略调优、日志 阅读详情

背景:

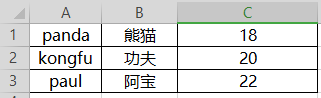
  • 有一批数据业务只能线excel的方式给
  • excel与数据表结构不一致

当然可以直接通过navicat导入excel数据,but、、python也得用起来呀
let us go ~

准备:

  • 编辑器 - 写代码得有开发工具啊,pyCharm也行、本文idea 2020.3
  • python 解释器 - 直接通过idea插件方式安装即可
  • 导包 - 需要啥导啥

步骤:

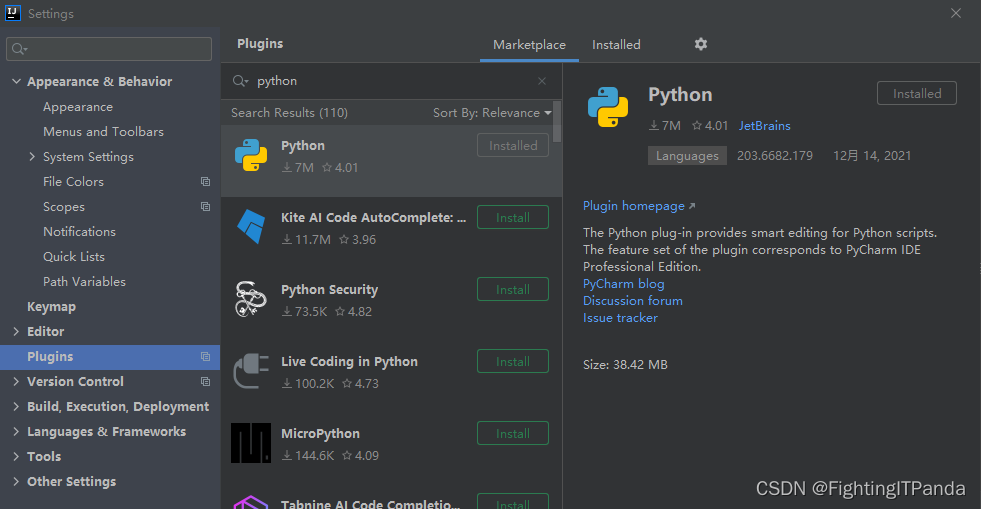
  • 1 idea 安装python 插件

File -> Settings -> plugins -> Marketplace
输入 python -> install 安装完重启idea
在这里插入图片描述

  • 2、创建python项目

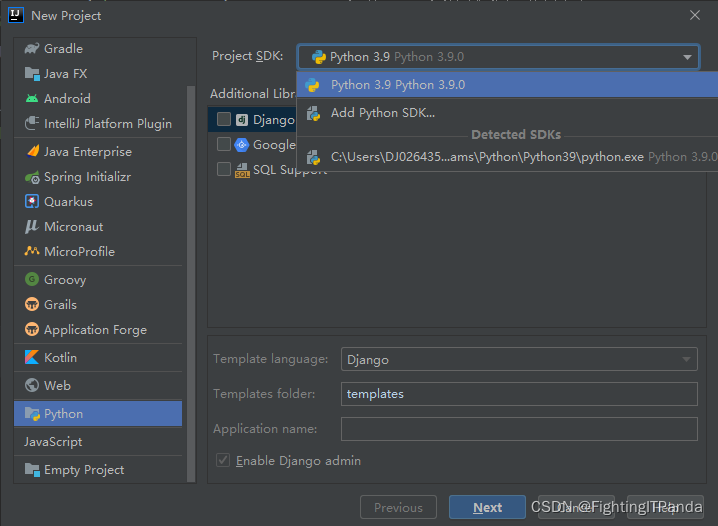
File -> New -> Project…
此时发现左侧已经有Python选项了,
Project SDK默认我们刚安装的Python最新版本,自己手动安装在本地的可以通过Add Python SDK 选择
然后一路下一步就可以了
这里是引用

  • 3、 环境验证

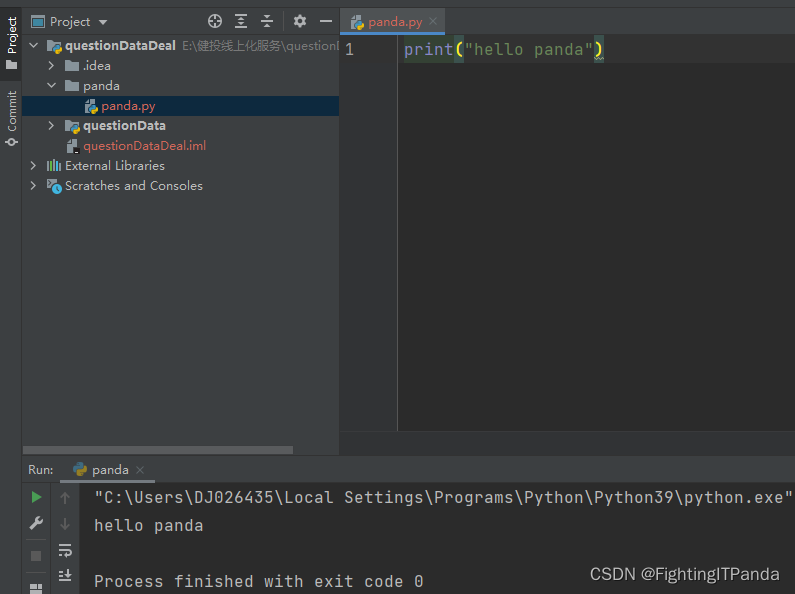
新建个文件(后缀为.py)
随便写点啥,打印一下
打印成功、环境已经准备完毕
这里是引用

  • 4、 建包、搭架子

我们的任务大致分为两步
1、读excel
2、写DB

读 Excel:

  • 新建一个module (概念同idea一致)
  • 安装openpyxl - 我们通过openpyxl处理excel

打开终端
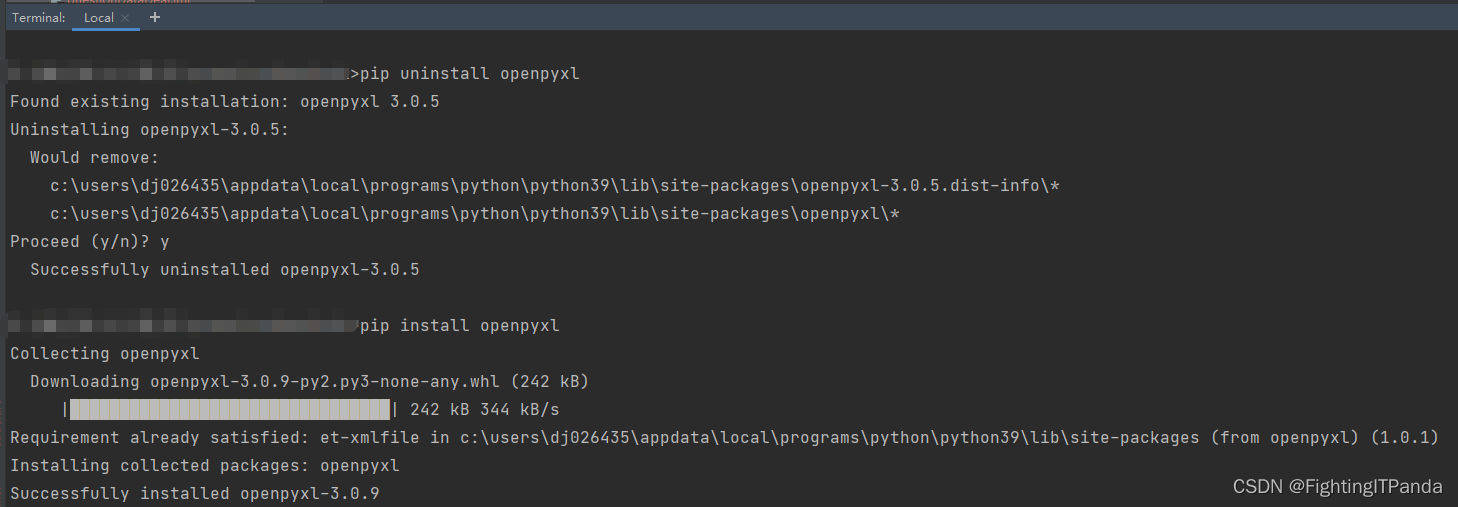
输入 pip install openpyxl,回撤
会有下载进度条提示,(我是先卸载了,重新安装的)
这里是引用

  • 读excel demo
    在这里插入图片描述
from openpyxl import load_workbook

# 读当前目录下excel
excel = load_workbook('./panda.xlsx')

# ['Sheet1', 'Sheet2', 'Sheet3']
tables = excel.sheetnames

# 表头
table = excel[tables[0]]

# 列数
columns = table.max_column

# 行数
rows = table.max_row

# 逐行读excel
for i in range(1, rows+1):
    # 行数组
    row = []

    # 第一列
    column1 = table.cell(row=i, column=1).value
    row.append(column1)

    # 第二列
    column2 = table.cell(row=i, column=2).value
    row.append(column2)

    # 第三列
    column3 = table.cell(row=i, column=3).value
    row.append(column3)

    # 打印
    print(row)

执行结果:说明excel数据已经成功读取到了
在这里插入图片描述
写DB:

  • 安装pymysql
  • 连接数据库
  • 执行sql

安装pymysql: 同上 pip install pymysql

在这里插入图片描述
连接数据库:新建一个配置文件dbconfig.py

import pymysql
# 连接db
conn = pymysql.connect(
    host="10.10.10.10",
    port=3306,
    user="panda",
    password="panda",
    database="panda",
    charset="utf8")

# 使用 cursor() 方法创建一个游标对象 cursor
cursor = conn.cursor()

验证DB连接:新建与DB 交互文件

from panda import dbconfig

# 获取连接
conn = dbconfig.conn
# 获取游标
cursor = dbconfig.cursor

# 使用 execute()  方法执行 SQL 查询
cursor.execute("SELECT * from panda_test")
# 使用fetchone 获取一条数据
result = cursor.fetchone()

# 打印结果
print(result)

# 关闭游标
cursor.close()
# 关闭数据库链接
conn.close()

执行结果:db连接成功
在这里插入图片描述
读excel + 写库:

步骤:

  • 连接数据库配置
  • 落库方法定义
  • 处理excel方法

目录结构:
在这里插入图片描述

  • 连接数据库配置
  • 落库方法定义
  • 处理excel方法

dbconfig.py

import pymysql
# 连接db
conn = pymysql.connect(
    host="10.10.10.10",
    port=3306,
    user="panda",
    password="panda",
    database="panda",
    charset="utf8")

# 使用 cursor() 方法创建一个游标对象 cursor
cursor = conn.cursor()

  • 连接数据库配置
  • 落库方法定义
  • 处理excel方法

db.py

from config import dbconfig
# 获取连接
conn = dbconfig.conn
# 获取游标
cursor = dbconfig.cursor
def insertData(data):
    # 表名
    table = 'panda_test'
    # 列名
    keys = ', '.join(data.keys())
    # 数据
    values = ', '.join(['%s'] * len(data))
    try:
        print(tuple(data.values()))
        # 组装sql
        sql = "INSERT INTO {table}({keys}) VALUES ({values})".format(table=table, keys=keys, values=values)
        # 执行sql
        cursor.execute(sql, tuple(data.values()))
        # 提交事务
        conn.commit()
    # 捕获异常
    except Exception as e:
        # 打印异常
        print("error..", e)
        # 回滚
        conn.rollback()
  • 连接数据库配置
  • 落库方法定义
  • 处理excel方法

panda.py

from openpyxl import load_workbook
from db import db

# 获取连接
conn = db.conn
# 获取游标
cursor = db.cursor
def dealexcel():
    # 读当前目录下excel
    excel = load_workbook('../excel/panda.xlsx')
    # ['Sheet1', 'Sheet2', 'Sheet3']
    tables = excel.sheetnames
    # 表头
    table = excel[tables[0]]
    # 行数
    rows = table.max_row
    # 逐行读excel
    for i in range(1, rows+1):
        # 行数组
        row = []
        # 第一列
        column1 = table.cell(row=i, column=1).value
        row.append(column1)
        # 第二列
        column2 = table.cell(row=i, column=2).value
        row.append(column2)
        # 第三列
        column3 = table.cell(row=i, column=3).value
        row.append(column3)
        # 打印行
        print(row)
        # 组装数据
        data = {
            'name': str(column1),
            'cname': str(column2),
            'age': str(column3)
        }
        # 落库
        db.insertData(data)
dealexcel()

# 关闭游标
cursor.close()
# 关闭连接
conn.close()

执行结果:
在这里插入图片描述
怕无归期~~ 怕空欢喜~~
怕来的不是你~~ 怕没有奇迹~~

手把手教你4种方法用Python批量实现多Excel多Sheet合并 一个一个打开复制粘贴固然可行,但是该方法费时费力,还容易出错,几个文件还可以手动处理,要是几十个甚至上百个,你就抓瞎了,不过这问题对Python来说,so easy,一起来看看吧! 二、项目目标 用Python实现多Excel、多Sheet的合并处理。 三、项目准备 软件:PyCharm 需要的库:pandas, xlrd,os 四、项目分析 1)如何选择要合并的Excel文件? 利用os,获取所有要合并的Excel文件。 2)如何选择要合并的Sheet? 利用xlrd库进行Excel读 阅读详情

相关推荐

Python-Pandas库实现EXCEL数据拆分成不同的表

Python-Pandas库实现EXCEL数据拆分成不同的表,并批量命名,顺带复习一下文本进度条的显示 Python-Pandas库实现EXCEL数据拆分成不同的表 事情原由:坚持懒才是第一生产力,同事说有大概十万行的数据,需要根据某一列中的值来拆分成不同的表,同时文件名要改成为对应的大区+小区+代码+名称,方便发邮件。 Pandas库+os库实现 用os库实现创建文件夹,Pandas实现拆分,顺...

varren的博客 6103

Python量化数据仓库搭建系列3:数据落库代码封装

Python量化数据仓库搭建系列3:数据落库代码封装 本系列教程为量化开发者,提供本地量化金融数据仓库的搭建教程与全套源代码。我们以恒有数(UDATA)金融数据社区为数据源,将金融基础数据落到本地数据库。教程提供全套源代码,包括历史数据下载与增量数据更新,数据更新任务部署与日常监控等操作。 在上一节讲述中,我们封装了Python操作MySQL数据库的自定义类,存为MySQLOperation.py文件;本节内容操作数据库部分,将会调用MySQLOperation中的方法,以及pandas.to_sql和pa

weixin_44068483的博客 1262

C++网络编程 - Boost::asio异步网络编程 - 01- boost库源码编译安装

知识的学习在于点滴记录,坚持不懈;知识的学习要有深度和广度,不能只流于表面,坐井观天;知识要善于总结,不仅能够理解,更知道如何表达! 目录 如果需要录屏资料,请私信邮箱shitou3000@qq.com获取。 ...

大秦坑王的专栏 1万+

mysql数据库落库_常用的MySQL数据库操作语句大全

注:SQL语句命令不区分大小写,都可以使用一、用户管理:1、新建用户:>CREATE USER 'username'@'host'IDENTIFIED BY 'password';实例1:>CREATEUSERusername1;实例2:>CREATEUSERusername2 IDENTIFIEDBY'password';2、更改密码:>SET PASSW...

weixin_39945178的博客 1839

DCDC--控制方式(Control Mode)

DCDC反馈控制方式

网始如芯个人博客 1万+

版电力系统故障录波_故障录波识图与典型故障波形分析

1、设置故障录波的目的故障录波装置是对电力系统运行状况进行监控的一种自动化设备。系统正常运行时,录波装置不启动录波,当系统发生故障时,通过启动录波装置迅速启动录波器录波,直接记录反应故障装置安装处系统故障的电气量。2、故障录波的作用(1)正确评价继电保护和自动装置的工作。(2)正确分析事故的原因并研究防止对侧。(3)发现继电保护和自动装置缺陷。(4)发现一次设备缺陷,及时消除隐患。(5)帮助寻找故...

weixin_42495661的博客 1万+

JAVA使用RabbitMQ解决生产端消息投递可靠性,消费端幂等性问题

Java使用RabbitMQ解决生产端消息投递可靠性,消费端幂等性问题

真正的大师永远怀着一颗学徒的心 5682

智能体在车联网中的应用:一份详尽到每日的100天学习路线图

这100天的旅程,是一次对毅力、学习方法和工程实践能力的综合考验。它不仅关乎掌握一系列技术点,更关乎培养解决复杂系统性问题的思维模式——将宏观的交通需求分解为微观的智能体决策,再通过多智能体协同涌现出宏观的智能行为。当你完成这份大纲时,你将拥有的不仅是一个项目作品集,更是一套应对“智能体+车联网”乃至更广泛AI+垂直领域挑战的方法论。未来已来,期待你成为构建智能交通新生态的关键贡献者。

IT深耕十余载,大道之简 1333

实现日志落库从0到1

日志记录第一步 创建日志实体类和数据库创建数据库创建实体类第二步 日志自定义注解注解第三步 模拟获取SessionUser()类SessionSessionUser第四步 创建日志类存储到数据库第五步 业务接口1接口请求数据2控制台打印数据3数据库数据存入 第一步 创建日志实体类和数据库 创建数据库 CREATE TABLE `aop_utils` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT '主键', `create_by` varchar(

weixin_45883611的博客 673

YOLOv11改进 | 融合改进篇 | 利用尺度统一检测头DynamicHead融合P2增加小目标检测层(让小目标无所遁形)

本文给大家带来的最新改进机制是针对性的改进,针对于小目标检测增加P2层针对于大目标检测增加P6层利用DynamicHead(原版本一比一复现,全网独一份,不同于网上魔改版本)进行检测,其中我们增加P2层其拥有更高的分辨率,这使得模型能够更好地捕捉到小尺寸目标的细节。我们增加P6层是一个较低分辨率但具有更大感受野的特征层。对于大尺寸目标,这意味着模型可以更有效地捕捉到整体的结构信息。在这些的基础上我们配合DynamicHead可以使模型根据不同尺寸的目标动态调整其检测策略,进一步提升模型的精度。

Snu77的博客 3948

第14.10章 高翔博士最新开源框架Lightning-LM源码解读(十):在线定位run_loc_online涉及到的核心模块总结

本文对Lightning-LM激光SLAM定位框架进行了全面剖析。该框架是一个轻量高效的激光雷达建图与定位系统,支持3D SLAM、动态图层管理等功能。文章首先介绍了项目概况和源码结构,包括核心模块如定位系统(loc_system)、激光匹配(lidar_loc)和位姿图优化(pose_graph)等。接着详细解析了各模块的关键函数和运行流程,如数据接收处理、NDT匹配和位姿优化等。最后总结了学习该框架所需的C++知识要点,包括智能指针、多线程编程等现代C++特性。该分析为SLAM开发者提供了实用的架构参考

行知SLAM 801

利用Python处理Excel数据——pandas库

新建一个excel表格(table1.csv)用于案例讲解: 一、导库 import pandas as pd import numpy as np 二、读取数据 df = pd.read_excel('table1.xlsx') # 相对路径 # df = pd.read_excel(r'E:\Anaconda\hc\dataScience\table1.csv') # 绝对路径...

QianT 1万+

三相五柱式消弧线圈自动测控装置设计与实现

本文设计了一种基于STM32的三相五柱式消弧线圈自动测控装置。该装置采用信号注入法检测系统对地电容电流,通过PID自适应算法调节消弧线圈电感值,实现单相接地故障时的快速补偿。硬件系统包含信号采集、注入、控制执行等模块,软件采用Goertzel算法提取特征频率信号,结合增量式PID实现精确控制。实验结果表明,装置电容检测误差小于2%,调谐响应时间小于50ms,满足配电网对消弧线圈自动调谐的技术要求。

AI的内部世界的博客 239

【Python处理EXCEL】基础操作篇:在Python中导入EXCEL数据

本篇是为python零基础数据分析的准备篇。

Deng333333555的博客 8万+

不同IP网段的PLC进行S7通信(PUT_GET)的具体步骤

不同IP网段的PLC进行S7通信(PUT_GET)的具体步骤 一般情况下,我们使用西门子的S7通信时都是将网络中的PLC的IP设置在同一网段,那么如果涉及到旧项目改造时,不方便修改IP地址,只能进行2个网段通信时,可以参考以下步骤: 准备条件: 2个路由器 CPU 1212C 主动连接 CPU 314C-2PN/DP 被动连接 网络搭建如下图所示: S7-1212C一侧 建立S7主动连接 ,IP地址:192.168.5.40,编写get/put 通信程序 S7-300 IP地址:192.168.0

Robot_PLC_HMI_Automation 2万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

Python读Excel数据自动化填入日常办公的网页表单

前言 本篇内容,让你完全掌握Python是如何自动化办公的~ 一、环境准备 1.1 Python 3.7.0 1.2 Pycharm (Python 开发工具) 1.3 Selenium (处理网页表单工具类) 1.4 openpyxl (处理Excel工具类) selenium 安装:pip install selenium -i https://pypi.douban.com/simple/ openpyxlpy安装:pip install openpyxl ...

arron_12的博客 1万+

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

使用Python的pandas库操作Excel

最近因需要用Excel电子表格处理数据,使用了其它一些方式处理Excel文件数据,这是学习笔记的整理。Python中有很多库可以操作Excel,像xlsxwriter、openpyxl、pandas、xlwings等。本文主要介绍pandas。

cnds123的专栏 2万+

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

python读Excel数据成numpy数组

        今年研究生数模的时候用到了,113.xlsx 是325个样本数据,每个样本数据126个初步筛选的特征 文章目录按列读按行读 按列读 import xlrd import numpy as np def excel2matrix(path): data = xlrd.open_workbook(path) table = data.sheets()[0] nrows = table.nrows # 行数 ncols =

雾隐雾现的至渝博客 4万+

python操作excel的库

python在操作excel的时候,用到很多库,常用的有xlwings、xlrd、xlwt、xlutils、xlsxwriter、openpyxl、pandas。这几个库都是第三方库,需要install和import才能使用xlrd和xlwt是早期支持操作excel的库,目前最新版本都只支持xls格式,不支持xlsx格式文件。xlrd负责读取excel文件,xlwt负责对excel进行写的操作。xlwt 和 xlrd 不光名字像,连很多函数和操作格式也是完全相同。

ly的博客 2725

利用Python处理Excel数据——xlrd,xlwt库

当面对成百上千个excel文件,需要重复读写时,你会不会很头大呢? 与其花费好几天去做这些繁琐无意义的操作,不如学学python如何批量读写excel文件,以下介绍用xlrd和xlwt库处理Excel数据。 我们新建一个excel表格(table1.xlsx)用于案例讲解: 一、使用xlrd库读取excel数据 1、python读取excel文件特定数据 import x...

QianT 1万+

这可能是全网最完整的 Python 操作 Excel 库总结

在之前的办公自动化系列文章中,我已经对Python操作Excel的几个常用库openpyxl、xlrd/xlwt、xlwings、xlsxwriter等进行了详细的讲解。为了进一步带大家了解各个库的异同,从而在不同场景下可以灵活使用,本文将横向比较7个可以操作 Excel 文件的常用模块,在比较各模块常用操作的同时进行巩固学习!首先让我们来整体把握下不同库的特点“xlrd、xlwt、xlutils 各自的功能都有局限性,但三者互为补充,覆盖了Excel文件尤其是 .xls 文件的操作。xlwt 可以生成 .

Python学习与数据挖掘 1万+

Python 读pdf数据写入Excel表中

一般pdf文件比较规整,不像word什么的随着版本的问题会有所变化,但是pdf转成其它格式也是比较头疼的问题,Python利用pdfplumber读取数据转成Excel或者其它都可以,真棒

80后大叔爱学习 2338

python读取excel数据

在Python中读取Excel数据是一个常见的任务,可以使用多种库来实现。

破损的天堂鸟博客 1万+

Python xlrd库:读excel表格

xlrd是一个 Python 库,用于读取 Excel 文件(包括.xls和.xlsx格式)。它提供了丰富的 API 来访问和操作 Excel 中的数据,包括读取单元格、处理工作表和工作簿等。xlrd是一个功能强大的库,可以帮助开发者高效地处理 Excel 文件。本文介绍了一些使用技巧,包括处理大型文件、使用命名单元格、处理日期和时间、条件过滤数据、处理公式和计算、读取样式和格式以及处理多个工作表。掌握这些技巧,可以显著提高处理 Excel 数据的效率和灵活性。希望本文能够帮助开发者更好地利用xlrd。

专注于全栈开发领域 1349

python之excel教学

执行 pip install openpyxl 安装该库 import os os.system("pip3 install openpyxl") 新建Excel,写入数据 xlrd 只能读取Excel内容,如果你要 创建 一个新的Excel并 写入 数据,可以使用 openpyxl 库。 openpyxl 库既可以读文件、也可以写文件、也可以修改文件。 但是,openpyxl 库不支持老版本 Office2003 的 xls 格式的Excel文档,如果要读写xls格式的文档,可以使用 Excel 进行相

星云随风 倚码为诗 9297

Python库与Excel

Python是一个十分便利的编程语言,这是因为它包含了很多丰富的Python库和第三方库。

2401_84944910的博客 1237
上一篇: panda白话 - G1垃圾收集器 - Mixed GC - 初始标记(根分区扫描)源码分析
下一篇: panda白话 - G1垃圾收集器 - Mixed GC - 并发标记阶段 - 源码分析
FightingITPanda
博客等级 码龄10年 477粉丝 211原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值