Spark

大数据—— Spark Core 知识点整理 1. Spark 和 Hadoop 相比有什么优势 运行速度快: Spark拥有DAG执行引擎,支持在内存中对数据进行迭代计算。官方提供的数据表明,如果数据由磁盘读取,速度是Hadoop MapReduce的10倍以上,如果数据从内存中读取,速度可以高达100多倍。 适用场景广泛: 大数据分析统计,实时数据处理,图计算及机器学习 易用性: 编写简单,支持80种以上的高级算子,支持多种语言,数据源丰富,可部署在多种集群中 容错性高: ... 阅读详情

运行模式:

local:适用于本地测试

yarn: 分为yarn-client、yarn-cluster两个模式。yarn-client的Driver驱动程序会在客户端进行运行,而yarn-cluster的驱动程序是在集群的(nodemanager)applicationMaster上面。

standalone:独立模式,spark客户端将任务提交到 Master/slaves结构的集群上的master处理,使用spark自身的调度系统。

spark任务提交的方式:J2ee还是shell?

shell

#!/bin/bash

# 设置Spark主节点URL和应用程序名称
SPARK_MASTER="spark://localhost:7077"
APP_NAME="MySparkApp"

# 设置其他Spark配置属性
SPARK_CONF="--executor-memory 2g --num-executors 4"

# 提交Spark应用程序
spark-submit \
    --master $SPARK_MASTER \
    --name $APP_NAME \
    $SPARK_CONF \
    path/to/your/app.jar

1)在提交任务时的几个重要参数

executor-cores —— 每个 executor 使用的内核数,默认为 1,官方建议 2-5 个,我们企业是 4 个 num-executors —— 启动 executors 的数量,默认为 2

executor-memory —— executor 内存大小,默认 1G

driver-cores —— driver 使用内核数,默认为 1

 driver-memory —— driver 内存大小,默认 512M

2)一个提交任务的样式

spark-submit 
\ --master local[5] 
\ --driver-cores 2 
\ --driver-memory 8g 
\ --executor-cores 4     
\ --num-executors 10 
\ --executor-memory 8g 
\ --class PackageName.ClassName XXXX.jar 
\ --name "Spark Job Name" 
\ InputPath 
\ OutputPath

spark架构与作业提交流程简述

yarn-cluster模式

1.spark-submit 中main被执行

2.反射 Client类的main方法执行

3.向RM注册任务并加入队列

4.NM认领后创建AM,AM中的driver申请所需资源

5.同时会申请相应的executors并创建executor对象,这个executors会向driver注册

6.driver 执行代码 初始化SC 任务划分

7.分配对应任务给指定的executors执行

spark的血统(lineage)概念及其作用

lineage是记录分区之间依赖关系的机制,分为宽依赖和窄依赖;窄依赖是一个分区依赖一个分区,没有shuffle操作,流程图呈现是一条直线;宽依赖是一个分区依赖多个分区,可能涉及shuffle操作,产生更多的IO。

  1. 窄依赖(Narrow Dependency):

    • 窄依赖表示父RDD的每个分区只被子RDD的一个或多个分区直接依赖。
    • 窄依赖可以通过简单的转换操作(如map、filter)进行计算,不需要进行数据的洗牌操作(Shuffle)。
    • 窄依赖保证了计算的高效性,因为父RDD的每个分区只需要被子RDD的一个或多个分区计算即可。
    • 窄依赖在血统中以依赖关系图的一条直线表示。
  2. 宽依赖(Wide Dependency):

    • 宽依赖表示父RDD的一个或多个分区被子RDD的多个分区依赖,需要进行数据的洗牌操作(Shuffle)。
    • 宽依赖通常发生在一些需要进行分组、聚合或排序等操作的转换上,这些操作需要将父RDD的数据重新分配和重组。
    • 宽依赖会引起数据的网络传输和磁盘读写,可能导致性能的下降。
    • 宽依赖在血统中以依赖关系图的分叉表示。

lineage的作用主要是以下2点:

1.容错和数据恢复

lineage可以让spark在出错后根据依赖关系定位上次出错的地方重新执行,把丢失的数据找回来。

2.优化执行

可以根据lineage依赖关系优化执行计划,由于spark是惰性计算,故只需识别用到的部分,过滤掉多余的宽依赖来提高效率。

spark根据什么划分stage?根据什么划分tasks?

根据宽依赖划分,将job划分成若干个stage,每一个宽依赖都会对应一个stage;一个stage是taskSet,而task是根据RDD中的分区数将stage划分成数个tasks。

spark常用的transformation算子(惰性算法,不会马上执行),列举并说明其作用(功能)。

map(func)转化算子,每个输入元素,使用接受到的func函数的聚合逻辑按key分组合并value(做了转化),返回一个新的RDD。(元素数=map调用数)

分区:数据集被划分成若干个较小的数据块,即分区,每个分区可以在集群不同的节点上并行处理,并行度=分区数。

元素:即数据项,数据集被划分成若干个较小的数据块,数据块包含一定数量的元素,元素是数据集中一个个独立的数据项,是处理的基本单元,spark对每个元素进行计算转换,并存储在分区中。

mapPartitions(func)类似于map,但mapP是针对每个分区调用一次,即分区数=调用mapP数。

reduceByKey (func,numtasks)numtasks指定reduce任务数(并行数),func为聚合函数逻辑,按key聚合value,输入k-v类型rdd,返回一个新的k-v类型rdd。

def aggregateByKey[U](zeroValue: U)(seqOp: (U, V) => U, combOp: (U, U) => U): RDD[(K, U)]

自定义函数,zeroV是初始值,seq是分区内聚合逻辑,comb是分区间聚合逻辑(将前两个value进行合并comb得到的结果与下一个value再一起传给comb,以此类推),返回一个k-v类型的rdd(key与计算结果作为一个新rdd)。

combineByKey 是一个做转化操作的算子,实现按键对数据集进行聚合计算。

def combineByKey[C](
  createCombiner: V => C,
  mergeValue: (C, V) => C,
  mergeCombiners: (C, C) => C): RDD[(K, C)]

  createCombiner初始化函数,用于 将每个键转化成初始聚合格式

  mergeValue是拿着初始聚合格式与分区内每个元素进行聚合。

mergeCombiners 分区间合并的聚合结果。

*combineByKey和aggregateByKey的区别在于 comb可以指定聚合格式,有三个参数,不需要初始值;agg需要有两个参数,以及一个初始值

spark常用的action算子(马上执行),列举并说明其作用(功能)。

reduce:reduce(func(a,b))接受一个函数func,对两个元素进行指定计算,得到结果再与下一个元素应用func,以此归约出最终的结果。action算子会马上执行。

*RDD与元素的关系: RDD说白了是数据集,里面的一个个数据项就是元素,RDD一创建就不可更改,想要修改,只能应用转换生成新的RDD,RDD是一个分布式数据集合。

collect:将存放在集群上各个节点的分区中的数据拉取到驱动程序中,使用数组存放,注意驱动程序的内存是否够用,否则数据量过大会内存溢出。

first:返回RDD中第一个分区的第一个元素,它不关心分区的顺序情况,若rdd为空,则抛异常。

take:take拉取RDD前N个元素,接受参数N,指定拿钱多少个元素出来,底层从远端拉取RDD中的元素到driver内存,应注意driver的内存大小与数据量的大小。

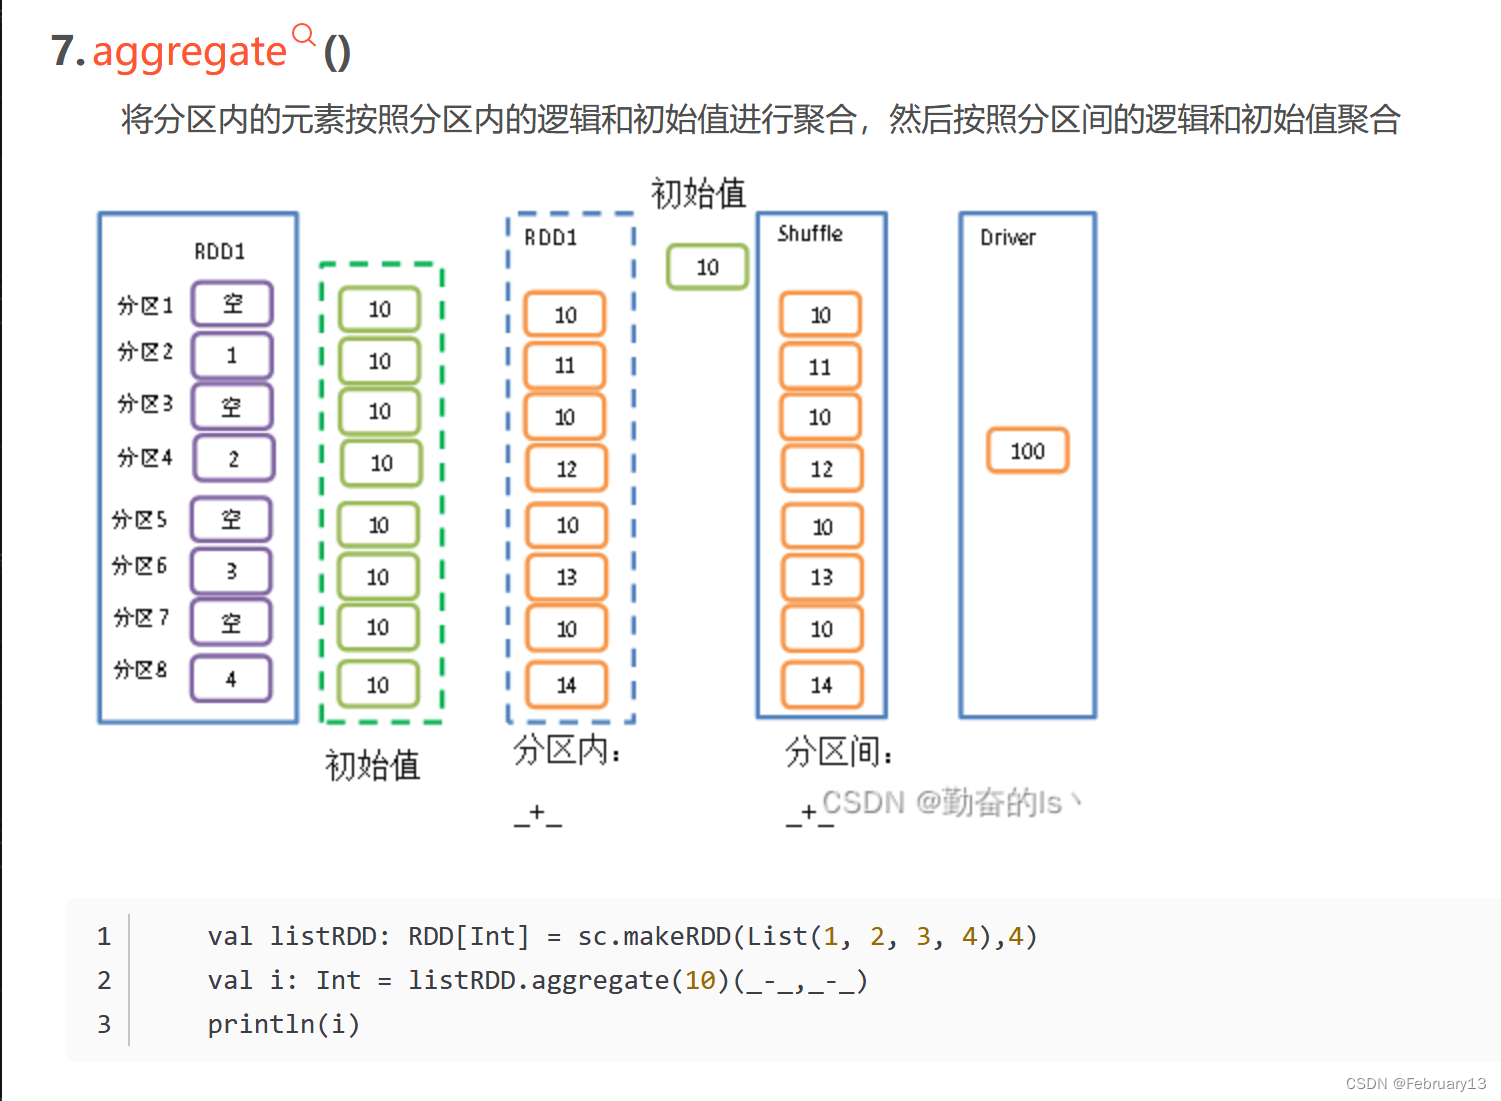
aggregate:

def aggregate[U](zeroValue: U)(seqOp: (U, T) => U, combOp: (U, U) => U): U

zeroValue初始值,seq分区内,comb分区间(全局)

注意分区间的操作也是基于初始化计算的。
count ByKey:行动算子,是按key计算key出现的次数,作用于一个RDD

 foreach:对RDD中每个元素应用指定函数

 saveAsTextFile:用于将RDD以Text的文件格式保存到指定路径,注意其中的操作保证幂等性

幂等操作的特点是其任意多次执行所产生的影响均与一次执行的影响相同

列举引起shuffle的算子,并简述功能。

1.聚合bykey类 reduceByKey groupByKey

2.集合表间交互(join、cogroup)

3.重分区repartition

4.去重、排序 sortByKey

简述spark核心hashShuffle和sortShuffle的工作流程,优化前后的差异。

hashShuffle未经优化:

1.分区数据进行哈希操作,确定数据需要发送到那个分区并落盘。

2.reduce任务拉取相应分区的磁盘上的数据。

优化后:

1.数据在每个executor 的多个task中处理时复用buffer缓冲区,减少落盘及溢写小文件的产生。

2.数据尽量存在内存,内存不足才会溢写到磁盘。

sortShuffle未经优化:

1.分区内做排序,现存内存,根据阈值判断是否溢写结果落盘

2.reduce拉取相应分区的磁盘上数据进行最终合并

优化后:bypass

如果输入数据的分区数小于或等于 Reduce 任务数的两倍(任务数少),就可以绕过分区排序操作,避免昂贵的排序操作,

直接将数据发送给reduce任务进行处理。

Spark 常用算子 reduceByKey 与 groupByKey 的区别,哪一 种更具优势?

reduceByKey是 分组聚合,shuffle之前会做combine预聚合处理,而groupByKey是分组,不会聚合,直接shuffle,故效率上reduceByKey更优。

但也要配合业务场景,因为仅仅分组的话,还是得用groupByKey。

repartition和coalesce的关系和区别:

都是用来改变rdd 的partition数量的, repartition底层调用的就是coalesce(numPartitions, shuffle =true)

repartition是宽依赖,增加或减少分区数,会触发shuffle

coalesce是窄依赖,合并或减少分区数,coalesce 根据传入的参数来判断是否发生 shuffle

分 别 简 述 Spark 中 的 缓 存 机 制 ( cache 和 persist ) 与 checkpoint 机制,并指出两者的区别与联系

cache 是临时缓存数据,在内存中,故发生错误,重新恢复后会失效,对于数据量大且高复用的场景,可以使用缓存避免重复计算。

ck是一种容错机制,在宕机后通过ck可以将RDD数据恢复到出错前的状态,继续处理,它会保存在磁盘。故CK会截断血统,避免血统过长

cache和ck都不会action,但cache会在计算节点间共享,而ck不会。cache适用于频繁使用的数据。ck适用于数据恢复的场景。

【Spark】Spark的Standalone模式安装部署 Spark运行模式Spark 有很多种模式,最简单就是单机本地模式,还有单机伪分布式模式,复杂的则运行在集群中,目前能很好的运行在 Yarn和 Mesos 中,当然 Spark 还有自带的 Standalone 模式,对于大多数情况 Standalone 模式就足够了,如果企业已经有 Yarn 或者 Mesos 环境,也是很方便部署的。 local(本地模式):常用于本地开发测试,本地还分 阅读详情

相关推荐

【Spark】Spark安装和Spark-shell使用

一、spark的安装模式 1、本地模式(local),单点模式,非分布式模式,只需要用到一台机器; 2、standalone模式,是spark自己实现的独立调度器,它是一个资源调度框架;Spark可以通过部署与Yarn的架构类似的框架来提供自己的集群模式,该集群模式的架构设计与HDFS和Yarn大相径庭,都是由一个主节点多个从节点组成,在Spark 的Standalone模式中,主节点为mas...

晚风中的自由 2721

Spark相关配置参数

spark重要参数配置

攻城狮Kevin 6507

Spark学习笔记[3]-Spark安装部署

Spark学习笔记[3]-Spark安装部署 1、下载对应版本的spark   官网我始终都下不下来,推荐一个国内的镜像: https://mirrors.tuna.tsinghua.edu.cn/apache/spark 2、概述 2-1 安装模式   虽然Spark是一个分布式计算框架,但是其不属于Hadoop Project,它有自己的资源层管理和文件系统,可以不依赖Hadoop的HDFS和Yarn,所以安装部署的时候可以只安装spark,对应的就是standalone集群, 但是一般都会使用HDF

unlock的博客 3929

Spark 面试题(十)

1. 简述Spark参数(性能)调优 ? 2. 简述Spark怎么基于内存计算的 ? 3. 简述什么是RDD(对RDD的理解)?RDD有哪些特点?说下知道的RDD算子 ? 4. 简述RDD属性 ? 5. 简述RDD的缓存级别 ? 6. 简述Spark广播变量的实现和原理 ?

闲依农圃邻,偶似山林客。 1263

基于Hadoop的Spark集群搭建

title: Spark集群搭建 date: 2020-03-19 19:30:31 tags: Hadoop 基于Hadoop的Spark集群搭建 准备 Spark三种运行模式简介 Local模式 Local 模式是最简单的一种Spark运行方式,它采用单节点多线程(cpu)方式运行,local模式是一种OOTB(开箱即用)的方式,只需要在spark-env.sh导出JAVA_HOME,无需其他任何配置即可使用,因而常用于开发和学习 方式:./spark-shell - -master loca.

qq_45703204的博客 1702

Spark 源码 | 脚本分析总结

最初是想学习一下Spark提交流程的源码,比如 Spark On Yarn 、Standalone。之前只是通过网上总结的文章大概了解整体的提交流程,但是每个文章描述的又不太一样,弄不清楚到底哪个说的准确,比如Client 和 CLuster 模式的区别,Driver到底是干啥的,是如何定义的,为了彻底弄清楚这些疑问,所以决定学习一下相关的源码。因为不管是服务启动还是应用程序启动,都是通过脚本提交的,所以我们先从分析脚本开始。

主要分享大数据相关的知识,如Spark、Hudi 2431

Spark core优化配置参数

Spark core优化配置参数 应用属性 描述 spark.driver.cores 在集群模式下管理资源时,用于driver程序的CPU内核数量。默认为1。在生产环境的硬件上,这个值可能最少要上调到8或16。 spark.driver.maxResultSize 如果应用频繁用此driver程序,建议对这个值的设置高于其默认值“1g”。0表示没有限制。...

Widsom的博客 1万+

Robocup3d

一、 比赛介绍 RoboCup 仿真比赛是一个能为多智能体系统和模拟智能进行研究、教育的工具。比赛是在一个标准的计算机环境中进行的,提供了一个完全分布式控制、实时异步多智能体环境。通过这个平台,可以测试各种理论、算法和Agent体系结构。在实时异步、有噪声的对抗环境中,研究多智能体的合作对抗问题。当然,仿真组的比赛使用的机器人并非是真的机器人。一个机器人是一个Agent, 它拥有自己的大脑,

zhanghe2775115的专栏 7264

Spark系列(一) —— SparkCore详解

1. =》Spark 引入 首先看一下MapReudce 计算和 Spark 计算的区别: MapReudce : 分布式计算框架 缺点:执行速度慢,shuffle 机制:数据需要输出到磁盘,而且每次 shuffle 都需要进行排序操作 框架的机制:只有 map 和 reduce 两个算子,对于比较复杂的任务,需要构建多个job来执行,当存在 job 依赖的时候,job 之间的数据...

专注AI与大数据技术分享与教程 6281

python blp模型 估计_随机系数Logit模型及Stata实现

欢迎投稿(荐稿)计量经济圈,计量相关都行邮箱:econometrics666@sina.cn作者:北京交通大学经济管理学院博士生,王琦珀。欢迎你加入计量经济圈社群,一起探讨前沿计量理论和实证方法。一、随机系数Logit模型1.背景实证产业组织(Empirical Industrial Organization,EIO)是目前产业组织理论的前沿,其中又以Ariel Pakes为带头人,其近期工作论文...

weixin_42298927的博客 2641

三分钟解决RKNN-Toolkit2安装失败:从模块报错到成功验证的完整记录

本文详细记录了RKNN-Toolkit2安装失败的解决方案,从环境配置到模型转换实战,特别针对常见的'No module named 'rknn''报错提供了完整修复指南。通过YOLOv8模型转换示例,展示了从ONNX到RKNN格式的完整流程,并分享了在RK3588芯片上的部署优化技巧。

html8的博客 264

【Spark】Spark安装详解

Spark安装详解Spark的详情Spark的安装详解Spark Local的安装Spark Standalone模式Spark On YARN模式Spark HA模式 Spark的详情 Spark的简绍 Spark是一种通用的大数据计算框架,是基于RDD(弹性分布式数据集)的一种计算模型。那到底是什么呢?可能很多人还不是太理解,通俗讲就是可以分布式处理大量集数据的,将大量集数据先拆分,分别进行计算,然后再将计算后的结果进行合并。 为什么使用Spark Spark在存储器内运行程序的运算速度能做到比Had

HR的博客 6629

CTransformers: 高效的Python语言模型绑定库

CTransformers是一个为C/C++实现的Transformer模型提供Python绑定的开源库。它基于GGML库构建,旨在为开发者提供一种高效且易用的方式来在Python中使用各种流行的语言模型。支持多种流行的语言模型,如GPT-2、LLaMA、Falcon等提供统一的简单API接口支持GPU加速(CUDA和Metal)与Hugging Face Transformers和LangChain集成支持流式输出和嵌入计算。

helloaiworld的博客 1267

11.Linux下Spark的安装配置以及spark-shell的启动和 Spark集群环境搭建

(1)安装Spark 1.先用xftp将安装包传到home/hadoop/Downloads文件夹下,然后解压安装。 2.解压缩: 3. 更改文件夹名称: 4.修改hadoop用户对文件夹spark的访问权限: (2)配置 1.复制一份由Spark安装文件自带的配置文件模板:如图所示:返回结果:Pi is roughly 3.144115720578603。

ghw666666666的博客 2万+

Vivado Combinatorial Loop Alert问题 [DRC LUTLP-1]

Vvado综合和布局布线都通过了但是无法生成bit文件,提示Combinatorial Loop Alert,错误如下图。在RTL图中可以看到LUT的输出连接到了输入上,这个就是。在代码中我并未找到导致这种情况发生的地方,如果遇到类似的问题先检查自己的代码是不是存在组合逻辑连接出现了问题,如果没问题再考虑通过设置去解决问题。

伊丽莎白的学习之路 6031

从零搭建一个AF架构项目:基于TIA Portal V19和S7-PLCSIM的仿真调试全流程

本文详细介绍了如何在TIA Portal V19环境中从零搭建西门子Automation Framework(AF架构)项目,包括环境准备、硬件组态、核心组件创建、项目架构分层实现以及仿真调试全流程。通过模块化编程和标准化接口设计,AF架构显著提升工业自动化项目的开发效率和维护便利性,特别适合S7-1500系列PLC的应用开发。

weixin_29313547的博客 672

spark安装以及hive on spark和spark on hive 的配置

安装spark版本为已经编译好的spark-3.2.1-bin-hadoop3.2-scala2.13.tgz,其同样兼容hadoop-3.3.2; Hive on Spark(为hive配置spark引擎):Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spark,Spark负责采用RDD执行。Hive默认执行引擎是mapreduce,由于需频繁读取磁盘,效率比较低,Spark在内存中读取数据,所以总体来讲比MapReduce快很多(当然首次执行速度还是比较慢的) ..

v15220的博客 4748

手把手教你学SOC芯片架构--NoC(片上网络,Network on Chip)全方位解析

​、​。

MHD0815的博客 863

Ubuntu安装Spark

Ubuntu安装Spark

weixin_56814370的博客 5176

【问题解决】Python 异步 asyncio 卡死、协程不执行、任务泄漏,保姆级排错

本文详细分析了Python异步编程中常见的卡死、协程不执行和任务泄漏问题。文章首先列举了这些问题的典型表现,如程序卡住、死锁、任务未启动等。然后深入剖析了各类问题的根源,包括同步阻塞操作、未正确await、资源未清理等。针对这些问题,文章提供了两套解决方案:一是异步编程最佳实践,包括安全协程执行、带超时的执行、任务清理等实用方法;二是死锁检测和预防机制,通过锁管理和等待图分析来避免死锁。文章还包含可直接使用的代码示例,帮助开发者快速定位和解决异步编程中的常见问题。

博客 448

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

hive on spark 配置 和 spark on hive

Hive引擎简介 Hive引擎包括:默认MR、tez、spark Hive on Spark:Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spark,Spark负责采用RDD执行。 Spark on Hive : Hive只作为存储元数据,Spark负责SQL解析优化,语法是SparkSQL语法,Spark负责采用RDD执行。 HiveonSpark配置 1)兼容性说明 注意:官网下载的Hive3.1.2和Spark3.0.0默认是不兼容的。因为Hive...

yang灬仔 4968

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Spark各模式介绍

在本地模式中,只需要将压缩包解压至目标文件夹即可解压命令如下在本地模式中执行sparkPi案例,不需要启动spark,在bin目录中,已经有了执行脚本脚本命令为因此,spark的本地模式直接解压即可。

weixin_45934766的博客 1325

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Spark Hadoop集群部署与Spark操作HDFS运行详解---Spark学习笔记10

目前spark的Run on的hadoop版本大多是hadoop2以上,但是实际上各个公司的生产环境不尽相同,用到2.0

OopsOutOfMemory盛利的博客 3万+

spark安装配置

spark安装配置

m0_66279156的博客 4575

Centos搭建spark

Centos搭建spark一、spark介绍二、spark安装前提三、集群规划四、spark安装五、修改spark环境变量六、修改spark-env.sh七、修改slaves八、将安装包分发给其他节点九、启动spark集群 一、spark介绍 Spark初识 二、spark安装前提 搭建spark环境前,需要搭建的环境有: JDK8 zookeeper hadoop Centos 搭建Hadoo...

爱是与世界平行 2575
上一篇: JVM构成
下一篇: Spark共享变量的基本原理与使用
February13
博客等级 码龄10年 26粉丝 93原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值