Python打卡训练营学习记录Day36

Pandas入门教程(二十二):股票数据分析实战——yfinance 获取数据、技术指标与收益率分析 把 Pandas 用在真实场景,才能体会它的价值。本文以茅台股票为例,用 yfinance 获取历史行情,完成缺失值处理与列筛选,绘制收盘价曲线,计算 SMA 移动平均线与 RSI 相对强弱指数,并通过日收益率、累计收益率和波动率完成完整的量化分析流程。 阅读详情

仔细回顾一下神经网络到目前的内容,没跟上进度的同学补一下进度。

  • 作业:对之前的信贷项目,利用神经网络训练下,尝试用到目前的知识点让代码更加规范和美观。
  • import pandas as pd    #用于数据处理和分析,可处理表格数据。
    import numpy as np     #用于数值计算,提供了高效的数组操作。
    import matplotlib.pyplot as plt    #用于绘制各种类型的图表
    import seaborn as sns   #基于matplotlib的高级绘图库,能绘制更美观的统计图形。
    import warnings
    warnings.filterwarnings("ignore")
     
    import torch
    import torch.nn as nn
    import torch.optim as optim
    from sklearn.datasets import load_iris
    from sklearn.model_selection import train_test_split
    from sklearn.preprocessing import MinMaxScaler
    import time
    from tqdm import tqdm  # 导入tqdm库用于进度条显示
     
     # 设置中文字体(解决中文显示问题)
    plt.rcParams['font.sans-serif'] = ['SimHei']  # Windows系统常用黑体字体
    plt.rcParams['axes.unicode_minus'] = False    # 正常显示负号
    data = pd.read_csv('data.csv')    #读取数据
     
    # 设置GPU设备
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print(f"使用设备: {device}")
     
    # 先筛选字符串变量 
    discrete_features = data.select_dtypes(include=['object']).columns.tolist()
    # Home Ownership 标签编码
    home_ownership_mapping = {
        'Own Home': 1,
        'Rent': 2,
        'Have Mortgage': 3,
        'Home Mortgage': 4
    }
    data['Home Ownership'] = data['Home Ownership'].map(home_ownership_mapping)
     
    # Years in current job 标签编码
    years_in_job_mapping = {
        '< 1 year': 1,
        '1 year': 2,
        '2 years': 3,
        '3 years': 4,
        '4 years': 5,
        '5 years': 6,
        '6 years': 7,
        '7 years': 8,
        '8 years': 9,
        '9 years': 10,
        '10+ years': 11
    }
    data['Years in current job'] = data['Years in current job'].map(years_in_job_mapping)
     
    # Purpose 独热编码,记得需要将bool类型转换为数值
    data = pd.get_dummies(data, columns=['Purpose'])
    data2 = pd.read_csv("data.csv") # 重新读取数据,用来做列名对比
    list_final = [] # 新建一个空列表,用于存放独热编码后新增的特征名
    for i in data.columns:
        if i not in data2.columns:
           list_final.append(i) # 这里打印出来的就是独热编码后的特征名
    for i in list_final:
        data[i] = data[i].astype(int) # 这里的i就是独热编码后的特征名
     
    # Term 0 - 1 映射
    term_mapping = {
        'Short Term': 0,
        'Long Term': 1
    }
    data['Term'] = data['Term'].map(term_mapping)
    data.rename(columns={'Term': 'Long Term'}, inplace=True) # 重命名列
    continuous_features = data.select_dtypes(include=['int64', 'float64']).columns.tolist()  #把筛选出来的列名转换成列表
     
     # 连续特征用中位数补全
    for feature in continuous_features:     
        mode_value = data[feature].mode()[0]            #获取该列的众数。
        data[feature].fillna(mode_value, inplace=True)          #用众数填充该列的缺失值,inplace=True表示直接在原数据上修改。
     
    # 最开始也说了 很多调参函数自带交叉验证,甚至是必选的参数,你如果想要不交叉反而实现起来会麻烦很多
    # 所以这里我们还是只划分一次数据集
    from sklearn.model_selection import train_test_split
    X = data.drop(['Credit Default'], axis=1)  # 特征,axis=1表示按列删除
    y = data['Credit Default'] # 标签
    # 按照8:2划分训练集和测试集
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)  # 80%训练集,20%测试集
    # 划分训练集和测试集
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
     
    # 归一化数据
    scaler = MinMaxScaler()
    X_train = scaler.fit_transform(X_train)
    X_test = scaler.transform(X_test)
    X_train = torch.FloatTensor(X_train).to(device)
    y_train = torch.LongTensor(y_train.values).to(device) 
    X_test = torch.FloatTensor(X_test).to(device)
    y_test = torch.LongTensor(y_test.values).to(device) 
     
    batch_size = 64
    train_dataset = torch.utils.data.TensorDataset(X_train, y_train)
    train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
     
    input_size=X_train.shape[1]
    class MLP(nn.Module):
        def __init__(self, input_size):  # 添加input_size参数
            super(MLP, self).__init__()
            self.fc1 = nn.Linear(input_size, 64)  # 输入维度为实际特征数
            self.relu = nn.ReLU()
            self.dropout = nn.Dropout(0.2)  # 新增dropout层防止过拟合
            self.fc2 = nn.Linear(64, 2)  # 输出改为2个神经元(二分类问题)
        
        def forward(self, x):
            out = self.fc1(x)
            out = self.relu(out)
            out = self.dropout(out)
            out = self.fc2(out)
            return out
     
    # 实例化模型
    model = MLP(input_size=X_train.shape[1]).to(device) 
     
    # 分类问题使用交叉熵损失函数
    criterion = nn.CrossEntropyLoss()
     
    optimizer = optim.Adam(model.parameters(), lr=0.001)  # 改为Adam优化器
    criterion = nn.CrossEntropyLoss()
     
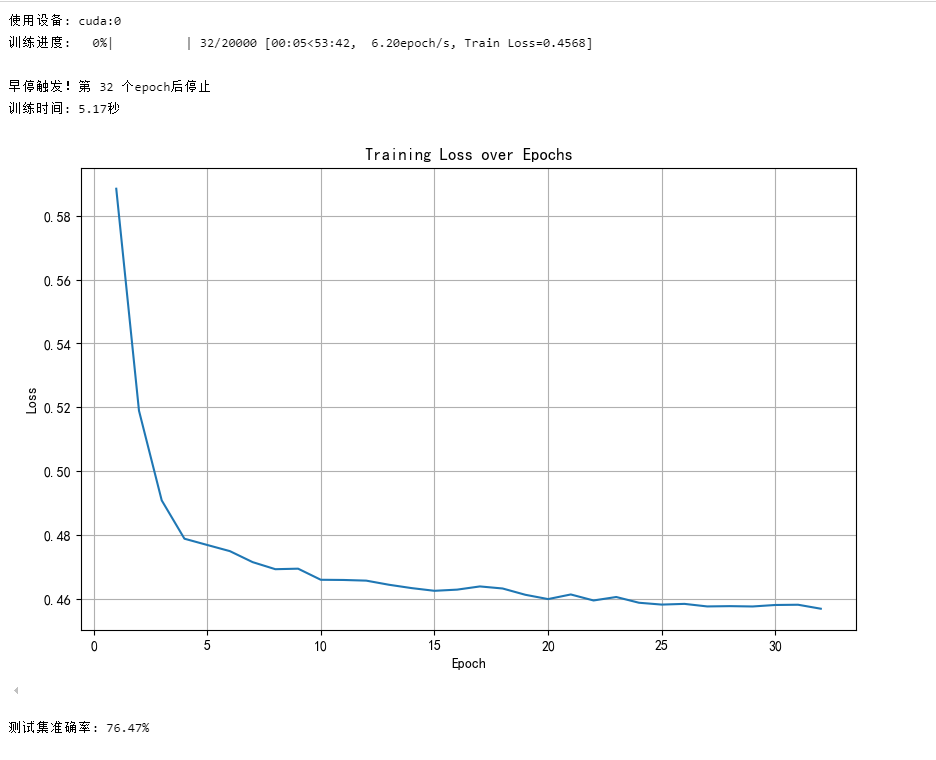
    num_epochs = 20000
    best_loss = float('inf')
    patience = 5       
    min_delta = 0.001  
    counter = 0        
     
    # 添加记录列表
    loss_history = []
    epoch_list = []
     
    start_time = time.time()
    with tqdm(total=num_epochs, desc="训练进度", unit="epoch") as pbar:
        for epoch in range(num_epochs):
            model.train()
            epoch_loss = 0.0
            
            # 训练步骤
            for inputs, labels in train_loader:
                optimizer.zero_grad()
                outputs = model(inputs)
                loss = criterion(outputs, labels)
                loss.backward()
                optimizer.step()
                epoch_loss += loss.item() * inputs.size(0)
            
            # 计算平均epoch损失
            avg_loss = epoch_loss / len(train_loader.dataset)
            loss_history.append(avg_loss)     
            epoch_list.append(epoch+1) 
            
            # 更新进度条
            pbar.set_postfix({'Train Loss': f'{avg_loss:.4f}'})
            pbar.update(1)
            
            # 早停逻辑(基于训练损失)
            if avg_loss < best_loss - min_delta:
                best_loss = avg_loss
                counter = 0
                best_weights = model.state_dict().copy()  # 保存最佳权重
            else:
                counter += 1
                if counter >= patience:
                    print(f"\n早停触发!第 {epoch+1} 个epoch后停止")
                    break
     
    # 加载最佳模型权重
    model.load_state_dict(best_weights)
     
    time_all = time.time() - start_time
    print(f'训练时间: {time_all:.2f}秒')
     
    # 可视化损失曲线
    plt.figure(figsize=(10, 6))
    plt.plot(epoch_list, loss_history)
    plt.xlabel('Epoch')
    plt.ylabel('Loss')
    plt.title('Training Loss over Epochs')
    plt.grid(True)
    plt.show()
     
    # 评估模型
    model.eval() # 设置模型为评估模式
    with torch.no_grad(): # torch.no_grad()的作用是禁用梯度计算,可以提高模型推理速度
        outputs = model(X_test)  # 对测试数据进行前向传播,获得预测结果
        _, predicted = torch.max(outputs, 1) # torch.max(outputs, 1)返回每行的最大值和对应的索引
     
        correct = (predicted == y_test).sum().item() # 计算预测正确的样本数
        accuracy = correct / y_test.size(0)
        print(f'测试集准确率: {accuracy * 100:.2f}%')
@浙大疏锦行 

如何处理动态语言(Python / JS)的“隐形”调用链? 本文揭示动态语言(Python/JS)中静态AST解析导致调用链“断链”的核心问题,提出通过运行时追踪补全图谱的解决方案。基于Code-Graph-RAG的cgr trace机制,分别利用pytest插件与V8 Profiler捕获真实调用路径,将动态边合并至静态图谱,并在权重体系中提升动态边优先级。实践表明,该方法可显著提升图谱覆盖率,实现“结构+行为”双视角理解代码,为MCP与Rerank系统提供可靠支持。 阅读详情

相关推荐

ubuntu打实时内核补丁教程以及安装后显卡驱动问题解决方法

在ubuntu20.04上安装成功,亲测有效 目录ubuntu打实时内核补丁教程1、下载实时内核2、解压和打补丁(patch)3、安装依赖和编译安装4、修改一些文件,便于之后切换内核5、重启电脑实时内核版本下安装nvidia显卡驱动的问题1、先切换回之前的内核(非实时)版本2、重装之前内核(非实时)版本下的显卡驱动3、切换回实时内核(按照上面的步骤)4、在实时内核下安装显卡驱动 ubuntu打实时内核补丁教程 安装目标系统:ubuntu20.04 电脑配置:i9,2080ti 1、下载实时内核 打开终端,输

weixin_39275295的博客 7996

60天python训练营打卡day36

●作业:对之前的信贷项目,利用神经网络训练下,尝试用到目前的知识点让代码更加规范和美观。●探索性作业(随意完成):尝试进入nn.Module中,查看他的方法。仔细回顾一下神经网络到目前的内容,没跟上进度的同学补一下进度。DAY 36 复习日。

extan的博客 239

从仿真到器件:铌酸锂电光调制器Comsol建模避坑指南

本文详细介绍了铌酸锂电光调制器在Comsol中的建模全流程,涵盖晶体切向选择、材料参数配置、多物理场耦合等关键技术。通过实战案例和调试技巧,帮助工程师避开常见建模陷阱,提升仿真精度与效率,特别适用于高速光通信系统的器件设计与优化。

m2n3b4v5c6的博客 419

python打卡训练营打卡记录day36

损失曲线显示前 5 epoch 快速收敛(从 0.62→0.48),后期缓慢下降,早停避免了冗余计算,符合小模型快速收敛的特性。由于引入了早停机制,训练进度只有29/20000,考虑到训练时间可能过短,所以进行优化。尝试了增加网络深度、平衡类别权重、调整学习率、梯度裁剪、动态早停阈值、添加L2正则化等多种方法,但这些方法无一例外出现训练时间延长,准确率反而下降的问题。对之前的信贷项目,利用神经网络训练下,尝试用到目前的知识点让代码更加规范和美观。这说明在深度学习中,

yorushika_的博客 716

STM32H745xI双核芯片SMPS/LDO配置误区:从复位失败到精准排查的实战复盘

本文详细分析了STM32H745xI双核芯片在SMPS/LDO配置中的常见误区,特别是复位失败问题的排查过程。通过对比参考板与故障板的波形数据,揭示了电感选型不当导致的电源稳定性问题,并提供了硬件设计检查清单和调试技巧,帮助开发者避免类似陷阱。

weixin_42531588的博客 265

OCTF2016--piapiapia

知识点: php反序列化长度变化尾部字符串逃逸 目录扫描发现www.zip,下载得到源码 源码有index.php,输入账号密码后会进入profile.php,还有register.php、updata.php、class.php和config.php flag值在config.php中,想办法访问到其内容 通过seay代码审计找到一点线索 看到profile.php中存在任意文件读取漏洞,前面还有反序列化 现在我们有个大体思路了,update.php中有一个$prof..

Oavinci的博客 474

Python打卡训练营day36

【代码】Python打卡训练营day36。

weixin_70153780的博客 232

AHB总线协议

1. 简介         AHB总线规范是AMBA总线规范的一部分,AMBA总线规范是ARM公司提出的总线规范,被大多数SoC设计采用,它规定了AHB (Advanced High-performance Bus)、ASB (Advanced System Bus)、APB (Advanced Peripheral Bus)。AHB用于高性能、高时钟频率的系统结构,典型的应用如ARM核与系统内

ivy_reny的专栏 8万+

Python打卡训练营day36——2025.05.25

【代码】Python打卡训练营day36——2025.05.25。

hans041113的博客 254

172、摄像头振动与异响分析:VCM 共振、OIS 机械噪声的用户体验改善

摘要: 本文深入探讨了手机摄像头模组中VCM(音圈马达)与OIS(光学防抖)系统产生的振动异响问题及其解决方案。通过实际案例,分析了VCM弹簧片共振、OIS悬丝机械噪声以及系统级共振的成因,提出了硬件改进(如弹簧片厚度调整、阻尼材料应用)、驱动优化(PWM频率微调、软启动配置)和算法避让等综合解决策略。特别强调了量产阶段隐蔽性问题的排查技巧,包括扫频测试、机械阻尼处理和用户体验优化方法(如频率掩蔽)。作者建议工程师避免过度依赖仿真数据,重视实物测试,并与声学团队协作,以解决这类"玄学"问题,提升用户感知体验

sundong_81的博客 128

YOLO11涨点优化:创新多尺度卷积注意力(MSCA)模块,小目标检测神器!

MSCA模块通过创新的多尺度设计,在保持计算效率的同时显著提升小目标检测能力。实验证明,在YOLOv5/v8等模型上嵌入MSCA后,mAP提升超过2%,小目标检测精度提升近4%,且计算代价增加极小。注意力机制的未来发展方向动态核尺寸:根据输入特征自适应调整卷积核大小跨模态融合:结合RGB与深度/热力图等多模态信息自监督优化:利用对比学习预训练注意力模块尝试在你的YOLO模型中插入MSCA模块,欢迎在评论区分享你的涨点结果!参考文献。

QQ_778132974的博客 470

Python训练营打卡Day36(2025.5.25)

【代码】Python训练营打卡Day36(2025.5.25)

2301_80505456的博客 272

数据治理——详解元数据、资源目录、主数据、数据元、元数据管理、主数据管理【附全文阅读】

摘要:数据中心建设的核心是元数据管理,即"描述数据的数据",包含内容、质量、所有者等关键信息。元数据在数据仓库中记录数据源、转换规则等,是管理基础;主数据管理则确保核心业务数据的准确一致。二者共同构建高效的数据资源目录,为数据服务提供支撑。(99字)

cdfunlove的博客 101

Python训练营打卡Day3

创建一个包含三个字符串元素的列表 tech_list,元素分别为 “Python”, “Java”, “Go”。修改 tech_list 中的第二个元素(索引为 1),将其从 “Java” 更改为 “Ruby”。定义一个包含整数的列表 scores,赋值为 [85, 92, 78, 65, 95, 88]。计算当前 tech_list 的长度,并将结果存储在变量 current_length 中。获取列表中的第一个元素,并将其存储在变量 first_tech 中。- 高于35度:打印"红色预警:高温天气!

wanderer0221的博客 606

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

百度paddlepaddle《青春有你2》Python小白逆袭大神技术打卡学习总结

之前参加过百度飞桨深度学习CV疫情训练营7天打卡学习,从了解概念到简单的使用paddle做一些口罩监测类的识别任务,收获特别多,这次又参加了更加基础的小白训练营,感觉对深度学习、padddle,paddleHub的了解又进一步加深,早上晨会的时候还向领导推荐EasyDL,并结合我对公司业务了解谈了自己的建议和想法,以及我们部门未来的技术方向问题。领导很认同,并要了EasyDL的应用案例网址了解一下...

Clay's Spectrum 838

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Python训练营打卡Day36-早停策略和模型权重的保存

知识点回顾:过拟合的判断:测试集和训练集同步打印指标模型的保存和加载仅保存权重保存权重和模型保存全部信息checkpoint,还包含训练状态早停策略作业:对信贷数据集训练后保存权重,加载权重后继续训练50轮,并采取早停策略。

m0_60783025的博客 361

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

百度AI-7Days-打卡集训营总结

这里写自定义目录标题打卡训练营总结Day1Day2Day3在这里插入图片描述在这里插入图片描述Day4Day5导出与导入导出导入 打卡训练营总结 本次打卡一共有7次授课,5次任务。 Day1:简单的格式化输出和os库的简单应用 Day2:爬取选手信息(自写爬取图片) Day3:《青春有你2》选手数据分析 Day1 第一次作业的内容: 1、输出 9*9 乘法口诀表(注意格式) 2、查找特定名称...

qq_44707928的博客 1209

python 爬虫课程推荐_大家有没有什么好的爬虫推荐教程?

正好,刚开始接触python的时候,参加了一个算是免费(其实是需要付费9.9)的培训课程,刚好是七天课程,爬虫入门!个人建议:python入门不建议报培训课!!!请须知!因为这些你自学就行,网上可以找到很多内容,你不花钱就能学会,你学不会(学废),花钱也没用!不是广告推销课程,仅仅是记录流水文,非利益相关,如果侵权可联系我删除!!说是七天,实际上是六天!新人学,六天,比较难吧,尤其是零基础可能会学...

weixin_39686353的博客 850

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 415

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 235

【每天一个 Python 小案例30】Python 基础知识综合小项目:我的工具盒

作为系列收官,本篇把前 29 篇的知识点合成一个能直接用的命令行工具"我的工具盒":计算器(用 ast 解析表达式,不碰 eval)、单位换算与温度转换(一张换算表 + 特例分支)、记账与分类统计(Decimal + JSON 持久化)、以及用"字典当命令表"把菜单和业务逻辑解耦的主循环。文中对比了 eval 的安全隐患与 ast 白名单的做法,解释了 lambda 闭包在字典里的写法与晚绑定陷阱,并在最后给出整个系列的知识地图,把变量、数据结构、控制流、函数、类、异常、文件、标准库八块内容对应到具体篇目。

xinjiyaya的博客 427

10分钟完成第一个Python小游戏

第一个项目不用找复杂的,‌直接选「猜数字小游戏」对应的教程‌就好——几乎所有入门教程都会讲这个项目,资料最多、遇到问题随便搜就能找到解决方法,不会卡壳,30分钟肯定能做完,非常容易建立信心。‌教程链接‌:直接搜标题👉 ‌《Python零基础入门项目:30分钟写完猜数字游戏》‌(优先选黑马程序员、鱼C-小甲鱼这两个UP主的版本,播放量都是百万级,口碑稳定)‌教程地址‌:打开菜鸟教程官网→找到「Python 实例」板块,直接在线写代码运行。全程不跳步,30分钟就能做完,做完能直接运行玩,成就感拉满。

mF44Job8l的博客 45

二进制木马免杀-Python 分离免杀与 Web 挂马

二进制木马免杀-Python 分离免杀与 Web 挂马

2503_94637398的博客 269

蓝桥杯·全国青少年信息素养大赛·电子学会Python/C++考级 备考:莫队算法离线区间查询详解

备赛进行时:第十八届蓝桥杯软件赛报名已于 2026-10-08 10:00 开启、12-18 14:00 截止,省赛定在 2027-04-10(C/C++·Python 程序设计 9:00–13:00);中国电子学会 2026 年 12 月软件编程(C/C++ 一级至十级、Python 一级至六级)考级报名 9/23–12/2 16:00、统考 12-12;全国青少年信息素养大赛 2026—2027 赛季算法应用主题赛也已进入复盘练兵窗口。

IT_Scratch的博客 158

我用 200 行代码写了个“代码屎山检测器“,扫完公司的老项目后我沉默了

这个工具不能帮你把屎山铲平,但至少能让你知道自己面对的是多大的山,也能在代码评审时用数据说话——“这个 PR 把圈复杂度从 12 推到了 18,能不能拆一下?毕竟,不能量化的东西,就没法改进。

xixiaoyunya的博客 249

魔塔社区微调训练Qwen2-1.5B-Instruct模型并烧录到‌RK3568开发板教程

本文基于Ubuntu 22.04 + CUDA 13.0.3环境,使用LLaMA-Factory框架对Qwen2-1.5B-Instruct模型进行LoRA微调,训练儿童故事生成专用模型。通过配置qwen模板、制作alpaca格式数据集、执行sft训练并合并LoRA权重,最终将模型转换为GGUF格式,并量化为Q4_K_M以适配RK3568嵌入式平台。全程支持国产镜像加速下载与显存优化,实现高效轻量化部署。

浅清秋慕夏的博客 187
上一篇: Python打卡训练营学习记录Day35
下一篇: 【无标题】
FanfanPyt
博客等级 码龄2年 82粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值