数据结构——快速排序与归并排序

从零开始学数据结构和算法 (五) 分治法 (二分查找、快速排序、归并排序) 概念 二分查找也称折半查找(Binary Search),它是一种效率较高的查找方法。但是,折半查找要求线性表必须采用顺序存储结构,而且表中元素按关键字有序排列。 优点 查找速度快 缺点 待查表为有序表 算法思路 首先,假设表中元素是按升序排列,将表中间位置记录的关键字与查找关键字比较,如果两者相等,则查找成功;否则利用中间位置记录将表分成前、后两个子表,如果中间位置记录的关键字大于查找关键字,则进一步查找前一子表,否则进一步查找后一子表。重复以上过程,直到找到满足条件的记录,使查找成功,或直 阅读详情

快速排序

定义:
快速排序是由冒泡排序改进而得的。在冒泡排序过程中,只对相邻的两个记录进行比较,因此每次交换两个相邻记录时只能消除一个逆序。如果能通过两个不相邻记录的一次交换,消除多个逆序,则会大大加快排序的速度。快速排序方法中的一次交换能消除多个逆序。

具体步骤:
1.选择待排序表中的第一个记录作为枢轴,附设两个指针low和high,初始时分别指向标的下界和上界;
2.从标的最右侧位置一次向左搜索,找到第一个关键字小于枢轴关键字的记录,将其移至low处;
3.然后再从表的最左侧位置,依次向右搜索找到第一个关键字大于枢轴的记录,将其移至high处;
4.重复2和3,直至low和high相等为止;
(实际上相当于取出第一个记录,从high向左搜索找到一个值放入第一个记录,再从low向右搜索找到一个值放入上轮空缺的high值。)

算法特点:
(1)记录非顺次的移动导致排序方法是不稳定的。
(2)排序过程中需要定位表的下界和上界,所以适合用于顺序结构,很难用于链式结构。
(3)当n较大时,在平均情况下快速排序是所有内部排序方法中速度最快的一种,所以其适合初始记录无序,n较大的情况。

时间复杂度空间复杂度
O(nlogn)O(1)

代码:(以对vector排序为例)

#include <iostream>
#include <vector>
using namespace std;
//快速排序
int Partition(vector<int> &arr, int low, int high)//low high指针移动一趟
{
    int p = arr[low];
    while (low < high) {
        while (low < high && arr[high] >= p)    high--;
        arr[low] = arr[high];
        while (low < high && arr[low] <= p)     low++;
        arr[high] = arr[low];
    }
    arr[low] = p;
    return low;//返回枢轴位置
}
void QSort(vector<int> &arr, int low, int high)//递归
{
    if (low < high) {
        int p = Partition(arr, low, high);
        QSort(arr, low, p - 1);
        QSort(arr, p + 1, high);
    }
}
int main()
{
    vector<int> test = { 49,38,65,97,76,13,27,49 };
    QSort(test, 0, test.size()-1);
    //输出排序后的向量
    for (int k = 0; k < test.size(); k++)
        cout << test[k] << " ";
}

归并排序

定义:
归并排序就是将两个或两个以上的有序表合并成一个有序表的过程,将两个有序表合并成一个有序表的过程称为2-路归并,2-路归并最简单和常用。

具体步骤:
2-路归并排序将R[low,high]中的记录归并排序后放入T[low,high]中,当序列长度等于1时,递归结束。否则:
1.将当前序列一分为二,求出分裂点mid=(low+high)/2;
2.对子序列R[low,mid]递归,进行归并排序,结果放入S[low,high]中;
3.对子序列R[mid+1,high]递归,进行归并排序,结果放入S[mid+1,high]中;
4.调用算法Merge,将有序的两个子序列S[low,mid]和S[mid+1,high]归并为一个有序的序列T[low,high];

算法特点:
(1)归并排序为稳定排序
(2)可用于链式结构,且不需要附加存储空间,但递归实现时仍需要开辟相应的递归工作栈。

时间复杂度空间复杂度
O(nlogn)O(n)

代码:(以对vector排序为例)

#include <iostream>
#include <vector>
using namespace std;
//归并排序
//将R[low,mid] R[mid+1,high]归并为有序表T[low,high]
void Merge(vector<int> &R, vector<int> &T, int low, int mid, int high)
{   
    int i = low, j = mid + 1, k = low;
    while (i <= mid && j <= high) {
        if (R[i] < R[j])
            T[k++] = R[i++];
        else
            T[k++] = R[j++];
    }
    while (i <= mid) T[k++] = R[i++];
    while (j <= high) T[k++] = R[j++];
}
//R归并排序后放入T中
void MSort(vector<int> &R, vector<int> &T, int low, int high)
{
    if (low == high) T[low] = R[low];
    else {
        int mid = (low + high) / 2;
        vector<int> S(R.size());
        MSort(R, S, low, mid);
        MSort(R, S, mid+1, high);
        Merge(S, T, low, mid, high);
    }
}
int main()
{
    vector<int> test = { 49,38,65,97,76,13,27,49 };
    MSort(test, test, 0, test.size()-1);
    for (int k = 0; k < test.size(); k++)
        cout << test[k] << " ";
}

实验结果截图:
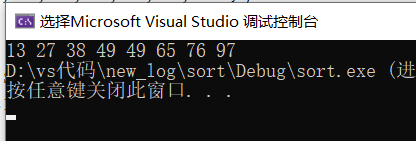
在这里插入图片描述

Spring AI 实战:5 分钟搭建你的第一个 AI 应用(含完整代码) 能力关键 API适用场景基础对话简单问答、文本生成流式输出实时打字机效果@Bean模型需要调用外部工具结构化输出需要返回 Java 对象多轮对话聊天机器人场景Spring AI 让 Java 开发者可以用最熟悉的方式(Spring Boot + Maven)进入 AI 应用开发领域,不用学新语言,不用换框架,这是它最大的优势。但目前为止,我们的 AI 应用只能回答"它脑子里已有的知识"。如果让它读懂你自己的技术文档、公司内部知识库呢?这就是下一篇文章的主题——RAG(检索增强生成)实战。 阅读详情

相关推荐

PMF5.0计算

EPA PMF5.0 计算步骤

nuistsy的博客 4545

快速排序

快速排序 快速排序是由冒泡排序改进而得的。在冒泡排序过程中,只对相邻的两个记录进行比较,因此每次交换两个相邻记录时只能消除一个逆序。如果能通过两个(不相邻)记录的一次交换,消除多个逆序,则会大大加快排序的速度。快速排序方法中的一次交换可能消除多个逆序。 基于分治的思想。首先在数组中选择一个基准点(该基准点的选取可能影响快速排序的效率,后面讲解选取的方法),然后分别从数组的两端扫描数组,设两个指示...

枫之木落的博客 387

​​瑞芯微RK系列 vs 全志系列芯片:终极选型指南(2025版)​

​。

jinxi996611的博客 1万+

快速排序-Java

快速排序(Quicksort)是对冒泡排序的一种改进。 快速排序由C. A. R. Hoare在1962年提出。它的基本思想是:通过一趟排序将要排序的数据分割成独立的两部分,其中一部分的所有数据都比另外一部分的所有数据都要小,然后再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归进行,以此达到整个数据变成有序序列。 设要排序的数组是A[0]……A[N-1],首先任意选取一个数据(通常选...

zzw_17600691357的博客 205

解锁SPWM电压利用率:三次谐波注入幅值的黄金分割点

本文深入探讨了SPWM电压利用率的提升方法,重点介绍了三次谐波注入技术及其黄金分割点(1/6比例)。通过数学推导和工程实践,揭示了如何通过特定幅值的三次谐波注入将电压利用率从86.6%提升至115%,与SVPWM相当。文章还提供了实验室调试流程和DSP实现代码,帮助工程师优化逆变器设计。

weixin_30729609的博客 916

C++面向对象程序设计大作业:魔兽世界(三):开战

C++面向对象程序设计大作业:魔兽世界(三):开战问题描述问题分析代码 问题描述 问题来自于北京大学郭炜老师的C++慕课的大作业 魔兽世界的西面是红魔军的司令部,东面是蓝魔军的司令部。两个司令部之间是依次排列的若干城市,城市从西向东依次编号为1,2,3 … N ( N <= 20)。红魔军的司令部算作编号为0的城市,蓝魔军的司令部算作编号为N+1的城市。司令部有生命元,用于制造武士。 两军的司令部都会制造武士。武士一共有dragon 、ninja、iceman、lion、wolf 五种。每种武士都有

RedRum_1965的博客 4038

《大话数据结构》笔记:第九章 排序

1.5.1逻辑结构 1.集合结构 2.线性结构 3.树形结构 4.图形结构 四种应该分别对应,数组,链表,树,图 1.5.2 物理结构 计算机中的实际存储形式 1.顺序存储结构:对应数组 2.链式存储结构:使用指针,对应链表 2.算法 算法: ...

weiruoxingguang的博客 440

LightGBM处理类别特征和缺失值有多省心?一个真实业务数据案例带你上手

本文通过真实电商数据案例,详细解析了LightGBM如何高效处理类别特征和缺失值。相比传统方法,LightGBM仅需一行代码即可自动处理高基数类别特征和缺失值,大幅提升模型训练效率和预测准确度,特别适合业务场景中的脏数据处理。

weixin_30689307的博客 460

数据结构----归并排序、快速排序

归并排序、快速排序一、归并排序1、规则2、代码3、时间复杂度、空间复杂度、稳定性二、快速排序1、规则2、代码3、时间复杂度、空间复杂度、稳定性三、总结 一、归并排序 1、规则 首先将所有的数据默认每个组,当所有的数 1、将所有数据单独给每个数据每个组(每个数据单独看,就是有序的) 原始数据:    84  9 18 19 48 12 90 84 90 12 第一次两两合并: 9  84 18 19 12 48 84 90 12 90 2、代码 3、时间复杂度、空间复杂度、稳定性 时间复杂度:O(n*l

li94263的博客 997

灵魂三问:因果推断

什么是因果推断?为什么研究因果推断?怎么进行因果推断研究?

ML OR 智能决策的博客 2903

最新Python爬虫实战(入门爬虫篇)——案例13:某乎热榜数据采集(详细爬虫思路截图+抓包动图演示+完整爬虫代码+详细注释)

本次案例通过Python爬虫技术,成功实现了基于Cookies认证的某乎热榜数据爬取与Excel保存。代码采用模块化设计,包含Cookies解析、HTML请求、结构化解析、Excel持久化等完整流程;通过配置浏览器请求头+Cookies认证,有效突破某乎基础反爬策略,保证请求稳定性。整个爬虫逻辑遵循“Cookies认证 → 页面请求 → HTML解析 → 数据清洗 → 保存到Excel”的标准流程,与需要会话验证的网站爬取范式高度一致。Cookies解析与认证。

努力让自己发光,对的人才能迎着光而来 33万+

Python算法与数据结构——快速排序、堆排序、归并排序

快速排序、堆排序、归并排序

weixin_74165584的博客 3164

Qt/C++ 音视频开发 - FFmpeg 安卓版

通过将 FFmpeg 集成到 Qt/C++ 项目中,我们可以实现强大且灵活的音视频处理功能。本文介绍了在安卓平台上使用 FFmpeg 的基本步骤,包括初始化、解码、处理和编码等。实际应用代码示例展示了如何在安卓设备上播放视频。

走向CTO的路上... 1193

数据结构与算法基础——快速排序与归并排序

前言 最近在复习数据结构,顺便整理之前刷题的一些模板和技巧,希望对大家都有帮助,博客会侧重讲解的是OJ代码实现,理论部分偏少但也会写一些自己的理解。 在之前大二上数据结构的时候我也有写过一个关于排序的专题介绍数据结构复习——内部排序 快速排序 快速排序主要就是通过选取一个基准点,将一个区间内的数分成大于和小于两个部分,然后对左右区间再进行上述操作,直到子区间的长度为空为止。快速排序是不稳定的排序,如果需要变成稳定排序通过双关键字排序即可,通过下标控制绝对大小就能得到稳定的排序结果。 快速排序分三步走: 确

Jack___E的博客 306

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

【数据结构】非递归实现快速排序与归并排序

归并排序与快排的非递归实现

2301_78636079的博客 1012

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

小鱼要学数据结构与算法(基于python)—Day14归并排序和快速排序

数据结构学习笔记14(北大公开课)目录排序和查找一、知识概览1.1 归并排序1.2 快速排序二 代码实现2.1 归并排序2.2 更pythonic的归并排序2.3 快速排序 排序和查找 一、知识概览 本章主要讲解六种排序算法中的归并排序和快速排序,知识概览如下。 1.1 归并排序 1.2 快速排序 归并排序的重点在于合,而快速排序的重点在于分,下面是分裂过程: 二 代码实现 2.1 归并排序 #归并排序 def mergeSort(alist): if len(alist)>1:

weixin_42186072的博客 310

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

【数据结构与算法】:非递归实现快速排序、归并排序

🔥个人主页🔥上篇文章我们详细讲解了递归版本的快速排序,本篇我们来探究非递归实现快速排序和归并排序。

Quietcoder的博客 4323

【数据结构】快速排序与归并排序的非递归实现

主要讲解了快速排序和归并排序的非递归实现。

Demon___1的博客 1203

【数据结构实战】一起探索快速排序和归并排序的奥秘

上一篇我们讲了各大排序之间的差距,以及他们实现的思路和代码,本期我们将详细的研究一下快速排序和归并排序的奥秘

m0_74779094的博客 1399

一文彻底搞清楚数据结构之快速排序和归并排序的深入优化

本文介绍了快速排序和归并排序的优化方法,重点分析了快速排序性能的关键点及三路划分算法。文章指出快速排序性能取决于每次单趟排序后key对数组的分割情况,并提出当数组中有大量重复数据时,传统方法效率会下降。针对这一问题,详细讲解了三路划分算法的核心思想:将数组分为小于key、等于key和大于key三部分,并给出了相应的代码实现。通过对比hoare、lomuto和三路划分三种单趟排序方法在不同数据情况下的表现,展示了三路划分在处理重复数据时的优势。该优化方法能有效提升快速排序在特定场景下的性能表现。

承于所学,探技术之渊;以代码求政,寻成长之道。 2299

数据结构与算法学习笔记——快速排序、归并排序

快速排序 快速排序(Quicksort)是对冒泡排序的一种改进。基本思想是:通过一趟排序将要排序的数据分割成独立的两部分,其中一部分的所有数据都比另外一部分的所有数据都要小,然后再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归进行,以此达到整个数据变成有序序列 实现思路 代码实现 import java.util.Arrays; public class QuickSort { public static void main(String[] args) { in

qq_29384339的博客 427

探索数据结构:快速排序与归并排序的实现与优化

快速排序和归并排序是两种常见的排序算法。快速排序是一种分治策略的排序算法,通过不断地将待排序数组分成更小的子数组,并对这些子数组进行排序,最终完成整个数组的排序。归并排序也是一种分治策略的排序算法,它将待排序数组分成两个子数组,然后递归地将每个子数组排序,最后将两个有序子数组合并为一个有序数组。相比之下,快速排序更加高效,但归并排序是一种稳定的排序算法。想要了解更多关于这两种排序算法的内容,赶快来看看本篇博客吧!

Bettysweetyaaa的博客 2250

数据结构与算法-归并排序,快速排序

数据结构与算法-归并排序,快速排序 这两种多可以算是分治排序 归并排序 时间复杂度O(nlogn) 空间复杂度O(n) 稳定排序 public static void mergeSort(int[] list,int start,int end) { if(start<end) { int mid = (start+end)/2; mergeSort(list, start,...

横行的螃蟹的博客 218

Java数据结构与算法-快速排序与归并排序

快速排序 1. 快速排序原理 2. 快排的递归实现 3. 代码 4. 测试排序的速度 1,排序原理 快速排序(Quicksort)是对冒泡排序的一种改进。 基本思想:通过一趟排序将要排序的数据分割成独立的两部分,其中一部分的所有数据都比另外一部分的所有数据都要小,然后再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归进行,以此达到整个数据变成有序序列 2,快速排序的示意图 ...

大美妞的博客 3981

【C语言 - 数据结构】万字详解快速排序、归并排序

你是我黄昏时买到一束花的快乐!1、hoare版本 2、挖坑法3、前后指针法 有了前面的讲解,我们对于hoare版本的快速排序已经有了一定的了解了,我们现在实现其代码部分:(大家可以先理解我对hoare版本的定义再来看其实现代码,或者是结合起来理解) 贴一张图方便大家理解 2.3前后指针法的递归代码示例 三、快速排序的非递归实现以及快排模板 3.1快排的非递归实现 我们还是使用前后指针法来找key,然后用栈来实现递归的作用 用前后指针加之栈来实现快排的代码:

qq_62662919的博客 5513

数据结构 面试算法 : 冒泡排序,插入排序,归并排序,快速排序。。。

3 排序算法 3.1 冒泡排序 3.2 插入排序 3.3 归并排序 开辟新的内存存

weixin_42031723的博客 320
上一篇: leetcode——最小栈
下一篇: 数据结构——查找
Your_Julia
博客等级 码龄8年 374粉丝 223原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值