


🌐 社群导航
🔗点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群
最新论文解读系列
论文名:ARTalk: Speech-Driven 3D Head Animation via Autoregressive Model
论文链接:https://arxiv.org/pdf/2502.20323
开源代码:https://xg-chu.site/project_artalk
导读
语音驱动的3D面部动画因其在虚拟现实、游戏动画、电影制作和人机交互等领域的广泛应用,在学术界和工业界都引起了极大关注。这项任务专注于直接从语音输入中生成自然且同步的面部表情,尤其是嘴唇动作,以及逼真的头部动作。近年来,许多探索性方法显著提升了语音驱动的动作生成任务的性能。然而,由于语音与面部或头部动作之间存在固有的复杂多对多映射关系,生成自然且逼真的动作仍然具有挑战性。捕捉这些复杂关系对于创建逼真的动画至关重要。
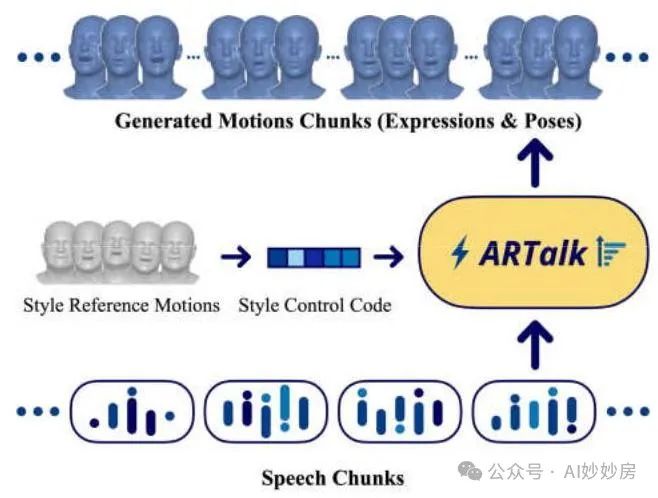
图1。我们推出了ARTalk,这是一个由语音驱动的3D面部动作生成框架。我们的方法学习从语音到多尺度动作码本的映射,从而能够实时生成逼真且多样的动画序列。
简介
语音驱动的3D面部动画旨在根据任意音频片段为3D头部模型生成逼真的嘴唇动作和面部表情。尽管现有的基于扩散的方法能够产生自然的动作,但其生成速度较慢,限制了其应用潜力。在本文中,我们介绍了一种新颖的自回归模型,该模型通过学习从语音到多尺度运动码本的映射,实现了高度同步的嘴唇动作、逼真的头部姿态和眨眼的实时生成。此外,我们的模型可以利用样本运动序列适应未见的说话风格,从而能够创建具有独特个人风格的3D会说话的虚拟形象,这些风格超出了训练期间所见的身份。大量的评估和用户研究表明,我们的方法在嘴唇同步准确性和感知质量方面优于现有方法。
方法与模型
我们在图2中对我们的方法进行概述。我们采用广泛使用的3DMM(三维可变形模型,Li等人,2017年)作为面部表征,并利用多尺度矢量量化(VQ)自编码器模型进行训练,以获得多尺度运动码本及其对应的编码器 - 解码器,从而实现运动空间的离散表征。随后,我们训练一个多尺度自回归模型,将语音信息映射到离散运动空间。
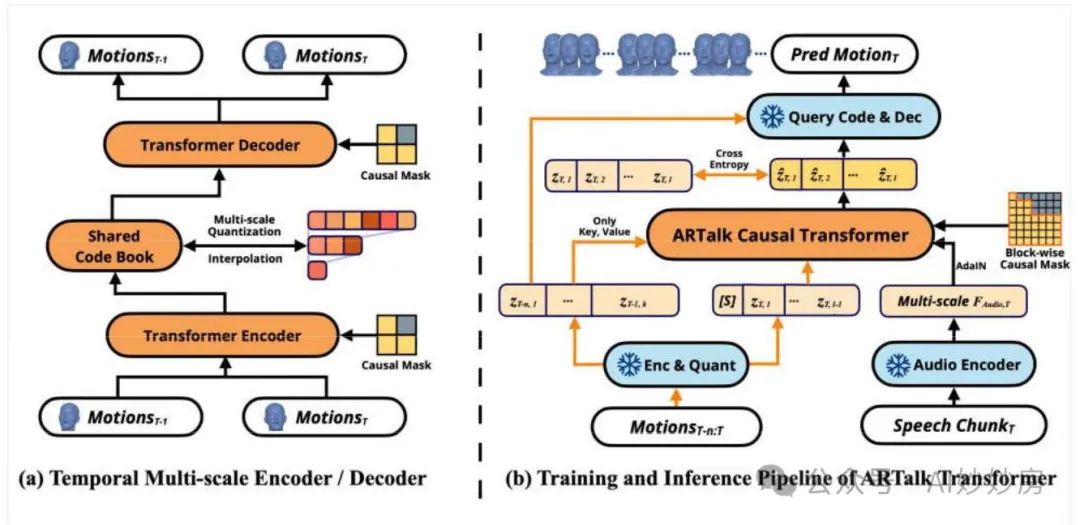
图2. ARTalk包含两个独立的部分。(a)展示了我们的时间多尺度矢量量化(VQ,Vector Quantization)自动编码器。它使用共享码本和时间上的因果掩码,将运动序列编码为多尺度令牌图。(b)展示了ARTalk因果Transformer,在训练时使用带有逐块因果注意力掩码的真实令牌,在推理时则基于语音特征、上一尺度的令牌和上一时间窗口的运动自回归地预测运动令牌。
1. 预备知识
我们采用广泛使用的3D可变形模型(3DMM)FLAME(李等人,2017年)来表示面部运动,其中每一帧都由形状、表情和姿态参数化。给定这些参数,通过混合形状和旋转操作来重建由5023个顶点组成的面部网格。与之前直接对网格进行建模的方法(范等人,2022年;邢等人,2023年;彭等人,2023a;诺森蒂尼等人,2024年)相比,FLAME通过将复杂的顶点运动转换为低维混合形状参数,同时保留表情和运动细节,简化了运动建模。
我们将运动向量定义为在帧上每帧表情和姿态参数的串联,即。对应的顶点坐标存储了每帧个网格顶点的三维位置,其中表示对应嘴唇区域的子集,该子集对于与语音相关的表情建模尤为重要。关于三维可变形模型(3DMM)的更多详细信息可在补充材料中找到。
2. 时间多尺度矢量量化自编码器
从语音中预测运动帧是一项离散任务,涉及高度密集的时间序列和复杂的映射。受离散表示在图像和运动生成方面取得的成功(邢等人,2023年;范登·奥尔德等人,2017年;周等人,2022年)以及多尺度编码的有效性(田等人,2024年)的启发,我们提出了一种时间多尺度矢量量化(VQ)自编码器,以有效地对运动动态进行建模。
由帧组成的输入运动序列首先由Transformer编码器进行处理,该编码器提取时间特征并将其映射到潜在空间中。然后使用一个多尺度码本对这些表示进行量化,该码本以不同的时间分辨率捕获运动信息,从而生成离散标记。Transformer解码器从这些离散嵌入中重建运动,同时关注局部和长距离依赖关系。
多尺度残差矢量量化(VQ)。为了逐步优化运动表示,我们采用了一种残差矢量量化方法:
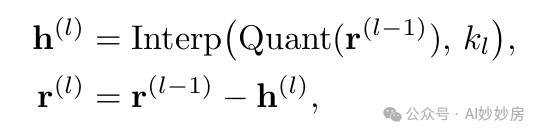
对于,其中是编码器的输出。量化函数Quant 将特征分配给最接近的码本条目,而则调整分辨率以确保平滑过渡。通过在不同尺度上累加输出,该模型在以结构化方式去除冗余的同时保持高保真度。
在最精细尺度上的残差累加可减少信息损失,而通过基于区域的插值进行下采样可提高效率。我们在不同尺度上使用共享码本,以维持统一的运动空间并简化自回归建模。这一策略提高了时间一致性,并在不同分辨率下保持了风格的连贯性。
时间因果推理。为确保在长序列上的稳定性,我们引入了一种因果推理机制,以保证跨窗口的一致性。我们的方法并非独立地生成帧,而是考虑两个连续的时间窗口,和。在训练和推理过程中,会应用因果掩码,确保对的预测仅依赖于从中先前观察到的信息,而不会泄露未来的细节。这可以防止时间上的不连续性,并增强长期运动的平滑性。
通过将多尺度残差量化与因果推理以及基于Transformer的编码/解码相结合,我们的方法确保了生成的运动序列既具有细粒度的表现力,又具有长期的连贯性。
训练目标:
为了训练矢量量化(VQ)自编码器,我们使用一种混合损失函数,以平衡运动精度、时间平滑性和码本稳定性。
重建损失强制预测的运动向量与真实值对齐,并对嘴唇和面部顶点施加额外的约束:
为确保平滑过渡,我们对速度和加速度的差异进行惩罚:
我们还应用标准的矢量量化(VQ)损失(我们将其称为),以促使矢量量化分配保持稳定并防止模式崩溃。
最终的训练目标是:
其中和控制时间约束。通过联合优化这些项,模型学习到紧凑且具有表现力的运动表征,确保合成结果具有高保真度和较强的时间连贯性。
3. 语音到动作自回归模型
在训练矢量量化自编码器(VQ autoencoder)之后,我们针对每个时间窗口在多个分辨率下获得离散码,其中的范围从最粗糙的到最精细的。为确保长期时间连贯性,我们使用一个在不同尺度和相邻窗口上自回归的Transformer对这些码进行建模。
架构。图2(b)展示了自回归(AR)模型,其中橙色箭头标记了仅用于训练的组件。一个预训练的HuBERT(许等人,2021年)编码器提取语音特征,并将其重采样到每个尺度。一个风格标记对说话人身份进行编码(孙等人,2024年)。给定前一个窗口的最精细尺度代码,我们预测当前窗口的。
两级自回归。在每个窗口内,代码是按尺度逐个生成的:
其中 表示所有更粗糙尺度上的代码。在每个尺度 内,在因果关注先前生成的尺度和前一个窗口的同时,并行(逐块)预测标记。
训练和推理。在训练期间,真实代码 通过交叉熵来监督模型:
在推理时,我们根据 和 依次采样或选择每个尺度的代码。在各个窗口上重复此过程会生成在时间上保持连贯且在风格上始终一致的运动序列。
实验与结果
数据集。我们使用孙(Sun)等人(2024年)提出的TFHP数据集来训练我们的模型,该数据集包含来自588个对象的1052个视频片段,总时长约为26.5小时。所有视频都在处进行跟踪,产生了大约238.5万个动作帧。为了进行训练和评估,我们采用了原论文(孙等人,2024年)中提供的训练/测试划分。此外,我们在广泛使用的VOCASET数据集(库代罗(Cudeiro)等人,2019年)的测试划分上评估了我们模型的泛化性能。测试划分包含来自2个对象的80对视听序列。为了使VOCASET适应我们的方法,我们在处跟踪FLAME参数,并对我们跟踪的数据进行评估。值得注意的是,我们不使用VOCASET的训练划分来训练或微调我们的方法。
实现细节。我们的方法在PyTorch框架(帕兹克等人,2017年)上实现。在第一阶段,我们训练我们的矢量量化(VQ)自编码器以获得多尺度运动码本。运动码本的大小为256,码维度为64。运动码本由256个条目组成,每个条目的码维度为64。时间窗口大小为100帧(4秒),多尺度级别为。在此阶段,我们使用AdamW优化器,学习率为1.0e - 4,总批量大小为64,并训练50000次迭代。在第二阶段,我们使用AdamW优化器训练多尺度自回归模型,学习率同样为1.0e - 4,批量大小为64,训练50000次迭代。在此阶段,我们采用预训练好的冻结的HuBERT(许等人,2021年)主干网络,不进行微调。
所有训练均在一块英伟达(NVIDIA)特斯拉(Tesla)A100图形处理器(GPU)上进行,总共大约需要13个GPU小时(第一阶段5小时,第二阶段8小时),这表明训练资源得到了有效利用。在推理阶段,我们的方法在英伟达特斯拉A100图形处理器上每秒仅需0.01秒即可生成动作,在苹果(Apple)M2 Pro芯片上则需0.057秒,展现出了较高的推理效率和较低的延迟。有关更多实现细节,请参考补充材料。
1. 定量结果
基于先前的研究(理查德(Richard)等人,2021年;范(Fan)等人,2022年;邢(Xing)等人,2023年;诺森蒂尼(Nocentini)等人,2024年;孙(Sun)等人,2024年),我们采用了两个量化指标,即嘴唇顶点误差(LVE,lip vertex error)(理查德等人,2021年)和上半脸动态偏差(FDD,upper face dynamic deviation)(邢等人,2023年),来评估生成的面部动作。LVE计算每一帧中所有嘴唇顶点的最大L2误差,评估预测的嘴唇位置与真实嘴唇位置之间的最大偏差。FDD计算预测结果与真实情况之间每个上半脸顶点随时间变化的运动标准差,评估上半脸运动的一致性,这与说话风格密切相关。此外,我们采用了与孙等人(2024年)类似的指标,即张嘴距离(MOD,mouth opening distance),以更准确地评估张嘴动作的风格相似性。MOD测量预测结果与真实情况之间张嘴区域的平均差异。与LVE相比,MMD更侧重于张嘴风格的相似性,并且对嘴唇的时间同步性不太敏感。对于嘴唇区域和上半脸的划分,我们使用了FLAME官方提供的掩码划分方法(李(Li)等人,2017年)。嘴唇区域包含254个点,而上半脸(包括眼睛区域和额头)包含884个点。
表2. 在TFHP(Sun等人,2024年)数据集上的定量结果。我们分别用颜色来表示第一名和第二名。表示该方法未在TFHP上进行训练,而其他所有方法均在TFHP上进行了训练或微调。
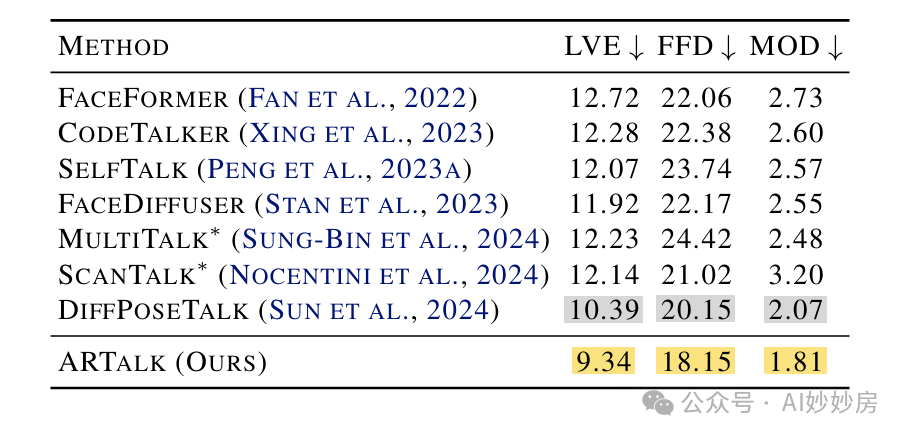
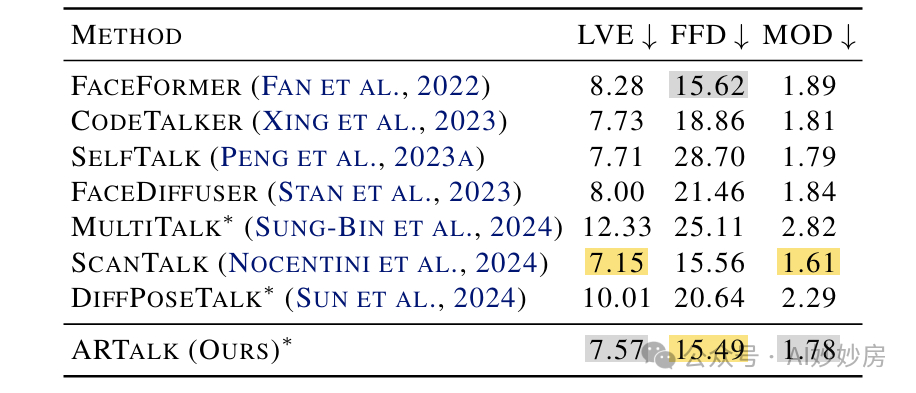
表3. 在VOCASET测试数据集(库代罗等人,2019年)上的定量结果。我们分别用颜色来表示第一名和第二名。表示该方法未在VO - CASET数据集上进行训练。值得注意的是,我们的方法未在VOCASET数据集上进行训练或微调。
我们在表2中展示了在TFHP数据集(Sun等人,2024年)上的定量比较结果。基线方法Face - Former(Fan等人,2022年)、CodeTalker(Xing等人,2023年)、SelfTalk(Peng等人,2023a)和FaceDiffuser(Stan等人,2023年)均为基于网格的方法,无法直接推广到任意风格或新的网格。为确保公平比较,我们在从TFHP数据集生成的网格上重新训练了这些方法。对于MultiTalk(Sung - Bin等人,2024年),它在FLAME网格上进行训练并支持基于语言的风格化,我们直接使用其英语风格进行评估。ScanTalk声称可在任意网格上工作,因此我们使用其官方提供的预训练权重。对于DiffPoseTalk,我们直接使用其在TFHP数据集(包括头部姿态)上的预训练权重进行评估。表2中的结果表明,我们的方法在唇同步精度(LVE)和风格对齐(FFD和MOD)方面取得了显著改进,这表明我们的方法不仅实现了精确的唇同步,还能有效捕捉个性化的说话风格。
为了证明我们方法的泛化能力,我们在VOCASET数据集(库戴罗(Cudeiro)等人,2019年)上对其进行了评估。结果如表3所示。值得注意的是,对于一些基线方法(范(Fan)等人,2022年;邢(Xing)等人,2023年;彭(Peng)等人,2023a;斯坦(Stan)等人,2023年;诺森蒂尼(Nocentini)等人,2024年),我们使用了它们在VOCASET上的预训练权重,而我们的方法并未在该数据集上进行训练或微调。尽管如此,我们的方法仍取得了极具竞争力的性能,并且优于大多数专门在该数据集上训练的基线方法。对于具有风格泛化能力的MultiTalk(成彬(Sung - Bin)等人,2024年)和DiffPoseTalk(孙(Sun)等人,2024年),我们采用了与我们方法相同的策略,即直接在VOCASET数据集上对其进行测试,而不进行任何额外的训练或微调。结果表明,我们的方法在泛化能力方面超越了它们,进一步验证了我们的方法在处理未见风格和数据时的鲁棒性。
我们还在图3中展示了潜在变量效率(LVE,Latent Variable Efficiency)和效率的比较。尽管我们的模型采用了两级自回归框架,但它仍然比完全自回归方法更高效。这种效率是通过使用更长的窗口长度,同时仅保留过去4秒的运动帧来实现的。此外,窗口内每个尺度的帧是并行生成的,这进一步提高了计算效率。
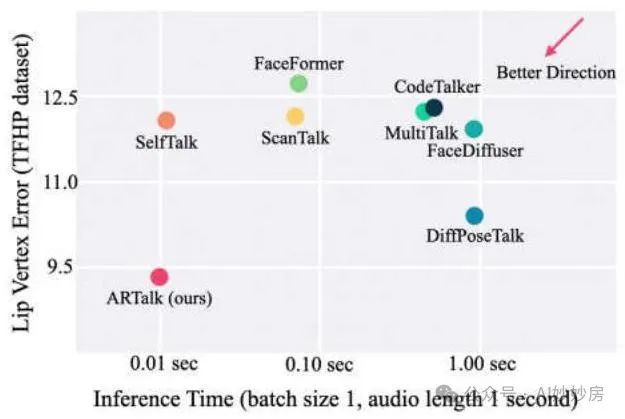
图3. 不同方法的运行时效率和性能比较。
2. 定性结果
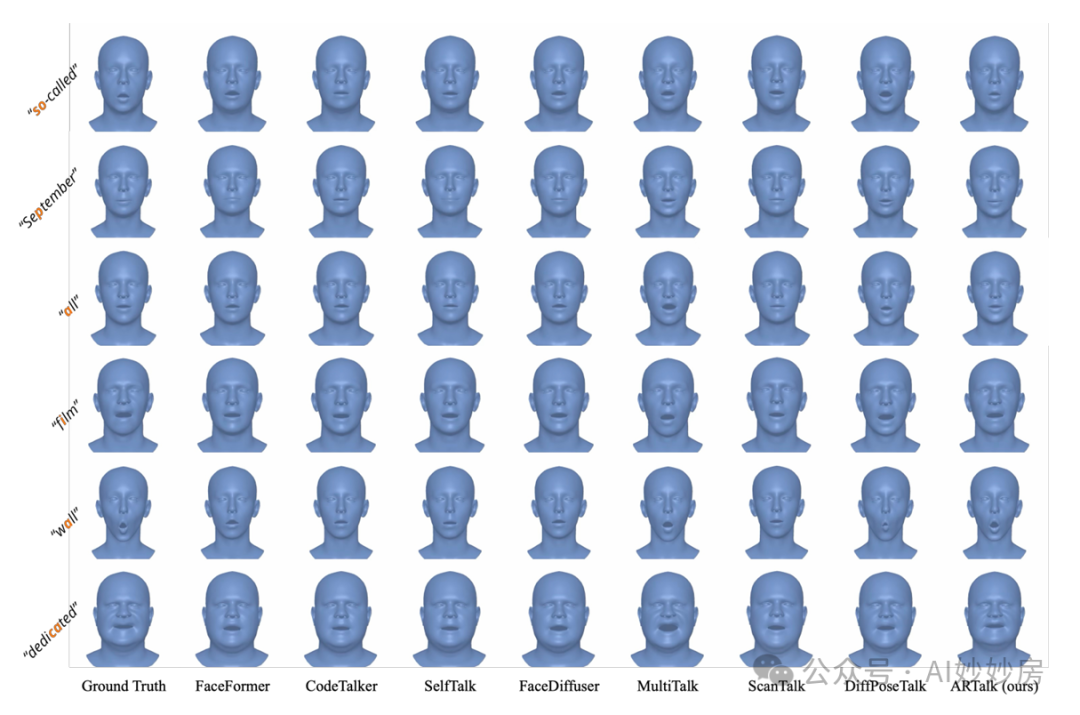
在图4中,我们展示了我们的方法与其他基线方法之间的定性比较。我们的方法展现出了出色的唇形同步效果,能够准确捕捉各种语音元素。此外,生成的结果呈现出逼真的面部表情和张嘴动作,与真实样本的风格非常匹配。值得注意的是,我们的方法还能生成逼真的眨眼和头部动作,这些都是在运动码本中隐式学习和编码的。更多定性评估结果可在补充视频中查看。
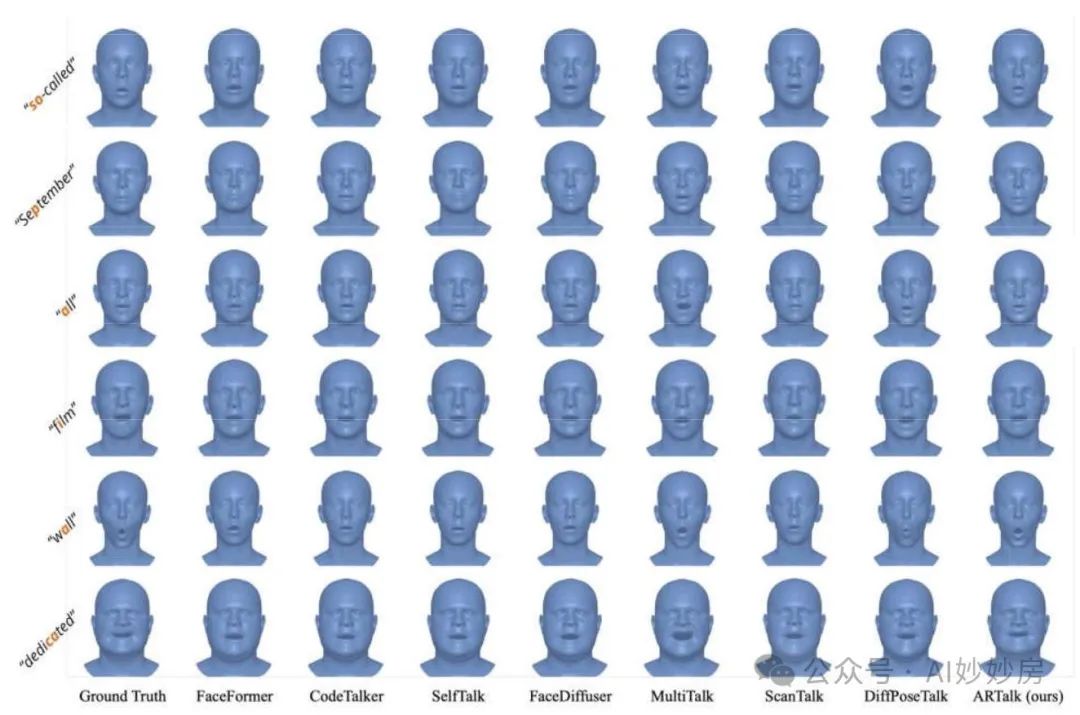
图4. 与现有方法的定性比较(所有头部姿态固定)。前四行来自TFHP数据集,最后两行来自VOCASET数据集。我们的方法在表情风格、嘴巴动态和唇形同步方面与真实样本的对齐效果更好。更多结果可在补充材料和演示视频中查看。
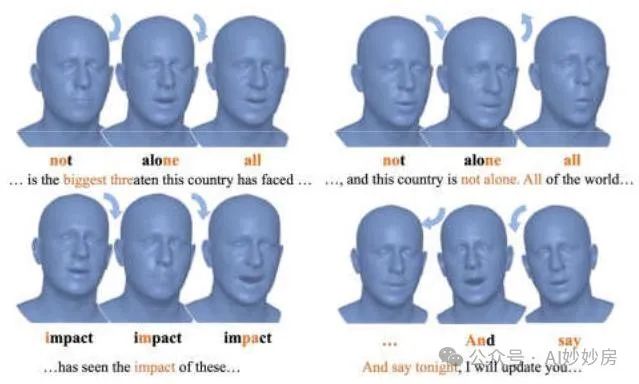
图5. 头部姿势的定性结果。当强调某些单词或出现重音时,模型会产生类似于人类行为的点头动作。此外,在不同讲话风格转换或句子停顿期间,头部会自然转动,反映出真实的对话动态。
3. 用户研究
用户研究是评估3D会说话头像的可靠方法。为了全面比较我们的方法与基线方法(范(Fan)等人,2022年;邢(Xing)等人,2023年;彭(Peng)等人,2023a;斯坦(Stan)等人,2023年;成彬(Sung - Bin)等人,2024年;诺琴蒂尼(No - centini)等人,2024年;孙(Sun)等人,2024年),我们开展了一项聚焦于四个关键指标的用户研究:唇形同步、面部表情自然度、风格一致性和头部姿态自然度。
鉴于头部运动能显著影响用户对唇形同步的评价,本研究分为两部分。在第一部分中,通过所有方法渲染头部姿势固定的视频,以评估唇形同步、面部表情的真实感和风格一致性。在第二部分中,渲染头部姿势动态的视频,以评估风格一致性和头部姿势的自然度。所有比较均采用两两比较的方式进行,将我们的方法生成的动作与一个竞争基线生成的动作并排展示,同时提供真实数据作为用户参考。观看视频后,用户根据主观偏好选择他们认为更好的动画。计算用户选择的比例以量化满意度。
表4. 用户研究结果。
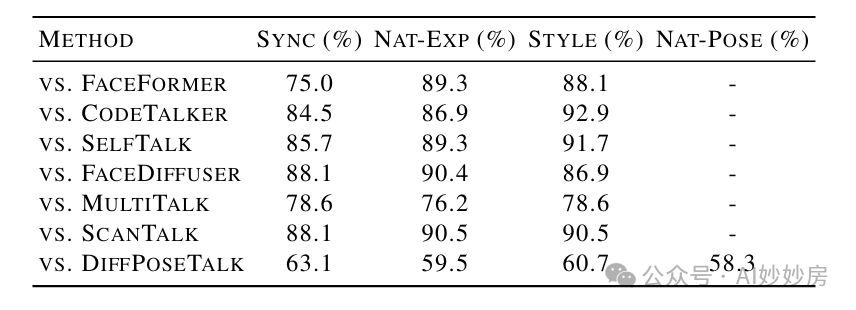
如表4所示,我们的方法在唇形同步、风格一致性和面部表情真实感方面显著优于基线方法。此外,与DiffPoseTalk(孙等人,2024年)相比,我们的方法在头部姿势自然度方面表现更优,显示出其全面优势。
4. 消融研究
表5. 在TFHP数据集上的消融实验结果。
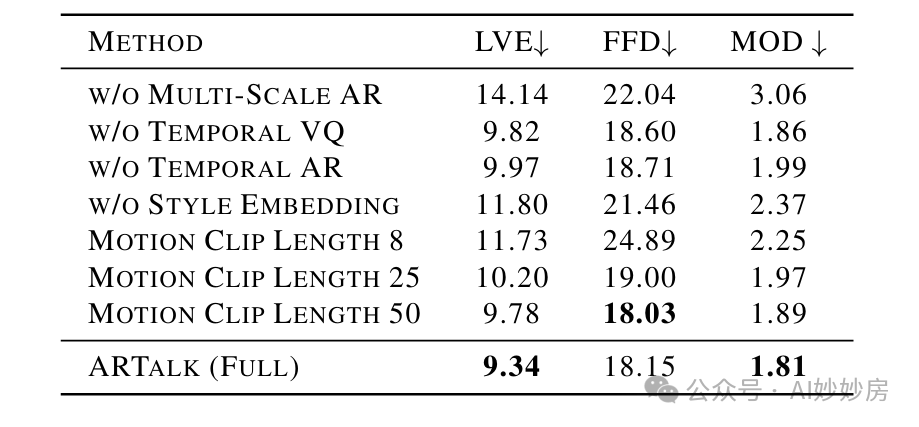
多尺度自回归。为了验证单个时间窗口内多尺度自回归建模的重要性,我们通过完全移除多尺度自回归机制进行了实验。表5中的结果表明,没有多尺度自回归时,生成准确率显著下降。我们将这种下降归因于在没有多尺度建模提供的分层结构的情况下,模型无法充分捕捉语音到动作映射的复杂细节。
时间编码器和时间自回归。为了评估跨时间窗口进行时间编码和自回归的必要性,我们分别用标准的多尺度编码器和单窗口多尺度自回归模型替换了我们提出的时间编码器和自回归模型。如表5所示,矢量量化(VQ)自编码器或自回归中缺乏时间建模都会导致生成质量下降。此外,我们还观察到动作序列中存在时间不连续性,这进一步强调了我们的时间设计在实现平滑连贯输出方面的关键作用。
说话人风格嵌入。我们还评估了去除说话人风格特征的影响,该特征是自回归过程的起始条件。如果没有这个特征,语音和动作之间多对多映射的复杂度会显著增加,并且生成的动作会缺乏个性化风格。如表5所示,去除风格特征会导致生成质量大幅下降,这凸显了它们在实现具有风格和表现力的输出方面的重要性。
关键超参数选择。我们探索了单个时间窗口内不同数量的运动帧,这对我们的方法至关重要。具体来说,我们测试了8帧、25帧和50帧的窗口长度。对于8帧的窗口长度,我们使用了的多尺度序列,而对于25帧和50帧的窗口长度,我们分别采用了[1,5,10,15,25]和[1,5,10,25,50]的序列。表5中呈现的结果表明,窗口大小的选择会显著影响性能。然而,窗口大小在很大程度上取决于下游任务的特性,例如输入是否由流式音频块组成。一般来说,较长的时间窗口通常会产生更好的结果。在本文中,我们选择了100帧的窗口长度和的多尺度序列,因为这与之前的工作(如DiffPoseTalk(孙等人,2024年))一致,并且在质量和效率之间取得了良好的平衡。
4 总结
在本文中,我们介绍了ARTalk,这是一种从语音生成3D面部和头部动作的新颖框架。我们方法的核心创新在于时间多尺度自动编码器和ARTalk自回归Transformer,它们共同确保了时间一致性和精确的动作生成。我们的实验结果表明,在唇形同步、表情自然度和风格一致性方面,ARTalk的表现优于现有最先进的基线方法,同时还保持了实时生成能力。我们相信,ARTalk强大的泛化能力使其成为一系列广泛应用的有前景的解决方案,这些应用包括虚拟化身、语言训练以及游戏和电影的动画制作。
局限性与未来工作。虽然ARTalk在唇形同步和表情方面表现出色,但目前的一个局限性在于,头部动作主要由语音韵律(节奏和重音)驱动,而非语义上下文。解决头部手势(如点头或摇头表示肯定)的文化和语义细微差别,需要更广泛、更多样化的数据集和细粒度的头部姿态控制,我们将此留作未来的工作。我们希望我们的工作为会说话的头部生成的进一步研究奠定坚实的基础。
 650


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


