让AI像人类一样思考:如何用数据喂养出 OpenAI o3 & o4-mini 的视觉大脑?

GPT-4o, GPT 4.5, GPT 4.1, O3, O4-mini等模型的区别与联系 OpenAI模型太多挑花眼?GPT-4o、GPT-4.5、O系列…区别联系全解析,开发者必看选型与性价比攻略!🚀💰 阅读详情

1. 基本介绍

北京时间2025年4月17日,OpenAI 发布了 o3 和 o4-mini 两个模型,再度引发强烈关注。

o3 是 OpenAI 目前最强推理模型,在编码、数学、科学、视觉感知等方面都有明显进步。o3 在 Codeforces 、SWE-bench 等基准测试中表现优异,适合复杂查询任务,在视觉任务中表现尤其出色。此外,与 o1 相比,o3 在完成现实任务中的错误率降低20%,能够在编程、商业/咨询和创意构思等领域提供重要帮助。

o4-mini 是一款体型更小的模型,专为快速、经济高效的推理做出了优化,同时保证了卓越的性能。o4-mini是在 AIME 2024和2025基准测试中表现最佳的模型,在非 STEM 任务以及数据科学等领域的表现也优于其前身 o3-mini。成本和性能共同使o4-mini成为解决推理问题的强大解决方案。

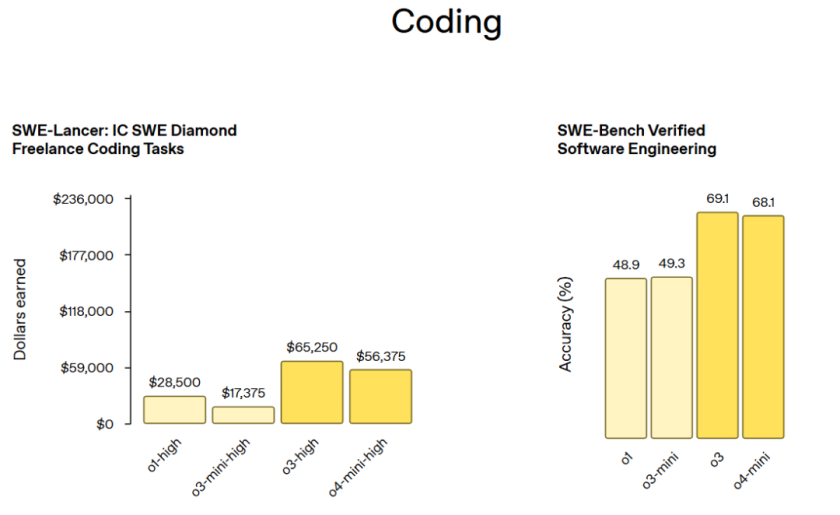
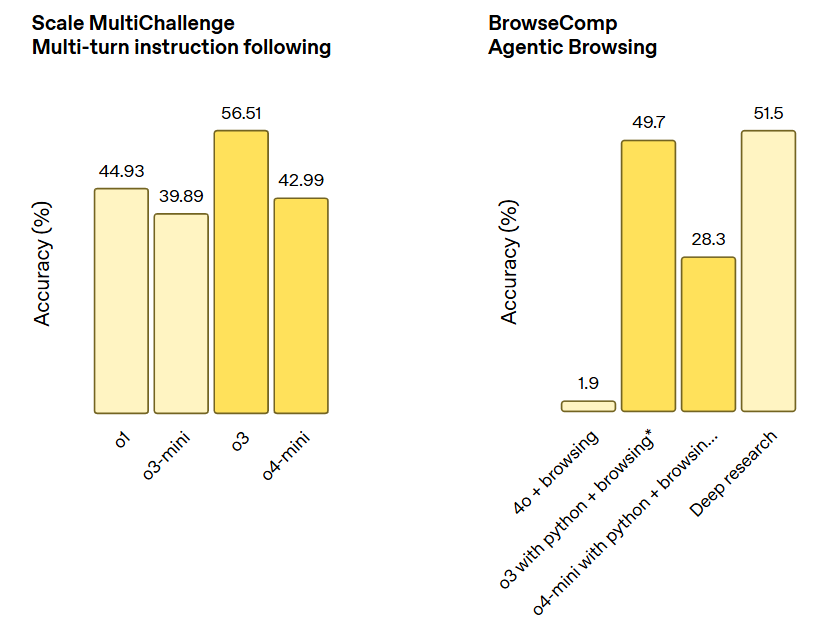
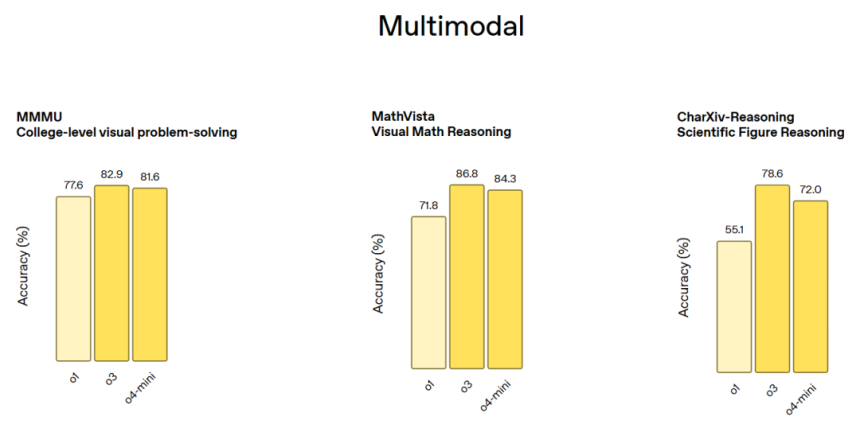
以下是 OpenAI o3 和 OpenAI o4-mini 在各类测试集上的表现(部分):
图片
多模态基准测试

图片
编程基准测试

图片
遵循指令并让智能体工具使用任务测试

更多详细评测结果请参考:https://openai.com/index/introducing-o3-and-o4-mini/

2. 技术原理:强化学习拓展模型多模态推理能力边界

在 o3 的开发过程中,OpenAI 观察到大规模强化学习呈现出与 GPT 系列预训练中相同的“计算量越大,性能越好”的趋势。据此,OpenAI 提高了强化学习中的训练计算量和推理时间,研究团队在训练计算量和推理时间方面都提升了一个数量级,并看到了明显的模型性能提升,这证明了模型的性能会随着思考时间的增加而持续提升。

此外,OpenAI 还发现可以通过强化学习训练模型多模态推理能力。模型通过强化学习,不仅学会了如何使用工具,还学会了推理何时使用工具。o3 和 o4-mini 能够根据期望结果部署工具,这使得它们在多模态推理场景中表现更佳,尤其是在涉及视觉推理和多步骤工作流程的情况下。根据早期测试人员的报告,这种进步在学术基准测试和实际任务中均有体现。

3. 关键进展:工具调用和视觉推理能力大幅提升

3.1. 工具调用

OpenAI o3 和 o4-mini 可以访问 ChatGPT 中的工具,并能通过 API 中的函数调用访问用户自定义的工具。这些模型经过训练,能够推理解决问题的方法,自行决定何时及如何使用工具,并以正确的输出格式快速生成详细周到的答案,通常在不到一分钟内完成。

例如,对于“加州夏季的能源使用量与去年相比如何”的问题,o3 模型可搜索网络公共事业数据,编写 Python 代码预测,生成图表或图像,并解释预测的关键因素,还能在需要时多次搜索网络,尝试新搜索以获取更多信息。

3.2. 视觉推理

OpenAI o3 模型首次将图像直接整合到思维链中,不仅能看图,还能用图思考,开启了融合视觉和文本推理的全新问题解决方式,在多模态基准测试中表现顶尖。

视觉推理能力的基础是强大的自主工具调用能力。例如,用户上传的白板照片、教科书图表或手绘草图,即使模糊、反转或质量低下,模型也能解读并借助工具动态操作图像,如旋转、缩放或变换等,实现了视觉感知任务的一流准确率。

图片
OpenAI 官网的视觉推理效果展示

3.3. 应用价值

o3 / o4-mini 通过工具调用与以此为基础诞生的视觉推理两大能力,展示了多模态推理在各类应用场景中的价值,激活了从技术探索到规模化落地的需求拐点。

  • 教育领域:学生上传手写解题步骤照片→模型识别笔迹→调用符号计算工具验证推导过程→生成讲解
  • 金融领域:输入财报图表→模型提取关键指标→调用经济预测模型→生成投资建议
  • 科研领域:实验观测图像→关联论文数据库→调用数值模拟工具→输出假设验证结论

4. 整数洞察:多模态推理类数据助力模型性能提升,整数智能打造数据解决方案

4.1. 多模态推理数据如何提升模型性能

本次 o3 与 o4-mini 的发布,让人深刻感受到强化学习在多模态推理方面的巨大探索空间。

强化学习通过智能体在环境中的试错学习最优策略以最大化累积奖励。高质量的多模态推理数据是强化学习在该领域取得成功的关键。

为此,整数智能提供了庞大的多模态推理成品数据集,能够最大程度上解决多模态推理数据不足的痛点;不仅如此,整数智能还拥有完善的数据采集体系, 极致效率的智能数据工程平台和大量高质量数据标注员,能够快速满足客户各类个性化数据需求;此外,由整数智能发起并资助的2077AI 基金会制作并开源了多个高质量推理类数据集,为前沿学术研究和模型训练做出贡献。

4.2. 整数智能提供多模态推理数据库

4.2.1. 多模态语义标注数据

通过对多模态数据施加更高层次的语义注释,包括详尽的 describe 描述与深入的 thought 思考,可以更全面地挖掘图像中丰富的特征与纹理信息,从而显著增强跨模态模型的理解能力和任务性能。整数智能拥有百万量级的图片和视频等多模态高质量数据集,这些数据集包含丰富的语义标注信息,可用于多模态语义推理、视觉推理等任务。

视频样例

{"question": "橙子在最终画面中的位置最接近哪个位置?\nA. 画面左侧\nB. 画面中央\nC. 画面右侧\nD. 画面下方\n", "answer": "A", "category": "对象定位", "diffculty": "简单"}{"question": "画面的水果总共有几个?\nA. 1个\nB. 3个\nC. 4个\nD. 2个\n", "answer": "B", "category": "对象计数", "diffculty": "普通"}{"question": "画面中苹果的相对位置在哪里?(最终画面)\nA. 橙子的左侧\nB. 梨的右侧\nC. 橙子和梨之间\nD. 橙子的上方\n", "answer": "C", "category": "空间关系", "diffculty": "普通"}

4.2.2. Agent 相关数据

记录用户指令、多模态输入、工具调用决策及输出结果的全流程数据,对于训练 Agent动态选择工具并验证结果合理性至关重要,极大助力其发展。整数智能自主研发的采集工具,可以高效记录用户指令,环境状态,任务轨迹等关键信息,并输出为 JSON 格式的数据,全面满足您的 Agent 数据集需求。具体样例即将在后续的 Agent 数据专题中进行展示。

  • 高质量:自研 Agent 数据集构造采集工具,可直接接入整数智能的智能数据工程平台,实现涵盖标注、审核等一体化流程,确保数据的高质量交付。
  • 高效率:整数智能配备了专业的 Agent 相关生产标注团队,团队全员由海内外名校硕博研究人员组成,实现数据生产从源头提效。

4.2.3. 多模态知识推理数据

多模态知识推理数据主要以带图长链推理习题为表现形式,其构建和应用常结合论文、教材、课件等专业领域知识,将这些知识与图片内容深度融合,驱动模型在科研、教育等场景完成知识密集型推理。整数智能拥有各教育阶段(k12、本科、研究生、公考、资格考),各难度级别(校内、竞赛),各类学科(数学、计算机、物理、化学)的多模态习题,总数超过千万量级;此外,整数智能还拥有代码(coding)类题目,字段包含完整的题干,答案和 Test Cases 等;整数智能所有习题数据均经过人工和模型双重校验和清洗,重复率低于1%,准确率达到95%以上。

{  "id": 317489,   "analysis": "Improper Integrals:\nAn improper integral is like a definite integral, except that one (or both) of the bounds of integration could be infinite, or the integrated could be undefined for some value in the interval. In all cases, an improper integral must be rewritten with a limit in order to hide the infinite bound of integration or the infinite discontinuity. For example, {eq}\\displaystyle\\int_a^\\infty f(x) dx = \\lim_{t\\to \\infty}\\int_a^t f(x)dx {/eq}. Then the definite integral is evaluated using standard antiderivative techniques, and then the limit is evaluated. If the limit exists as a finite number, we say the integral converges. Otherwise, it diverges.",  "answer": "In general, to find the area of a shaded region on a graph, we would need to evaluate a definite integral. This shaded region starts at {eq}x = 2 {/eq} but extends infinitely to the right. This means we need to evaluate the improper integral {eq}\\displaystyle\\int_2^\\infty \\dfrac{3}{(x-1)^{3/2}} \\ dx {/eq}.\nFirst, rewrite the improper integral with a limit. It may also help to rewrite with a negative exponent.\n{eq}\\begin{align} \\int_2^\\infty \\dfrac{3}{(x-1)^{3/2}} \\ dx {} & = \\lim_{t\\to\\infty}\\int_2^t\\dfrac{3}{(x-1)^{3/2}} \\ dx\\\\ \\\\ & = \\lim_{t\\to\\infty}\\int_2^t 3(x-1)^{-3/2}\\ dx \\end{align} {/eq}\nThis antiderivative can be evaluated using u-substitution with {eq}u = x - 1 {/eq} and {eq}du = dx {/eq}.\nEvaluating just the antiderivative {eq}\\displaystyle\\int 3(x-1)^{-3/2} \\ dx = \\int_3u^{-3/2} \\ du {/eq} using the power rule, we have:\n{eq}\\begin{align} \\int_3u^{-3/2}du {}& = \\dfrac{3}{-1/2} u^{-1/2} + C\\\\ \\\\ & = -6u^{-1/2} + C\\\\ \\\\ & = -\\dfrac{6}{u^{1/2}} + C\\\\ \\\\ & = -\\dfrac{6}{(x-1)^{1/2}} + C \\end{align} {/eq}\nThen, going back to our improper integral and using this antiderivative, we have:\n{eq}\\begin{align} \\lim_{t\\to\\infty}\\int_2^t 3(x-1)^{-3/2}\\ dx {}& = \\lim_{t\\to\\infty} - \\dfrac{6}{(x-1)^{1/2}} \\bigg|_2^t\\\\ \\\\ & = \\lim_{t\\to\\infty}\\left( -\\dfrac{6}{(t-1)^{1/2}} + \\dfrac{6}{(2-1)^{1/2}}\\right)\\\\ \\\\ & = \\lim_{t\\to\\infty}\\left(-\\dfrac{6}{(t-1)^{1/2}} + 6\\right)\\\\ \\\\ & = 0 + 6\\\\ \\\\ & = 6 \\end{align} {/eq}\nTherefore, the area of the shaded region is {eq}6 {/eq}.",  "subject": "Math",  "grade": "college",  "qtype": "Short Answer",   "imgs": "{\"img0000\": \"imgs/317489_img0000.png\"}",   "question": "Compute the size of the highlighted portion, if relevant. (If a solution is unavailable, reply with DNE.)"}

image.png
Json 样例配图

4.2.4. 多模态逻辑推理数据

多模态逻辑推理通常指模型以逻辑思维能力为核心,在较少依赖真实世界的专业学科知识的情况下,完成图片类的逻辑推理任务。这类数据以公务员行测考试,数独,智力评估题为代表。整数智能拥有总量超过五百万的图片推理类数据,拥有完整的题干,图片,答案,解析等信息,以 JSON 格式储存;可根据具体需求进行格式调整或定制化采集服务。

    {        "id": 44991638,        "contents": "<p>请从四个选项中选出最恰当的一项填入问号处,使题干图形呈现一定的规律性。<br/><img src=\"0b41135ade85418b2f952c3b79e9f058.png\"></p>",        "grade_class": "\"对称性\",\"轴对称\",\"整体轴对称\",\"轴对称图形\"",        "type_text": "单选题",        "answer": "D",        "parse": "<p>第一步,观察特征。<br/>组成元素不同,优先考虑数量类或属性类,图形对称特征明显,优先考虑对称性。<br/>第二步,九宫格,横向规律较为常见,优先考虑。<br/>第一行找规律,图一为只有一条对称轴的轴对称图形,图二为中心对称图形,图三既是轴对称图形又是中心对称图形,有两条对称轴;第二行验证规律,符合;第三行应用规律,只有D项符合。<br/>因此,选择D选项。</p>",        "images": ["0b41135ade85418b2f952c3b79e9f058.png"],          }

0b41135ade85418b2f952c3b79e9f058.png
Json 题目样例配图

4.3. 极致效率的整数智能数据工程平台

image.png
数据构建的极致提效

智能数据工程平台集成了 N+大模型,辅以高效的编辑工具,无需特定模型或训练,轻松完成任何场景、任何数据的智能标注。

未来大模型的产品竞争里,算法是一方面,构建高效的数据闭环,是大模型产品研发的核心竞争力。构建这样的系统,就能加速产品的升级和迭代速度。

4.4. 整数助力2077AI推出多个高质量开源数据集

2077AI Community 是一个致力于推动人工智能数据行业规范开源发展的非营利组织,其核心目标是提供高质量、关键性的数据集,以支持人工智能前沿领域的研究与开发,加速整个人工智能时代的新发展。

  • 开源资源为开发者提供三重助力:中小模型训练「启动燃料」→ 算法优化「基准坐标系」→ 学术研究「共享知识池」
  • 当前生态仍受限于 → 数据规模阈值 → 领域穿透深度
  • 我们构建智能数据工程平台闭环服务,通过多模态架构重组与认知密度优化,为高阶模型进化提供原子级赋能

4.4.1. COIG-P:高质量大规模中文偏好数据集,与人类价值观对齐

下载链接:http://huggingface.co/papers/2504.05535

在将大模型与人类偏好对齐方面已取得显著进展,然而现有的中文偏好数据集仍面临规模较小、领域覆盖狭窄以及缺乏严谨数据验证的问题。我们严格筛选了 9.2 万条高质量中文查询,随后选用 15 款主流 LLM 生成并评分“选中—拒绝”回答对。在此基础上,推出了 COIG‑P(Chinese Open Instruction Generalist – Preference),这是一个高质量、大规模的中文偏好数据集,共包含 100.9 万条偏好对,覆盖聊天(Chat)、代码(Code)、数学(Math)、逻辑(Logic)、小说(Novel)和角色扮演(Role)六大领域。

4.4.2. SuperGPQA:在 285 个研究生学科中扩展LLM评估 

下载链接:https://huggingface.co/papers/2502.14739

大模型在数学、物理和计算机科学等主流学科中表现出色。然而,人类知识涵盖超过200个专业学科,远远超出了现有基准测试的范围。 LLMs 在许多专业领域(尤其是在轻工业、农业和服务导向学科)的能力尚未得到充分评估。为了填补这一空白,我们提出了 SuperGPQA ,这是一个涵盖285个学科的研究生水平知识和推理能力的综合基准测试。

4.4.3. PIN:一对多和交错多模态文档的知识密集型数据集

下载链接:https://huggingface.co/papers/2406.13923

PIN 格式基于三个基本原则:知识密集性、可扩展性和对多样化训练模态的支持。这种创新格式结合了 Markdown 文件和丰富的图像,通过密集的知识结构和灵活的训练策略丰富了训练数据。我们推出了 PIN-14M ,这是一个包含1,400万样本的开源数据集,涵盖了多种中文和英文来源,专门包括复杂的网络和科学内容。

5. 结语

o3 与 o4-mini 的发布,不仅展示了多模态推理的技术高度,更揭示了数据生态的关键作用。未来,工具交互、3D场景、垂直领域知识等多模态推理类数据将成为AI进化的新燃料。企业与研究机构需提前布局高价值数据资源的采集与标注,以抢占多模态智能时代的先机。

整数智能作为AI领域的数据合伙人,愿意与大模型公司共同推动下一代多模态推理模型的到来。

参考链接:

https://openai.com/index/introducing-o3-and-o4-mini/

https://cdn.openai.com/pdf/2221c875-02dc-4789-800b-e7758f3722c1/o3-and-o4-mini-system-card.pdf

https://arxiv.org/abs/2503.14504

https://www.2077ai.com/resources/paper


整数智能,人工智能行业的数据合伙人。
 

GPT-5.4 mini如何重塑AI开发工作流架构 大模型在软件开发中的落地,正从单体智能向分层协同演进。其核心在于理解‘开发工作流’这一工程化概念——即需求输入、任务分解、工具调用、代码生成、测试验证到部署反馈的完整闭环。GPT-5.4 mini并非轻量版主模型,而是专为执行层设计的轻量级执行单元(LEU),具备毫秒级响应、高并发调度与确定性输出能力,显著提升Terminal-Bench和Toolathlon等工具链相关任务的准确率。它通过与规划层(GPT-5.4)协同,实现‘战略大脑+战术尖兵’的异构分工,在VS Code、Codex CLI等真实场景中 阅读详情

相关推荐

脑机接口与大语言模型的双轨协同:湿实验室与干实验室融合实践

脑机接口(BCI)和大语言模型(LLM)是当前人工智能演进的两大基础范式,分别对应生物神经信号采集与高维语义建模。其底层原理均涉及信息编码、解码与跨模态映射:BCI将神经脉冲序列转化为意图指令,LLM则将文本序列建模为概率分布。技术价值在于突破单一路径局限——BCI提供低延迟、高保真意图源,LLM赋予语义丰容与上下文推理能力。典型应用场景包括瘫痪患者意念通信、实时神经反馈增强学习及合成脑电数据生成。本文聚焦二者在工程层的可集成性,系统解析神经解码与语言生成之间的协议栈对齐、低延迟协同与伦理约束机制。

weixin_33892359的博客 432

ChatGPT版本大乱斗:o3、4o、o4-mini,哪个才是你的菜?

嘿,朋友们!如果你最近打开ChatGPT,感觉像是走进了一个AI型号的“迷宫”,别慌!今天咱就来聊聊OpenAI的这些花式型号:o3、4o、o4-mini,还有那传说中的GPT-4.5,到底谁才是你的最佳AI小助手?借着大神Andrej Karpathy的“使用攻略”,我来给你整一篇幽默又实用的科普,包你看完不迷路!

大模型教程的博客 8541

基于LlamaIndex构建企业级AI文本生成系统:从检索增强生成到智能体应用

检索增强生成(RAG)是当前解决大语言模型知识局限性和幻觉问题的关键技术范式。其核心原理是通过将外部知识库向量化存储,在用户查询时进行语义检索,并将检索到的相关上下文与大模型结合,从而生成准确、可追溯的答案。这一技术显著提升了AI系统在专业领域的可靠性和实用性,尤其适用于企业知识库问答、智能客服和文档分析等场景。LlamaIndex作为RAG领域的优秀框架,提供了从文档加载、向量化索引到智能检索与合成的完整工具链,并支持通过智能体实现多步推理和工具调用,使得开发者能够高效构建基于私有数据的可控文本生成应用。

weixin_34289454的博客 387

OpenAI 王炸 o3/o4-mini,打通自主工具+视觉思考。

总而言之,o3 和 o4-mini 的发布,标志着 OpenAI 在模型智能和 Agent 能力上的又一次重要迭代,特别是赋予了 AI 灵活组合使用多种工具和“带着图像思考”的能力。根据社区反馈,实际限制可能如下: 使用 ChatGPT Plus、团队或企业帐户,您每周可以使用 o3 访问 50 条消息,每天可以使用 o4-mini 访问 150 条消息,每天可以使用 o4-mini-high 访问 50 条消息。因为效率高,o4-mini 的调用额度比 o3 高得多,适合需要大量推理的高并发场景。

lythinking的博客 1267

LLM工程化落地的四条硬核路径:本地优先、Agent架构、高效微调与多模态抽象

大语言模型(LLM)开发已从API调用阶段迈入工程化落地深水区。理解其本质需回归‘模型即服务组件’的技术定位:推理部署需权衡本地化确定性与云服务弹性,业务逻辑复杂度突破阈值后提示工程必然让位于可控的Agent状态机,微调效能的关键不在数据规模而在信号密度与意图建模,而多模态能力普及正倒逼接口层从技术协议升级为意图协议(如MCP)。这些趋势共同指向一个现实——LLM应用成败,越来越取决于数据管道、工具契约与抽象分层等基础设施能力。本文基于100+真实交付项目,聚焦本地推理选型、Agent状态路由、LoRA参数

com_xpp的专栏 681

国税局发票查验中英文验证码识别最新版,识别率99.9%

采用深度学习进行发票查验验证码模型的训练,在我电脑上模型训练的环境如下: 显卡:RTX 2080TI tensorflow-gpu:2.5.3 1 训练集和测试集的准备 发票查验的验证码分为4种类型,分别为黑色、红色、黄色、蓝色,经过我的测试,采用4个模型的效果最好,每个模型对应识别一种类型的验证码。 首先我们4种类型的验证码都准备10万张。 00黑色类型的验证码: 01红色类型的验证码: 02黄色类型的验证码: 03蓝色类型的验证码: 验证码图像图像准备好后,对其进行标记,也就是对验证码重命名:

Keras深度学习 83万+

OpenAI 推出一对 AI 推理模型 o3 和 o4-mini

更值得一提的是,o3 和 o4-mini 成为 OpenAI 首批能够“以图思考”的模型——用户可以在对话中上传白板草图或 PDF 中的示意图,模型会在“思考链”阶段对图像进行分析,再给出回答。Sam Altman 也暗示,o3 与 o4-mini 可能是 GPT-5 正式发布前,最后一批以“独立推理模型”形式亮相的产品——GPT-5 将融合传统 GPT-4 系列与推理模型的优势,带来更统一的大模型体验。而 o4-mini 则与 o3-mini 保持一致,提供,无需担心网络和地区限制,体验与官方一致。

Him__的博客 1468

海思SD3403/SS928开发(二)环境搭建:从零到一构建高效开发环境的实战指南

本文详细介绍了海思SD3403/SS928开发板环境搭建的全流程,包括Ubuntu系统选择、基础配置、开发环境依赖安装、SDK工具链配置等关键步骤。通过实战经验分享,帮助开发者避免常见问题,快速构建高效开发环境,提升开发效率。

weixin_28717683的博客 286

【读点论文】PIN: A Knowledge-Intensive Dataset for Paired and Interleaved Multimodal Doc...逐渐有标准去构建基础工程

此外,我们有能力支持更多样化的训练策略,例如基于图像的知识提取。对于预先存在的多模态数据集(如 OBELICS 和 MMC4 ),我们通过直接处理为每个文档生成一个“整体图像”,并将原始的基于文本的列表结构转换为统一的交错 markdown 格式。鉴于我们的数据集来源多样,且涉及的流程复杂,我们数据集中的每个样本都附有许可证字段,其中指定了数据的许可条款。此外,我们从纯文本的 markdown 文件过渡到带有内容图像的交错格式,并提供“整体图像”,重新捕获 NOUGAT 数据集构建中丢失的多模态信息。

白水空空 1587

MATLAB功率谱函数psd与pwelch的使用

在网上看到 clear; Fs=1000; n=0:1/Fs:1; y=cos(2*pi*40*n)+3*cos(2*pi*100*n)+randn(size(n)); Nfft=1000; window=hanning(100); noverlap=20; dflag='none'; [Pxx,f]=psd(y,Nfft,Fs,window,noverlap); figure plot(f,10*log10(Pxx)); xlabel('frequency/Hz');ylab

qq_41687938的博客 2万+

EnlightenGAN训练复现记录

记录EnlightenGAN过程中的问题和解决方式。提示:以下是本篇文章正文内容,下面案例可供参考。

L_27N113E的博客 3849

AI Agent操作计算机:从Mac mini采购看智能体训练与工程实践

人工智能正从文本生成走向真实世界的自动化操作,AI Agent(智能体)作为大模型的核心应用形态,正在改变人与软件的交互方式。智能体要操作计算机,需要具备视觉理解、屏幕识别、动作决策与反馈闭环等基础能力,这与传统RPA的固定流程有着本质区别。训练此类智能体依赖海量真实操作系统交互数据,因此头部企业会采购大批Mac mini等统一硬件环境,用于搭建数据采集与模型训练的基础设施。理解观察-决策-动作-反馈的闭环原理,掌握任务完成率等评估指标,并借鉴Harness Engineering的工程约束理念,是开发者切

weixin_34239592的博客 438

基于RK3562J开发板的MCP2518FD CAN-FD控制器驱动适配与测试指南

本文详细介绍了在RK3562J开发板上适配MCP2518FD CAN-FD控制器驱动的完整流程。内容涵盖内核驱动配置、设备树修改、编译烧录以及实际通信测试,重点分享了调试方法,旨在帮助开发者快速为嵌入式系统扩展高速CAN-FD通信能力,适用于汽车电子、工业控制等场景。

jenkins8butler的博客 496

普通人也能做的多模态AI助手:从冰箱照片到微信采购清单

多模态AI助手是指能同时理解图像、语音、文本等多类型输入的智能系统,其核心在于感知层与执行层的协同设计,而非依赖单一超大模型。通过视觉编码、语音转写、结构化抽取与任务规划等模块分工,可显著提升日常任务完成率与隐私安全性。这类助手的技术价值体现在低门槛部署、本地化运行和个性化记忆能力,典型应用场景包括家庭库存管理、个人知识库问答、生活事务自动化等。本文聚焦非技术用户如何基于Qwen2.5与Phi-3.5-vision构建真正可用的Agentic多模态助手,覆盖从脏图清洗、原子化任务规划到微信自动化集成的完整链

weixin_33802505的博客 358

CATIA CAA开发环境搭建避坑指南:从授权服务到VS配置全流程

本文提供了一份详尽的CATIA CAA开发环境搭建避坑指南,涵盖从授权服务(DSLS)安装、Visual Studio版本匹配与集成配置,到编译调试全流程。重点解析了授权服务无法连接、模块加载失败等典型问题的解决方案,强调版本严格对应与纯英文环境是成功搭建的关键。

redis7keeper的博客 575

向华为学习——IPD流程体系之IPD术语

《IPD体系核心概念与业务术语解析》摘要: IPD(集成产品开发)是一种以市场为导向的结构化产品开发管理模式,通过跨部门协作、异步开发、CBB(通用构建模块)和管道管理等手段,实现产品全生命周期高效管理。体系包含七大核心要素:跨部门团队(如IPMT决策层、PDT执行层)、结构化流程(分阶段评审)、端到端项目管理(WBS分级计划)、客户需求分析、投资组合优化及质量管控(TR技术评审)。各业务领域术语涵盖财务(NPV、IRR)、开发(需求分解、基线化)、制造(可制造性设计)、采购(Sourcing团队)及市场(

cdfunlove的博客 483

大模型数据枯竭危机:从信息熵衰减到世界模型破局

大模型训练依赖的高质量人类数据正面临物理性耗尽,其本质是有效数据的信息熵密度加速衰减,而非原始数据量不足。这一现象已引发数据燃烧率上升、模型崩溃加速、合成数据毒性放大等工程现实问题。技术价值在于推动AI从统计拟合转向可验证推理,催生数据血缘追踪、认知蒸馏、领域知识约束等新型数据治理范式。典型应用场景覆盖医疗、法律、工业质检等高可靠性需求领域,尤其适用于需强事实性、低幻觉、可审计的AI系统构建。本文聚焦数据枯竭的量化验证与一线可落地的四层突围路径。

chubaisheng8627的博客 481

深度学习中常用的几种卷积(下篇):膨胀卷积、可分离卷积(深度可分离、空间可分离)、分组卷积(附Pytorch测试代码)

膨胀卷积也称为扩张卷积或空洞卷积,一般可通过对标准二维卷积的卷积核设置合适的膨胀率(具体地指卷积核元素之间的距离)实现。合理利用膨胀卷积可在不引入其他参数的同时,扩大输出中元素的感受野,提高特征的全局表示能力。下面通过展示几个不同膨胀率下的卷积核大小以及感受野变化情况,可以更直观的理解:图中灰色为输入,蓝色为卷积核,黄色为输出。1)dilation=1:表示卷积核元素之间距离为1,使用0进行大小为dilation-1=0的填充(这是默认情况),因此。

NorthSmile的博客 9018

AI模型选型实战指南:10个已落地的生产级模型深度解析

AI模型选型不是比参数、看榜单,而是面向真实业务场景的技术决策。从轻量端侧推理到长文本理解、可控图像生成、多模态交互与小样本适配,核心在于模型的工程化能力、硬件亲和力与场景穿透力。本文聚焦2024年仍在保持技术代差优势的10个生产级模型,覆盖Llama、Qwen、Claude、Stable Diffusion、Flux、Gemini等主流选择,结合实测吞吐量、首token延迟、P95稳定性等硬指标,揭示其在医疗、制造、教育、法律等垂直领域的落地条件与典型陷阱。不讲理论上限,只谈工程下限——这才是企业AI项目

dengwan3818的博客 594

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

本地部署个人AI智能体:从Ollama到Open WebUI的完整实践指南

大语言模型(LLM)通过模拟人类语言模式,实现了自然语言理解与生成。其核心原理基于Transformer架构,通过海量数据预训练和微调,使模型具备强大的上下文学习和推理能力。这一技术价值在于将通用AI能力从云端下沉至本地,为隐私保护、个性化定制和离线可用性提供了基础。在应用场景上,本地化部署的AI智能体正成为个人知识管理、自动化工作流和隐私敏感型任务的重要工具。通过结合向量数据库实现长期记忆,并利用开源框架进行系统集成,常驻个人AI智能体能够基于本地硬件(如配备8GB显存的消费级GPU)持续运行,理解用户习

weixin_34198762的博客 407

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

AI Agent落地难?揭秘能做事的Agent三大核心基建

AI Agent并非升级版聊天机器人,而是具备目标分解、工具调度与状态管理能力的数字员工。其技术本质是融合推理模型、可信工具链与结构化状态协议的系统工程。区别于传统LLM的生成开环,Agent需在开放世界中完成决策闭环,依赖因果推理、意图建模与反事实验证等能力。当前落地瓶颈不在模型参数大小,而在工具调用的语义鸿沟、状态管理的时效缺失与执行过程的可信审计。真正可部署的Agentic RAG已从单点检索进化为感知-推理-执行三层协同架构,强调数据包语义标注、多跳逻辑链与状态机驱动的人类认知模拟。本文聚焦AI-A

weixin_30756499的博客 335

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

AI日报系统:轻量级信息聚合流水线设计与实践

信息聚合是知识工作者应对信息过载的基础能力,其核心在于结构化采集、语义清洗、事实提取、可控摘要与人工闭环校验。不同于端到端大模型方案,本文聚焦可审计、可调试、可交接的分层流水线设计,强调确定性模块对信源噪声、结构噪声与语义噪声的逐级治理。技术选型上优先轻量模型(如T5-small)、规则引擎与本地化工具链(Playwright+BeautifulSoup+Flask+Git),兼顾精度、速度与工程鲁棒性。典型应用场景包括技术动态追踪、竞品监测与个人知识基线构建,适用于内容运营、研发管理与独立研究者。关键词涵

weixin_34221773的博客 330

Whisper+PaLM双引擎AI语音助教:打造实时发音纠错语言教学系统

语音助手在语言教学中的核心价值,远不止于语音转文字或对话生成,而在于实现‘听音辨错—精准反馈—即时训练’的闭环。其技术基础是语音信号处理(ASR)与语言理解(LLM)的协同优化:Whisper提供高时序精度的音素级对齐能力,PaLM则依托教育微调模型输出符合二语习得规律的教学策略。这种分离式双引擎架构兼顾实时性(RTF<0.8)、诊断颗粒度(单音素偏差识别)与教学适配性(i+1原则、最小对立对生成),适用于中小学口语课堂、成人自学及备考场景。本文即围绕该架构的本地化部署、提示词工程与真实教学验证展开。

weixin_33778544的博客 589

M2.7是开源模型吗?商用授权与强制标注背后的AI服务本质

开源模型的核心在于技术主权可移交,而非仅代码可见或命名似开源。从原理看,真正的开源需满足运行、学习、分发、改进四大自由,而商用API服务(如MiniMax M2.7)仅提供受限的调用权,缺失权重开放、离线部署、协议透明等关键要素。其技术价值体现为开箱即用与快速集成,但代价是输出强制标注、数据回传、逆向限制与审计穿透等法律约束。典型应用场景包括智能客服、合同摘要与金融研报生成,但在需私有化、强合规、低延迟或内容可控的工程实践中面临显著风险。本文聚焦M2.7系列所引发的‘准开源’认知冲突,深入剖析商用授权、强制

weixin_30629653的博客 381

DeepSeek-R1-671B大模型满血版私有化部署高可用教程-SparkAi系统集成图文教程

SparkAi创作系统是一款基于OpenAI-ChatGPT、AI大模型、AI智能体(自定义GPTs智能体对接)、AI绘画Midjourney、Dalle绘画开发的AI大模型智能问答和AI绘画系统;支持最新DeepSeek思考推理大模型(独家全天稳定高并发高可用!),支持deepseek-r1-671B满血版,最新deepseek-v3大模型,OpenAI-o1、o3推理大模型使用;一站式AI系统,提供面向个人用户 (ToC)、开发者 (ToD) 和企业 (ToB) 的全面解决方案。

CodeRunning的博客 7139

百度人工智能的数据来源

在数据方面,除了海量的优质数据,百度拥有大量自建的高质量数据,包括百度阿拉丁(优质资源开放平台)、百度知道、百度百科、知识图谱等,不仅可以支持结构化数据的文章的生成,还可以支持基于内容聚合方式的文章生成。百度阿拉丁的时效性结构化数据,如体育比赛、彩票、股票信息、恶劣天气预警等,是速报类文章生成的数据基础。百度百科、百度知道和知识图谱是知识类文章生成的重要数据来源。     以百度百科的城市百科为

Eric_LH的博客专栏 2100
上一篇: 整数有约 | 刘乾专访:继续预训练策略与数据优化之道
下一篇: FormalMATH Benchmark:推动AI极限的形式化数学基准
整数智能
博客等级 码龄2年 215粉丝 19原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值