Transformer原理全解析:小白也能看懂的实战模拟

【AI】用大白话解释Transformer:编码与解码的奇幻之旅 一个现实的例子类比Transformer 讨论“人工智能在房地产公司的使用前景” 问题背景: 正在讨论“人工智能在房地产公司的使用前景”。 多头注意力(互联网公司): 在整个讨论过程中,有6家互联网公司参与。每家公司充当一个“编码器”,并为整体讨论提供独特的视角。这就是多头注意力的体现,每个编码器(公司)关注讨论中的不同议题。 阅读详情

🔥 Transformer原理全解析:小白也能看懂的实战模拟

一、写在前面:为什么一定要搞懂Transformer?

你一定听过这些热词:ChatGPT、Sora、AI绘画、智能翻译、大语言模型(LLM)。
这些看似五花八门的AI应用,背后其实都站着同一个核心骨架——Transformer。

可以说:不懂Transformer,就等于不懂现代AI。

但很多人对Transformer的印象都是:复杂的向量、晦涩的公式、难懂的术语,看完还是一头雾水。
本文完全抛弃公式堆砌,用**“小白也能听懂”的语言+真实案例**,带你从零到一,彻底搞懂Transformer的工作原理,并用“我爱吃苹果”这个案例,从头模拟一遍完整流程。
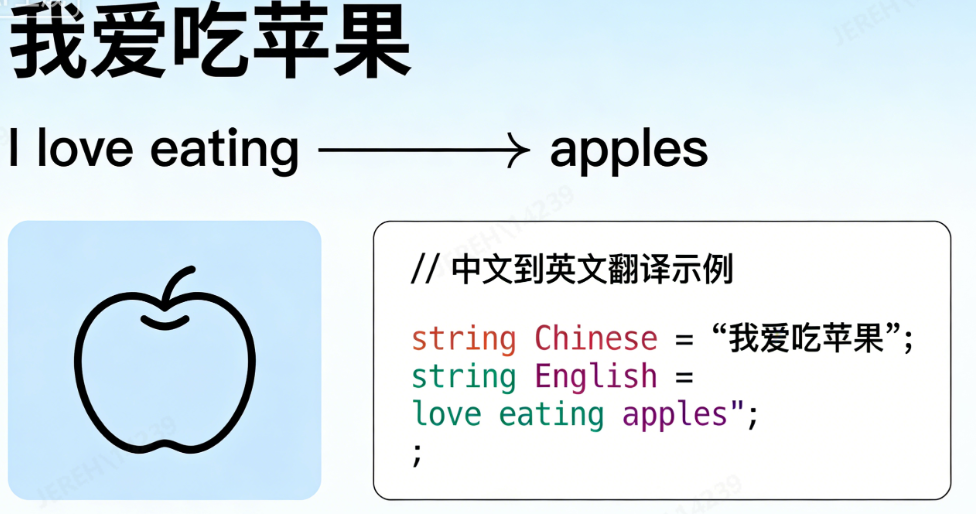
图片为AI生成

二、一句话核心概念:Transformer是什么?

先给大家建立最直观的认知:
Transformer = 一个会“自动找重点”的超级智能翻译官。

它的核心架构只有两大部分,就像人的“大脑”和“双手”:

  1. Encoder(编码器):负责**“看懂”**输入内容(比如中文句子、图片像素、语音片段)。
  2. Decoder(解码器):负责**“生成”**输出内容(比如英文翻译、文字、图片、视频)。

而它最厉害的“武器”,就是Attention(注意力机制)——能自动识别输入中“谁和谁关系最紧密”,精准抓住重点。

三、整体架构:Transformer的“大脑结构”

我们可以把Transformer想象成一个**“智能翻译工厂”**,整体流程如下:
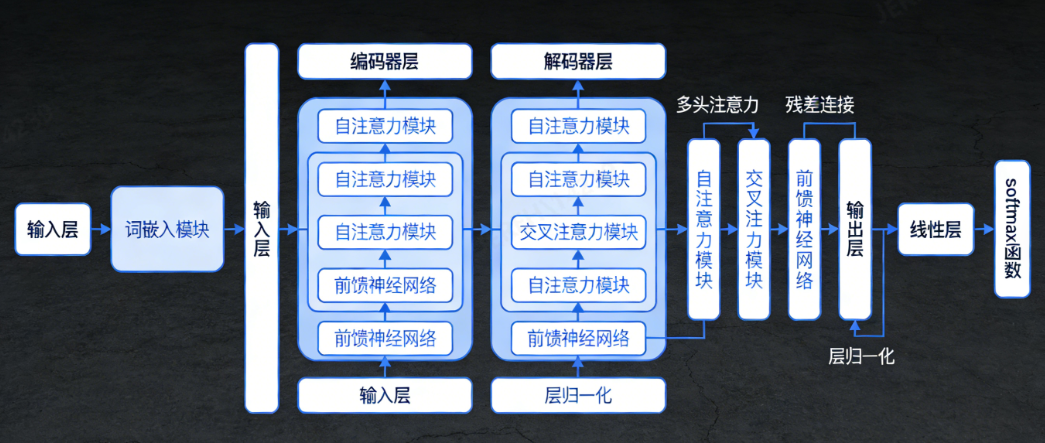
图片为AI生成

1. Encoder(编码器):核心职责

Encoder是Transformer的“理解大脑”,它的任务只有一个:
把输入内容翻译成模型能读懂的“语义密码”,并建立内容内部的关系图谱。

比如输入是中文句子“我爱吃苹果”,Encoder会把每个词的含义、顺序、词与词之间的关联全部梳理清楚,最终生成一份**“语义记忆库”**,这份记忆库会全程传给Decoder,保证生成不跑偏。

2. Decoder(解码器):核心职责

Decoder是Transformer的“生成双手”,它的任务是:
根据Encoder的语义记忆库,一个元素一个元素地生成输出内容。

比如翻译任务中,Decoder会依次生成“I、love、eating、apples”;在AI绘画任务中,Decoder会根据文字描述,依次生成图片的像素点;在语音合成中,Decoder会生成语音的声波片段。

3. 核心桥梁:注意力机制(Attention)

注意力机制是Transformer的“灵魂”,没有它,Transformer就是一堆无用的数学模型。
它的核心作用是:让模型自动“关注”重要内容,忽略无关内容。

举个简单例子:
读句子“小明把书借给了小红,因为他要复习”,你的大脑会自动:

  • 重点关注“他”→ 推断出“他”指的是小明;
  • 忽略“因为”“了”这类无意义的连接词。

Transformer的注意力机制,就是让模型也拥有这种“自动抓重点”的能力。

四、核心原理:注意力机制

注意力机制看似复杂,本质就是**“给每个内容打关注度分数”**,我们用3步拆解,保证人人都能懂。

1. 核心三要素:Query、Key、Value

注意力机制围绕三个核心概念展开,我们用**“找人”**的例子类比:

  • Query(查询):相当于“我想找什么人”。比如你在人群中找“你的同桌”,这个“找同桌的意图”就是Query。
  • Key(键):相当于“每个人的身份标签”。比如人群里每个人都有自己的名字、特征,这些身份标签就是Key。
  • Value(值):相当于“每个人的具体信息”。比如每个人的身高、爱好、座位号,这些详细信息就是Value。

2. 注意力计算逻辑:三步找重点

以句子中的一个词“爱”为例,注意力机制的计算流程如下:

  1. 生成Query/Key/Value:“爱”生成自己的Query(我要找和我关系紧密的词),其他词(我、吃、苹果)生成自己的Key(我的身份)和Value(我的详细信息)。
  2. 计算相似度分数:用Query和其他词的Key做匹配,算“像不像”。匹配度越高,分数越高。
    • “爱”和“我”匹配:关系紧密 → 分数90分;
    • “爱”和“吃”匹配:关系极紧密 → 分数95分;
    • “爱”和“苹果”匹配:有点关联 → 分数70分。
  3. 加权融合信息:把所有词的Value按相似度分数加权相加。最终“爱”不再是孤立的字,而是带着“我、吃、苹果信息的融合词”。

3. 两种核心注意力类型

Transformer中最常用的是两种注意力,也是理解Encoder和Decoder的关键:

  • 自注意力(Self-Attention):让内容内部的元素互相匹配,建立内容自身的关系。比如Encoder用自注意力,让“我”“爱”“吃”“苹果”互相建立关联。
  • 交叉注意力(Cross-Attention):让Decoder的生成内容和Encoder的语义记忆库匹配,保证生成不偏离输入。比如Decoder翻译时,用交叉注意力对照Encoder的中文记忆,确保英文翻译准确。

五、实战模拟:用“我爱吃苹果”走完完整Transformer流程

我们选一个最基础的任务:将中文句子“我爱吃苹果”翻译成英文。
整个流程分为4大步骤,我们一步步拆解,全程不涉及任何复杂公式。

步骤1:输入预处理——把句子变成模型能读懂的“密码”

模型不认识汉字,也不认识图片,所以第一步要把输入内容“翻译”成模型能理解的向量(可以简单理解为“语义编号”),做两件事:

1. 词嵌入(Embedding):给每个词分配“语义编号”

给句子中的每个词分配一个专属的语义向量,比如:

  • 我 → 语义向量A;
  • 爱 → 语义向量B;
  • 吃 → 语义向量C;
  • 苹果 → 语义向量D。
2. 位置编码(Positional Encoding):给每个词贴“顺序标签”

Transformer本身不知道内容的顺序,所以必须手动给每个元素贴上顺序标签:

  • 我:第1个词;
  • 爱:第2个词;
  • 吃:第3个词;
  • 苹果:第4个词。

经过这一步,模型知道了:这是4个按顺序排列的语义向量,对应“我、爱、吃、苹果”。

步骤2:Encoder(编码器)——看懂中文,生成语义记忆库

Encoder的核心任务是:用自注意力,让每个词互相匹配,建立整句的语义关系。

我们以“爱”这个词为例,模拟自注意力的完整过程:

  1. 生成Query/Key/Value:
    • “爱”生成Query:我要找和我关系紧密的词;
    • “我”“吃”“苹果”生成Key:我的身份;
    • “我”“吃”“苹果”生成Value:我的详细信息(比如“我”是主语,“吃”是动作,“苹果”是对象)。
  2. 计算相似度分数:
    • “爱”与“我”匹配:关系紧密 → 90分;
    • “爱”与“吃”匹配:关系极紧密 → 95分;
    • “爱”与“苹果”匹配:有点关联 → 70分。
  3. 加权融合信息:
    模型把这些分数归一化,得到注意力权重,再用权重对Value加权求和。最终“爱”变成了**“带着我、吃、苹果信息的融合词”**。

同理,“我”“吃”“苹果”也会经过同样的自注意力过程,最终Encoder处理完所有词,生成一份中文语义记忆库,里面清晰记录着:

主语是“我”,动作是“爱吃”,对象是“苹果”。

这份记忆库就是Decoder生成的唯一依据,全程不会丢失。

步骤3:Decoder(解码器)——逐词生成英文翻译

Decoder是一个词一个词地生成英文的,每生成一个词,都会经历**“掩码自注意力 + 交叉注意力”**两个核心步骤,直到生成结束符。

我们依次模拟生成“I、love、eating、apples”的全过程:

生成第1个词:I
  1. 掩码自注意力(Masked Self-Attention):
    Decoder初始只有一个开始符<start>,此时只能看自己,绝对不能偷看未来的词(防止作弊)。这一步是为了让Decoder理解已生成的内容。
  2. 交叉注意力(核心!):
    Decoder拿着当前的生成状态,去查询Encoder的中文语义记忆库:

    第一个词的内容是“我”。
    模型匹配“我”的英文翻译 → I。

  3. 生成结果:Decoder输出第一个英文单词I。
生成第2个词:love
  1. 掩码自注意力:
    现在Decoder已生成“I”,只能看“I”和自己,梳理已生成内容的关系。
  2. 交叉注意力:
    Decoder拿着“I”去查询语义记忆库:

    “我”后面的动作是“爱”。
    模型匹配“爱”的英文翻译 → love。

  3. 生成结果:Decoder输出第二个英文单词love。
生成第3个词:eating
  1. 掩码自注意力:
    已生成“I、love”,梳理这两个词的关联。
  2. 交叉注意力:
    Decoder拿着“I love”去查询语义记忆库:

    “我爱”后面的动作是“吃”。
    模型匹配“吃”的英文形式(动名词)→ eating。

  3. 生成结果:Decoder输出第三个英文单词eating。
生成第4个词:apples
  1. 掩码自注意力:
    已生成“I、love、eating”,梳理三者的关联。
  2. 交叉注意力:
    Decoder拿着整句英文去查询语义记忆库:

    “吃”的对象是“苹果”。
    模型匹配“苹果”的英文翻译 → apples。

  3. 生成结果:Decoder输出第四个英文单词apples。
结束流程

Decoder遇到结束符<end>,翻译任务完成,最终生成完整英文句子:

I love eating apples.

步骤4:最终验证

整个Transformer流程结束,输入“我爱吃苹果”,输出“I love eating apples”,翻译准确完成。

六、核心总结:3句话背下Transformer原理

为了方便记忆,我们把Transformer的核心原理浓缩成3句大白话:

  1. Encoder负责“看懂”:用自注意力,让每个元素互相匹配,建立输入内容的语义关系,生成记忆库。
  2. Decoder负责“生成”:用掩码自注意力防止偷看未来,用交叉注意力时刻对照Encoder的记忆库,逐元素生成输出内容。
  3. 注意力机制是灵魂:通过Query、Key、Value计算相似度,自动抓住输入中的重点和关联,让模型更智能。

七、补充

补充以下硬核要点:

  1. 架构本质:基于自注意力机制的Seq2Seq(序列到序列)模型,通过Encoder-Decoder架构实现输入到输出的映射。
  2. 核心优势:解决了传统RNN/LSTM的长距离依赖问题,自注意力机制可并行计算,训练效率远高于传统循环模型。
  3. 应用扩展:不仅限于NLP领域,通过ViT(视觉Transformer)、Whisper(语音Transformer)等变体,已广泛应用于计算机视觉、语音识别、多模态融合等场景。
  4. 高效优化:2025-2026年主流优化方向包括FlashAttention(降低显存占用)、Mamba/SSM(长序列高效计算)、MoE(混合专家模型,稀疏激活提升效率)。
BERT模型原理与实战:从Transformer到下游任务微调全解析 在自然语言处理领域,词向量和上下文建模是基础而核心的技术概念。传统词袋模型无法区分词语在不同语境下的含义,而基于Transformer架构的预训练模型通过自注意力机制实现了真正的双向上下文理解。这一技术突破使得模型能够从海量无标注文本中学习通用的语言表征,大幅提升了NLP任务的效果。BERT作为里程碑式模型,其核心在于掩码语言模型和下一句预测两个预训练任务,让模型学会联系上下文理解每个词。在工程实践中,通过微调范式,可以将这种强大的预训练能力快速迁移到情感分析、命名实体识别、问答系统等具体应用场景。本文深入 阅读详情

相关推荐

ChatGPT技术解析:从Transformer原理到提示工程实战

Transformer架构作为现代大语言模型的核心基础,通过自注意力机制实现了对文本上下文的高效并行理解,解决了传统RNN模型在长距离依赖和计算效率上的瓶颈。这一突破性技术催生了以GPT为代表的生成式预训练模型,通过海量无监督学习和预测下一个词的训练目标,使模型掌握了语言的深层规律。在工程实践中,指令微调与人类反馈强化学习等对齐技术,将原始语言模型转化为安全、有用的对话助手,显著降低了AI技术的使用门槛。如今,基于Transformer的模型已广泛应用于代码生成、内容创作、智能问答等场景,而提示工程技巧则成

weixin_30786657的博客 796

大白话transformer学习笔记(个人理解)

本篇文章是自己对transformer的理解,有不正确的地方望大家指出!!!!互相学习直接上图:transformer由编码器解码器结构组成,Encoder-Decoder并不是一个具体的模型,而是一类框架。我以为是很陌生的一个专业名词,但是我们熟悉的CNN也可以认为是用编码器解码器结构。所谓编码,就是将输入序列转化成一个固定长度的向量;解码,就是将之前生成的固定向量再转化成输出序列。CNN:CNN一直扛着视觉的大旗,transformer出来之后爆火,也逐渐应用于视觉领域。

jisuaijicainiao的博客 1566

BERT模型详解:从原理到实战应用全解析

在自然语言处理(NLP)的世界里,我们一直希望计算机能像人类一样理解和处理语言。BERT模型的出现,为解决这个问题带来了重大突破。本文的目的就是要详细介绍BERT模型,从最基础的概念到复杂的原理,再到实际的应用场景,让大家对BERT有一个全面且深入的了解。本文将按照以下结构展开:首先介绍BERT模型的核心概念与联系,包括用故事引入、核心概念解释以及它们之间的关系;接着详细讲解BERT模型的核心算法原理和具体操作步骤;然后给出相关的数学模型和公式,并举例说明;

AGI×大数据,开启智能时代的认知跃迁;解码AGI,赋能数据驱动的智能革命。 582

大白话解释Transformer

大白话解释TransformerTransformer 与 ‘seq2seq+attention’首先理解 *self-attention*multi-head & position-encoding 引入Transformer 模型 Transformer 与 ‘seq2seq+attention’ 核心是 self-attention,就是将2代的 encoder 和 decoder...

qq_41687961的博客 1860

AI大模型学习路线全解析:从Transformer到智能体开发实战指南

Transformer架构作为现代大模型的核心基础,通过自注意力机制解决了序列建模中的长距离依赖和并行计算效率问题。其技术价值在于为自然语言处理、多模态理解等任务提供了统一的建模框架,显著提升了模型性能和训练效率。在实际应用中,基于Transformer的大模型通过微调、提示词工程等技术,能够快速适配各类下游任务,广泛应用于智能对话、代码生成、知识问答等场景。本文聚焦于如何体系化地学习大模型技术,深入剖析了Transformer原理、LangChain智能体开发、RAG检索增强生成等关键模块,并提供了从理论

weixin_30439067的博客 464

深度学习七大经典网络:从CNN到Transformer的原理与实战解析

深度学习作为人工智能的核心技术,通过多层神经网络模拟人脑学习机制,在计算机视觉、自然语言处理等领域展现出强大能力。其核心原理在于通过反向传播算法优化网络参数,实现从数据中自动提取特征。在工程实践中,卷积神经网络(CNN)通过局部连接和权值共享有效处理图像数据,而Transformer凭借自注意力机制突破了序列建模的瓶颈。这些技术的价值在于能够端到端地解决复杂模式识别问题,在图像分类、目标检测、图数据分析等场景广泛应用。本文以CNN、GNN、YOLO、Transformer等七大经典网络为主线,系统解析其设计

weixin_29050513的博客 307

Transformer架构大白话:从原理到瓶颈,助你成为大模型专家(建议收藏)

Transformer架构大白话:从原理到瓶颈,助你成为大模型专家(建议收藏)

优快云_224022的博客 1453

深度学习五大神经网络核心原理与实战:CNN、RNN、Transformer、GNN、GAN全解析

如果你刚接触深度学习,可能会被各种神经网络模型搞得眼花缭乱:CNN、RNN、GAN、Transformer、GNN……它们听起来都像“黑盒子”,为什么这些由数学公式和矩阵运算组成的结构,能够识别图像、生成文本、甚至创作音乐?它们背后有没有一个统一的“学习”逻辑? 这篇文章不打算用10分钟动画一笔带过,而是想和你一起解决一个更根本的问题: 神经网络究竟是如何“学会”东西的? 理解了这一点,你再看GNN、RNN、GAN、CNN、Transformer这五大模型,就不会觉得它们是彼此孤立的“魔法”,而是针对不同数

weixin_33811539的博客 327

人人都能听懂的大白话 Transformer 技术原理

▼最近直播超级多,预约保你有收获今晚直播:《开发框架应用案例实战》—1—Transformer 网络架构剖析几乎所有主流的大模型都是基于 Transformer 网络架构构建的,Transformer 的重要性不言而喻。大模型可以类比人类的大脑,那么 Transformer 就可以类比人类大脑中的神经网络结构。Transformer 网络结构最核心的组成部分为:编码器(Encoder)和解码器(...

musicml的博客 2241

AIGC领域必知必会:Transformer架构原理解析与实战应用

在当前人工智能生成内容(AIGC)蓬勃发展的时代,Transformer架构凭借其卓越的性能和创新性,成为了众多AIGC应用的核心基础。本文的目的在于深入剖析Transformer架构的原理,并通过实战应用案例,帮助读者全面理解和掌握这一重要架构。文章将涵盖Transformer架构的核心概念、算法原理、数学模型,以及在实际项目中的开发和应用。本文将按照以下结构展开:首先介绍相关背景知识和术语;接着阐述Transformer的核心概念与联系,以图形化方式展示其架构;

AI天才研究院 1270

KiCad自动布线实战:FreeRouting插件安装与使用指南

在PCB设计流程中,布线环节往往占据大量重复性工作,尤其对于中小型双面板,成百上千条飞线的手动连接既繁琐又易出错。自动布线技术通过算法在给定设计规则和元件布局的基础上自动规划走线路径,能显著提升布线效率。FreeRouting作为一款开源自动布线器,与KiCad通过DSN/SES标准中间格式无缝配合,让工程师将精力集中于关键信号和布局优化,而将常规网络交给工具处理。本文从自动布线的原理与边界出发,讲解了FreeRouting的安装、DSN导出、参数设置、自动布线及结果回传的完整流程,并结合实际案例展示了在S

weixin_32025789的博客 277

小白也能看懂!Transformer大模型核心机制深度解析(收藏版)

本文详细解析了Transformer模型的每一层结构,从输入表示层的词嵌入与位置编码,到编码器的多头自注意力机制和前馈网络,再到解码器的掩码自注意力与编码器-解码器注意力,最后是输出层的线性变换与softmax。文章通过具体的数学计算示例,帮助读者理解Transformer的完整计算流程,并探讨了关键技术与优化细节,如缩放点积注意力、多头注意力的优势、残差连接的作用等。此外,还介绍了Transformer的变体与改进,如高效注意力机制、位置表示的改进和模型架构演进,为读者提供了全面而深入的视角。 ---

2401_85375186的博客 1283

机器学习教程 之 半监督学习 Co-training 协同训练 (论文、算法、数据集、代码)

这篇博客介绍的是一篇用于半监督分类问题的方法: 协同训练 Co-training, A. Blum and T. Mitchell, “Combining labeled and unlabeled data with co-training,” in Proc. of the 11th Annual Conf. on Computational Learning Theory, 1998.,这算是半监督领域里面始祖级的论文了,是1998年两位CMU大佬提出的方法。 之前还写过一篇关于Tri-trainin

冯良骏 的 博客 1万+

【Pytorch第三期解锁PyTorch进阶技能:Transformer与实战应用全解析】

本文聚焦PyTorch生态中Transformer模型及相关核心内容,深入讲解PyTorch Transformer模块用法,剖析优化器`torch.optim`、计算机视觉库`torchvision`的实践要点,覆盖模型部署、保存加载流程,还通过图像分类、文本情感分析实战,结合代码示例与原理阐释,帮助读者掌握从模型构建到落地应用的全链路技能,适配进阶学习者探索深度学习项目开发与部署。

qq_45832651的博客 1315

东方通TongWeb虚拟主机配置全流程:从创建到应用部署的保姆级教程

本文提供东方通TongWeb虚拟主机从创建、HTTP通道配置到应用部署的完整实战指南。重点解析虚拟主机的逻辑隔离价值、通道参数调优原理及企业级多应用部署架构,并涵盖常见报错排查与性能优化建议,旨在帮助运维和开发人员高效、稳定地完成应用系统部署。

oil88的博客 530

探针卡技术演进:从金线微针到MEMS探针的Wafer Sort革命

本文探讨了探针卡技术从传统金线微针到MEMS探针的演进,及其对晶圆测试(Wafer Sort)的革命性影响。随着芯片焊垫间距进入45微米以下,MEMS技术凭借其超高精度、超长寿命和卓越的信号完整性,成为应对高密度、高速及3D IC测试挑战的关键,显著提升了测试效率与稳定性。

lstm7chronicler的博客 365

Transformer原理与实战:大模型底层原理解析

编码器 (Encoder):像个超级读者。它的任务是深度阅读和理解输入内容(比如一句话),并把它的核心思想提取出来。解码器 (Decoder):像个超级作者。它的任务是根据“读者”提取的核心思想,一个字一个字地写出全新的内容(比如翻译后的句子或答案)。它们俩一个负责“读明白”,一个负责“写出来”。Transformer是谷歌于2017年在《Attention Is All You Need》中提出的深度学习模型,彻底改变了自然语言处理领域。其核心是自注意力机制。

m0_56255097的博客 1326

DFX从芯片到系统:可制造性、可测试性与可靠性设计实战指南

DFX(Design for eXcellence)是一套面向产品全生命周期的设计方法论,涵盖可制造性(DFM)、可测试性(DFT)、可靠性(DFR)等维度。其核心原理是将制造、测试、维护等环节的约束前置到设计阶段,从而降低流片与量产风险。在芯片与系统硬件领域,DFX不仅是提升良率与测试效率的关键手段,更是保障车规、工控等严苛场景下长期稳定运行的基础。从芯片物理实现到PCB布局,再到系统级散热与维护设计,DFX的落地需要工具链、流程闸门与跨部门协作的体系化支撑。本文基于实际项目经验,分享DFX从设计决策到工

weixin_32349093的博客 350

Trajectory Transformer轨迹预测模型:从原理到实战的完整解析

在现代人工智能应用中,轨迹预测技术正成为自动驾驶、机器人导航等领域的关键支撑。Trajectory Transformer作为基于Transformer架构的先进轨迹预测框架,凭借其强大的时空建模能力,为复杂环境下的运动轨迹预测提供了高效解决方案。 ## 🎯 技术架构深度剖析 ### 多层次时空特征提取 该模型借鉴了自然语言处理中的自注意力机制,实现了对连续时空数据的多尺度特征捕捉。核心模型

gitblog_00174的博客 946

告别Python中间件!C#原生调用YOLOv11/v12:工业视觉检测零语言壁垒全流程

本文介绍了一种基于C#和ONNX Runtime的工业视觉检测解决方案,解决了传统YOLO模型在工业应用中面临的三大痛点:语言壁垒、性能损耗和模型更新困难。该系统采用三层架构设计,支持C#原生调用YOLO模型,无需中间件,性能损耗低于5%,满足工业产线30FPS+的实时性要求。文章详细阐述了环境搭建、模型导出规范、核心代码实现及工业级优化方案,提供可直接用于生产环境的完整流程,实现了训练与部署的解耦,显著降低了维护成本。该方案兼容主流YOLO版本,支持全平台部署,为工业视觉检测提供了高效可靠的C#集成方案。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 186

反应动力学仿真软件:Kintecus_(11).数据输入与输出解析

在反应动力学仿真软件的二次开发中,数据输入与输出解析是至关重要的步骤。正确地解析输入数据和生成输出结果不仅能够确保仿真过程的顺利进行,还可以提高仿真的准确性和效率。本节将详细介绍如何在仿真软件中实现数据输入与输出的解析,包括文件格式、数据结构、解析方法以及实际操作示例。

kkchenjj的博客 757

GNN+Transformer工业缺陷检测实战:从原理到部署全解析

图神经网络(GNN)通过建模实体间的关系结构,而Transformer凭借其自注意力机制擅长捕捉长距离依赖,两者结合为复杂模式识别提供了新范式。这种融合技术在工程上的核心价值在于,能够突破传统卷积神经网络(CNN)对规则局部结构的依赖,从而更有效地处理非欧几里得数据和不规则模式。在工业视觉领域,这一特性恰好适用于解决**纹理背景**下**形状不规则**缺陷的检测难题,例如布匹瑕疵、焊接气泡或微小裂纹的精准定位。本文将以一个具体的工业缺陷检测项目为例,详细拆解GNN与Transformer融合模型的部署流程、

weixin_30918633的博客 364

C语言设计模式全面解析:从理论到28个实战示例

本文系统介绍了23种经典设计模式在C语言中的实现方法。通过结构体、函数指针等技巧,C语言可以优雅地模拟面向对象特性,实现代码复用与解耦。文章分类详解了创建型、结构型、行为型三大类模式,并提供了28个完整代码示例,包括单例、策略、观察者等核心模式的精简实现。这些模式在嵌入式系统、操作系统内核等场景中广泛应用,如状态机、事件驱动等。学习C语言设计模式的关键在于理解模式意图,掌握函数指针和结构体组合等技巧,并在实际项目中灵活运用。本文为C语言开发者提供了全面的设计模式参考指南。

数字人生 363

Transformer归一化深度解析:小白也能看懂大模型核心原理与实战技巧(收藏版)

本文深入解析了Transformer模型中的归一化技术,从基础概念到实际应用。归一化通过统一数据分布范围,解决了特征权重失衡、训练不稳定等问题,是深层大模型训练的关键技术。重点对比了LayerNorm与BatchNorm的区别,指出LayerNorm更适合NLP任务。文章还详细介绍了字节跳动和Google在大模型训练中的归一化优化实践,包括Pre-LN结构、RMSNorm应用及混合精度适配等实战技巧,为工程师提供了有价值的参考。

weixin_55154866的博客 977

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Transformer原理与大厂AI面试全解析

Transformer作为深度学习领域的核心架构,通过Self-Attention机制实现了高效的序列建模。其核心原理包括QKV矩阵计算、多头注意力机制和位置编码设计,这些技术显著提升了模型在长序列任务中的表现。在工程实践中,Transformer的并行计算优势使其成为自然语言处理(NLP)和计算机视觉(CV)领域的首选方案。大厂面试中,Transformer相关问题的高频出现反映了其对候选人基本功的考察价值,特别是对Self-Attention推导和代码实现能力的测试。掌握Transformer不仅有助于

weixin_34221332的博客 460

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Transformer架构深度解析:从数学原理到工程落地

Transformer是一种基于自注意力机制的序列建模架构,其核心在于通过Query-Key-Value计算实现全局上下文建模,突破RNN的时序依赖瓶颈与CNN的局部感受野限制。原理上,它依赖缩放点积注意力、正弦位置编码与残差归一化等关键设计,保障长程依赖捕获与训练稳定性;技术价值体现在并行计算效率高、位置泛化能力强、模块可解释性好;广泛应用于机器翻译、法律文书生成、金融文本摘要等需强语义关联与逻辑严谨性的场景。本文结合PyTorch手写实现与中文法律项目实战,深入剖析Self-Attention公式细节、

weixin_30856725的博客 485

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

上一篇: 从本地模型到MoE核心,一文读懂大模型底层逻辑(分类梳理版·含Ollama实操)
下一篇: 炸穿时序数据痛点!5分钟学会IoTDB 原生AI直接预测+告警
Dad_of_Object
博客等级 码龄9年 0粉丝 5原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Dad_of_Object

您的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值