关于运用python读取PDF 文件的知识

深入学习python解析并读取PDF文件内容的方法 这篇文章主要学习了python解析并读取PDF文件内容的方法,包括对学习库的应用,python2.7和python3.6中python解析PDF文件内容库的更新,包括对pdfminer库的详细解释和应用。主要参考了一些已有的博客内容,代码。   主要思路是首先利用一个做项目的形式,描述所做的问题,运行环境,和需要安装的库,然后写代码,此代码是在python2.7中运行,小编也写出在python3.... 阅读详情

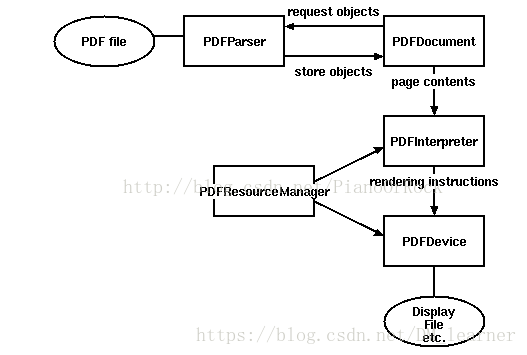
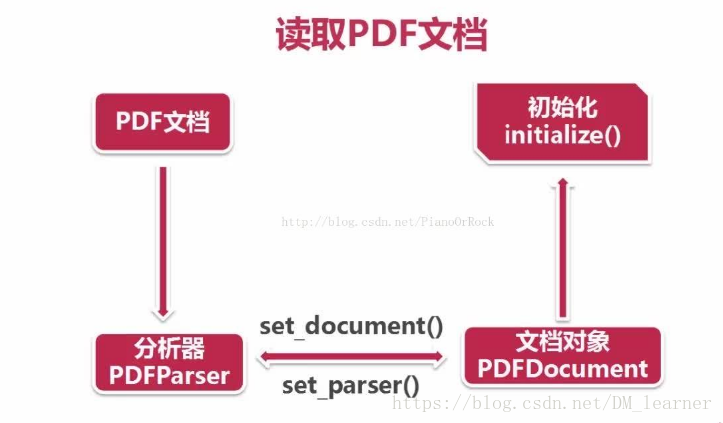
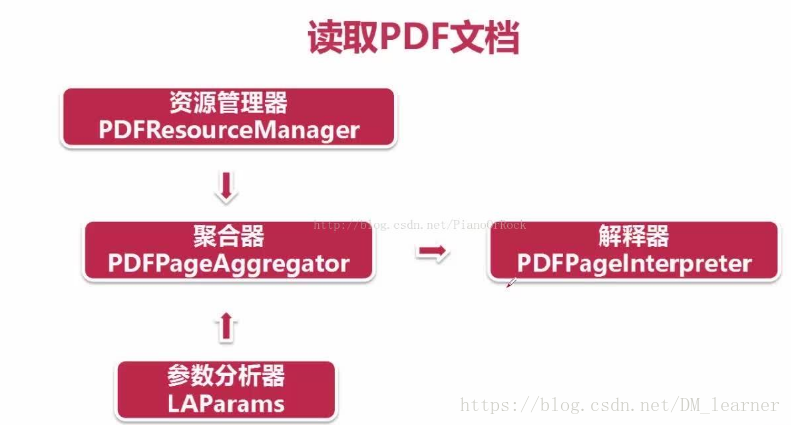
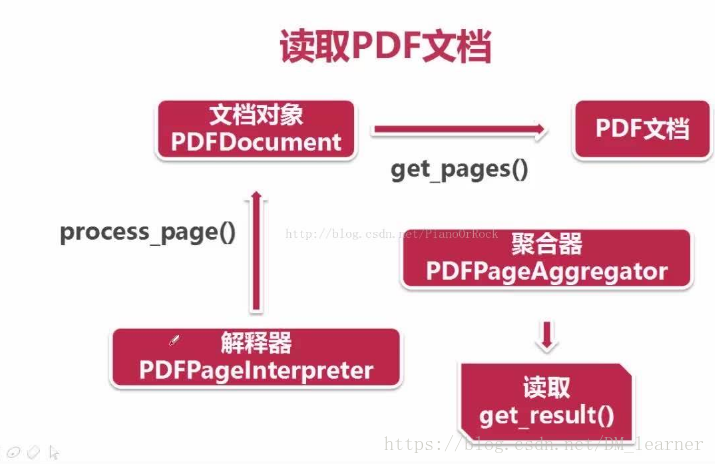
pdf读取总刚要:


(1)


(2)


(3)
 

代码如下:

#!/usr/bin/env python3
#coding=utf-8

from pdfminer.pdfparser import PDFParser,PDFDocument
from pdfminer.pdfinterp import PDFResourceManager,PDFPageInterpreter
from pdfminer.converter import PDFPageAggregator
from pdfminer.layout import LAParams
from pprint import pprint

#获取文档对象
pdf=open(r'C:\Users\pc\Desktop\医疗数据\医疗机构数据\2015年全省各地区每千人口床位、人员、医生、护士数(常住).pdf','rb',encoding='Unicode')

#创建一个与文档关联的解释器
parser=PDFParser(pdf)

#创建一个PDF文档对象
doc=PDFDocument()

#连接文档对象和文件解释器
parser.set_document(doc)  #存储对象
doc.set_parser(parser)    #请求对象

#文档初始化
doc.initialize('')

#创建PDF资源管理器
resources=PDFResourceManager()

#创建参数分析器
analyparam=LAParams()

#创建一个聚合器,并接受资源管理器,参数分析器作为参数
polymerizer=PDFPageAggregator(resources,laparams=analyparam)

#创建一个页面解释器,将PDF资源管理器和聚合器作为参数
pageInterpreter=PDFPageInterpreter(resources,polymerizer)

#使用文档对象获取页面的集合
for page in doc.get_pages():
    #使用页面解释器读取页面信息
    pageInterpreter.process_page(page)
    #使用聚合器读取页面内容
    layout=polymerizer.get_result()
    for out in layout:
        if hasattr(out,'get_text'):
            pprint(out.get_text)

注:对于python读取pdf文件,要想成功必须pdf文件是一个比较规范的格式,如果是一个不规范的表格形式,就会出现乱码错误,个人觉得python读取pdf文件的准确性,并不是特别高,希望读者多用别的方法尝试。

如何通过python来实现PDF文件的读取 网上查了好几个关于python如何读取PDF文件的实例,或多或少都有错误,根本无法运行。 这几天专门修改优化了一下,并在机器上真实操作过,现完全复制出来,供大家参考。 1.python版本:python3.8.1 2.注意:python通过pip安装时速度很慢,发现连接的是官网,后来修改为豆瓣网,速度奇快无比,爽 3.代码如下: ```python # -*- coding: utf-8 -*- ... 阅读详情

相关推荐

python网络爬虫文档读取-PDF文件读取

针对PDF文档的Python网络爬虫的文档读取进行分析和介绍,讲述了如何通过Python网络爬虫采集PDF文档中的文档信息。通过Python的PDFMIner3K库可以在3.x的python版本中进行pdf文件信息的读取。

wanght89的专栏 5909

利用python库中的pdfminer解析paper pdf文档

original url: http://www.bkjia.com/Pythonjc/1073800.html # cat readpdf_searchkeyword.py # -*- coding: utf-8 -*- # download this code from http://www.bkjia.com/Pythonjc/1073800.html from pd

junmuzi的专栏 4594

autoDL算力云装Xinference[坑与步骤]

在页面直接点击下载会出现下着下载进度条消失,试了几次才出现这个报错,现在我们就继续安装缺少的包吧。这一步成功绕开了系统盘空间限制。先租用一个合适的服务器,建议不要选最新版本,跟我选的一样即可,不然后面会出现。最近在 AutoDL 上尝试部署。🚫 不要直接使用以下命令。点击下面链接即可打开。

ngadminq的博客 2387

浅谈Python处理PDF的方法

文章目录python 读取文件内容 刚好最近有这方面需求就稍微学习了一下模块的使用,记录一下 python 读取文件内容 一.安装pdfminer3k模块 python3 -m pip install pdfminer3k 二.读取pdf文件 找了很久,才找到能运行不报错的python3读取pdf文件 import sys import importlib importlib.reload(sys) from pdfminer.pdfparser import PDFParser, PDFDocumen

qq_44657899的博客 325

华三R4900 G5服务器实战:用PMC P460-B4阵列卡配置RAID1+RAID6,并搞定CentOS 7.9安装(含热备盘设置)

本文详细解析了在华三R4900 G5服务器上使用PMC P460-B4阵列卡配置RAID1+RAID6混合阵列的全过程,包括热备盘设置和CentOS 7.9系统安装。通过实战步骤和性能优化建议,帮助企业IT人员高效部署高可用存储方案,特别适合需要数据冗余和系统稳定性的企业级应用场景。

weixin_29248653的博客 358

LightGBM处理类别特征和缺失值有多省心?一个真实业务数据案例带你上手

本文通过真实电商数据案例,详细解析了LightGBM如何高效处理类别特征和缺失值。相比传统方法,LightGBM仅需一行代码即可自动处理高基数类别特征和缺失值,大幅提升模型训练效率和预测准确度,特别适合业务场景中的脏数据处理。

weixin_30689307的博客 460

python 原理 pdf_利用Python处理PDF——裁剪和生成新的PDF

安装在cmd中输入这一句:pip install -U pdfminer3k -i https://pypi.tuna.tsinghua.edu.cn/simple --user注意:这里安装的是pdfminer3k而不是pdfminer。不小心安装了pdfminer(pip install pdfminer)的同学,请回到你安装包的文件夹中(类似这个文件夹:....\Python\Python3...

weixin_39666782的博客 795

车载LIN总线避坑指南:主从节点通信失败的5个常见原因及解决方案

本文深度解析车载LIN总线主从节点通信失败的五大常见原因,涵盖物理层信号异常、调度表冲突、LDF配置错误、节点状态机缺陷及环境干扰。重点剖析了LDF文件配置不一致、波特率不匹配等关键问题,并提供了从示波器波形分析到软件配置检查的完整实战排查路径,帮助工程师高效定位并解决LIN通信故障。

g9h0i1的博客 1252

python读取pdf表格_【Python 库】解析PDF文本及表格——pdfminer、tabula、pdfplumber 的用法及对比...

pdf 是个异常坑爹的东西,有很多处理 pdf 的库,但是没有完美的。一、pdfminer3kpdfminer3k 是 pdfminer 的 python3 版本,主要用于读取 pdf 中的文本。网上有很多 pdfminer3k 的代码示例,看过以后,只想吐槽一下,太复杂了,有违 python 的简洁。from pdfminer.pdfparser importPDFParser, PDFDocu...

weixin_39792519的博客 854

【C++】小猫钓鱼纸牌游戏--C++实现

小猫钓鱼问题: 描述:初始,两个人各有n张牌(牌面0-10),顺序固定,只能按顺序出牌。然后,两个人轮流在桌面上以接龙的方式出牌,当某个人放置的牌在桌面上已经出现时,他收起相同牌面及其中间的牌作为自己的筹码,同时需要再放一张牌到桌面。某人手上的牌出完后,另一个人继续出,直到两人手上都没牌为止,输出结束时两个人手上的筹码数。 #include<iostream> using namespace std; struct queue { int head; //队列首 int tail; //

qq_41344430的博客 3202

基于CH32X035的USB双K型热电偶温度计:硬件设计、冷端补偿与信号放大详解

本文详细介绍了基于CH32X035单片机设计USB双K型热电偶温度计的完整方案。重点解析了硬件设计中的核心挑战:如何利用精密运放GS8552-SR进行信号放大,以及采用NTC热敏电阻和查表法实现精确的冷端补偿。项目通过USB供电通信,实现了双路高精度温度测量与显示,为电子爱好者和工程师提供了实用的参考设计。

weixin_42153793的博客 163

python提取pdf

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 例如:第一章 Python 机器学习入门之pandas的使用 提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录系列文章目录前言一、pandas是什么?二、使用步骤1.引入库2.读入数据总结 前言 提示:这里可以添加本文要记录的大概内容: 例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。 提示:以下是本篇文章正文内容,下面案例

Mr__666的博客 461

【Java核心高阶进阶】44-Java8核心新特性

模块十:Java新特性演进 · 第 1 篇Java 8 是 Java 语言历史上最重要的一次发布,它引入的函数式编程范式从根本上改变了 Java 的编码方式。即便到了 JDK 21 的今天,Lambda、Stream、Optional 仍是日常开发的高频工具。本篇将深入这些特性的语法、原理与底层机制,帮助你不仅会用,更知其所以然。

gaochufukanyongren的博客 24

Python 操作pdf文件(pdfplumber读取PDF写入Excel)

Python 操作pdf(pdfplumber读取PDF写入Exce) Python读取pdf文件存入Excel

感谢关注-最近在编写开源的自动化测试框架还没整理完 7100

基于simulink的能量管理策略的场景实例:混合动力电动汽车(HEV)的能量回收与分配策略

本文以混合动力电动汽车(HEV)为研究对象,通过Simulink建模详细演示了能量管理策略的设计与实现。内容涵盖HEV系统架构、核心组件工作原理,并分步骤指导搭建车辆动力学模型、动力系统组件模型和基于规则的能量管理策略。重点分析了制动能量回收与功率分配机制,通过仿真验证了逻辑门限策略在提升燃油经济性和维持电池SOC平衡方面的有效性。文章最后展望了更高级控制策略的应用前景,为HEV能量优化提供了完整的仿真研究框架。

xiaoheshang_123的博客 213

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

使用Python读取pdf文件

学习python,不用再为pdf无法转换而烦恼~~~ 下面我们介绍python读取pdf文件(主要是针对文字部分) 1、打开环境 2、安装pdfminer3k包 可以使用jupyter notebook进行安装,如下图所示: 安装成功,大功告成第一步。 3、导入相关的包: from io import StringIO from pdfminer.pdfinterp import PDFResourceManager from pdfminer.pdfinterp import proce

u013236891的博客 2万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Python读取PDF文档(或TXT)

字符串在Python内部的表示是Unicode编码,首先我们来认识Python中encode()和decode()的作用与区别: 在做编码转换时,通常需要以unicode作为中间编码,即先将其他编码的字符解码(decode)成unicode,再从unicode编码(encode)成另一种编码。

薛定谔的猫-前端领域 2万+

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

python怎么读取pdf文件_Python解析并读取PDF文件内容的方法

本文实例讲述了Python解析并读取PDF文件内容的方法。分享给大家供大家参考,具体如下:一、问题描述利用python,去读取pdf文本内容。二、效果三、运行环境python2.7四、需要安装的库pip install pdfminer五、实现源代码代码1(win64)# coding=utf-8import sysreload(sys)sys.setdefaultencoding('utf-8'...

weixin_39549110的博客 4807

python读取pdf中的文本

python处理pdf也是常用的技术了,对于python3来说,pdfminer3k是一个非常好的工具。 pip install pdfminer3k 首先,为了满足大部分人的需求,我先给一个通用一点的脚本来读取pdf中的文本: from io import StringIO from io import open from pdfminer.converter import Text...

木盏 4万+

python 从PDF文件中读取书签/目录

python 从PDF文件中读取书签/目录一级目录二级目录三级目录 使用python3 , 需导入PyPDF2模块 from PyPDF2 import PdfFileReader as pdf_read #每个书签的索引格式 #{'/Title': '书签名', '/Page': 指向的目标页数, '/Type': '类型'} directory_str = '' def bookmark_listhandler(list): global directory_str fo

龙纸人的博客 9911

Python 读取pdf文件

本篇使用Python 实现读取pdf文件简单示例

json_li的博客 3921

python读取pdf文件_python读取pdf文件

广告关闭腾讯云11.11云上盛惠 ,精选热门产品助力上云,云服务器首年88元起,买的越多返的越多,最高返5000元!一.安装pdfminer3k模块?二. 读取pdf文件import sysimport importlibimportlib.reload(sys) frompdfminer.pdfparser import pdfparser,pdfdocumentfrom pdfminer.pd...

weixin_39691233的博客 1267

python读取pdf文件获取pdf的文本内容

安装PyPDF2 , pip install PyPDF2 import PyPDF2 from urllib.request import urlopen file = open('D:/ltn20190716133.pdf', 'rb') fileReader = PyPDF2.PdfFileReader(file) #pdf page numbers totals print(fileR...

weixin_42185136的博客 7624

两行代码读取pdf、docx文件

最近运行课件代码,发现pdf文件读取部分的函数失效。这里找到读取pdf文件的可运行代码,为了方便后续学习使用,我已将pdf和docx读取方法封装成pdfdocx包。pdfdocx只有简单...

大邓和他的Python 2376

Python_读取PDF文件内容

涉及到一些PDF文件中的读取,特地去网上简单学习一下并记录下来 大神链接: https://www.cnblogs.com/wj-1314/p/9429816.html 自己简单代码的分享以边自己后边用到 from pdfminer.converter import PDFPageAggregator from pdfminer.pdfparser import PDFParser, PDFDo...

后青春诗ing 7946

Python读取PDF、WORD、EXCEL、PPT里文本

文章目录场景PDFWORDEXCELPPT 场景 获取文件中的文本内容 PDF WORD EXCEL PPT

ArYe 2653
上一篇: 关于python连接mysql相关知识
下一篇: 关于python连接mysql相关知识(2)
DM_learner
博客等级 码龄9年 21粉丝 23原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值