python爬虫——爬取简书文章

Python爬虫:爬取简书文章内容与数据解析完整教程 本文详细介绍了如何使用Python爬取简书网站的文章内容,并通过数据解析与存储的方式获取到文章标题、内容、作者信息等数据。在实际应用中,爬虫的稳定性与效率至关重要,因此除了基本的爬虫设计外,合理的反爬虫措施和优化策略也需要特别注意。通过不断的迭代与优化,我们可以构建出高效且稳健的数据抓取工具。 阅读详情

       这段时间在做的事情需要从网上获得一点资讯类似文章啊、电影啊、新闻啊等等,看了很久感觉用简书这个网址来做爬虫相对来说简单一点,可以不需要设置登录啥的就能够获取到内容,相比较起来已经很容易了。
(一)分析页面结构
       我选择了一个简书的专题,就是固定的一个url,专题里面文章也比较多,如果需要多个专题,把专题链接复制下来写在一个数组里面让爬虫循环爬就可以。本次就举一个固定的url为例来写。
打开Chrome的开发者工具,就会出现页面的结构。(之前用火狐浏览器感觉也挺方便的)一层层打开可以找到显示文章的标签
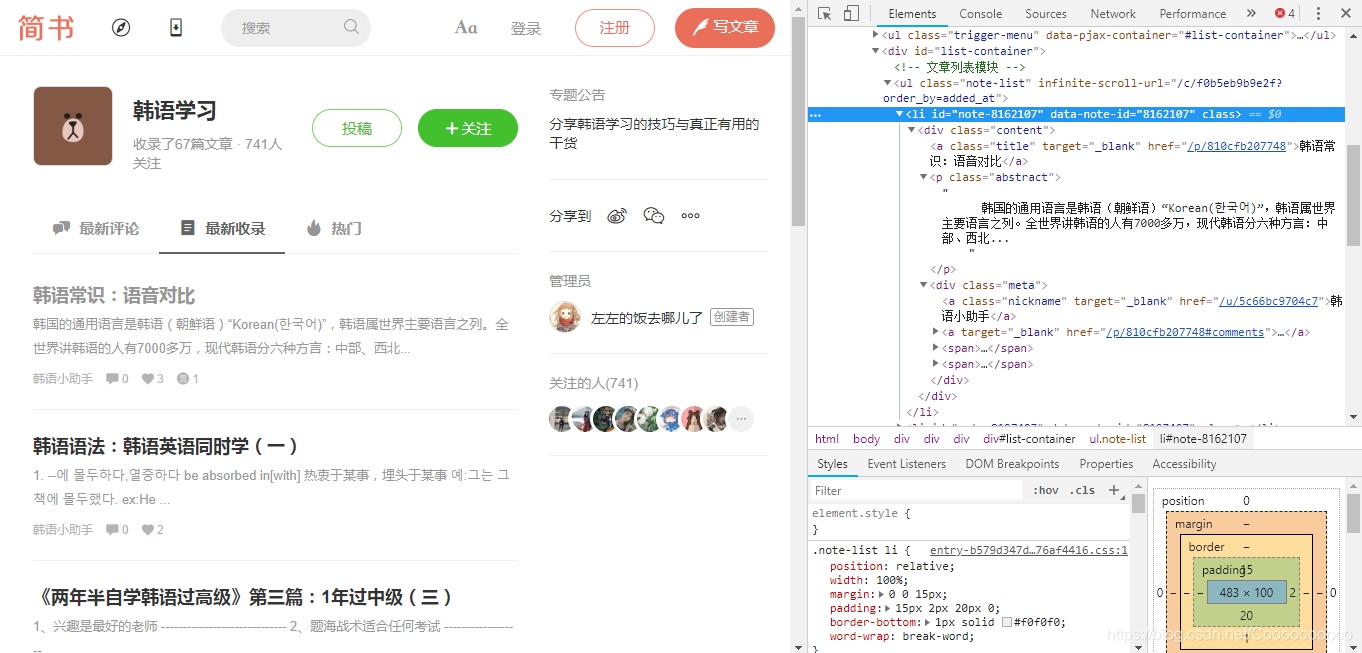
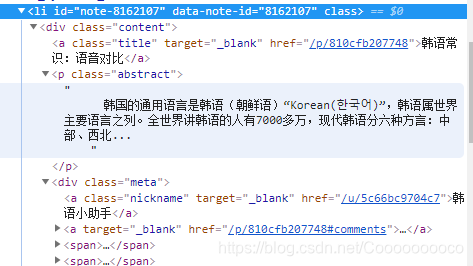
       可以发现需要爬取的文章在<li>这个标签下,<a>标签为标题和链接,<p>为文章摘要,下面还有作者名字、点赞数等等,我主要需要获取标题、摘要以及文章链接即可。


(二)处理获取到的文本

        爬虫爬下来的是整个页面的xml文本,需要找到我们所需要的东西还得经过处理才行,这里选择用xpath来处理,我觉得还挺好用的。
        xpath相关语法可以参照这个:http://www.w3school.com.cn/xpath/xpath_syntax.asp

        先设置各个路径如下:

#获取所有 li标签
xpath_items = '//ul[@class="note-list"]/li'
#对每个 li标签再提取
xpath_link = './div/a/@href'
xpath_title = './div/a[@class="title"]/text()'
xpath_abstract='./div/p/text()'

        使用request的get方法获取页面,之后进行处理:

items1 = dom1.xpath(xpath_items)
    for article in items1:
        t = {}
        t['link'] = 'https://www.jianshu.com'+article.xpath(xpath_link)[0]
        t['title'] = article.xpath(xpath_title)[0]
        t['abstract']=article.xpath(xpath_abstract)[0]
        print(t)

(三)解决页面自动翻页问题

       第一次爬的时候只爬取到了第一页的文章,大概5、6?篇的样子,后来看了好久,也在网上搜了搜发现是属于Ajax动态加载(https://zhuanlan.zhihu.com/p/27346009),翻页时页面url不变。此时需要打开Chrome的Network,这种技术的文档属于XHR文件,打开后可以看到一个新的request url,其中添加了order_by =added_at 和page=2,方法还是get方法。往下继续翻可以看到只是page在改变,这样的网站简直简单多了。٩꒰▽ ꒱۶⁼³₌₃ 
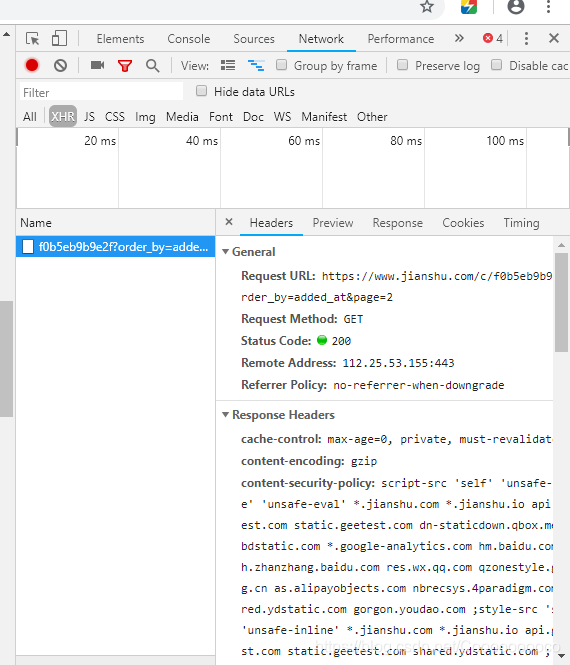
那么可以设置一个循环来实现页面的增加

a='added_at'
count=1
#获取和解析网页
while count<5:
    r1 = requests.get('https://www.jianshu.com/c/f0b5eb9b9e2f?order_by={}&page={}'.format(a,count))
    print('https://www.jianshu.com/c/f0b5eb9b9e2f?order_by={}&page={}'.format(a,count))
    r1.encoding = r1.apparent_encoding
    dom1 = etree.HTML(r1.text)
    print(r1.status_code)

#获取所有的文章标签
    items1 = dom1.xpath(xpath_items)
    for article in items1:
        t = {}
        t['link'] = 'https://www.jianshu.com'+article.xpath(xpath_link)[0]
        t['title'] = article.xpath(xpath_title)[0]
        t['abstract']=article.xpath(xpath_abstract)[0]
        print(t)
#解析完毕
    count=count+1
    print(count)
    r1.close()

(四)解决一些爬虫常见问题

       ①解决了翻页问题但是却逃不过被网站拒绝访问qwq,需要设置请求头和代理。请求头很简单,复制一下就ok。

       设置代理这个,,我觉得得(dei)看运气(:3[▓▓] 一个代理ip网址:https://www.kuaidaili.com/free/(其实有很多,收费的比免费的更稳定)

       最开始随便选择了几个,打算采取随机选取的方法,让访问的时候随机选择一个ip,这样不太容易被识别出来,但失败次数还是蛮高的。试了好几个以后发现有一个ip访问这个每次都是成功的,然后找了几个相似的居然成功率还挺高。不知道现在这个还行不行(。⊙౪⊙。)。因为简书的网址是https的,所以选择代理ip的时候也需要选择对应的。

#代理
proxy_list = [
    {"https" : "218.60.8.98:3129"},
    {"https" : "218.60.8.83:3129"},
    {"https" : "218.60.8.99:3129"}
]

      ②避免太频繁,除了多设几个代理ip以外,还可以加一个沉睡时间(单位为s级)

  time.sleep(5)

(五)完整代码(暂时只翻了5页,获取到的数据没有写进文件,可以改改)

#-*- coding: utf-8 -*
import requests
from lxml import etree
import time
import random
import socket

socket.setdefaulttimeout(20)
#请求头
headers1 = {
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
    'Accept-Encoding': 'gzip, deflate',
    'Accept-Language': 'zh-CN,zh;q=0.9',
    'Cache-Control': 'max-age=0',
    'Content-Type': 'application/x-www-form-urlencoded',
    'Proxy-Connection': 'keep-alive',
    'Upgrade-Insecure-Requests': '1',
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.117 Safari/537.36',
}

#代理
proxy_list = [
    {"https" : "218.60.8.98:3129"},
    {"https" : "218.60.8.83:3129"},
    {"https" : "218.60.8.99:3129"}
]

#获取所有 li标签
xpath_items = '//ul[@class="note-list"]/li'
#对每个 li标签再提取
xpath_link = './div/a/@href'
xpath_title = './div/a[@class="title"]/text()'
xpath_abstract='./div/p/text()'

a='added_at'
count=1
#获取和解析网页
while count<5:
    proxy = random.choice(proxy_list)
    print(proxy)
    r1 = requests.get('https://www.jianshu.com/c/f0b5eb9b9e2f?order_by={}&page={}'.format(a,count), headers=headers1,proxies=proxy)
    print('https://www.jianshu.com/c/f0b5eb9b9e2f?order_by={}&page={}'.format(a,count))
    r1.encoding = r1.apparent_encoding
    dom1 = etree.HTML(r1.text)
    print(r1.status_code)

#获取所有的文章标签
    items1 = dom1.xpath(xpath_items)
    for article in items1:
        t = {}
        t['link'] = 'https://www.jianshu.com'+article.xpath(xpath_link)[0]
        t['title'] = article.xpath(xpath_title)[0]
        t['abstract']=article.xpath(xpath_abstract)[0]
        print(t)
#解析完毕
    count=count+1
    print(count)
    r1.close()
    time.sleep(5)

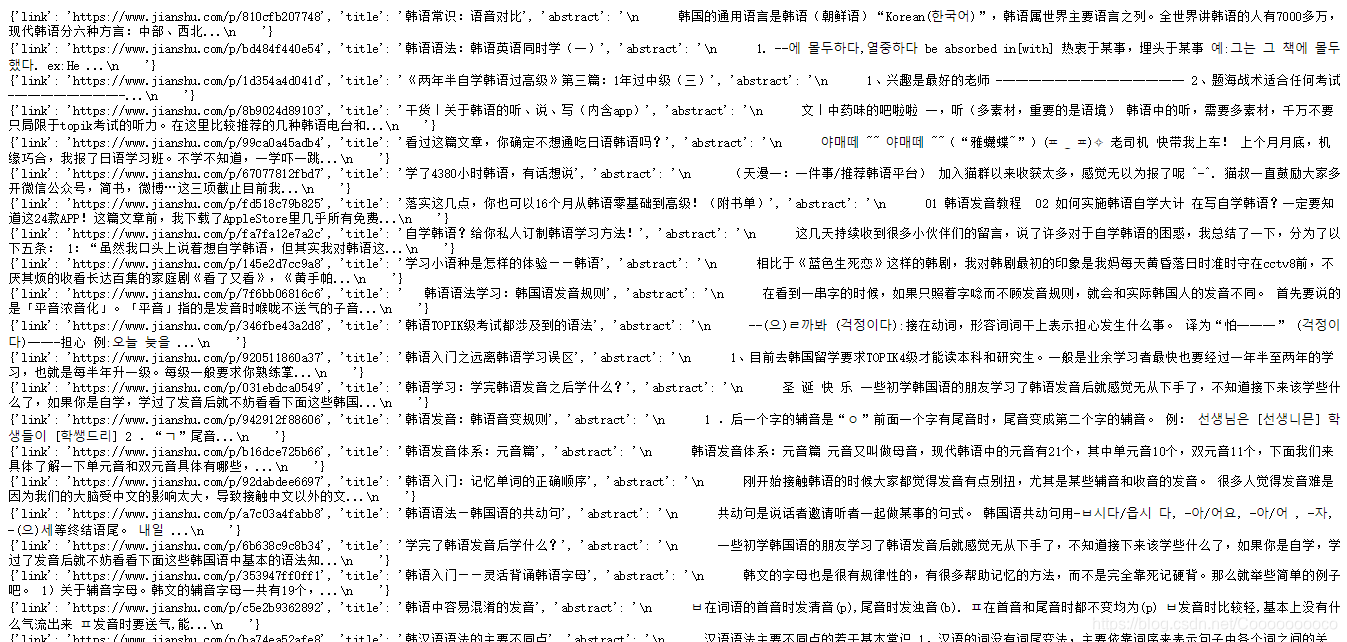
结果用json文件存的,比较方便传数据库
【Python爬虫实战】爬取简书热门文章数据 本文详细介绍了如何使用Python爬虫技术爬取简书热门文章数据,涵盖了从请求模拟、页面解析、数据提取到存储的全过程。通过爬虫的实现,我们不仅掌握了如何应对网站的反爬机制,还学会了如何高效地存储和分析爬取的数据。未来,我们可以将这些数据进一步挖掘,通过自然语言处理等技术,分析文章内容的情感趋势,帮助内容创作者提升创作质量,或者帮助读者发现更多优质文章。 阅读详情

相关推荐

Python爬虫实战:使用最新技术爬取简书热门文章

本文详细介绍了如何使用Python最新技术爬取简书热门文章,从基础的同步爬虫到高级的异步分布式爬虫,涵盖了多种实现方案和技术细节。我们使用了Requests-HTML、Playwright、Asyncio等现代化工具,实现了高效、稳定的爬虫程序,并考虑了反爬策略、数据存储、分析和监控等多个方面。

2201_76125261的博客 922

简书python_python爬虫(以简书为例)

1.主题:简单爬取简书中的专题‘’@IT·互联网“中的文章,爬取信息之后通过jieba分词生成词云并且进行分析;2.实现过程:第一步:打开简书并进入到@IT-互联网专题网页链接:https://www.jianshu.com/c/V2CqjW?utm_medium=index-collections&utm_source=desktop通过观察,我们可以发现网页中的文章并没有分页,而是通过下拉滚动...

weixin_39618121的博客 461

Python爬虫实战 | 全面解析爬取简书热门文章

简书(jianshu.com)是中国知名的创作分享平台,涵盖文章、故事、技术干货等多样内容。平台每日产生大量高质量热门文章,爬取这些热门文章数据对于内容分析、推荐系统开发及数据挖掘都极具价值。本文全面介绍了使用Python爬取简书热门文章的过程,包括页面结构分析、反爬机制突破及代码示范。掌握这些技能后,能应对更多复杂动态网站的数据抓取。HTTP协议及浏览器行为JavaScript渲染与浏览器自动化数据清洗与分析技术爬虫框架(Scrapy、Splash等)

2201_76125261的博客 1187

Python爬虫获取简书的用户、文章、评论、图片等数据,并存入数据库

Python爬虫获取简书的用户、文章、评论、图片等数据,并存入数据库 爬虫定义:网络爬虫(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。(来源:百度百科——爬虫) 爬取原理:万维网由许多的url构成,犹如一张巨大的网。通过url并发送请求获取数据(html),最后解析提取所需数据即可。 实战演示:获取简书的用户、文章、评论、图片等数据,并存入数据库。 (1)网

Qian_Qian_IT的博客 1800

Python爬虫实战:利用最新技术高效爬取简书文章列表

本文将详细介绍如何使用Python最新技术栈构建一个高效的简书文章列表爬虫。我们将从爬虫基础知识讲起,逐步深入到高级技巧,包括异步IO、反反爬策略、数据存储优化等。本文提供了完整的代码实现,并详细解释了每个技术选择的理由。通过阅读本文,您将掌握一个现代化Python爬虫的完整开发流程。关键词:Python爬虫、简书、异步IO、反反爬、数据存储、aiohttp、Playwright、MongoDB网络爬虫(Web Crawler)是一种自动获取网页内容的程序,是搜索引擎的重要组成部分。

2201_76125261的博客 897

Python爬虫实战:利用最新技术高效爬取简书热门文章

本文将详细介绍如何使用Python最新技术栈构建一个高效、稳定的简书热门文章爬虫。我们将从爬虫基础原理讲起,逐步深入到反反爬策略、异步处理、数据存储等高级话题,最终实现一个完整的简书热门文章爬取系统。文章包含大量实战代码和最新技术应用,适合中高级Python开发者学习参考。关键词:Python爬虫、简书、异步爬虫、反反爬、数据存储网络爬虫(Web Crawler)是一种自动获取网页内容的程序,其核心工作流程包括:发送HTTP请求→获取响应→解析内容→存储数据。

2201_76125261的博客 969

简书博客列表爬取

主要介绍了爬取简书某一作者博客列表的实现。并阐述了在实现过程中遇见的问题以及解决方法。

fovever_的博客 661

Python爬虫实战:全面爬取简书关键词文章列表的技巧与代码解析

简书是中国知名的内容创作社区,聚集了大量高质量原创文章。对于研究内容分布、热门主题或进行内容推荐,批量采集简书关键词文章列表数据尤为重要。本文以“关键词文章列表”为切入点,系统讲解如何用Python实现简书文章批量爬取,涵盖从分析到实战,技术细节到反爬应对,帮助你搭建一个实用爬虫框架。本文基于Python,全面介绍了如何爬取简书关键词文章列表,涵盖网页结构分析、请求模拟、分页处理、反爬策略、代码实现和数据处理。后续可以深入探索异步爬虫、智能代理池、数据挖掘和机器学习建模,打造一体化的内容分析平台。

2201_76125261的博客 883

爬虫入门 - 爬取简书互联网前十页文章

在本文中,我们将介绍怎样使用Python爬取简书的文章。首先,我们需要用到Python中的一个网络爬虫框架——BeautifulSoup。它可以帮助我们方便地解析HTML和XML文档,从而获得文档中的内容。主要目的:2️⃣ 要求将各个功能模块封装为函数。

weixin_65123909的博客 1450

简书爬虫--python

简书爬虫 功能: 1、爬取简书分类下的文章内容,作者,评论,喜欢等数据 2、对简书用户进行数据分析 环境:python3+mysql数据库 使用到的技术: GUI(wxpython)+ socket网络编程 + 文件读写 + 爬虫(beautifulsoup) + 数据库 + 数据分析绘图(matplotlib)

爬取简书文章.zip

使用Scrapy+ Selenium+ChromeDriver爬取简书所有文章,然后存储到mysql数据库中,作为爬虫的练习。当然也可以用这些文章进行数据分析等等。 该压缩包有项目的完整源码和数据库的sql文件。读者可以直接使用。

python爬虫之爬取简书中的小文章标题

       学习了三个星期的python基础语法,对python语法有了一个基本的了解,然后想继续深入学习,但不喜欢每天啃书本,太无聊了,只有实战才是练兵的最好效果。听说爬虫技术还是比较好玩的,就搞爬虫,但找了好多资料没有找到合适的资料,最后才找到传说中的合适爬虫初学者的书籍《Python 3网络爬虫开发实战 ,崔庆才著》(文末附书本下载链接),学习了三天,终于完整搞出了自己的第一爬虫,哈哈~。...

scx2006114的博客 1万+

Python-scrapy实现爬取简书首页热门文章

scrapy实现爬取简书首页热门文章

简书python爬虫权威_使用 Python 爬取简书网的所有文章

image阅读文本大概需要 6 分钟。抓取目标我们要爬取的目标是「 简书网 」。打开简书网的首页,随手点击一篇文章进入到详情页面。image我们要爬取的数据有:作者、头像、发布时间、文章 ID 以及文章内容。准备工作在编写爬虫程序之前,我都是先对页面进行简单分析,然后指定爬取思路。由于我们爬取简书网所有的文章数据,所以考虑使用「 CrawlSpider 」来对整个网站进行爬取。首先使用 Scrap...

weixin_42315338的博客 232

Fluent VOF造波从入门到放弃?手把手教你用k-w SST模型搞定波浪模拟

本文详细介绍了使用Fluent VOF和k-w SST模型进行波浪模拟的实战技巧,从参数设置到结果优化,帮助用户避开常见误区。通过工业项目验证的配置方案,提升波浪模拟的准确性和计算效率,特别适合处理多相流和复杂湍流场景。

weixin_27102543的博客 422

机器学习系列(1)_逻辑回归初步

1、总述 逻辑回归是应用非常广泛的一个分类机器学习算法,它将数据拟合到一个logit函数(或者叫做logistic函数)中,从而能够完成对事件发生的概率进行预测。 2、由来     要说逻辑回归,我们得追溯到线性回归,想必大家对线性回归都有一定的了解,即对于多维空间中存在的样本点,我们用特征的线性组合去拟合空间中点的分布和轨迹。如下图所示:     线性回归能对连续值结果进行预测,

寒小阳 13万+

python2.7爬虫实例-Python2.7爬虫-爬取简书文章-入门

参考原文:分为五个模块:主模块、URL管理器、下载器、解析器、输出器。主模块首先调用URL管理器管理URL,接着将URL传给下载器,下载器发送请求到URL并得到响应数据,本例中除了第一次请求之外,再次请求时需要发送两个参数到服务器,将响应数据传给解析器解析出真正需要的数据,再将数据交给输出器输出。这里爬取的是简书的新上榜文章 http://www.jianshu.com/recommendati...

weixin_37988176的博客 299

一、数学建模层次分析法(AHP)【清风数学建模个人笔记】

层次分析法: 层次分析法主要用于解决评价类问题(例如:选择哪种方案更好、哪位员工、运动员等表现得更优秀) 评价类问题: 分析问题得出评判问题的子标,分别给不同子标赋予权重(权重和要为1) ...

m0_58882109的博客 1万+

使用python抓取简书的关键字专题下所有文章

import requests from bs4 import BeautifulSoup import time from selenium import webdriver def urls(url, headers): '''访问url并返回text''' u = requests.get(url, headers=headers) if u.status_cod...

YeLang 269

大疆精灵3无人机2.4GHz通信系统实测:跳频扩频技术深度解析

跳频扩频(FHSS)是一种经典的扩频通信技术,其核心原理是通过让载波频率在一个宽频带上按伪随机序列快速跳变,将窄带信号的能量扩散开来。这种技术能有效对抗固定频率干扰,提升通信的可靠性和抗截获性,在无线遥控、军事通信等领域具有重要价值。在无人机、物联网等对实时性与可靠性要求高的应用场景中,FHSS技术能显著增强复杂电磁环境下的链路鲁棒性。本文以频谱分析仪实测大疆精灵3无人机为例,深入剖析其2.4GHz频段遥控与图传系统的工作特性,揭示了其采用的成熟FHSS方案,包括约76MHz的总跳频带宽、39个信道及约2M

weixin_33935636的博客 310

STM32F4_LCD显示汉字

LCD显示汉字和显示图片、数字、字符的原理是一样的,都是将汉字、图片、数字以及字符转换点阵,进而通过函数扫描点阵在LCD上显示;

light_2025的博客 1万+

python写爬虫之提取网页的内容(筛选)_python写爬虫之提取网页的内容(筛选)

利用网络爬虫获取简单信息的基本步骤是:提取网页源码——>筛选内容——>保存内容一、提取网页源码取网页源码方法很多,常用的库有:urllib库,requests库等。。。 具体的例程可访问我的上篇文件:二、筛选内容在我的上篇文章里使用的筛选的方法是通过正则表达式完成,但正则表达式编写过程复杂,而且容易出错。在此篇文章中我向大家替换的方法,主要是应用库来代替正则表达式。①使用 XPath②使用 Bea...

weixin_39898150的博客 711

SWMM建模与案例应用

4、排水系统控制规则通过控制功能,可以在模拟进行过程中,通过条件判断,对闸门、水泵、管道、孔口、堰进行控制,实现排水系统实时控制。5、SWMM与其他模型对比分析分析:STORM、MOUSE、Info Works、SUSTAIN、SWC。1、模型初始设置主要参数:雨量计、汇水区、节点、出水口、管渠、分流器、蓄水池等参数前缀的设置。2、气象数据设置温度、蒸发、风速、融雪、面积亏损、气候调整、雨量计。1、多软件数据交互:CAD、Arcgis、SWMM。(1)节点、管段、水泵、孔口、堰、雨水口和街道。

m0_74575633的博客 3417
上一篇: c#实现的简单学生信息管理系统
下一篇: 2020-08-19
Cooooooooco
博客等级 码龄9年 32粉丝 10原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
