Google开源了LaserTagger,一种可加速文本生成的AI模型

text_data_enhancement_with_LaserTagger:Modify Chinese text, modified on LaserTagger Model. 文本复述,基于lasertagger做中文文本数据增强 LaserTagger 一.概述 文本复述任务是指把一句/段文本A改写成文本B,要求文本B采用与文本A略有差异的表述方式来表达与之意思相近的文本。 改进谷歌的LaserTagger模型,使用LCQMC等中文语料训练文本复述模型,即修改一段文本并保持原有语义。 复述的结果可用于数据增强,文本泛化,从而增加特定场景的语料规模,提高模型泛化能力。 二.模型介绍 谷歌在文献《Encode, Tag, Realize: High-Precision Text Editing》中采用序列标注的框架进行文本编辑,在文本拆分和自动摘要任务上取得了最佳效果。 在同样采用BERT作为编码器的条件下,本方法相比于Seq2Seq的方法具有更高的可靠度,更快的训练和推理效率,且在语料规模较小的情况下优势更明显。 谷歌公开了本文献对应的代码,但是原有任务与当前任务有一定的差异性,需要修改部分代码,主要修改如下: A. 立即下载

序列到序列AI模型由Google于2014年推出,旨在将固定长度的输入(通常是文本)与固定长度输出映射,其中输入和输出的长度可能会有所不同。它们被用于文本生成任务,包括摘要,语法错误纠正和语句合并,并且最近的体系结构突破使它们相比以前能够发挥出更大的作用。
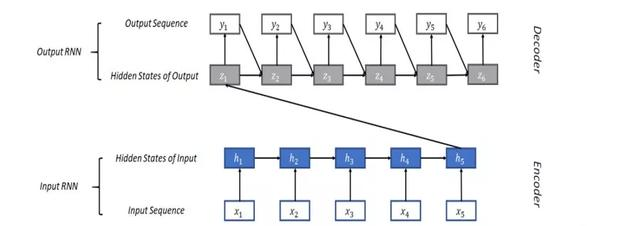
 

但是该模型本身并不完善,因为它们(1)需要大量的训练数据才能达到可接受的性能水平,(2)而且通常需要逐字生成输出(这会使它们固有地变慢)。这就是Google研究人员开发LaserTagger的原因,LaserTagger是一种开放源代码的文本编辑模型,该模型可以预测将源文本转换为目标文本的一系列编辑操作。研究人员宣称LaserTagger以一种不易出错的方式处理文本生成,并且更易于训练和执行。

github地址:https://github.com/google-research/lasertagger论文地址:https://arxiv.org/pdf/1909.01187.pdf

LaserTagger的发布紧随Google在自然语言处理和理解领域做出的杰出贡献。上周,这家科技巨头推出了Meena聊天机器人模型。
 

Meena是一个具有26亿个参数的端到端训练的神经网络对话模型。根据Google的说法,Meena经过30天的训练,使用了2,048张量处理单元(Google专用的AI专用芯片),数据集为400亿个单词(不是随机的)。Google挖掘了公共领域的社交媒体,以进行“多回合对话”,其中“回合”指的是对话中的一对短语。

然而即使Google开源了Meena的代码,也只有少数机构能够训练类似Meena的模型。目前Meena仍停留在实验室阶段,并且管理起来非常复杂,还不能被合并到工具中,Google也不太可能很快将其作为服务推出。


LaserTagger的开发是基于以下情况:对于许多文本生成任务,输入和输出之间经常存在重叠。例如,在检测和纠正语法错误或融合多个句子时,大多数输入文本是可以保持不变的,只需要修改其中一小部分单词。然后,LaserTagger会产生一系列的编辑操作,而不是实际的单词,例如keep(将单词直接复制到输出),delete(删除单词),以及keep-addx(在标记前添加短语X)和delete-addx(删除已标记的字)。


添加的短语来自受限制的词汇表,该词汇表已经过优化,可以最大程度地减少词汇量,并增加训练示例的数量。添加到目标文本的唯一必要单词仅来自词汇表,从而避免了模型添加任意单词的问题,并减少了产生输入文本不支持的输出的情况发生。此外,LaserTagger还可以高精度地并行预测编辑操作,与按顺序执行预测的模型相比,可以实现端到端的加速。

谷歌的开发者对多个文本生成任务进行了评估,LaserTagger在使用大量训练示例的基准模型上表现出“相当强大”的性能,并且比序列到序列模型速度快100倍。即使仅使用几百或几千个培训示例进行训练,它也会产生“合理”的结果,可以手动编辑或整理。


该团队称:“ LaserTagger的优势在大规模应用时会变得更加明显,例如,通过减少响应时间并减少重复性,改进了某些服务中语音应答的格式。高推理速度使该模型可以插入现有技术堆栈中,而不会在用户端增加任何明显的延迟,而改进的数据效率可以收集多种语言的训练数据,从而使来自不同语言背景的用户受益。”

文章采集伪原创批量生成工具 很好用的,不懂问软件开发者,记住要先安装 Set Up.exe,然后才能运行工具。 立即下载

相关推荐

速奇原创文章生成软件(免费原创文章生成器)V1.1.1 绿色中文版

速奇原创文章生成软件(免费原创文章生成器)是一款绿色小巧的远程文章生成工具。速奇原创文章生成软件功能强大,操作简单,为SEO优化者提供高质量原创内容生成服务,快速提升搜索引擎收录和关键词排名。

Lasertagger的理解及在标题生成任务中的python实践

Lasertagger出自论文Encode, Tag, Realize: High-Precision Text Editing,本文提供了一种简单的实现思路,并开源在https://github.com/hanggun/lasertagger-chinese   文章一共提出了2种模型结构,分别为LasertaggerARLasertagger_{AR}LasertaggerAR​和LasertaggerFFLasertagger_{FF}LasertaggerFF​,其主要区别点在于解码器的不同。...

algorithm learning blog 577

做一个有想法的AI | 用LaserTagger做NLP的文本复述任务-附件资源

做一个有想法的AI | 用LaserTagger做NLP的文本复述任务-附件资源

python文本数据增强_(中文)文本复述任务实现,用于NLP语料的数据增强

LaserTagger一.概述文本复述任务是指把一句/段文本A改写成文本B,要求文本B采用与文本A略有差异的表述方式来表达与之意思相近的文本。改进谷歌的LaserTagger模型,使用LCQMC等中文语料训练文本复述模型,即修改一段文本并保持原有语义。复述的结果可用于数据增强,文本泛化,从而增加特定场景的语料规模,提高模型泛化能力。二.模型介绍谷歌在文献《Encode, Tag, Realize:...

weixin_39800112的博客 1528

ε-差分隐私之拉普拉斯噪声机制(定义 + 证明 + 代码)

ε-差分隐私之拉普拉斯噪声机制 差分隐私的描述 1-范式的定义:使用matlab调用函数norm(x, 1) 更多范式见 范式 差分隐私的定义应该满足 拉普拉斯噪声的证明全过程如下: DP方向差分隐私证明是基本入门!!! -拉普拉斯噪声分布代码 Laplace分布的概率密度函数的形式是: 使用python - matplotlib来绘制概率分布图: import matplotlib.pyplot as plt import numpy as np def laplace_fun

毕业才是起点 1万+

YOLOv8模型RKNN量化策略与RK3588部署实战解析

本文详细解析了YOLOv8模型在RK3588平台上的RKNN量化策略与部署实践。通过对比INT8和FP16量化方式的性能差异,结合实际测试数据,为开发者提供了从模型导出、转换到板端部署的完整解决方案,帮助实现高效的边缘AI应用部署。

oil88的博客 1092

YOLO v5 实现目标检测(参考数据集&自制数据集)

YOLO v5 实现目标检测(参考数据集&自制数据集) Author: Labyrinthine Leo   Init_time: 2020.10.26 GitHub: https://github.com/ultralytics/yolov5 Index Words: Object Detection、YOLO v5、YOLO Series 1、引言 1.1、写作动机 由于博主当前的研究问题涉及到图片的局部图像提取,于是决定使用目前比较流行且高效的目标检测网络框架YOLOv5(虽然其沿

风雨_寒的博客 2万+

ML307A模组连接ONENET平台(AT指令步骤教程)

ML307A 是一款集成度高、体积小的物联网通信模组,支持多种无线通信协议,如 LoRa、NB-IoT 等。它具有低功耗、远程通信等特点,适用于多种物联网场景。支持 LoRa 和 NB-IoT 等多种无线通信标准。提供丰富的 GPIO 接口。内置多种传感器支持。UART 接口:用于与微控制器或其他设备通信。GPIO 接口:可以连接外部传感器或执行器。电源接口:用于供电。OneNET 是中国移动推出的一款物联网开放平台,它提供了从数据采集、存储到分析的一站式解决方案。

xiewengeng的博客 5481

LaserTagger:中文文本复述的利器

LaserTagger:中文文本复述的利器 项目介绍 LaserTagger 是一个基于谷歌开源的文本编辑模型改进而来的中文文本复述工具。文本复述任务旨在将一段文本A改写成文本B,同时保持B与A的语义一致,但表述方式略有不同。这种技术在数据增强、文本泛化等领域有着广泛的应用,能够有效提升特定场景下的语料规模和模型泛化能力。 本项目在谷歌的LaserTagger模型基础上,针对中文语料进行了优化,使...

gitblog_00007的博客 523

STM32F407+LWIP实战:手把手教你移植mbedtls库实现Modbus TCP双向认证

本文详细介绍了如何在STM32F407微控制器上移植mbedtls库,结合LWIP协议栈实现Modbus TCP的双向认证功能。通过TLS 1.2加密通道,有效提升工业物联网通信的数据安全性,涵盖证书管理、内存优化及性能调优等关键步骤,为嵌入式系统开发者提供了一套完整的解决方案。

weixin_28721917的博客 516

lego-loam featureAssociation 源码注释(五)

上一次我们已经看完了特征提取,这次我们进入特征匹配的内容!!!systemInitedLM的初始值为false。

Joeybee的博客 889

如何高效规划和执行营销活动:Marketing-for-Engineers的终极指南

Marketing-for-Engineers是一个精心策划的营销文章和工具集合,旨在帮助工程师和产品团队有效规划和执行营销活动,实现产品增长目标。本指南将详细介绍如何利用该项目资源,从活动策划到落地执行的完整流程。 [![Marketing-for-Engineers项目封面图](https://raw.gitcode.com/gh_mirrors/ma/Marketing-for-Engin

gitblog_01066的博客 371

网络层隧道技术之ICMP隧道(pingTunnel/IcmpTunnel)

目录 ICMP隧道 使用ICMP搭建隧道(PingTunnel) 使用ICMP搭建隧道(Icmptunnel) ICMP隧道 ICMP隧道简单实用,是一个比较特殊的协议。在一般的通信协议里,如果两台设备要进行通信,肯定需要开放端口,而在ICMP协议下就不需要。最常见的ping命令就是利用的ICMP协议,攻击者可以利用命令行得到比回复更多的ICMP请求。在通常情况下,每个ping命令都有相...

谢公子的博客 6696

终极Task性能优化指南:10个技巧让构建速度提升300%

Task作为一款现代化的快速构建工具,专为现代工作流设计,能够显著提升开发效率。如果你正在寻找Task性能优化的实用技巧,那么这篇文章将为你揭示10个让构建速度提升300%的终极方法。无论你是新手还是经验丰富的开发者,这些优化技巧都能帮助你的Task构建过程达到极致速度。🚀 ## 📊 Task性能优化的核心原则 Task构建工具的优化主要围绕三个核心原则:**并行化执行**、**智能缓存策

gitblog_00037的博客 412

【WRF后处理】基于wrf-python处理wrf运行结果wrfout_d01

基于wrf-python处理wrf运行结果wrfout_d01

WW、forever的博客 5209

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

京东智能客服言犀意图体系搭建和意图识别技术介绍

01 背景介绍近年来随着人工智能技术的不断发展,以及各行业内部系统对智能化需求的日益增大,智能客服机器人服务水平大幅提升,越来越多的企业开始建立自己的智能客服产品,尤其是一些中大型企业。搭建一款智能客服机器人需要哪些技术储备,其中的核心环节有哪些,成为各个商家需要回答的问题。京东于2012年在京东商城上线智能客服,并于2020年11月25日在JDDiscovery-202...

京东科技开发者 9652

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

NLP复述模型

方案一:seq2seq端到端生成 数据来源:相似句数据:https://github.com/zejunwang1/CSTS 效果:2层transformer, 生成bleu=37.7, 缺点:语句不通顺 示例: 句子不通顺,句子片段不通: source: = 我跟您说的是这么一件事。 target = 对了,我有话要跟您说。 predict = 我您, 我说 什要跟您说。 source: = 不,最好把这些东西扔到什么地方去。 target = 不,最好是出去一趟,把这些东西一齐扔掉。 predict

weixin_36378508的博客 989

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

谷歌开源文本生成新方法 LaserTagger,直击 seq2seq 效率低、推理慢、控制差三大缺陷!

目前,在序列到序列( seq2seq )的自然语言生成任务中,主流预训练模型仍然面临一些重大缺陷,例如:生成输出与输入文本之间长度匹配问题、需要大量训练数据才能实现较高性能、推断速度慢等。 因此,Google 提出了一种新型的文本生成模型 LaserTagger,该模型旨在解决 seq2seq 模型运行过程中的上述缺陷,可以预测将将源文本转换为目标文本的一系列生成操作。Google 发布了相关文...

喜欢打酱油的老鸟 1078

推断速度达seq2seq模型的100倍,谷歌开源文本生成新方法LaserTagger

选自arXiv作者:Eric Malmi等机器之心编译序列到序列(seq2seq)模型给机器翻译领域带来了巨大变革,并成为多种文本生成任务的首选工具,如文本摘要、句子融合和语法纠错。模型...

机器学习算法与Python学习 947

基于编辑方法的文本生成(下)

点击下面卡片,关注我呀,每天给你送来AI技术干货!来自:哈工大讯飞联合实验室上一期介绍了在文本生成任务中引入编辑方法,以及Google Research的两篇工作——LaserTagger...

zenRRan的博客 1023

语法纠错的研究现状

引言语法纠错(Grammatical Error Correction, GEC)是自然语言处理领域中的一个重要任务,GEC任务要求检测一句话中是否有语法错误,并自动将检测出的语法错误进行纠正,GEC在文本校对、外文学习辅助中都有重要的应用。下面是一个语法纠错任务的示例,在这句话中,加粗的形容词absolute应该修改为副词absolutely。目前语法纠错任务主要是采用类似于机器翻译任务的Seq2Seq框架来实现的。具体来说,输入的错误句子为源语句,输出正确的句子为目标语句。例如下图中,“A B C D”

CSer 4241

Python加载json格式超参数配置

谷歌提出的BERT、lasertagger等项目都提供了json形式配置文件,利用python的json工具可以快速加载这种形式的配置文件,方便地实现超参数与模型代码的分离。 一、配置文件 配置文件lasertagger_config.json的内容如下: { "attention_probs_dropout_prob": 0.1, "hidden_act": "gelu", "hid...

u010404548的博客 1125

清华华为发布“万词王”反向词典系统,入选AAAI 2020

本文部分内容源自清华大学计算机系在读博士岂凡超在AI科技评论发布的:话到嘴边却忘了?这个模型能帮你 | AAAI 2020。会议之眼参考论文对模型框架、背景知识以及数据来源、评测部分进行了补充。 岂凡超 论文简介和摘要 《Multi-channelReverse Dictionary Model》是由清华大学、华为诺亚方舟合作的论文。该论文已经被AAAI 2020录用。 ...

ConferenceEye的博客 6577
上一篇: 被苹果、字节、谷歌、亚马逊推荐的数据挖掘顶会WSDM今日召开,还不快去学习
下一篇: 5G和边缘计算助力零售业走入快车道!
会议之眼
博客等级 码龄7年 1164粉丝 226原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值