四、机器学习基础概念介绍

情感脑机接口与跨被试情感模型问题研究 情感脑机接口与跨被试情感模型问题研究综述基于最大分类器差异域对抗方法的跨被试脑电情绪识别研究引言部分关键要点提取MCD_DA 模型解读数据集创建以及处理模型训练步骤实验结果 基于最大分类器差异域对抗方法的跨被试脑电情绪识别研究 论文发表杂志:生物医学工程学杂志 论文发表日期:2021年6月 这篇文章为了解决跨被试,跨时间情绪分类的问题,提出了最大分类器差异域对抗方法(MCD_DA),通过建立神经网络情感识别模型,将浅层特征提取器分别对抗域分类器和情感分类器,进而使特征提取器产生域不变表达,在实现近似联合分 阅读详情

1_机器学习基础概念

机器学习一般可以分为训练和测试两个步骤。
训练:让模型学习数据的特点。
测试:让模型对新的数据进行预测,对比预测结果与实际结果之间的差异。
训练集:这批数据是供模型学习使用。
测试集:这批数据是供模型测试使用。
一般情况训练集和测试集是完全不相同的,训练集和测试集发生重叠是一个严重错误!

机器学习分类

1)按照学习方式

  • 有监督学习:训练数据包含了数据本身及其对应的标签。每个训练数据都有一个明确的标识或结果。
  • 无监督学习:训练数据只包含数据本身,不包含对应的标签。例如通过聚类算法对很多段EEG信号进行聚类分析。模型能够自主的学习到一些数据的特点。(通常缺乏先验知识,因此难以对数据进行标注或者标注成本太高)
  • 半监督学习:部分训练数据有标签,部分训练数据没有标签。
  • 强化学习:强化学习的标签可以不是一个明确的标识或结果。 一般是一个反馈或者奖励。

2)按照算法的原理

  • 传统的机器学习(不包含任何人工神经网络结构,此文章的重点)
  • 深度学习

1.1 有监督学习

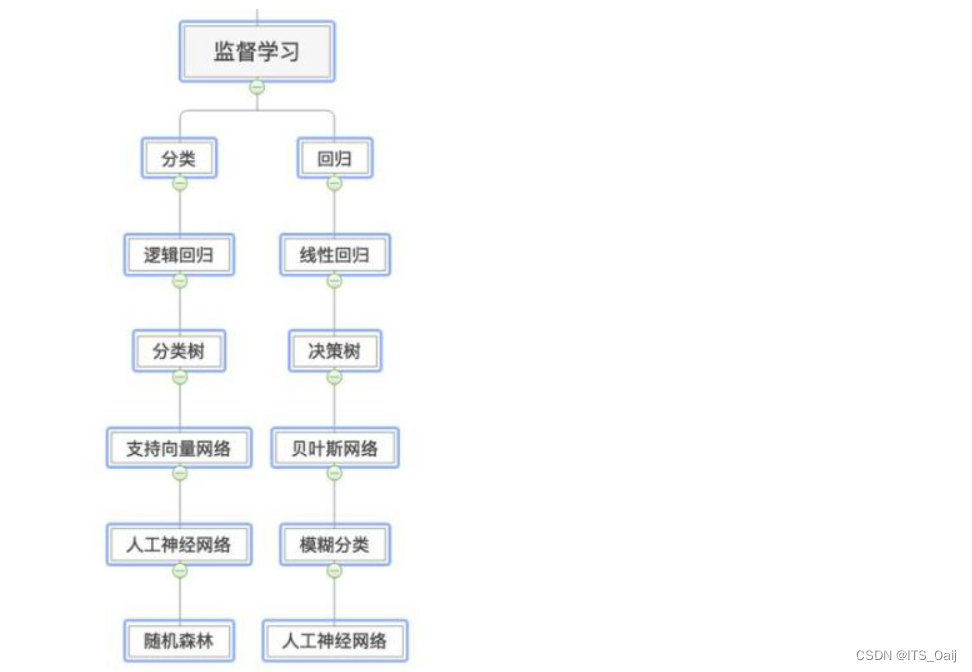
监督学习一般解决两个问题:分类和回归
1) 分类和回归是做什么的

  • 无论是分类还是回归,其本质都是对输入进行预测,都是有监督学习。
  • 分类是根据输出得到一个分类的类别,而回归是根据输出得到一个具体的值。

2)分类和回归的区别

  • 分类问题的输出的物体所属的类别,而回归问题的输出是物体的值。
  • 分类问题的输出是离散值(0,1,2,3,…),回归问题输出的是连续值(36.7,36.8,…)
  • eg:输入是一堆气象数据:
    如果输出是具体的天气情况:雨天?晴天?阴天? —分类—
    如果输出是具体的温度? —回归—

3)有监督学习有哪些
在这里插入图片描述

1.2 无监督学习

无监督学习一般解决两个问题:聚类和降维
1)聚类

  • 在无监督学习中,数据不会带有任何标签。将这些无标签数据分成N个分开点集(称为簇)的算法,就被称为聚类算法。
  • 常用聚类算法:K均值聚类和层次聚类
  • 聚类和分类的区别:分类是有标签的,每个物体有其具体的明确的归属。而聚类是没有标签的,根据算法不同可能会得到不通过的结果。

2)降维

  • 采用某种映射方法,将原高维空间中的数据点映射到低维度的空间中。
  • 降维是对数据本身处理,不需要标签。
  • 常用降维算法:PCA、张量分解。

2_有监督机器学习—常见评估方法

常见的评估方法有:留出法、校验验证法和自助法

数据集的划分

  • 第一种:训练集和测试集(不建议适用)
  • 第二种:训练集、验证集和测试集(正确的数据集划分方法)

训练集——学生的课本;学生 根据课本里的内容来掌握知识。
验证集——作业,通过作业可以知道 不同学生学习情况、进步的速度快慢。
测试集——考试,考的题是平常都没有见过,考察学生举一反三的能力。

正确做法: 在训练集上训练模型,在验证集上评估模型(对模型进行参数调整),最后在测试集上测试模型。

2.1 留出法

  • 将数据集D分割为两个互斥的集合:训练集S和测试集T。
  • 其中训练集S还可以进一步划分为训练集S1和验证集V。
  • 数据集划分完毕后,直接在训练集S上训练模型,在验证集S1上评估模型,在测试集T上测试模型即可。

一般情况下,会选择20%左右的数据作为测试集。
缺点:数据选择随机,结果的方差比较大

2.2 校验验证法(重点方法)

校验验证法:能充分利用数据集,但不适用于特别大的数据集

  • 一般分为:简单交叉验证,留一法交叉验证和K折交叉验证
  • 其中,K折交叉验证(单独流出测试集)(该方法为常用方法,Sklearn的默认方法)

简单交叉验证

  • 将样本全部打乱,随机的将样本数据集分为互斥的两个部分:训练集和测试集。其中训练集还可以划分为训练集和验证集。
  • 通过训练集训练模型,通过验证集选择模型参数,在测试集上评估模型的分类率。
  • 接着重新把样本数据打乱,重新划分训练集和测试集。重复上述过程若干次,此时将会得到若千个分类率。
  • 选择最大的分类率作为最终分类率。

等价于将留出法重复n次,通常用于模型预筛,可作为论文中探讨模型选择的一部分。

K折交叉验证(单独流出测试集)(常用方法/Sklearn的默认方法)

  • 将样本全部打乱,随机从样本数据集划分出互斥的两部分:训练集和测试集。从训练集D分类K大小相似的互斥子集。
  • 每次选用K-1个子集作为训练集,余下的那个子集作为验证集。这样就得到了K组训练/验证集,从而可以进行 K次训练和验证,可以返回K个模型。
  • 在测试集上分别对K个模型进行测试得到分类率,最终K次测试中分类率的均值作为最终分类率。

在这里插入图片描述k为几就是几折交叉验证,通常五折/十折。

k折交叉验证(不单独留出测试集)

在这里插入图片描述

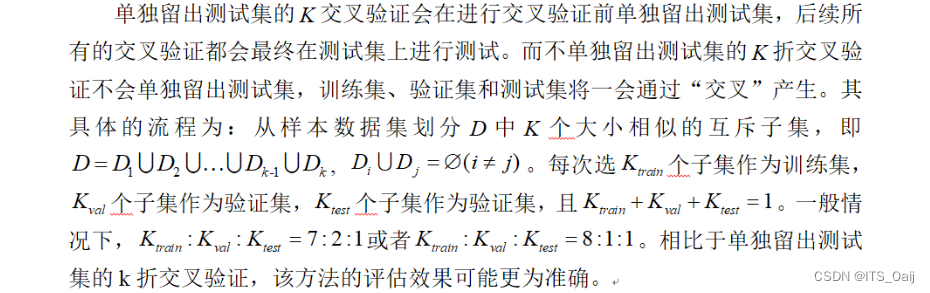
  • 单独留出测试集的交叉验证会在进行交叉验证前单独留出测试集,后续所有的交叉验证都会最终在测试集上进行测试。
  • 而不单独留出测试集的折交叉验证不会单独留出测试集,训练集、验证集和测试集将一会通过“交叉”产生。
  • 数据量比较多,10折。10000个样本,

留一法交叉验证

  • 当K折交叉验证中的K与样本个数N相等时,此时该验证方法被称为“留一法”。
  • 理论上,留一法对数据的利用最为充分,其结果最接近实际的结果。如果样本数据比较大,会带来极大的计算量,因此留一法一般只适用于小样本量数据集。最终K个模型分类率的均值作为最终分类率。
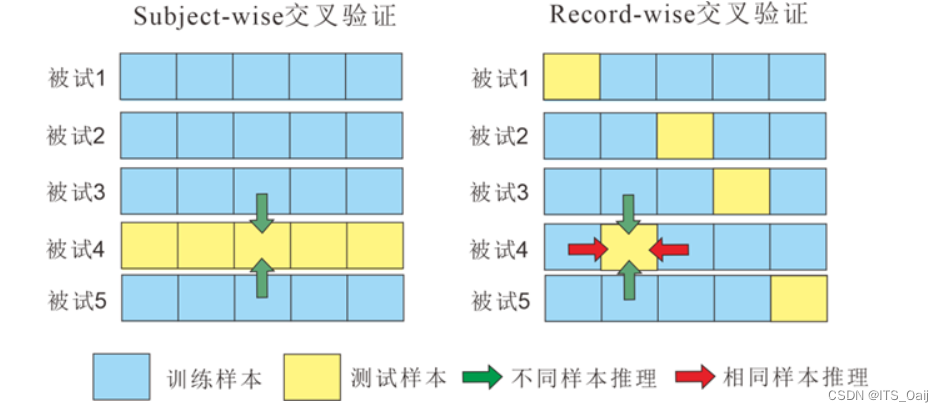
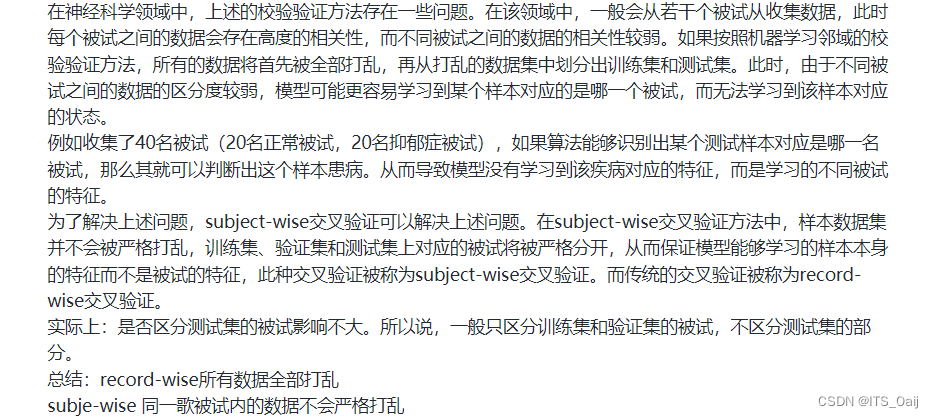
  • 注意:在神经科学领域,一般使用留一被试法
  • 留一被试法:将同一个被试的所有的样本视为一个特定的集合,每次选择一个被试的样本作为测试集,其他被试的样本作为训练集。

Subject-wise交叉验证
在这里插入图片描述在这里插入图片描述

2.3 bootstrap自助法

3_ 有监督机器学习—学习评价指标

3.1 准确率(Accuracy)
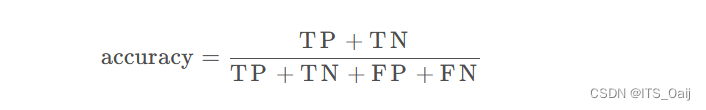
在这里插入图片描述
准确率能够清晰的判断我们模型的表现,但有一个严重的缺陷: 在正负样本不均衡的情况下,占比大的类别往往会成为影响 Accuracy 的最主要因素,此时的 Accuracy 并不能很好的反映模型的整体情况。
例如,一个测试集有正样本99个,负样本1个。模型把所有的样本都预测为正样本,那么模型的Accuracy为99%,看评价指标,模型的效果很好,但实际上模型没有任何预测能力。

混淆矩阵

TP = True Postive = 真阳性; FP = False Positive = 假阳性
FN = False Negative = 假阴性; TN = True Negative = 真阴性
比如我们一个模型对15个样本进行预测,然后结果如下。
真实值:0 1 1 0 1 1 0 0 1 0 1 0 1 0 0
预测值:1 1 1 1 1 0 0 0 0 0 1 1 1 0 1
在这里插入图片描述

3.2 精确率(Precision)

精度(precision, 或者PPV,,positive predictive value) = TP / (TP + FP)
在上面的例子中,精度=5/(5+4)= 0.556
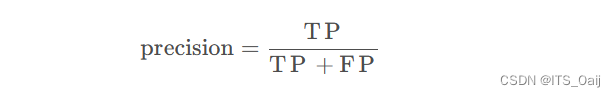
在这里插入图片描述

3.3 召回率(Recall)

·召回(recall,或者敏感度,sensitivity,真阳性率,TPR,True Positive Rate)= TP /(TP +FN)
在上面的例子中,召回=5/(5+2) = 0.714
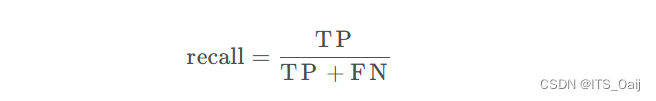
在这里插入图片描述

3.4 特异度(Specificity)

特异度(specificity,或者真阴性率,TNR,True Negative Rate) = TN / (TN + FP)
在上面的例子中,特异度 = 4 / (4+2) = 0.667

3.5 F1-值(F1-score)

F1-值(F1-score) = 2TP / (2TP+FP+FN)
精确率和召回率是一对矛盾的指标,因此需要放到一起综合考虑。F1-score是精确率和召回率的调和平均值。
相对于ACC的优势:能够同时表明模型对正负样本的预测能力
在上面的例子中,F1-值 = 25 / (25+4+2) = 0.625
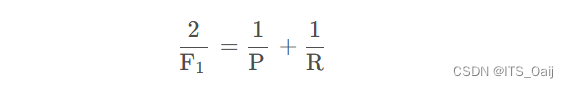
在这里插入图片描述

  • 敏感度和特异度有何用?
    特异度(specificity),TNR,即它反映筛检试验确定非病人的能力。
    敏感度(sensitivity,召回率),TPR,即它反映筛检试验确定病人的能力。
    敏感度高=漏诊率低,特异度高=误诊率低。
    例如:核酸检测允许比较高的误诊率,但漏诊率低一定要很低。

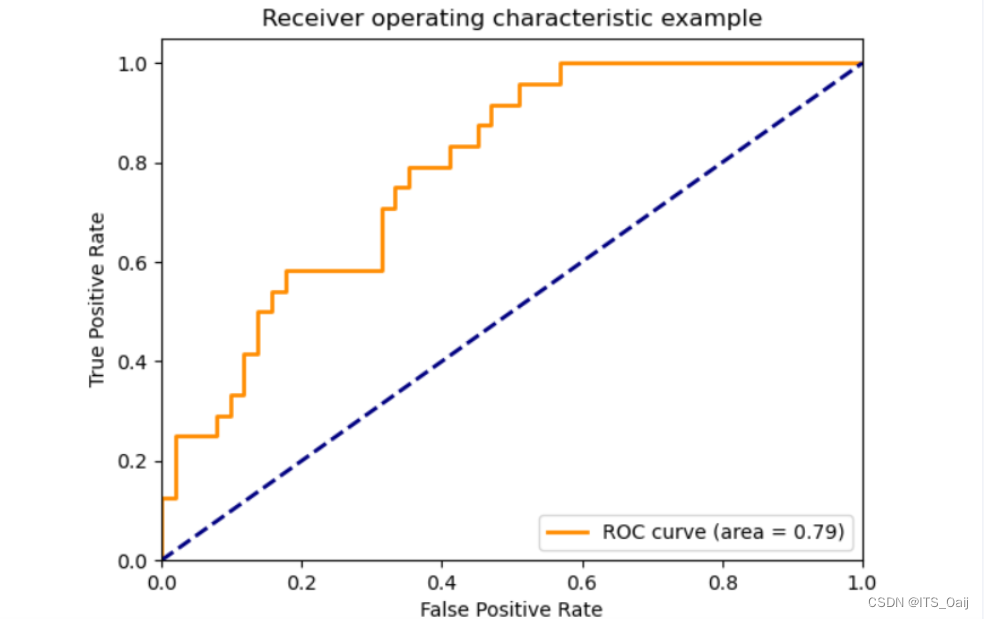
3,6 ROC曲线

ROC曲线(横轴:FPR;纵轴:TPR)该曲线越接近左上角越好
TPR = TP / (TP+FN); 真阳率
FPR = FP / (FP + TN); 伪阳率
在这里插入图片描述

3.7 AUC面积

AUC(ROC与坐标轴围成图像的面积)
AUC = 1,是完美分类器。
AUC = [0.85, 0.95], 效果很好
AUC = [0.7, 0.85], 效果一般
AUC = [0.5, 0.7],效果较低,但用于预测股票已经很不错了
AUC = 0.5,跟随机猜测一样(例:丢铜板),模型没有预测价值。
AUC < 0.5,比随机猜测还差;但只要总是反预测而行,就优于随机猜测。

3.8 PR曲线

(仅供了解,横轴是recall,纵轴是precision,越接近右上角越好)

【AI】用iOS的ML(机器学习)创建自己的AI App 在机器学习中,一切都始于模型,这是进行预测或识别的系统。教计算机学习涉及使用训练数据的机器学习算法进行学习。从训练中生成的输出通常称为机器学习模型。有不同类型的机器学习模型来解决同一个问题(例如对象识别),但使用不同的算法。是其中一些机器学习算法。 阅读详情

相关推荐

人工智能AI 与 机器学习ML 的关键区别

人工智能(AI)是指计算机系统能够执行通常需要人类智能才能完成的任务。包括理解自然语言、识别图像、解决复杂问题和做出决策。AI的目标是创建能够模仿或超越人类智能的系统。弱人工智能(弱AI):也称为窄AI,专注于特定任务。例如,语音助手(如Siri和Alexa)和推荐系统(如Netflix和Amazon的推荐算法)。强人工智能(强AI):也称为通用AI,具有执行任何人类智能任务的能力。目前,强AI仍处于理论阶段,尚未实现。机器学习(ML)是人工智能的一个子领域。

王教主的博客 5944

基于稀疏表示的分类方法 Sparse Representation based Classification Method

文章来源 Jia K, Chan T H, Ma Y. Robust and practical face recognition via structured sparsity[J]. Computer Vision–ECCV 2012, 2012: 331-344.Highlight 作为一种 sparse representation based classification method(S

Jingyang.Zhang的博客 1万+

在 Azure ML 上用 .NET 跑机器学习

.NET ML 你在用了吗?

Kinfey 4410

机器学习: t-Stochastic Neighbor Embedding 降维算法 (一)

Introduction 在计算机视觉及机器学习领域,数据的可视化是非常重要的一个应用,一般我们处理的数据都是成百上千维的,但是我们知道,目前我们可以感知的数据维度最多只有三维,超出三维的数据是没有办法直接显示出来的,所以需要做降维的处理,数据的降维,简单来说就是将高维度的数据映射到较低的维度,如果要能达到数据可视化的目的,就要将数据映射到二维或者三维空间。数据的降维是一种无监督的学习过程,我们

Matrix-11 9330

初学者入门机器学习 (ML)的推荐教程

了解基本的机器学习概念并不难。有大量免费的在线博客文章、视频和编码教程可以引导您了解基础知识——从介绍性内容到常见应用程序,再到算法和应用技能。这篇文章总结了一些用于介绍 ML 的最佳免费选项。它按逻辑顺序排列,每个概念都建立在上一个概念的基础上。

u010542847的博客 4626

ML Compiler入门及相关概念介绍

简单介绍ML编译器,以及IR等相关概念

qq_43527718的博客 911

深度学习+EEG:一种采用单通道EEG检测被试注意力状态的卷积神经网络构架

脑机接口(BCI)系统可以记录并处理大脑信号并将其转换为输出命令,其可用于各种应用场景,如辅助技术,神经康复和认知增强等。在各种用于脑信号记录的技术中,脑电图(EEG)是BCI研究中研究最多的方法。而基于EEG的认知BCI,旨在评估和增强诸如注意力等认知功能。 之前的研究更多的关注于选取合适的特征,以将其用来对注意力程度进行分类。用于监视专注精神状态的现有技术方法主要与EEG频带中的特定频段有关。大量的研究调查了注意力引起的beta,alpha 和不同频段之间能量比值的变化。总体而言,很多研究认为像beta

悦影科技 5034

SwiftUI机器学习基础之Create ML app 是什么

Create ML app 是什么 Create ML app是一个macOS应用程序,允许您使用界面方式构建机器学习模型。Create ML app是在WWDC 2019中引入的,它是Create ML框架的后续版本。它提供了一种面向任务的模型构建方法。 Create ML框架是一个Swift框架,可让您使用Xcode并使用Swift代码创建机器学习模型。另一方面,Create ML应用程序根本...

iCloudEnd的博客 1771

Unity 机器学习(ML-Agents) 基础

Unity 机器学习 ML-Agents 基础Unity 官方示例下载ML-Agents 部分Python 下载AnacondaAnaconda 虚拟环境构建 ML-Agents安装 ML-Agents Python 包安装 ML-Agents 包ML-Agents 入门指南Unity Hub 部分虚拟环境 训练虚拟环境 训练运行:虚拟环境 开始训练:虚拟环境 观察训练进度:虚拟环境 停止训练虚拟环境 恢复训练虚拟环境 训练模型ML-Agents 打造新的学习环境ML-Agents 资产导入 Unity 官

Maddie_Mo的博客 1万+

Unity中的机器学习ML-Agents

一:介绍 二:搭建环境 ——升级Python版本 因为mac自带的是python2.7.X的版本, 查看当前python版本:python -V ——搭建Python环境 安装Anconda:https://www.anaconda.com/products/individual

L的博客 8351

机器学习ML.NET

是用于 .NET 的跨平台开源机器学习 (ML) 框架。ML.NET 允许开发人员在其 .NET 应用程序中轻松构建、训练、部署和使用自定义模型,而无需开发机器学习模型的专业知识或使用 Python 或 R 等其他编程语言的经验。该框架提供从文件和数据库加载数据,支持数据转换,并包含许多 ML 算法。借助 ML.NET,您可以针对(如分类、预测和异常检测)训练模型。您还可以在 ML.NET 中使用 TensorFlow 和 ONNX 模型,这使得框架更具可扩展性,并扩展了支持的方案数量。

A_nanda的博客 5527

ML.NET 机器学习实用指南(一)

机器学习(ML)在许多行业中得到广泛应用,如科学、医疗保健和研究,其受欢迎程度仍在不断增长。2018 年 3 月,微软推出了 ML.NET,以帮助.NET 爱好者与机器学习(ML)进行工作。通过这本书,你将探索如何使用 C#代码构建 ML.NET 应用程序,并使用各种 ML 模型。本书首先为你概述了机器学习和使用的 ML 算法类型,同时介绍了 ML.NET 是什么以及为什么需要它来构建 ML 应用程序。然后,你将探索 ML.NET 框架、其组件和 API。本书将作为一本实用指南,帮助你使用 ML.NET 库

龙哥盟 3001

Automatic-Subject-Wise-Corpus-Creation:一个小脚本,该脚本使用数据挖掘来给定主题或关键字,以创建基于文本的语料库

自动主题明智的Corpus创建 通过使用数据挖掘(BeautifulSoup)从给定的关键字或主题创建数据集或语料库的Python脚本,可使用该关键字从Google搜索的首页链接中获取内容。 创建一个脏的,半结构化的语料库。 尚不能保证语料库中的所有数据都与给定主题100%相关。 待办事项:清理bs4_urlcrawlgoogle.py生成的原始数据集,并尝试查看是否有任何方法仅保留相关数据。

机器学习基础【ML】

机器学习基础【ML】

sikh_0529的博客 2万+

易康eCognition9.0分类|规则集和机器学习的方法的面向对象的多尺度分割分类

基于易康eCognition9.0软件的规则集和机器学习的方法的面向对象的多尺度分割分类

weixin_46493028的博客 1万+

ERGM指数随机图模型全解析:从基础原理到R语言实操

从社交网络中的互惠、传递性和同质性等基本现象切入,介绍网络数据与传统回归分析的本质差异——边与边之间的依赖关系。指数随机图模型(ERGM)正是为刻画这种依赖结构而设计的统计框架,它通过指数族分布将网络结构效应显式建模,结合MCMC方法完成参数估计。ERGM在组织协作、传播扩散、生物生态等领域的应用日益广泛,其扩展模型TERGM、GERGM和多层ERGM进一步支持时序、权重与多重关系网络。本文系统梳理ERGM的理论基础、核心统计量、扩展模型选型及R语言实操要点,帮助研究者理解网络生成机制并完成收敛性诊断与结果

weixin_29050271的博客 365

ML Collections的介绍(一)

ML Collections的介绍(一) 在看一篇论文的源码时,看到import ml_collections这行代码,系统报错,经过寻找之后发现并不是源码中的一个文件,之后感觉应该是一个深度学习的安装包,然后就在网上搜索这个包的安装过程,却没有任何信息,于是自己直接尝试了pip install ml-collections,于是就安装成功了。今天在github上搜索了这个安装包,潜心学习了一下。 ML Collections ML Collections是为ML use cases而设计的一个Python

weixin_47066348的博客 1万+

S32K144 LPI2C Master/Slave模式配置与多设备通信实战

本文详细介绍了NXP S32K144微控制器中LPI2C模块的主从模式配置与多设备通信实战。内容涵盖硬件连接、引脚配置、主从模式深度设置、中断/DMA应用,并通过AT24C16 EEPROM、SHT30传感器等实例,解析了多设备通信中的地址切换、时序控制及常见问题排查技巧,帮助开发者高效实现基于LPI2C的稳定通信。

weixin_29158047的博客 269

机器学习ml_机器学习简介(ML)

Here you will get introduction to machine learning. 在这里,您将获得机器学习的介绍。 Hello there. Many of you must be aware of this term but some might be wondering what the heck is this? Another technical jargon o...

culing2941的博客 5416

2025.06.25【微生物】|Emu工具安装与使用详解:全长16S扩增子微生物丰度分析

Emu是一款基于贝叶斯方法的微生物多样性分析工具,专为处理高错误率的长读长16S/18S扩增子数据优化。本文详细介绍了Emu的安装与使用方法:1)通过conda创建独立环境并安装Emu;2)提供SILVA等预构建数据库的下载指南,并说明自定义数据库的构建方法;3)演示单样本和多样本分析流程,解读关键输出文件;4)介绍丰度表合并、分类等级汇总等实用功能扩展;5)建议后续分析方向。文章还附有官方GitHub链接和相关文献资源,为微生物群落结构研究提供了一套完整的分析解决方案。

1256

C++调用海康相机SDK采集图像(C++\QT Creator\openCV\线程\接口)

C++调用海康相机SDK采集图像(C++\QT Creator\openCV\线程\接口) 之前写了一篇关于C++调用海康相机SDK采集图像的文章,有很多人私下发送消息咨询了一些问题,由于工作繁忙,只答复了一部分问题,今天抽出时间从头梳理了一下大家提出的问题,把我能够回答的问题都解答一次。上一次的程序只是简单的实现了图像的采集,没有使用到线程,今天把程序重新做出调整,把线程和多态加进去。文章最后有项目的下载地址。 我使用的是QT Creator这个IDE,版本信息如下: 我把相机采集的图像转换为openC

大樱桃的博客 1万+

AIDE ML — 机器学习工程代理

AIDE 算法是一个树搜索代理,能够自主地编写、调试和测试代码,直到用户定义的指标达到最大值。由 LLM 驱动的代理,能够编写、评估和改进机器学习代码。知道还有其他引用或衍生自 AIDE 的公共项目吗?提示:使用完全本地化的模型时,性能可能会有所下降。使用侧边栏粘贴您的 API 密钥,上传数据,设置。用户界面显示实时日志、解决方案树和最佳代码。使用的Python 包的形式发布,并包含。智能体使用数据集,并用通俗易懂的英语描述。完全本地化(代码+评估器——无外部调用)替换新的搜索启发式方法、评估器。

具身机器人和通用AI 3948

RK3588 Ubuntu 20.04 编译 eglinfo 踩坑实录:从 Python 环境配置到 Mali 驱动调试

本文详细解析了在RK3588平台上使用Ubuntu 20.04编译eglinfo的全过程,包括Python环境配置、waf构建系统升级、Mali驱动调试等关键步骤。通过系统级软链接方案、驱动状态诊断和EGL环境验证技巧,帮助开发者快速解决常见问题,构建可靠的图形调试环境。

weixin_29158047的博客 375

ML/DL入门介绍(底层理解+基本概念)

随着人工智能的不断发展,机器学习这门技术也越来越重要,本文就介绍了机器学习的基础内容。该笔记结合了《机器学习》和《动手学深度学习》两门课(前者为主),更好地认识ML和DL。

weixin_50967907的博客 6050

如何对正射影像DOM(卫星影像、无人机航拍影像)进行拼接、合并以及去黑边(附 Global Mapper Pro 24.0 安装包(中文注册版))

为什么要对正射影像DOM进行拼接?影像去黑边、影像拼接的操作和步骤。

从地图看世界的专栏 4300

R数据分析:广义估计方程式GEE的做法和解释

好久没有更新文章了,因为同学们咨询的问题有点多,另一个原因就是自己实在太懒。。。。 今天继续给大家写广义估计方程式GEE。 In statistics, a generalized estimating equation (GEE) is used to estimate the parameters of a generalized linear model with a possible unknown correlation between outcomes. 上面的英文解释告诉我们,当我们

Codewar的博客 1万+
上一篇: 三、特征提取、特征预处理
下一篇: 五、机器学习模型及其实现1
ITS_Oaij
博客等级 码龄6年 1857粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值