


引言:为什么我们需要一个“更懂我们”的数据库?
大家好,我是你们的AI伙伴狸猫算君。
还记得我第一次尝试用大模型处理公司内部文档时的尴尬吗?我满心欢喜地问它一个关于最新产品的问题,它却给了我一个基于两年前数据的、似是而非的答案。那一刻我意识到,再强大的模型,如果它的知识是“静止”的、无法触及我的私有数据,那它的能力就大打折扣。
这不仅仅是我的问题。传统的关键词搜索在应对复杂、专业的语义查询时,也常常捉襟见肘。比如,你在公司知识库里搜索“如何优化API响应慢”,而文档里写的是“提升接口性能方法”,关键词匹配很可能就把这份最相关的资料给漏掉了。
这就是向量数据库(Vector Database) 登场的时刻。它正在成为连接大模型与我们海量、动态、私有数据的桥梁,是构建 RAG(检索增强生成) 应用——也就是给大模型配上一个实时、专属的“外挂大脑”——的核心组件。今天,我就用最直白的语言,带你彻底搞懂它,并亲手实践一个简单的检索系统。
一、技术原理:抛开数学,用“感觉”理解向量
刚开始听到“高维向量”、“嵌入”这些词,我也头大。别急,我们换个方式理解。
1. 核心比喻:给文字拍一张“语义身份证”
想象一下,我们要给图书馆里每一本书的核心思想,拍一张特殊的“照片”。这张照片不是由像素组成的,而是由几百个数字(比如512个)组成的序列,我们称之为 “向量” 或 “嵌入(Embedding)” 。
- 如何“拍照”? 这背后是嵌入模型(如BERT、OpenAI的text-embedding系列)的功劳。这个模型经过海量文本训练,学会了把语义相近的文字,映射到数字空间里相近的位置。
- 举个例子: “机器学习”、“AI算法”、“智能模型”这三句话,虽然在字面上不同,但含义接近。经过嵌入模型“拍照”后,它们对应的三串数字(向量)在数字空间里的“距离”会非常近。
简单说:嵌入模型 = 语义相机,向量 = 文字的数字照片。
2. 向量数据库:超级智能的“相册管理员”
现在,我们有了成千上万张“语义照片”(向量)。传统数据库(如MySQL)就像是一个只会按文件名检索的文件夹,你查“机器学习.jpg”,它就找不到“AI算法.png”。
而向量数据库,则是一个超级智能的相册管理员。它的超能力是:
- 存储这些数字照片(向量)。
- 理解照片之间的语义关联(通过计算向量间的距离)。
- 检索:当你问它“找找和‘人工智能’相关的照片”,它不会傻傻地找文件名里带“人工智能”的,而是直接拿出一张“人工智能”的照片作为样本,然后在图库里快速找出和这张样本照片“看起来最像”的几张——也就是语义最相近的向量,不管它们的原始文字是什么。
3. RAG:给大模型装上“实时外挂”
理解了向量数据库,RAG就很好懂了。它解决了大模型的两大痛点:知识过时和不了解私域数据。
RAG的工作流程:
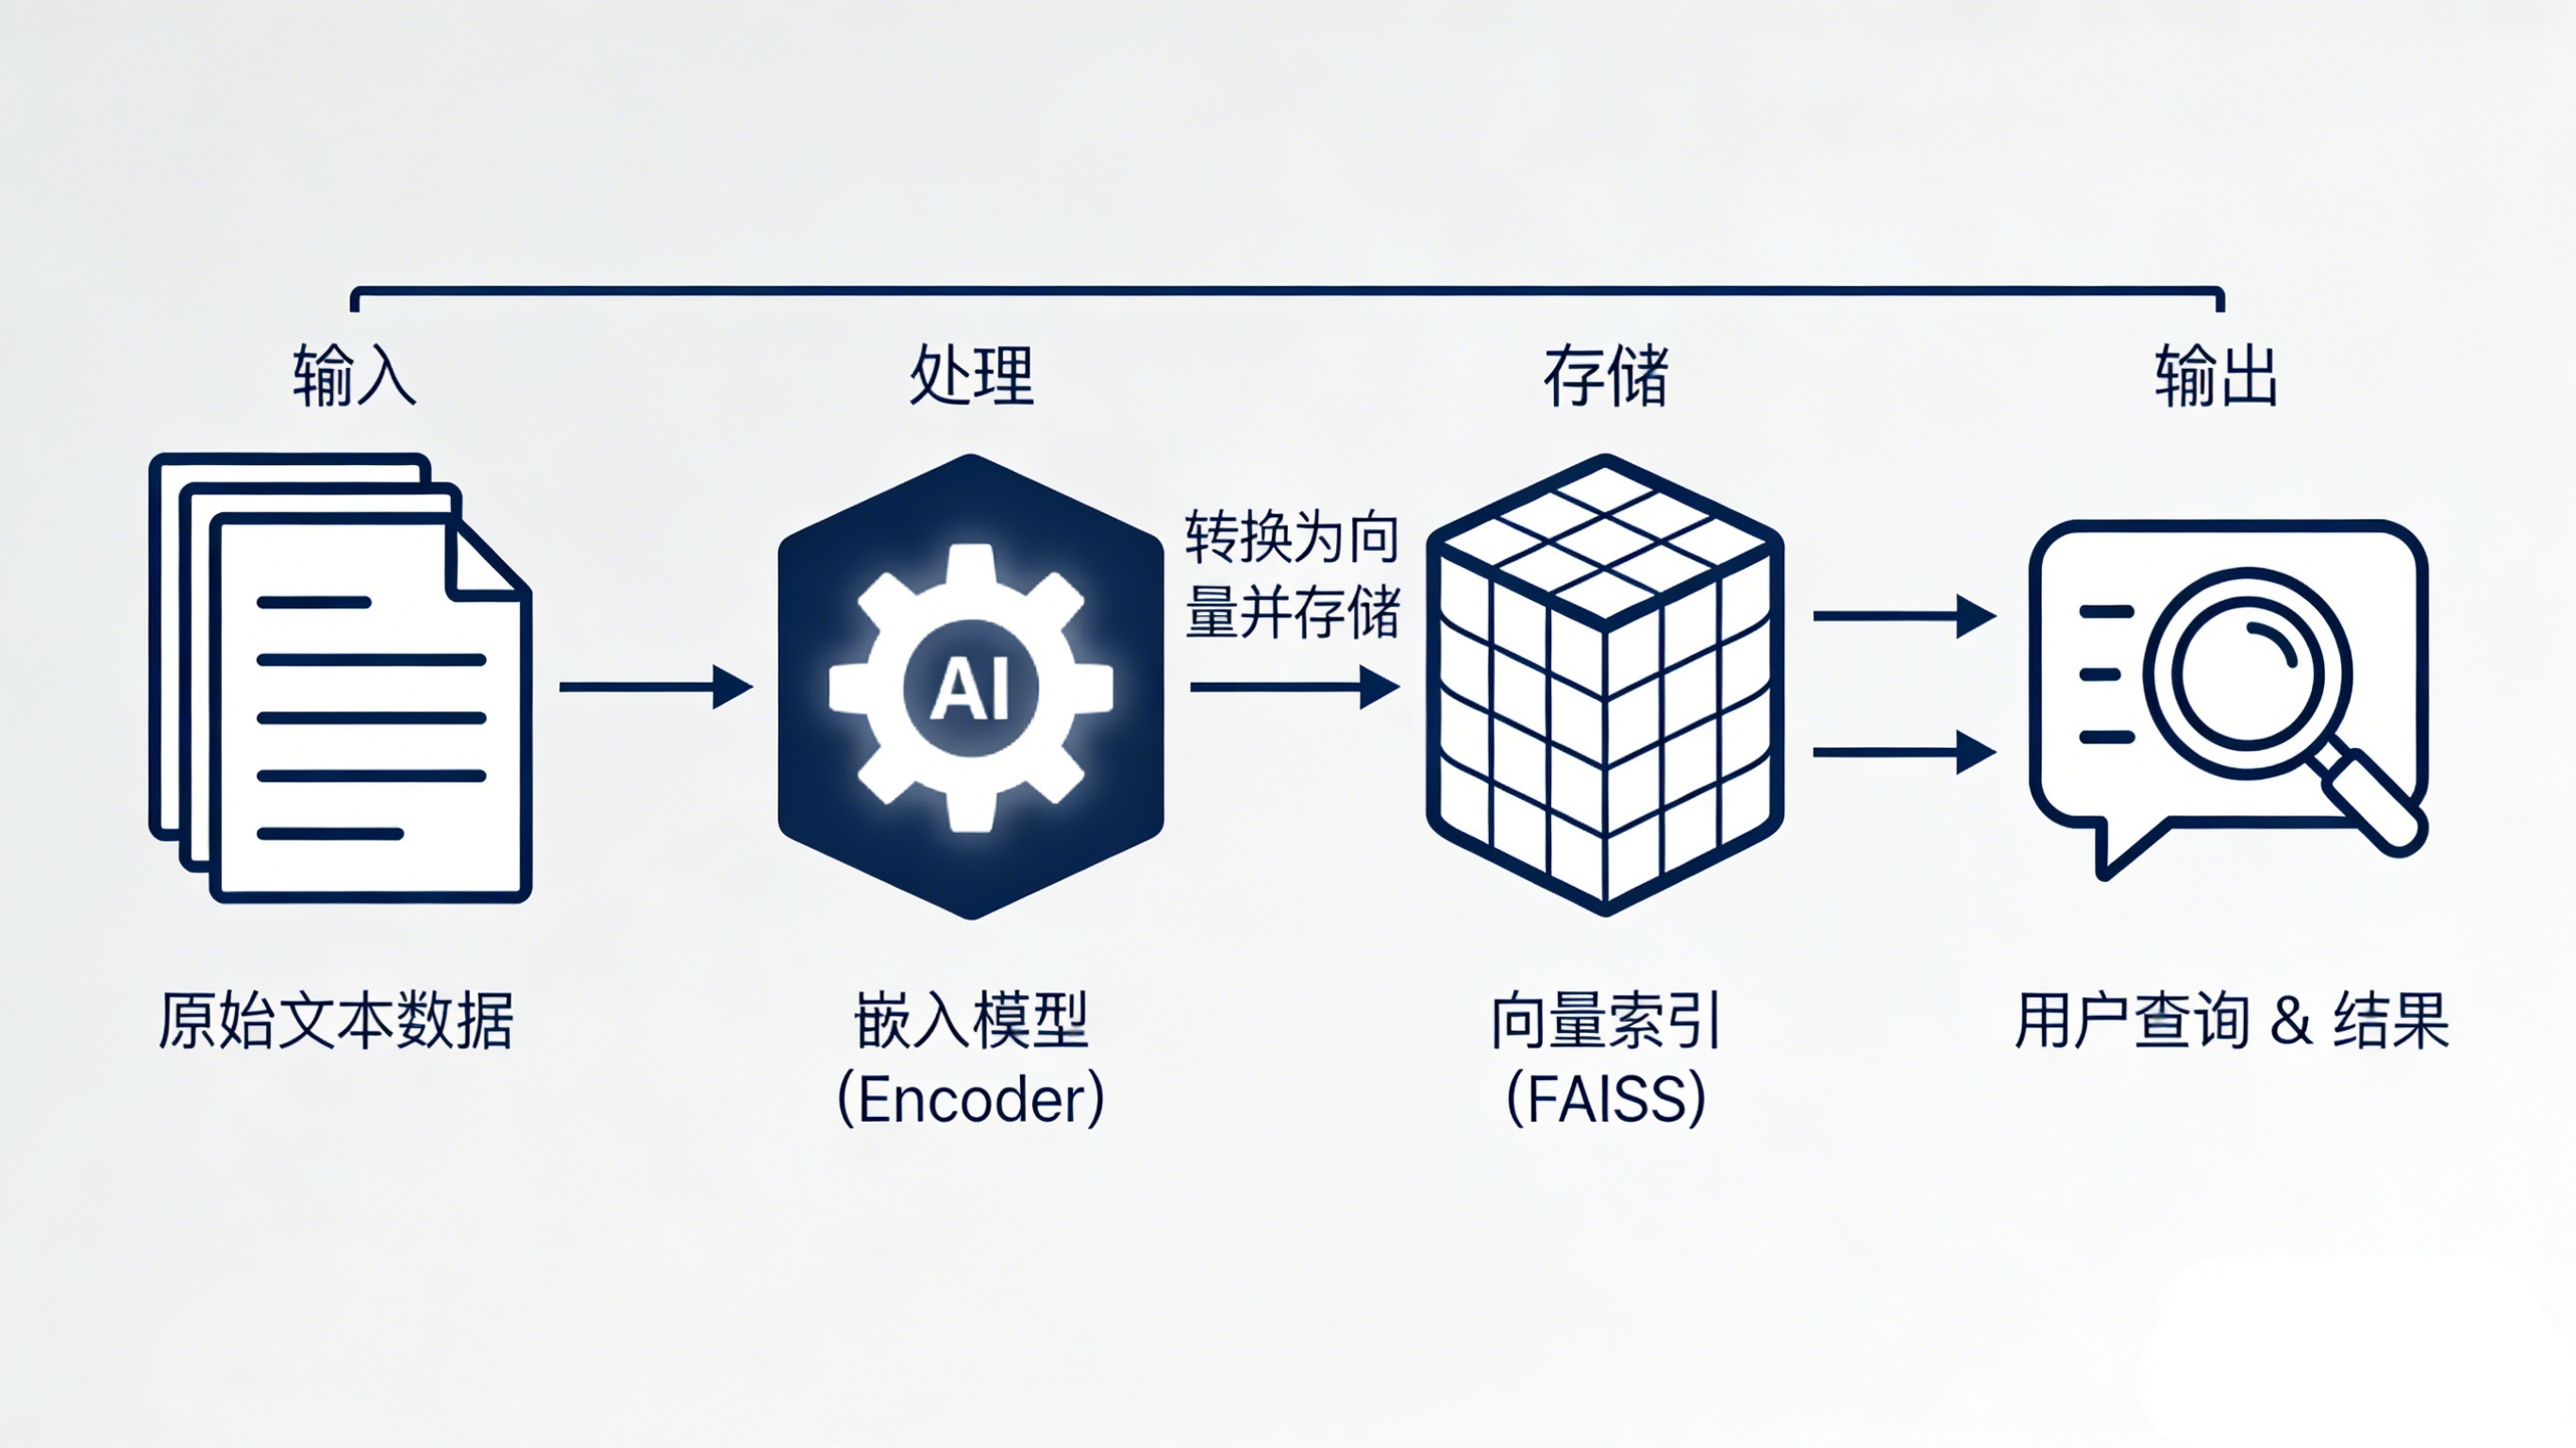
- 知识库准备:将你的文档、手册、报告等所有资料,通过嵌入模型转换成向量,存入向量数据库。
- 用户提问:当用户向大模型提问时,先把这个问题也转换成向量。
- 智能检索:用这个“问题向量”去向量数据库里,快速找出语义最相关的几段资料(原文)。
- 增强生成:把这些检索到的资料和用户问题一起,“喂”给大模型,并指令它:“请基于以下资料回答问题”。这样,大模型就能给出一个既有通用知识、又结合了最新/私有信息的精准回复。
整个过程,向量数据库扮演的就是那个瞬间从海量资料中精准抓取关键信息的“外挂大脑”。
二、动手实践:10分钟搭建你的第一个向量检索demo
理论说再多,不如动手跑一遍。我们将使用Python中非常流行的 Faiss(Facebook AI开源的向量检索库)和 sentence-transformers(一个简单好用的嵌入模型库),来模拟一个微型向量数据库的完整流程。
环境准备
确保你的Python环境已安装以下包:
bash
pip install faiss-cpu sentence-transformers numpy
代码详解:一个简易向量数据库类
python
import numpy as np
import faiss
from sentence_transformers import SentenceTransformer

class SimpleVectorDB:
    """
    一个极简的向量数据库实现类,用于演示核心流程。
    """
    def __init__(self):
        """初始化:加载模型并创建空索引。"""
        # 1. 加载嵌入模型(我们选用对中文友好的BGE小型模型)
        # 它就是我们那把“语义相机”
        self.model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
        # 获取模型输出的向量维度,例如 384 或 512
        self.dimension = self.model.get_sentence_embedding_dimension()

        # 2. 创建一个Faiss的“扁平”索引(最基础但最精确的检索方式)
        # 使用欧几里得距离(L2)来衡量向量间的相似度
        self.index = faiss.IndexFlatL2(self.dimension)

        # 3. 用一个列表来存放原始文本,因为索引只存向量,不存原文
        self.texts = []

    def add_documents(self, documents):
        """
        核心步骤1:添加文档。
        将文本列表转换成向量,并存入索引。
        """
        print("=== 开始将文本向量化 ===")
        vectors = []

        for i, doc in enumerate(documents):
            # 使用模型对单句文本进行编码(向量化)
            # encode方法返回一个numpy数组,形状为 (1, dimension)
            vector = self.model.encode([doc])
            vectors.append(vector[0])  # 取出第一行,即这个文本的向量
            self.texts.append(doc)     # 保存原始文本

            # 打印过程,帮助理解(生产环境可关闭)
            print(f"文档 {i+1}: '{doc[:20]}...' -> 向量形状: {vector.shape}")

        # 将列表转换为Faiss所需的numpy矩阵格式
        vectors_array = np.array(vectors, dtype=np.float32)
        print(f"\n所有向量组成的矩阵形状: {vectors_array.shape} (文档数, 向量维度)")

        # 将向量矩阵添加到索引中
        self.index.add(vectors_array)
        print(f"索引中现有向量总数: {self.index.ntotal}")
        return vectors_array

    def search(self, query, k=3):
        """
        核心步骤2:语义检索。
        将查询语句向量化,并从索引中找出最相似的k个结果。
        """
        print(f"\n=== 执行查询: '{query}' ===")

        # 1. 将查询文本同样转换为向量
        query_vector = self.model.encode([query])[0]  # 得到查询向量
        query_vector = query_vector.reshape(1, -1).astype(np.float32)  # 调整形状为(1, dimension)

        # 2. 搜索!这是Faiss的核心功能
        # distances: 查询向量与每个结果向量的距离(越小越相似)
        # indices: 结果在索引中的位置
        distances, indices = self.index.search(query_vector, k)

        print("检索结果:")
        results = []
        for i in range(k):
            idx = indices[0][i]
            distance = distances[0][i]
            # 将距离转换为更直观的相似度分数(0~1之间,越大越相似)
            similarity = 1 / (1 + distance)
            result = {
                "rank": i+1,
                "text": self.texts[idx],
                "similarity_score": round(similarity, 4),
                "distance": round(distance, 4)
            }
            results.append(result)
            print(f"  [{i+1}] 相似度: {similarity:.2%} | 原文: '{self.texts[idx]}'")

        return results

# 让我们来运行它!
if __name__ == "__main__":
    # 模拟一个微型知识库
    documents = [
        "苹果是一种营养丰富的水果,富含维生素和纤维。",
        "Python是一种简洁易学的编程语言,适合初学者。",
        "机器学习是人工智能的一个重要分支,让计算机从数据中学习。",
        "香蕉含有丰富的钾元素,有助于维持心脏健康。",
        "深度学习利用深层神经网络处理复杂模式识别任务。",
        "橙子富含维生素C,能够增强人体免疫力。",
        "自然语言处理(NLP)是AI的一个应用领域,旨在让机器理解人类语言。"
    ]

    # 1. 创建数据库实例
    print("初始化向量数据库...")
    db = SimpleVectorDB()

    # 2. 添加文档(构建知识库)
    db.add_documents(documents)

    # 3. 进行几次语义查询
    test_queries = ["有什么健康的水果推荐?", "我想学习编程", "AI有哪些研究方向?"]

    for query in test_queries:
        db.search(query, k=2)  # 每个问题返回最相似的2个结果
        print("-" * 50)
运行这个脚本,你会看到:
- 向量化过程:每句话被转换成一个长长的数字数组(如512个浮点数)。
- 神奇的结果:当你查询“健康的水果”时,即使原文没有这个词,系统也能返回“苹果”、“香蕉”、“橙子”的相关描述。这就是语义检索的魅力——按意思找,而不是按字面找。
三、效果评估:如何判断你的“外挂大脑”是否聪明?
搭建起来只是第一步,如何评估这个RAG系统的质量呢?可以从以下几个层面入手:
1. 检索效果评估(核心)
- 命中率(Hit Rate) :对于一个问题,标准答案(或相关文档)出现在检索结果Top K(如前3/前5)中的比例。比例越高,检索越准。
- 平均排名倒数(Mean Reciprocal Rank, MRR) :关注标准答案在结果列表中的位置。第一名得1分,第二名得1/2分,以此类推。MRR越高,说明系统越能把最相关的文档排到前面。
- 人工抽样检查:最接地气的方法。随机抽取一批问题,人工判断检索出的文档是否真的相关、是否有用。
2. 端到端生成效果评估
检索的最终目的是为了让大模型生成更好的答案。
- 人工评分:让领域专家从答案相关性、信息准确性、完整性、有用性等维度对最终生成的答案进行打分。
- 基于LLM的自动评估:设计一套提示词,让一个更强大的LLM(如GPT-4)扮演裁判,根据参考文档和问题,对生成的答案进行评分。虽然不完全可靠,但可用于快速批量评估。
3. 性能评估
- 检索速度:从提出问题到返回检索结果的平均耗时。对于交互式应用,最好在百毫秒级别。
- 吞吐量:系统每秒能处理多少个查询请求。
- 资源消耗:索引占用的内存/磁盘空间大小。
看到这里你可能发现,实操中涉及大量环境配置、代码调试和资源管理。如果你想跳过这些繁琐步骤,直接专注于数据和效果,可以尝试LLaMA-Factory Online这类平台。它将上述所有步骤集成在一个Web界面中。你只需要上传数据、选择模型、配置训练任务(平台会提供推荐的参数配置),点击开始即可。平台会自动处理分布式训练、资源调度和实验跟踪,让你无需代码基础也能体验到从数据到专属模型的完整创造过程,在实践中深刻理解如何让模型“更像你想要的样子”。
四、总结与展望
通过今天的分享,我们希望你已经对向量数据库不再陌生。它本质上是一个专门为“语义”设计的数据管理系统,通过将数据映射到连续向量空间并高效检索,实现了超越关键词匹配的智能查找。
总结一下关键点:
- 为什么需要它:打破大模型的知识边界,连接动态/私有数据,是构建RAG应用的基石。
- 核心原理:嵌入模型把数据变成向量,向量数据库存储并基于向量距离进行智能检索。
- 如何上手:从Faiss + Sentence-Transformers这样的轻量级组合开始实验,理解流程。
- 如何选型:根据数据规模、性能要求、运维能力和团队技术栈,在Milvus、Pinecone、Qdrant、Weaviate等成熟产品中选择。
- 效果是关键:建立评估体系,确保你的“外挂大脑”真的有用。
展望未来:
向量数据库技术仍在飞速进化。我们看到它与大模型的结合越来越紧密,多模态检索(同时搜索文本、图片、视频)、智能过滤(在检索时结合元数据条件)、更高效的索引算法以应对千亿甚至万亿级别的向量规模,都将是重要的方向。
对于开发者而言,理解向量数据库的原理和应用,已经成为构建下一代AI原生应用的必备技能。希望这篇文章能成为你探索这个有趣领域的起点。从今天的小Demo开始,试着用向量数据库去管理你的个人笔记、公司文档,或者打造一个智能问答机器人吧!
 1267


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


