NO.4|模型管理|会话管理|数据管理|Sqlite

别再只用SQLite了!HarmonyOS融合搜索API深度评测:性能、限制与最佳实践 本文深入评测HarmonyOS融合搜索API的性能优势与最佳实践,对比SQLite在10万条数据量下的搜索耗时差异,揭示倒排索引技术的核心价值。通过实战案例展示如何实现毫秒级响应,解决企业级应用的搜索性能瓶颈,提升用户体验。 阅读详情

模型管理

现在deepseek-chat、gpt-4o-mini、gemini-2.0-flash模型已经接⼊成功,每个模型都对应单独的Provider类,为了后续使⽤简单,再封装⼀个LLMManager类将模型管理起来,后续通过多态的⽅式实现模型路由

LLMManager.h
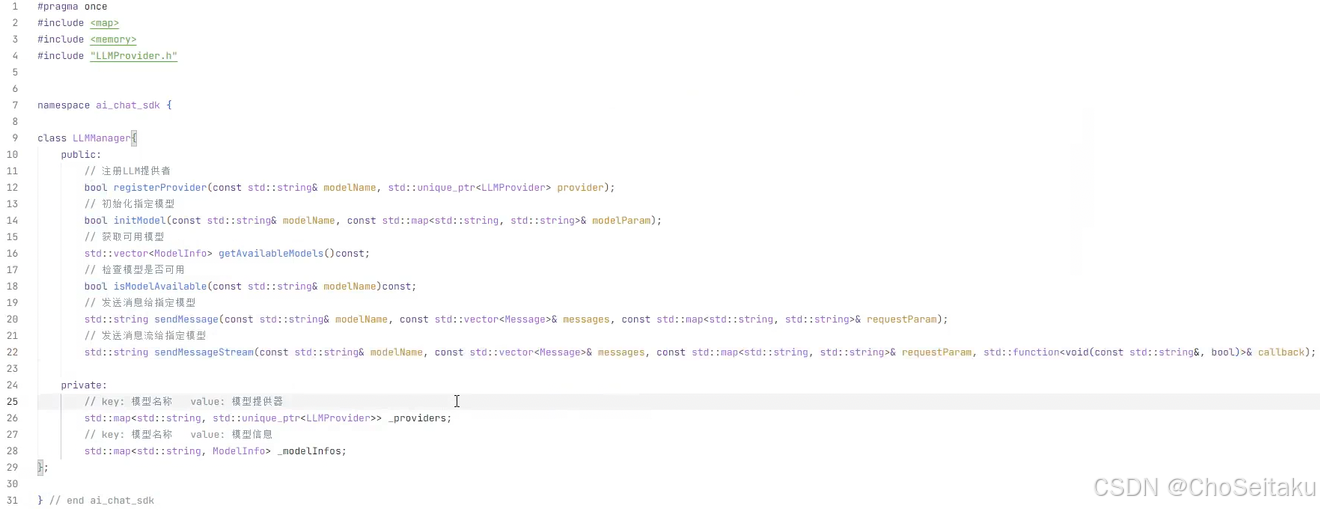
![[Pasted image 20260416100058.png]]

LLMManager.cpp
![[Pasted image 20260416100208.png]]
![[Pasted image 20260416095557.png]]
![[Pasted image 20260416095745.png]]
![[Pasted image 20260416100000.png]]
![[Pasted image 20260416100133.png]]

会话管理

假设,现在使用 LLMManager 封装了一个智能聊天助手应用,当用户和模型聊天的过程中,会存在以下问题:

  1. 在某次聊天中,我们和模型进行了多轮的消息发送,这些消息在程序中如何存储?
  2. 模型没有记忆,每次给模型发送消息时需要带上历史消息,如果没有保存历史消息,在给模型发送消息时就无法带上历史消息,模型在回复的时候也没有办法参考往期的消息内容
  3. 假设和模型有多轮聊天,每轮聊天中都包含有多条消息,如何区分某条消息属于那一次聊天中的消息呢?
  4. 在给模型发送消息时,需要带上历史消息,假设所有的消息都保存在一起,如何获取某次聊天中的所有消息呢?
    要解决上述问题,需要引入会话机制。每次和模型开启新一轮聊天,都可以看成是一次会话。

在本次会话中,会和模型进行多次聊天,这些聊天信息可以保存在本次会话中了,除了保存会话消息外,还需要保存模型名称、会话创建时间等都需要保存 —— 需要设计数据结构,该数据结构就是会话结构

会话介绍

会话是⽤⼾与⼤语⾔模型之间的⼀系列连续交互,它通过维护上下⽂和状态信息,确保对话的连贯性和⼀致性。由于⼤模型不会为⽤⼾管理会话信息,因此需要程序员⼿动完成会话管理。
会话管理涉及以下内容:

  1. 保存会话数据。由于存在多组会话,每组会话可能有多条聊天消息,在保存会话数据时可以将会话id和具体的会话简历映射关系,⽅便后续查询。<session_id,session>
  2. 创建会话。在和⼤模型建⽴连接前,需要先创建好会话,将后续每次和⼤模型聊天的消息信息要存在该会话中。
  3. 通过会话id获取指定会话。
  4. 向某会话中添加消息。在和⼤模型聊天时,需要将⽤⼾提问、模型恢复的消息保存到会话中。
  5. 获某会话中所有消息。当⽤⼾点击某个会话时,需要将该会话中的历史消息显⽰到界⾯。
  6. 索取所有会话列表。获取所有的会话列表,显⽰在界⾯中。
  7. 删除会话。⽤⼾可以在⻚⾯中删除具体的会话。
  8. 更新会话时间戳。继上次聊完之后,⽤⼾再次打开该会话继续和模型聊天时,需更新会话时间戳。
  9. 清空所有会话
  10. 获取会话总数
  11. ⽣成会话id。需要⽣成唯⼀的会话id来标记具体某条会话。
  12. ⽣成消息id。需要使⽤唯⼀的消息id来标记具体某条消息。
    注意:会话管理模块会保存所有的会话,在同⼀时刻,可能会对多个会话进⾏操作,因此创建会话、更新会话、删除会话等时需要考虑线程安全问题。
会话管理数据结构设计
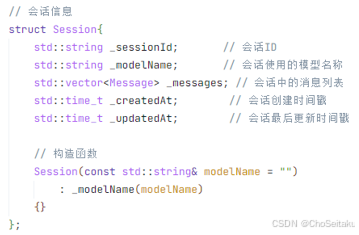
![[Pasted image 20260416154822.png]]

会话实现

SessionManager.h
![[Pasted image 20260416104638.png]]

SessionManager.cpp
![[Pasted image 20260416105326.png]]
![[Pasted image 20260416104859.png]]
![[Pasted image 20260416105517.png]]
![[Pasted image 20260416105657.png]]
![[Pasted image 20260416111147.png]]
![[Pasted image 20260416111449.png]]

getSessionLists()实际返回的是会话的会话id
能否直接返回会话对象?
答案是可以的,但不够友好,具体的原因如下:

  1. 直接返回会话对象,在返回时候会增加内存拷贝的开销,影响程序的运行效率
  2. SessionManager 中基本都是通过会话 id 来操作对应的回话对象的,如果返回会话对象,其他模块就要对会话对象进行操作,SessionManager 和其他模块的耦合度增高,不便于后期的维护
    所以返回会话对象不是很友好
    而且,会话信息存储在 sqlite 中,获取会话历史消息、删除会话等,都是通过会话 id 来进行的,因此返回会话 id 更有利于 CURD 的操作
    因此返回会话 id 会更好一点
    注意:在返回的这些会话 id 中,最好将会话按照更新的时间戳进行降序排列

数据管理

持久化存储

⽬前在程序中创建的会话以及和模型交互的历史数据都存储在内存中,⽽内存是⼀种带电存储设备,⼀旦断电或者程序重启之后数据就丢失了,想要拿到之前的会话数据就回天乏术了。Deepseek、ChatGPT提供的⽹⻚聊天机器⼈都是⽀持会话存储的,⽅便⽤⼾查看以往的会话记录。因此,ChatSDK中也需要添加数据持久化存储的功能,即将数据永久的保存下来,不会因为断电或关闭程序⽽引起数据丢失。
持久化存储最常⻅的⽅案就是将数据存储到数据库,由于ChatSDK实现好之后,需要共享给其他需要的⽤⼾使⽤,为了减少⽤⼾使⽤成本(使⽤时不需要安装过多依赖或三⽅⼯具),本项⽬采⽤SQLite实现数据存储。

SQLite

SQLite介绍

SQLite Home Page
SQLite 数据类型 | 菜鸟教程
SQLite是⼀个开源、轻量级、零配置、⽆服务器、⾃包含、事务性、⽀持标准SQL、跨平台的数据库管理系统。

  • 开源:免费使⽤,源码透明
  • 轻量级:整个库⾮常⼩,编译之后仅需⼏百KB
  • 零配置:⽆需安装、启动、停⽌或配置任何数据库服务器进程
  • ⽆服务器:SQLite没有独⽴的服务器进程,应⽤程序直接通过函数调⽤读写磁盘上的数据库⽂件
  • ⾃包含:整个数据库就是⼀个独⽴的、跨平台的单个⽂件(通常是.db后缀),⽂件中包含所有表、索引、数据和元信息
  • 事务性:完全⽀持ACID(原⼦性、⼀致性、隔离性、持久性)事务,即使系统崩溃或断电也嗯呢保证数据完整性
  • ⽀持标准SQL:它使⽤SQL语句来管理和查询数据,最多⽀持128TB
  • 跨平台:数据库⽂件跨平台
  • 简单易⽤:只需包含⼀个sqlite3.h和⼀个库⽂件即可
    ⼀般常⽤于嵌⼊式系统、移动开发中。
ubuntu下SQLite命令⾏和开发库安装
> sudo apt install sqlite3 # 安装 sqlite3 命令⾏⼯具  
> sudo apt install libsqlite3-dev # 安装 sqlite 开发包  
> dpkg -L libsqlite3-dev  # 列出已安装的 libsqlite3-dev 软件包所包含的所有⽂件及其安装路径
/.  
/usr  
/usr/include  
/usr/include/sqlite3.h  
/usr/include/sqlite3ext.h  
/usr/lib  
/usr/lib/x86_64-linux-gnu  
/usr/lib/x86_64-linux-gnu/libsqlite3.a  
/usr/lib/x86_64-linux-gnu/pkgconfig  
/usr/lib/x86_64-linux-gnu/pkgconfig/sqlite3.pc  
/usr/share  
/usr/share/doc  
/usr/share/doc/libsqlite3-dev  
/usr/share/doc/libsqlite3-dev/copyright
/usr/lib/x86_64-linux-gnu/libsqlite3.so  
/usr/share/doc/libsqlite3-dev/changelog.Debian.gz

编译时链接 sqlite3 库

makefile⽂件:  
g++ main.cpp -o my_program -lsqlite3  

CMakelists.txt:  
target_link_libraries(${SDK_NAME} sqlite3)
终端使⽤介绍

常⽤命令
数据库操作命令

命令说明示例
.open 文件名打开或创建数据库文件.open student.db
.databases显示所有连接的数据库.databases
.attach 文件 as 别名附加另一个数据库.attach archive.db as archive
.backup 文件名备份当前数据库.backup backup.db
.restore 文件名从备份恢复数据库.restore recovery.db
.quit退出 SQLite.quit
.exit退出 SQLite.exit
.help显示帮助信息.help
表和结构命令
命令说明示例
.tables显示所有表.tables
.schema [表名]显示表结构.schema students
.indexes [表名]显示索引.indexes students
注意:sqlite3⽀持标准sql语句。
使⽤演⽰

创建好表之后,sqlite 会根据每个列的数据类型自动生成亲和类型

create table test{
 a INT, -- 亲和类型:
 INTEGER b TEXT -- 亲和类型:TEXT 
};

在插入数据的时候,sqlite 会根据实际插入的数据,结合亲和类型,来确定数据实际在磁盘上的存储类

insert into test values ('123', 456);
  • a 列:INT(亲和类型 INTEGER),实际插入的数据'123'字符串,会被转换为整形数据123
  • b 列:TEXT(亲和类型 TEXT),实际插入的数据456整形数据,会被转化为字符串'456'
    实际在定义表的时候,用户根据列的属性选择合适的数据类型即可,不用关心亲和类型和存储类
    sqlite 会根据偏好设置亲和类型,实际的存储类型取决于偏好类型转化规则和实际插入的数值
    ![[Pasted image 20260416135134.png]]

查看版本
![[Pasted image 20260416135206.png]]

创建数据库
![[Pasted image 20260416140312.png]]

创建表
![[Pasted image 20260416140327.png]]

查看结构
![[Pasted image 20260416140400.png]]

插入数据,查询数据
![[Pasted image 20260416140611.png]]

删除数据
![[Pasted image 20260416140710.png]]

.quit

退出sqlite

常⽤api介绍

包含头文件

#include <sqlite3.h>
数据库连接管理:  
int sqlite3_open(const char *filename, sqlite3 **ppDb);
功能:打开⼀个数据库连接。如果数据库⽂件不存在,则创建它  
参数:filename - 数据库⽂件的路径,  
	  ppDb:⼀个指向sqlite3*的指针。函数成功后会在这个指针⾥填⼊数据库连接句柄  
返回值:SQLITE_OK 表⽰创建成功,否则为错误码  

int sqlite3_close(sqlite3* db);  
功能:关闭打开的数据库连接,并释放所有资源  
参数:要关闭的数据库连接句柄  
返回值:SQLITE_OK表⽰成功,如果还有未完成的预处理语句 
 
const char *sqlite3_errmsg(sqlite3* db);  
功能:获取与数据库连接相关的最后⼀次错误操作的英⽂描述字符串。在操作失败后调⽤它来获取错误原因  
参数:db数据库连接句柄  
返回值:只想错误信息字符串的指针。如果还有查询没有完成,将返回SQLITE_BUSY禁⽌关闭的错误消息 

执⾏SQL语句  
int sqlite3_prepare_v2( sqlite3 *db,const char *zSql,int nByte,  
						sqlite3_stmt **ppStmt,const char **pzTail);  
功能:将⼀条SQL语句编译成⼀个预处理语句对象,为执⾏和绑定参数做准备  
参数:db - 数据库连接句柄  
	  zSql:要编译的SQL语句⽂本  
	  nByte:SQL⽂本的⻓度(字节),-1表⽰⾃动计算到\0结束  
	  ppStmt:指向sqlite3_stmt*的指针,表⽰输出预处理结果语句的句柄  
	  pzTail:指向未使⽤的SQL部分指针,通常置为NULL  
返回值:编译成功返回SQLITE_K,否则返回错误码  
int sqlite3_bind_int64(sqlite3_stmt*, int index, sqlite3_int64 value);  
功能:向预处理语句中的指定参数位置绑定⼀个64位的整数值  
参数:index - 参数的序号,从1开始  
value - 要绑定的整数值  
返回值:SQLITE_OK表⽰绑定成功,否则为错误码  

int sqlite3_bind_text(sqlite3_stmt*, int index, const char *value, 
								     int len, void(*destructor)(void*));  
功能:向预处理语句的指定参数位置绑定⼀个⽂本字符串  
参数: index - 参数的序号,从1开始  
	  value - 要绑定的⽂本字符串  
	  len - 字符串的⻓度(字节),-1表⽰⾃动计算到\0结束  
	  destructor:⽤于指定SQLite不会尝试释放该字符串  
	  SQLITE_STATIC:SQLite不会尝试释放该字符串  
	  SQLITE_TRANSIENT:SQLite会制作该字符串的副本  
返回值:SQLITE_OK表⽰绑定成功,否则为错误码  

int sqlite3_exec(sqlite3* db, const char *sql,
				int (*callback)(void*, int, char**, char**),void *arg,char **errmsg);  
功能:执⾏⼀条或多条SQL语句,适合不返回数据的语句,如CREATE、INSERT  
参数:db - 数据库连接句柄  
	 sql - 要执⾏的SQL语句字符串  
	 callback:回调函数,每有⼀条结果记录就产⽣⼀次调⽤,可以设置为NULL  
	 arg:传递给回调函数的第⼀个参数  
	 errmsg:只想错误信息的指针。必须⽤sqlite3_free释放  
返回值:执⾏成功返回SQLITE_OK,否则返回错误码  

int sqlite3_step(sqlite3_stmt *pStmt);  
功能:⽤于逐步执⾏预处理语句。⼀般⽤于执⾏查询和更新操作,并返回执⾏结果。对于查询操作,sqlite3_step 需要多次调⽤,直到返回 SQLITE_DONE  
参数:pstmt - 预处理语句句柄  
返回值: SQLITE_ROW - 表⽰有⼀⾏结果数据就绪  
		SQLITE_DONE - 表⽰语句执⾏完成  
		否则表⽰有其他错误  

const unsigned char *sqlite3_column_text(sqlite3_stmt*, int iCol);  
功能:从当前结果⾏中,以const unsigned cht*的形式获取制定⽂本列的值  
参数:iCol表⽰列号,从0开始  
返回值:指向⽂本数据的指针。  

int sqlite3_finalize(sqlite3_stmt *pStmt);  
功能:销毁预处理语句对象,释放所有关联资源  
参数:pstmt - 要销毁的预处理语句句柄  
返回值:成功返回SQLITE_OK,否则为错误码

sqlite3_prepare_v2

insert into student(name, gender, age, gap) values('张三', '男', 18, 3.5) insert into student(name, gender, age, gap) values('李四', '男', 18, 3.5) insert into student(name, gender, age, gap) values(?, ?, ?, ?) 
insert into student(name, gender, age, gap) values(:name, :gender, :age, :gap)

sqlite3_prepare_v2: 函数会对输入的 SQL 语句进行语法检测,如果语法有问题会立马返回错误码
如果语法正确,会将 SQL 语句编译成字节码,这个字节码给 SQLite 的虚拟机执行的形式
编译完成之后,该函数会创建一个sqlite3_stmt的结构,将编译的结果存储在该对象中

使用案例

testSqlite3.cpp
![[Pasted image 20260416153153.png]]
![[Pasted image 20260416144315.png]]
![[Pasted image 20260416144124.png]]
![[Pasted image 20260416151729.png]]
![[Pasted image 20260416151856.png]]
![[Pasted image 20260416152133.png]]
![[Pasted image 20260416152400.png]]
![[Pasted image 20260416152514.png]]
![[Pasted image 20260416153055.png]]
![[Pasted image 20260416153341.png]]

编译
![[Pasted image 20260416153430.png]]

![[Pasted image 20260416153549.png]]

数据管理模块设计

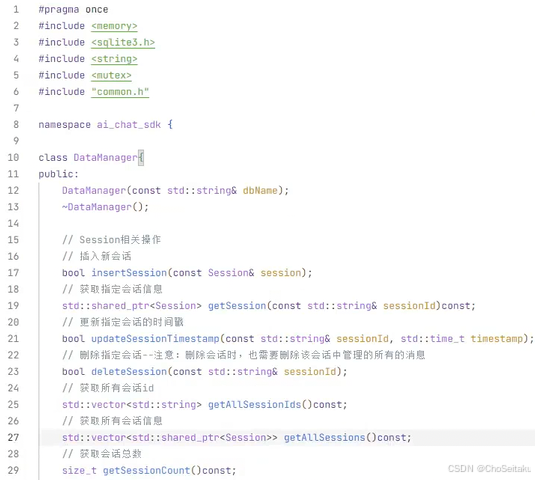
DataManager.h
![[Pasted image 20260416163411.png]]
![[Pasted image 20260416161710.png]]
![[Pasted image 20260416165457.png]]

数据管理模块实现

DataManager.cpp
![[Pasted image 20260416155832.png]]
![[Pasted image 20260416160630.png]]
![[Pasted image 20260416160655.png]]
![[Pasted image 20260416161459.png]]
![[Pasted image 20260416161341.png]]
![[Pasted image 20260416161831.png]]
![[Pasted image 20260416162308.png]]
![[Pasted image 20260416162439.png]]
![[Pasted image 20260416162521.png]]
![[Pasted image 20260416162913.png]]
![[Pasted image 20260416163301.png]]
![[Pasted image 20260416163533.png]]
![[Pasted image 20260416163622.png]]
![[Pasted image 20260416164020.png]]
![[Pasted image 20260416164132.png]]
![[Pasted image 20260416164406.png]]
![[Pasted image 20260416165042.png]]
![[Pasted image 20260416165247.png]]
![[Pasted image 20260416165314.png]]

会话数据同步到数据库

每次创建新会话、删除会话、更新会话、以及⽣成消息记录等都需要同步到SQLite中,因此让SessionManager类持有⼀个DataManager的对象,当发⽣上述操作时,通过DataManager的对象持久化会话数据。

SessionManager.h
![[Pasted image 20260417184928.png]]

SessionManager.cpp
![[Pasted image 20260417183806.png]]

![[Pasted image 20260417184328.png]]
![[Pasted image 20260417185101.png]]

![[Pasted image 20260417185329.png]]
![[Pasted image 20260417185509.png]]
![[Pasted image 20260417185556.png]]
![[Pasted image 20260417185857.png]]
![[Pasted image 20260417185955.png]]
![[Pasted image 20260417190414.png]]

DataManager.h
![[Pasted image 20260417190042.png]]

DataManager.cpp
![[Pasted image 20260417190150.png]]

Waveloom:开源终端AI编程助手安装配置与使用全指南 AI编程助手是基于大语言模型的智能代码辅助工具,通过自然语言处理技术理解开发需求。其核心原理是利用预训练模型分析代码上下文,提供代码生成、错误修复和项目分析等功能。这类工具的技术价值在于显著提升开发效率,减少上下文切换,特别适合终端环境下的快速编程任务。在应用场景方面,AI编程助手广泛应用于代码理解、Git操作辅助、测试编写和文档生成等开发环节。Waveloom作为开源终端AI编程助手,支持本地部署和自定义模型,为开发者提供了类似Claude Code的免费替代方案,特别适合国内开发环境使用。 阅读详情

相关推荐

基于C++ QT与DeepSeek API构建桌面AI对话客户端实践

在现代桌面应用开发中,GUI框架与网络服务的集成是核心技术挑战之一。QT框架凭借其信号槽机制和成熟的网络模块,为C++开发者提供了高效的原生跨平台解决方案。通过QNetworkAccessManager处理HTTP请求,结合JSON数据解析,开发者能够实现与云端API的稳定通信。这种技术组合在需要高性能、实时交互的应用场景中价值显著,例如构建AI助手客户端。本文以DeepSeek对话功能为例,详细解析了如何利用QT实现流式响应处理、线程安全的界面更新等工程实践,帮助开发者掌握桌面应用与AI服务集成的完整链路

weixin_30251829的博客 288

CSM:为 Claude Code/Codex 构建终端会话档案系统

CLI 工具中的会话管理,本质是将人机交互过程转化为可追溯、可复用、可审计的结构化数据。其核心原理在于捕获命令行输入、模型输出、执行环境等多维元数据,并通过轻量存储与内存索引实现毫秒级检索。技术价值体现在打破黑盒式交互局限,让 AI 编程助手真正融入开发者工作流——既支持精准回溯(如 csm replay),也支撑模型对比(csm diff)与知识沉淀(csm export)。典型应用场景包括调试复现、多模型评估、团队知识归档及 Git 集成审计。本文聚焦基于 Bun 运行时构建的 CSM(Claude S

weixin_30247307的博客 440

免越狱iPhone搭建SQLmap渗透测试环境:A-Shell实战指南

SQL注入作为Web安全的核心漏洞类型,其检测与利用原理基于对数据库查询语句的非法操控。自动化工具通过构造特定Payload探测和利用注入点,极大提升了测试效率。在移动办公和应急响应场景下,安全人员常需快速验证漏洞。本文以A-Shell终端模拟器为技术载体,在iOS沙盒环境中部署Python及SQLmap,实现免越狱的移动端渗透测试环境搭建,并详细解析了依赖安装、靶场连接及移动端优化技巧,为安全学习和授权测试提供便携解决方案。

weixin_33704591的博客 375

深度解析Owncast数据库设计:用户数据存储结构与高效管理指南

Owncast作为一款开源的自托管直播流媒体服务器,其数据库设计直接影响系统性能和用户体验。本文将深入剖析Owncast的数据库架构,重点解析用户数据存储结构、表关系设计及最佳实践,帮助开发者和管理员更好地理解和优化系统数据管理。 ## 数据库整体架构概览 Owncast采用SQLite作为默认数据库,通过简洁而高效的表结构设计支撑直播、聊天、用户管理等核心功能。数据库 schema 定义在

gitblog_00347的博客 390

Burp Suite自动化安全测试:构建AI驱动的智能审计助手

在Web应用安全测试领域,自动化与智能化已成为提升效率的关键。传统手动测试在面对复杂应用架构时存在瓶颈,而通过脚本化与API集成,可以实现安全审计的范式转移。其技术原理在于利用Burp Suite的扩展接口(如Extender API)或外部通信协议(如MCP Server),将重复性任务(如参数模糊测试、动态Token处理)自动化,从而释放安全工程师的精力,专注于高阶漏洞挖掘。这种自动化框架的价值在于提升测试的可重复性、可扩展性和知识沉淀能力。在实际应用场景中,它可以与AI大模型(如Claude Code

coolmsn8786的博客 424

【信息科学与工程学】【数据中心】第三十五篇 云计算数据中心的学科知识04

编号学科(课程)核心知识点在云计算/云存储/云网络/云安全/云MaaS中的作用代表教材/资料/论文 + 数学方程式列表工业界应用D1421​云原生数据库:TiDB​HTAP(混合事务/分析处理)、分布式SQL、水平扩展、强一致(Raft)、自动故障恢复、与MySQL兼容、TiFlash列式引擎提供弹性扩展的分布式数据库;支撑高并发在线交易与实时分析教材:《TiDB in Action》PingCAP(2020) 论文:《TiDB: A Raft-based HTAP Database》(2017)

weixin_49199313的博客 404

【愚公系列】《移动端AI应用开发》044-基于DeepSeek的Android、iOS端应用插件开发实战(DeepSeek集成与数据传输)

文章摘要 本文介绍了如何基于DeepSeek API开发跨平台(Android/iOS)应用插件,重点围绕API集成与数据传输展开。通过代码示例演示了端到端数据流实现(请求构建、处理与响应解析)及会话状态管理方案(加密存储、SQLite数据库操作)。内容涵盖: DeepSeek API集成:封装请求模块,处理自然语言交互 数据流设计:从用户输入到API响应的高效传输逻辑 安全存储:采用Fernet加密和SQLite实现用户数据持久化 会话管理:通过唯一会话ID追踪上下文状态 适用于需要为移动应用添加智能功能

愚公智库 7175

ABAP代码使用OAuth2.0 Client Credential调用外部API

ABAP-OAuth2.0-调用外部API

m0_74015269的博客 1956

FastAPI学习,阶段3:数据库与ORM

本文包含 SQLAlchemy 基础 、SQLAlchemy + FastAPI 集成、Alembic 数据库迁移、异步数据库操作、数据库高级话题(索引、事务…)。

xiaoma的博客 923

Blazor Session设置

微软官方封装了一些浏览器的操作,其中就有Session的操作的封装ProtectedSessionStorage 微软文档因为我们知道,依赖注入的生命周期是Singleton程序Scoped网页:刷新,url直接跳转都会重置。Transient路由C# Blazor 学习笔记(10):依赖注入但是没有一个和浏览器绑定的生命周期。即浏览器关闭才会退出。这个是后端无法获取的,因为后端根本不知道浏览器何时关闭。这个只能用浏览器自带的缓存。

qq_44695769的博客 1788

【NLP】文献翻译4——CH-SIMS:中文多模态情感分析数据集与细粒度的模态注释

CH-SIMS: A Chinese Multimodal Sentiment Analysis Dataset with Fine-grained Annotations of Modality摘要1. 介绍2. 相关工作2.1 多模态数据集2.2 多模态情感分析2.3 多任务学习3. CH-SIMS 数据集3.1 数据获取3.2 标注3.3 特征提取4. 多模式多任务学习框架4.1 单模态子网4.2 特征融合网络4.3 优化目标5. 实验5.1 基准5.2 实验的细节5.3 结果和讨论5.3.1 与

YoungSeng's Blog 1万+

TLChat数据库设计详解:高效存储聊天记录与用户数据

TLChat作为高仿微信的开源项目,其数据库设计直接影响聊天体验的流畅度和数据管理的效率。本文将深入剖析TLChat的数据库架构、核心表结构设计及优化策略,帮助开发者理解如何构建高性能的即时通讯数据存储系统。 ## 数据库架构 overview 📊 TLChat采用**多队列分离存储**架构,通过TLDBManager实现数据库连接管理。核心代码定义了两个独立的FMDatabaseQueue

gitblog_07071的博客 423

用友u8服务器优化,用友U8erp软件运行的性能优化方案图文教程

今天一定要给大家分享一下用友U8erp软件运行的性能优化方案图文教程,以下方案来自用友软件官方维护工程师反馈在在处理客户问题的时候,有一类问题较为挠头,就是诸如用友U8服务器效率低下的问题。比如用友U8运行慢,卡住等,我们暂先不提用友U8软件代码、脚本层面本身的性能提升问题,我们只是基于现有用友U8软件版本,在客户现有环境下排查用友U8软件运行的性能瓶颈,并采取一定的技术手段进行性能调校。本文将推...

weixin_39882870的博客 5306

Douyin Downloader 深度解析:Python 驱动的抖音内容管理技术架构与实践指南

douyin-downloader 是一个基于 Python 开发的抖音内容下载与管理工具,采用异步架构设计,支持视频、图文、合集、音乐等多种内容类型的批量下载。该项目不仅实现了无水印视频下载的核心功能,还提供了完整的元数据管理、智能去重、断点续传等企业级特性。通过模块化设计,该项目将复杂的抖音 API 交互、浏览器自动化、文件管理等技术问题封装为可维护的组件,为技术开发者提供了研究抖音平台数据获

gitblog_00251的博客 703

ST-Link V2的隐藏技能:多通道串口调试的终极指南

本文深入探讨了ST-Link V2的多通道串口调试功能,突破传统烧录工具的限制。通过详细的硬件配置、Arduino IDE设置和实战案例,展示了如何利用SWD接口实现多通道数据监控,提升STM32F103C8T6等开发板的调试效率。文章还提供了PCB布局优化和性能调优技巧,助力开发者充分发挥ST-Link V2的潜能。

weixin_29285605的博客 355

Windows 11 + AMD 780M 运行 ComfyUI 完整指南:DirectML 实战方案

ComfyUI 是基于 PyTorch 的 Stable Diffusion 可视化工作流工具,其性能高度依赖 GPU 后端支持。在 Windows 平台,传统 CUDA 方案仅适配 NVIDIA 显卡,而 AMD 核显用户长期面临 ROCm 兼容性差、驱动链路断裂等系统级障碍。DirectML 作为微软原生机器学习 API,绕过 ROCm 生态断层,直接对接 DirectX 12 硬件抽象层,成为 RDNA 3 架构(如 Radeon 780M)在 Windows 11 上运行 AI 绘画的最优解。它提供

weixin_30099989的博客 727

Memos Docker部署实战指南:从零到企业级的最佳实践深度解析

作为技术决策者和运维工程师,我们经常面临这样的困境:如何将开源笔记系统快速部署到生产环境,同时确保数据安全、性能稳定和运维便捷?传统部署方式往往存在配置复杂、扩展困难、监控缺失等问题,而容器化部署虽然简化了流程,但在企业级场景下仍需解决网络隔离、数据持久化、安全加固等挑战。本文将带你从实际问题出发,通过"问题识别→方案设计→实施落地→效果验证"的四段式方法,深度解析Memos开源笔记系统的Dock

gitblog_00886的博客 789

【控制模块路径跟踪算法】PID控制算法实现路径跟踪(附C++代码)

认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长!本文先对PID控制算法实现路径跟踪–飞思卡尔的方法做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章提示:以下是本篇文章正文内容PID属于无模型控制,调节三个环节的参数会产生什么影响根据控制对象的不同也会有很大差别PID形象解释小明接到这样一个任务:有一个水缸点漏水(而且漏水的速度还不一定固定不变),要求水面高度维持在某个位置,一旦发现水面高度低于要求位置,就要往水缸里加水。

qq_35635374的博客 2386

在 Claude Code 中生成证据驱动的 SEO 优化交付物:claude-seo 的 FLOW Optimize 阶段结构化提示词(Claude Prompt 2)实战指南

本文讲解 claude-seo 项目中 [`skills/seo-flow/references/prompts/optimize/claude-prompt-2.md`](https://pre-link.gitcode.com/i/d8b4e5c7a0c2b1306dc25e04a497d19f) 所定义的「结构化 Optimize 提示词」:它用于让 Claude 以证据为边界、以执行可落地

gitblog_01036的博客 675

Python爬虫实战:美团商家数据采集系统

本文将详细介绍如何使用Python最新技术栈构建高效的美团商家信息采集系统。内容涵盖异步爬虫、反爬对抗、数据存储、可视化分析等完整流程,提供可落地的代码方案和工程实践。

2201_76125261的博客 2660

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

JuiceFS如何让S3真正支持POSIX文件系统语义

对象存储(如Amazon S3)本质是键值系统,缺乏目录、inode、原子rename等POSIX核心能力;其‘伪文件系统’实现(如s3fs)依赖HTTP层语义映射,导致list慢、open延迟高、write覆盖重传、rename非原子等问题。JuiceFS通过元数据与数据分离架构,将文件系统语义重建在Redis等高性能数据库之上,实现真正的ls、flock、mmap和强一致性访问。它不是封装S3,而是以S3为数据底座、用可插拔元数据引擎补全POSIX筋骨,显著提升AI训练、CI/CD、多线程应用等场景的吞

daxi1047的博客 382

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

基于Flask与OpenCV构建游戏PV视频分析工具:从关键帧提取到规则推理

视频处理与信息提取是多媒体内容分析领域的核心技术,其原理在于通过算法将连续的时序数据转化为可分析的结构化信息。在工程实践中,这通常涉及关键帧提取、特征标注与数据存储等环节,其技术价值在于能够将非结构化的视频内容转化为可查询、可推理的知识单元。在游戏开发与社区内容创作等应用场景中,这类技术可用于构建辅助分析工具,例如为角色宣传视频(PV)实现交互式标注与逻辑推理功能。本文以构建一个游戏PV“外置大脑”辅助推理工具为例,详细阐述了如何利用Flask框架搭建Web API,并集成OpenCV进行视频处理,实现从视

weixin_33709364的博客 750

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Django、Flask、Tornado框架选型实战指南

Web框架是构建服务端应用的核心基础设施,其本质是HTTP请求处理、路由分发、中间件编排与异步IO调度的技术载体。理解Django的全栈约定、Flask的显式可拆卸设计和Tornado的单线程事件循环原理,有助于规避N+1查询、上下文丢失、连接池耗尽等高频工程陷阱。三者技术价值迥异:Django胜在开箱即用的生产就绪能力,Flask强于轻量嵌入与微服务解耦,Tornado专精高并发长连接场景。典型应用场景包括内部管理系统(Django admin)、边缘设备API(Flask单文件部署)、实时协作服务(To

weixin_33901926的博客 366

百度提供的SQLite 执行 TPC-DS 基准测试方法

可以,但 TPC-DS 数据没法直接生成到 SQLite 文件里,得先借 DuckDB 的内存表生成,再用 CTAS 导出到 SQLite 文件。用 DuckDB 生成数据再导入 SQLite:DuckDB 内置 TPC-DS 扩展,可先在其内存中生成数据,再用 CTAS 语句导入 SQLite 文件。SQLite 本身并不直接支持 TPC-DS 基准测试,因为 TPC-DS 是为数据仓库和分析型系统(OLAP)设计的,而 SQLite 是嵌入式 OLTP 数据库,缺乏复杂查询所需的优化器能力。

l1t的专栏 142

内存数据库SQLite

本文以“黑板”比喻内存数据库,对比传统硬盘数据库,详解 SQLite 使用 :memory: 实现高速临时存储的原理与优势。通过动态占位符生成、executemany 批量操作等技巧,实现毫秒级数据读写,适用于单元测试、临时计算与隐私保护场景。强调其瞬时性与内存限制,提醒开发者注意数据量控制与安全防护,突出参数化查询防注入的核心价值。

看了都说刑的博客 324

量化数据管道实战:从接口调用到生产级落库(第 14 篇):SQLite 表范式设计

表设计不好,亿级历史一查就卡、一写就锁。本篇收口这个 14 篇周期,给出第一张能撑住管线的本地表:日线主表 + 股票维度表 + 合理索引。这也是本系列上半场(第 1–14 篇)的收官篇:从"发请求"到"本地落库可被策略调用",上半场的管道骨架在此闭合。下半场(第 15–28 篇)将进入落库进阶(UPSERT、分区索引、历史回填)、增量调度、多源对齐与生产化收官,本篇的表就是下半场所有工作的地基。

2601_96840033的博客 197
上一篇: NO.3|接入ChatGPT|Gemini|Ollama本地接入DeepSeek
下一篇: NO.5|ChatSDK|ChatServer|前端生成
ChoSeitaku
博客等级 码龄5年 3452粉丝 557原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值