Hadoop学习 MapReduce

Hadoop学习总结-上篇(HDFS、MapReduce) 跟学尚硅谷Hadoop3.x, 1 入门 1.1 优势与组成(面试重点) HDFS-Hadoop Distributed File System,一个分布式文件系统 NameNode(nn);DataNode(dn);Secondary NameNode(2nn) YARN-Yet Another Resource Negotiator ,另一种资源协调者,是 Hadoop 的资源管理器 MapReduce -Map 阶段并行处理输入数据; Reduce 阶段对 .. 阅读详情

MapReduce  思想
MapReduce 思想在生活中处处可见。或多或少都曾接触过这种思想。
MapReduce 的思想核心是“ 分而治之”,适用于大量复杂的任务处理场景(大规模
数据处理场景)。即使是发布过论文实现分布式计算的谷歌也只是实现了这种思
想,而不是自己原创。
Map 负责“分”,即把复杂的任务分解为若干个“简单的任务”来并行处理。
可以进行拆分的前提是这些小任务可以并行计算,彼此间几乎没有依赖关系。
Reduce 负责“合”,即对 map 阶段的结果进行全局汇总。
这两个阶段合起来正是 MapReduce 思想的体现。


MapReduce 最大的亮点在于通过抽象模型和计算框架把需要做什么(what
need to do)与具体怎么做(how to do)分开了,为程序员提供一个抽象和高层的编
程接口和框架。程序员仅需要关心其应用层的具体计算问题,仅需编写少量的处
理应用本身计算问题的程序代码。如何具体完成这个并行计算任务所相关的诸多
系统层细节被隐藏起来,交给计算框架去处理:从分布代码的执行,到大到数千小
到单个节点集群的自动调度使用。


. MapReduce  框架结构
一个完整的 mapreduce 程序在分布式运行时有三类实例进程:
1、MRAppMaster:负责整个程序的过程调度及状态协调
2、MapTask:负责 map 阶段的整个数据处理流程
3、ReduceTask:负责 reduce 阶段的整个数据处理流程


 MapReduce  编程规范及示例编写
2.1. . 编程规范 编程规范
(1) 用户编写的程序分成三个部分:Mapper,Reducer,Driver(提交运行 mr 程
序的客户端)
(2)Mapper 的输入数据是 KV 对的形式(KV 的类型可自定义)
(3)Mapper 的输出数据是 KV 对的形式(KV 的类型可自定义)
(4)Mapper 中的业务逻辑写在 map()方法中
(5)map()方法(maptask 进程)对每一个<K,V>调用一次
(6)Reducer 的输入数据类型对应 Mapper 的输出数据类型,也是 KV
(7)Reducer 的业务逻辑写在 reduce()方法中
(8)Reducetask 进程对每一组相同 k 的<k,v>组调用一次 reduce()方法
(9)用户自定义的 Mapper 和 Reducer 都要继承各自的父类
(10)整个程序需要一个 Drvier 来进行提交,提交的是一个描述了各种必要信
息的 job 对象


定义一个 mapper 

//首先要定义四个泛型的类型
//keyin: LongWritable valuein: Text
//keyout: Text valueout:IntWritable

public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable>{
//map 方法的生命周期: 框架每传一行数据就被调用一次
//key : 这一行的起始点在文件中的偏移量
//value: 这一行的内容
@Override
protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException
{
//拿到一行数据转换为 string
String line = value.toString();
北京市昌平区建材城西路金燕龙办公楼一层 电话:400-618-9090
//将这一行切分出各个单词
String[] words = line.split(" ");
//遍历数组,输出<单词,1>
for(String word:words){
context.write(new Text(word), new IntWritable(1));
}
}
}


定义一个 reducer 

//生命周期:框架每传递进来一个 kv 组,reduce 方法被调用一次
@Override
protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException,
InterruptedException {
//定义一个计数器
int count = 0;
//遍历这一组 kv 的所有 v,累加到 count 中
for(IntWritable value:values){
count += value.get();
}
context.write(key, new IntWritable(count));
}
}


Mapper 任务 任务 执行过程详解

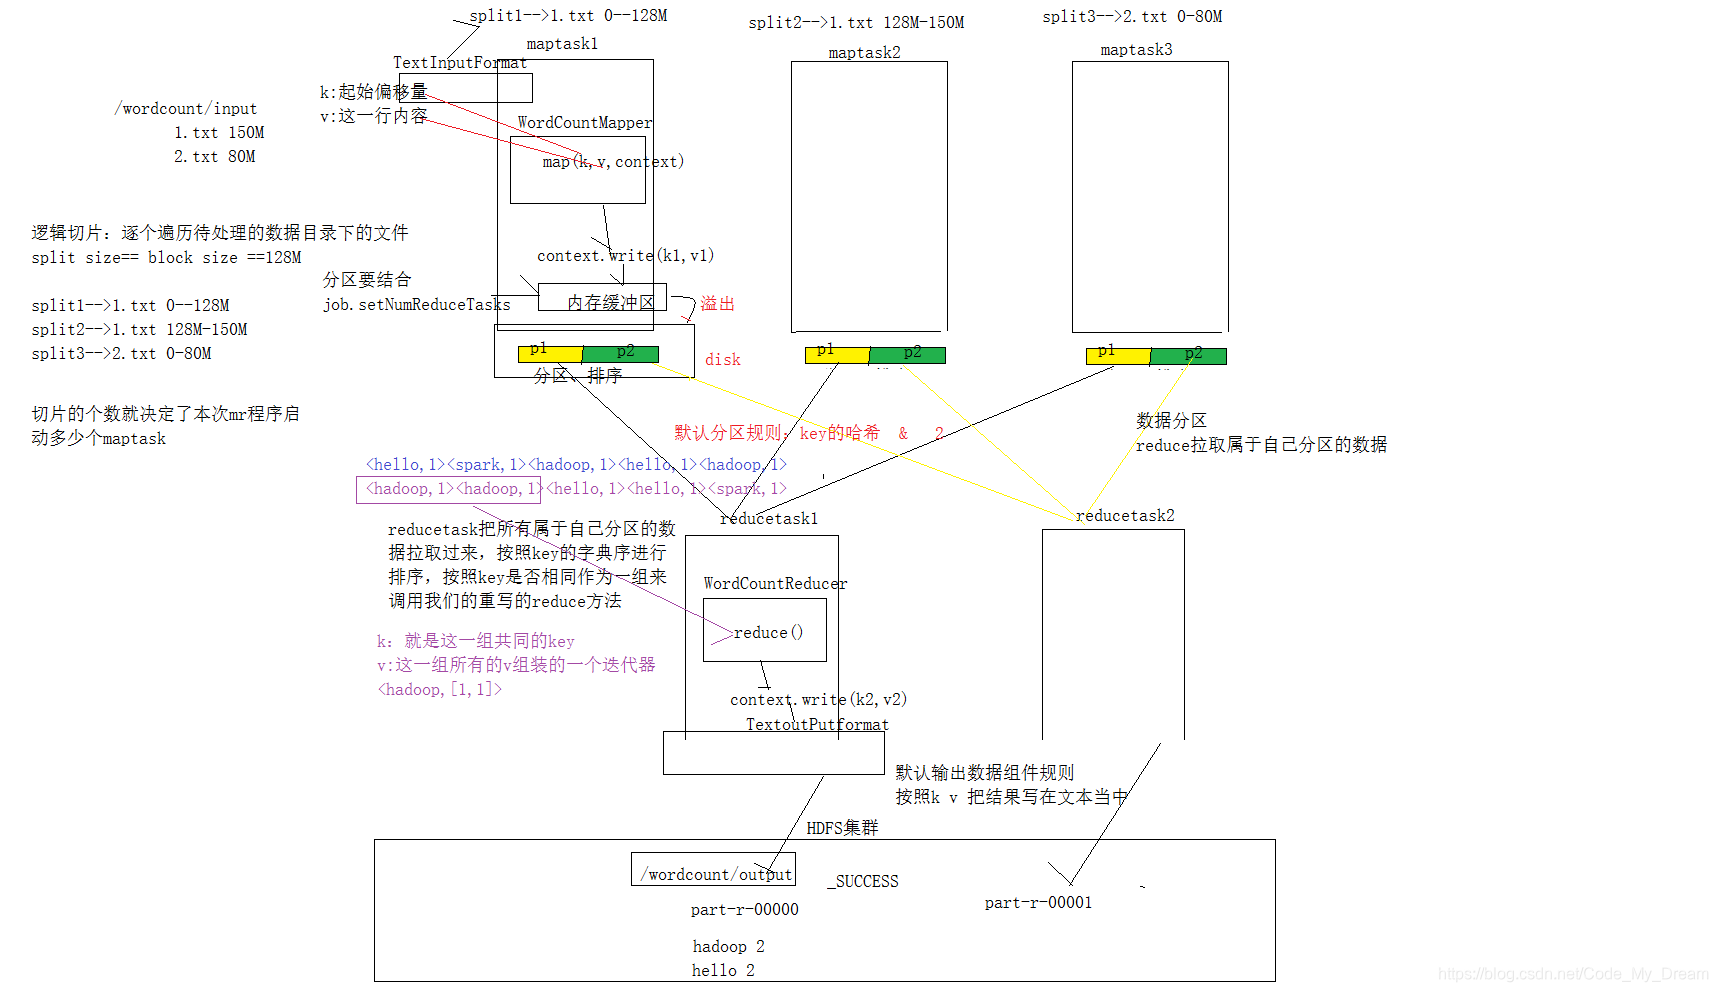
  第一阶段是把输入目录下文件按照一定的标准逐个进行逻辑切片,形成切
片规划。默认情况下,Split size = Block size。每一个切片由一个
MapTask 处理。(getSplits)

第二阶段是对切片中的数据按照一定的规则解析成<key,value>对。默认规
则是把每一行文本内容解析成键值对。key 是每一行的起始位置(单位是字
节),value 是本行的文本内容。(TextInputFormat)

 第三阶段是调用 Mapper 类中的 map 方法。上阶段中每解析出来的一个
<k,v>,调用一次 map 方法。每次调用 map 方法会输出零个或多个键值对。

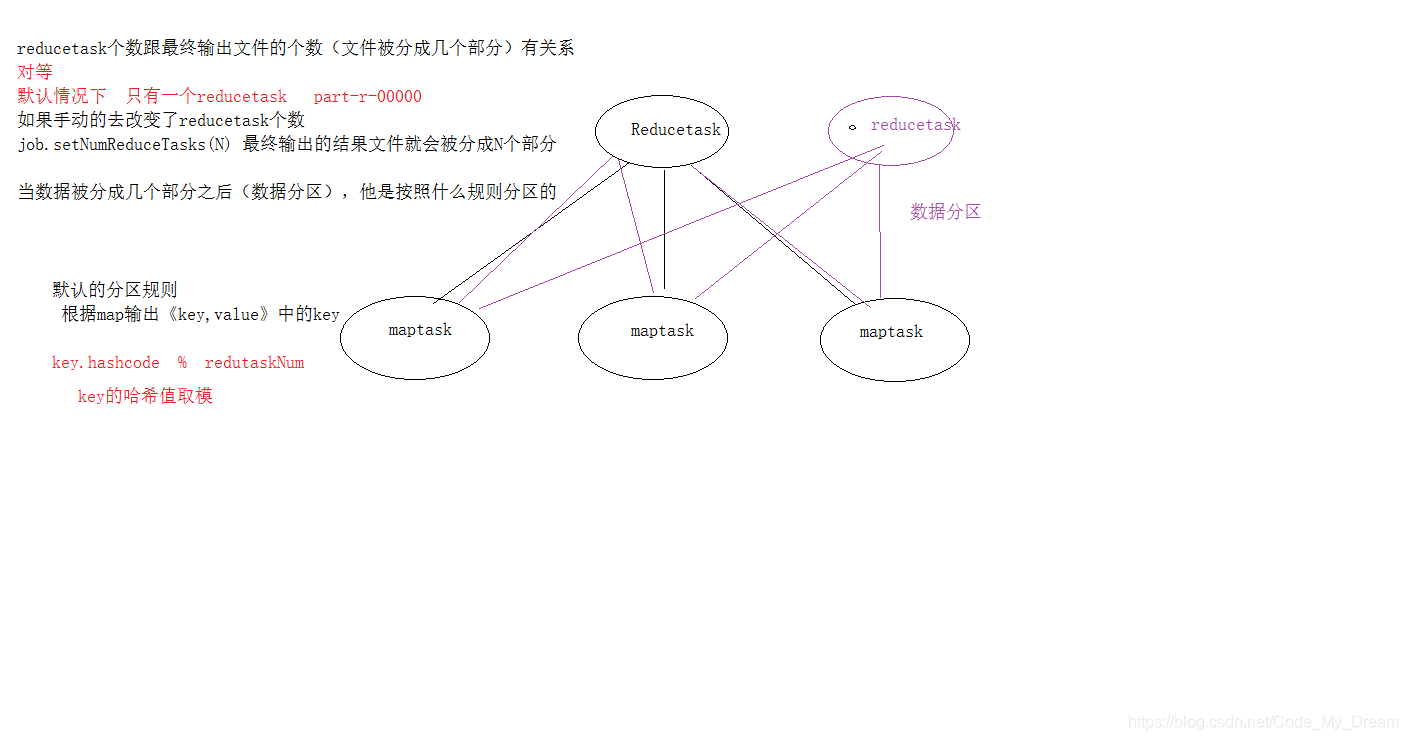
第四阶段是按照一定的规则对第三阶段输出的键值对进行分区。默认是只
有一个区。分区的数量就是 Reducer 任务运行的数量。默认只有一个
Reducer 任务。

 第五阶段是对每个分区中的键值对进行排序。首先,按照键进行排序,对
于键相同的键值对,按照值进行排序。比如三个键值对<2,2>、<1,3>、
<2,1>,键和值分别是整数。那么排序后的结果是<1,3>、<2,1>、<2,2>。
如果有第六阶段,那么进入第六阶段;如果没有,直接输出到文件中。

 第六阶段是对数据进行局部聚合处理,也就是 combiner 处理。键相等的键
值对会调用一次 reduce 方法。经过这一阶段,数据量会减少。 本阶段默认
是没有的 。


Reducer 任务 任务 执行过程详解
第一阶段是 Reducer 任务会主动从 Mapper 任务复制其输出的键值对。
Mapper 任务可能会有很多,因此 Reducer 会复制多个 Mapper 的输出。
第二阶段是把复制到 Reducer 本地数据,全部进行合并,即把分散的数据
合并成一个大的数据。再对合并后的数据排序。
 第三阶段是对排序后的键值对调用 reduce 方法。键相等的键值对调用一次
reduce 方法,每次调用会产生零个或者多个键值对。最后把这些输出的键
值对写入到 HDFS 文件中


大数据之Hadoop学习——动手实战学习MapReduce编程实例 文章目录一、MapReduce编程实例1.自定义对象序列化需求分析报错:Exception in thread &amp;amp;amp;amp;quot;main&amp;amp;amp;amp;quot; java.lang.IllegalArgumentException: Wrong FS: hdfs://192.168.17.10:9000/workspace/flowStatistics/output, expected: file:///解答一、正常处理即可,不过在... 阅读详情

相关推荐

从零开始学习Hadoop--第2章 第一个MapReduce程序

1.Hadoop从头说 1.1 Google是一家做搜索的公司 做搜索是技术难度很高的活。首先要存储很多的数据,要把全球的大部分网页都抓下来,可想而知存储量有多大。然后,要能快速检索网页,用户输入几个关键词找资料,越快越好,最好在一秒之内出结果。如果全球每秒有上亿个用户在检索,只有一两秒的检索时间,要在全球的网页里找到最合适的检索结果,难度很大。如果你准备了解大数据开发或是正在学习大数据开发,...

uhgrft4645的博客 1272

html取出单元格中的数值_详解10个工作中经常遇到的excel问题,一看就懂,让你秒变大神...

Hello,大家好,今天跟大家分享10个很多粉丝问到次数中最多问题,都会我们工作中经常遇到的一些问题,话不多说,下面就让我们来一起看一下吧一、输入数据前面的几个0显示我们在单元格中输入00025的时候,仅仅只会显示25,前面的几个0是不显示的,因为单元格会自动的屏蔽掉无意义的0,这个时候有两种方法,第一种方法:在输入数据之前将单元格格式设置为文本格式,这样的话我们输入什么就会在单元中显示什么。但是...

weixin_35640876的博客 297

MapReduce-Code:Hadoop平台下的MapReduce源码分析

MapReduce代码 MapReduce源码分析(主要四大模块,其他表示父目录下的.java文件的总称):1.org.apache.hadoop.mapred(旧版MapReduceAPI):( 1).jobcontrol(job作业直接控制类)(2 ).join :(作业作业中用于模仿数据连接处理工具)(3).lib(MapReduce所依赖的工具方法)| ----(1).aggregate(用于数据聚合处理的文件)| ----(2).db(数据库操作相关文件)| ----(3).others(4).pipes(Hadoop MapReduce的C ++接口代称)(5).tools(就包含了一个MRAdmin文件,(用于连接连接操作,新版本中已无此文件)(6).others 2.org.apache.hadoop.mapreduce(新版MapReduceAPI):(1).exampl

【Hadoop--MapReduce单词统计原理】

掌握MapReduce单词统计原理。

a2752454047的博客 993

Zynq 【SDK裸机开发之PS】——DDR的内存分配使用详解

Zynq如果跑操作系统的话,内存管理的工作都会交给系统来操作,但是如果是裸机的话,则需要自己对DDR3的内存进行管理。

shizhibuyi1234的博客 7375

卡诺图化简法

目录 1.学前需要了解知识点 2.卡诺图(karnaugh map) 3.逻辑函数的卡诺图化简法 4.总结 1.学前需要了解知识点 最小项的定义 最小项的表示方法 最小项的相邻性 最小项的定义:一个函数的某个乘积项包含了函数的全部变量,其中每个变量都以原变量或反变量的形式出现,且仅出现一次,则这个乘积项称为该函数的一个标准积项,通常称为最小项。 最小项的表示方法:通常用来表...

hahasusu的专栏 17万+

mapReduce求文本偏移量和每行数据的和

mapReduce求文本偏移量和每行数据的和 一.文本 二.建三个java类 Map Count Reduce 三.写Map 1、实例一个实体类,继承Mapper<输入放入key的类型,输入的value的类型,输出放入key的类型,输出的value的类型> public class WordCountMap extends Mapper<LongWritable,Te...

隔壁的橘猫的博客 2836

论文阅读《Eigen-GNN: A Graph Structure Preserving Plug-in for GNNs》

好久没看论文了,感觉好生疏 关于这篇文章的大致脉络,这篇文章已经介绍过了。

且视他人之疑目如盏盏鬼火,大胆地去走你的夜路 461

MapReduce--最最最基础部分

前言: MapReduce作为hadoop中和HDFS YARN 三大组件之一 还是很有必要去掌握其中原理 并进行代码编写 在这部分导包内容 是基于后续写代码的过程中 进行导入的(可跳过) package com.xkh.mr; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.LongWritable; import org.apach

Fishwetmaster的博客 407

超速U盘选购避坑指南:如何通过Rx Detect机制识别真伪USB3.0设备

本文深入解析了USB 3.0超速U盘的选购避坑要点,重点介绍了通过Rx Detect机制识别真伪设备的核心原理。文章提供了从软件检测到实际性能测试的完整方案,帮助消费者和技术人员有效辨别虚假的USB3.0设备,确保获得真正的超速传输体验。

weixin_29189373的博客 442

C++如何实时监测另一个进程是否已经退出?(附源码)

调用WaitForSingleObject实时监测目标进程是否已经退出

dvlinker的技术专栏 8275

MapReduce系统学习

新思潮: 移动计算比移动数据更划算,因为大量数据的时间耗时主要是在网络I/O 和磁盘I/O. 案例: 如果copy一个50G的内容,就算是内网的两台机器也很慢,如果是用U盘,那就比较快。 为什么呢? 因为没有网络IO,而磁盘IO一直是存在的。 MapReduce原理剖析 map端做的是局部的聚合排序,reduce是全局的聚合和排序。reduce是处理多个map多个分区的聚合结果。不可以混淆两者 ...

MyySophia的博客 1498

(10)三相三绕组变压器的建模仿真

建立了三相三绕组变压器组的Simulink仿真模型,通过实例进行了仿真计算。

weixin_45670943的博客 1141

Hadoop,MapReduce学习步骤

http://prinx.blog.163.com/blog/static/190115275201211128513868/  以下是我看过的最有价值的资料,收录在Core文件夹内,按如下顺序看效果最佳:  List代码   1.MapReduce Simplied Data Processing on Large Clusters   2.Hadoop环境的

KoalaY_Doctor的专栏 556

【2023年】云计算比赛——金砖挑战赛正式题

文章摘要 本文详细记录了OpenStack私有云平台与Kubernetes容器云平台的部署与运维过程,涵盖环境初始化、组件安装、服务配置及自动化运维等关键任务。主要内容包括: OpenStack部署 环境初始化(主机名、Yum源、FTP服务等) 核心组件安装(Keystone、Glance、Nova、Neutron等) 运维任务(安全组管理、镜像上传、存储服务配置等) Kubernetes集群搭建 节点配置(时间同步、免密登录) 容器运行时(Docker)与网络插件(Flannel)部署 Harbor私有仓

geekgold的博客 310

京东豆自动领取脚本配置教程

腾讯云/阿里云服务器(Docker环境):全自动跑脚本领京豆(无需本地代理,使用加速源)

AIOT魔法师 853

Hadoop学习(14)-MapReduce框架排序

原文来自:扎心了,老铁的《Hadoop学习之路(十九)MapReduce框架排序》

上海一九四三 225

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

hadoop之MapReduce学习教程

hadoop之YARN学习 MapReduce概述 MapReduce定义 MapReduce是一个分布式运算程序的编程框架,是用户开发“基于Hadoop的数据分析应用”的核心框架。 MapReduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并行运行在一个Hadoop集群上。 MapReduce优缺点 优点 易于编程 良好的扩展性 当你的计算资源不能得到满足的时候,你可以通过简单的增加机器来扩展它的计算能力。 高容错性 MapReduce设计的初

weixin_44178366的博客 700

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Hadoop MapReduce 学习笔记

本文的部分图片、文字来自于HKU COMP7305 Cluster and Cloud Computing,Professor: C.L.Wanghadoop官方文档:http://hadoop.apache.org/docs/r2.7.5/拓扑结构和硬件配置先讲一下Hadoop之前的底层的结构,我们是4人一组,每个人一台机器,装上Xen,然后用Xen开两个VM,就是一共8个VM,配置上格式跟下图...

世靖的码场 904

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Hadoop学习之MapReduce

MapReduce简介 1.什么是MapReduce? MapReduce做为hadoop三大核心组件之一,是一个分布式运算程序的编程框架,是用户开发“基于 hadoop 的数据分析应用”的核心框架。MapReduce 的核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个hadoop 集群上。 2.为什么要用MapReduce? (1) 海量数据在单机上处理因为硬件资源限制,无法胜任; (2) 一旦将单机版程序扩展到集群来分布式运行,将极大增加程序的复杂度和开发难

qq_34330118的博客 1138

hadoop之MapReduce学习

为什么需要MapReduce 进行分析数据,计算方便和复用性强;而且是文件级别的 进程包括三个 mrappmaster:负责整个程序管理 maptask:负责map阶段的整个过程 reducemask:负责reduce阶段的整个过程 为什么需要把jar包上传到集群上? 因为不止一个节点需要用到jar包,放到本地不能够被使用,因此放到集群上, namenode会告诉需要的节点...

dci75702的博客 194

Hadoop Mapreduce 学习

Shuffle过程是MapReduce的核心,也被称为奇迹发生的地方。要想理解MapReduce,Shuffle是必须要了解的。我看过很多相关的资料,但每次看完都云里雾里的绕着,很难理清大致的逻辑,反而越搅越混。前段时间在做MapReduce job性能调优的工作,需要深入代码研究MapReduce的运行机制,这才对Shuffle探了个究竟。考虑到之前我在看相关资料而看不懂时很恼火,所以在这里我尽最大的可能试着把Shuffle说清楚,让每一位想了解它原理的朋友都能有所收获。如果你对这篇文章有任何疑问或建..

大师兄你家猴跑啦的博客 557

hadoop学习:mapreduce的wordcount时候,继承mapper没有对应的mapreduce的包

问题描述 hadoop学习:mapreduce的wordcount时候,继承mapper没有对应的mapreduce的包 1)首先setting设置:idea和maven版本不兼容会导致这个问题的!!(我不太清楚,但是我从maven3.8.5降低版本到3.5.4就可以使用了) 2)其次是创建号maven文件后的pom.xml里面的依赖: 3)写好之后在idea右侧Maven点开 刷新一下,多出Dependencies就可以了 4)最终展示: 这就是我要解决的问题 打开idea自动更行maven 这个开

Kevinwen0228的博客 743

hadoop 学习笔记:mapreduce框架详解

非常简单详细明了的一篇文章,手动点赞吧!

Hebe 417
上一篇: Hadoop学习 HDFS 使用
下一篇: MapReduce  的序列化
Code_My_Dream
博客等级 码龄10年 75粉丝 236原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值