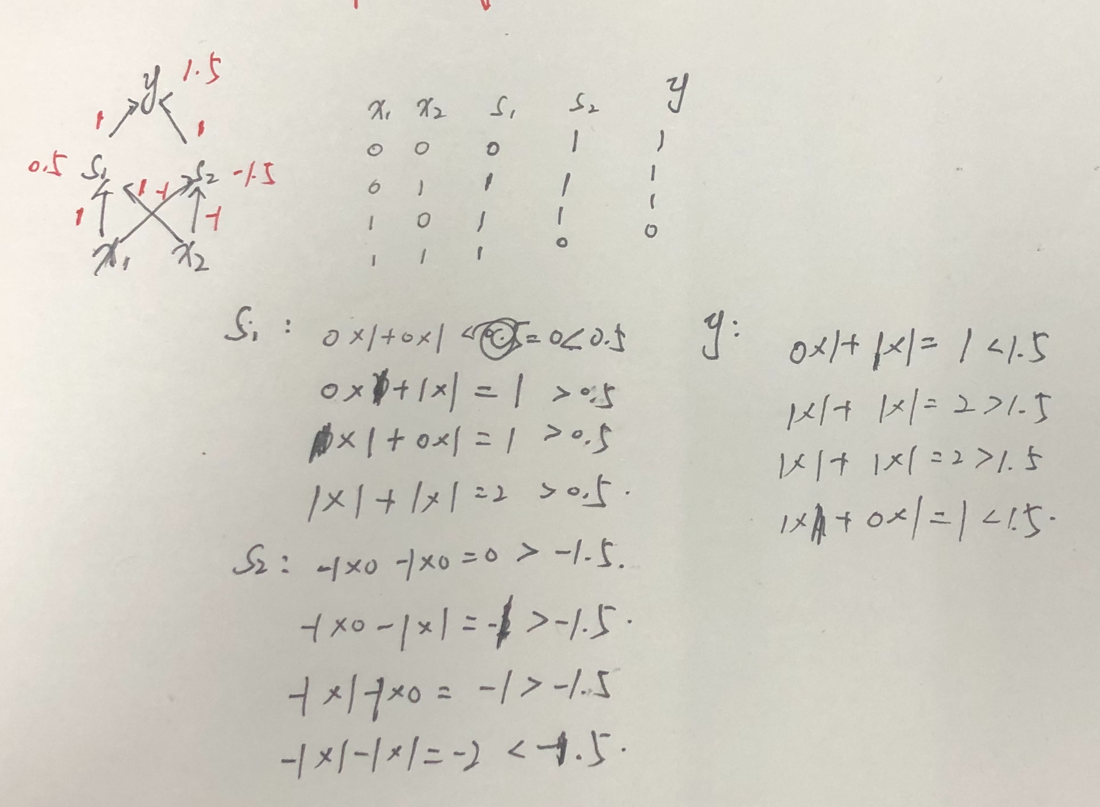
【西瓜书阅读笔记】05神经网络

神经网络中的权值共享 权值共享的卷积操作有效解决了这个问题,无论图像的尺寸是多大,都可以选择固定尺寸的卷积核,LeNet中最大的卷积核只有5*5*1,而在AlexNet中最大的卷积核也不过是11*11*3。2012年的AlexNet网络是深度学习的开端,但是CNN的开端最早其实可以追溯到LeNet5模型,它的几个特性在2010年初的卷积神经网络研究中被广泛的使用——其中一个就是。权值共享后意味着每一个卷积核只能提取到一种特征,为了增加CNN的表达能力,当然需要多个核,不幸的是,它是一个Hyper-Parameter。... 阅读详情

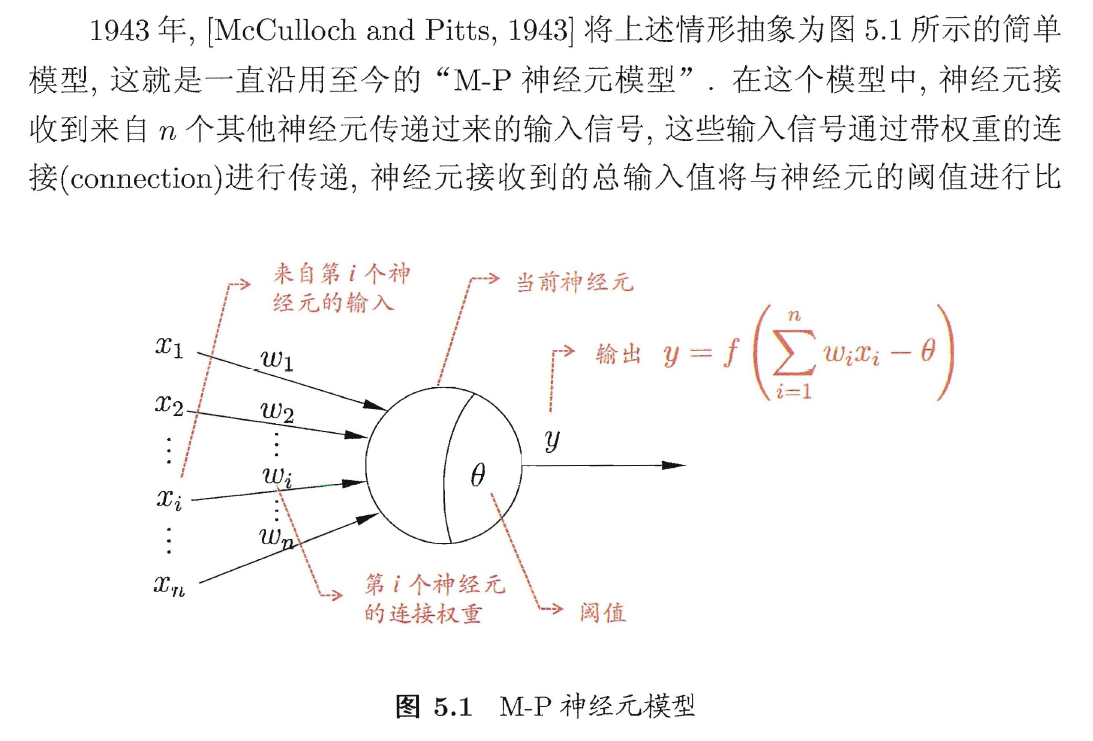
一、神经元Neuron

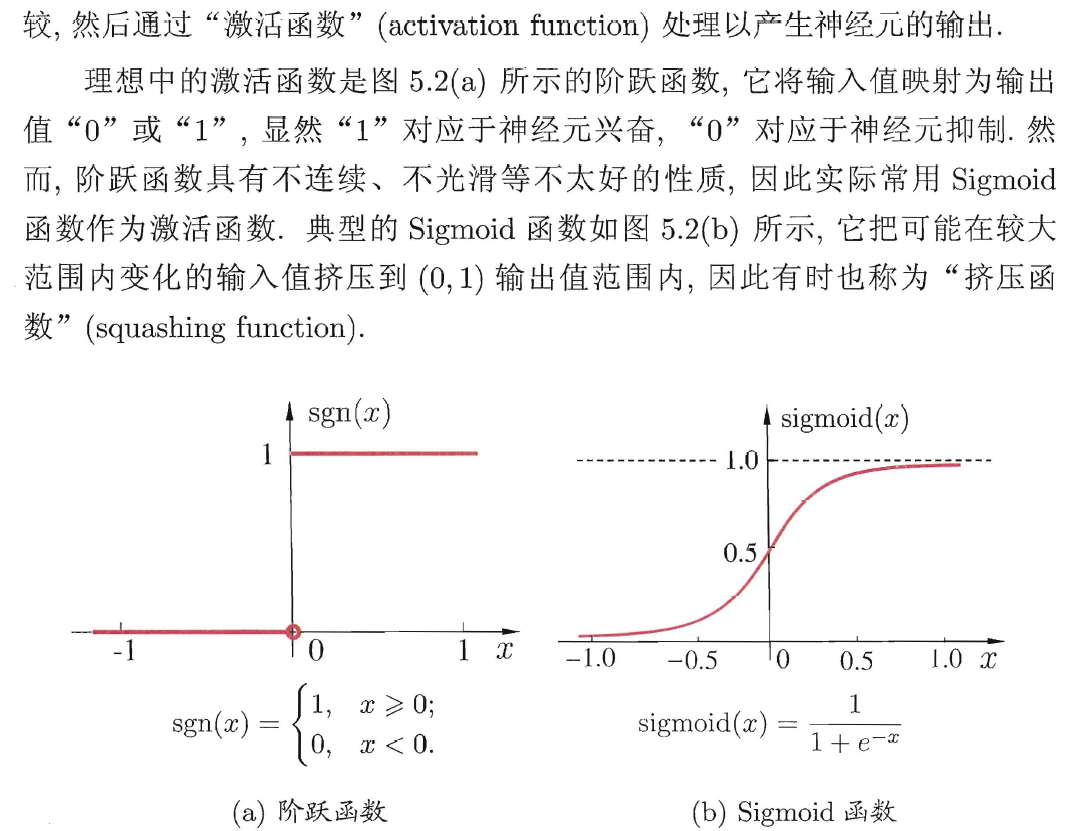
三种常见的激活函数:sgn, sigmoid, ReLU 
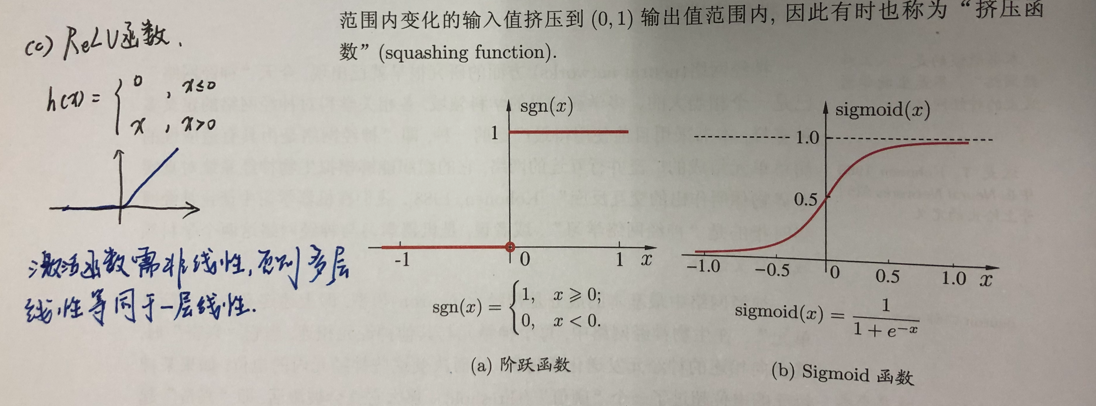
二、感知机Perceptron与多层网络

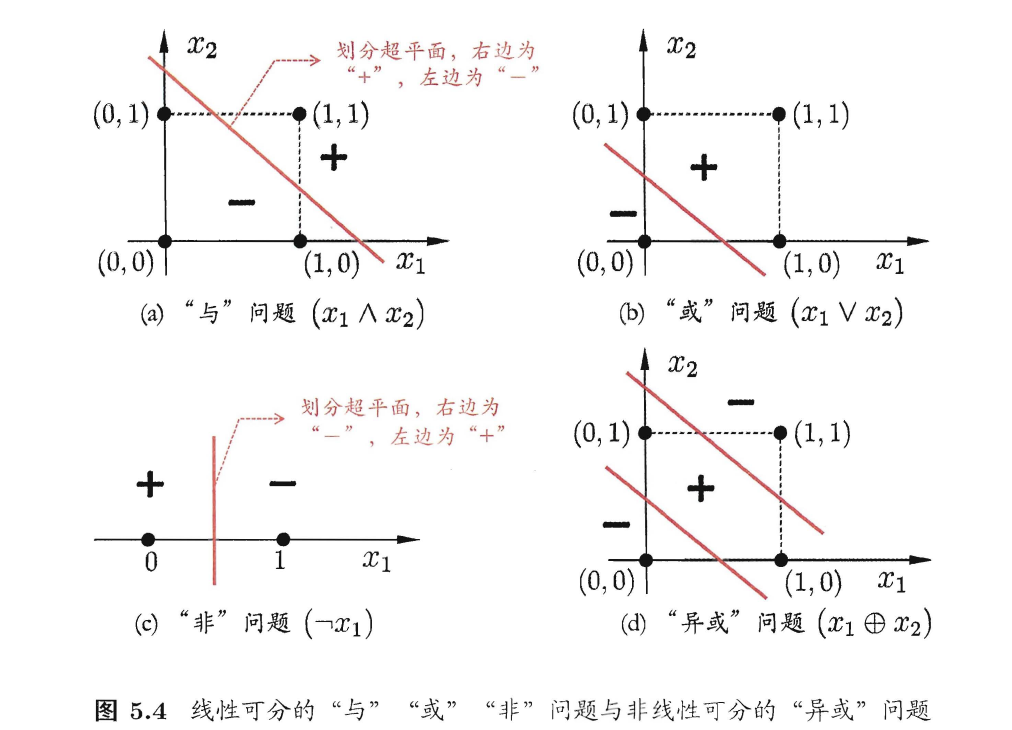
1、与(And),或(Or),与非(Not And),异或(Xor)
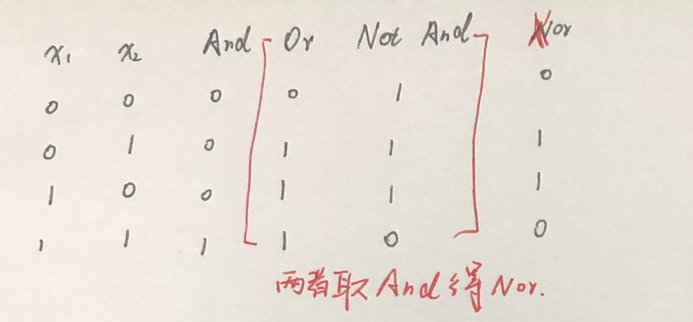
 2、多层网络构建“异或”门 
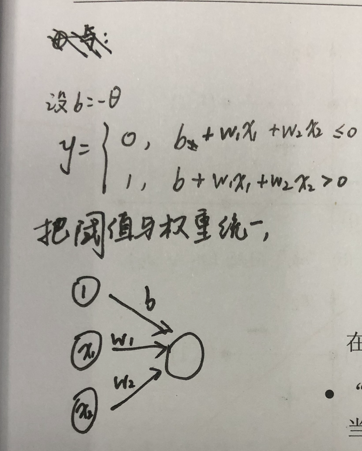
3、将阈值纳入权重
三、误差逆传播算法(error BackPropagation)

1、一个简单的单隐层网络
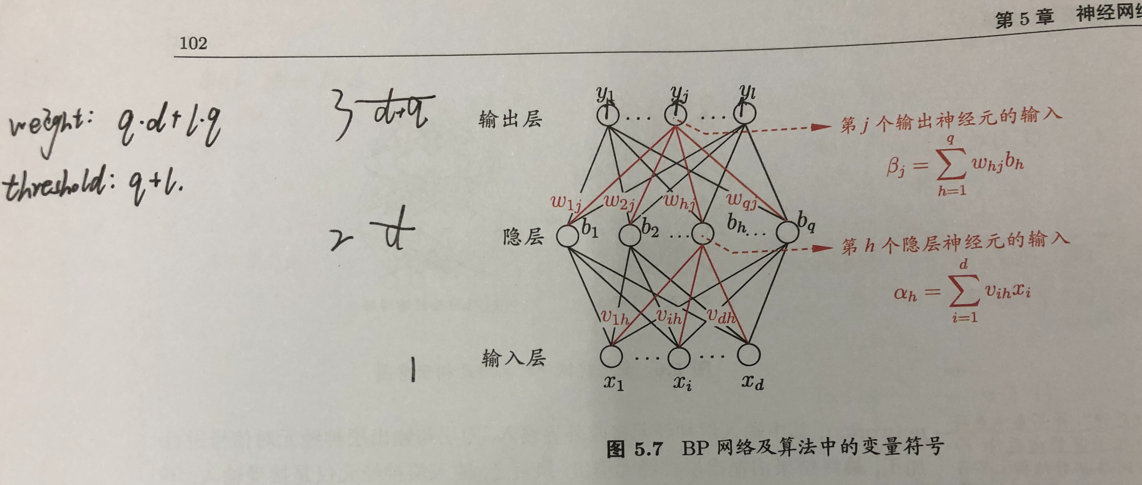
(1)每层每个nodes都有输入以及输出,这个需要谨记;

(2)假设每个神经元都使用sigmoid函数;

(3)输出层的输出可以写为:
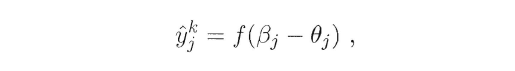
输出层的输入为beta,f即为sigmoid函数,theta为阈值;

(4)得到均方误差:
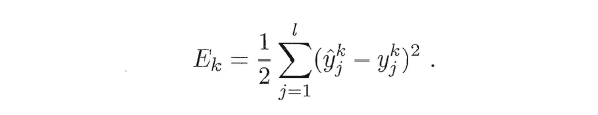
(5)此时该误差为神经网络参数的函数,参数包括(q*d+l*q)个权重以及(q+l)个阈值。调整参数使误差最小:
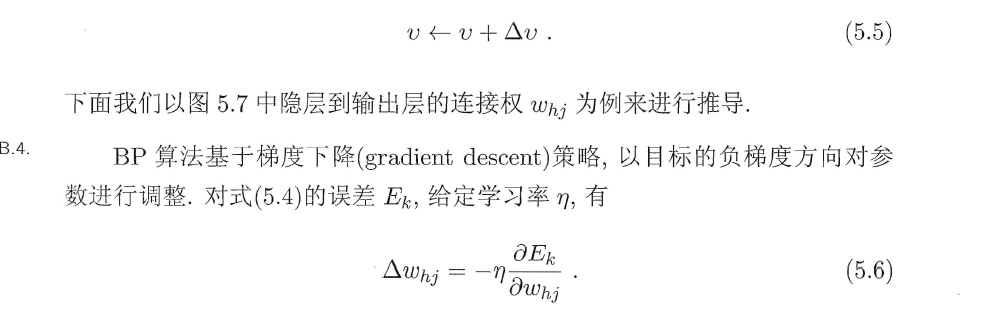
 (6)参数推导
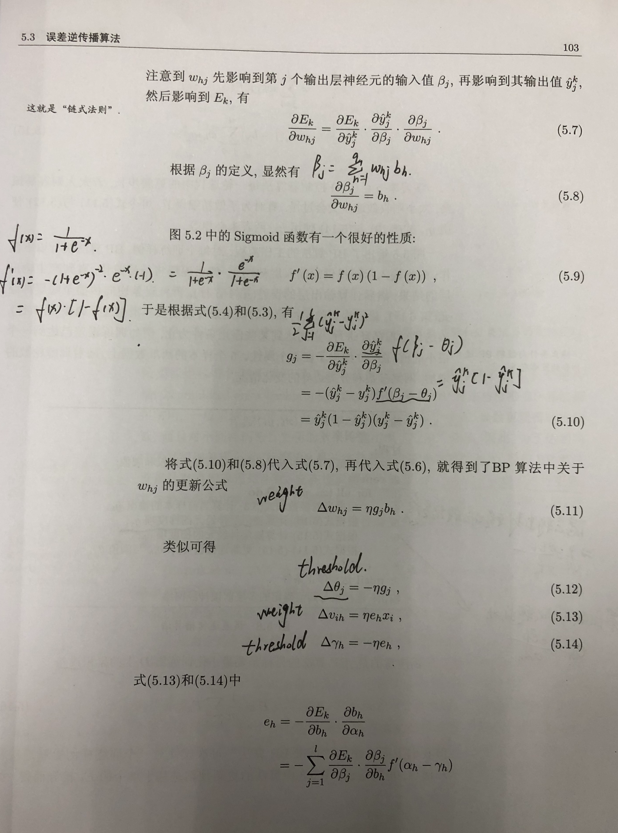
 (7)BP流程
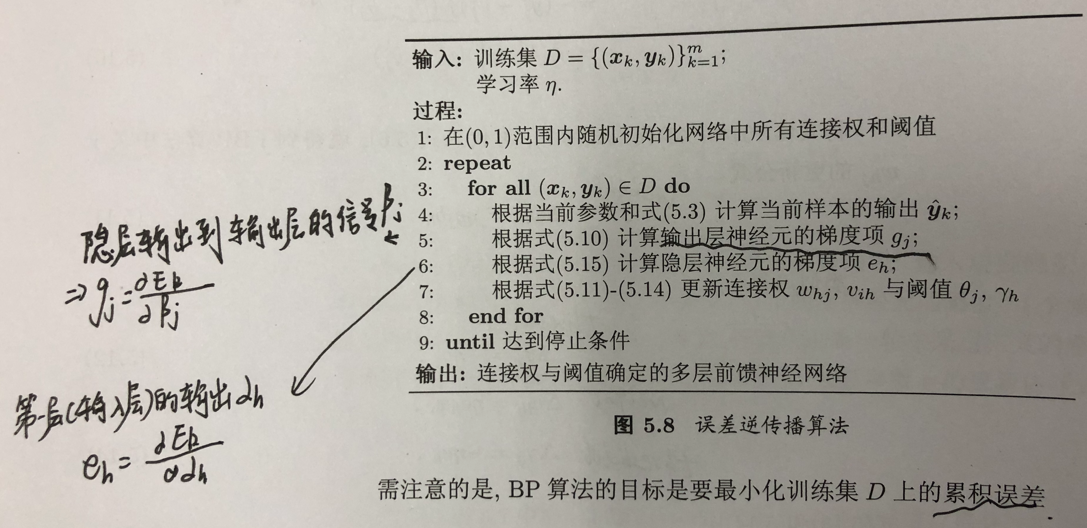
2、标准BP算法和累积BP算法

标准BP:针对单个样例;

累积BP:读取整个训练集后才对参数进行更新。

3、两种策略以控制overfitting

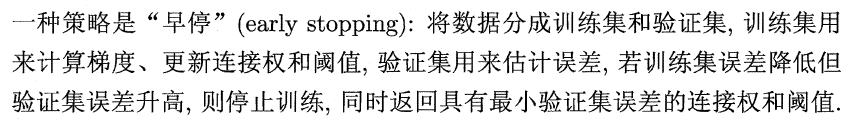
(1) early stopping:训练集误差降低但验证集误差升高时停止训练
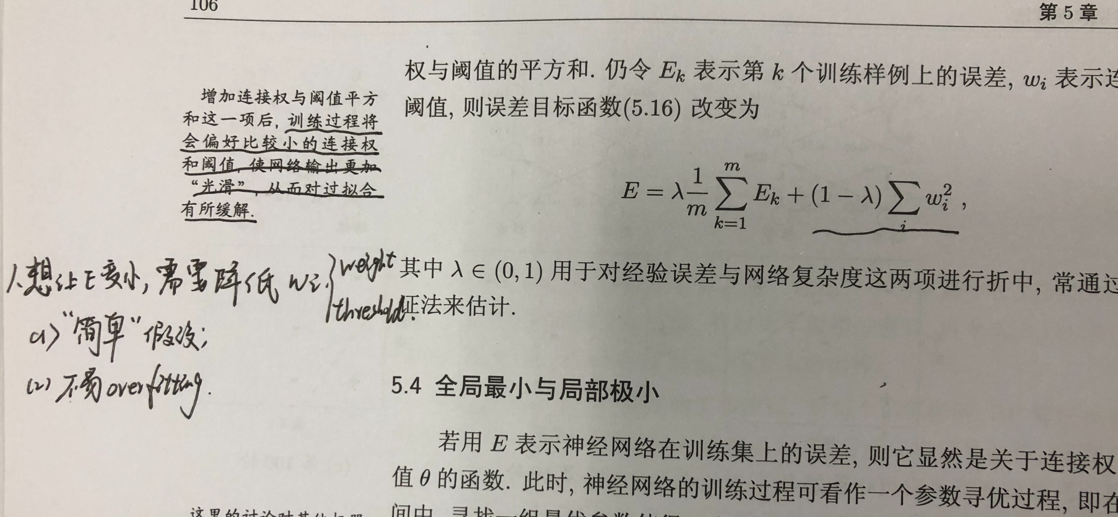
(2)regularization正则化

https://www.youtube.com/watch?v=KvtGD37Rm5I
 

四、全局最小与局部最小

1、概念:
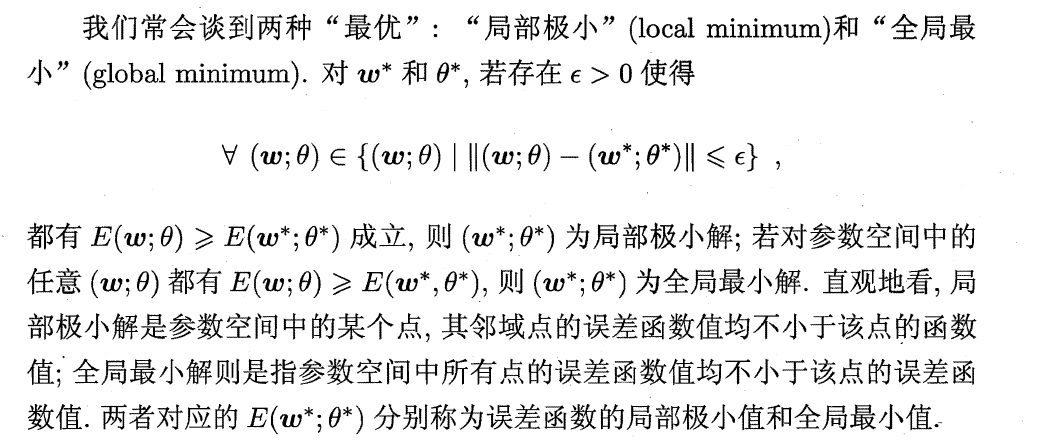
 2、跳出局部最小:

(1)以多组不同参数值初始化多个神经网络,取其中误差最小的解作为最终参数;

(2)模拟退火(repeated heating and cooling strengthens the blade);

接受次优解

(3)随机梯度下降法:即便陷入局部极小点,其梯度仍不为0(标准梯度下降法为0)。

五、其他常见的神经网络

1、RBF网络 Radial Basis Function

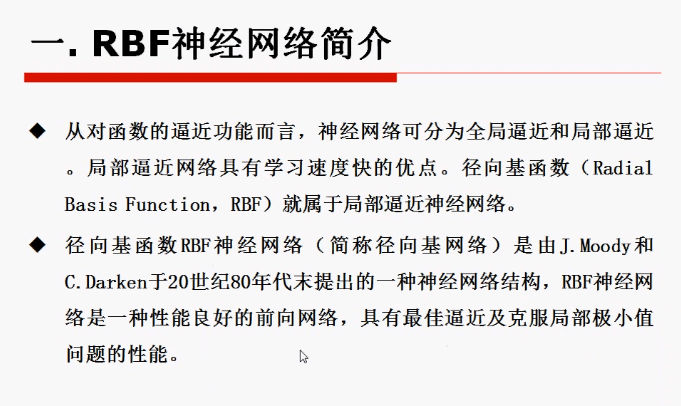
(1)隐层神经元激活函数为“径向基函数”:学习速度快;克服局部最小问题。
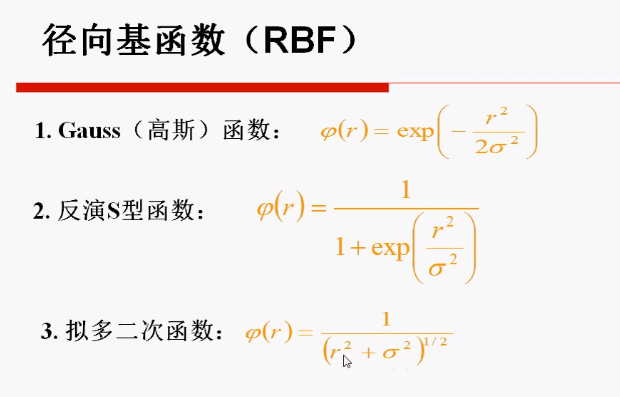
 (2)隐藏层函数:径向基函数。基函数有多种选择,可以通过优化基函数以优化算法。

其中r为样本x与中心c的距离。
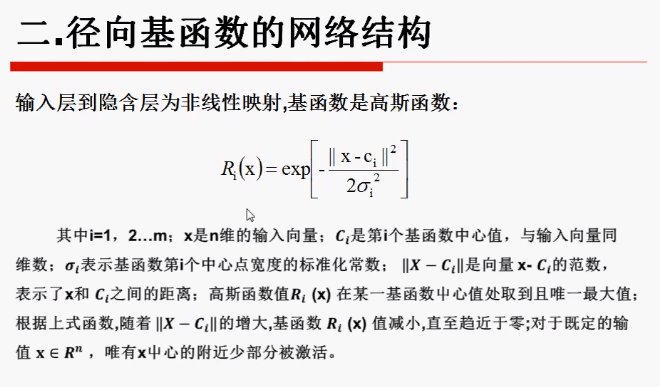
 (3)输入的距离越大,函数输出越趋近于0。因此只有中心附近可以被激活。
(4)两步法:
 2、ART网络 Adaptive Resonance Theory

(1)属于竞争型学习,网络的输出神经元相互竞争,每一个时刻仅有一个竞争获胜的神经元被激活;

(2)竞争方式:
 分类

(3)当识别阈值较高时,输入样本将被分成比较多、比较精细的模式类;如果识别阈值较低,则会产生比较少、比较粗略的模式类。

阈值高时,有更高的概率增设新神经元,形成比较多、精细的模式类。

(4)缓解了竞争性学习中的“可塑性-稳定性窘境”


3、SOM网络 Self-organizing Map自映射网络

(1)竞争型无监督神经网络:将高维输入数据映射到低维空间

(2)输出层获胜神经元
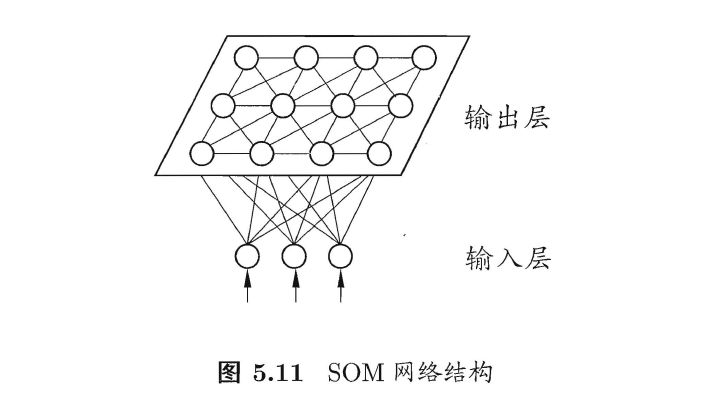
 (3)训练过程:选出输出层的最佳匹配单元
 

4、级联相关网络

(1)学习目标不止于连接权和阈值,还包含了网络结构(隐层层数,隐层神经元数量)

(2)两个主要成分:级联、相关

创建层级结构;最大化新神经元的输出与网络误差之间的相关性训练参数。

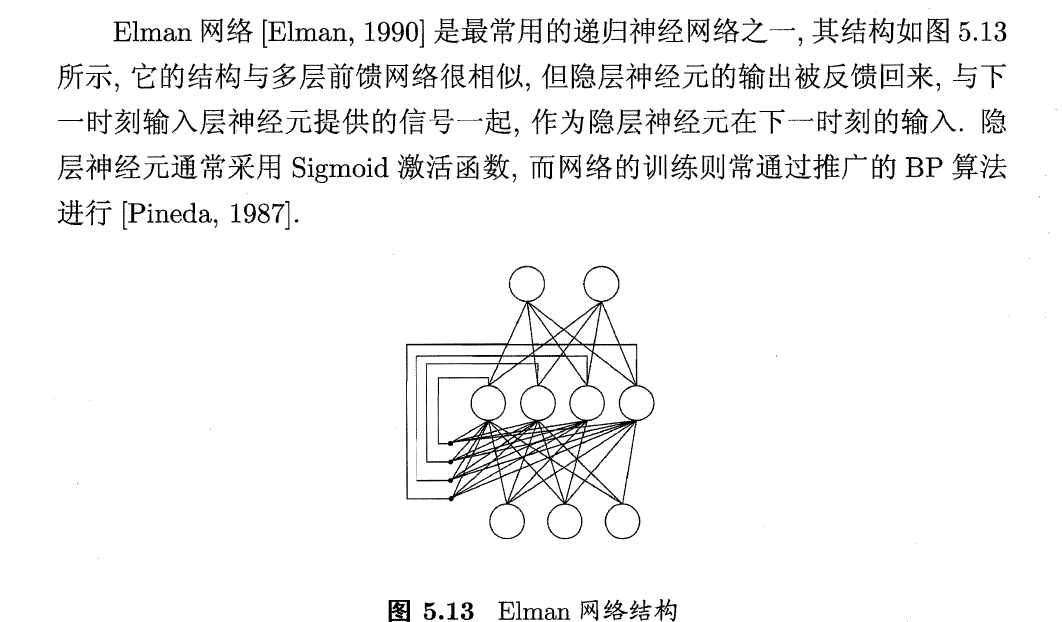
5、Elman网络(输入RNN网络)

(1)递归神经网络:RNN recurrent neural networks允许一些神经元的输出反馈回来作为输入信号
 (2)Elman
 6、Boltzmann机

(1)训练目标:最小化能量函数;

(2)向量s表示n个神经元状态,如(1,0,0,0,1,0,1);

(3)计算向量s对应的Boltzmann机能量;
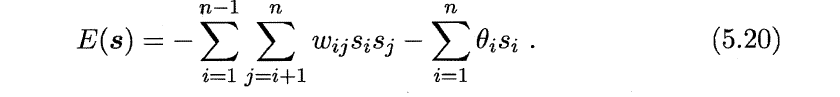
 (4)训练过程:将每个训练样本视为一个状态向量,使其出现概率尽可能大
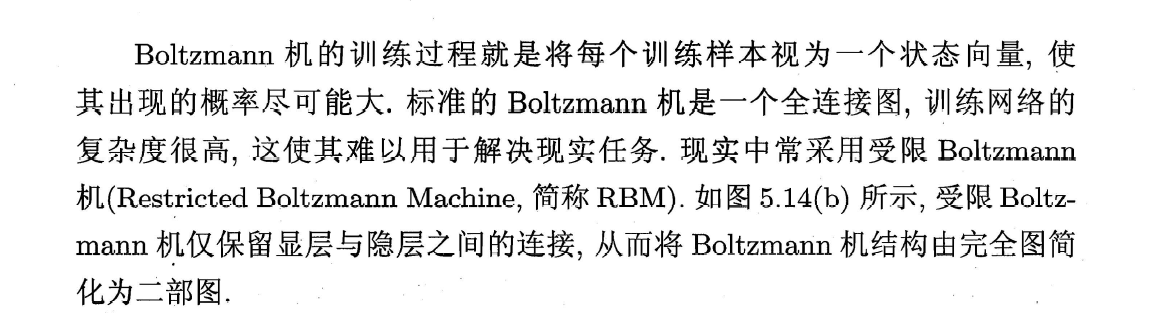
  (5)受限Boltzmann

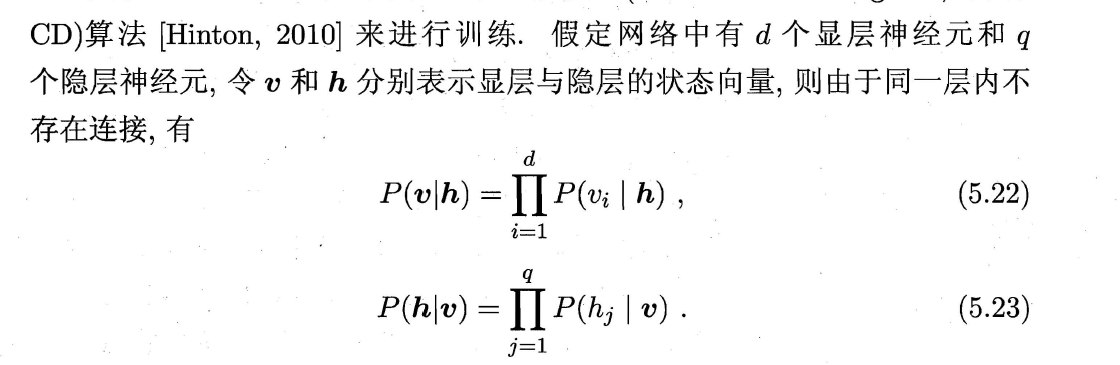
1)"对比散度" (Contrastive Divergence,简称CD)算法进行训练.

2)对每个训练样本u,根据(5.23)计算得隐层神经元状态概率分布,根据该概率分布采样得隐层状态向量h;根据(5.22)由h计算得u1,再根据u1及(5.23)计算得h1,循环往复。
 (3)连接权更新公式为:
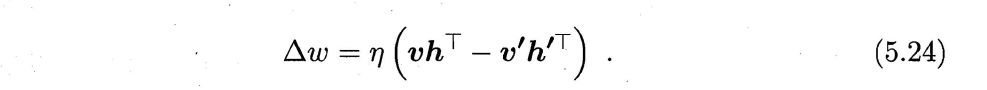
阈值类似获得。

六、深度学习

1、训练数据的大幅增加可以降低过拟合风险。

2、多隐层可以提升神经模型的表现;但多隐层神经网络难以直接用BP算法训练,因为误差在多隐层逆传播时难以收敛。

3、无监督逐层训练(unsupervised layer-wise training)是多隐层网络训练的有效手段:

(1)基本思想:预训练+微调

1)预训练(pre-training):将上一层隐结点的输出作为下一层隐结点的输入

2)微调(fine-tuning)

(2)可以视为:将大量参数分组,对每组找到局部最优;联合局部最优寻找全局最优。

4、权共享(weight sharing)

(1)让一组神经元使用相同的连接权,在卷积神经网络(CNN)起到较大作用;

(2)例子
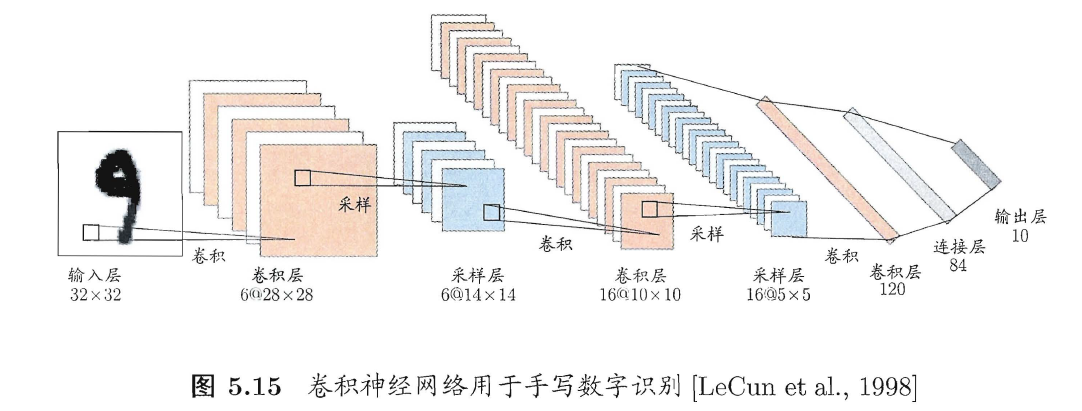
 1)第一个卷积层:有6个特征(面),每个特征由28*28的神经元阵列表示,每个神经元从5*5的区域通过卷积滤波器提取局部特征;

2)第一个采样层(亦称汇合层pooling):基于局部相关性进行亚采样,减少数据量且保留有用信息(类似PCA)。第一个卷积层(28*28)2*2计算输出,得到28/2=14*14的采样层。

3)在上图训练中,每个平面的神经元都是用相同的连接权,减少了参数。

5、特征工程

(1)描述样本的特征通常由人类专家设计,这称为“特征工程”。

(2)人类专家设计出好特征并非易事,因此特征学习通过机器学习技术自身产生好的特征,向“全自动数据分析”迈进。

 

神经网络中的权值共享是什么? 权值共享通常在卷积神经网络(Convolutional Neural Networks,CNNs)中使用,因为CNNs在图像处理等任务中有很强的表现,并且图像中的局部特征具有平移不变性,这意味着对于图像的不同位置,相同的特征可以共享相同的权重。权值共享的一个典型示例是CNN中的卷积层,其中卷积核的参数被共享,这允许网络在整个输入上检测相同的特征。权值共享是一种神经网络中的技术,它可以在模型中的不同位置共享相同的权重参数,从而减少模型参数的数量并改善模型的泛化能力。 阅读详情

相关推荐

西瓜书《机器学习》-第二章 模型评估与选择代码实现.zip

【我的博客有详细讲解】 题目要求: 1、选取某UCI分类数据集,划分数据集,用10折交叉验证,选用两个现成的分类算法(或者一个算法、参数不同),得到分类模型A和B,给出交叉验证预测结果。 2、对两模型的交叉验证预测结果,分别给出混淆矩阵、P、R和F1值,作出P-R曲线、ROC曲线,并求AUC。 3、应用paired t-test假设检验,比较两个模型性能的优劣。

《机器学习》西瓜书 算法代码 python实现

目录决策树算法ID3 以下代码均为本人原创,随本人学习进度和心情更新,欢迎讨论 决策树算法 ID3 使用 python3.7 # -*- coding: utf-8 -*- from math import log import pandas as pd class DecisionNode: ''' 若不为叶子结点 attribute: 当前判断属性 values: 属性所有可选值[value1,value2...] 若为叶子结点 attribute:

qq_46841701的博客 8052

逆向工程实战:手把手教你破解药监局网站的动态数据加载机制(Python+Chrome开发者工具)

本文详细介绍了如何利用Python和Chrome开发者工具逆向破解药监局网站的动态数据加载机制。通过分析Ajax请求、解析JSON响应数据以及处理动态参数,帮助开发者高效采集动态加载内容,适用于爬虫开发与数据分析场景。

weixin_30832143的博客 68

入门机器学习(西瓜书+南瓜书)模型选择与评估总结(python代码实现)

机器学习(西瓜书+南瓜书)第一、二章总结(python代码实现)

qq_26274961的博客 6255

fsQCA实战:从数据校准到结果解读的完整流程(附R代码示例)

本文提供了一份完整的模糊集定性比较分析(fsQCA)实战指南,详细阐述了从数据校准、必要条件分析、真值表构建到布尔最小化与结果解读的全流程。通过R语言代码示例,帮助研究者掌握如何将理论转化为可操作的分析步骤,并产出稳健的中间解,以揭示导致结果的复杂条件组合。

d6e7f8g9h的博客 1184

工业级越界行为识别数据集:YOLOv8/v9直接训练的围栏异常检测资源

越界行为识别是智能安防与工业安全中的基础视觉任务,其核心在于对人员、车辆等目标跨越物理边界(如围栏、警戒线、作业禁区)的精准检测与分割。该技术依赖于高质量实例分割标注、归一化坐标格式及场景鲁棒性设计,具备低延迟、高召回、强泛化等工程价值,广泛应用于智慧工地电子围栏、化工厂禁区告警、物流园区越界监控及变电站安全巡检等真实工业场景。本数据集以YOLOv8/v9为基准构建,提供万张实拍+合成图像、像素级Segmentation标注、分层划分与完备元数据,开箱即用,直击工业落地中数据清洗、格式转换与标注不一致等关键

weixin_30080745的博客 322

(西瓜书)对数几率回归代码详解

""" 训练样本(Training sample data.txt) -0.017612 14.053064 0 -1.395634 4.662541 1 -0.752157 6.538620 0 -1.322371 7.152853 0 0.423363 11.054677 0 0.406704 7.067335 1 0.667394 12.741452 0 -2.460150 6.866805 1 0.569411 9.548755 0 -0.026632 10.427743 0 0.850433 6.

xiao_haohao的博客 660

Win11下DCMTK的Visual Studio 2022配置教程

最近有个新需求,需要完成读取和解析DICOM数据相关的SDK

qq_45797625的博客 3264

秦州:西瓜书 + 南瓜书 吃瓜系列 16. 计算学习理论(上)

吃瓜教程——西瓜书+南瓜书 Datawhale南瓜书是经典机器学习教材《机器学习》(西瓜书)的公式推导解析指南,旨在让在学习西瓜书的过程中,再也没有难推的公式,学好机器学习。 内容属性:机器学习(理论)专题 航路开辟者:谢文睿、秦州 领航员:凌亮、张海腾、邱振波、刘琳、薛皖中、郑锴岚、陈伟峰、潘磊 航海士:谢文睿、秦州 开源内容:https://github.com/datawhalechina/pumpkin-book B 站视频:https://www.bilibili.com/video/BV1Mh

老马的程序人生 502

海康WEB3.3控件开发包 V3.3 前端vue项目调用实时监控画面

本需求的完成离不开后端将设备映射到公网, 以及前端单独部署demo页面这个思路的转变。

hero8011的博客 1万+

【EMC专题】为什么芯片规格书ESD性能中看不到MM(机器放电模型)

器件级ESD包括三种类型,HBM人体放电模型、MM机械放电模型和CDM元件充电模型。但在芯片规格书中为什么只见到HBM模型与CDM模型,却没有看到MM模型的数据?

一点硬件 455

【LLM大模型】机器学习导论(西瓜书)[推荐阅读]_大模型 教材 机器学习

第1章 绪论第2章 模型评估与选择第3章 线性模型第4章 决策树第5章 神经网络第6章 支持向量机第7章 贝叶斯分类器第8章 集成学习第9章 聚类第10章 降维与度量学习第11章 特征选择与稀疏学习第12章 计算学习理论第13章 半监督学习第14章 概率图模型第15章 规则学习第16章 强化学习。

z551646的博客 364

单智能体篇:Prompt工程艺术

模型在接收到 Prompt 时会自动扮演“角色”,角色定义的好坏直接影响智能体输出的风格和专业性。角色定义的重要性让智能体具备明确身份,例如“你是一位专业理财顾问”或“你是一个幽默的文案创作助手”。角色限定了模型知识输出的范围,使回答更专业、更贴合预期。实战示例模糊Prompt给我一些投资建议。你可以投资股票或者基金。优化Prompt你是一位具有10年经验的专业理财顾问,请给我针对30岁男性,年收入20万,风险偏中等的投资组合建议。

公众号:AI前沿侦探 1306

【组队学习】【30期】吃瓜教程——西瓜书+南瓜书

吃瓜教程——西瓜书+南瓜书 航路开辟者:谢文睿、秦州 领航员:邱振波 航海士:谢文睿、秦州 基本信息 开源内容:https://github.com/datawhalechina/pumpkin-book B 站视频:https://www.bilibili.com/video/BV1Mh411e7VU 内容属性:机器学习(理论)专题 内容说明:周志华老师的“西瓜书”是机器学习经典入门教材,值得反复阅读,配合“南瓜书”从本科数学基础的视角进行讲解,一起打好基础! 定位人群:有本科数学基础(高等数学、线

老马的程序人生 726

YOLOv8【第十一章:视频追踪与流处理篇·第16节】一文搞懂,DeepStream 部署入门:NVIDIA 视频分析 SDK 与 YOLOv8 结合!

🏆 本文收录于 《YOLOv8实战:从入门到深度优化》 专栏。该专栏系统复现并梳理全网各类 YOLOv8 改进与实战案例(当前已覆盖分类 / 检测 / 分割 / 追踪 / 关键点 / OBB 检测等方向),坚持持续更新 + 深度解析,质量分长期稳定在 97 分以上,可视为当前市面上 覆盖较全、更新较快、实战导向极强 的 YOLO 改进系列内容之一。

**My Coding Family** 842

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

【组队学习】【33期】组队学习内容详情

第33期 Datawhale 组队学习活动马上就要开始啦! 01月05日(星期三),宣发,寒假组队学习计划!。 01月08日(星期六),进入学习群、开营仪式。 本次组队学习的内容为: 吃瓜教程——西瓜书+南瓜书 动手学数据分析 李宏毅机器学习(含深度学习) 数据可视化(Matplotlib) LeetCode刷题 Scratch(一级) 大家可以根据我们的开源内容进行自学,也可以加入我们的组队学习一起来学。 1. 吃瓜教程——西瓜书+南瓜书 航路开辟者:谢文睿、秦州 领航员:潘磊 航海士:谢文睿

老马的程序人生 716

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

掌握“机器学习”,这可能是比啃西瓜书更高效的方法

儿子初三了,今天单位开会晚了,同事就开玩笑的跟我讲,快回家给孩子补习功课去,我很尴尬的笑了笑。虽然我号称是个理工科博士,但自打小学一年级给孩子补课受挫后,基本上就把这个重...

fuyipingwml1976124的博客 310

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

<机器学习>第五章阅读

神经元模型:每个神经元都接收到其他n个神经元的输入信号,将神经元接收到的总输入值与神经元的阈值作比较,当输入值大于阈值时,神经元就被激活,产生一个输出信号,最后通过。神经元模型内层是线性的,外层是非线性的激活函数,激活函数作用是让神经网络能够表示非线性关系,通过不断的学习,就能得到输入与输出之间的非线性关系。全局最小是局部最小的一种特殊情况,全局最小意味着在整个参数空间中找到的最优解,而局部最小是在某邻域内的最优解,所以可能存在多个局部最小点。由下图可知,当总输入值小于阈值时,映射为0,反之为1。

weixin_70251770的博客 1657

从神经网络(BP算法及传播过程的实例分析)到深度学习 (二)

BP算法的推导分析和实现过程 【参考:周志华教授的西瓜书,李沐等的《动手学深度学习》,电科大张栗粽老师的课件; [Poll的笔记](https://www.cnblogs.com/maybe2030/p/5597716.html); [BP算法详解](https://www.cnblogs.com/duanhx/p/9655213.html); [AI从入门到放弃:BP神经网络算法推导及代码实现笔记](http://baijiahao.baidu.com/s?id=1603526007545961785&a

Ax的博客 1148

【阅读材料精选 From-to-Date:2020.05.01~2020.10.31】

【阅读材料精选 From-to-Date:2020.05.01~2020.05.09】 重点内容 【PyTorch教程的更新和改进】 介绍页: https://pytorch.org/blog/updates-improvements-to-pytorch-tutorials/ 尝试页:https://pytorch.org/tutorials/recipes/recipes_index.html 【基于单目视频的自监督人体深度估计】 web:https://www.arxiv-vanity.com/pap

adolhung的博客 617

智慧图书阅读基于HarmonyOS ArkTS 24实现完成为了支持本地持久化(书架列表的progress直接读取避免每次计算),这种“缓存trade-off“在性能敏感场景下是合理的工程选择

在 HarmonyOS NEXT 正式商用的背景下,ArkTS 作为鸿蒙生态的官方应用开发语言,正在从传统的命令式 UI 开发范式向声明式 UI 范式全面迁移。ArkUI 框架以组件化、声明式、状态驱动为核心特征,要求开发者以"描述 UI 应该是什么样"而非"一步步操作 UI 怎么变"的思维方式构建界面。

2301_79516720的博客 302

如何快速搭建机器学习实战环境:面向初学者的完整指南

如果你正在学习《机器学习》(西瓜书),想要通过代码实战来加深理解,那么这个项目正是为你准备的!《机器学习》(西瓜书)代码实战项目是一个基于Python的开源学习资源,它通过13个核心算法模块帮助你从理论走向实践。无论你是机器学习新手,还是希望巩固基础的中级学习者,这里都为你提供了完整的代码实现和可视化展示。 ## 🎯 为什么选择这个项目? 这个项目的独特之处在于它实现了"数码结合"——将数学

gitblog_00858的博客 75

CS231n课程相关资料

视频课程主讲:斯坦福李飞飞团队 先修课程:斯坦福机器学习(吴恩达) 这门课的宗旨就是:从机器学习者成为计算机视觉算法工程师,参加Kaggle比赛证明自己 课程资料 课程主页 英文笔记 中文笔记 课程视频 实验环境推荐使用Linux或者Mac系统,以下环境搭建方法皆适用: Docker环境配置 本地环境配置 作业链接 作业参考 重要????????一些的资源: 深度学习斯坦福教程 廖雪峰python3教程...

地山谦的博客 494

为一月份开设的组队学习课程投票啦

目前Datawhale的开源内容分为两种:第一种是已经囊括在我们的学习路线图内的Datawhale精品课,第二种是暂未囊括在我们的学习路线图内的Datawhale测试课。 我们根据您的投票来确定精品课程的排期,其它测试课程一旦完成,即可排入我们每个月的组队学习。 请选择您一月份希望学习的Datawhale精品课程。如果某门课程超过100人选择,那么我们就邀请该课程设计者开设该课程的组队学习。 -> 插入投票 01 吃瓜教程——西瓜书+南瓜书 内容属性:机器学习(理论)专题 航路开辟者:谢文睿、秦州

老马的程序人生 1719

Datawhale组队学习周报(第039周)

本周报总结了从 11月08日至11月14日,Datawhale组队学习的运行情况,我们一直秉承“与学习者一起成长的理念”,希望这个活动能够让更多的学习者受益。 第 30 期组队学习一共 8 门开源课程,共组建了 8 个学习群,参与的学习者有 908 人,该八门课程全部经营。 01 深入浅出Pytorch 02 时间序列分析 03 CV中的Transformer 04 李宏毅机器学习(含深度学习) 05 青少年编程(Scratch 三级) 06 吃瓜教程——西瓜书+南瓜书 07 树模型与集成学习 08 机器

老马的程序人生 960

Datawhale线上组队学习汇总

组队学习就是一群志同道合的小伙伴,一起学习讨论,一起克服拖延症,一起组队打boss。没有老师,没有教学,有的是一群热爱学习和渴望改变的人,交流学习,互促共进。 <font color='red'><b>如果您对哪门开源内容感兴趣,请在下方留言区写上课程的名称。我们就邀请该课程设计者开设该课程的组队学习。</b></font>

老马的程序人生 2739
上一篇: 【文献阅读】Journal of Finance76卷5期
下一篇: 【文献阅读】Do economic variables forecast commodity futures volatility
Checkmate9949
博客等级 码龄5年 6176粉丝 43原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值