Kafka上的优化经验

Kafka篇之参数优化进而提高kafka集群性能 kafka参数优化 阅读详情

1. 平滑扩容

Motivation

kafka扩容⼀台新机器的流程

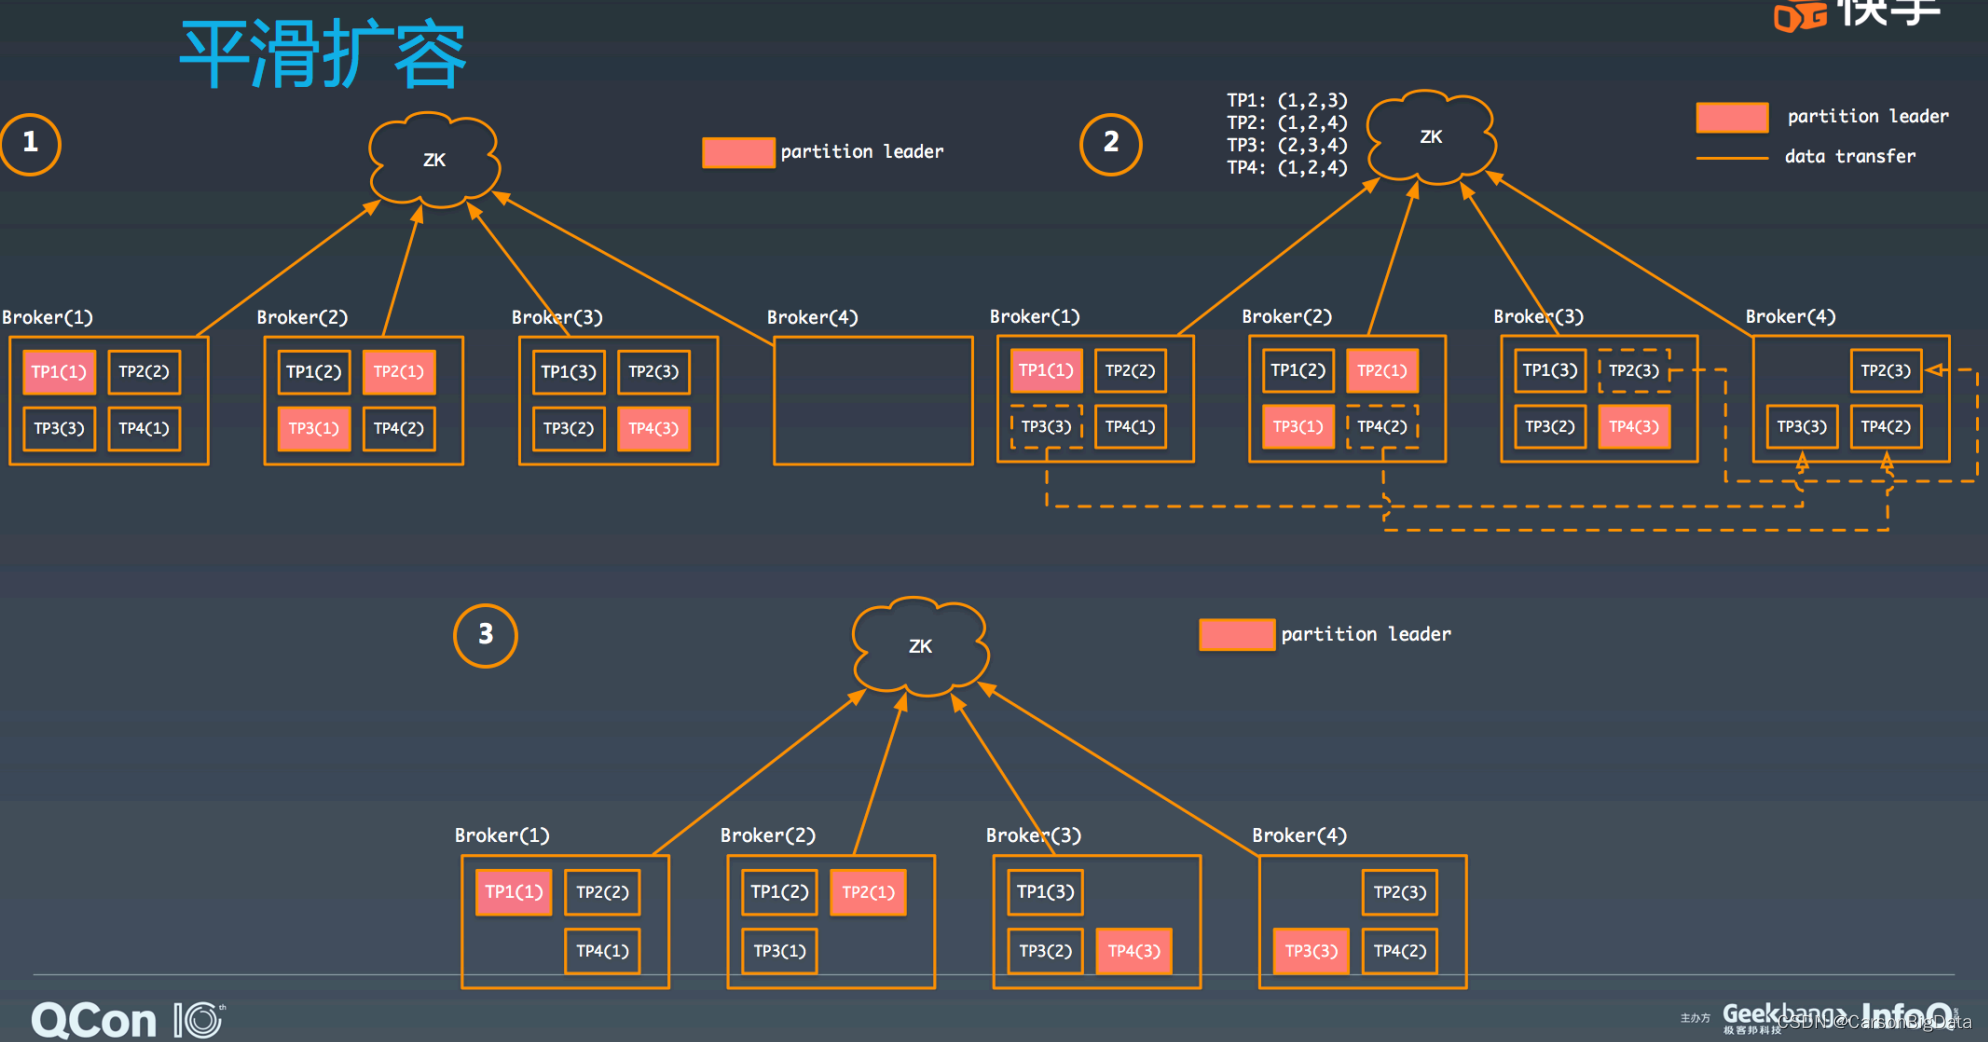
假如集群有 3 个 broker,⼀共有 4 个 TP,每个 3 副本,均匀分布。现在要扩容⼀台机器,
新 broker 加⼊集群后需要通过⼯具进⾏ TP 的迁移。⼀共迁移 3 个 TP 的副本到新 broker
上。等迁移结束之后,会重新进⾏ leader balance,最终的 TP 分布如图所示:

从微观的⻆度看,TP 从⼀台 broker 迁移到另⼀个 broker 的流程是怎么样的呢?咱们来看 下 TP3 第三个副本,从 broker1 迁移到 broker4 的过程,如下图所示,broker4 作为 TP3 的 follower,从 broker1 上最早的 offffset 进⾏获取数据,直到赶上最新的 offffset 为⽌,新副 本被放⼊ ISR 中,并移除 broker1 上的副本,迁移过程完毕。
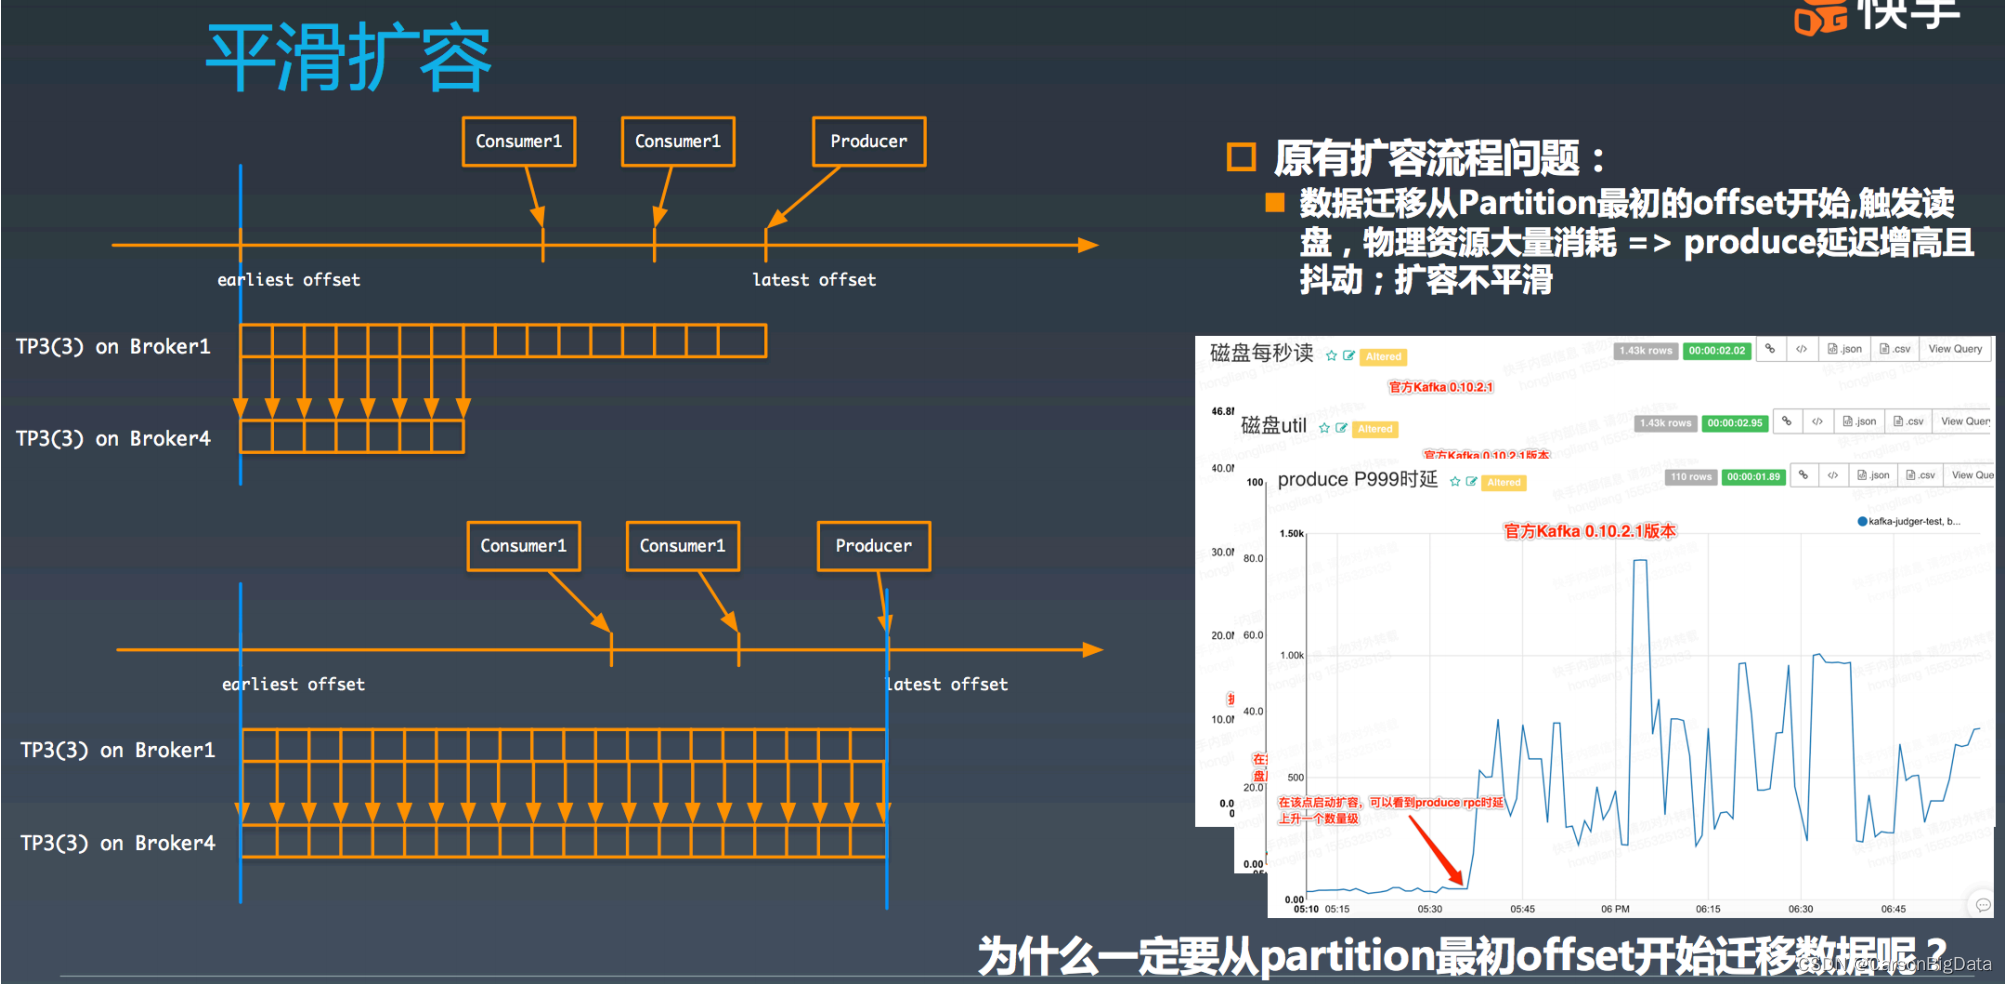
但在现有的扩容流程中存有如下问题:数据迁移从 TP3 的最初的 offset 开始拷⻉数据,这 会导致⼤量读磁盘,消耗⼤量的 I/O 资源,导致磁盘繁忙,从⽽造成 produce 操作延迟增 ⻓,产⽣抖动。所以整体迁移流程不够平滑。我们看下实际的监控到的数据。从中可以看到 数据迁移中, broker1 上磁盘读量增⼤,磁盘 util 持续打满,produce 的 P999 的延迟陡增,极其不稳定。

改进⽅案
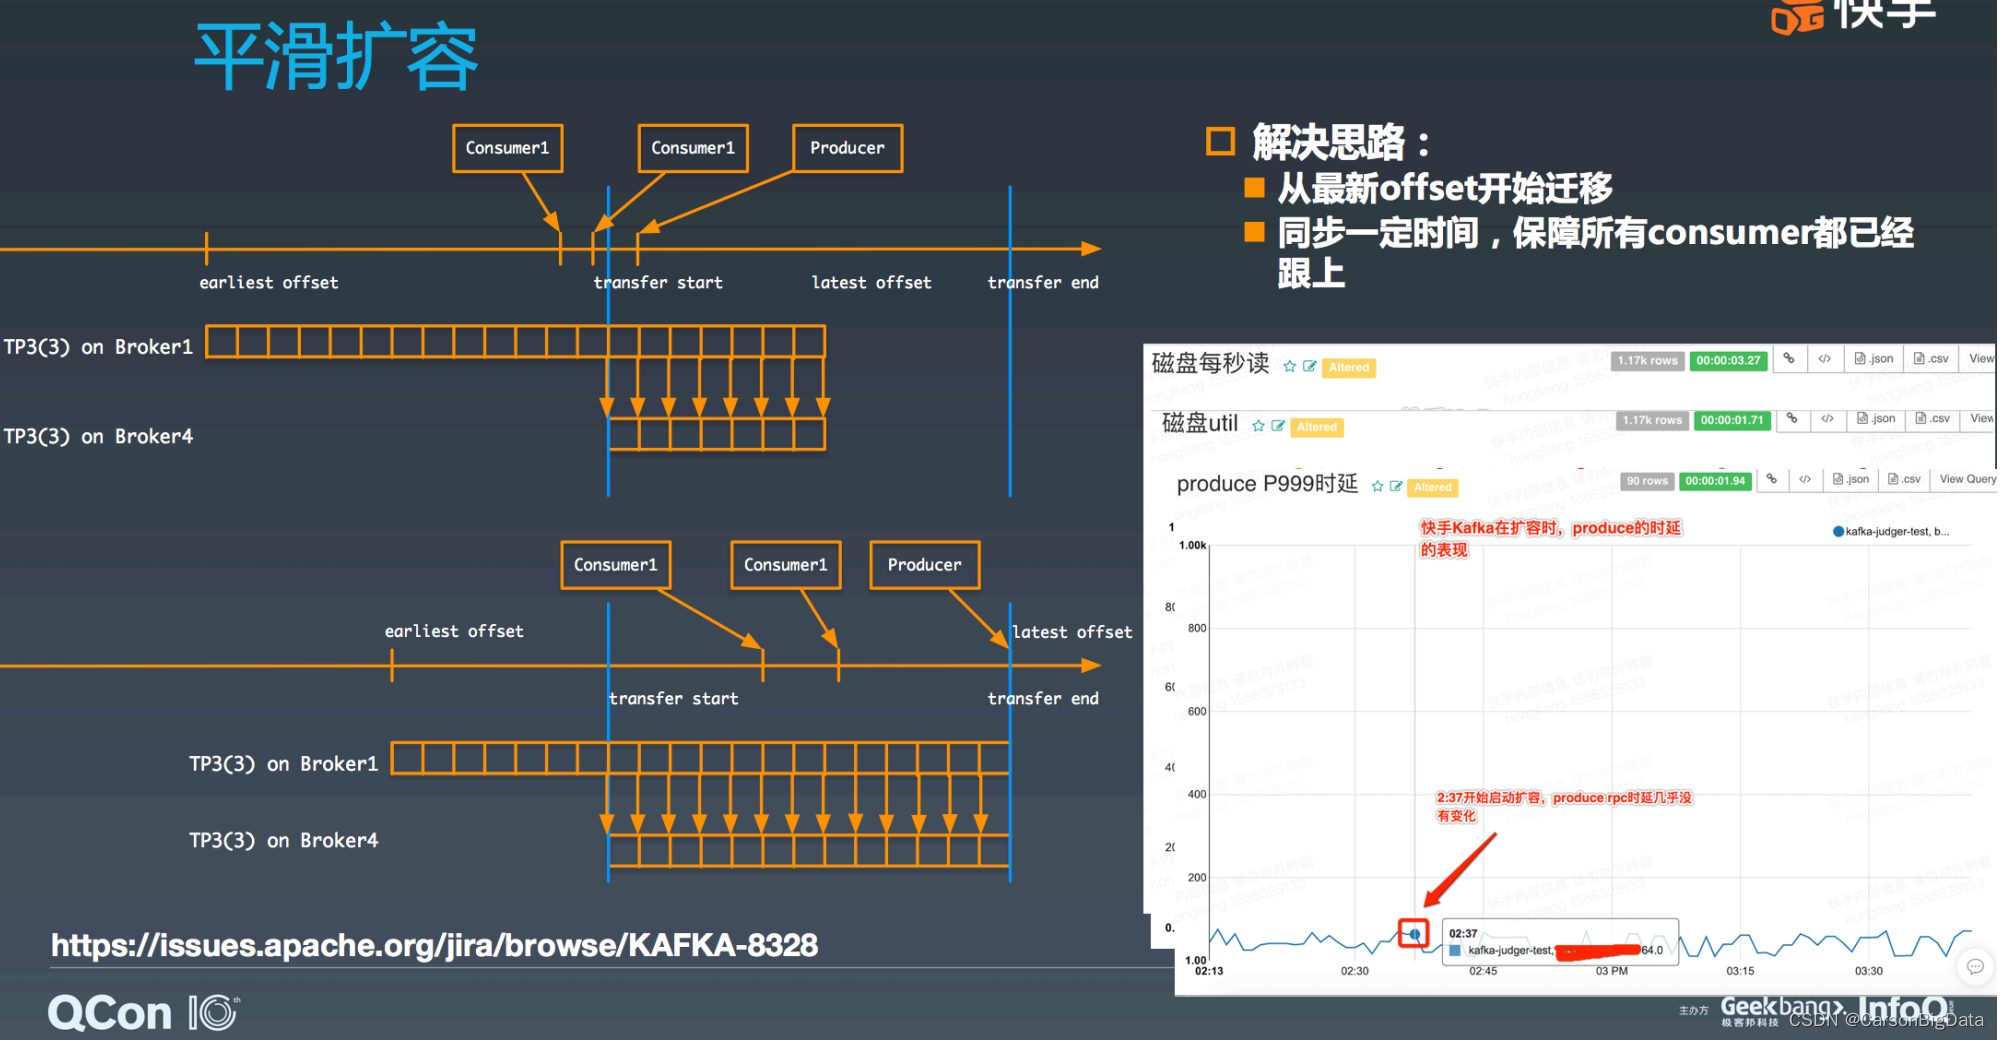
在迁移 TP 时,直接从 partition 最新的 offset 开始数据迁移,但是要同步保持⼀段时间,
主要是确保所有 consumer 都已经跟得上了。如图所示,再来看这个 TP3 的第三个副本从
broker1 迁移到 broker4 的过程。这次 broker4 直接从 broker1 最新的 offset 开始迁移,即
transfer start 这条竖线。此时,因为 consumer1 还没能跟得上,所以整个迁移过程需要保
持⼀段时间,直到 transfer end 这个点。这个时候,可以将 TP3 的新副本放到 ISR 中,同
时去掉 broker1 上的副本,迁移过程完毕。从这次的迁移过程中看,因为都是读最近的数
据,不会出现读⼤量磁盘数据的问题,仅仅多了⼀个副本的流量,基本对系统⽆影响。此
时,我们再来看下磁盘读量、磁盘 util、以及 produce 的延迟,从图中可知基本没有任何变
化。整体过程⾮常平滑,可以说通过这种⽅式很优雅地解决了 Kafka 平滑扩容问题,我们之
前也有在晚⾼峰期间做扩容的情况,但是从 Kafka 整体服务质量上看,对业务没有任何影
响。这个功能有⼀个 patch 可⽤: https://issues.apache.org/jira/browse/KAFKA-8328

这个⽅案存在的问题

1. 快⼿的这个patch是针对kafka 0.10.2.0版本,其他版本不⽀持,如果我们引⼊的话,需要针对⽣产环境上的版本进⾏代码修改

2. 设计的缺陷:

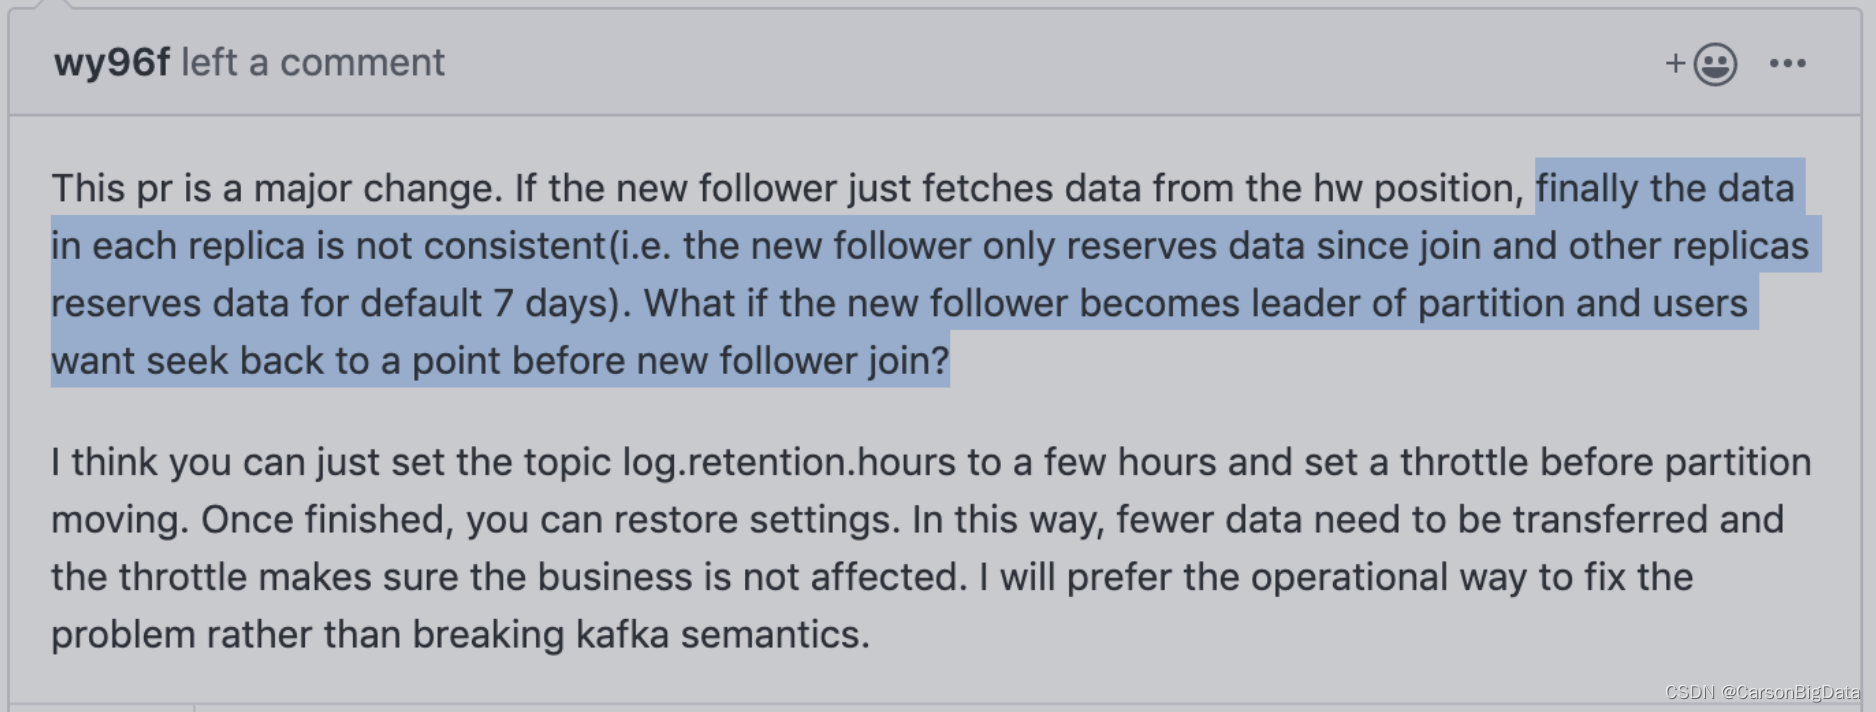
a)replica直接从最新的produce offset进⾏复制,⽆法保证kafka⼀致性语义(所有的副本数据完全⼀致),最新的replica缺失now - retention_ms这段时间的数据,如果consumer想要通过⾃定义offset来消费历史数据,可能会抛异常(当这个replica变成leader时);

b)replica从最新的produce offset进⾏同步,加⼊ISR的时机为 所有consumer offset全部⼤于起始同步offset,如果某个consumer group在此期间停⽌了消费测试⽤的group id),则会导致这个replica⼀直⽆法加⼊ISR

3. 这个patch只能在jdk 7 & scala 2.10编译通过,测试通过,在jdk 8 & scala 2.11环境下,测试⽆法通过

4. 社区的意⻅
 

5. 快⼿针对这个改进提了⼀个KIP,但是这个KIP已经被删掉了,没有找到他们当时对这个improvement的讨论

6. 这个patch kafka社区没有approve

2. Kafka RPC 队列隔离

Motivation
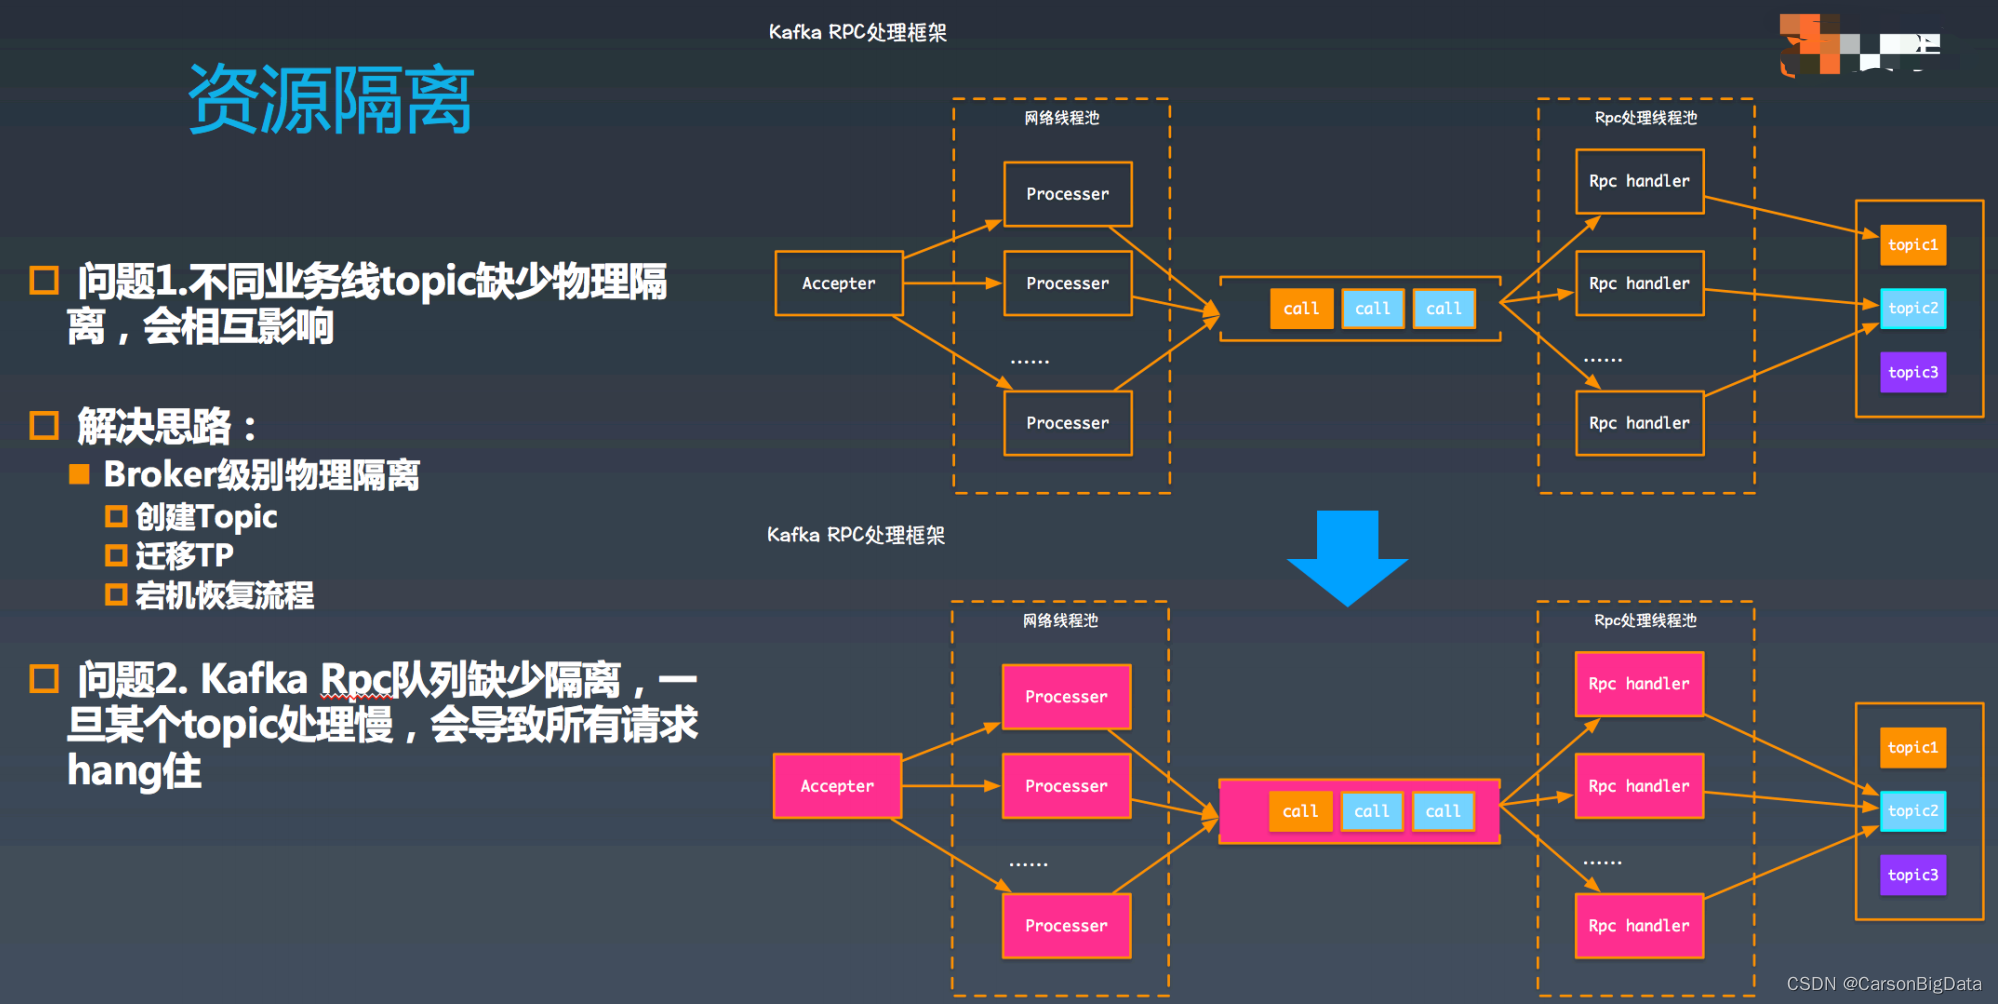
如图所示,Kafka RPC 框架中,⾸先由 accepter 从⽹络中接受连接,每收到⼀个连接,都
会交给⼀个⽹络处理线程(processer)处理,processor 在读取⽹络中的数据并将请求简单
解析处理后,放到 call 队列中,RPC 线程会从 call 队列中获取请求,然后进⾏ RPC 处理。
此时,假如 topic2 的写⼊出现延迟,例如是由于磁盘繁忙导致,则会最终将 RPC 线程池打
满,进⽽阻塞 call 队列,进⽽打满⽹络线程池,这样发到这个 broker 的所有请求都没法处
理了。

改进⽅案
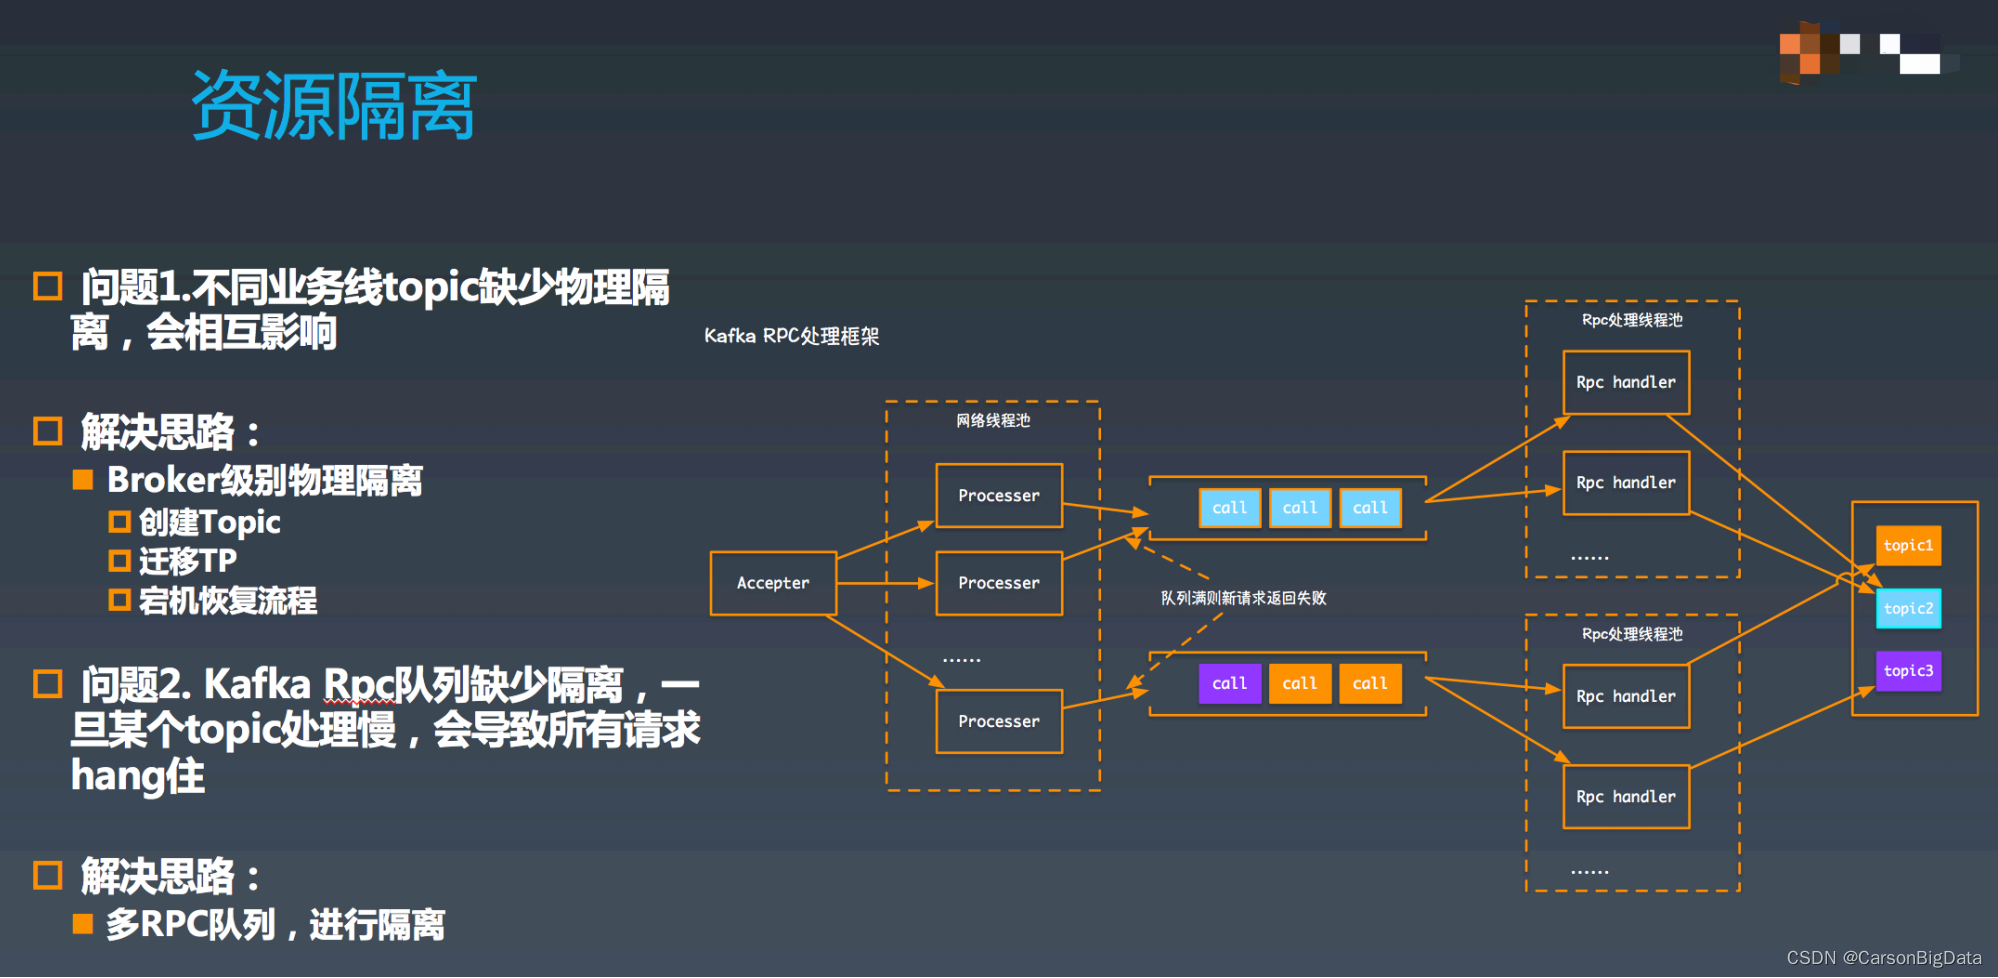
解决这个问题的思路也⽐较直接,需要按照控制流、数据流分离,且数据流要能够按照
topic 做隔离。⾸先将 call 队列按照拆解成多个,并且为每个 call 队列都分配⼀个线程池。
在 call 队列的配置上,⼀个队列单独处理 controller 请求的队列(隔离控制流),其余多个
队列按照 topic 做 hash 的分散开(数据流之间隔离)。如果⼀个 topic 出现问题,则只会
阻塞其中的⼀个 RPC 处理线程池,以及 call 队列。这⾥还有⼀个需要注意的是 processor
在将请求放⼊ call 队列中,如果发现队列已满,则需要将请求⽴即失败掉(否则还是会被阻
塞)。这样就保障了阻塞⼀条链路,其他的处理链路是畅通的。

3. Cache改造

Motivation

我们都知道,Kafka 之所以有如此⾼的性能,主要依赖于 page cache,producer 的写操
作,broker 会将数据写⼊到 page cache 中,随后 consumer 发起读操作,如果短时间内
page cache 仍然有效,则 broker 直接从内存返回数据,这样,整体性能吞吐⾮常⾼。
但是由于 page cache 是操作系统层⾯的缓存,难于控制,有些时候,会受到污染,从⽽导
致 Kafka 整体性能的下降。我们来看 2 个例⼦:
 
第⼀个 case:consumer 的 lag 读会对 page cache 产⽣污染。
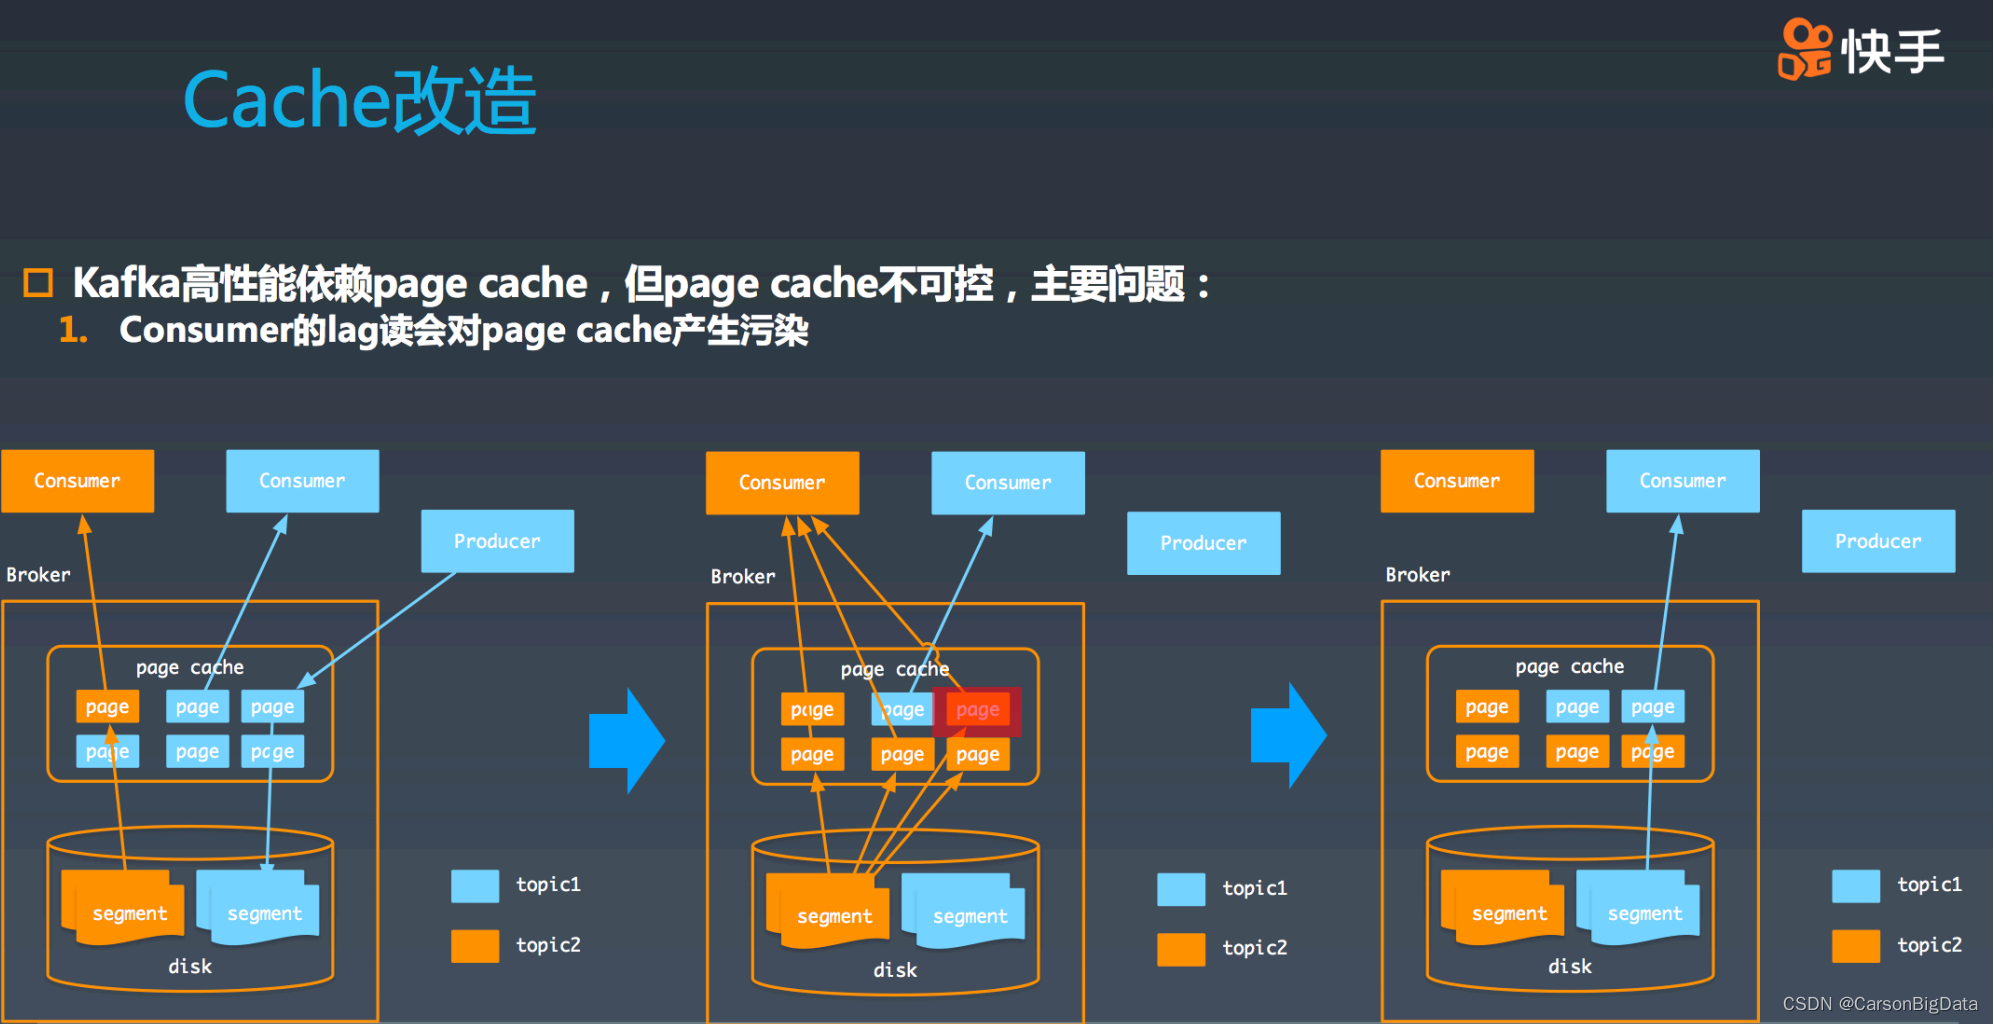
如图所示,假如有 2 个 consumer,1 个 producer。其中,蓝⾊ producer 在⽣产数据,蓝
⾊ consumer 正在消费数据,但是他们之间有⼀定的 lag,导致分别访问的是不同的 page
cache 中的 page。如果⼀个橙⾊ consumer 从 topic partition 最初的 offffset 开始消费数据
的话,会触发⼤量读盘并填充 page cache。其中的 5 个蓝⾊ topic 的 page 数据都被橙⾊
topic 的数据填充了。另外⼀⽅⾯,刚刚蓝⾊ producer ⽣产的数据,也已经被冲掉了。此
时,如果蓝⾊ consumer 读取到了蓝⾊ producer 刚刚⽣产的数据,它不得不再次将刚刚写
⼊的数据从磁盘读取到 page cache 中。综上所述,⼤ lag 的 consumer 会造成 cache 污
染。在极端情况下,会造成整体的吞吐下降。
第⼆个 case:follower 也会造成 page cache 的污染。
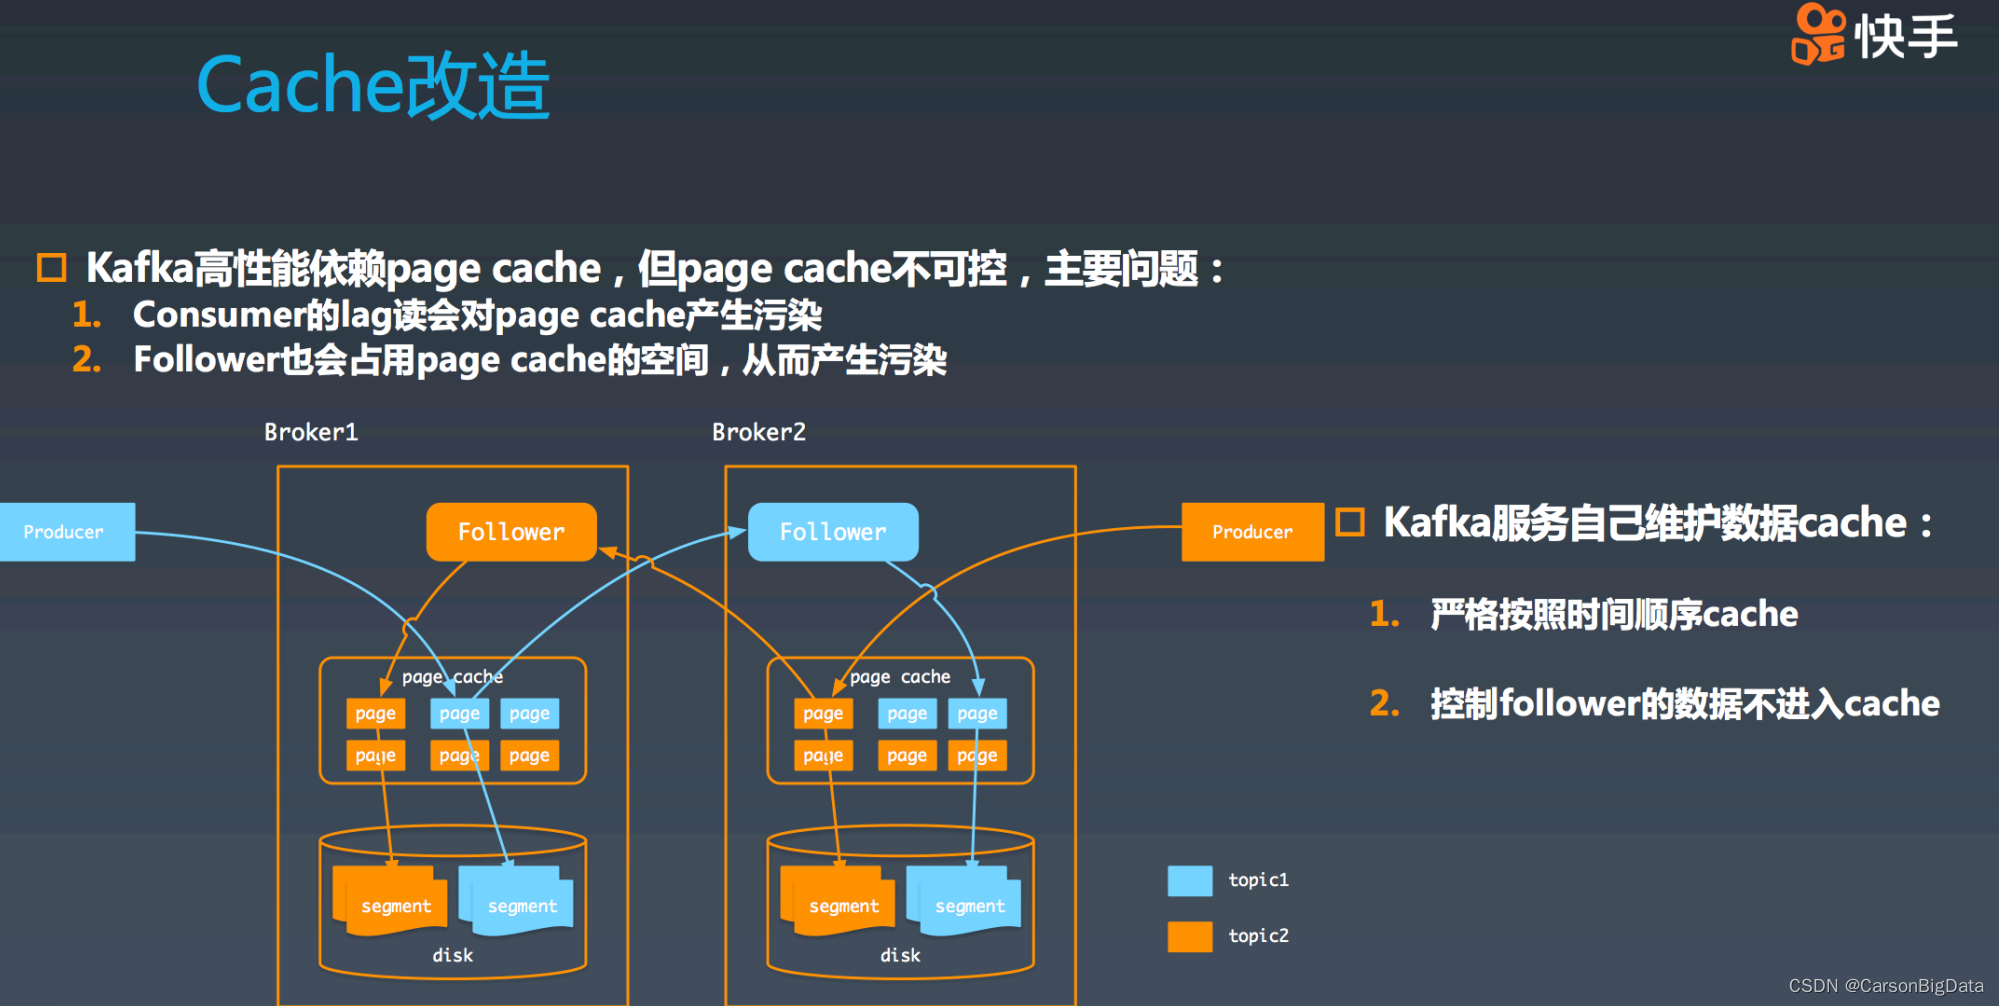
 

在图中 broker1 机器内部,其中 page cache 中除了包括蓝⾊ producer 写⼊的数据之外,
还包括橙⾊ follower 写⼊的数据。但是橙⾊ follower 写⼊的数据,在正常的情况下,之后不
会再有访问,这相当于将不需要再被访问的数据放⼊了 cache,这是对 cache 的浪费并造
成了污染。所以,很容易想到 Kafka 是否可以⾃⼰维护 cache 呢?⾸先,严格按照时间的
顺序进⾏ cache,可以避免异常 consumer 的 lag 读造成的 cache 污染。其次,控制
follower 的数据不进⼊ cache,这样阻⽌了 follower 对 cache 的污染,可以进⼀步提升
cache 的容量。
 

改进⽅案
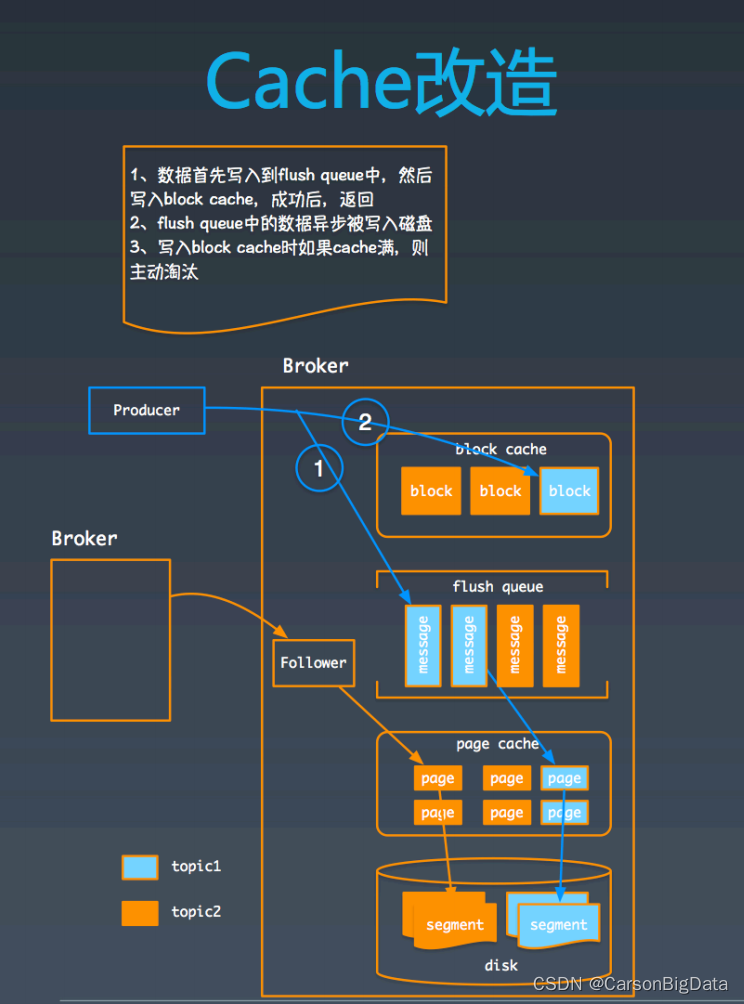
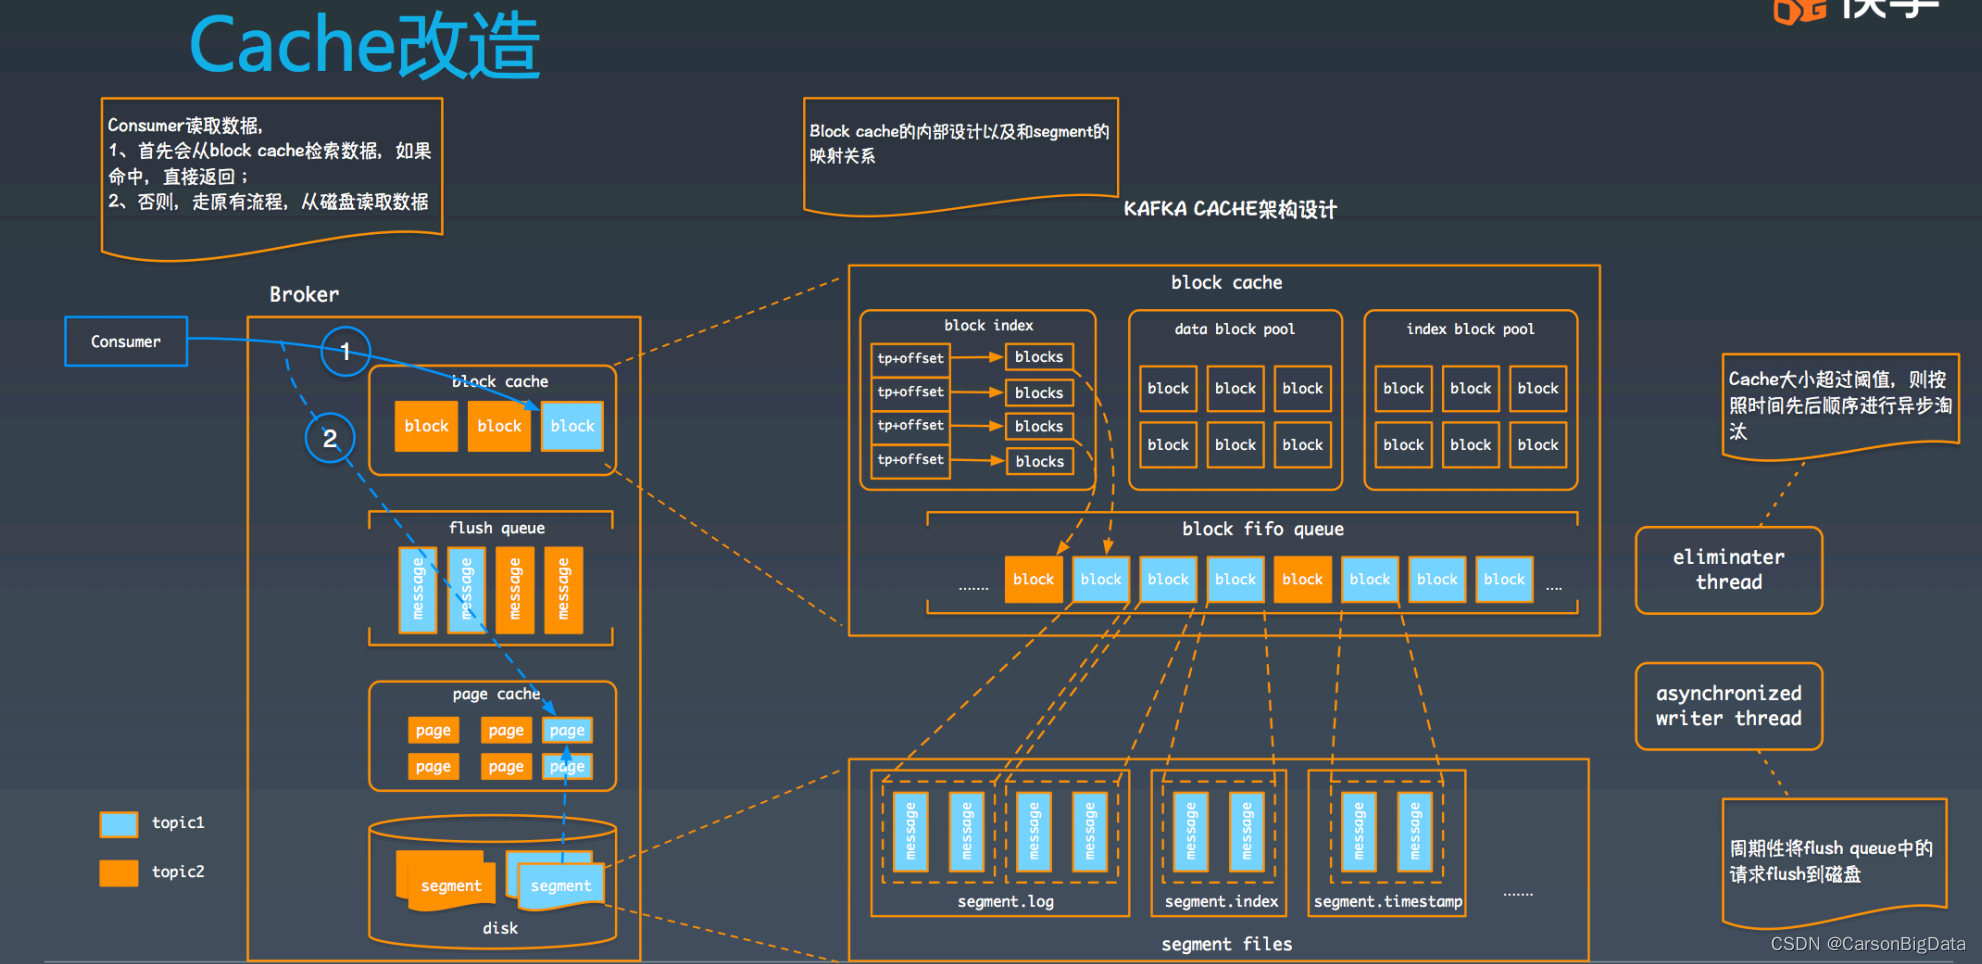
我们在 broker 中引⼊了两个对象:⼀个是 block cache;另⼀个是 flflush queue。Producer
的写⼊请求在 broker 端⾸先会被以原 message 的形式写⼊ flflush queue 中,之后再将数据
写⼊到 block cache 的⼀个 block 中,之后整个请求就结束了。在 flflush queue 中的数据会
由其他线程异步地写⼊到磁盘中(会经历 page cache 过程)。⽽ follower 的处理流程保持
和原来⼀致,从其他 broker 读到数据之后,直接把数据写到磁盘(也会经历 page
cache)。这种模式保证了 block cache 中的数据全都是 producer 产⽣的,不会被 follower
污染。
对于 consumer ⽽⾔,在 broker 接到消费请求后,⾸先会从 block cache 中检索数据,如
果命中,则直接返回。否则,则从磁盘读取数据。这样的读取模式保障了 consumer 的
cache miss 读并不会填充 block cache,从⽽避免了产⽣污染,即使有⼤ lag 的 consumer
读磁盘,也仍然保证 block cache 的稳定。

接下来,我们看下 block cache 的微观设计,整个 block cache 由 3 个部分组成:

第⼀部分:2 类 block pool,维护着空闲的 block 信息,之所以分成 2 类,主要是因
segment 数据以及 segment 的索引⼤⼩不同,统⼀划分会导致空间浪费;
第⼆部分:先进先出的 block 队列,⽤于维护 block ⽣产的时序关系,在触发淘汰时,会优
先淘汰时间上最早的 block;
第三部分:TP+offffset 到有效 blocks 的索引,⽤于快速定位⼀个 block。⼀个 block 可以看
做是 segment 的⼀部分。segment 数据以及 segment 索引和 block 的对应关系如图所示。
最后,还有两个额外的线程:
eliminater 线程,⽤于异步进⾏ block cache 淘汰,当然,如果 produce 请求处理时,发现
block cache 满也会同步进⾏ cache 淘汰的;
异步写线程,⽤于将 flflush queue 中的 message 异步写⼊到磁盘中。
这个就是 Kafka cache 的整体设计,可以看出,已经很好地解决了上述的两个对 cache 污
染的问题了。

性能测试

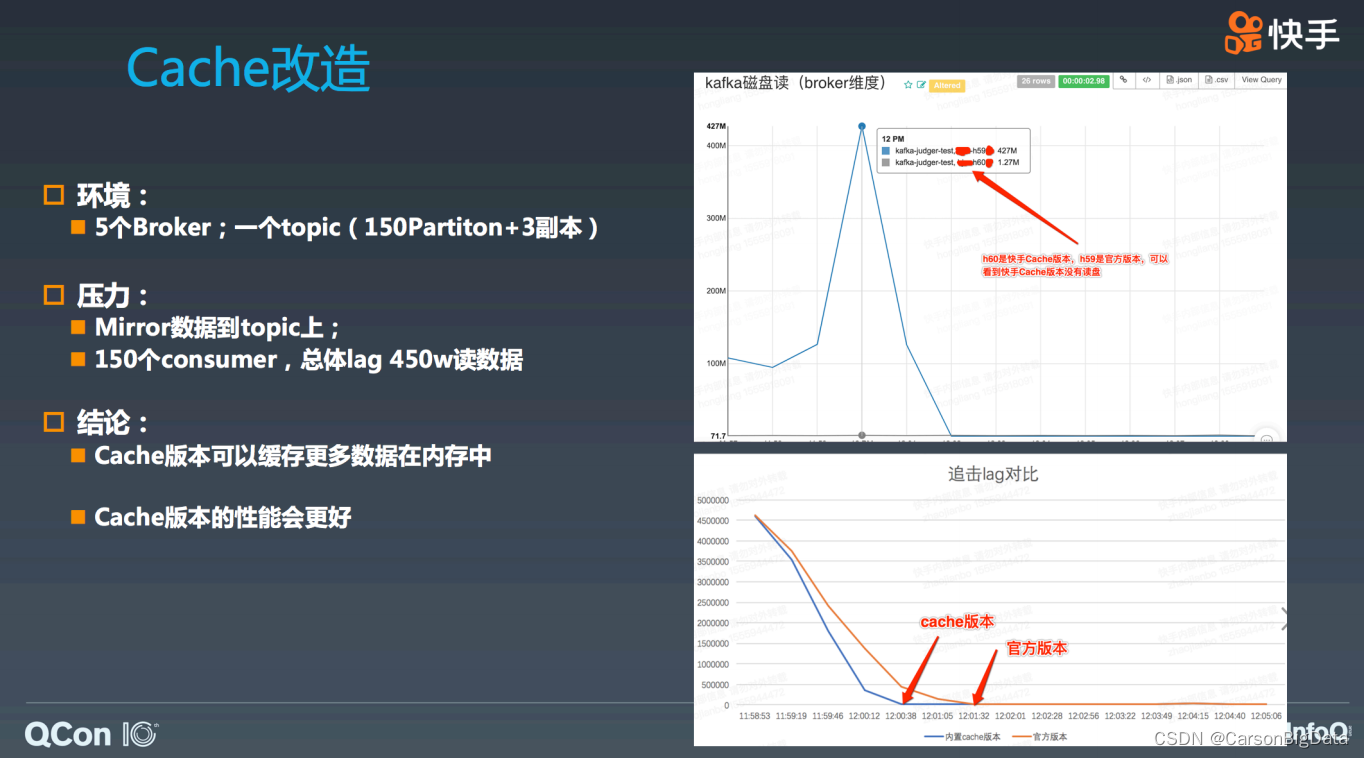
我们搭建了 5 个 broker 的集群,其中⼀个换成了 Kafka cache 的版本。并创建了⼀个 150
个 partition 的 topic,3 副本。所以算上副本,⼀共有 450 个 partition,每台机器上 90 台
TP。之后我们 Mirror 了⼀个线上的流量数据,并启动 150 个 consumer,以总体 lag 450w
条数据开始读。

从图中可以看出,原始版本在这种情况下会造成⼤量的磁盘读,⽽ Kafka cache 版本没有任

何磁盘读取操作,这说明 Kafka cache 版本可以 cache 更多的有效数据,这点是排除了
follower 造成的污染,经过精细化统计,发现 Kafka cache 有效空间刚好为原版本的 2 倍
(正好和同⼀台 broker 中 TP 为 leader 和 follower 的数量⽐⼀致)。从恢复的时间上看,
由于排除了读磁盘以及多个 consumer 之间读可能会 cache 产⽣的污染,Kafka cache 的版
本也⽐原有版本速度要快了 30%。

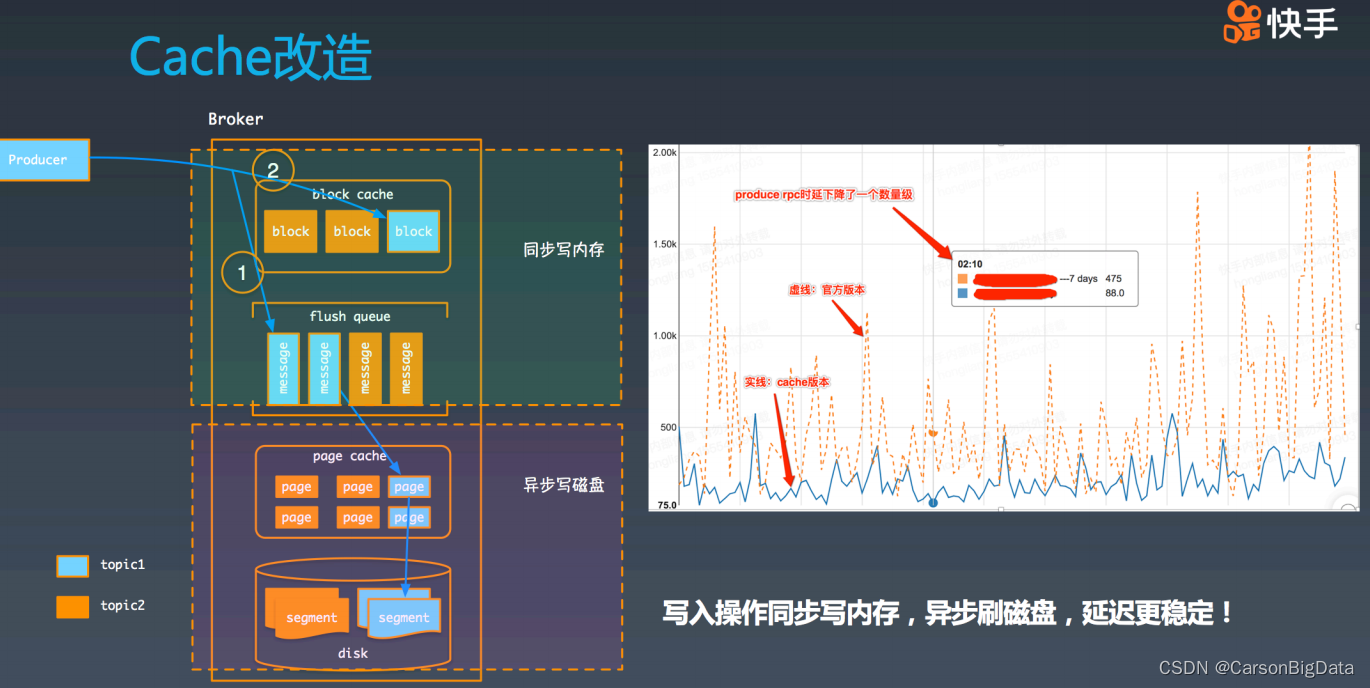
除此之外,再看下改进后的 broker,从这个图中可以看出,produce 整个写⼊过程,先是同
步写⼊内存,然后再被异步刷⼊磁盘。虽然 page cache 的模式也是类似这种,但是 pagecache 会存在⼀定不稳定性(可能会触发同步写盘)。这个是我们上线 Kafka cache 版本前
后的 produce p999 的延迟对⽐。从图中可以看到:Kafka cache 版本⽐原来版本的延迟低
了很多,且稳定性有极⼤改进。


引⼊该⽅案存在的问题

1. ⽬前快⼿只提出了⼀个⾃⼰管理Cache的⽅案,没有公开源码,我们需要⾃⼰写代码实
现
2. 我们集群Kafka的版本⽬前不统⼀,在实现这个⽅案之前需要统⼀Kafka版本

Kafka性能优化 目录1、消费者参数优化1.1 enable.auto.commit1.2 auto.offset.reset1.3 session.timeout.ms1.4 max.partition.fetch.bytes1.5 fetch.min.bytes1.6 fetch.max.wait.ms1.7 receive.buffer.bytes + send.buffer.bytes1.8 client.id2、生产者参数优化2.1 bootstrap.servers2.2 acks2.3 buffer.memor 阅读详情

相关推荐

【Kafka高级】Kafka性能优化与调优实践

Kafka的性能优化是一个系统性工程,需要从生产者、消费者和集群三个层面进行综合调整。通过优化生产者的批量发送和压缩策略,可以显著提高消息发送效率;通过调整消费者的批量拉取和偏移量管理策略,可以提升消费速度和可靠性;通过监控集群的关键指标并调整Broker和Zookeeper配置,可以优化集群的整体性能。

2401_86224057的博客 2523

kafka优化

调整 Kafka 集群的配置:可以通过调整 Kafka 的一些配置参数来提高其性能,如调整消息存储的副本数、扩大 Kafka 集群的规模、调整批处理的大小等。合理规划主题和分区:在设计 Kafka 主题和分区时,需要考虑主题的数据量、消息生产者和消费者的数量,以及消息处理的延迟等因素,从而合理规划主题和分区。优化消息生产者和消费者的代码:可以通过优化消息生产者和消费者的代码来提高其性能,如使用异步方式发送消息、批量发送消息、使用压缩算法等。

牛肉胡辣汤 1177

kafka数据写入速度优化【项目经验总结】

先说结论:调整集群参数 # 每当producer写入10000条消息时,刷数据到磁盘 log.flush.interval.messages=10000 # 每间隔1秒钟时间,刷数据到磁盘 log.flush.interval.ms=1000 好久没有更新了, 沣哥给介绍了个对象,也不知道能不能成,看的看不上咱0.0 回归主题,前几天领导给我派了个活,说客户的kafka消费速度有问题,派我出差去排查一下,我到了现场后先梳理了一下数据链路,一个服务(二进制数据流)->kafkatopic1-&

Dmaple的博客 5864

Kafka 生产者优化与数据处理经验

在大数据处理领域,Kafka 作为一款高性能的分布式消息队列系统,被广泛应用于数据的传输、存储与处理。对于生产者而言,如何高效地将数据发送到 Kafka 集群,同时保证数据的可靠性、去重、有序性等,是至关重要的问题。本文将深入探讨 Kafka 生产者在提高吞吐量、保证数据可靠性、去重、有序性等方面的生产经验,并结合代码示例进行详细分析。

天冬忘忧的博客 1829

大数据领域Kafka的性能优化实践经验分享

Apache Kafka作为分布式流处理平台的核心组件,在现代大数据架构中扮演着至关重要的角色。随着数据量的爆炸式增长和实时处理需求的提升,Kafka集群的性能优化成为企业面临的关键挑战之一。本文旨在分享Kafka性能优化的系统化方法和实践经验,帮助读者构建高性能、高可用的Kafka基础设施。首先介绍Kafka的核心概念和性能关键点然后深入分析影响性能的各个因素接着提供具体的优化策略和实现方法最后通过实际案例展示优化效果Broker: Kafka集群中的服务器节点,负责消息的存储和转发。

架构师的AI之路,分享AI应用开发架构的学习与实践。 1192

我用Kafka实现提示工程的消息队列:经验总结

在AI原生应用中,提示(Prompt)是用户与LLM沟通的“语言”,而提示工程则是“优化这门语言”的艺术。并发请求“冲垮”LLM服务:100个用户同时发送提示,LLM API(如OpenAI)的QPS限制会导致大量请求失败;长提示链“阻塞”系统:一个复杂任务(如“分析100页文档并生成报告”)需要多轮提示调用,同步处理会让用户等待几分钟;任务优先级“混乱”:付费用户的“加急提示”和普通用户的“常规提示”混在一起,重要任务可能被延迟;故障恢复“无迹可寻”

AI算力网络与通信的博客 1万+

高并发消息中间件RocketMQ与Kafka在互联网系统优化实践经验分享

架构与高可用设计多Broker/NameServer节点,分区副本保证高可用Leader选举机制和自动故障迁移,防止单点故障消息生产与消费优化批量发送、异步处理、序列化优化多线程消费、幂等设计和偏移量管理分区与负载均衡Kafka分区、RocketMQ队列热点队列扩容,消费组均衡处理监控与工程化闭环消息吞吐、延迟、积压监控自动化部署、弹性扩容和压测优化形成持续闭环通过合理的消息中间件架构设计、生产消费优化、分区与负载均衡、高可用容错机制,以及监控和工程化部署,高并发互联网系统能够实现。

2501_94114711的博客 627

中国主要湖泊水库面状矢量边界图层ArcGIS应用实战:从数据获取到专题图制作

本文详细介绍了中国主要湖泊水库面状矢量边界图层在ArcGIS中的实战应用,从数据获取到专题图制作的全流程。涵盖官方数据源、科研机构共享数据及商业平台的选择,以及ArcGIS中的数据处理、拓扑错误修正和专题图设计技巧,帮助用户高效完成湖泊水库的空间分析与可视化。

weixin_33672400的博客 255

Apache Kafka高吞吐消息系统实践分享:实时数据流处理与消息可靠性优化经验

合理主题与分区设计保证吞吐量和顺序性生产者批量与压缩优化提升发送效率消费者多线程与手动提交偏移保证可靠消费副本与幂等策略确保消息不丢失实时监控与告警提升系统稳定性Kafka 通过高吞吐量、低延迟和可扩展性,为企业实时数据流和消息系统提供可靠解决方案,是金融、电商和 IoT 系统不可或缺的核心组件。

2501_94114477的博客 690

【Arduino】入门篇——交通信号灯

模拟交通信号灯一、实验目的二、实验材料三、电路图四、实验过程五、代码块六、实验结果 一、实验目的 我想大家都看见过交通灯,就是马路上十字路口的红绿灯。如果您开过车,我想您一定仔细观察过交通灯,如果您还没有驾驶过车,您是否仔细观察过交通灯呢?交通灯包括三种个不同颜色的灯:红灯、黄灯和绿灯。 每个路口的红绿灯切换的时间并不是相同,这个是根据不同路口的车流情况来设定的,下面就是模仿交通灯的一个实验 二...

漠宸离若的博客 1万+

Linux CentOS7文件系统(/dev/var)的容量扩充

原因是之前安装docker后,再想安装Nessus,系统说home、var文件系统的内存都不够。

JHoanna的博客 3226

Java高性能消息队列与Kafka实战分享:分布式消息处理与性能优化经验

分布式架构与分区策略保证高可用和高并发批量异步处理提高消息吞吐量多线程消费者与手动提交保障消息可靠性压缩和批量发送优化网络性能监控与告警体系快速发现并解决系统瓶颈Java 结合 Kafka,通过高性能消息处理、分布式部署和监控告警,为金融、电商和互联网高并发系统提供了可靠、可扩展的数据传输与异步处理解决方案。

2501_94114742的博客 423

微带功分器设计与ADS-EM联合仿真实战解析

本文详细解析了微带功分器设计与ADS-EM联合仿真的实战技巧,涵盖特性阻抗计算、ADS原理图设计、版图生成与EM仿真等关键步骤。通过实际案例分享,帮助工程师掌握射频电路设计中的核心技术和调试方法,提升功分器设计效率与性能。

weixin_29280219的博客 451

Java高性能消息队列与Kafka实战分享:大规模消息处理、异步通信与性能优化经验

分区设计与异步生产保证高吞吐量批量发送与压缩策略减少网络开销消费者线程池与异步处理提升并发处理能力监控与告警机制确保系统稳定运行消费者组扩展支持高并发消息消费Java 结合 Kafka,通过高性能消息队列设计、异步处理和批量优化,为金融、电商和互联网系统提供了稳定、高效且可扩展的异步通信解决方案。

2501_94180726的博客 463

abapGit 安装与初始化完整指南:从 on-premise 到 SAP BTP ABAP environment 的一条龙实践

本文为ABAP开发者提供abapGit从安装到团队协作的完整指南。内容涵盖社区版ZABAPGIT的on-premise安装、Eclipse ADT插件配置、BTP环境使用及常见网络问题处理。重点包括:获取最新构建的安装步骤、EN语言环境的重要性、ADT插件安装方法、以及如何实现on-premise与BTP间的代码迁移。文中特别强调企业环境下代理设置、证书配置等注意事项,并提供实际操作案例,如将RAP业务对象迁移到BTP环境。文末附有可复用的实施清单,帮助开发者快速落地abapGit。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 413

stable diffusioncontrolNet 预处理器/模型的下载及安装使用教程

首先说明,controlNet 的模型 不同于stable diffusion 模型,这一点一定要区分清楚。下面提供多个ControlNet 预处理器+ 专用模型的百度网盘下载链接,都是由群友整理贡献,但各自包含的版本不同,大家可自行选择。推荐下载紫色链接内的模型,fp16版文件更小,稍微新一些的controlnet插件还添加了对control-lora的支持(注意,要求controlnet插件的版本比12月16号新(1.1.423以上)才能正常识别),推荐下载;

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 3385

高并发消息队列Kafka与RabbitMQ在互联网系统优化实践经验分享

架构与队列设计Kafka高吞吐适合流量大场景RabbitMQ可靠性高,适合复杂路由和业务逻辑高并发生产消费优化批量发送、异步处理、批量消费幂等设计保证数据一致性分区与负载均衡策略Kafka分区、RabbitMQ路由多Queue热点队列扩容,避免单点瓶颈高可用与容错机制Kafka副本、Leader选举、ISR机制RabbitMQ镜像队列、HA模式监控与工程化闭环关键指标监控、日志分析、告警自动化自动化部署、弹性扩容、压测优化形成闭环。

2501_94114585的博客 1192

大学计算 - 方程求解 实训答案 第3关

【代码】大学计算 - 方程求解 实训答案 第3关。

2403_89314916的博客 107

Java面试:Kafka与RocketMQ的深度探讨

面试官对候选人的表现非常满意,认为其在Kafka和RocketMQ方面有扎实的理论基础和丰富的实战经验,能够快速定位和解决复杂问题,是团队中不可多得的技术人才。本次面试通过层层深入的提问,全面考察了候选人在Kafka和RocketMQ方面的技术能力。候选人的回答展现了扎实的理论基础和丰富的实战经验。面试官对候选人的表现给予了高度评价,认为其是团队中不可多得的技术人才。

南客先生的博客 758

一文看懂 SAP Integration Suite:从架构治理、接口编排到事件驱动的集成全景

SAP Integration Suite是企业数字化转型中的关键集成平台,通过统一的方法论和工具链解决系统互联、数据对齐和流程协同等复杂问题。其核心能力包括:1)集成评估(Integration Assessment)提供战略规划框架;2)迁移评估(Migration Assessment)支持从传统平台向云的平滑过渡;3)云集成(Cloud Integration)实现日常业务流程编排;4)集成顾问(Integration Advisor)简化B2B标准映射;5)贸易伙伴管理(TPM)优化外部协作流程;

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 501

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

用 Kafka、RabbitMQ、RocketMQ、Redis 、Nginx等组件优化

Kafka、RabbitMQ、RocketMQ、Redis、Nginx等组件是现代分布式系统和高并发业务中常用的工具,它们在处理数据流、消息队列、缓存、负载均衡等方面起到了重要作用。通过正确配置和优化这些组件,可以有效地解决很多常见的业务问题,提升系统的性能和稳定性。

qq_40708522的博客 1920

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

【转载】LinkedIn是如何优化Kafka的

http://www.wtoutiao.com/p/18d5RY0.html 在LinkedIn的数据基础设施中,Kafka是核心支柱之一。来自LinkedIn的工程师曾经就Kafka写过一系列的专题文章,包括它的现状和未来、如何规模化运行、如何适应LinkedIn的开源策略以及如何适应整体的技术栈等。近日,来自LinkedIn的高级工程主管Kartik Paramasivam撰文分享了他...

weixin_30835933的博客 255

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

kafka 经验

1、数据丢失和重复 kafka ack 设置为0 不等leader落盘直接确认回复 leader挂了 数据丢失 设置为1 时 leader落盘后不等所有副本全部落盘 确认回复 leader 挂了 选举新leader 无此数据 数据丢失 ACK设置为-1 leader和副本都落盘后确认回复 如果在落盘完成之后 leader回...

qq_34897849的博客 568

项目经验之Kafka压力测试以及kafka机器数量计算

Kafka压测 用Kafka官方自带的脚本,对Kafka进行压测。Kafka压测时,可以查看到哪个地方出现了瓶颈(CPU,内存,网络IO)。一般都是网络IO达到瓶颈。 kafka-consumer-perf-test.sh kafka-producer-perf-test.sh 2)Kafka Producer压力测试 (1)在/opt/module/kafka/bin目录下面有这两个文...

weixin_45751589的博客 599
上一篇: 基于H3Core分区的司机轨迹实时存储的技术方案
下一篇: Clickhouse 常见问题及解决方案汇总
CarsonBigData
博客等级 码龄9年 8315粉丝 166原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值