NED:An Inter-Graph Node Metric Based on Edit Distance

用于视觉问答的图形推理网络模型《Graph Reasoning Networks for Visual Question Answering》 目录 一、文献摘要介绍 二、网络框架介绍 三、实验分析 四、结论 这是视觉问答论文阅读的系列笔记之一,本文有点长,请耐心阅读,定会有收货。如有不足,随时欢迎交流和探讨。 一、文献摘要介绍 The interaction between language and visual information has been emphasized in visual question ans... 阅读详情

文章简介:

  1. 文章标题:NED:An Inter-Graph Node Metric Based on Edit Distance
  2. 文章来源:VLDB 2017
  3. 作者:
    2.1. 朱浩瀚(苹果公司)、
    2.2. Xianrui Meng(Apple Inc)
    2.3. George Killoos(Boston University)
    3.Git项目地址

NED:An Inter-Graph Node Metric Based on Edit Distance

摘要:

  节点的相似性的研究是图论中的重要问题。以往科研人员总是把重心放在图的内部的节点的相似性中,对于图与图之间的相似性的研究还不够。况且人们经常在社会网络、自传等方面用到这样的相似性的比较,因此对于图间结点相似性的研究是十分必要的。
  作者提出了一种NED的方法,它是基于TED*的方法上面经过改造的一种具有度量 性质的函数。它可以通过构建一个结点的邻居拓扑结构来比较结点之间的相似性,并且不管这个图是否有标签的信息都可以比较图中的某个结点。
  NED作为一种度量标准,可以提供**有效的索引**(?),同时在这篇文章中,作者通过一个去匿名化的例子来表明了NED相比于Feature的方法更加高效。

(在正式介绍本文时,我们先来介绍一些基础知识以方便读者的理解)

  1. NP-Complete
  2. 去匿名化(OddBall/NetSmile/ReFX/HITS)
  3. Ego-Network
  4. 多项式可计算
  5. 广度优先搜索
  6. 子树的概念
  7. 图的同构
  8. 生成树
  9. 树的同构
  10. 集合差的运算
  11. 完全二部图概念
  12. 映射的概念(什么是双射)
  13. 匈牙利算法是什么
  14. 子图的含义是什么
  15. ReFx
  16. HITS是什么
  17. A*是什么算法
  18. 什么是训练集,什么是测试集

  社会网络中结点相似度问题是图论中的一个重要问题。但是最近几年来的研究一直把重心放在了一个图中的节点相似度的研究中,图和图之间的节点相似度的研究还没有得到广泛的关注。但是,图间节点相似度的研究对于转移学习是十分重要的。如给定一个已知信息的图,从这个图中提取信息从而推断出另外一个图的信息都要用到图间节点的相似度。图间节点相似度的研究将会应用在生物、交流和网络的领域。
  我在阅读了VLDB 2017的论文[1]和SIGKDD 2002[2]之后以及近期的其他论文,写下了本篇报告。报告中将结合俩位作者的成果,展开详细的叙述。
  本文作者在前人的研究中提出了一种叫做NED(基于编辑距离的图间节点的相似度)的算法,此算法的目的是为了测度图间节点的相似度。在NED中,俩个节点根据他们邻居拓扑结构的信息进行比较,这里的邻居拓扑结构指的是新定义的k-adjacent树。由于比较图的编辑距离是NP问题,所以NED的比较久显得有优势了,比如NED是多项式时间内可计算的方法。同时NED相比于其他的方法,不仅仅有测度性质,同时还有比较高的效率。

  本文对于图间节点的相似度的研究,主要研究成果及 贡献如下:

  1. 作者人提出了一种多项式时间内可计算的函数NED,它可以用来测度图间节点的相似度。
  2. 作者提出了一种修改后的编辑距离TED*,用来比较无序树,同时TED*也是多项式时间内可计算的。
  3. 将TED*和原来的TED进行比较,体现出优化的性能。
    4.由于NED的测度性能,TED可以高效地找出图中相似的节点。

关键字:社会网络;结点相似度;图的相似度;树

第二章 节点的邻居拓扑结构的选择

2.1 K-adjacent树

定义1:

  给定一个图G,若存在其中的某个顶点v,则其中的顶点V的k-adjacent树就是以v为树根,经过宽度优先遍历的树。树的高度为k层,代表了前k层子树的高度。

2.2 子图同构复杂度

  由于在图论领域中,目前仍然把图的同构问题定义为NP问题,因此作者选用了树的同构作为俩个节点之间相似性比较的基准。

第三章 节点相似度

3.1 TED*

  TED*(树的编辑距离的改进版本),TED* 用来将一棵树转变为另外一棵树后,所需要的最少的编辑次数。转变过程中包括:
1)插入一个结点
2)删除一个结点
3)同一层移动一个结点
  TED* 和原来的TED相比最主要的不同是:TED操作过程中不会改变节点的深度。然后结点深度在一棵树中表示了这个节点的拓扑结构,因此作者利用了TED*这个特点引入了NED的方法。具体参见图2

图2 TED*和TED的比较

3.2 NED

  NED是基于TED而来的,它是俩棵树之间经过TED的编辑后,得到的值。其逻辑关系用下面等式表示:
δk(u,v)=δk(T(u,k) , T(v,k))
通俗地讲,俩个图中的节点转换成的K-adjcent树的TED*的值,就是NED的值。

第四章 TED*的计算

  NED的取决于TED的值,因此作者详细提出了TED的算法。算法分为六个步骤,节点的每一个K-adjacent树的每层,都会从下往上运行这个算法,直到根节点为止。以下是计算TED*的六个步骤。

4.1 节点Padding

  Padding是根据俩个k-adjacent树的同一层的个数的差值决定的。例如俩棵树的第4层,一个有三个节点,一个有五个节点,那么Padding@Cost=2

4.2 节点Canolization

  节点的Canolization是在Padding之后运行的。标签树的同构代表了俩个数具有相同的树形,但是对于从图中节点所提取的节点的k-adjacent树是没有标签的,如何进行同构的比较?那么作者提出了可以为k-adjacent树进行Canonization。具体的同构规则如下:如果俩个节点的子树是同树形的,那么这俩个节点的标签是一样的。根据规则,树中所有叶子节点因为没有子树,因此都会有相同的标签。作者把叶节点的标签赋值为0,那么对于其他的标签作者提出了一个如下的算法:

  从算法可知,每个节点的标签虽然需要将其子树进行比较,但是只需要比较其孩子节点,子孙节点不需要考虑。因为算法是自底向上运行的,每个节点已经包含了其孩子节点。算法中标签值的大小以及先后顺序都是不重要的,可以使1,2,3….也可以是A,B,C…. 下面图3是节点的Canolization的例子。

图三 节点的Canolization

4.3 完全二部图的构建

  在节点的Canolization之后开始进行完全二部图的构建。构建的对象是两棵树对应层节点。由于二部图的定义是把图中节点分为俩类,因此在构建过程中,每一个节点和相对应的另一层的节点有一条边,而边权重就是每个节点孩子的标签的不同个数。若节点A的孩子标签集合是{1,2,4},节点B的孩子的标签集合是{2,3,4},那么A和B之间的权重是2。下图是二部图构建的一个例子。

图4 加权完全二部图构建
   从图4可以清楚看出,在完全二部图构建之前,必去进行Padding以及Canolization之后才能保证有相同个数的节点进行构建。需要注意的是,为了防止计算重复的匹配成本Matching Cost,在Padding中的节点是不连接到任何一个父节点进行计算的。那么图中的权值的具体含义是什么呢?权值代表了在相同层进行移动节点所需要的次数。而最小权值的综合是评估NED的一个重要成本。

4.4 二部图的匹配

  二部图匹配是4.4所提的二部图构建中,在二部图节点一一匹配的条件下,找出其中最小权值和的计算过程。形式化语言表示如下:
f_i:m(G^2 )=Min∑_(∀x∈L_i (u))▒〖w(x,f_i (x))〗

4.5 匹配成本计算

   由于匹配成本表示把俩个K-adjacent树的一层转换为对应层所需要的最小操作次数,因此匹配成本的计算需涉及Padding值和4.4中的二部图匹配的最小值。形式化语言如下:
M_i=(m(G_i^2 )-P_(i+1) )/2
如果要计算第i层的匹配成本,那么需要计算第i层的二部图构建成本和第i+1层的Padding成本。由于在匹配过程中的双射关系,第i层中的节点x匹配到对应的另外一棵树中的y,这需要产生一次匹配成本;相对应的y匹配到x又是一次匹配成本,为了不计算重复的大小,需要去匹配过程中总花费的一半。

4.6 节点的Re-Canolization

  作者基于不用给每层节点Padding的情况下,为节点Recanolization。Recanolization的规则如下:

  总结来讲,经过双射函数匹配后的节点的标签值,需要将每层节点个数较大的那个标签赋值。赋值完之后,进行下一个节点的算法的运算。

第五章 算法分析

5.1 算法满足的可测量性质

作为算法,NED满足一下四个性质
①非负性
②对称性
③相等性
④三角不等式性
由于编辑操作的值最小是1,因此满足性质①;在俩个K-adjacent树中,层节点转换到相对应的层节点之间的编辑距离是相同的,因此满足性质②。

5.2 复杂度分析

由于算法是自下而上逐层运行的,因此假设m、n是俩个树对应层节点的个数,并且假设m>n。
第一步:Padding 复杂度:O(m-n)
第二步:Canolization 复杂度:O((m-n)log(m+n))
第三步:二部图构建 复杂度:O(mn)
第四步:二部图匹配 复杂度:O( m 3 m^3 m3)
第五步:匹配成本计算 复杂度:O(m)
因此,总体来说整个NED算法的时间复杂度是O( K m 3 Km^3 Km3),其中K是指k-adjacent的层数。由于在K-adjacent中的k值不需要设置太大,因此整个算法的复杂度在实际运算过程中是高效的。

第六章 实验

6.5 案例研究:去匿名化的应用

   所需要的知识:置换检验
  用这个案例是为了表现NED的性质。图的去匿名化是数据库和数据挖掘领域重要的隐私问题。社交网络中的用户通常会匿名化自己的一些数据,但是有一些去匿名化的技术可以通过已经公布的信息来挖掘有用的信息。以前经常用基于特征的相似度来解决去匿名化的问题。这个实验通过将PGP和DBLP中的数据分成两个部分(训练集:存放含有标识的子图,测试集:不含有标识,经过朴素化、稀疏化、扰动化的匿名子图),进行模拟去匿名化的过程。所使用的方法:在测试集集中(不含有标识的子图)通过猜测方法,找到前面最最相似的节点进行分配标识。由于NED可以通过更多的拓扑信息来进行计算,它可以更加精确(前面提过)。相反的,HITS和基于特征的方法的精确性就差些了。

补充信息:

文献来源:

https://arxiv.org/pdf/1602.02358.pdf
文章相关资料:https://github.com/tiankonghenlan20113046/NED
在这里插入图片描述

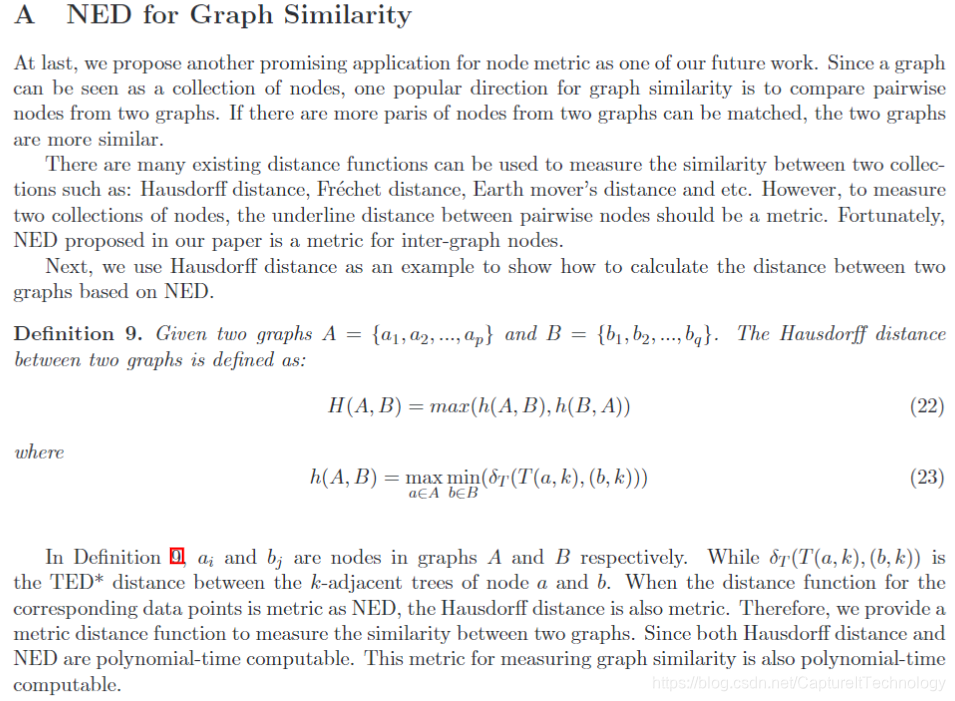
  注意作者最后的定义,这种metric可以为图相似度服务。检查俩个图的相似度,可以通过检查俩个图中点对的相似度,如果相似的点越多,则俩个图的相似性越大。点的metric文章已经给出,可以使用这种metric去计算。

文章总结:

  1. 文章解决的问题:比较俩个图中节点对的相似度。给定俩个图,通过修改的树的编辑距离TED*的这个metric,去计算图间节点的相似度。同时许多文献的角度大多集中在图内节点的相似度,比如SimRank及其变种的算法、ReFeX[7]、HITTS这些算法。

  2. 作者使用的方法:通过修改树的编辑距离TED,提出了一种新的编辑距离TED*,这种编辑距离是在多项式时间内可以计算的,然后通过这种可以计算的修改后树的编辑距离,提出了NED这种metric。相对于NP-C的TED来讲,NED满足了metric的四种基本条件。同时metric考虑到了节点的拓扑结构(k-adjacent tree),有效地计算了图间节点的相似度。

  3. 作者创新点:
    3.1 虽然也是研究了节点的相似度,但是前人的工作大多集中在了图内的节点。
    3.2 从树的编辑距离考虑了节点的相似度。

  4. 作者方法的不足:
    4.1 全文分析了如何比较俩个图中点对的相似度,但是没有把算法放在俩个图中所有点对的计算。并且一个点对的计算复杂度在文章提到,高达 O ( m 3 ) O(m^3) O(m3)(假设 m 、 n m、n m、n是k-adjacent树的对应层节点个数)。虽然文章用了 H u n g a r i a n Hungarian Hungarian算法去匹配二部图,但是指数为3对于算法来说还是很高,有没有匹配二部图的算法,可以把这个成本往下降低?
    4.2 对于 k k k取值的问题,文章都是通过实验取经验获得,但是 k k k应该通过理论分析得出,实验的开销很大。这也是很多运用 k − a d j a c e n t k-adjacent k−adjacent树作为索引经常存在的问题,在将索引进行应用之前,有没有理论分析可以证明出对于哪种数据集,适合什么样的 k k k值呢?
    4.3 文章忽略了节点和边的label。从算法开始,都没有考虑过有label节点的情况。虽然在算法的第二步进行了节点Canoliazation,但是加上标签的情况是为了确定子树是相同的树形结构。所以如果考虑到边和节点的label,应该会更准确些。即在图的算法中,考虑的结构信息越多,度量越精准。
图联邦学习(Federated Graph Learning) 联邦学习(Federated Learning, FL)是一种分布式学习方案,通过多个参与方(即客户端)协作训练一个模型而无需共享他们的隐私数据,以解决数据隔离问题。图联邦学习(Federated Graph Learning,FGL)是联邦学习在图数据上的应用,通过以联邦方式训练图神经网络,来解决图数据隐私保护的问题。 阅读详情

相关推荐

LRTimelapse Pro v7.0.0 激活版下载安装教程 (延迟摄影后期渲染)

LRTimelapse Pro 是一款优秀的高级延时摄影解决方案,使用将为用户提供最全面的工具和功能,从导入和组织您的延时摄影序列、视觉工作流程、在 LRTimelapse 中直接编辑和渲染、视觉去闪烁等等,功能齐全,可以使用 LRTimelapse Pro 编辑多个序列时显著提高您的效率,轻松在 LRTimelapse 中配置和使用色彩管理,进行长期延时编辑,在 LRTimelapse Pro 中使用长期工作流程。为延时编辑、关键帧、分级和渲染提供最全面的解决方案。

wyqshusan的博客 3464

1-NED

1-NED 指的是normalized edit distance edit distance 编辑距离 在NLP任务中经常会碰到比较两个字符串的相似度,比如拼写纠错和指代判断。用户很可能在搜索时输入错别字,比如“微信”输成了“为信”,但是搜索引擎返回的结果纠正为“微信”的搜索结果,如图1-1。另外比如“北京大学校长”和“北大校长”,“北京故宫博物院”和“北京故宫”都是指的同一个人或事物。 上述问题,可以利用两个词或短语的编辑距离大小来解决。 利用编辑距离可以判断两个字符串的相似程度,...

hxxjxw的博客 2015

FDTD Solutions-入射波长模式

经常在文献中看到仿真光源使用TM/TE模式,这个确定是十分必要的,决定了仿真结果。 但是也不能局限于选择TM/TE,因为不同领域、不同软件之间的使用习惯和命名可能不同。并且在现代光波导器件中,几乎全部 都是混合模式,或者称之为quasi-TE(准TE模式)和quasi-TM(准TM模式),多数情况下都简称为TE模式和TM模式。要知道 到底是TE模式还是TM模式,需要查看其电场的主分量(即振幅...

HECHUANWANG的博客 1万+

常用十大算法_迪杰斯特拉(Dijkstra)算法,弗洛伊德(Floyd)算法

Dijkstra算法(迪杰斯特拉算法) 通过普里姆算法与克鲁斯卡尔算法,我们可以运算出最优全连通结果。但若要计算某个顶点与其他顶点连接的最短距离时,则需要了解地杰斯特拉算法(D算法)与弗洛伊德算法(F算法) 【例子】如下图,有一个7村庄(A~G),需要求得G村庄到其他村庄的最短距离 D算法流程: visited_vertex数组:存储顶点是否被访问的信息(1为被访问) pre_visited数组:存储对应结点的父节点 distance数组:存储对应结点距起始结点的距离 ...

泥煤少年的博客 2565

DEM数据下载,拼接,裁剪

目录: 1、数字高程模型(DEM)的数据下载 2、在ENVI里面进行拼接,生成SARscape标准格式的DEM数据3、在ArcGIS里面安装已有的矢量范文,进行掩膜裁剪 4、注意事项 数字高程模型的数据下载: 网址:http://dwtkns.com/srtm30m/ 1.对研究区域进行经纬度选择,然后进行选择下载即可 2.下载的数据是.hgt格式的,按照不同的需求进行转换,这里我是用于ENVI处理,且下载了四个,所有进行了拼接,拼接、格式转换如下 注:可能有时候需要登陆注册,点击下...

weixin_40874151的博客 2万+

Keil C51开发必看:详解data/xdata/bdata内存分配陷阱与避坑指南

本文深入解析Keil C51开发中的data/xdata/bdata内存分配陷阱,提供针对51芯片的高效避坑指南。通过真实案例揭示Keil编译器的隐藏规则,分享内存优化策略和调试技巧,帮助开发者解决data溢出、xdata访问异常等典型问题,提升嵌入式开发效率。

v6b7n8m9q0的博客 1070

[评测系列第一篇]计算机视觉:图像分类、目标检测、目标识别评测指标介绍

随着人工智能如火如荼的发展,无论是学界的模型创新,还是业界的模型应用,如何去评价模型的优劣都是十分重要的工作。每年业界或学术界都会举办很多AI方面的比赛,而作为量化所有参赛者的成绩则是运用他们的模型在给定的测试集下计算出对应的指标。 我给大家深入分析下CV场景下评测指标的含义。无论您是作为开发工程师,还是算法工程师,希望这篇文章能够让你弄清楚这些指标的含义。 1、图像分类指标 分类模型的指标主要有...

cheney的专栏 3422

LeRobot 入门教程(十)LIBERO 机器人终身学习评估

LIBERO是一项专注于机器人终身学习(LLDM)的基准测试平台,包含130项任务,分为5大套件(空间推理、物体操作、目标约束等)。LeRobot框架已集成LIBERO,支持单/多套件评估,并兼容SmolVLA模型。训练需使用预处理数据集(HuggingFaceVLA/libero),观测数据需符合规范(8维状态+双摄像头图像)。该平台采用MuJoCo模拟,支持无头服务器运行,旨在推动机器人持续学习算法的发展与标准化评估。

2506_90492529的博客 1662

vba 数字转文本_基于编辑距离算法的文本相似度3种解决方案

点击“数字化审计”,可以关注哦!开篇啰嗦话如何有效的对两个有关联、但内容相似的文本进行模糊对比分析以发现审计疑点是审计数据分析业务中经常要面临的问题。本文基于文本相似度的编辑距离算法实现了对两个相似文本的进行了模糊对比分析,能有效地解决了审计实务中相似文本模糊匹配的难题,为快速锁定审计线索提供有效帮助基于编辑距离的文本相似度3种解决方案文本相似度对于审计的必要性大数据时代,企业的各...

weixin_39877504的博客 1078

解锁PyCharm+Deepseek:本地部署AI编程超能力

在本次探索中,我们成功地在 PyCharm 中实现了 DeepSeek 的本地化部署,这一过程虽然涉及多个步骤,但每一步都为我们开启 AI 编程大门奠定了基础。从安装最新版 PyCharm,确保我们拥有一个功能强大且兼容性良好的开发环境,到注册 DeepSeek 账号并获取 API Key,这是连接我们与强大 AI 能力的关键纽带。接着,在 PyCharm 中安装 Continue 插件并进行精细配置,让 DeepSeek 能够深度融入我们的编程流程。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 5548

[工作流节点10] 获取多条数据并循环执行 —— 明道云批处理自动化实战

本文系统介绍了明道云工作流中"获取多条数据+循环执行"的批处理功能。该功能通过筛选数据集合并逐条处理,适用于批量通知、数据更新等场景。文章详细解析了功能配置方法,包括数据筛选、循环设置和异常处理,并提供了合同到期提醒等典型应用案例。同时强调了数据量控制、分批处理、错误处理等优化策略,帮助用户实现高效批量自动化。这一功能组合能将业务从单条处理升级为批量驱动,显著提升工作效率。

每日出拳老爷子的博客 454

利用公共子图同构计算图编辑距离相似度(CSI_GED:An Efficient Approach for Graph Edit Similarity Computation ICDE2016)

用边映射的方法,寻找最佳匹配的路径

CaptureItTechnology的博客 4667

【uniapp踩坑记】App Store上传失败:Invalid Swift Support错误怎么解决?

作为一个前端出身的开发者,用 uniapp 开发原生 App 已经够挑战了,打包 iOS 上传 App Store 更是处处暗雷。这次的坑虽然小,但确实容易忽略。如果你也遇到了类似的报错,希望这篇文章能帮你少踩一次坑!

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 1143

An Exact Graph Edit Distance Algorithm for Solving Pattern Recognition Problems

2015年的文章,已经用python实现,必应搜索networkx.simialrity.py 图形编辑距离是一种容错匹配技术,可用于解决模式识别,机器学习和数据挖掘中的不同任务的强大而灵活的图形匹配范例;它表示通过插入,删除和替换顶点和/或边线将一个图形转换为另一个图形的最低成本顺序。 精确图形编辑距离计算的一种广泛使用的方法是基于A算法。 为了克服遍历要存储的待解决方案的搜索树时遇到的高内存负...

CaptureItTechnology的博客 1416

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Graph Edit Distance Computation via Graph Neural Networks 2019 WSDM

使用神经网络计算图编辑距离

CaptureItTechnology的博客 1265

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

图挖掘的基本概述 以后写文献综述

https://blog.youkuaiyun.com/qq_41653753/article/details/79112436 近年来,图挖掘作为,数据挖掘的重要组成部分引起了社会各界的极大关注。图挖掘(Graph Mining)是指利用图模型从海量数据中发现和提起有用知识和信息的过程。通过图挖掘所获取的知识和信息已广泛应用于各种领域,如商务管理、市场分析、生产控制、科学探索和工程设计 ...

CaptureItTechnology的博客 1172

Graph Similarity Search with Edit Distance Constraint in Large Graph Databases通过分支(Branch)构建编辑距离下界

文章简介: 文章标题:Graph Similarity Search with Edit Distance Constraint in Large Graph Databases 文章来源:CIKM 2013 作者单位: 郑伟国 北京大学 邹雷 北京大学 德克萨斯州湘联大学-泛美分校,美国爱丁堡 北京大学 王东 北京大学 赵冬岩 文章链接 文章正文: 分支距离的概念: 下界的提出: ...

CaptureItTechnology的博客 1130

匈牙利算法计算GED

time:2020.5.20 文章标题《approximate graph edit distance computation by means of bipartite graphs matching》 GED计算通常构建一个搜索空间树,其中根节点表示开始搜索的空节点。这课树的构造是在搜索过程中建立的,在以往的算法[22]中,通常需要全部遍历到叶子节点(叶子节点不一定是最佳的编辑路径),采用“best-first”思路:设定启发式函数h(f) + g(f)。g表示从根的编辑操作空节点到当前节点的代价,h表

CaptureItTechnology的博客 1051

Exact Computation of Graph Edit Distance for Uniform and Non-uniform Metric Edit Costs

精确计算GED三种方法(BLP_GED、CSI_GED、DF_GED)的比较和总结

CaptureItTechnology的博客 918

An Efficient Probabilistic Approach for Graph Similarity Search [Extended Technical Report]

An Efficient Probabilistic Approach for Graph Similarity Search 文章链接 文章简介: 作者单位: 香港科技大学计算机科学与工程系 李子健/建勋/联想 美国肯特州立大学计算机科学系 陈磊 文章来源:2018 ICDE 文章总结 ...

CaptureItTechnology的博客 709

Speeding up Graph Edit Distance Computation with a Bipartite Heuristic 使用二部图匹配寻找顶点的最佳映射

文章简介 文章标题:Speeding up Graph Edit Distance Computation with a Bipartite Heuristic 文章链接 作者单位:Kaspar Riesen,伯尔尼大学 文章来源:International Workshop on Mining and Learning with Graphs(MLG 2007) 会议视频 ppt 1.他人代码...

CaptureItTechnology的博客 701

gSpan算法的研究多层索引文献引用判断图同构

gsapn 算法的回顾,自己掌握得不好。

CaptureItTechnology的博客 676

2017Similarity Search in Graph Databases:A Multi-layer Indexing Approach 论文概述

多层索引结构,将一个图分区,查看分区Q是否子图同构到一定数量,符合要求则为相似。

CaptureItTechnology的博客 629

New binary linear programming formulation to compute the graph edit distance 2015

利用整数线性规划(Integer linear programming)计算图编辑距离

CaptureItTechnology的博客 609

如何在图中寻找一条最佳的路径?

参考链接

CaptureItTechnology的博客 598

通过层次代表矩阵的top-k图搜索

“”" time:2020.5.26 reference: 1.https://blog.youkuaiyun.com/qq_37475168/article/details/103616443 2.<<>top k graph similarity> “”" 辅助定理: 假设有一个矩阵如下, [1374161214212]\begin{bmatrix} 13 &7 &4 &16 \\ 12&14 &2 &12 \end{bmatri

CaptureItTechnology的博客 591
上一篇: Eclipse调试(转)
下一篇: An Efficient Framework for Exact Set Similarity Search using Tree Structure Indexes
RunningBComeOn
博客等级 码龄10年 133粉丝 161原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

RunningBComeOn

你的鼓励是我最大的动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值