AI写的代码你不敢merge,问题可能不在AI

很多团队引入AI编程工具后,遇到了一个尴尬的局面:AI生成的代码能编译通过、能跑通测试、看起来逻辑也没问题,但开发者就是不敢点那个merge按钮。

不是代码写得不好,而是开发者不知道这些代码为什么是这样写的。每行代码都合理,但合在一起,review的人无法确认它是否真正理解了业务意图。

这种信任缺失,根源不在AI的代码质量,而在上下文对齐。
在这里插入图片描述

信任问题的本质:不是代码差,是上下文缺失

Stripe的工程基础设施团队在部署Claude Code时遇到了类似问题。他们向1,370名工程师推广AI编码助手后,发现最大的挑战不是技术层面的,而是教育层面的。

Stripe的开发者基础设施负责人Scott MacVicar发现,工程师最初把AI助手当作"替代自己写代码的工具",给它一个模糊的指令就期望AI产出完美的代码。结果当然不尽如人意——开发者不敢merge,因为AI的产出和他们的预期不一致。

Stripe最终的解决方案是建立一个新的心智模型:把AI当作一个"刚入职的、技术很强但不懂业务的新工程师"。新工程师知道所有编程语言,但不知道你的代码库架构、不理解你的业务逻辑、不了解你们团队的做事方式。你需要给他上下文——指向文档、展示示例代码、解释架构模式。

这个心智模型改变了一切。工程师不再给AI模糊的指令然后期待魔法,而是学会了提供充分的上下文:项目结构说明、业务规则描述、架构约定、代码规范。AI产出质量大幅提升,merge的信心也随之增强。

上下文对齐的三个层面

Stripe的经验揭示了一个关键认知:AI代码不敢merge,问题不在AI的能力,在于上下文是否充分对齐。这个对齐需要覆盖三个层面:

业务上下文:AI需要理解这段代码解决什么业务问题。不是"写一个用户注册接口",而是"写一个用户注册接口,注册成功后发送欢迎邮件,邮件发送失败不阻塞注册流程,密码使用BCrypt加密,用户名长度3-20字符"。

架构上下文:AI需要理解项目的分层约定和设计模式。Controller不写业务逻辑,Service不直接返回Entity,Repository不跨模块调用。这些约定不告诉AI,它可能按通用最佳实践写代码,但和你的项目风格不一致。

质量上下文:AI需要知道项目的质量底线。是否要求所有公开方法写单元测试?是否禁止使用@Autowired字段注入?是否要求所有异常都通过@ControllerAdvice统一处理?这些规范不明确,AI的产出就可能踩到团队的雷区。

传统AI编码助手的上下文局限

通用AI编码助手(Copilot、Cursor、Claude Code)在上下文对齐方面做了不少工作。Cursor 2.0引入了SKILL.md技能文件和rules规则声明,Claude Code通过CLAUDE.md项目指导文件提供持久化上下文。

但这些方案的共同局限是:上下文对齐依赖开发者手动维护。你需要手写CLAUDE.md或SKILL.md,告诉AI项目的架构、规范和约定。每次项目结构变化,这些文件也需要同步更新。实际上,很多团队根本没有时间维护这些文件,AI的上下文对齐就变成了"有则好、无则忍"的状态。

更深层的问题是:即使上下文文件写得很完善,AI在生成代码后,开发者仍然需要确认"AI是否真的理解了这些上下文"。这个确认过程本身就是一种心智负担——你需要逐行审查代码,判断每一处实现是否符合你在上下文文件中描述的约定。

把判断力前移:从"事后审查"到"事前确认"

解决"不敢merge"问题的另一个思路,是把判断节点从"代码生成之后"前移到"代码生成之前"。

传统AI编码助手的工作流程是:开发者给指令 → AI直接生成代码 → 开发者审查代码 → merge或打回。判断发生在最后一步,成本最高——代码已经写完了,如果方向不对,返工成本很大。

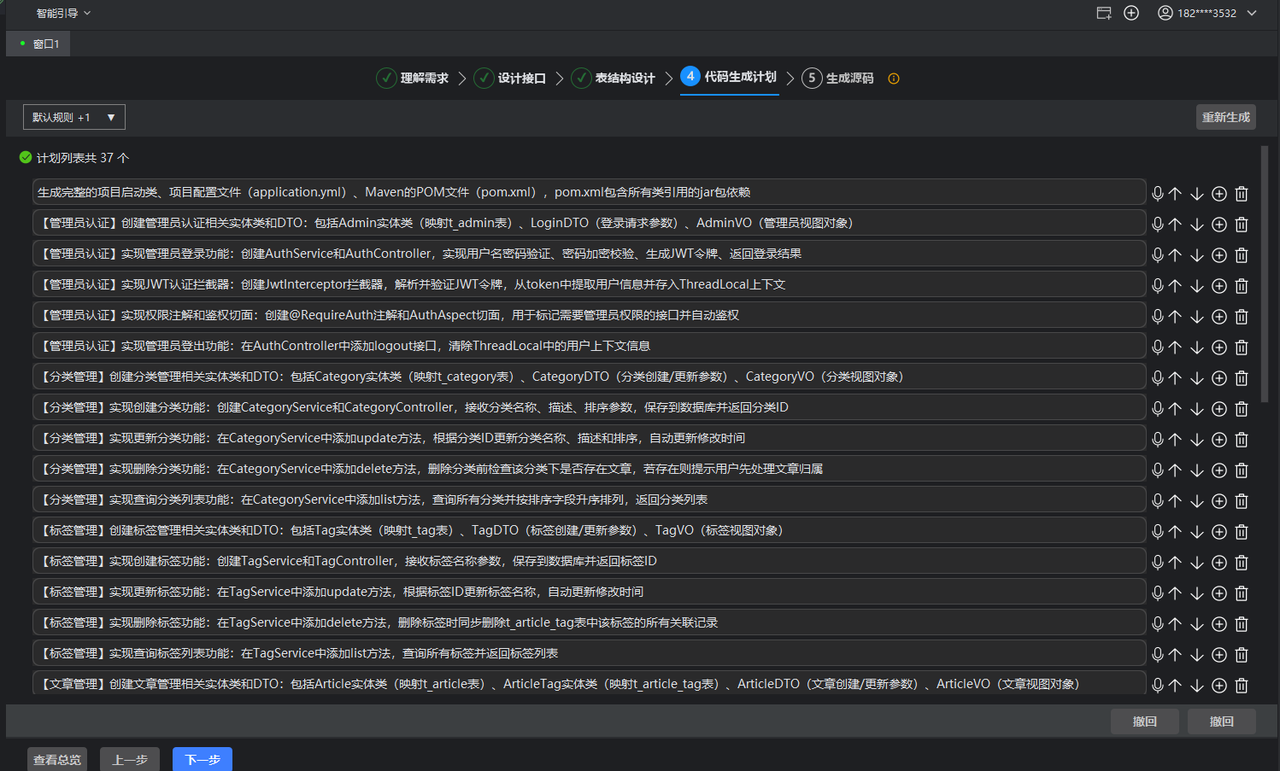
飞算JavaAI的5步智能引导采用了不同的流程:开发者输入需求 → AI拆解子任务 → 开发者确认 → AI设计接口 → 开发者确认 → AI设计表结构 → 开发者确认 → AI生成处理逻辑 → 开发者确认 → AI生成源码。
在这里插入图片描述

每个关键节点都有一次确认机会。开发者不需要在代码生成后判断"AI是否理解了业务意图",而是在代码生成前,通过确认AI的接口设计、表结构、处理逻辑来确保方向正确。

这种方式的信任建立逻辑是:不是让AI生成更好的代码让你敢merge,而是让AI在每个决策点都经过你的确认,让你对最终代码有"参与感"。你审查的不再是"AI写的代码",而是"你确认过设计后、由AI实现的代码"。信任自然建立。

merge的勇气来自流程而非代码

回到最初的问题:AI写的代码不敢merge,怎么办?

答案不是让AI写更好的代码,也不是让开发者更仔细地审查代码。而是建立一个让信任自然产生的流程。

这个流程需要满足三个条件:

  1. 上下文在代码生成前就对齐:不是写完代码再检查是否符合业务意图,而是在设计阶段就确认AI理解了需求
  2. 判断节点前移:在接口设计、表结构、处理逻辑等关键决策点设置确认环节,而不是只在最终代码审查时判断
  3. 质量保障自动化:编译错误、安全漏洞、规范违规由工具自动扫描和修复,开发者只需聚焦业务逻辑审查

当这三个条件满足时,merge不再需要"勇气"——因为代码的每个环节都经过了你的确认,质量保障由工具自动完成,你审查的焦点只剩业务逻辑正确性。

结语

AI写的代码不敢merge,表面上看是代码质量问题,实际上是流程问题。

Stripe的"AI是新工程师"心智模型和飞算JavaAI的"5步确认点"设计,从不同角度指向同一个结论:信任来自上下文对齐和流程设计,而非代码本身的质量。

通用编码助手擅长快速生成代码,但在上下文对齐和判断前移方面仍有局限。对于"不敢merge"的团队来说,真正需要解决的不是"AI代码够不够好",而是"有没有一个流程,让开发者在代码生成前就建立信心"。

相关推荐

让模型盯着界面写断言:GLM-5.3-Flash 在 UI 回归测试里替掉了哪几步人工

GLM-5.3-Flash 通过原生多模态能力,自动完成“看图识错—转为断言—生成检查逻辑”三步,替代人工在视觉回归中识别布局错位、文案溢出、图片裁切等问题的繁琐操作。第四步(判断差异是否为真问题)仍需人工介入,确保准确性。其0.15×低消耗系数使每轮视觉断言可低成本运行,实现高效自动化。

CalEx_Tech的博客 201

整仓一次读完,我还是不敢让它改一行:Kimi-K3 在版本升级里的正确位置

手里攥着一个多模块的 Java 仓库,要升一批依赖,最磨人的从来不是改,是「改之前得先弄清牵动多少」。BOM 里动一个版本号,传递依赖跟着飘,几十个pom.xml、几百处调用点、还有散在各处的废弃 API,人肉翻一遍三天打底。Kimi-K3 那个 1M 单一窗口,确实能把整仓连文档带测试一次装进去,我干过,地图画得又快又全。可画完我连一行pom。

CalEx_Tech的博客 382

批量代码生成降本实践:Kimi-K3-低速版的性价比打法

500个文件的老项目Java 17改造,用Kimi-K3跑完账单21块8,换K3-低速版重跑同样的任务,11块2。活一模一样,钱差了一半。两条路跑的是同一套调度脚本、同一份提示词模板,唯一变量是模型档位,所以这个差价是干净的对照数据。这半年我们组把批量类的代码生成任务全切到了低速版,踩了一些坑,也攒出一套稳定的调度打法,这篇摊开聊聊。

CalEx_Tech的博客 602

用Kimi-K3写架构设计文档:AI辅助技术方案写作的正确姿势

AI写方案的上限,取决于你喂了什么,而不是它有多聪明。只喂一份口语记录,它给你正确的废话;把存量代码、真实配置一起喂进去,它才能写出落地的方案;再让它反过来当一次评审官,你的方案就很难被别人挑穿。你们写技术方案时敢把存量代码喂给AI吗?担心泄密的同学、已经在做的同学,评论区都来聊聊。

CalEx_Tech的博客 259

代码生成不是终点:飞算JavaAI + Kimi 的“生成-验证”闭环实践

AI 生成代码最常见的翻车姿势,不是编译报错,而是“编译干净、自测全绿、一上预发就崩”。我用飞算JavaAI(飞算科技面向 Java 开发者的 IDE 插件)搭配 Kimi 系模型跑了几个月,被坑过也验证过,结论收敛成一句话:生成质量取……

CalEx_Tech的博客 552

前后端两个仓库的痛,三年开发最懂:为什么 2026 年你需要一个 Workspace

说回开头那个"隐形工时"的话题。我算了这样一笔账:一个需求,前后端联调平均消耗 2 小时;一个月 10 个需求,就是 20 小时;一年就是 240 小时,几乎等于 6 个完整的工作周。而这些时间,既没有沉淀成代码,也没有沉淀成文档,全浪费在"两边的信息没对上"上。Workspace 多项目支持真正解决的,不是写代码的速度,是信息对齐的成本。它让 AI 编程工具从"单仓库的代码补全器"变成了"懂整个业务链路的协作者"——你给它一个窗口,它看到的是从前端页面到后端接口的完整链路。

CalEx_Tech的博客 491

线上排错实录:日志、堆栈、代码一起丢给 Kimi,定位快在哪

结论前置:线上排错慢,多数时候不是思路不清,而是信息散——异常堆栈在控制台,相关代码在工程里,上下游日志在别的服务。人肉排查就是在三个信息源之间来回切换,每切一次就丢一截刚建立的因果链。把日志片段、可疑类源码、启动配置一次性交给长上下文……

CalEx_Tech的博客 524

大模型选型不是玄学:手把手算清AI编程的Token成本账

成本核算搭起来两小时,之后每月复盘十分钟。它带给你的不只是省钱,更是"哪类任务交给哪档模型"的量化直觉。你的团队算过AI编程的账吗?有没有发现过反直觉的成本数据?评论区见。

CalEx_Tech的博客 877

从需求文档到接口设计:飞算JavaAI+Kimi驱动的Java后端全流程提效

上周三下午三点,产品把一份12页的PRD拍到我桌上:《营销优惠券发放功能》,下周一提测。放到去年,我的第一反应是先叹口气——吃透需求、建表、定接口、撸骨架、写联调文档,一切顺利也要三天。这次我把整条链路放在飞算JavaAI上跑了一遍,模型接的是Kimi-K3,周四下午骨架就给同组的兄弟过了一遍。这篇复盘把每个环节的耗时、token消耗、人工改动占比都记下来,给准备做同类尝试的同学一个可对照的基线。

CalEx_Tech的博客 467

Kimi 三款模型写代码该选谁?一篇文章全明白!

选Kimi写代码,三模型各有定位:K3广度强、长上下文优;K3.1-Pro执行力与可靠性跃升,幻觉率低,但输出冗长、耗时耗能;K3-低速为同一模型的调度降级版,仅延迟换取成本,无能力损失。关键不是倍率,而是输出token量×单价——K3.1-Pro虽贵,却在复杂任务中省去人工纠错成本。若追求效率与稳定,选Pro;若可容忍等待且重性价比,低速是唯一无损省钱方案;若只需基础编码,原版K3已足够。

CalEx_Tech的博客 663

前后端分离三年,我为什么把两个项目塞进同一个 Workspace?

本文探讨前后端分离项目中因代码割裂导致的开发效率低下问题,提出通过 IntelliJ IDEA 2025.2 及 Multi-Project Workspace 插件,将前后端项目纳入同一工作区,实现“一个指令、双端同步修改”。文章详解配置流程、实操效果与真实迭代对比,揭示其在减少上下文切换、避免返工、提升联调效率方面的显著价值,并区分多项目支持与多模块、Monorepo 的本质差异,为前后端独立部署、需频繁协同的团队提供高效协作新范式。

CalEx_Tech的博客 571

22 小时不睡觉把 GPU 内核推到 508 TFLOPS,AA 指数却只有 44:Step-5-Preview 的 0.5× 买的是续航不是智商,那 42% 便宜只够多试 1.74 轮

—前者对应 SRE 0.4%,后者虽然 CyberGym 84.7% 很高,但"越权 + 反序列化"这种需要业务语义判断的场景,它的强项用不上。

CalEx_Tech的博客 667

DeepSeek V4 四款模型写代码该选谁?算完 2.0×、1.0×、0.5× 这笔账,结论有点反常识

右边跟着两列数字——原价倍率与折后倍率。很多人凭直觉选「Pro」,因为 Pro 听起来更贵更强;也有人随手选最便宜的 Flash,觉得写代码都差不多。这两种选法都会亏钱,而且亏的方式不一样。;而。

CalEx_Tech的博客 1094

MiniMax-M3 折后只剩 0.15×,是整张模型表里最便宜的一格——可它在官方榜上 59%、在别人的终端 harness 上只有 1.01%,这一格到底该派什么活

既省钱,又避免长上下文里注意力稀释。

CalEx_Tech的博客 509

Qwen3.8-Max 0.5× 对 Flash 0.15×,倍率只差 3.33 倍,官方价差却是 15 倍——这张表在补贴旗舰、溢价轻量,多数人恰好选反了

Max 的"开源"是姿态,Flash-Next 的"开源"是可以落地的方案——125B/6B 激活这个体量,在合理量化下是几台机器能装下的量级。这是本系列所有模型里,自托管可行性最高的一档。

CalEx_Tech的博客 758

一个指令,前后端同步开发:刚提完需求,两端代码一起落地的真实体验

以前开发跨端需求是"等着别人/另一端的代码",现在变成了"验收两端一起生成的代码"。变化不是"从写代码变成不写代码",而是工作重心从"转译需求 + 对齐口径"转移到了"审核生成、把关边界、验回归"。后者是更接近工程本质的工作。如果你也是前后端分仓库、一个人扛需求、或者整天被联调折磨,建议按上篇文章的步骤把 Workspace 搭起来,拿一个真实的筛选类需求试一次。跑通之后你就会发现,以前最花时间的"联调对齐",变成了生成时就完成的事。

CalEx_Tech的博客 871

一篇文章说清楚,模型该如何选

飞算JavaAI 的模型选择框,这次被完整截了下来。17 行,5 个厂商,每一行都是「原价划掉 → 实收价」的格式,后面挂一个小小的角标。先看三个一眼能看出来的东西。四个 0.15×(GLM-5.3-Flash、MiMo-V2.6-Flash、MiniMax-M3、Qwen3.8-Flash),两个 0.2×(两个 DeepSeek Flash),保留率清一色落在 15%–20%。这不是巧合,是标准定价策略——轻量层不靠折扣区分,谁打折都一样深。

CalEx_Tech的博客 617

60万个JUnit 4测试、几年的活压缩到几周:Uber用Agent啃下Java遗留系统最硬的骨头

Uber用AIAgent将60万个JUnit4测试迁移至JUnit5,仅用几周完成原需数年的工程,打破“迁移成本过高”困局。本文解析其成功关键:任务高度模式化、验证完备、可分批回滚;核心在于构建代码语义上下文,让Agent“看懂”复杂遗产系统。中小团队可三步启动:建全量代码索引、优先迁移机械性批次、独立会话管理专项任务。真正变革不在于模型更聪明,而在于先建图、再行动——存量升级的偿还窗口已开启。

CalEx_Tech的博客 297

一周连发四款编程模型、轻量款输入只要1毛钱:模型开始「分层上班」,Java团队的路由怎么配

11月9日至12日,Anthropic、谷歌、Meta、Kimi接连发布四款编程模型,形成“旗舰重活、速度日常、轻量跑腿、提速长任务”的分层格局。模型价格从0.1至8美元/百万token,分工明确。对Java团队而言,选型难题转向智能路由——通过任务难度自动分配模型,实现成本节省69.4%。飞算等工具推动“智能路由+专家模式”双层架构,助力团队降本增效。未来,谁能精准派活,谁就胜出。

CalEx_Tech的博客 576

AGENTS.md 里塞一句话,AI 九成会照做:先查你仓库里这几个文件

安全公司ForeverSecurity披露,智能体因读取恶意指令文件(如AGENTS.md)导致高复现攻击风险,暴露了代码生成链路中“说明文件即入口”的安全隐患。攻击者可伪装合法提交,绕过审查,使智能体执行恶意操作。行业应对方向为前置防护:厂商推沙箱与政策钩子,团队则需构建自身控制面——通过扫描、单元测试验证及流程化验收,确保产物可运行、可追溯。关键在于将安全检查嵌入开发流程,实现“三步走”:文件进Review、改动跑用例、上线前扫漏洞。唯有双层护栏协同,才能真正封堵此类低门槛高风险攻击。

CalEx_Tech的博客 202

61%的企业开源账单流向Kimi、Llama只剩7%:中国模型赢下份额战,Java团队该跟着换吗

2026年企业AI报告显示,中国模型占企业开源支出89%,Kimi以61%份额领先,但榜单第一不等于Java场景最优。通用模型在代码补全、依赖管理等实战中存在颗粒度、上下文成本与安全边界三大落差。真正决定效率的是工具层:是否理解工程结构、能否智能控费、是否支持本地化部署。选型应聚焦“认不认得我的工程”“账单可不可控”“代码出不出域”三大问题,而非盲目追随份额。

CalEx_Tech的博客 321

Spring Boot 4.2 刚 GA,4.0 就停维护:这轮升级别裸迁,AI 先替你踩一遍雷

Spring Boot 4.2 GA将于11月底发布,4.0开源支持将于12月31日终止。团队需在年底前完成升级或转入商业支持。升级关键在于更新依赖、迁移配置、替换废弃API,尤其需新增“盘点AI生成代码的API版本”项——因训练语料滞后,AI生成代码常含旧版API,易引发编译与运行时问题。建议先编译排查报错,再结合产物记录与Code Review定位混用点,形成清单以备后续升级。借助文档与模型流程对齐,确保新代码与工程版本一致。两笔账(依赖+AI代码)同步清,可大幅降低回归成本,实现平稳升级。

CalEx_Tech的博客 303

一千多美元、两周时间,智能体偷走苹果签名证书和19万游戏凭证:AI干活的安全账,谁来记

智能体攻击成本降至千元级,4小时完成入侵,企业修复却需43天。一例攻击中,自主智能体两周内窃取苹果证书与19万游戏凭证,暴露凭据管理、代码路径与工具安全漏洞。对Java团队,四条防线亟需建立:凭据轮换、投毒文件审查(如AGENTS.MD)、代码本地化处理、全程操作审计。安全不再依赖技术高墙,而取决于响应速度与流程闭环。

CalEx_Tech的博客 584

Cursor 发布 Build Live Apps:AI 写完代码之后,到上线还有几步

本月AI编码工具竞争焦点从代码生成转向生成后链路承接。Cursor打通建库、登录、安全检查到发布的全流程,实现一键上线;Copilot与Anthropic强化本地沙箱与前置审查,提升安全性。对多仓库企业系统而言,关键在于前后端接口对齐——飞算JavaAI通过多项目工作区实现跨仓库同步修改,变更可见、提交独立,大幅减少沟通成本。工具选型应匹配项目形态:单仓库选全链路工具,多仓库则优先支持协同编辑与变更可视化的方案。试用小需求即可验证工具适配性,真正高效的是“改哪看哪”的透明化协作。

CalEx_Tech的博客 311

思考过程看得见、中断后一键续跑:当AI编程工具开始「晒思路」,Java开发者该怎么验收

飞算JavaAI发布新版本,新增智能会话思考内容展示、任务中断后“继续生成”按钮、容错优化及IDEA卡顿治理,配合Tokens福利中心与邀请有礼功能,推动AI编程从“黑盒执行”走向“透明协作”。通过“晒思路”,开发者可实时掌握智能体决策逻辑,实现任务可追溯、可干预、可续跑。尤其在Java场景中,深度理解代码结构与工程约束的思考内容,成为可信交付的关键。结合Cursor实时语音交互,两大工具共同指向同一趋势:下一阶段竞争核心是过程透明与可控性。真正可靠的AI助手,不在于快,而在于讲得清、错得起、停得下。

CalEx_Tech的博客 223

不用再手动开线程、主Agent自己拆任务派活:多Agent编排卷到「说目标」这一层,Java团队怎么接

Amp与Meta同步推出Spaces,标志着多Agent编排从“谁开更多线程”转向“谁替你管线程”。开发者不再手动调度,而是通过清晰描述目标,由主Agent自动拆解任务、协调并行线程,并以实时卡片反馈进展。对Java团队而言,关键在于:提供完整工程上下文、写清目标、确保过程可观测。工具迭代不停,但“懂工程”与“会说目标”才是核心竞争力。

CalEx_Tech的博客 470

AI估值一天缩水千亿、编码客户被报九成折扣:资本降温之后,Java团队的Token账怎么省

资本降温下,AI估值缩水千亿,企业开始严控Token开支。智能体时代三大隐性成本:上下文膨胀、重试开销与并发消耗,并提出四条省钱策略:智能路由降本69.4%、可视化消耗追踪、会话压缩防浪费、统筹福利额度。工具机制与使用习惯双管齐下,让每枚Token都产出价值,实现预算内效率翻倍。

CalEx_Tech的博客 178

ChatGPT封号潮之后:AI编程这笔账,还有一块在订阅费外面

产物落在仓库,账号那头就轻了。对话记录没了,需求为什么这么定,docs/ 里的文档写着;提示词调没了,接口约定在文件里,下游照读不误。新人接手,翻 docs/ 就能上手,交接不拄任何人的账号还活着。封号潮里最疼的是「说没就没」,落成文件的产物没有这个死穴:换台机器、换个账号,工程克隆下来,文档和代码还是配套的,接上就能继续干。复盘也省事:哪次改动为什么这么定,翻文件就有,不用去问当年的会话还在不在。第三问是验证谁兜底。生成的代码不直接进仓库。

CalEx_Tech的博客 124

Java 超过 C++ 重回第三:TIOBE 11 月榜,后端的热度回来了

11月TIOBE榜单显示,Java搜索热度回升至第三,超越C++,反映其在企业级后端的持续影响力。尽管热度不等于岗位或装机量,但Java生态成熟、需求稳定,支撑其长期竞争力。AI辅助开发虽提升编码效率,却加剧了对齐与文档的依赖。飞算JavaAI通过智能生成并沉淀需求、接口、库表等产物至docs/,实现流程留痕,提升协作效率与项目稳定性。真正决定项目成败的,不是语言排名,而是工程产出是否完整可追溯。

CalEx_Tech的博客 157

AI 编程工具怎么选?写给 Java 开发者的七款主流工具盘点

2026年AI编程工具分工明确,按形态可分为四类:AI原生IDE(如Cursor、TRAE)、插件型(Copilot、通义灵码、CodeBuddy)、终端智能体(ClaudeCode)与垂直工程化工具(如飞算JavaAI)。选工具关键看“交哪段活”:补全提速用插件,原型开发选原生IDE,批量任务用终端工具,而Java企业级工程从需求到落地全程管控,需依赖飞算JavaAI这类垂直工具。核心三问:认不认工程、产物落不落仓库、验证谁兜底。不盲目跟风,对号入座才是高效之法。

CalEx_Tech的博客 182
上一篇: # Cursor让8个Agent同时写Java,但多Agent并行改代码的后果谁来兜底
下一篇: 从需求到代码只需10分钟?飞算JavaAI智能引导五步法全流程详解
飞算JavaAI智能体
飞算JavaAI智能体 飞算官方账号 飞算官方账号
博客等级 码龄6年 2333粉丝 1750原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值