


(一)前缀树
1.前缀树
何为前缀树?如何生成前缀树?
比如["abc","bck","abd","ace"],“ ”包围的就是从根节点出发走向的的路的名称,如果有就复用,如果没有就添加节点将路延续下去,其中节点是按照遍历集合生成路径的顺序命名的。如图所示:
          n0
       a /   \b
        /     \
       n1      n5
     b/  \c     \c
     /    \      \
    n3     n9     n6
  c/  \d    \e     \k
  /    \     \      \
 n4     n8    n10    n7
我们可以设置两个信号值来模拟这一过程。以["abc","ab","bc","bck"]为例,我们为每一个节点ni设置一个通路标记(p,pass)和一个末尾节点标记(e,end)来判断这一过程。p和e在抵达初始节点(n0)之前设置为0,当初始节点n0进入之后,pass值就加1;由于我们设置了有26条向下走的路,道路a是第一条进入的路,所以end值设置为0。
| 轮次 | 当前字符串 | 当前节点 | 当前字符 | pass | end | 已经加入的道路 | 节点-道路序列 |
| 0 | 0 | 0 | () | {n0} | |||
| 1 | “abc” | n0 | a | 1 | 0 | (a) | {n0-a-n1} |
| 2 | "abc" | n1 | b | 1 | 0 | (a,b) | {n0-a-n1-b-n2} |
| 3 | "abc" | n2 | c | 1 | 0 | (a,b,c) | {n0-a-n1-b-n2-c-n3} |
| 4 | "abc" | n3 | c | 1 | 1 | (a,b,c) | {n0-a-n1-b-n2-c-n3} |
| 5 | "ab" | n0 | a | 2 | 0 | (a) | {n0-a-n1} |
| 6 | "ab" | n1 | b | 2 | 0 | (a,b) | {n0-a-n1-b-n2} |
| 7 | "ab" | n2 | b | 2 | 1 | (a,b) | {n0-a-n1-b-n2} |
| 8 | "bc" | n0 | b | 3 | 0 | (b) | {n0-b-n4} |
| 9 | "bc" | n4 | c | 1 | 0 | (b,c) | {n0-b-n4-c-n5} |
| 10 | "bc" | n5 | c | 1 | 1 | (b,c) | {n0-b-n4-c-n5} |
| 11 | "bck" | n0 | b | 4 | 0 | (b) | {n0-b-n4} |
| 12 | "bck" | n4 | c | 2 | 0 | (b,c) | {n0-b-n4-c-n5} |
| 13 | "bck" | n5 | k | 2 | 1 | (b,c,k) | {n0-b-n4-c-n5-k-n6} |
| 14 | "bck" | n6 | k | 1 | 1 | (b,c,k) | {n0-b-n4-c-n5-k-n6} |
最后形成的前缀树:
          n0(4,0)
       a /   \b
        /     \
       n1(2,0) n4(2,0)
     b/         \c
     /           \
    n2(2,1)      n5(2,1)
  c/              \k
  /                \
 n3(1,1)            n6(1,1)
那么它的实际应用是什么?比如说查询数组中有没有"bc"这个字符串,我们按照这棵树的查询方法进行查询,只需要判断这个节点的e值,如果这个节点的e=0,说明没有加过"bc";如果这个节点的e!=0,说明加过"bc"几次。此外,这个前缀树的作用还可以用来查询有多少个字符串是以"ab"作为前缀的,可以通过查询这个节点的p值得到(这个查询用hashmap很难做到,而前缀树可以)。
另,对于空字符串““也就是只有一个n0节点,没有边。
代码:
package class007;

import java.util.HashSet;

public class Code_TrieTree {
    public static class TrieNode{
        public int pass;//通过了多少次
        public int end;//判断这个节点是否是字符串的结尾节点,如果是的话,它是多少个字符串的结尾节点
        //向下走的路
        //HashMap<char,Node>nexts;
        //TreeMap<char,Node>nexts;
        public TrieNode[]nexts;
        public TrieNode(){
            pass=0;
            end=0;
            //nexts[0]==null 没有走向'a'的路
            //nexts[0]!=null 有走向‘a’的路
            //...
            //nexts[25]!=null 有走向'Z'的路
            nexts=new TrieNode[26];
        }
    }
    public static class Trie {
        private TrieNode root;
        //头节点建立
        public Trie(){
            root=new TrieNode();
        }
        //加入字符串
        public void insert(String word){
            if(word==null){
                return;
            }
            //将“abc”拆成['a','b','c']
            char[]chs=word.toCharArray();
            //node从根节点出发
            TrieNode node=root;
            node.pass++;
            int index=0;
            for (int i=0;i<chs.length;i++){//从左到右遍历字符
                index=chs[i]-'a';//由字符(a对应0,b对应1,以此类推),对应成走向哪条路
                //判断0位置下一级是不是空节点(判断能不能建立新路)
                if(node.nexts[index]==null){
                    //判断没有就新建节点,有就复用原来的节点
                    node.nexts[index]=new TrieNode();
                }
                //直接复用的情况
                node=node.nexts[index];
                //沿途node++
                node.pass++;
            }
            //最后到达的点的end++
            node.end++;
        }
        public void delete(String word){
            if (search(word)!=0){//确定树中确实加入过word,才删除
                char[]chs=word.toCharArray();
                TrieNode node=root;
                node.pass--;
                int index=0;
                for(int i=0;i<chs.length;i++){
                    index=chs[i]-'a';
                    //如果删除多个字符串,可能会使得下级节点节点的pass值变成0
                    //那么就需要去除最后一个节点
                    if(--node.nexts[index].pass==0){
                        //java可以直接释放空间 C++要遍历到低去析构
                        //直接把下级节点标空
                        node.nexts[index]=null;
                        //...
                        return;
                    }
                    //如果不为空,可以继续--
                    node=node.nexts[index];
                }
                node.end--;
            }
        }
        //delete节点的类似CPP实现
        //不能像 Java 一样马上把引用设为 null 就完事,需要找到需要删除的第一条路径,然后把后续节点释放掉。
        public void deleteCPP(String word) {
            // 字符串必须真实存在才能删除
            if (search(word) == 0) {return;}
            char[] chs = word.toCharArray();
            TrieNode node = root;
            // 根节点少经过一个字符串
            node.pass--;
            /*
             * firstDeleteParent:
             * 第一个需要断开路径的父节点
             *
             * deleteIndex:
             * 从哪个字符位置断开
             */
            TrieNode firstDeleteParent = null;
            int deleteIndex = -1;
            /*
             * 模拟C++中需要释放的节点集合
             *
             * Java其实不需要这个集合,
             * 因为有GC。
             */
            HashSet<TrieNode> deleteSet = new HashSet<>();
            for (int i = 0; i < chs.length; i++) {
                int index = chs[i] - 'a';
                TrieNode next = node.nexts[index];
                // 当前下一个节点少经过一次
                next.pass--;
                /*
                 * 如果pass第一次变成0:
                 *
                 * 说明从这里开始,
                 * 后面的整条路径都可以删除。
                 */
                if (next.pass == 0) {
                    if (firstDeleteParent == null) {
                        firstDeleteParent = node;
                        deleteIndex = index;
                    }
                    // 模拟C++收集待释放节点
                    deleteSet.add(next);
                }
                // 继续向下走
                node = next;
            }
            // word的结尾少一个
            node.end--;
            /*
             * 如果确实出现pass==0的节点,
             * 将第一条无用路径断开。
             */
            if (firstDeleteParent != null) {
                firstDeleteParent.nexts[deleteIndex] = null;
            }
            /*
             * C++中:
             * 这里可以真正delete deleteSet中的节点。
             *
             * Java中:
             * 不需要手动释放,
             * GC会负责回收。
             */
        }

        //word这个单词之前加入过几次
        public int search(String word){
            if (word==null){
                return 0;
            }
            char[]chs=word.toCharArray();
            TrieNode node=root;
            int index=0;
            for (int i=0;i<chs.length;i++){
                index=chs[i]-'a';
                if (node.nexts[index]==null){
                    //空串返回0
                    return 0;
                }
                node=node.nexts[index];
            }
            return node.end;
        }
        //所有加入的字符串中,有几个是以pre这个字符串作为前缀的
        public int prefixNumber(String pre){
            if(pre==null){
                return 0;
            }
            char[]chs=pre.toCharArray();
            TrieNode node=root;
            int index=0;
            for (int i=0;i<chs.length;i++){
                index=chs[i]-'a';
                if(node.nexts[index]==null){
                    return 0;
                }
                node=node.nexts[index];
            }
            return node.pass;
        }
    }
    public static void main(String[] args) {
        Trie trie = new Trie();
        // =========================
        // 1. 插入字符串
        // =========================
        trie.insert("abc");
        trie.insert("ab");
        trie.insert("bc");
        trie.insert("bck");
        System.out.println("====== 插入后 ======");
        // =========================
        // 2. search测试
        // =========================
        System.out.println("abc出现次数:" + trie.search("abc"));
        System.out.println("ab出现次数:" + trie.search("ab"));
        System.out.println("bc出现次数:" + trie.search("bc"));
        System.out.println("bck出现次数:" + trie.search("bck"));
        System.out.println("a出现次数:" + trie.search("a"));
        // =========================
        // 3. prefix测试
        // =========================
        System.out.println();
        System.out.println("====== 前缀查询 ======");
        System.out.println("以ab开头:" + trie.prefixNumber("ab"));
        System.out.println("以b开头:" + trie.prefixNumber("b"));
        System.out.println("以bc开头:" + trie.prefixNumber("bc"));
        // =========================
        // 4. 普通delete测试
        // =========================
        System.out.println();
        System.out.println("====== delete(\"ab\") ======");
        trie.delete("ab");
        System.out.println("ab出现次数:" + trie.search("ab"));
        System.out.println("abc出现次数:" + trie.search("abc"));
        System.out.println("以ab开头:" + trie.prefixNumber("ab"));
        // =========================
        // 5. deleteCPP测试
        // =========================
        System.out.println();
        System.out.println("====== deleteCPP(\"bck\") ======");
        trie.deleteCPP("bck");
        System.out.println("bck出现次数:" + trie.search("bck"));
        System.out.println("bc出现次数:" + trie.search("bc"));
        System.out.println("以bc开头:" + trie.prefixNumber("bc"));
        // =========================
        // 6. 重复字符串测试
        // =========================
        System.out.println();
        System.out.println("====== 重复字符串测试 ======");
        trie.insert("abc");
        trie.insert("abc");
        System.out.println("abc出现次数:" + trie.search("abc"));
        System.out.println("以abc开头:" + trie.prefixNumber("abc"));
        trie.delete("abc");
        System.out.println("删除一次abc后:");
        System.out.println("abc出现次数:" + trie.search("abc"));
    }
}
运行结果:
====== 插入后 ======
abc出现次数:1
ab出现次数:1
bc出现次数:1
bck出现次数:1
a出现次数:0

====== 前缀查询 ======
以ab开头:2
以b开头:2
以bc开头:2

====== delete("ab") ======
ab出现次数:0
abc出现次数:1
以ab开头:1

====== deleteCPP("bck") ======
bck出现次数:0
bc出现次数:1
以bc开头:1

====== 重复字符串测试 ======
abc出现次数:3
以abc开头:3
删除一次abc后:
abc出现次数:2
示例题目:
一个字符串类型的数组arr1,另一个字符串类型的数组arr2。arr2中有哪些字符,是arr1中出现的?请打印。arr2中有哪些字符,是作为arr1中某个字符串前缀出现的?请打印。arr2中有哪些字符,是作为arr1中某个字符串前缀出现的?请打印arr2中出现次数最大的前缀。
2.前缀树的时间复杂度
我们设定:
N:字符串数量
L:当前操作字符串的长度
P:查询前缀的长度
S:所有字符串字符总数
M:Trie实际创建的节点数,M <= S
| 操作 | Trie 前缀树 | HashSet / HashMap | 数组 / ArrayList 暴力 |
|---|---|---|---|
| 插入长度为 L 的字符串 | O(L) | 平均 O(L) | 尾部添加 O(1) |
| 精确查询字符串 | O(L) | 平均 O(L) | O(N·L) |
| 删除字符串 | O(L) | 平均 O(L) | O(N·L) |
| 判断某前缀是否存在 | O(P) | 通常 O(N·P) | O(N·P) |
| 统计以某前缀开头的字符串数量 | O(P) | 通常 O(N·P) | O(N·P) |
| 统计某字符串出现次数 | O(L) | 平均 O(L) | O(N·L) |
可见,在判断前缀和前缀数量问题上,前缀树的优势很大。
(二)贪心算法
在某一个标准下,优先考虑最满足标准的样本,最后考虑最不满足标准的样本,最终得到一个答案的算法,叫作贪心算法。
也就是说,不从整体最优上加以考虑,所做出的是在某种意义上的局部最优解。
局部最优 -?-> 整体最优
从一个题目引入:
1.会议问题
一些项目要占用一个会议室宣讲,会议室不能同时容纳两个项目的宣讲。给你每一个项目开始的时间和结束的时间(给你一个数组,里面是一个个具体的项目),你来安排宣讲的日程,要求会议室进行的宣讲的场次最多。返回这个最多的宣讲场次。
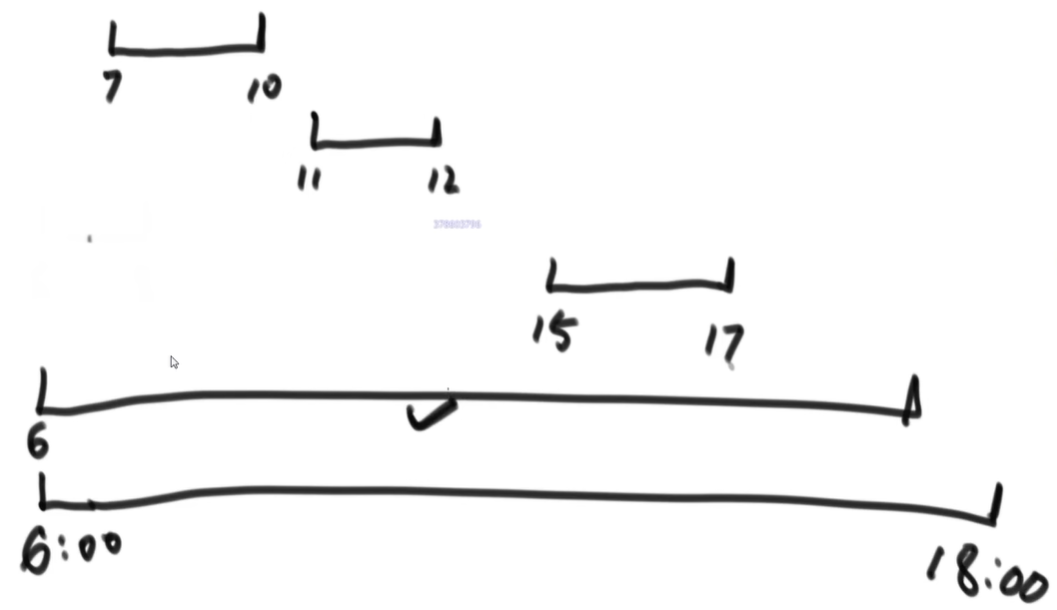
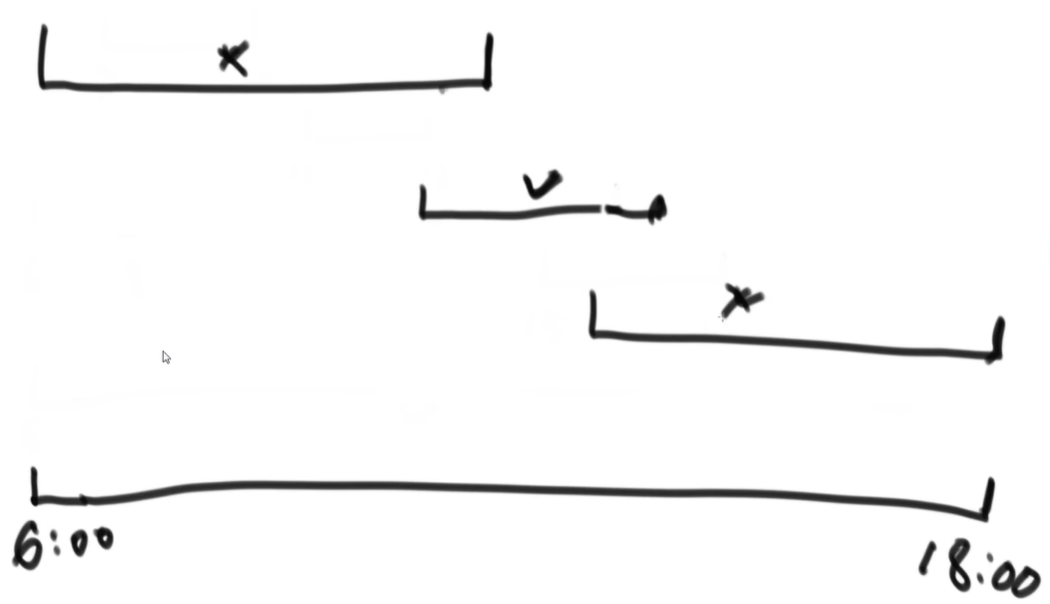
分析:如果采用谁开始得早就安排谁的方法,耗时长且开始早的项目会占用其它项目的时间,导致全局最差;如果按照每个项目持续时间短来安排,有可能会发生某个短项目会占用两个长项目的中间时间,无法安排长项目。这两种方法的短板如图所示:
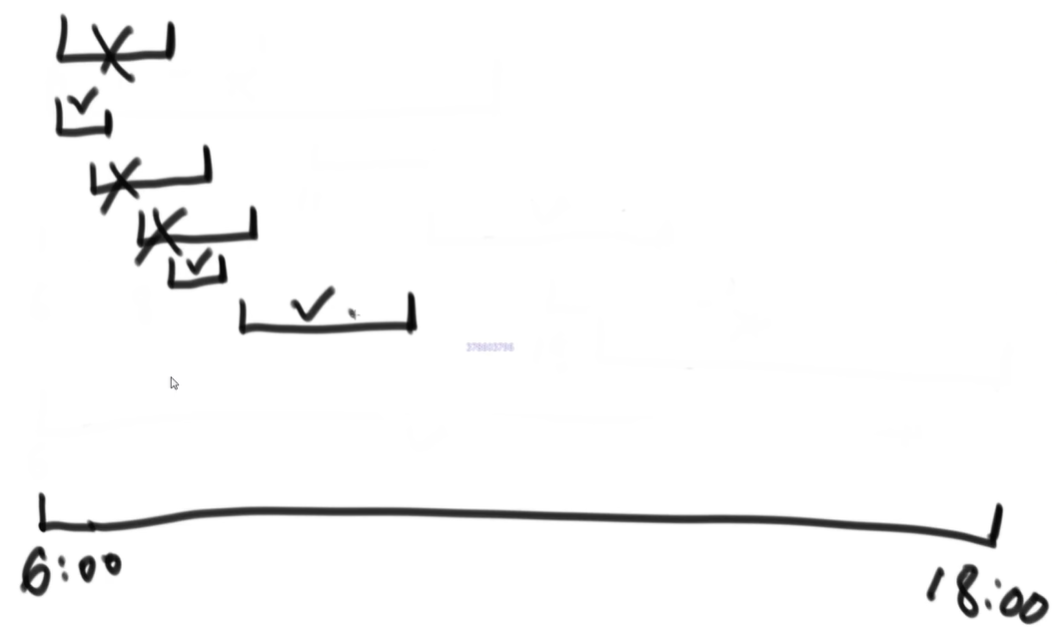
那么最好的安排方法是什么?我们规定哪一个会议结束时间最早,就安排谁,安排之后,把不能安排的会议删除掉;剩下的会议再以时间早的先安排,然后把不能安排的会议删除掉。以此类推。核心原因是保证每次都有最长剩余时间。
代码:
package class007;
import java.util.Arrays;
import java.util.Comparator;

public class Code_BestArrange {
    public static class Program{
        public int start;
        public int end;
        public Program(int start,int end){
            this.start=start;
            this.end=end;
        }
    }
    public static class ProgramComparator implements Comparator<Program>{
        @Override
        public int compare(Program o1,Program o2){
            return o1.end-o2.end;
        }
    }
    //所有项目,所有会议的时间点
    public static int bestArrange(Program[] programs,int timePoint){
        //把项目根据结束时间早进行排序
        Arrays.sort(programs,new ProgramComparator());
        int result=0;
        //从左往右依次遍历所有的会议
        for (int i=0;i<programs.length;i++){
            //现在的时间点,有没有早于当前会议的开始时间
            if(timePoint<=programs[i].start){
                //如果有,就安排这个会议
                result++;
                //时间点来到这个会议结束的时候
                timePoint=programs[i].end;
            }
        }
        return result;
    }
    public static void main(String[] args) {
        /*
         * 会议室可使用时间:
         *
         * 6:00 - 18:00
         *
         * 项目:
         *
         * 6:00  - 8:00
         * 6:00  - 9:00
         * 7:00  - 10:00
         * 8:00  - 9:00
         * 9:00  - 10:00
         * 9:00  - 11:00
         * 10:00 - 12:00
         * 11:00 - 13:00
         * 12:00 - 14:00
         * 13:00 - 15:00
         * 14:00 - 16:00
         * 15:00 - 17:00
         * 16:00 - 18:00
         *
         * 按照“结束时间最早”安排:
         *
         * 6-8
         * 8-9
         * 9-10
         * 10-12
         * 12-14
         * 14-16
         * 16-18
         *
         * 最多安排:
         *
         * 7 场
         */
        Program[] programs = {
                new Program(6, 8),
                new Program(6, 9),
                new Program(7, 10),
                new Program(8, 9),
                new Program(9, 10),
                new Program(9, 11),
                new Program(10, 12),
                new Program(11, 13),
                new Program(12, 14),
                new Program(13, 15),
                new Program(14, 16),
                new Program(15, 17),
                new Program(16, 18)
        };
        int timePoint = 6;
        int result = bestArrange(programs, timePoint);
        System.out.println("最多可以安排的会议场数:" + result);
    }
}
运行结果:
最多可以安排的会议场数:7
2.贪心算法的解题套路
1,实现一个不依靠贪心策略的解法X,可以用最暴力的尝试
2,脑补出贪心策略A、贪心策略B、贪心策略C...
3,用解法X和对数器,去验证每一个贪心策略,用实验的方式得知哪个贪心策略正确
4,不要去纠结贪心策略的证明
这里不做证明,只举例分析:
(1)单词的字典序。
对于同样长度的单词,字母序列在字母表中的顺序更前的单词,则字典序低,放在前面。比如abc<bck。对于不同长度的单词,将短单词用0补成和长单词一样长,依次比较高位和低位。比如b和apple,在b后面补全0000,发现b0000>apple。
对于[bk,att,cs],要把这些单词拼接成一个字典序最低的字符串,应该怎么拼接?
第一种贪心方法,按照首字母字典序拼接成“atbkcs”,但它不能保证每一次字典序最低。例如[b,ba],按照第一种方法,拼接起来是“bba”,但最好的结果是“bab”,显然这种方法不行。这种方法的策略是直接比较a和b的大小,a<=?b,是则输出a,否则输出b。
第二种贪心策略,利用比较器。设置比较器,将a和b投入比较器,比较a and b<=?b and a,如果满足,则把a排在前面,否则把b排在前面。第二种方法的代码:
package class007;

import java.util.Arrays;
import java.util.Comparator;

public class Code_LowestLexicography {
    public static class MyComparator implements Comparator<String> {
        @Override
        public int compare(String a,String b){
            return (a+b).compareTo(b+a);
        }
    }
    public static String lowestString(String[] strs){
        if (strs==null||strs.length==0){
            return "";
        }
        Arrays.sort(strs,new MyComparator());
        String res="";
        for (int i=0;i<strs.length;i++){
            res +=strs[i];
        }
        return res;
    }
    public static void main(String [] args){
        String[] strs1={"jibw","ji","jp","bw","jibw"};
        System.out.println(lowestString(strs1));
        String[] strs2={"ba","b"};
        System.out.println(lowestString(strs2));
    }
}
运行结果:
bwjibwjibwjijp
bab
核心思想:证明比较策略有传递性。例如:已知a and b<=b and a,b and c<= c and b,(a.b<=b.a,b.c<=c.b)如果能够证明a and c<=c and a,(a.c<=c.a)则说明有传递性。
对于字符串的字典序比较。我们可以把字符串认为是一种k进制数。str->k进制数,对于“abc”和“de”,由于“abc”的字典序比较小,将两个字符串合并后变成“abcde”,对于十进制来说,“abc”的位提升了两位,那么“abcde”可以写成“abc”*k^2+"de",将拼接运算变成了数学运算。
一般的,str a 拼接 str b,即"a.b",可以写成a*k^(b长度)+b,我们把k^(b长度)=m(b),m(b)是向左位移b个长度单位。那么,之前的a.b<=b.a,b.c<=c.b,可以改写成a*m(b)+b<=b*m(a)+a,b*m(c)<=c*m(b)+b。
接下来对两个不等式进行运算,对于第一个不等式,a*m(b)<=b*m(a)+a-b,两边再同时乘上c,则a*m(b)*c<=(b*m(a)+a-b)*c=b*m(a)*c+a*c-b*c;对于第二个不等式,b*m(c)*a+c*a-b*a<=c*m(b)*a。
由于乘法交换律,a*m(b)*c=c*m(b)*a,于是b*m(c)*a+c*a-b*a<=b*m(a)*c+a*c-b*c,得到m(c)*a-a<=m(a)*c-c,进一步得到,m(c)*a+c<=m(a)*c+a,于是a.c<=c.a得证。
但现在我们只证明了字典序的传递性,但没有证明为什么按照这样的顺序拼接有最小的字典序,下面我们来证明。
我们不妨设我们按照之前的方法得到了一组最小的字典序的序列[......a......b.....],a和b是任意两个字符串(a前b后)现在把a和b交换顺序,序列变成[......b......a.....],要证明字典序上升了。
情况1,a和b临近,[......ab.....],[......ba.....],由a.b<=b.a,证毕;
情况2,a和b不相邻,[......a,m1,m2,b.....],[......b,m1,m2,a.....],我们可以利用传递性,
则,[......a,m1,m2,b.....]<=[......m1,a,m2,b.....]<=[......m1,m2,a,b.....]<=[......m1,m2,b,a.....],接着保持a不变,把b往前交换,[......m1,m2,b,a.....]<=[......m1,b,m2,a.....]<=[......b,m1,m2,a.....],两个间隔交换的证明完了,接着可以用数学归纳法得到任意k个之间交换之间也成立,进而证明贪心策略成立。
可见数学方法证明贪心策略较难,实践中常用对数器。
贪心策略在实现时,经常使用到的技巧:
1,根据某标准建立一个比较器来排序
2,根据某标准建立一个比较器来组成堆
3.分金条问题
一块金条切成两半,是需要花费和长度数值一样的铜板的。比如长度为20的金条,不管切成长度多大的两半,都要花费20个铜板。
一群人想整分整块金条,怎么分最省铜板?
例如,给定数组[10,20,30],代表一共三个人,整块金条长度为10+20+30=60。
金条要分成10,20,30三个部分。
如果先把长度60的金条分成10和50,花费60;
再把长度50的金条分成20和30,花费50;一共花费110铜板。
但是如果先把长度60的金条分成30和30,花费60;再把长度30金条分成10和20,花费30;一共花费90铜板。
输入一个数组,返回分割的最小代价。
思路:这是一个哈夫曼编码问题,可以用小根堆解决,证明略。哈夫曼树的证明见王道数据结构视频。
代码:
package class007;

import java.util.Comparator;
import java.util.PriorityQueue;

public class Code_LessMoneySplitGold {
    public static int lessMoney(int[] arr){//所有数字
        //准备小根堆
        PriorityQueue<Integer> pQ=new PriorityQueue<>();
        for (int i=0;i<arr.length;i++){
            //所有数字扔进小根堆
            pQ.add(arr[i]);
        }
        int sum=0;
        int cur=0;
        while (pQ.size()>1){
            //每一次小根堆里面弹出两个数字,结合一下
            cur=pQ.poll()+pQ.poll();
            //累加到总代价上去
            sum+=cur;
            //再把结合后的数字仍回小根堆
            pQ.add(cur);
        }
        //当小根堆中只剩一个数时会跳出循环,返回沿途所有代价
        return sum;
    }
    public static class ProgramComparator implements Comparator<Integer> {
        @Override
        public int compare( Integer o1,  Integer o2){
            return o1-o2;
        }
    }
    public static void main(String[] args) {
        // =========================
        // 测试1
        // =========================
        int[] arr1 = {10, 20, 30};
        System.out.println("测试1最小代价:" + lessMoney(arr1));
        // 期望:90
        // =========================
        // 测试2
        // =========================
        int[] arr2 = {10, 20, 30, 40};
        System.out.println("测试2最小代价:" + lessMoney(arr2));
        // 期望:190
        // =========================
        // 测试3
        // =========================
        int[] arr3 = {6, 7, 8, 9};
        System.out.println("测试3最小代价:" + lessMoney(arr3));
        // =========================
        // 测试4:只有一个人
        // 不需要切
        // =========================
        int[] arr4 = {20};
        System.out.println("测试4最小代价:" + lessMoney(arr4));
        // 期望:0
    }
}
运行结果:
测试1最小代价:90
测试2最小代价:190
测试3最小代价:60
测试4最小代价:0
4.项目收益问题
输入:
正数数组costs
正数数组profits
正数k
正数m
含义:
costs[i]表示i号项目的花费
profits[i]表示i号项目在扣除花费之后还能挣到的钱(利润)
k表示你只能串行的最多做k个项目
m表示你初始的资金
说明:
你每做完一个项目,马上获得的收益,可以支持你去做下一个项目。
输出:
你最后获得的最大钱数。
思路,可以设计一个小根堆和大根堆来解决。
举例;项目组(1,1),(1,4),(2,3),(2,7),(3,2)(4,10),m=1,k=4。先按照项目的花费排一个小根堆(1,1),(1,4),(2,3),(2,7),(3,2)(4,10),命名为锁住的项目,另外设置一个按照利润组织的大根堆,用于收集哪些从小根堆弹出的满足本金小于等于花费的项目,命名为解锁的项目。
| 顺序 | m,k | 小根堆 | 大根堆 | 弹出 | 已做项目组 |
| 0 | 1,4 | (1,1),(1,4),(2,3),(2,7),(3,2),(4,10) | |||
| 1 | 1,4 | (2,3),(2,7),(3,2),(4,10) | (1,4),(1,1) | (1,4) | |
| 2 | 5,4 | (2,3),(2,7),(3,2)(4,10) | (1,1) | (1,4) | |
| 3 | 5,4 |
(4,10),(2,7),(2,3),(3,2),(1,1) | (4,10) | (1,4) | |
| 4 | 15,4 | (2,7),(2,3),(3,2),(1,1) | (1,4)(4,10) | ||
| 5 | 15,4 | (2,7),(2,3),(3,2),(1,1) | (2,7) | (1,4)(4,10) | |
| 6 | 22,4 | (2,3),(3,2),(1,1) | (1,4)(4,10)(2,7) | ||
| 7 | 22,4 | (2,3),(3,2),(1,1) | (2,3) | (1,4)(4,10)(2,7) | |
| 8 | 25,4 | (3,2),(1,1) | (1,4)(4,10)(2,7)(2,3) |
代码:
package class007;

import java.util.Comparator;
import java.util.PriorityQueue;

public class Code_IPO {
    public static class Node{
        public int p;
        public int c;
        public Node(int p,int c){
            this.p=p;
            this.c=c;
        }
    }
    //小根堆比较器,按照花费
    public static class MinCostComparator implements Comparator<Node>{
        @Override
        public int compare(Node o1,Node o2){
            return o1.c-o2.c;
        }
    }
    //大根堆比较器,按照利润
    public static class MaxProfitComparator implements Comparator<Node>{
        @Override
        public int compare(Node o1,Node o2){
            return o2.p-o1.p;
        }
    }
    public static int findMaximizedCapital(int k,int W,int[] Profits,int[] Capital){
        PriorityQueue<Node>minCostQ=new PriorityQueue<>(new MinCostComparator());
        PriorityQueue<Node>maxProfitQ=new PriorityQueue<>(new MaxProfitComparator());
        //所有项目扔到被锁池中,花费组织的小根堆
        for (int i=0;i<Profits.length;i++){
            minCostQ.add(new Node(Profits[i],Capital[i]));
        }
        for (int i=0;i<k;i++){//进行K轮
            //能力所及的项目,全解锁
            while (!minCostQ.isEmpty()&&minCostQ.peek().c<=W){
                maxProfitQ.add(minCostQ.poll());
            }
            if(maxProfitQ.isEmpty()){
                return W;
            }
            W+=maxProfitQ.poll().p;
        }
        return W;
    }
    public static void main(String[] args) {
        /*
         * 项目:
         *
         * (cost, profit)
         *
         * (1,1)
         * (1,4)
         * (2,3)
         * (2,7)
         * (3,2)
         * (4,10)
         *
         * 初始资金:
         * W = 1
         *
         * 最多做:
         * k = 4
         */
        int[] Capital = {1, 1, 2, 2, 3, 4};
        int[] Profits = {1, 4, 3, 7, 2, 10};
        int k = 4;
        int W = 1;
        int result = findMaximizedCapital(k, W, Profits, Capital);
        System.out.println("最终最大资金:" + result);
    }
}
运行结果:
最终最大资金:25
5.数据流的中位数
一个数据流中,随时可以取得中位数。也就是源源不断地给数字,要求不断得到这些数字的中位数,时间要快。(leetcode295)
思路:设立一个大根堆和一个小根堆解决。(1)用户的第一个数字进入大根堆;(2)第二个数字进入时,判断当前数字是否小于大根堆的堆顶,如果是,当前数字入大根堆,如果不是,当前数字入小根堆;(3)判断大根堆和小根堆的大小,如果两个堆的size之差达到2,则size较大的那个弹出堆顶元素加入size较小的那个堆中去。
示例:5,3,7,4依次输入:
| 顺序 | 输入元素 | 大于大根堆顶? | dsize>2? | 调整元素 | 大根堆 | 小根堆 | 中位数 |
| 0 | |||||||
| 1 | 5 | 5 | |||||
| 2 | 3 | 5,3 | |||||
| 3 | y | 5 | 3 | 5 | |||
| 4 | 7 | y | 3 | 5.7 | |||
| 5 | 4 | 3 | 4,5,7 | ||||
| 6 | y | 4 | 4,3 | 5,7 | 4.5(偶数) |
如此,依靠小根堆的堆顶和大根堆的堆顶就可以得到中位数。
代码:
package class007;

import java.util.Collections;
import java.util.PriorityQueue;

public class Code_MedianFinder {
    public static class MedianFinder{
        //大根堆:保存较小的一半数字
        private PriorityQueue<Integer>maxHeap;
        //小根堆,保存较大的一半数字
        private PriorityQueue<Integer>minHeap;
        public MedianFinder(){
            //大根堆
            maxHeap=new PriorityQueue<>(Collections.reverseOrder());
            //小根堆
            minHeap=new PriorityQueue<>();
        }
        //加入一个新的数字
        public void addNum(int num){
            /*
            * 1.决定num进入哪个堆
            * 如果大根堆为空
            * 或者num<=大根堆堆顶,
            * 放入大根堆
            * */
            if(maxHeap.isEmpty()||num<=maxHeap.peek()){
                maxHeap.add(num);
            }else {
                minHeap.add(num);
            }
            /*
            * 2.调整两个堆的大小
            * 两个堆的size差不能超过1
            * */
            if(maxHeap.size()-minHeap.size()==2){
                minHeap.add(maxHeap.poll());
            }else if (minHeap.size()-maxHeap.size()==2){
                maxHeap.add(minHeap.poll());
            }
        }
        //返回当前中位数
        public double findMedian(){
            int maxSize=maxHeap.size();
            int minSize=minHeap.size();
            /*
            * 总个数为偶数
            * 两个堆数量相同
            * 中位数=两个堆顶平均值
            */
            if(maxSize==minSize){
                return ((long)maxHeap.peek()+minHeap.peek())/2.0;
            }
            /**总个数是奇数,
             * 哪个堆元素更多
             * 哪个堆的堆顶就是中位数
             */
            return maxSize>minSize?maxHeap.peek():minHeap.peek();
        }
        public static void main(String[] args) {
            MedianFinder finder = new MedianFinder();
            finder.addNum(5);
            System.out.println("加入5,中位数:" + finder.findMedian());
            finder.addNum(3);
            System.out.println("加入3,中位数:" + finder.findMedian());
            finder.addNum(7);
            System.out.println("加入7,中位数:" + finder.findMedian());
            finder.addNum(4);
            System.out.println("加入4,中位数:" + finder.findMedian());
        }
    }
}
运行结果:
加入5,中位数:5.0
加入3,中位数:4.0
加入7,中位数:5.0
加入4,中位数:4.5
6.N皇后问题
N皇后问题是指在 N×N 的棋盘上要摆 N 个皇后,要求任何两个皇后不同行、不同列,也不在同一条斜线上。
给定一个整数 n,返回 n 皇后的摆法有多少种。
n=1,返回1。
n=2或3,2皇后和3皇后问题无论怎么摆都不行,返回0。
n=8,返回92。
分析:同列和同行可以直接比较,共斜线可以比较两个点的横纵坐标之差相等与否判断。
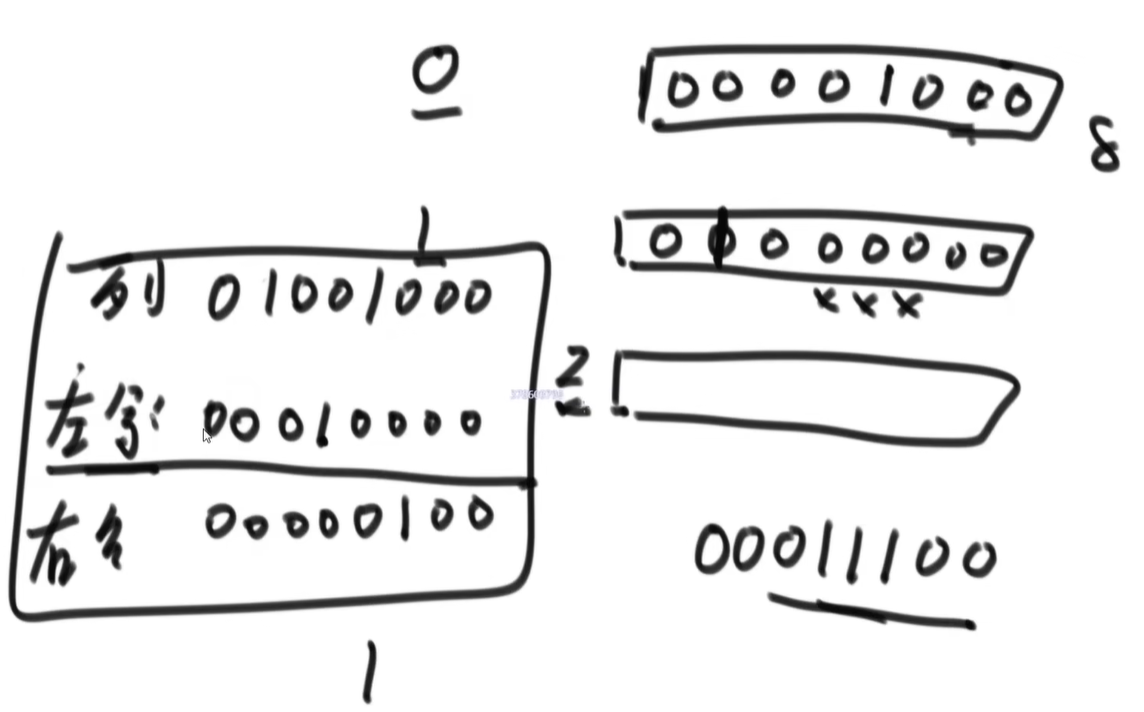
n皇后的时间复杂度为O(N^N),但我们可以对它进行常数级别的优化。对于斜线上的限制,左限制可以看作向左位移一位,右限制可以看成向右位移一位。
示例:
package class007;

public class Code_NQueens {
    public static int num1(int n){
        if (n<1){
            return 0;
        }
        int[] record=new int[n];//record[i]->i行的皇后,放在了第几列
        return process1(0,record,n);
    }
    //目前来到了第i行
    //record[0..i-1]表示之前的行,放了的皇后位置
    //n表示整体一共有多少行
    //返回值是,摆完所有的皇后,合理的摆法有多少种
    public static int process1(int i,int[] record,int n){
        if (i==n){//终止行
            return 1;
        }
        int res=0;
        for (int j=0;j<n;j++){//当前行在i行,尝试i行所有的列->j
            //当前i行的皇后,放在j列,会不会和之前(0..i-1)的皇后,共行共列或共斜线
            //如果是,认为无效
            //如果不是,认为有效
            if(isValid(record,i,j)){
                record[i]=j;
                res+=process1(i+1,record,n);
            }
        }
        return res;
    }
    //record[0..i-1]需要看,record[i..]不需要看
    //返回i行皇后,放在了j列,是否有效
    public static boolean isValid(int[] record,int i,int j){
        for (int k=0;k<i;k++){//之前的某个k行的皇后
            //列坐标减完后的绝对值等于行坐标减完后的绝对值,说明等于45度,共斜线
            if(j==record[k]||Math.abs(record[k]-j)==Math.abs(i-k)){
                return false;
            }
        }
        return true;
    }
    //n皇后问题尽量不要超过32
    public static int num2(int n){
        if(n<1||n>32){
            return 0;
        }
        //示例,如果是8皇后问题,申请一个末八位是1,前面都是0的数
        int limit =n==32?-1:(1<<n)-1;
        //开始的行的限制是没有的
        return process2(limit,0,0,0);
    }
    //colLim列的限制,1的位置不能放皇后,0的位置可以
    //liftDiaLim左斜线的限制,1的位置不能放皇后,0的位置可以
    //rightDiaLim右斜线的限制,1的位置不能放皇后,0的位置可以
    public static int process2(
            int limit,
            int colLim,
            int leftDiaLim,
            int rightDiaLim){
        //列的限制全满了
        if (colLim==limit){//base case
            return 1;
        }
        int pos=0;
        int mostRightOne=0;
        pos=limit&(~(colLim|leftDiaLim|rightDiaLim));
        int res=0;
        //while循环:
        //把当前行所有合法位置一个一个取出来,
        //每个位置都放一次皇后,
        //递归尝试下一行,
        //最后把所有方案数累加起来
        while (pos!=0){
            //把当前这一行所有可以放皇后的列,一个一个取出来,每个位置分别尝试一次递归。
            //提取出最右侧候选皇后的依赖(把一个二进制数中,最右侧的1提取出来)
            mostRightOne=pos&(~pos+1);
            pos=pos-mostRightOne;
            res+=process2(limit,colLim|mostRightOne,
                    (leftDiaLim|mostRightOne)<<1,
                    (rightDiaLim|mostRightOne)>>>1);
        }
        return res;
    }
    public static void main(String [] args){
        int n=14;
        //n皇后的优化对比
        System.out.println("n=14时,n皇后的优化对比");
        long start=System.currentTimeMillis();
        System.out.println(num2(n));
        long end=System.currentTimeMillis();
        System.out.println("位运算优化后,cost time:"+(end-start)+"ms");

        start=System.currentTimeMillis();
        System.out.println(num1(n));
        end=System.currentTimeMillis();
        System.out.println("不优化时,cost time:"+(end-start)+"ms");
    }
}
运行结果:
n=14时,n皇后的优化对比
365596
位运算优化后,cost time:141ms
365596
不优化时,cost time:2570ms
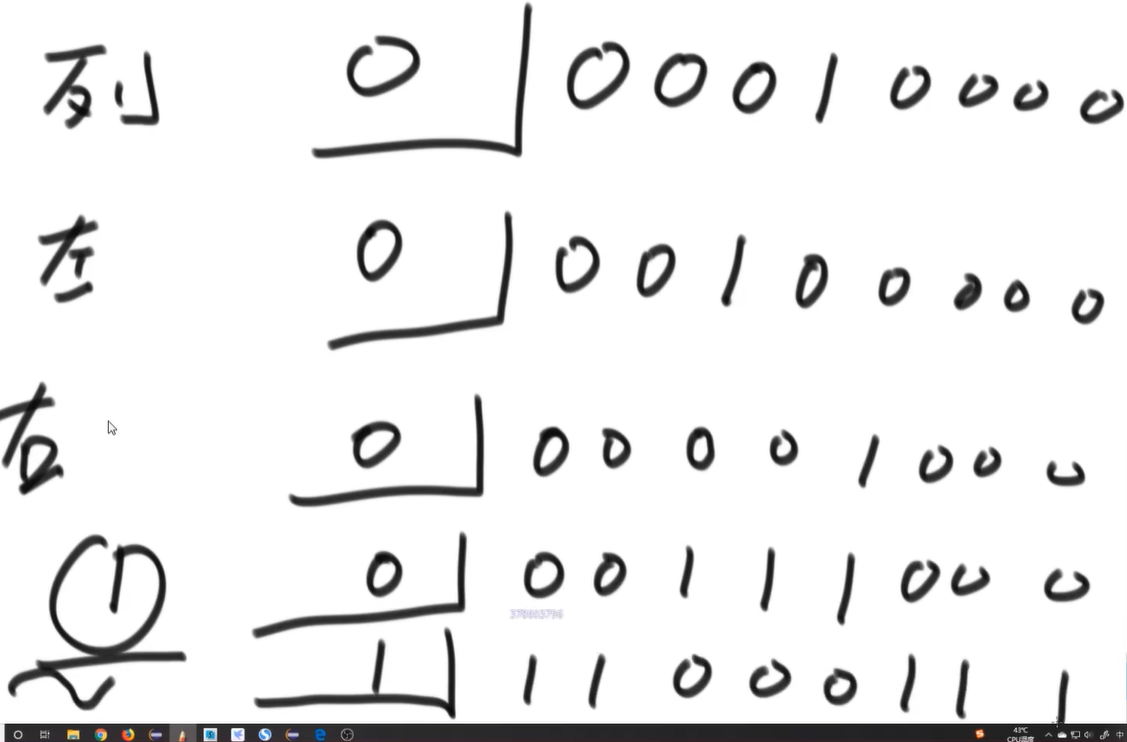
代码中的pos=limit&(~(colLim|leftDiaLim|rightDiaLim)),举例理解:
列限制(0|00010000)加左限制(0|00100000)加右限制(0|00001000)的与运算的结果(0|00111000),进行取反,得到一个数(1|11000111);再将它和limit(0|11111111)求与,就得到了能够选择皇后的位置。即,0| 11000111。采用limit的原因是与运算后,位数溢出后截取到n以内。
可以由以下图理解:
代码中的while (pos!=0)循环示例:
当前行:
pos = 00101100
        ↓
取最右侧1
00000100
        ↓
在这里放皇后
        ↓
递归下一行
        ↓
回来以后继续
pos = 00101000
        ↓
再取最右侧1
00001000
        ↓
递归下一行
        ↓
继续
pos = 00100000
        ↓
取最后一个1
00100000
        ↓
递归下一行
        ↓
pos = 00000000
        ↓
当前行所有可能都尝试完
while结束

 376


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


