【入门教程】GraphRAG 结构化检索增强生成 :从原理到实战

【大模型】检索增强生成:从RAG、GraphRAG到LightRAG 自 ChatGPT 发布以来,大型语言模型(Large Language Model,LLM,大模型)得到了飞速发展,它在处理复杂任务、增强自然语言理解和生成类人文本等方面的能力让人惊叹,几乎各行各业均可从中获益。为了解决以上通用大模型问题,方案就应运而生。 阅读详情

在这里插入图片描述

1. 什么是 GraphRAG?

GraphRAG 是一种结构化的、分层的检索增强生成(Retrieval-Augmented Generation,简称 RAG)方法

  • 和传统的 RAG 不同,GraphRAG 不仅仅依赖文本相似度搜索,而是先把文本转成 知识图谱(-Knowledge Graph),再基于图谱结构来检索和生成答案。
  • 【回答质量高,但 token 消耗大、生成时间久,所以使用代价较高,个人部署不建议 ~~~ 】

简单来说:

  • 传统 RAG:找到和问题最像的文本片段 → 直接生成答案。
  • GraphRAG:先提取实体和关系 → 构建知识图谱 → 检索更精准的信息 → 生成更丰富的答案。

这样做的好处是:

  • 更好地处理跨文档、多跳推理的问题。
  • 能发现信息之间的隐含联系,而不仅是关键词匹配。

2. GraphRAG 原理
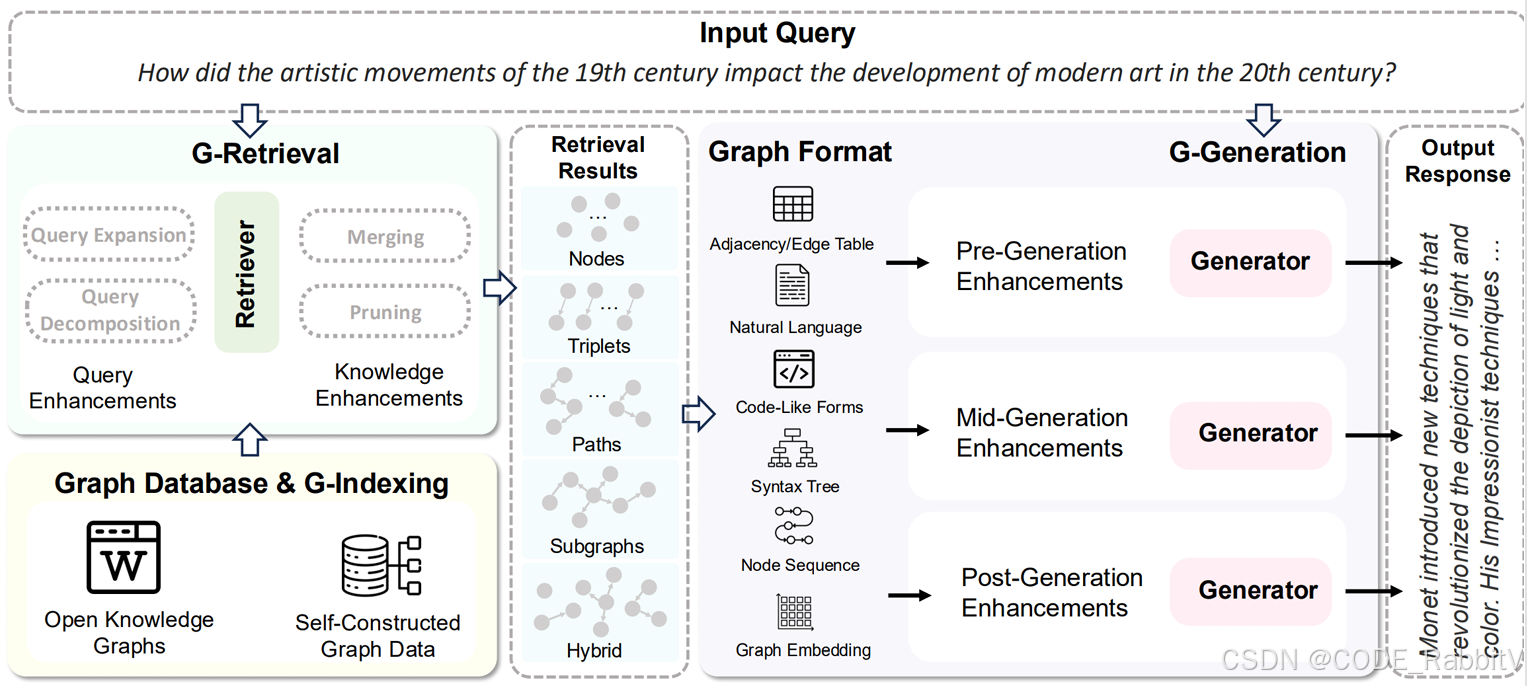
在这里插入图片描述

GraphRAG 核心思想:

  1. 从原始文本中提取知识图谱
    • 节点(实体)+ 边(关系)
  2. 构建社区层级(Community Levels)
    • 发现信息的群体结构,比如哪些实体属于同一主题、组织或地理位置。
  3. 为这些社区生成摘要
    • 让模型理解某个社区的整体背景。
  4. 结合 RAG 任务执行问答
    • 通过图谱检索找到最相关的信息,再生成答案。

类比一下:传统 RAG 是“在书里找几段相关的句子”,GraphRAG 是“先画一张信息关系图,再从图上找到最优路径来回答问题”。


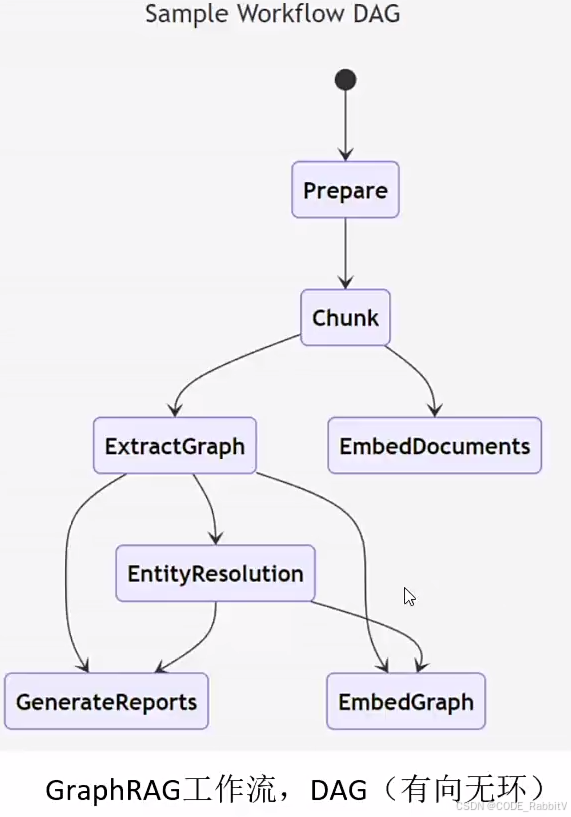
3. GraphRAG 的流程

GraphRAG 的整体流程可以分为两大部分:索引阶段 和 查询阶段。
在这里插入图片描述

3.1 索引阶段(Indexing)

  1. 切分文本: 把大文本库切成可处理的小单元(TextUnits)。
  2. 提取实体、关系和关键声明:用 LLM 从文本中抽取人物、地点、事件等实体及它们之间的关系。
  3. 构建知识图谱:节点是实体,边是关系。
  4. 社区检测与聚类:用 Leiden 等算法将图谱分成若干社区。
  5. 生成社区摘要:用 LLM 总结社区关键信息。
  6. 存储到图数据库:方便后续高效检索。

3.2 查询阶段(Querying)

  1. 解析用户问题:分解查询、识别涉及的实体。
  2. 全局检索:从社区摘要中获取整体背景。
  3. 局部检索:深入邻居节点和相关关系,获取细节。
  4. 生成答案:将检索结果交给 LLM,生成自然语言回答。

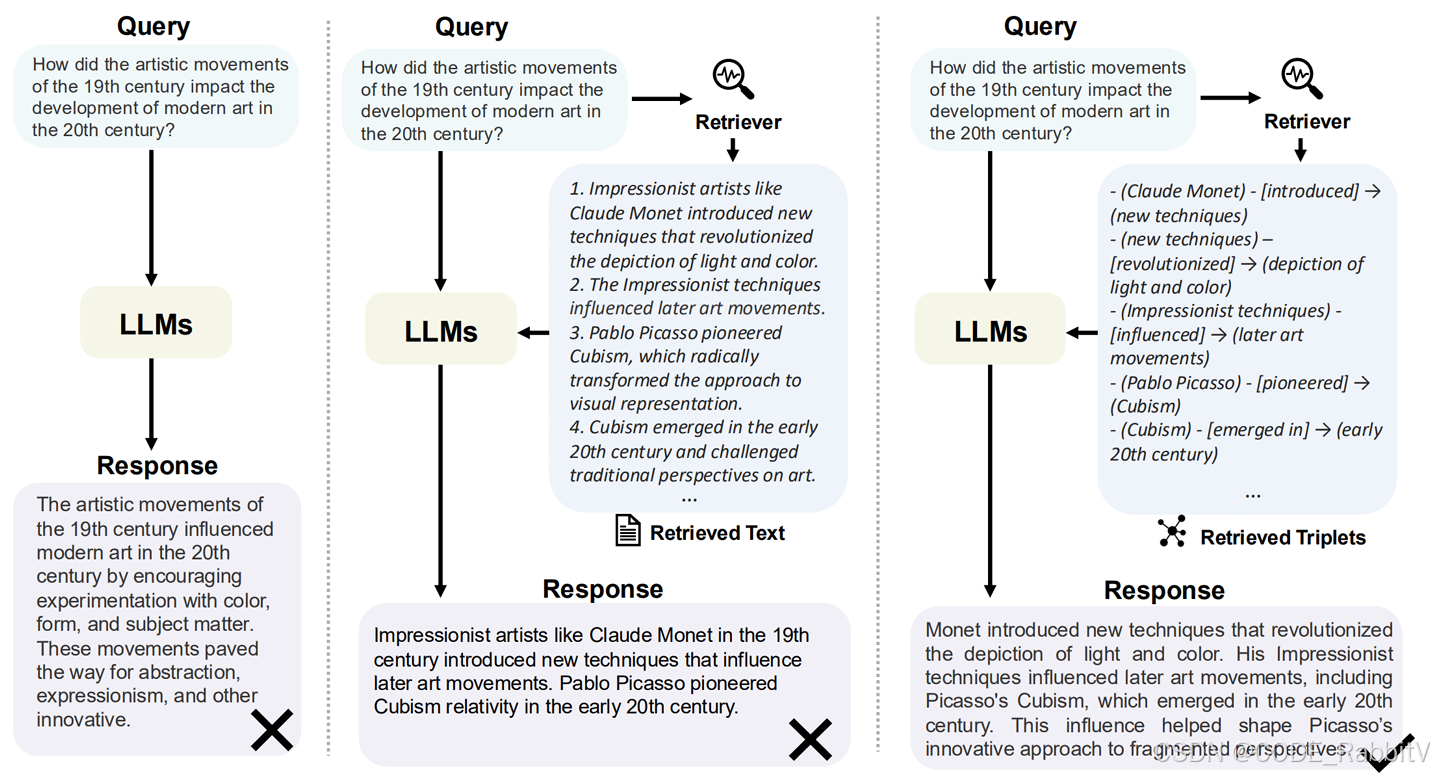
4. 示例对比

在这里插入图片描述

假设问题是:

“Query:19世纪的艺术运动是如何影响20世纪现代艺术的发展的?”

  • 传统 LLM 直接回答:

    “19 世纪的艺术运动通过鼓励对色彩、形式和主题的实验,影响了 20 世纪的现代艺术……”

    笼统,没有细节链路!

  • 普通 RAG 回答(检索文本片段):

    检索:1. 像克劳德·莫奈这样的印象派艺术家引入了新技术,彻底改变了对光和颜色的描绘。2. 印象派的技法影响了后来的 …
    回答:莫奈引入新技术,改变了光和色彩的描绘;印象派影响了后来的艺术运动;毕加索开创立体主义……

    回答依旧可能割裂!

  • GraphRAG 回答(基于知识图谱):

    检索:(莫奈)- [引进] →(新技术)- [革新] →(光和颜色的描绘)…
    回答:“莫奈引入的新技术彻底改变了光和色彩的描绘,他的印象派技巧影响了后来的艺术运动,包括 20 世纪初出现的毕加索立体主义。这种影响帮助塑造了毕加索对碎片化视角的创新方法。”

    优势:

    • 有因果链条(莫奈 → 新技术 → 印象派 → 立体主义)
    • 信息更连贯

5. 实战:如何跑 GraphRAG

官方代码地址:https://github.com/microsoft/graphrag

Step 1. 克隆代码

git clone https://github.com/microsoft/graphrag.git
cd graphrag

Step 2. 安装依赖、初始化 & 配置

pip install poetry
poetry install
poetry run poe index --init--root .
  • 正确运行后,此处会在 graphrag 目录下生成 output、prompts、.env、settings.yaml 文件
  • 之后需要对 .env 文件配置 GRAPHRAG_API_KEY、修改 settings.yaml 设置 model

Step 3. 准备数据,放到 ./input 目录下

  • 准备一个包含多篇文档的文本数据集(比如企业内部报告)
  • 格式可以是 .txt / .csv / .json

Step 4. 构建索引 (文本越长越久)

python -m graphrag.index --init

之后会看到类似如下的一些生成信息:

create_base_text_units
...

create base_extracted_entities
...

create_summarized_entities
...

create_base_entity_graph
...

create_final_entity 
...


create_final_communities
...
...
...

All workflows completed successfully.
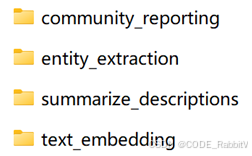
  • 正确运行后,会在 ./cache 文件夹下面生成4个文件夹,方便后续进行提问
    在这里插入图片描述

Step 5. 运行查询

python -m graphrag.query--root ./cases --method global "你的问题"  ## global 模式
  • local 答案生成(代价高):针对具体问题,GraphRAG通过结合元素和元素摘要生成初步答案,这些答案来源于GraphRAG中的特定社区;
  • global 答案生成 (代价非常高):对于需要涵盖整个数据集的全局性问题,GraphRAG采用Map-Reduce机制,将所有社区的初步答案组合起来。

6. 适用场景

GraphRAG 特别适合:

  • 跨文档问答:多个文档中信息关联的问题。
  • 多跳推理:需要从多个实体关系链推理出答案。
  • 知识管理:企业内部知识库、科研资料等。
  • 长文本总结:社区层级摘要可以提炼核心脉络。

7. 总结

GraphRAG 让 RAG 不再是“找最像的文本”,而是“基于关系图谱推理回答”。
它的关键价值在于:

  • 结构化信息 → 让知识更可检索、可推理。
  • 分层摘要 → 快速获得全局视野与细节。
  • 更适合复杂、跨域的问题。

如果你平时做的问答任务经常遇到:

  • 回答内容碎片化、不连贯
  • 模型找不到跨文档的关键信息

那 GraphRAG 值得你尝试。

基于图的检索增强生成(GraphRAG)概述 GraphRAG 通过结合图数据和 RAG 方法,为复杂的信息检索和生成任务提供了新的解决方案。未来的研究应关注如何提高其可扩展性、提高检索效率,并探索更丰富的应用场景。 阅读详情

相关推荐

GraphRAG源码解读:基于知识图谱构建的检索增强生成系统

讨论代码前, 我们先简单了解下 GraphRAG 项目的目标与定位. 在论文中, 作者很明确地提出了一个常规 RAG 无法处理的应用场景:也就是类似该数据集的主题是什么这种 high level 的总结性问题。作者认为, 这种应用场景本质上是一种聚焦于查询的总结性(QueryFocused Summarization, QFS)任务, 单纯只做数据检索是无法解决的.。相应地, 其解决思路也在论文中清楚地描述出来了:

2401_85377976的博客 1889

微软开源GraphRAG的使用教程(最全,非常详细)

目前微软已经开源了GraphRAG的完整项目代码。对于某一些LLM的下游任务则可以使用GraphRAG去增强自己业务的RAG的表现。项目给出了两种使用方式: 1. 在打包好的项目状态下运行,可进行尝试使用。 2. 在源码基础上运行,适合为了下游任务的微调时使用。

科研探索ing!研究方向:人工智能及优化 5万+

基于langchain实现GraphRAG:基于图结构的检索增强生成系统

基于LangChain框架构建的GraphRAG,通过FAISS向量库、LLMChainExtractor和PromptTemplate等组件实现文档分块、知识图谱构建与智能检索。系统采用Dijkstra算法遍历图谱节点,结合ChatOpenAI生成答案,并通过可视化工具展示推理路径。测试表明,它能准确回答"气候变化主因"等复杂问题,且推理过程完全透明,显著提升了RAG系统的上下文理解能力。

AI人工智能的学习之路 1580

全网首发!GraphRAG知识图谱全流程解析,小白也能轻松读懂

当GraphRAG完成索引过程后,它默认会将构建知识图谱所需的所有数据持久化。这些数据被存储在输出目录中,并采用Parquet文件格式。Parquet是一种列式压缩存储格式,专为高效的数据存储和分析而设计。你可以将其视为DataFrame的一种持久化方式。在查询阶段,这些Parquet文件会被加载到内存和向量数据库中。这样做的好处在于,我们可以直接从内存和数据库中检索信息,而无需再次从原始数据源抽取和处理数据。这大大提高了查询的效率和速度。

2401_84495872的博客 1985

基于图的检索增强生成(GraphRAG)

随着研究者对图研究的深入,未来GraphRAG会是一个前沿的研究方向,里面还有很多挑战与机遇值得我们去解决,以更好地挖掘图的深层含义,更好的为大语言模型服务。2025年11月3日学习笔记文章同步更新在同名今日头条号“一的万次方”(GraphRAG)

qq_41009600的博客 580

数字锁相环的原理与FPGA实现

数字锁相环是锁相环电路的全数字实现。锁相环电路能够实现对输入信号的相位进行跟踪,进而在噪声中提取纯净的有用信号。以上就是今天要讲的内容,本文简单地介绍了锁相环的原理,然后,在Vivado仿真平台上,通过verilog做仿真验证。最终仿真结果能够实现锁定,但锁定时间较长,表明参数仍可做调整。

weixin_45857378的博客 8510

实战微软新一代RAG:GraphRAG(附教程)

本月初,微软发布最强 RAG知识库,开源方案 GraphRAG,项目上线即爆火,现在星标量已经达到 12.1 k。

AAI666666的博客 2441

DataWorks PyODPS第三方包全攻略:从打包到加载的完整流程

本文详细介绍了在DataWorks的PyODPS节点中使用第三方Python包的完整流程,包括环境限制、打包工具pyodps-pack的使用、资源上传与加载实战,以及特殊场景处理技巧。通过本文,开发者可以掌握在MaxCompute受限环境中灵活使用自定义依赖的方法,提升数据处理效率。

dd012的博客 991

微软开源GraphRAG的使用教程-使用自定义数据测试GraphRAG

这篇文章主要介绍了微软开源的GraphRAG的安装教程,并以《太白金星有点烦》为例,动手实操测试了下GraphRAG的实际效果。

luxinfeng的博客 2万+

海康视觉平台VisionMaster实战入门:从通讯配置到工具应用

本文为海康VisionMaster视觉平台实战入门指南,详细介绍了从软件安装准备、与PLC等外部设备的通讯配置,到匹配定位、测量、畸变矫正等核心工具的应用方法。通过实战案例拆解,帮助工程师快速掌握如何搭建完整的机器视觉检测与引导定位系统,实现工业自动化项目落地。

weixin_29224309的博客 1016

PowerBuilder 9.0安装组件全解析:Adaptive Server Anywhere、PowerDynamo、InfoMaker到底怎么选?

本文从技术架构师视角详细解析PowerBuilder 9.0安装组件选型策略,包括Adaptive Server Anywhere、PowerDynamo和InfoMaker的核心功能与应用场景。通过分析组件间的依赖关系和安装冲突机制,提供针对不同开发需求的最佳安装方案,帮助开发者高效配置PB9.0开发环境。

weixin_28700593的博客 441

手把手教你构建基于知识图谱的GraphRAG之结构化数据篇【LangChain+Neo4j】

检索增强生成(RAG)是一种利用外部知识来增强大模型生成能力减少幻觉的主流方法,而对知识最常见的一种组织与索引的形式是向量化及基于向量相近性的检索。但除此之外,基于Graph图结构的知识图谱也是一种强大的知识组织工具,在很多场景下它可以实现更有意义的上下文检索并帮助模型输出更加准确的响应内容。预备知识:GraphRAG基础在开始之前,我们先快速了解图(Graph)、图数据库(GraphDB)、知识图谱(Knowledge Graph)以及GraphRAG的基础知识。。

Python_cocola的博客 6138

RT-DETR改进策略【Neck】| GFPN 超越BiFPN 通过跳层连接和跨尺度连接改进RT-DETR颈部网络

本文记录的是利用颈部结构优化RT-DETR的目标检测网络模型。利用改进后的颈部网络,通过跳层连接,避免了在进行反向传播时的梯度消失问题,并且引入跨尺度连接,可以实现不同级别和层次的特征充分融合,获取足够的高层语义信息和低层空间信息交换,从而在大规模变化场景下提高检测性能。GIRAFFEDET: A HEAVY-NECK PARADIGM FOR OBJECT DETECTION-GFPN包含了上述的跳层连接(dense-link和log2nlog _{2} nlog2​n-link)以及跨尺度连接(Quee

Limiiiing的博客 2229

知识图谱检索增强的GraphRAG(基于Neo4j代码实现)

对一个查询问题分别进行了测试, 与没有RAG,仅利用LLM生成回复的情况进行对比,在有GraphRAG 的情况下,LLM模型回答的信息量更大、准确会更高。

2401_84206094的博客 6862

【图像拼接】源码精读:Parallax-Tolerant Unsupervised Deep Image Stitching(UDIS++)

注:Pytorch代码。【图像拼接论文精读】专栏对应文章【图像拼接】论文精读:Parallax-Tolerant Unsupervised Deep Image Stitching(UDIS++)配合对应的文章阅读,效果更佳!注:请重点关注代码段中的注释!!!有一些讲解的东西直接写在代码段的注释中了,同时多关注红色字体和绿色字体!!!我认为深度学习方法和传统方法有很多相似之处。比如:深度学习中的损失函数和传统方法中的对齐项、失真项等其实原理相同,只是求解方式不同。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 7274

在 ABAP Cloud 中玩转 CL_ABAP_PARALLEL 并行处理:从原理到实战

ABAP并行处理框架CL_ABAP_PARALLEL解析 本文系统介绍了SAP ABAP环境中实现并行处理的CL_ABAP_PARALLEL框架。该框架通过封装异步RFC和对话进程,为开发者提供了面向对象的API,显著提升大批量数据处理的效率。 文章首先分析了ABAP环境需要并行处理的原因:传统的串行处理在面对百万级数据时效率低下。然后详细介绍了CL_ABAP_PARALLEL的设计思路,它是一个"小型线程池"式的同步并行框架,适用于批量计算场景。此外,文章重点讲解了控制并行任务的关键参

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 341

基于图的检索增强生成(GraphRAG)

GraphRAG(Graph-based Retrieval-Augmented Generation,基于图的检索增强生成)是知识图谱(Knowledge Graph, KAG)领域的重要分支,通过将知识图谱的结构化关系与大语言模型(LLM)结合,显著提升复杂场景下的生成准确性和可解释性。GraphRAG通过知识图谱的结构化优势与大语言模型的生成能力互补,在复杂推理、多模态检索、可解释性等方面树立了新标杆。

weixin_43156294的博客 1838

单光子雪崩二极管(SPAD):原理、极高增益机制与微光探测解析

本文系统阐述了单光子雪崩二极管(SPAD)的工作原理及其在弱光探测中的应用。SPAD通过工作在盖革模式下的碰撞离化效应实现单光子探测,其核心机理包括:1)采用p+-n-n+结构实现高电场分布;2)通过雪崩倍增过程获得10^6量级增益;3)采用主动/被动淬灭机制实现快速恢复。文章详细分析了SPAD的关键性能参数(如光子探测效率、暗计数率等)及其在量子通信、激光雷达等领域的应用优势,揭示了该器件在极微弱光信号探测中的独特价值。

Fun_LiDAR的博客 1044

图检索增强生成(GraphRAG):让AI真正理解复杂知识

你是否曾经遇到过这样的情况:向ChatGPT提问专业问题时,它给出的答案看似合理,但实际上缺乏深度或存在事实错误?今天,我们将探索一项解决这一问题的前沿技术——图检索增强生成(GraphRAG),这项结合知识图谱与检索增强生成的创新方法正在彻底改变AI在专业领域的应用方式。

m0_59164304的博客 1225

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

GraphRAG:知识图谱赋能的检索增强生成

GraphRAG是RAG(检索增强生成)的升级版,利用知识图谱为LLM提供结构化知识网络。它通过节点(实体)和边(关系)构建知识连接,使AI不仅能检索信息,还能理解知识间的关联。相比传统RAG处理孤立文本,GraphRAG支持多跳推理,在医疗、金融、教育等领域展现更强推理能力,推动AI从信息检索迈向知识理解的新阶段。

1081

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

GraphRAG深度解析:从原理到实战,重塑RAG检索增强生成的未来

如何安全、高效、精准地与私域数据交互。私域数据(企业内部文档、医疗记录、金融报表等)具有高度的隐私性和专业性。虽然GPT-4等基座模型拥有海量的通识知识,但它们对企业内部的“暗知识”一无所知。直接将数据微调(Fine-tuning)面临成本高、更新慢、灾难性遗忘等问题。因此,上下文学习(In-Context Learning)成为主流——即把相关知识“喂”给模型。上下文窗口限制:虽然窗口越来越大,但仍无法一次性塞入TB级的企业数据库。不可控的“幻觉”:模型通过概率生成内容,本质上是不可控的。

2502_91999045的博客 1133

GraphRAG 综述:图结构如何重构检索增强生成的技术边界?

GraphRAG:突破传统RAG局限,专为图结构数据设计的检索增强生成框架

m0_68241160的博客 1977

GraphRAG:基于知识图谱的智能检索增强生成系统

本文深入探讨了GraphRAG系统的核心概念、技术原理和应用实践。GraphRAG是一种结构化的、分层次的检索增强生成(RAG)方法,通过构建知识图谱、社区层次结构和摘要,显著提升了语言模型对私有数据的理解和推理能力。文章将详细介绍GraphRAG的工作原理、核心组件、实现方法以及与传统RAG的对比,帮助开发者更好地理解和应用这一创新技术。mindmap核心特点结构化检索层次化处理知识图谱技术优势深度理解关联分析智能推理应用场景私有数据企业文档研究资料技术优势深度理解关联分析。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1244

图检索增强生成(GraphRAG)精要(一)

到现在为止,你可能已经遇到或听说过 ChatGPT,这是对话式 AI 中最突出的例子之一。ChatGPT 是由 OpenAI 开发的一个对话式用户界面,由 LLM(如 GPT-4,OpenAI et al.,2024)提供支持。LLM 建立在 Transformer 架构(Vaswani et al.,2017)之上,这使得它们能够高效地处理和生成文本。这些模型在大量文本数据上训练,使它们能够学习模式、语法、上下文,甚至一定程度上的推理。

龙哥盟 1220

大模型 | GraphRAG技术最新全面综述(二)图引导的检索、图增强的生成、GraphRAG应用和评估

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 2245
上一篇: RAFT:让语言模型更聪明地用文档答题
下一篇: Qwen Agent 入门介绍与简单使用示例
CODE_RabbitV
博客等级 码龄7年 2931粉丝 218原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值