Elastic Attention:将 MoE 路由引入 Attention,让大模型长文本推理“该省省,该花花”

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情

0. 省流版(TL;DR)

  • 痛点:长文本推理中,Full Attention 太慢太贵,固定比例的 Sparse Attention 又容易在困难任务上掉点。
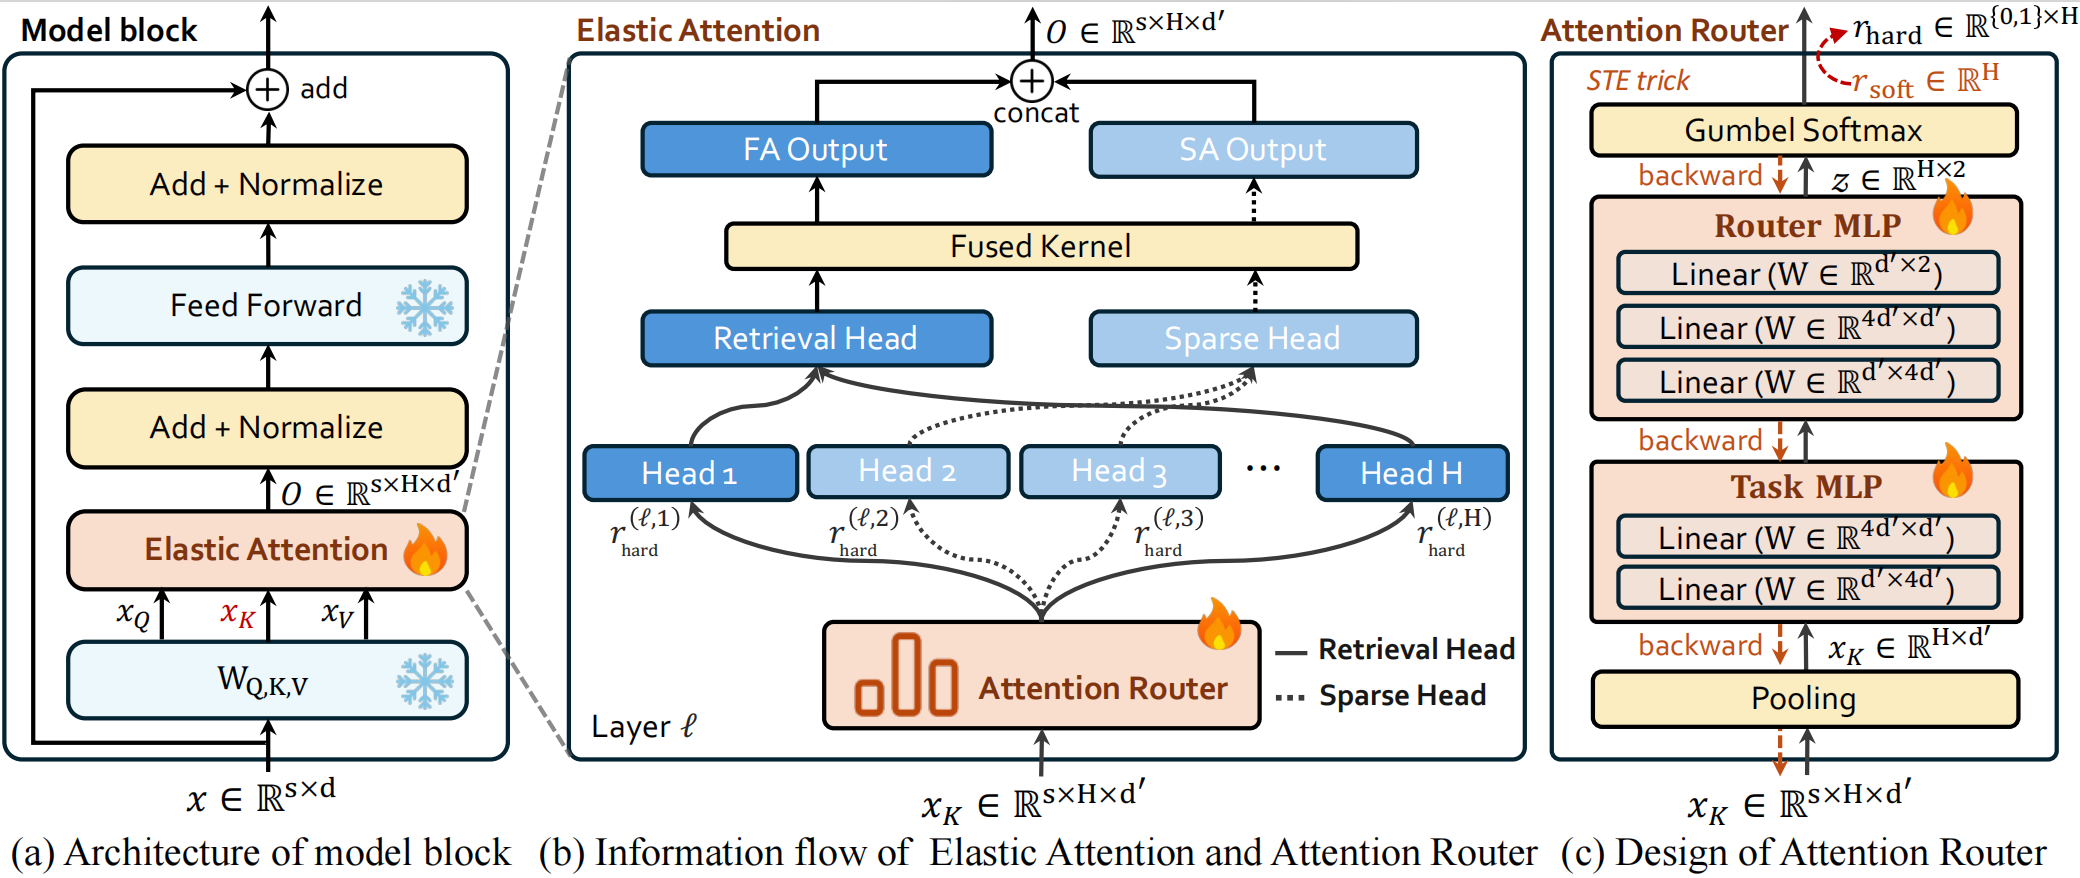
  • Method:Elastic Attention。在 Attention 层引入类似 MoE 的 Router(路由器),根据输入内容,动态决定每个 Head 是走 Full Attention(全关注)还是 Sparse Attention(稀疏关注)。
  • 工程优化:手写了 Fused Kernel,在一个 Kernel 内并行处理稀疏和稠密计算,拒绝 Python 层面的串行调度延迟。
  • 效果:在 LongBench 等多个榜单上超越 DuoAttention、InfLLM-v2 等基线,性能逼近(部分超越) Full Attention,但速度显著提升 。
    请添加图片描述

1. 为什么我们需要“弹性”的注意力?

大模型处理长文本时,Attention 的 复杂度是最大的拦路虎 。

为了解决这个问题,业界提出了很多 Hybrid Attention(混合注意力) 方案,比如 DuoAttention 或 PruLong。它们的核心思想是:一部分 Head 负责看全局(Full Attention),一部分 Head 只看局部或滑动窗口(Sparse Attention) 。

但现有的方法有一个明显的问题:
即使是 Hybrid 策略,其“稀疏 vs 稠密”的比例通常是静态的或者是预先设定好的 。

然而,我们在实验中发现,下游任务对稀疏度的敏感性截然不同 :

  • Sparsity-Robust 任务(如文档摘要):只需要粗粒度信息,很高的稀疏度也能由不错的效果。
  • Sparsity-Sensitive 任务(如多跳 QA):需要精准检索细节,稀疏度一高,性能立马崩盘。

如果模型不能动态调整计算策略,就必然会在“效率”和“效果”之间顾此失彼。 于是,我们想到了 MoE。


2. Elastic Attention:Attention 层面的 MoE

MoE(Mixture-of-Experts)的核心魅力在于 Dynamic Computation(动态计算)。既然 MLP 层可以路由到不同的专家,为什么 Attention 层不能路由到不同的计算模式呢?

2.1 核心架构:Attention Router

我们在预训练好的 LLM(如 Qwen3, Llama-3.1)中插入了一个轻量级的 Attention Router 。它的工作原理如下:

  1. 输入感知:Router 接收当前的 Key hidden states 作为输入 。
  2. 路由决策:通过一个简单的 MLP 网络,Router 为每一层的每一个 Head 生成一个路由信号 r r r 。
    • r = 0 r = 0 r=0:该 Head 执行 Full Attention (FA),确保精准召回。
    • r = 1 r = 1 r=1:该 Head 执行 Sparse Attention (SA),大幅节省计算 。
  3. 结果融合:最后将不同模式计算出的结果 Concat 起来 。

整个过程完全是 Instance-aware(输入感知) 的。面对简单的 Token 或任务,Router 会自动加大 SA 的比例;面对复杂的推理,它会自动切换回 FA。

训练Trick:为了让离散的路由决策(0或1)可导,我们使用了 Gumbel-Softmax 结合 Straight-Through Estimator (STE) 技术,确保在反向传播时梯度能正常流动 。

2.2 并不增加负担

大家可能会担心 Router 会不会很重?
完全不会。对于 8B 模型,Attention Router 仅增加了 每层 0.27M 参数,且不需要对 Backbone 进行重新训练,只需 12小时(8卡 A800) 的轻量级微调即可完成适配 。


3. 硬核工程优化:Fused Kernel

这是我们在工程实现上花费精力最多的地方。

在 PyTorch 层面实现这种混合注意力通常很慢,因为你需要先把 Head 分成两组(FA组和SA组),分别计算后再拼回去。这种 Serial Dispatch(串行调度) 会导致 GPU 上的 Kernel Launch 开销巨大,且破坏了流水线并行 。

为了解决这个问题,我们基于 Triton/CUDA 开发了 Fused Kernel(融合算子) 。

  • 统一视角:我们将路由决策作为 Metadata 传入 Kernel 。
  • 并行执行:Kernel 内部通过 Thread Block 分支逻辑,让同一个 Kernel Launch 可以同时处理执行 FA 的 Head 和执行 SA 的 Head 。
  • 效果:相比 PyTorch 原生实现,Prefill 阶段获得了显著的加速,显存占用也大幅降低 。

4. 实验结果:效果与速度的双赢

我们在 Qwen3-4B/8B 和 Llama-3.1-8B 上进行了广泛验证 。

4.1 性能表现

在 LongBench-E 和 LongBench-V2 等主流榜单上,Elastic Attention 的平均性能均优于现有的 SOTA 方法(如 InfLLM-V2, DuoAttention, PruLong) 。

特别是在 RULER(长度外推测试)中,我们将上下文扩展到 256K,Elastic Attention 依然保持了极高的性能稳定性,而其他基线方法在超长文本下往往出现严重衰退 。

4.2 任务自适应性

最有意思的发现是 Router 的行为模式。如下图(论文 Figure 6)所示,对于 Code(代码) 任务,模型自动分配了约 85% 的稀疏度;而对于 QA(问答) 任务,稀疏度则降低到 68% 左右 。

这完美印证了我们的初衷:模型学会了根据任务难度“看菜下碟”。


5. 总结与展望

Elastic Attention 是我们在 Dynamic Sparse Attention 方向的一次尝试。通过引入 MoE 路由机制,我们打破了静态稀疏注意力的限制,证明了“动态路由”在 Attention 层同样大有可为。

目前代码、模型和论文均已开源,欢迎大家 Star、引用和交流!


如果你对长文本优化、MoE 架构或底层算子优化感兴趣,欢迎在评论区留言讨论!

深度学习之Seq2Seq原理与实战 【代码】深度学习之Seq2Seq原理与实战。 阅读详情

相关推荐

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 187

拒绝计算“一视同仁”!Elastic Attention:让大模型学会“看人下菜碟”

在 LongBench-E 评测中,Elastic Attention 在保持高稀疏度(推理更高效)的同时,其平均性能不仅优于 InfLLM-V2、DuoAttention 和 PruLong 等现有方法,甚至。(c) 展示了注意力路由器的轻量级设计。:面对 RULER 和 LongBench-V2 中的QA任务或高难度推理任务,Elastic Attention同样逼近或超过了全注意力的基础模型。),模型会在训练中自动寻找“性能”与“稀疏度”的最佳平衡点,从而解耦了不同任务之间的优化冲突。

zenRRan的博客 95

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 258

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 196

深度学习之词袋(Bag-of-Words, BoW)原理与实战

【代码】深度学习之词袋(Bag-of-Words, BoW)原理与实战。

yumiwangzi30的博客 224

深度学习之LSTM原理与实战

【代码】深度学习之LSTM原理与实战。

yumiwangzi30的博客 130

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 366

Elastic Attention:动态稀疏注意力机制优化Transformer性能

注意力机制是Transformer架构的核心组件,其计算复杂度随序列长度呈平方级增长,成为模型效率的瓶颈。动态稀疏化技术通过智能选择关键token参与计算,在保持模型性能的同时显著降低计算开销。Elastic Attention创新性地引入可学习稀疏门控机制,使每个注意力头能自主调整参与计算的token比例。这种技术在工程实践中展现出显著优势,如在BERT-large模型部署中,仅用70%计算量就达到标准注意力的98%准确率。结合渐进式训练策略和内存优化技巧,该方案特别适合处理300-1000token的中

weixin_28289089的博客 553

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 216

AI对战五子棋——深度学习策略网络

在本篇博文中,我们完成了:✔ 构建一个 CNN 五子棋策略网络✔ 让神经网络输出落子概率✔ 使用 Policy Gradient 强化学习训练 AI✔ 让 AI 实现人与 AI、AI 自对弈博弈。

X2829352498的博客 25

从零开始:在Ubuntu 22.04上配置Isaac Gym Preview 3环境(含常见错误解决方案)

本文提供了在Ubuntu 22.04系统上从零开始配置Isaac Gym Preview 3环境的完整实战指南。内容涵盖NVIDIA驱动安装、Conda环境搭建、CUDA与PyTorch版本精准匹配、Isaac Gym核心安装与验证,并重点介绍了针对四足机器人等复杂系统的强化学习训练环境配置、常见错误解决方案及性能调优技巧,旨在帮助开发者高效部署这一高性能物理仿真平台。

weixin_29048775的博客 392

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 354

Win10系统安装Ubuntu虚拟机,这回真的是零基础!(结尾附NS3的配置)

Win10系统安装Ubuntu虚拟机(结尾附NS3的配置) 序幕 本人现在还在念大二,有一门很有趣而且老师讲得也不错的课程《计算机网络原理》。这周老师布置了一个实验《NS3网络模拟》,为了详细记录本次实验过程,顺便也便于自己复习,就写了这篇博客,希望能够对你有帮助! NS3是什么呢?实际上就是一门算法,和计算机网络有关的。不过在我们日常使用的Windows系统上去做这个实验是行不通的,这个实验一定要在Linux系统上进行模拟才能玩的下去,作为一名 Windows选手对此表示不爽但是没办法,为了实验也只

灼热之翼的博客 7382

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 385

Maya vray 3S皮肤材质球设置与材质节点连接

Maya vray 3S皮肤材质球设置与材质节点连接

WETQETF的博客 2697

Index-TTS-1.5:多模态语音合成的技术演进与商业落地实践

本文深入探讨了Index-TTS-1.5在多模态语音合成领域的技术演进与商业落地。该模型基于GPT风格的自回归Transformer架构,通过优化条件编码器和引入字符-拼音混合建模,显著提升了语音生成的稳定性、精准度和真实感,实现了高质量的零样本语音克隆。文章还详细介绍了其云端体验、本地WebUI部署及ComfyUI集成等实战路径,并分析了其在虚拟数字人、个性化内容创作等商业场景中的应用潜力与挑战。

weixin_29098367的博客 402

CNN 卷积神经网络深度解析:卷积、池化与特征提取的底层原理

卷积核(Kernel),也叫滤波器(Filter),本质上是一个可以训练的权重矩阵。1 0 -11 0 -11 0 -1这个卷积核可以对图像中的局部像素进行加权计算。不同的卷积核能够提取不同类型的特征:水平边缘特征垂直边缘特征纹理特征角点特征局部形状特征在传统图像处理中,滤波器通常由人工设计。而在 CNN 中,卷积核的权重通过训练数据和反向传播自动学习得到。这也是 CNN 能够自动提取图像特征的关键。# 第一层卷积padding=1# 第二层卷积padding=1。

2503_90237586的博客 240

缺陷检测-金属表面缺陷检测

1介绍 缺陷检测是工业视觉技术中最重要的组成部分。业务广泛,场景丰富,技术难点高、工作量大。针对不同的场景,选择不同的相机和

huneng1991的专栏 5250

图解常用深度学习优化器

来隐式构造 Hessian 逆的近似,从而直接估计出“谷底在哪”,而非仅仅判断“哪边最陡”。即SGD/Adam 主要看“当前坡度”,LBFGS 还会看“最近几步坡度怎么变”,像用局部地形图来规划路线。训练 Transformer 时,有些层梯度大,有些层梯度小。如果用 Adam + L2,梯度大的参数反而可能被“少衰减”,正则效果不稳定;:你要下山,但每次迈步前都要派侦察兵把整座山的每一个坡面都测量一遍,算出“绝对最陡”的方向才走一步。:还是下山,但这次你只问身边一个路人“哪边最陡”,然后就走。

技术管理两手抓,两手都要硬. 200

宇树科技嵌入式面试题及参考答案(春晚机器人的公司)

内存对齐是指在内存中为数据对象分配存储空间时,按照一定的规则将数据存储在特定的地址上,以提高内存访问效率。不同的数据类型在内存中都有其特定的对齐要求,例如,int类型通常要求 4 字节对齐,double类型通常要求 8 字节对齐。这意味着数据的存储地址必须是其对齐字节数的整数倍。如果不进行内存对齐,处理器在访问数据时可能需要进行多次内存访问,从而降低了访问效率。指令可以用于控制结构体内存布局,它允许程序员指定结构体成员的对齐方式。其基本用法是在结构体定义之前使用来指定对齐字节数n,其中n。

大模型大数据攻城狮的专栏 3226

教程: 将 SolidWorks 设计导出为 ROS 的 URDF

请按照以下步骤应用自定义徽标纹理:创建徽标材质文件:techniquepass材质名称:测试/材质颜色属性:环境、漫反射、镜面和发射都设置为白色(1 1 1 1),这意味着该材质看起来完全是白色的。纹理 在表面应用纹理图像 logo.png。将材质文件复制到 gazebo matrial:复制徽标图像:将 “徽标 ”替换为机器人上徽标所在位置的适当参考值。按照以上步骤,您就可以在 Gazebo 中为机器人添加自定义材质和纹理,包括徽标。

机器人控制与仿真应用 2458

证件阅读机如何用多光谱光学成像、端到端深度学习 OCR 与 MRZ 解析、13.56MHz 射频芯片认证三层能力,把单证核验压缩到 1–2 秒

"说走就走"的外国游客多了,酒店前台的压力也就跟着一起"入境"了。复印件在红外图里会丢掉层次,屏幕翻拍件在紫外图里会暴露像素网格和屏幕的摩尔纹,PS 改过的资料页在红外和可见光的交叉比对下常常"对不上"。客人只觉得"这家酒店办入住挺快",前台只觉得"今天没被催",店长只觉得"这个月没收到整改通知"。三只眼睛和一个 AI 大脑在 1–2 秒里跑完的一整套核验,被压缩成了体验里那句轻飘飘的"好的,您的房卡"。有意思的是,真正在缓解这个压力的,不是多招几个前台,而是柜台上多了一台巴掌大的小设备——证件阅读机。

智能图像识别 346

【Godot】【工程】中文字体与多语言(缺字/体积/打包:一次性配置到位)

本文介绍了Godot游戏开发中的中文字体配置与多语言支持方案。主要内容包括:1)中文字体的全局与局部设置;2)使用子集化技术减小字体体积;3)多语言资源管理及翻译系统实现;4)语言切换机制与控件刷新方法;5)字体回退策略优化显示效果;6)打包优化建议。文章提供了从字体导入到多语言实现的完整解决方案,帮助开发者系统性解决中文显示和多语言支持问题,同时优化资源体积和性能表现。配套案例可供学习参考。

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 598

基于深度学习的猫图像目标检测方法研究:YOLOv8s模型海选、多种子对比训练与Django+ONNX部署实现详解

本课题基于深度学习研究猫图像目标检测问题。数据集含1000张猫图像、1188个标注框,按固定比例划分并冻结清单;训练前在多个候选族中短训海选,确定YOLOv8s为主模型,经学习率搜索与显存标定后完成150轮训练,验证集mAP50达到0.92,并以7个随机种子的对比实验验证稳定性。最优权重导出为ONNX接入Django系统,提供图片、视频、摄像头三种识别方式,配套识别记录管理与统计大屏,形成从训练到应用的完整闭环。

WEIXIN_JSJBSZDS的博客 168

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

深度学习0:数学知识:正态分布2(积分,幂函数积分公式)

积分符号∫(\int∫= 把无数个极窄的小矩形面积(高度×dx(\times dx×dx))“拼接”起来。dx(dxdx= 无穷小的宽度。定积分的结果= 曲线下方的总面积(一个具体的数字)。不定积分= 寻找求导前的那个原函数。这就是“积分求面积”最朴素的意思!

tellmewhoisi的博客 210

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

qq_2529413168的博客 181

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

上一篇: 【深度长文】RLHF 算法全景解析:从 PPO 到 DPO/GRPO 的范式革命
下一篇: 飞书批量下载工具开发记录:从痛点到解决方案
ACEEE-1222
博客等级 码龄4年 432粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值