


1. Merkle Patricia Trie 源码分析
0.1 RLP编码:json 未知编码 byte 解码_以太坊RLP编码_最暖最珍贵的博客-优快云博客
RLP(RECURSIVE LENGTH PREFIX) 递归长度前缀序列化方式,还有常见的就是json序列化方式.(序列化是将任意的数据结构编码为有结构的二进制数据byte arrays)
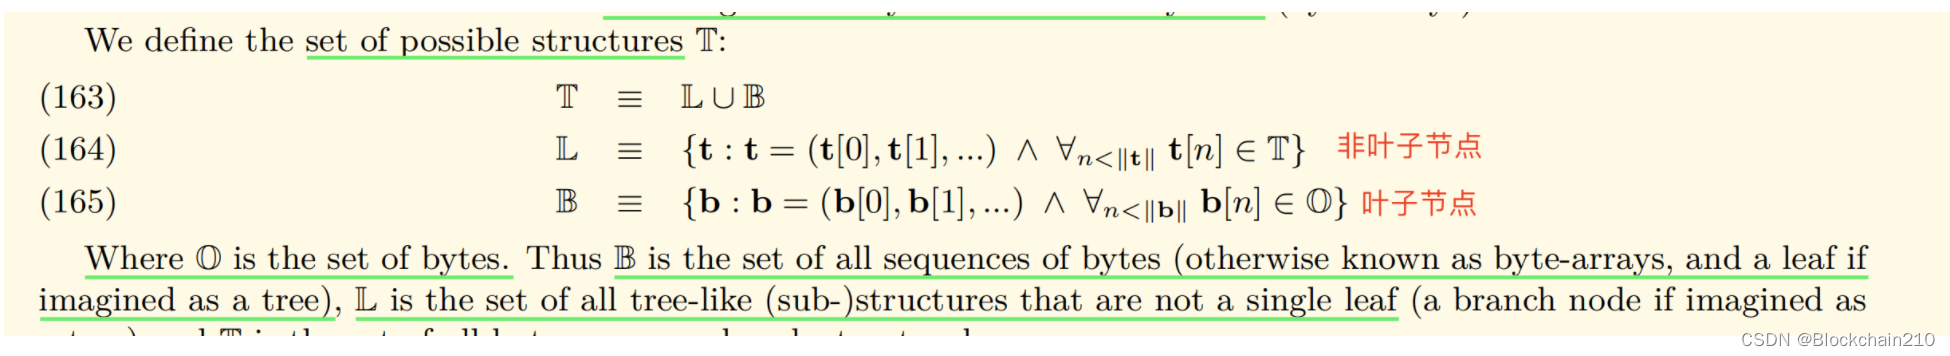
RLP函数的定义(递归函数定义):
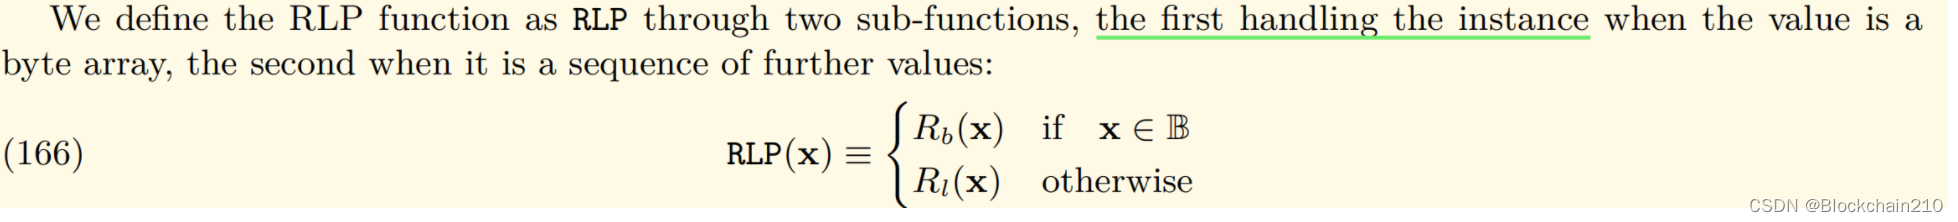
RLP函数的5条编码规则(通过以下规则,我们可以通过字节数组推导出值):
-
如果值在[0,127]之间的单个字节,其编码是其本身.

-
如果byte数组的长度l<=55,编码的结果是数组本身,再加上128+l作为前缀.
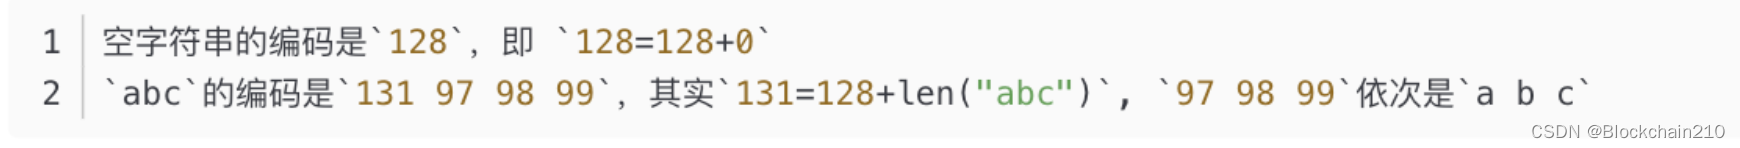
-
如果数组长度大于55,编码结果第一个值是183(128+55)加数组长度的编码的长度,然后是数组长度本身的编码,最后是byte数组的编码.
比如编码一个重复1024次"a",且结果是
185 1 0 97 97 97 ...因为长度大于55,所以1024的2进制表示:0000,0100,0000,0000
按照大端序:0000,0000,0001,0000=> 所以按照16进制表示:0010,省略前面的0,长度为2.
-
如果列表(字节数组的数组) 长度小于55,编码结果第一位是192加列表长度的编码的长度,然后依次连接各个子列表的编码.

["abc","def"]的编码结果是200| 131 97 98 99 | 131 100 101 102
|是实际不存在的,只是便于我们理解而存在
1.1 Trie的概述
包位置:go-ethereum/trie
该包用New方法在数据库(database)构建一个trie.
-
无论何时trie执行一个commit操作,生成的节点都会在集合中被收集并返回.
-
一旦trie被提交,它就再也不会被使用(Once the trie is committed,it’s not usable anymore.)
-
Callers 不等不在更新的trie database上重新创建一个new root的trie.
1.1.1 trie的提供的接口:
-
New方法:建立一个trie
func New(id *ID, db *Database) (*Trie, error) -
NewEmpty方法:构建一个空的trie(这个所谓的空是指创世区块中StateRoot所对应的MPT树)
func NewEmpty(db *Database) *Trie {
    //types.EmptyRootHash是创世根hash的作用.
    tr, _ := New(TrieID(types.EmptyRootHash), db)
    return tr
}
// TrieID constructs an identifier for a standard trie(not a second-layer trie) // with provided root. It's mostly used in tests and some other tries like CHT trie. func TrieID(root common.Hash) *ID { return &ID{ StateRoot: root, Owner: common.Hash{}, Root: root, } }
1.2 trie package中的Trie的数据结构(重点在于reader和tracer字段)
reader字段用于检索MPT树的节点;tracer用来追踪MPT树的变化
type Trie struct{
  root node
  owner common.Hash
  //标记该Trie是否被提交,如果提交了那么该trie就不会被使用(最新状态也不可见)
  committed bool
  //追踪自从上次hash操作开始被插入的叶子节点数量
  unhashed int
  //reader是trie检索节点的处理函数
  reader *trieReader
  //tracer是追踪trie改变的工具
  // 每次提交操作之后将会被重置.
  tracer *tracer
}
其可以用如下图来表示Trie的数据结构 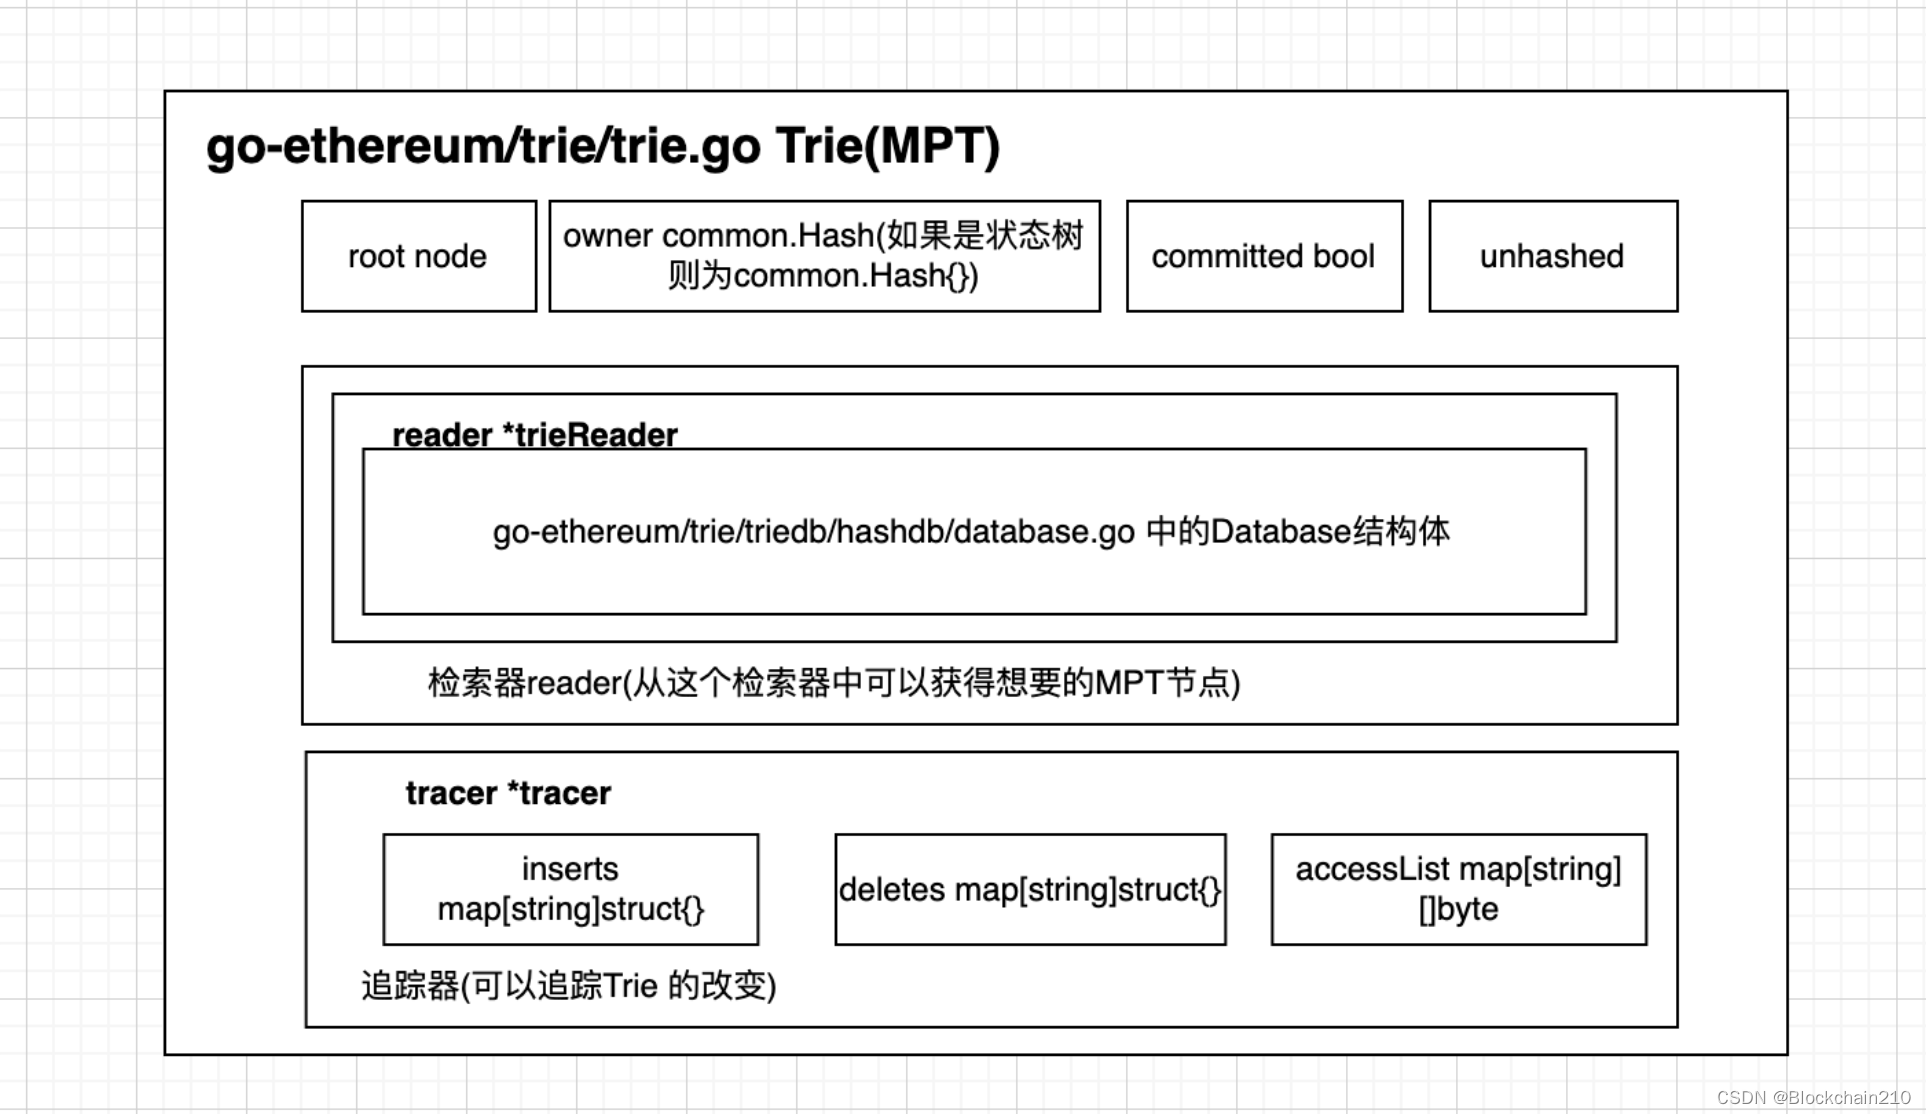
1.2.1 新建Trie
func New(id *ID, db *Database) (*Trie, error) {
    //db *Database 包是在go-ethereum/trie/database.go
    //创建可以检索MPT树的处理函数,详见1.2.2Reader
    reader, err := newTrieReader(id.StateRoot, id.Owner, db)


    if err != nil {
        return nil, err
    }
    trie := &Trie{
        owner:  id.Owner,
        reader: reader,
        tracer: newTracer(),//新建追踪器,
    }
    //接下来如何找到MPT的root,详见1.2.6
    if id.Root != (common.Hash{}) && id.Root != types.EmptyRootHash {
        //详见1.2.7:如何寻找MPT的root node?(resolveAndTrack)
        rootnode, err := trie.resolveAndTrack(id.Root[:], nil)
        if err != nil {
            return nil, err
        }
        trie.root = rootnode
    }

}
id *ID: 数据结构表示如下: 决定了该创建的MPT树是状态树还是存储树
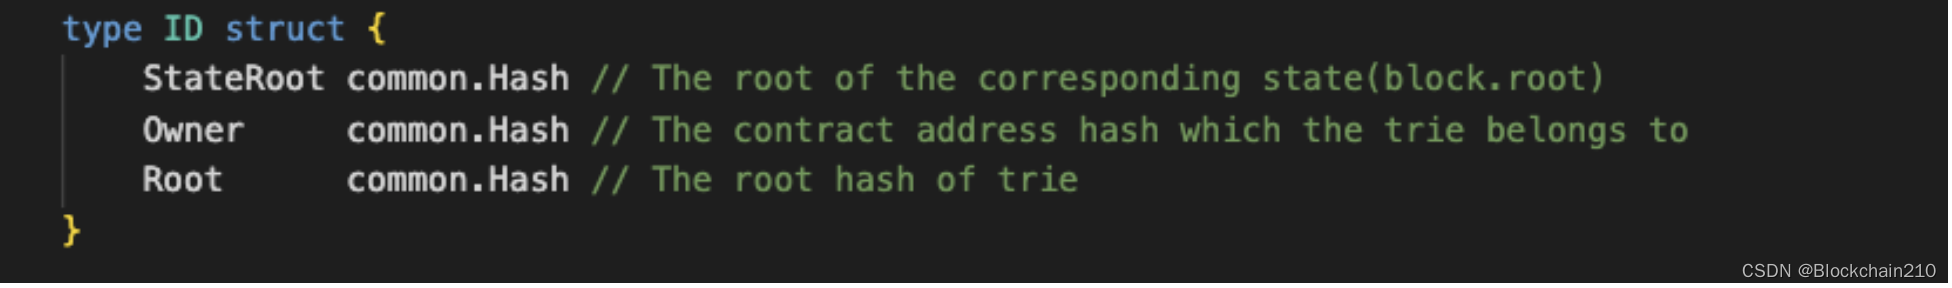
状态树(state trie)需要StateRoot和Root(且StateRoot字段和Root字段相同);存储树(storage trie)需要StateRoot,Owner(因为存储树是相对于一个智能合约的,所以需要合约地址)以及Root
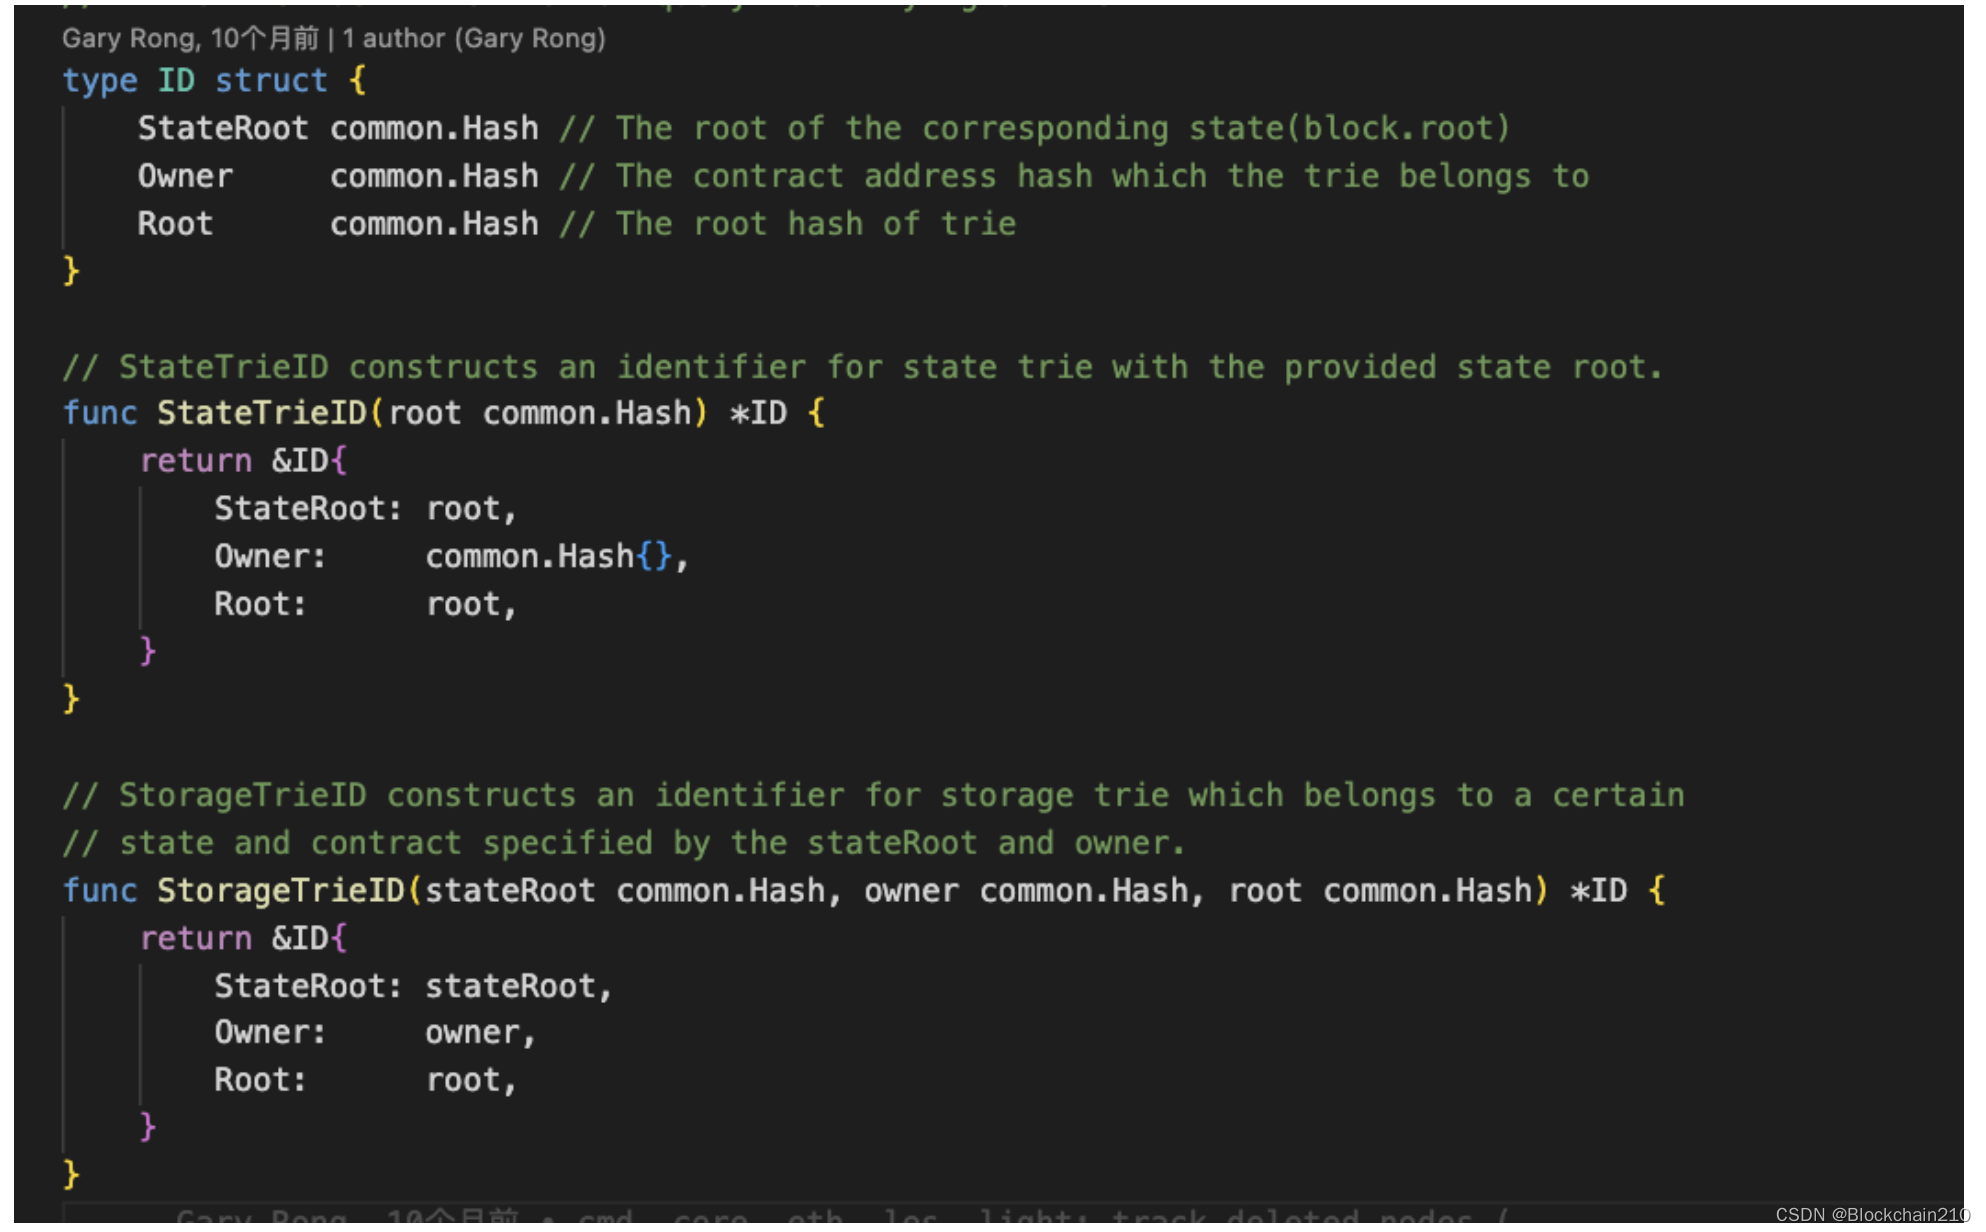
需要值得注意的是:
ID.StateRoot是指区块的Root字段
ID.Root是指该MPT树的根节点的hash值
1.2.2 Reader(检索器)数据结构及方法
代码位置: go-ethereum/trie/trie_reader.go
// reader接口包装了trie存储的节点方法.
type Reader interface{
    Node(owner common.Hash, path []byte, hash common.Hash) ([]byte, error)
}
对 上述接口的实现结构体
type trieReader struct{
    owner  common.Hash
    reader Reader
    banned map[string]struct{} // Marker to prevent node from being accessed, for tests
}
创建TrieReader方法:newTrieReader()
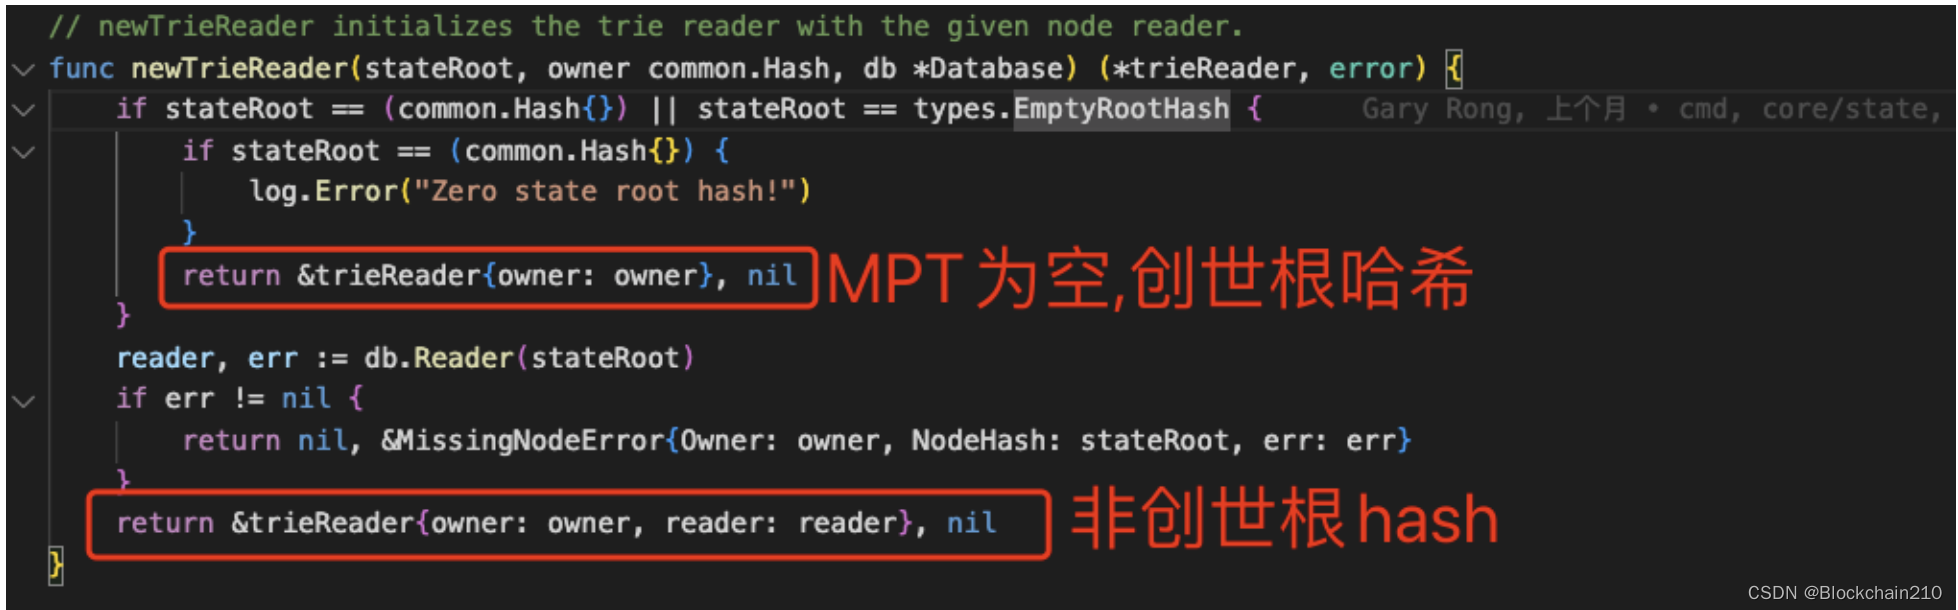
实际上trieReader的reader字段是由db *Database 中的Reader方法所创建的,详见1.2.4
EmptyRootHash =common.HexToHash("56e81f171bcc55a6ff8345e692c0f86e5b48e01b996cadc001622fb5e363b421")
上述的hash值称为创世根hash即在创世区块中的StateRoot
1.2.3 Database 数据结构
代码位置go-ethereum/trie/database.go
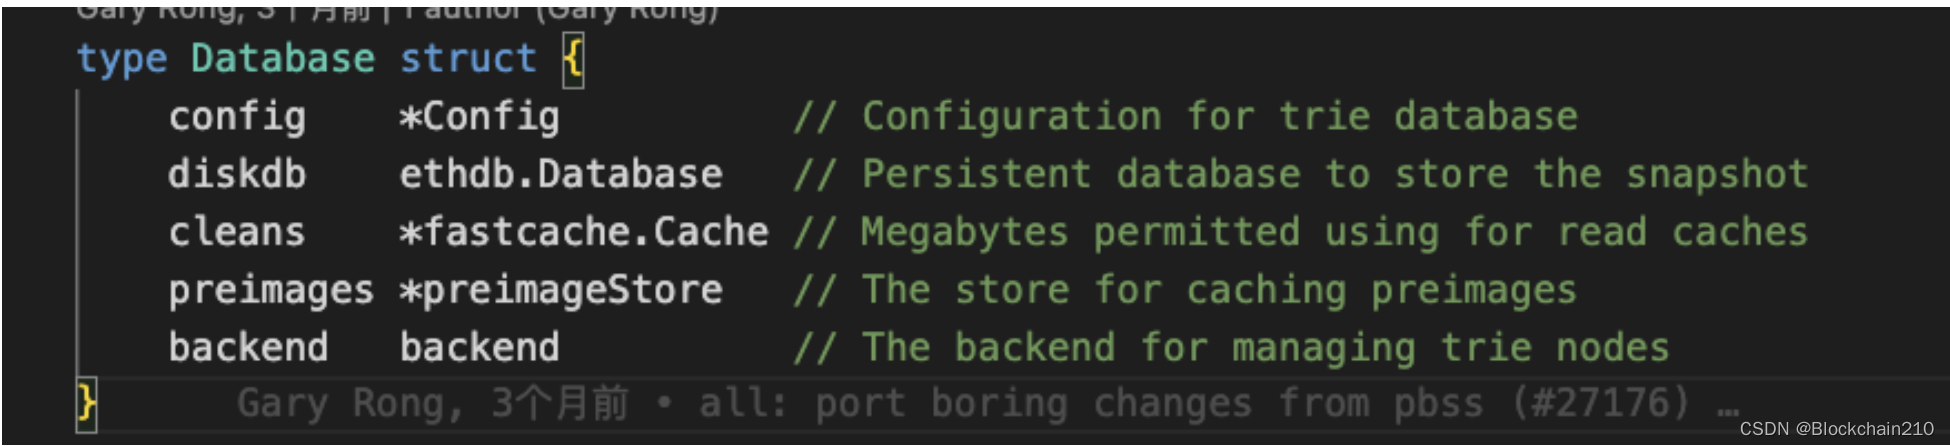
对于树的节点的管理,我们定义了backend接口,只要实现该接口中的方法就可以实现MPT树的节点管理.
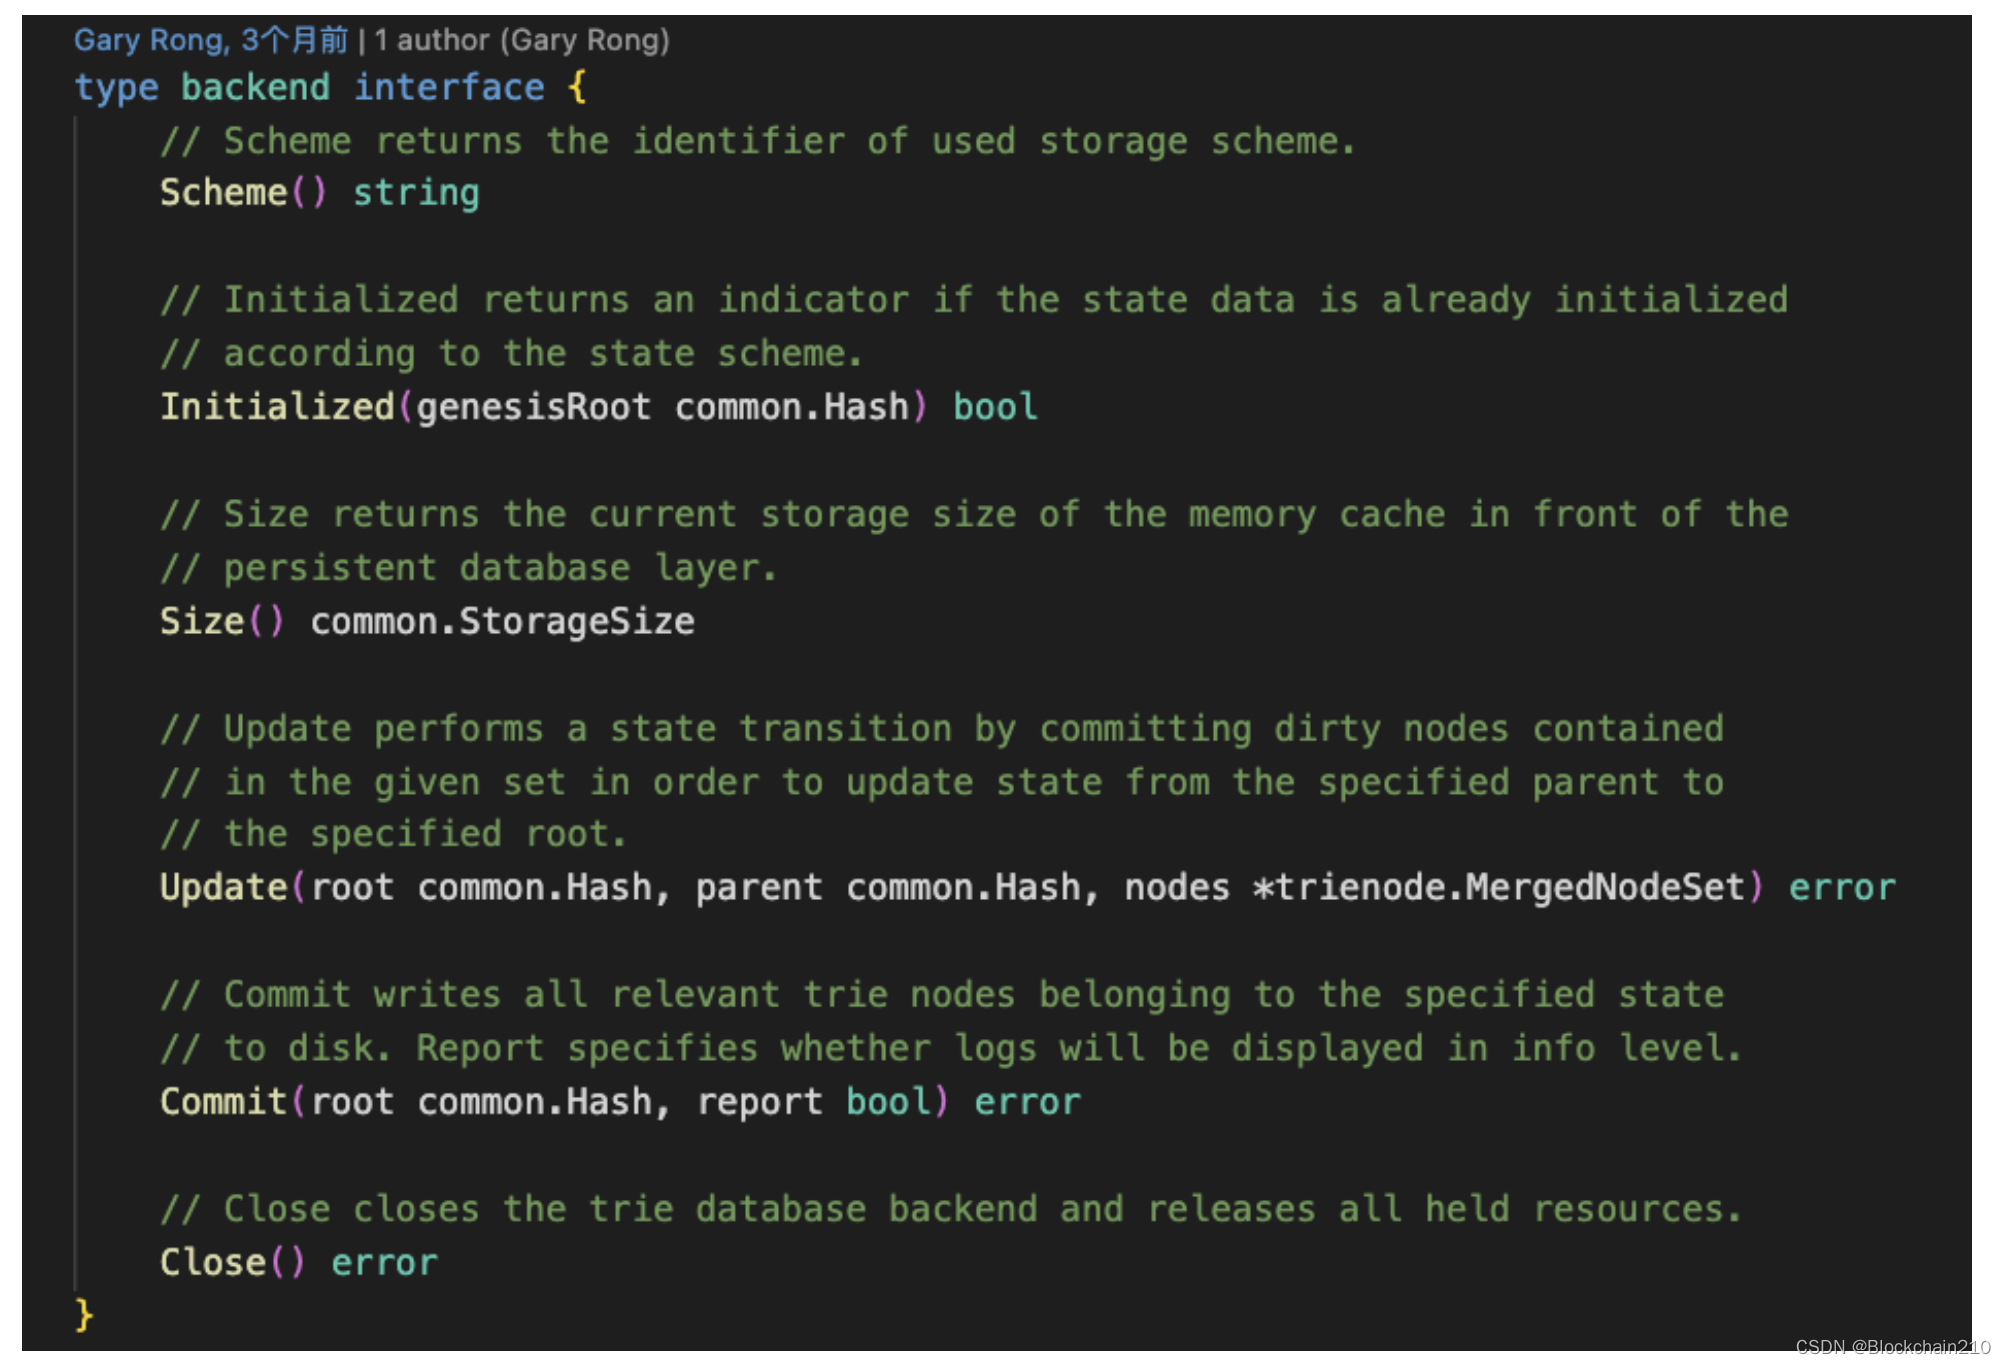
1.2.4 Database.Reader()方法
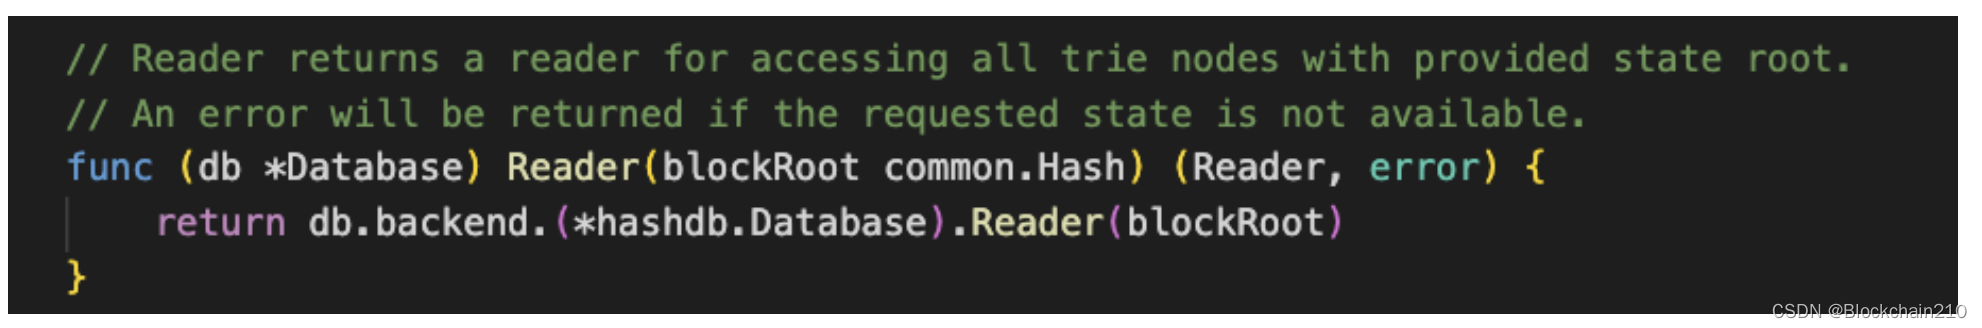
实际上是利用hashdb package的Reader方法,详见
1.2.5 Tracer(追踪器)数据结构及方法
代码位置: go-ethereum/trie/tracer.go
该追踪器记录着增加的节点,删除的节点以及可以访问的节点列表.
type tracer struct {
    //map只是标识作用,所以value的值不重要,为了节省内存所以用空结构体.
    inserts    map[string]struct{}
    deletes    map[string]struct{}
    accessList map[string][]byte
}
1.2.6 Root(MPT树的根节点)数据结构及方法
MPT树的根节点实际上就是MPT树的节点,代码位置:
go-ethereum/trie/node.go
在MPT树中节点可以分为扩展节点(extension node),叶子节点(leaf node)以及分支节点(branch node).在实际实现中,这些节点都需要实现接口:
type node interface {
    cache() (hashNode, bool) //返回该节点与缓存相关的元数据
    //hashNode的数据结构是 []byte即32位的
    encode(w rlp.EncoderBuffer)  // 将节点编码为RLP的格式(序列化的过程)
    fstring(string) string //格式化输出字符串
}
RLP 是一种简单而有效的方式,将任意复杂的数据结构转换为字节序列
上述的encode(递归的写法)方法:
//full node的encode方法
func (n *fullNode)encode(w rlp.EncoderBuffer){
    //返回一个列表(类似一个树的先序遍历算法)
    offset := w.List()
    for _, c := range n.Children {
        if c != nil {
            c.encode(w)
        } else {
            w.Write(rlp.EmptyString)
        }
    }
    //结束列表
    w.ListEnd(offset)
}

//short node的encode方法
func (n *shortNode)encode(w *rlp.EncoderBuffer){
    offset := w.List()
    w.WriteBytes(n.Key)
    if n.Val != nil {
        n.Val.encode(w)
    } else {
        w.Write(rlp.EmptyString)
    }
    w.ListEnd(offset)
}
且扩展节点和叶子节点的数据结构类型,分支节点的数据类型分别如下:

fullnode中Children对应的下标为:

每个节点都有一个nodeFlag结构体:(go-ethereum/trie/node.go)
//nodeFlag 保存着一节点的缓存相关的元数据
type nodeFlag struct {
    //hashNode
    hash  hashNode // cached hash of the node (may be nil)
    dirty bool     // whether the node has changes that must be written to the database
}
1.2.7 如何寻找MPT的root node? (resolveAndTrack方法)
该方法在 go-ethereum/trie/trie.go
/*
* 给定 节点的hash和路径前缀 从底层存储中加载节点
*
*/
func (t *Trie) resolveAndTrack(n hashNode, prefix []byte) (node, error) {
/*
根据root的hash值返回node.
*/
    blob, err := t.reader.node(prefix, common.BytesToHash(n))
    if err != nil {
        return nil, err
    }
    t.tracer.onRead(prefix, blob)
    //将RLP编码的节点解码获得node数据结构
    return mustDecodeNode(n, blob), nil
}
以太坊中的比较重要的字节数组的长度:1. hash值(32字节) 2. state地址(20字节)
地址:/home/hypan/go-ethereum/common/types.go

1.3 hashdb package中的Database
该包在go-ethereum/trie/triedb/hashdb,该包中只有一个文件就是database.go

1.3.1 Reader()方法
go-ethereum/trie/trie_reader.go中的newTrieReader方法中调用了reader, err := db.Reader(stateRoot) 即为以下方法:
// Reader retrieves a node reader belonging to the given state root.
// An error will be returned if the requested state is not available.
func (db *Database) Reader(root common.Hash) (*reader, error) {
    if _, err := db.Node(root); err != nil {
        return nil, fmt.Errorf("state %#x is not available, %v", root, err)
    }
    return &reader{db: db}, nil
}
上述的root common.Hash 实际上是指向的是1.2.1中ID.StateRoot即区块哈希值.
db.Node方法
2. Trie中的检索器(trieReader)
go-ethereum/trie/trie_reader.go
trieReader结构体和Reader接口:
模型为:

为什么是这样的,推导如下:
type trieReader struct{
    //如果是状态树,那么owner common.Hash字段为空;
    //如果是存储树,那么owner则为合约地址
    owner common.Hash
    reader Reader //Reader是接口
    banned map[string]struct{} //标记以防止节点访问,测试用
}
// Reader interface
type Reader interface{
    //给定trie的标识符(owner合约地址),节点路径和相应的节点标识符
    Node(owner common.Hash,path []byte,hash common.Hash)([]byte,error)
}
    根据创建TrieReader的newTrieReader()方法可以知道结构体中的reader Reader是由

go-ethereum/trie/database.go中的Reader方法创建// stateRoot:表示区块的root字段(状态树的根root),owner:合约地址
func newTrieReader(stateRoot, owner common.Hash, db *Database) (*trieReader, error) {
    //types.EmptyRootHash创世根hash
    if stateRoot == (common.Hash{}) || stateRoot == types.EmptyRootHash {
        if stateRoot == (common.Hash{}) {
            log.Error("Zero state root hash!")
        }
        return &trieReader{owner: owner}, nil
    }
    reader, err := db.Reader(stateRoot) //Reader方法
    if err != nil {
        return nil, &MissingNodeError{Owner: owner, NodeHash: stateRoot, err: err}
    }
    return &trieReader{owner: owner, reader: reader}, nil
}
然后在go-ethereum/trie/database.go中调用Reader方法,创建Reader:
func (db *Database) Reader(blockRoot common.Hash) (Reader, error) {
    return db.backend.(*hashdb.Database).Reader(blockRoot)
    // we need 断言,然后调用 go-ethereum/trie/triedb/database.go中的Reader方法
}
在go-ethereum/trie/triedb/hashdb/database.go中Reader方法:
//root common.Hash表示的是MPT树根节点hash值.
func (db *Database) Reader(root common.Hash) (*reader, error) {
    //db.Node:从内存中检索编码的缓存trie节点,如果找不到缓存的内容,
    //该方法将查询持久数据库以获取内容.
    if _, err := db.Node(root); err != nil {
        //如果找不到内容,则说明不能构建以该root为根的MPT树的读取器
        return nil, fmt.Errorf("state %#x is not available, %v", root, err)
    }
    //如果找到内容,那么就可以构建该读取器,该读取器实际上就是
    //go-ethereum/trie/triedb/hashdb/database.go中的Database
    return &reader{db: db}, nil
}
根据上述可以知道trieReader本质上就是go-ethereum/trie/triedb/hashdb/database.go总的Database数据结构.

2.1 trieReader结构体中node()
接口形式:
func (r *trieReader) node(path []byte, hash common.Hash) ([]byte, error) {
    // Perform the logics in tests for preventing trie node access.
    if r.banned != nil {
        if _, ok := r.banned[string(path)]; ok {
            return nil, &MissingNodeError{Owner: r.owner, NodeHash: hash, Path: path}
        }
    }
    //根本不存在该trie树
    if r.reader == nil {
        return nil, &MissingNodeError{Owner: r.owner, NodeHash: hash, Path: path}
    }
    //如果是状态树,那么r.owner为nil;如果是存储树,那么r.owner为合约地址.
    //Node方法调用的是go-ethereum/trie/triedb/hashdb/database.go中的Node方法
    blob, err := r.reader.Node(r.owner, path, hash)
    if err != nil || len(blob) == 0 {
        return nil, &MissingNodeError{Owner: r.owner, NodeHash: hash, Path: path, err: err}
    }
    return blob, nil
}
功能:根据路径和trie的根节点hash找到想要rlp编码的节点
参数: path:是路径,hash是trie的根节点hash值.
返回值: rlp编码的节点.
=> go-ethereum/trie/triedb/hashdb/database.go中reader结构体的Node方法如下:
func (reader *reader) Node(owner common.Hash, path []byte, hash common.Hash) ([]byte, error) {
    //实际上只用到了节点的hash
    blob, _ := reader.db.Node(hash)
    return blob, nil
}
=> 后期又调用该文件中Database结构体的Node方法:

// Node retrieves an encoded cached trie node from memory. If it cannot be found
// cached, the method queries the persistent database for the content.
func (db *Database) Node(hash common.Hash) ([]byte, error) {
    // It doesn't make sense to retrieve the metaroot
    if hash == (common.Hash{}) {
        return nil, errors.New("not found")
    }
    // Retrieve the node from the clean cache if available
    if db.cleans != nil {
        if enc := db.cleans.Get(nil, hash[:]); enc != nil {
            memcacheCleanHitMeter.Mark(1)
            memcacheCleanReadMeter.Mark(int64(len(enc)))
            return enc, nil
        }
    }
    // Retrieve the node from the dirty cache if available
    db.lock.RLock()
    dirty := db.dirties[hash]
    db.lock.RUnlock()

    if dirty != nil {
        memcacheDirtyHitMeter.Mark(1)
        memcacheDirtyReadMeter.Mark(int64(len(dirty.node)))
        return dirty.node, nil
    }
    memcacheDirtyMissMeter.Mark(1)

    // Content unavailable in memory, attempt to retrieve from disk
    enc := rawdb.ReadLegacyTrieNode(db.diskdb, hash)
    if len(enc) != 0 {
        if db.cleans != nil {
            db.cleans.Set(hash[:], enc)
            memcacheCleanMissMeter.Mark(1)
            memcacheCleanWriteMeter.Mark(int64(len(enc)))
        }
        return enc, nil
    }
    return nil, errors.New("not found")
}
上述中内存中获取是否有该hash的节点(内存中GC回收的缓存clean cache+脏写的缓存dirty cache),如果上述中都没有该hash的节点,那么就从磁盘中检索该node(retrieve the node from the dirty cache if available).
3. Trie中的追踪器(tracer)
追踪器的作用:
追踪trie节点的改变,需要追踪从trie中删除和插入的节点. 被改变的节点可以分为两类: 叶子节点和中间节点. 前者插入和删除是由callers调用的,后者的插入和删除是因为需要满足trie的规则.
追踪器的数据结构:
type tracer struct{
    insers map[string]struct{}
    deletes map[string]struct{}
    accessList map[string][]byte
}
4. trie中的Get方法(key []byte)([]byte , error).
接口形式为:
func (t *Trie)Get(key []byte)([]byte,error){
    // Short circuit if the trie is already committed and not usable.
    if t.committed {
        return nil, ErrCommitted
    }
    value, newroot, didResolve, err := t.get(t.root, keybytesToHex(key), 0)
    if err == nil && didResolve {
        t.root = newroot
    }
    return value, err
}

根据上述的图片我们可以更好的理解trie.go中get方法:
//Param: 1. origNode表示的是root节点; 2. key是前缀的含义 3. pos是位置.
//Return: value:想要找点节点的value
func (t *Trie) get(origNode node, key []byte, pos int) (value []byte, newnode node, didResolve bool, err error) {
    switch n := (origNode).(type) {
    case nil:
        return nil, nil, false, nil
    case valueNode: //叶子节点或者分支节点的value是value node
        return n, n, false, nil
    case *shortNode: //扩展节点
        //表示当前节点上的key部分与要寻找value的Key相对应部分的key不对应
        if len(key)-pos < len(n.Key) || !bytes.Equal(n.Key, key[pos:pos+len(n.Key)]) {
            // key not found in trie
            return nil, n, false, nil
        }
        value, newnode, didResolve, err = t.get(n.Val, key, pos+len(n.Key))
        if err == nil && didResolve {
            n = n.copy() //不是深拷贝
            n.Val = newnode
        }
        return value, n, didResolve, err
    case *fullNode: //分支节点
        value, newnode, didResolve, err = t.get(n.Children[key[pos]], key, pos+1)
        if err == nil && didResolve {
            n = n.copy()
            n.Children[key[pos]] = newnode
        }
        return value, n, didResolve, err
    case hashNode: //拓展节点的value
        //从内存/磁盘中加载节点的过程.
        child, err := t.resolveAndTrack(n, key[:pos])
        if err != nil {
            return nil, n, true, err
        }
        value, newnode, _, err := t.get(child, key, pos)
        return value, newnode, true, err
    default:
        panic(fmt.Sprintf("%T: invalid node: %v", origNode, origNode))
    }
}
5. trie中的Update方法(key,value []byte)error
功能: 根据key值更新相应的value值. 如果value的值长度为0,那么就意味着从该trie中删除该节点.那么后续去Get该key时,就会返回nil.
接口的形式:
func (t *Trie) Update(key, value []byte) error
=>实际上调用的是func (t *Trie)update(key,value []byte)error
=>实际逻辑:
当value的长度为0时,表示删除该key-value;
当value的长度不为0时,表示插入/更新该key-value值.
func (t *Trie) update(key, value []byte) error {
    t.unhashed++
    k := keybytesToHex(key)
    if len(value) != 0 {// 插入/更新节点
        //首先要把value转化为valueNode
        _, n, err := t.insert(t.root, nil, k, valueNode(value))
        if err != nil {
            return err
        }
        t.root = n
    } else { // 删除节点
        _, n, err := t.delete(t.root, nil, k)
        if err != nil {
            return err
        }
        t.root = n
    }
    return nil
}

 8788


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


