聊聊BufferedInputStream和BufferedOutputStream的二三事

Java8 I/O源码-BufferedInputStream与BufferedOutputStream BufferedInputStream是缓冲输入流,作用是为另一个输入流添加一些功能,比如缓冲输入功能以及支持mark和reset方法的能力。在创建BufferedInputStream时,会在内存中创建一个内部缓冲区数组。在读取或跳过流中的字节时,可根据需要从包含的输入流一次性填充多个字节到该内部缓冲区。当程序需要读取字节时,直接从内部缓冲区中读取。当内部缓冲区中数据被读完后,会再次从包含的输入流一次性填充多个字节 阅读详情

BufferedInputStream是对InputStream的一种包装,属于设计模式中的装饰器模式。同样的,BufferedOutputStream是对OutputStream的一种包装。

关联现实世界,相当于:

假如使用FileInputStream,就像是一个快递员从仓库取出一件包裹给客户送去,再取第二件包裹给客户送去,如此往复。

而BufferedInputStream干了件什么事呢?它先从仓库里把包裹一件一件拿出来以后,先不给客户送过去,只是先用个容器给装起来,等容器装满了或者调用了flush方法或者调用了close方法,才会给客户送过去。这样的话,就提高了效率。

BufferedOutputStream也是同样的道理!


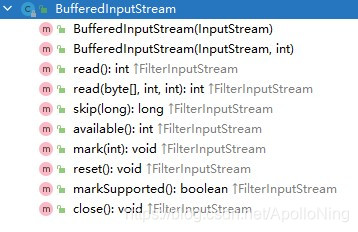
先聊聊BufferedInputStream类吧!
在这里插入图片描述

它和FileInputStream的API差不多,但是也是有区别的,比如:

boolean markSupported()

void reset()

void mark(int readlimit)

我们知道,在FileInputStream中,markSupported()返回的是false!是不支持标记功能的。但是在BufferedInputStream类中是支持的。

public boolean markSupported() {
	return true;
}

那我们就试一试!

public class BufferedInputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedInputStream bufferedInputStream = new BufferedInputStream(new FileInputStream("ThreeKind"))) {
            System.out.println("markSupported = " + bufferedInputStream.markSupported());
            System.out.println(bufferedInputStream.read());
            System.out.println(bufferedInputStream.read());
            bufferedInputStream.mark(3);//第三个位置做上标记
            System.out.println(bufferedInputStream.read());
            System.out.println(bufferedInputStream.read());
            bufferedInputStream.reset();//回到标记的位置(第三个位置)
            System.out.println(bufferedInputStream.read());
            System.out.println(bufferedInputStream.read());
        } catch (Exception exception) {
        }
    }
}

ThreeKind文件的内容是:ABCDEFG。运行结果是:

markSupported = true
65
66
67
68
67
68

可以看出,先输出了对mark功能是支持的,返回true。先输出的2个字节分别是 65 66 即 A B。此时我们在C即第三个字节做了标记,继续输出2个字节,分别是C D即 67 68。紧接着,我们reset()一下,就回到了标记处,再次输出2个字节,又是 67 68 即C D。这就是mark的功能。

好,继续看下其他的API:

  • int available()

功能类似,获取剩余的字节数。

public class BufferedInputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedInputStream bufferedInputStream = new BufferedInputStream(new FileInputStream("ThreeKind"))) {
            int available = bufferedInputStream.available();
            System.out.println("available = " + available);
        } catch (Exception exception) {
        }
    }
}
available = 7
  • long skip(long n)

功能类似,跳过指定的字节数,返回值是实际跳过的字节数。

public class BufferedInputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedInputStream bufferedInputStream = new BufferedInputStream(new FileInputStream("ThreeKind"))) {
            long skip = bufferedInputStream.skip(1);
            System.out.println("skip = " + skip);
            int data = bufferedInputStream.read();
            System.out.println("data = " + (char) data);
        } catch (Exception exception) {
        }
    }
}
skip = 1
data = B

跳过了一个字节,本来应该是输出A的,被跳过去了。

接下来就是读的API了,由于和FileInputStream的API很类似,所以就贴下代码,不做解释了。

public class BufferedInputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedInputStream bufferedInputStream = new BufferedInputStream(new FileInputStream("ThreeKind"))) {
            int data;
            while ((data = bufferedInputStream.read()) != -1) {
                System.out.print((char) data);
            }
        } catch (Exception exception) {
        }
    }
}
public class BufferedInputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedInputStream bufferedInputStream = new BufferedInputStream(new FileInputStream("ThreeKind"))) {
            int len;//读取字节数
            byte[] bytes = new byte[4];
            while ((len = bufferedInputStream.read(bytes)) != -1) {
                System.out.println("len = " + len + "bytes = " + Arrays.toString(bytes));
            }
        } catch (Exception exception) {
        }
    }
}
public class BufferedInputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedInputStream bufferedInputStream = new BufferedInputStream(new FileInputStream("ThreeKind"))) {
            int len;//读取字节数
            byte[] bytes = new byte[4];
            while ((len = bufferedInputStream.read(bytes, 1/*起始位置,从0开始*/, 2/*存放字节数组长度*/)) != -1) {
                System.out.println("len = " + len + "bytes = " + Arrays.toString(bytes));
            }
        } catch (Exception exception) {
        }
    }
}

最后,说一下BufferedInputStream的构造方法吧!很简单就2种!

public BufferedInputStream(InputStream in) {
	this(in, DEFAULT_BUFFER_SIZE);
}
public BufferedInputStream(InputStream in, int size) {
	super(in);
	if (size <= 0) {
		throw new IllegalArgumentException("Buffer size <= 0");
	}
	buf = new byte[size];
}

第一个构造方法是调用第二个构造方法的。int size参数给的是DEFAULT_BUFFER_SIZE。DEFAULT_BUFFER_SIZE是一个固定值:private static int DEFAULT_BUFFER_SIZE = 8192;

所以,可以看出,默认的缓冲大小是8192字节,就是8kb。日常来说是够用了,当然可以用第②种构造方法来修改。


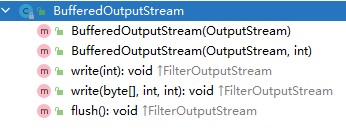
好,接下来聊一下,BufferedOutputStream,看看它的用法。
在这里插入图片描述

BufferedOutputStream并不是一个字节一个字节的往硬盘上写的,而是有个桶,就是缓冲区,先把要写的数据装进缓冲区里,然后一次性把桶里的数据写出去。

public BufferedOutputStream(OutputStream out) {
	this(out, 8192);
}
public BufferedOutputStream(OutputStream out, int size) {
	super(out);
	if (size <= 0) {
		throw new IllegalArgumentException("Buffer size <= 0");
	}
	buf = new byte[size];
}

看到,this(out, 8192);了吗?这就是调用了第二个构造方法!默认的size就是8192,就是缓冲区,大小是8kb。

那么,什么时候会往磁盘中写数据呢?

第①种:缓存区满了,写出去!

第②种:void flush()方法被调用,写出去!

第③种:void close()方法被调用,写出去!因为,close()方法被调用的时候,会先调用flush()方法。

public class BufferedOutputStreamTestClient {
    public static void main(String[] args) {
        try (BufferedOutputStream bufferedOutputStream = new BufferedOutputStream(new FileOutputStream("ThreeKind"), 4)) {
            bufferedOutputStream.write(65);
            bufferedOutputStream.flush();//调用flush()方法会将缓冲区的数据刷入到磁盘中
            bufferedOutputStream.write(66);//flush()方法将缓冲区清空,此语句执行完,缓冲区只有一个字节的数据
            bufferedOutputStream.write(67);
            bufferedOutputStream.write(68);
            bufferedOutputStream.write(69);//此条语句执行完缓冲区刚刚满,但是还未将数据刷入到磁盘中
            bufferedOutputStream.write(70);//缓冲区已经满了先将数据刷入到磁盘中,清空缓冲区,再存入一个字节
            bufferedOutputStream.write(71);
        } catch (Exception exception) {
        }
    }
}

通过调试模式,一步一步调试,进行测试:

由于,构造函数第二个参数是4,所以默认的8192被覆盖了,缓冲区的大小变成了4字节。

当write(65)时,文件中没有数据,因为,此时65被写入了缓冲区,还没到磁盘;

当flush()方法被调用时,文件中有了A字母。此时的缓冲区被清空了。

接下来的数据都被写入的缓冲区,直到write(70)时,发现缓冲区满了,此时将缓冲区的数据写入磁盘中,并将缓冲区清空,将70写入缓冲区。

当write(71)时,文件中只有ABCDE,即65 66 67 68 69,此时的 70 和 71 还未写入到文件中。

直到,准备跳出try代码块,程序会自动调用close方法,为什么?原因在FileInputStream一文的开始就说了,在这里就不罗嗦了。close方法又会调用flush方法,所以,此时,FG才会写入文件中。

以上就是关于BufferedInputStream和BufferedOutputStream的全部内容!不知客官欣赏的是否尽兴,评论区聊聊?
Java后端Word转PDF全方案:从Aspose到开源docx4j的实战与避坑 文档格式转换是数据处理与系统集成中的常见需求,其核心原理在于将源文档的结构化内容与样式信息,通过特定的渲染引擎重新绘制为目标格式。在Java生态中,实现高保真、跨平台的Word转PDF功能,对保障数据安全、实现自动化流程具有重要技术价值,尤其适用于OA、CMS、知识库等需要文档预览与归档的内部系统。针对这一需求,开发者需在商业库与开源方案间做出权衡:Aspose.Words以其卓越的保真度和易用性成为企业级首选,而基于docx4j与Apache FOP的开源组合则提供了可控的替代路径。无论选择哪条技术路线, 阅读详情

相关推荐

搭建微信机器人的方案都在这了!

功能超级强大,虽不支持二次开发,但已有的功能足够个人使用,可惜官方作品已被腾讯告死,好在市面上还流落着不少破解版,有需要的自行搜索。可惜的是,微信官方已不准许新的微信号再使用 web 登录,这就直接从源头扼杀了 web 协议的微信机器人,虽说老的微信号还是能凑合着用,不过部分功能也受限。所以,这些都属于 PC 端的微信机器人。无论是 PC 端还是手机端,用 hook 方式实现的最大缺点就是要和某一个版本的微信客户端进行绑定,如果框架本身不对最新版本的微信适配,那使用的时候就无法升级到最新版本的微信。

weixin_47246330的博客 1万+

Java学习16(IO设计模式)

Java学习

ldy007714的博客 821

FDTD Script命令学习-farfield3d/farfieldux/farfielduy

介绍了farfield3d/farfieldux/farfielduy命令功能,及不同应用语法和参数介绍,以及对官网示例进行介绍。

jxxl_1314的博客 3098

BufferedInputStream 和 BufferedOutputStream流

1. 简介 BufferedInputStream / BufferedOutputStream流字节缓冲流,字节缓冲流通常需要配合InputStream / OutputStream类衍生出的字节流类使用,这两个流是用来加快读取/写入速度的。 具体的功能就是下图蓝色圈指出的。说白了就是减少内存和外部磁盘的交互次数。 而是否使用字节数组一次性读取多个字节是红色框指出的。说白了就是减少程序频繁去内存中读取数据。 2. BufferedInputStream字节输入缓冲流 1. 两种构造方法 //

weixin_43808717的博客 1054

宏基因组功能注释实战:从CAZyme到VFDB的完整流程(含数据库下载与脚本优化)

本文详细介绍了宏基因组功能注释的完整流程,涵盖CAZyme、eggNOG、CARD和VFDB四大核心数据库的实战应用。从环境配置、数据库下载与预处理到注释流程执行与优化,提供了全面的操作指南和脚本优化建议,帮助研究人员高效完成宏基因组数据分析。特别针对CAZyme注释等关键步骤给出了参数优化方案和常见问题排查方法。

weixin_29289821的博客 295

马尔可夫网络和贝叶斯网络的一些总结

马尔可夫网络和贝叶斯网络的一些总结 最近学习了一些关于概率逻辑的知识图谱推理方法,主要就是贝叶斯网络和马尔可夫网络,在此总结一下,内容都来自网络资料,这里加入了一下个人的理解,尽量为大家避雷! 这篇文章是我目前在网络上找到的关于贝叶斯网络最清晰的介绍,大家有兴趣可以去看看 贝叶斯网络中比较重要的两部分就是贝叶斯网络的结构和条件概率表。 贝叶斯网络的结构 下面通过一个例子来介绍: 贝叶斯网的网络结...

qq_43654303的博客 4372

IO流:BufferedOutputStream 一定比 FileOutputStream 快吗?

FilteOutputStream 不带缓冲的操作(FilteOutputStream类和FilteInputStream类),每读一个字节就要写入一个字节,由于涉及磁盘的IO操作相比内存的操作要慢很多,所以在读写的字节比较少的情况下,效率比较低; FileOutputStream fileOutputStream = new FileOutputStream("D:\\1.txt"); BufferedOutputStream BufferedOutputStream是带缓冲区的输出流,不管是Buffe

叶新东老师的博客 2533

QT使用libssh2库通过密匙实现sftp协议上传文件

qt下使用libssh2通过密匙连接sftp服务器端

小米的修行之路 941

BufferedOutputStream和BufferedInputStream字节缓冲流如何使用呢?

有关BufferedOutputStream和BufferedInputStream流的使用,它的构造方法是什么,怎么样去使用,这里给出了详细的使用案例。另外,既然这两个类被称为高效类,那肯定速度是very good!我最后做了个文件复制的操作来观察它的执行速度,果然是非常的快。...

JavaNewMans的博客 1550

Claude Code 100个真实案例 - 用AI做数据可视化大屏(ECharts+实时数据)

数据报表看着枯燥?领导汇报缺少视觉冲击力?是时候做一个酷炫的数据可视化大屏了!本案例将用 Claude Code 从零搭建一个实时数据可视化大屏,使用 ECharts 实现折线图、柱状图、饼图、地图、仪表盘等多种图表,配合 WebSocket 实现秒级数据刷新,深色主题科技感拉满!

yueyeguzhuo的专栏 196

【AI大模型】DeepSeek + Kimi 高效制作PPT实战详解

AI赋能,使用DeepSeek 高效制作PPT实战详解

congge 1万+

BufferedInputStream及相关类介绍

关于BufferedInputStream 是java提供的具有缓存作用的字节输入流。与之对应的还有BufferedOutStream 和 BufferedRead 和BufferedWriter 这4个都是FilterOutStream的子类。该使用装饰者模式对基础的InputStream进行装饰,并提供了缓存作用。 关于缓冲数组的作用 由于CPU、内存、硬盘三者的速率不匹配, 我们知道...

xhn_swh的博客 567

代谢组数据分析(二十八):基于广义估计方程(GEE)的方法探究代谢物与临床表型相关性

本研究利用广义估计方程(GEE)方法对代谢组学数据进行了深入分析,旨在探究代谢物与临床表型之间的相关性。代谢组学数据具有高维性、样本间相关性以及混杂因素的复杂性,传统的统计方法难以有效处理这些问题。GEE方法通过引入相关性结构,能够有效地处理样本间的相关性,并同时调整多个混杂因素,从而提高了分析结果的准确性和可靠性。

专注生信领域 1277

I/O---BufferedInputStream及相关类介绍

关于BufferedInputStream 是java提供的具有缓存作用的字节输入流。与之对应的还有BufferedOutStream 和 BufferedRead 和BufferedWriter 这4个都是FilterOutStream的子类。该使用装饰者模式对基础的InputStream进行装饰,并提供了缓存作用。 关于缓冲数组的作用 由于CPU、内存、硬盘三者的速率不匹配.我...

177

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

简单聊聊对IO中的缓冲流理解

缓冲流可以提高字节流和字符流的读写数据的性能 BufferedInputStream 是 Java 编程语言中的一个类,它为输入流提供缓冲。它用于从源(如文件或网络连接)读取数据,并将数据存储在缓冲区中。这可以通过减少所需的单个读取操作的数量来提高输入操作的效率。 BufferedOutputStream 是 Java 编程语言中的一个类,它为输出流提供缓冲。它用于将数据写入目的地,例如文件或网络连接,并将数据存储在缓冲区中。这可以通过减少所需的单个写入操作的数量来提高输出操作的效率。

Javatutouhouduan的博客 841

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Java IO流实战:用字节缓冲流复制大文件,效率提升300%的秘诀

本文深入解析Java IO流中字节缓冲流的工作原理,通过对比测试数据揭示其如何将大文件复制效率提升300%以上。文章详细阐述了减少系统调用、合理设置缓冲区大小等核心优化秘诀,并提供了包括NIO transferTo方法在内的实战代码与最佳实践,帮助开发者彻底解决Java处理大文件时的性能瓶颈。

mac99的博客 1007

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

简单聊聊IO流

IO流分类 * IO流 * 字节流 字符流 * 字节输入流 字节输出流 字符输入流 字符输出流 * InputStream ...

zzm0707的博客 251

java对文件内容操作 -- 输入输出流

目录 InputStream(输入字节流)和OutputStream(输出字节流) Reader(字符输入流)与Writer(字符输出流) Print 流 我们通过对File类的学习, 了解到File类并不能去操作文件的内容,可以操作文件内容的则是以下这些实现类,现在来一一介绍 InputStream(输入字节流)和OutputStream(输出字节流) 在谈这两个类之前,我们先来聊聊,什么是输入和输出呢 , 简单理解的话,我们编写的程序就相当于一个中转站, 首先将一个文件的内容输入...

xx12321q的博客 3513

[03] 节点流和处理流

1、节点流和处理流的概念根据输入输出方式不同,我们划分了输入流和输出流;根据处理数据流的单位不同,我们划分了字节流和字符流;现在我们根据数据封装类型的不同划分节点流和处理流。节点流如果流封装的是某种特定的数据源,如文件、字符串、字符串数组等,则称为节点流处理流如果流封装的是其他的流对象,称之为处理流。处理流提供缓冲功能,提高读写效率2、节点流和处理流的常用类节点流中常用类:字节输入流 FileIn...

weixin_30379531的博客 169

JAVA中如何实现代码优化(技巧讲解)

博主传送门:

退役复学在校大学生,目光所至,皆为华夏 6万+

Java I/O流详解:字节流与字符流的本质区别、编码问题与性能优化

在计算机编程中,输入输出(I/O)是数据交换的基础,而流(Stream)是实现这一过程的核心机制。从底层原理看,所有数据在存储和传输时都以二进制字节形式存在,字节流(如InputStream/OutputStream)正是处理这种原始数据的通用工具,它不关心数据语义,适用于图像、音频等任意二进制文件。然而,当处理文本数据时,字符编码(如UTF-8、GBK)成为关键,字符流(如Reader/Writer)在此基础上构建,通过自动编解码将字节序列转换为有意义的字符,从而避免乱码问题。这种设计体现了装饰器模式,允

weixin_34208185的博客 306

JavaIO流:文件复制实战指南

文本文件复制:优先使用,高效、便捷、对中文友好,是处理文本文件的首选。任意文件复制:必须使用,它是真正的万能复制工具,支持所有文件类型,效率极高。掌握这两种文件复制方式,无论是日常开发还是竞赛面试,都能轻松应对。

Qhh200012284140的博客 183

Java实现AES-GCM-256加密:原理、代码实践与生产环境部署指南

对称加密是保障数据机密性的基础技术,其中AES作为国际标准算法,通过分组加密模式实现高效安全的数据保护。GCM模式将加密与认证机制深度融合,在CTR模式基础上集成伽罗瓦域认证,一次性提供机密性、完整性和身份验证,解决了传统模式需分步操作的繁琐与安全隐患。该技术显著提升了开发效率与运行性能,特别适用于微服务通信、数据库字段保护等高安全要求场景。本文以AES-GCM-256为例,详解其核心原理,并给出包含密钥管理、异常处理的生产级Java实现方案,涵盖从基础概念到微服务落地的完整实践路径。

weixin_34357887的博客 352

节点流和处理流 字符处理流BufferedReader、BufferedWriter,字节处理流-BufferedInputStream和BufferedOutputStream (代码均正确且可运行

节点流和处理流 对象处理流-ObjectInputStream和ObjectOutputStream字符处理流BufferedReader、BufferedWriter,字节处理流-BufferedInputStream和BufferedOutputStream (代码均正确且可运行)

weixin_73936404的博客 1487

BufferedOutputStream,BufferedInputStream是字节流,对象处理流,序列化,输入输出流,转换流

InputStreamReader:Reader的子类,可以将InputStream(字节流)包装成(转换)Reader(字符流)OutputStreamWriter:Writer的子类,实现将OutputStream(字节流)包装成Writer(字符流)当处理纯文本数据时,如果使用字符流效率更高,并且可以有效解决中文问题,所以建议将字节流转换成字符流。序列化具备可继承性,也就是如果某类已经实现了序列化,则它的所有子类也已经默认实现了序列化。序列化对象时,要求里面属性的类型也需要实现序列化接口。

weixin_43669384的博客 2013
上一篇: 聊聊FileReader文件输入流的二三事
下一篇: 聊聊BufferedWriter和BufferedReader的二三事
盖了帽
博客等级 码龄8年 17粉丝 62原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值