


一、安装 Ollama
1.1 下载和安装
Ollama 是一个强大的本地大模型运行框架,支持多种开源模型。以下是安装步骤:
Windows 系统安装:
- 访问 Ollama 官网 (https://ollama.com/)
- 下载 Windows 版本安装包
- 双击安装包完成安装
- 打开命令行终端,验证安装:
ollama --version
macOS 系统安装:
# 使用 Homebrew 安装brew install ollama# 或者下载手动安装包# 启动 Ollama 服务ollama serve
Linux 系统安装:
# 使用一键安装脚本curl -fsSL https://ollama.ai/install.sh | sh# 或者使用 Dockerdocker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
1.2 基本使用和配置
安装完成后,进行基本配置:
# 查看已安装的模型ollama list# 运行一个测试模型ollama run llama3.2# 查看运行状态ollama ps
1.3 Python 客户端安装
pip install ollama
二、下载模型 BGE-M3
2.1 BGE-M3 模型介绍
BGE-M3因其在多语言、多功能和多粒度方面的能力而得名。BGE-M3 能够支持 100 多种语言,为多语言和跨语言检索任务树立了新的标杆。它在单一框架内执行密集检索、多向量检索和稀疏检索的独特能力,使其成为各种信息检索(IR)应用的理想选择。支持:
- 多语言文本嵌入
- 密集向量检索
- 多向量检索
- 稀疏向量检索
- 多任务学习
2.2 通过 Ollama 下载模型
# 下载 bge-m3 模型ollama pull bge-m3# 验证模型下载ollama list
2.3 模型测试
import ollama# 测试模型响应response = ollama.embeddings( model='bge-m3', prompt='你好,这是一个测试句子')print(f"嵌入向量长度: {len(response['embedding'])}")
三、文档提取(PDF、Word)
3.1 安装必要的库
pip install pypdf2 python-docx pdfminer.six unstructured
3.2 PDF 文档提取
import PyPDF2from pdfminer.high_level import extract_textimport osdef extract_text_from_pdf(pdf_path): """ 从 PDF 文件中提取文本内容 """ text = "" try: # 使用 PyPDF2 with open(pdf_path, 'rb') as file: pdf_reader = PyPDF2.PdfReader(file) for page in pdf_reader.pages: text += page.extract_text() + "\n" except: try: # 使用 pdfminer text = extract_text(pdf_path) except Exception as e: print(f"提取 PDF 文本失败: {e}") return text
3.3 Word 文档提取
from docx import Documentimport docx2txtdef extract_text_from_docx(docx_path): """ 从 Word 文档中提取文本内容 """ try: # 使用 python-docx doc = Document(docx_path) text = '\n'.join([paragraph.text for paragraph in doc.paragraphs]) # 如果提取的内容过少,尝试使用 docx2txt if len(text.strip()) < 100: text = docx2txt.process(docx_path) except Exception as e: print(f"提取 Word 文档文本失败: {e}") text = "" return text
3.4 文档处理
import osfrom pathlib import Pathclass DocumentProcessor: def __init__(self): self.supported_formats = ['.pdf', '.docx', '.doc', '.txt'] def process_document(self, file_path): """ 统一处理各种格式的文档 """ file_path = Path(file_path) if not file_path.exists(): raise FileNotFoundError(f"文件不存在: {file_path}") file_ext = file_path.suffix.lower() if file_ext == '.pdf': content = extract_text_from_pdf(file_path) elif file_ext in ['.docx', '.doc']: content = extract_text_from_docx(file_path) elif file_ext == '.txt': with open(file_path, 'r', encoding='utf-8') as f: content = f.read() else: raise ValueError(f"不支持的文档格式: {file_ext}") return { 'content': content, 'file_name': file_path.name, 'file_size': os.path.getsize(file_path) } def process_directory(self, directory_path): """ 处理目录中的所有支持文档 """ directory_path = Path(directory_path) documents = [] for file_path in directory_path.iterdir(): if file_path.suffix.lower() in self.supported_formats: try: document = self.process_document(file_path) documents.append(document) print(f"成功处理: {file_path.name}") except Exception as e: print(f"处理失败 {file_path.name}: {e}") return documents
四、知识库系统实现
4.1 文本预处理和分块
import refrom typing import Listimport numpy as npfrom langchain_text_splitters import RecursiveCharacterTextSplitterimport ollamaclass TextPreprocessor: def __init__(self, chunk_size=512, overlap=0): self.chunk_size = chunk_size self.overlap = overlap def clean_text(self, text): """ 清理文本内容 """ # 移除多余的空白字符 text = re.sub(r'\s+', ' ', text) # 移除特殊字符(保留中文、英文、数字和基本标点) text = re.sub(r'[^\w\u4e00-\u9fff\s\.\,\!\?\;\\]', '', text) return text.strip() def split_into_chunks(self, text): """ 将长文本分割成 chunks,使用 langchian 来处理 """ chunks = [] text_splitter = RecursiveCharacterTextSplitter(chunk_size=self.chunk_size, chunk_overlap=self.overlap) chunks = text_splitter.split_text(text) # 过滤掉空块 chunks = [chunk.strip() for chunk in chunks if chunk.strip()] return chunksclass KnowledgeBase: def __init__(self, embedding_model): self.embedding_model = embedding_model self.documents = [] self.embeddings = [] self.metadata = [] self.preprocessor = TextPreprocessor() def add_document(self, content, file_name): """ 添加文档到知识库 """ self.metadata['file_name'] = file_name cleaned_content = self.preprocessor.clean_text(content) chunks = self.preprocessor.split_into_chunks(cleaned_content) for i, chunk in enumerate(chunks): self.documents.append(chunk) def get_embedding(self, chunk): """ 字符串转向量(embeddings) :param chunk: 块内容 :return: 向量array """ # print(chunk) # milkey/m3e 0.642084887746903 # bge-m3 0.6073383067378445 res = ollama.embeddings(model=self.embedding_model, prompt=chunk) # print(res) # print(res['embedding']) return res['embedding'] def generate_embeddings(self): """ 为所有文档生成嵌入向量 """ print("正在生成嵌入向量...") self.embeddings = [] for i, doc in enumerate(self.documents): try: eb = self.get_embedding(doc) self.embeddings.append(eb) if (i + 1) % 10 == 0: print(f"已处理 {i + 1}/{len(self.documents)} 个文档块") except Exception as e: print(f"生成嵌入向量失败: {e}") self.embeddings.append(None) # 移除生成失败的项目 valid_indices = [i for i, emb in enumerate(self.embeddings) if emb is not None] self.documents = [self.documents[i] for i in valid_indices] self.embeddings = [self.embeddings[i] for i in valid_indices] self.embeddings = np.array(self.embeddings) print(f"嵌入向量生成完成,共 {len(self.embeddings)} 个有效向量")
4.2 向量检索和相似度计算
from sklearn.metrics.pairwise import cosine_similarityimport numpy as npclass VectorRetriever: def __init__(self, knowledge_base): self.kb = knowledge_base def search(self, query, top_k=5): """ 搜索相关知识片段 """ # 生成查询的嵌入向量 try: eb = self.kb.get_embedding(query) query_embedding = np.array(eb).reshape(1, -1) except Exception as e: print(f"查询嵌入生成失败: {e}") return [] # 计算余弦相似度 if len(self.kb.embeddings) == 0: return [] similarities = cosine_similarity(query_embedding, self.kb.embeddings) top_indices = similarities.argsort()[0][-top_k:][::-1] results = [] for idx in top_indices: results.append({ 'document': self.kb.documents[idx], 'similarity': similarities[0][idx] }) return results def batch_search(self, queries, top_k=3): """ 批量搜索 """ results = {} for query in queries: results[query] = self.search(query, top_k) return results
4.3 知识问答系统
import ollamaclass KnowledgeQA: def __init__(self, knowledge_base): self.kb = knowledge_base self.retriever = VectorRetriever(knowledge_base) def answer_question(self, question, context_window=3): """ 基于知识库回答问题 """ # 检索相关文档片段 relevant_docs = self.retriever.search(question, top_k=context_window) if not relevant_docs: return "抱歉,在知识库中没有找到相关信息。" # 构建上下文 context = "\n".join([f"[来源: {doc['metadata'].get('file_name', '未知')}]\n{doc['document']}" for doc in relevant_docs]) # 构建提示词 prompt = f"""基于以下上下文信息,请回答问题。 上下文: {context} 问题:{question} 请根据上下文提供准确、简洁的回答。如果上下文中的信息不足以回答问题,请如实告知。""" try: # 使用 Ollama 生成回答 response = ollama.chat( model='llama3.2', # 可以使用其他模型 messages=[{'role': 'user', 'content': prompt}] ) return response['message']['content'] except Exception as e: return f"生成回答时出错: {e}" def get_sources(self, question, top_k=3): """ 获取答案的来源信息 """ relevant_docs = self.retriever.search(question, top_k=top_k) return [ { 'content': doc['document'], 'similarity': doc['similarity'], 'source': doc['metadata'].get('file_name', '未知'), 'chunk_id': doc['metadata'].get('chunk_id', 0) } for doc in relevant_docs ]
4.4 示例代码
import osfrom pathlib import Pathdef build_knowledge_base(documents_dir): """ 构建完整知识库的示例函数 """ # 初始化处理器和知识库 processor = DocumentProcessor() kb = KnowledgeBase() # 处理文档 print("开始处理文档...") documents = processor.process_directory(documents_dir) # 添加到知识库 for doc in documents: kb.add_document(doc['content'], doc['file_name']) # 生成嵌入向量 kb.generate_embeddings() return kbdef main(): # 设置文档目录 docs_dir = "./knowledge_documents" # 构建知识库 print("构建知识库中...") knowledge_base = build_knowledge_base(docs_dir) # 初始化问答系统 qa_system = KnowledgeQA(knowledge_base) # 示例问答 questions = [ "什么是机器学习?", "请总结文档中的主要内容", "有哪些重要的技术概念?" ] for question in questions: print(f"\n问题: {question}") answer = qa_system.answer_question(question) print(f"回答: {answer}") # 显示来源 sources = qa_system.get_sources(question) print("\n来源信息:") for source in sources: print(f"- {source['source']} (相似度: {source['similarity']:.3f})")if __name__ == "__main__": main()
总结
–
本文详细介绍了如何使用 Python + Ollama + BGE-M3 构建一个完整的本地知识库系统。这个系统具备以下特点:
- 易于部署:全部组件都可以在本地运行,无需网络连接
- 多格式支持:支持 PDF、Word、TXT 等多种文档格式
- 高效检索:基于 BGE-M3 嵌入模型提供准确的语义搜索
- 智能问答:结合大语言模型提供自然语言问答功能
这个知识库系统适合企业文档管理、个人知识整理、学术研究等场景,既保护了数据隐私,又提供了强大的知识检索能力。
改进方向:
- 支持更多文档格式(如 PPT、Excel 等)
通过这个系统,可以轻松地将文档资料转化为结构化的智能知识库。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
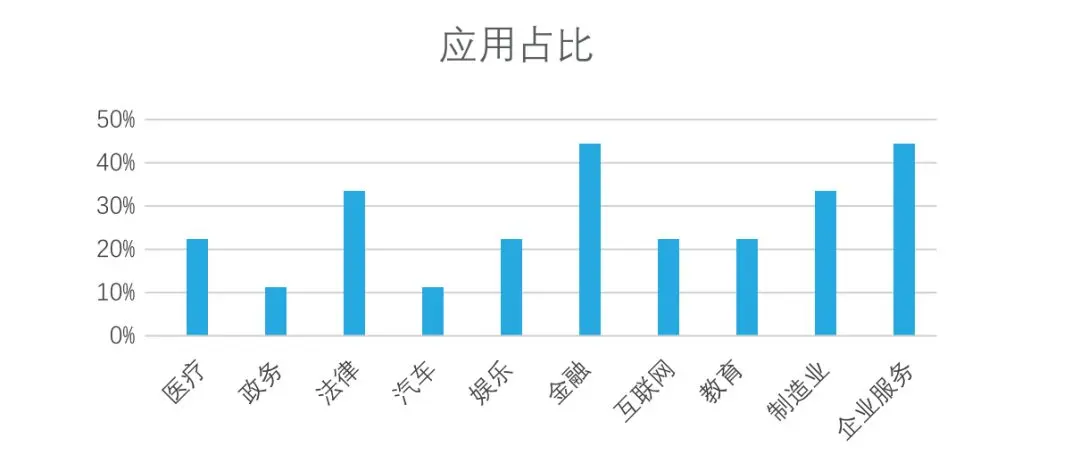
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
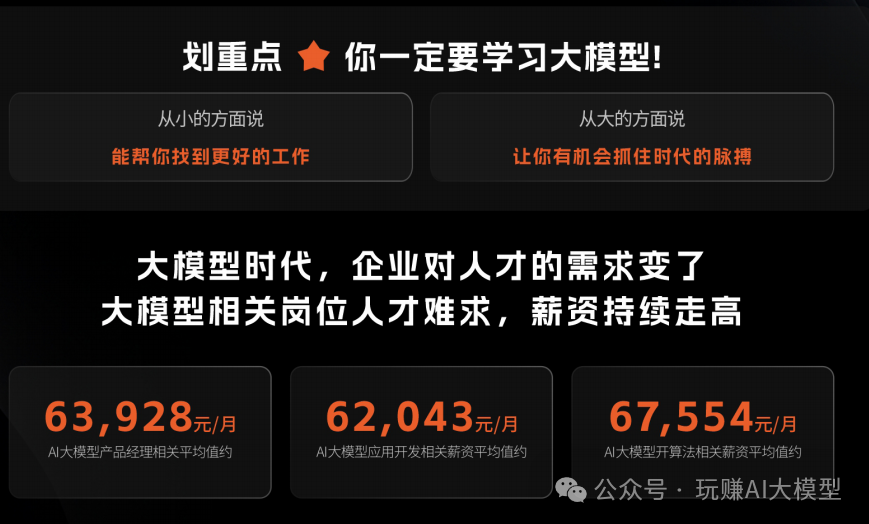
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。
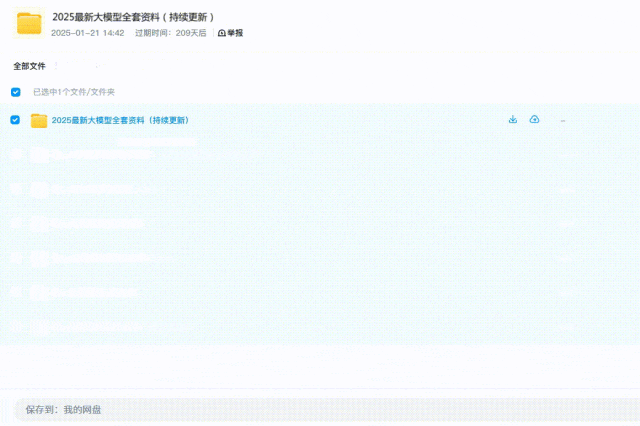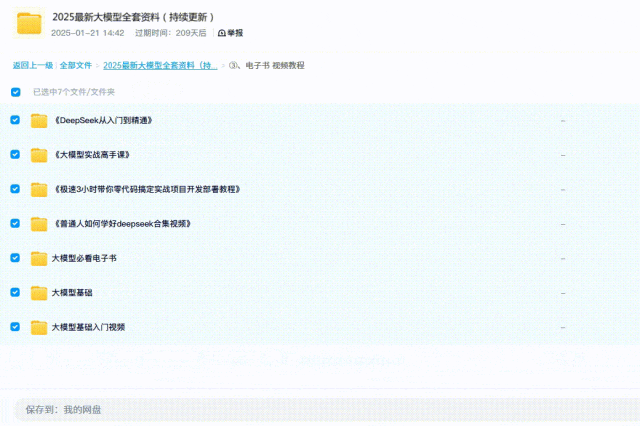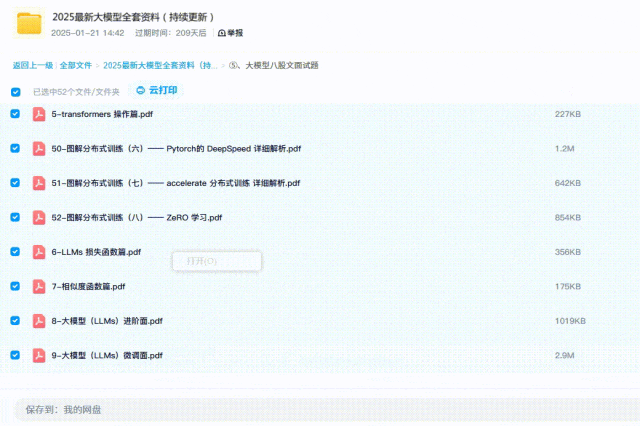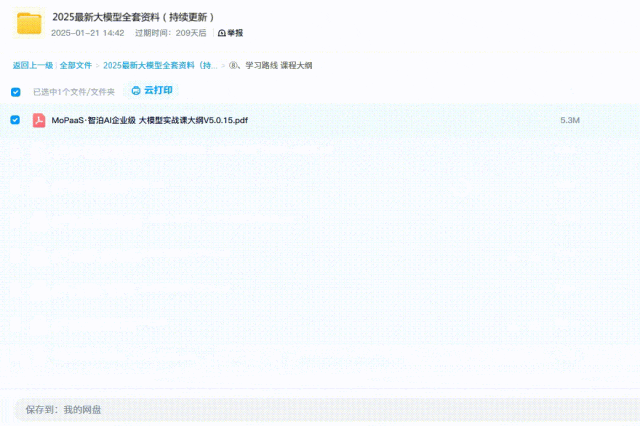
希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
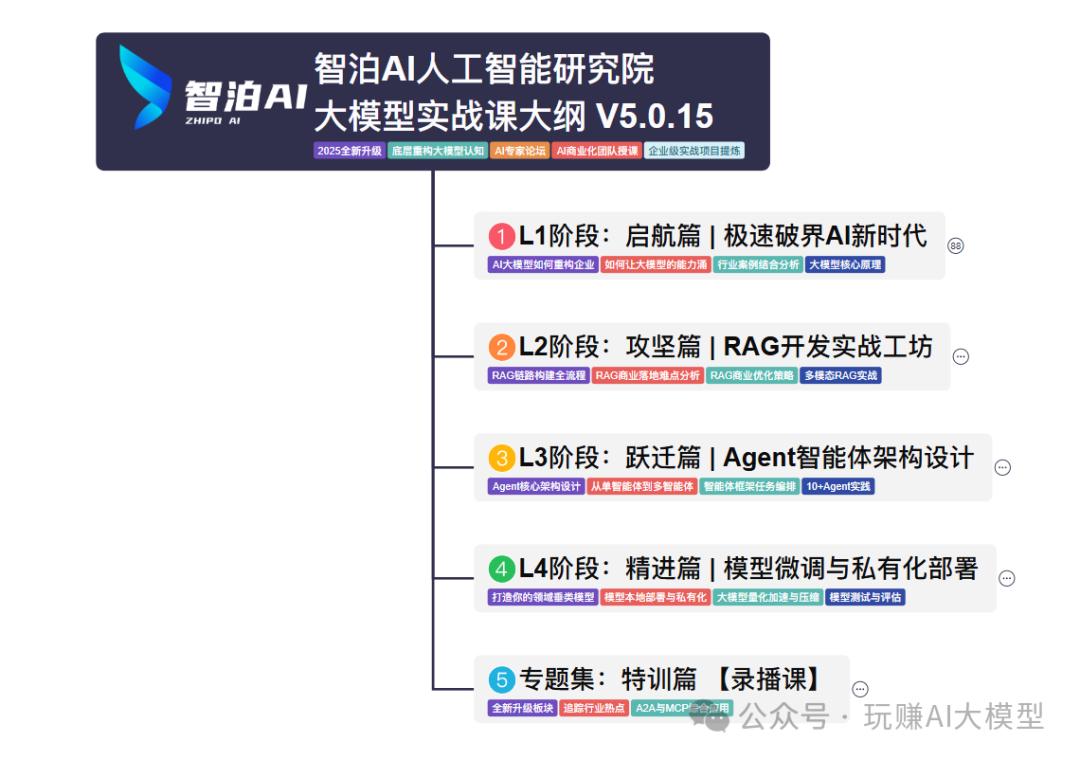
01 教学内容
-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
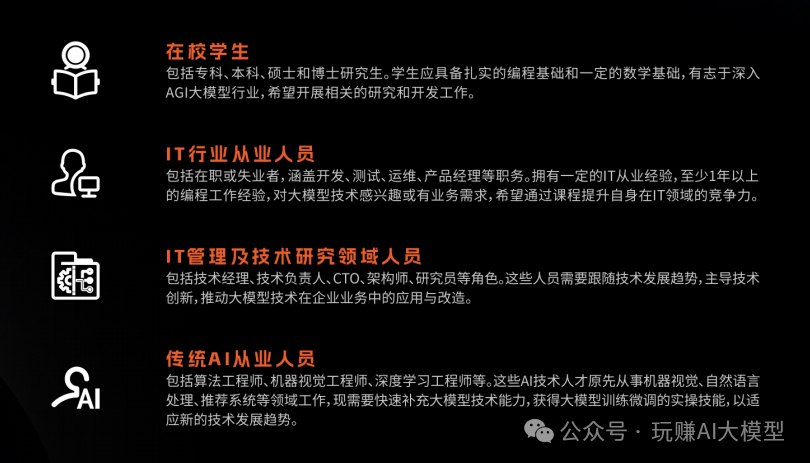
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
vx扫描下方二维码即可
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
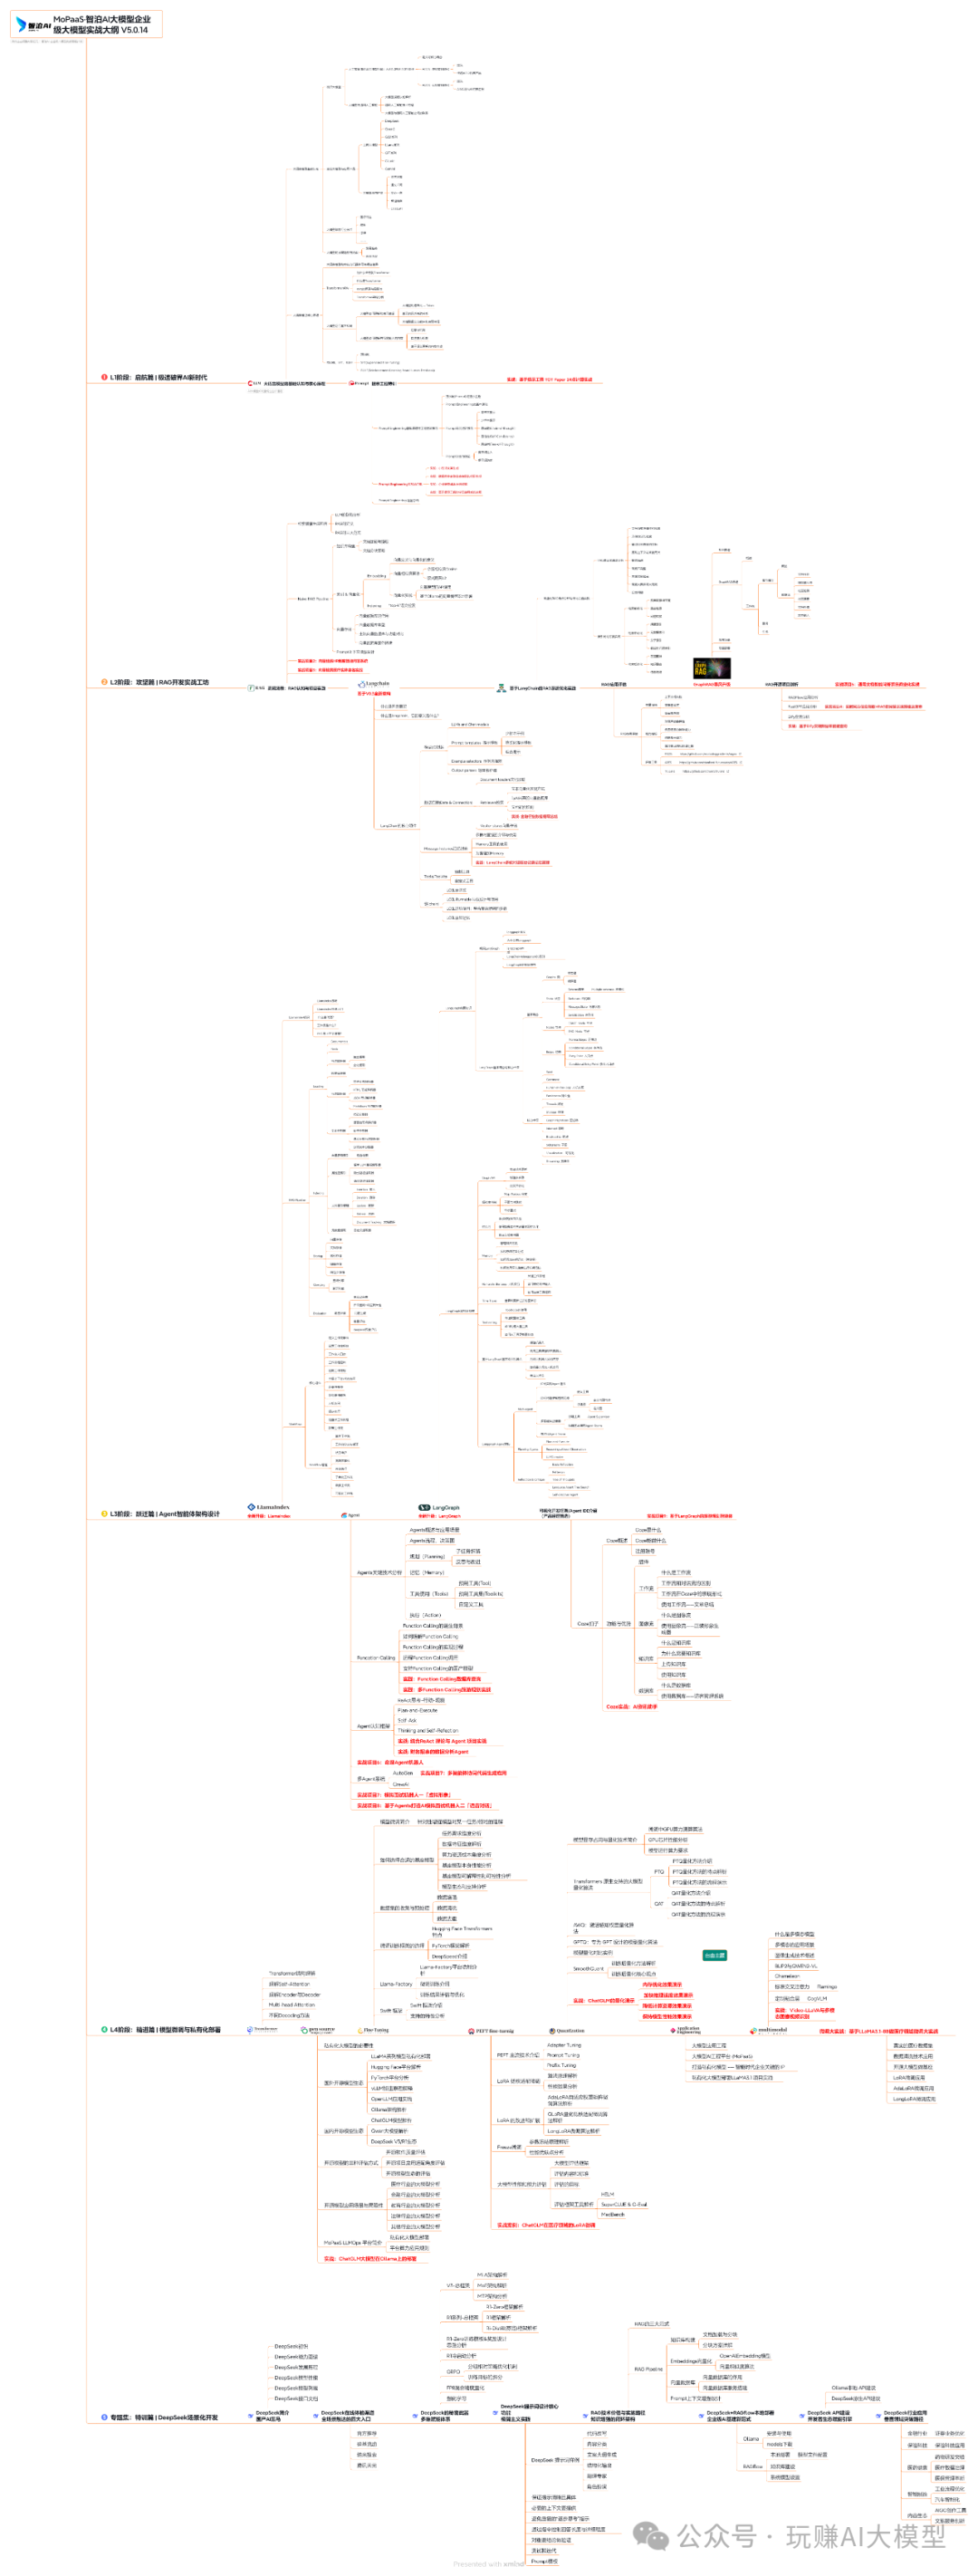
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:
04 视频和书籍PDF合集
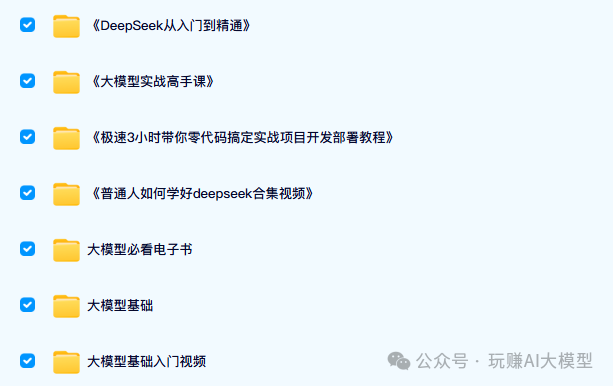
从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)
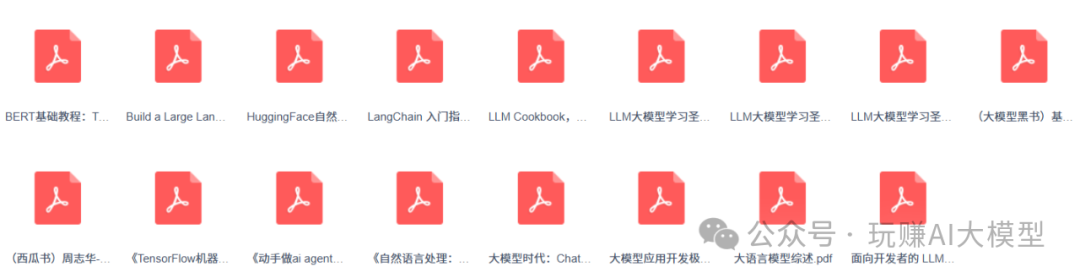
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)
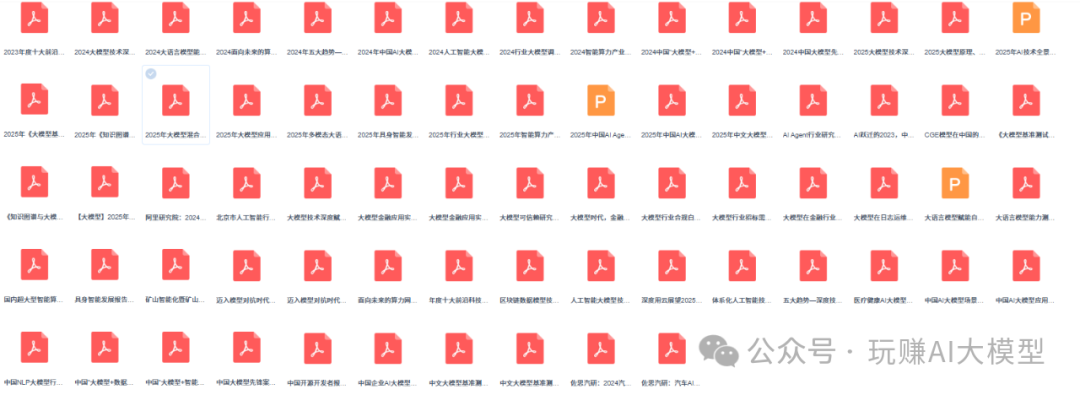
05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)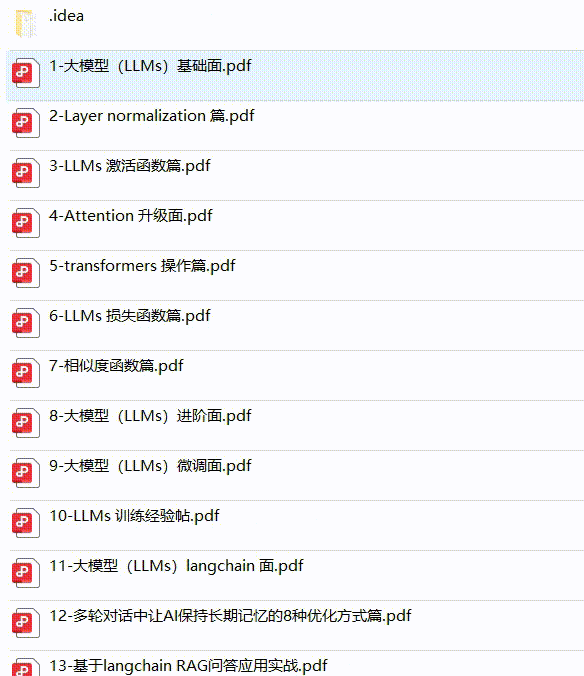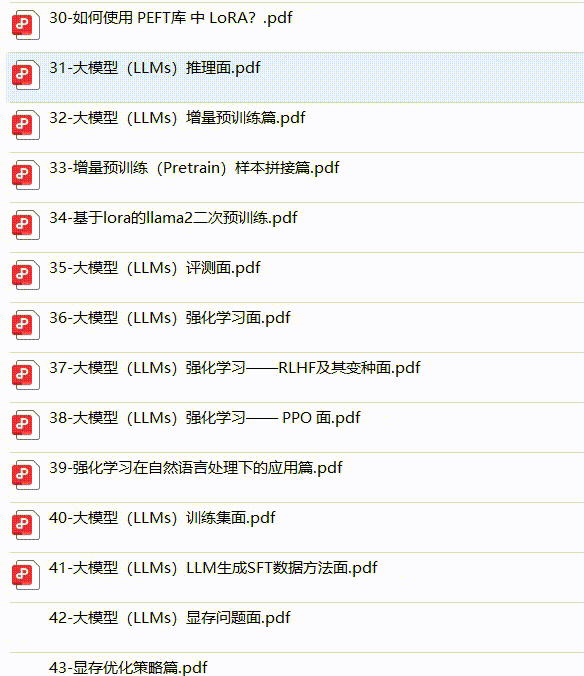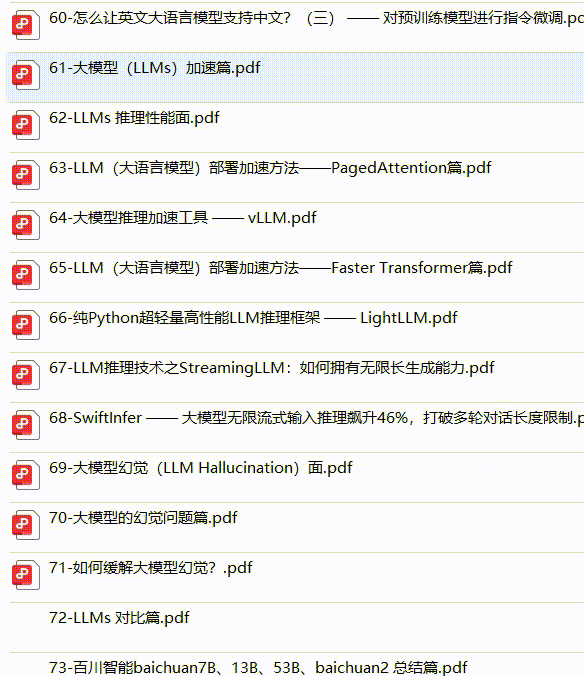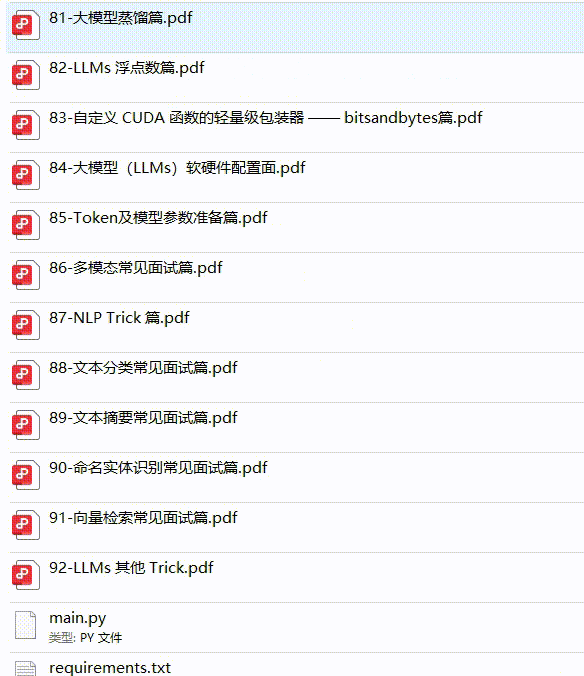
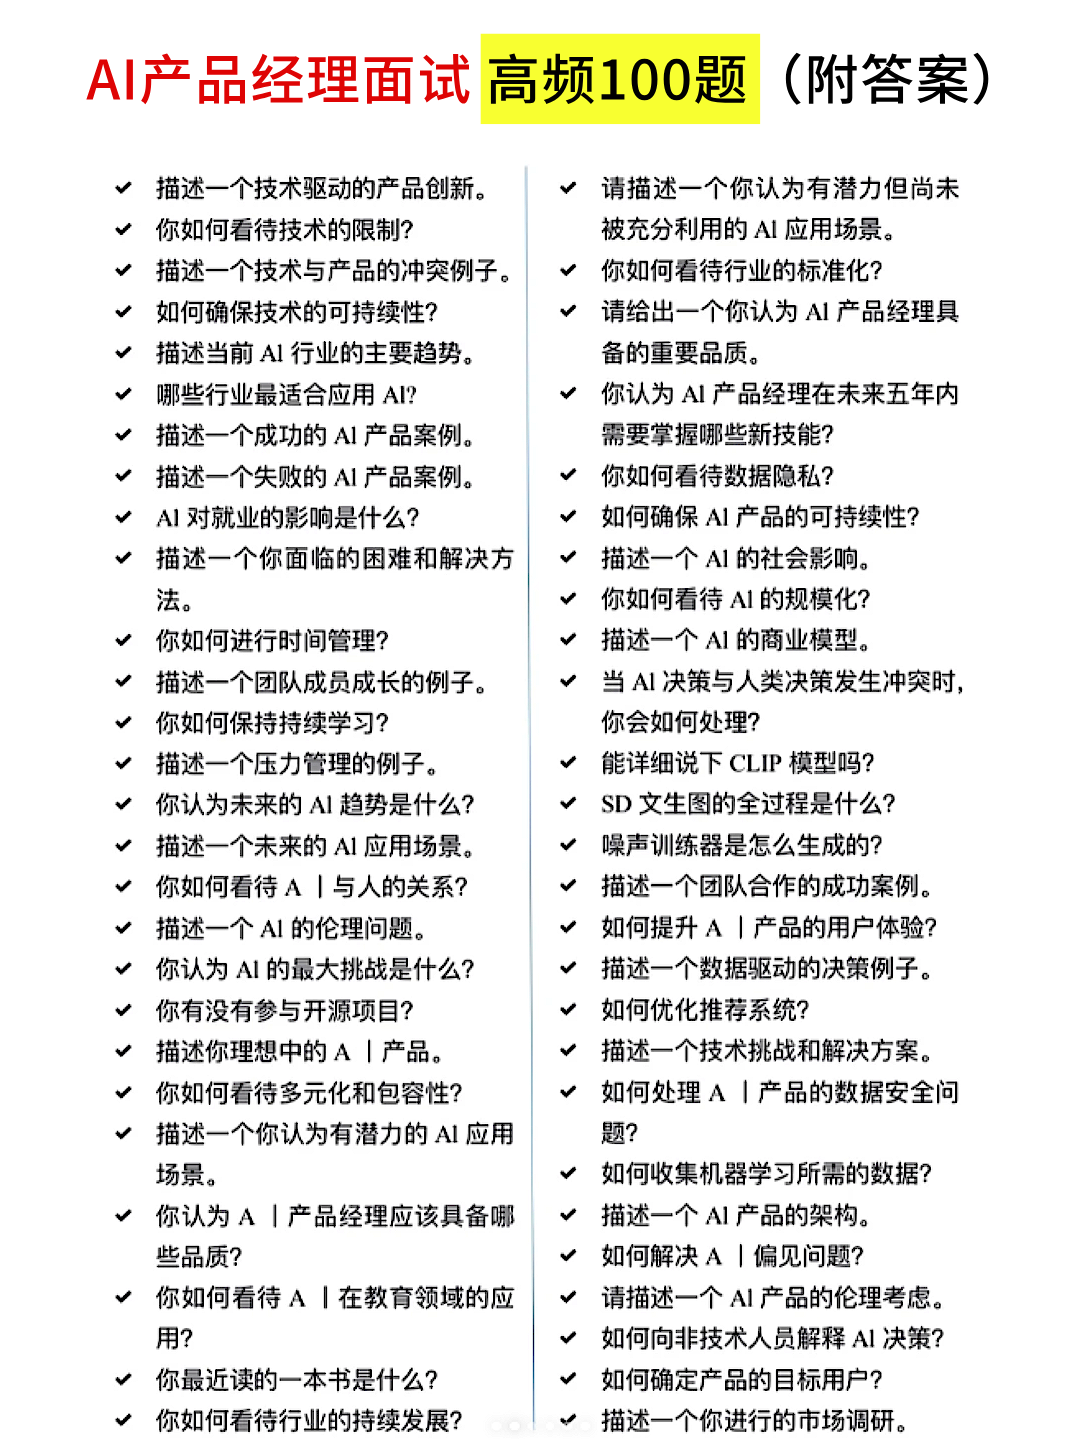
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
 368


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


