


1 引言
在当今动态的商业环境中,检索增强生成(Retrieval-Augmented Generation, RAG)代表着AI模型处理复杂任务的革命性转变。通过将实时数据检索能力与先进文本生成技术相结合,RAG能够提升决策效率、自动化业务流程,并生成高度精准且具备上下文感知能力的响应。这种集成化方案为寻求在客户服务、内容创作、市场情报等领域拓展业务的企业提供了强有力的解决方案。
2 RAG的工作原理
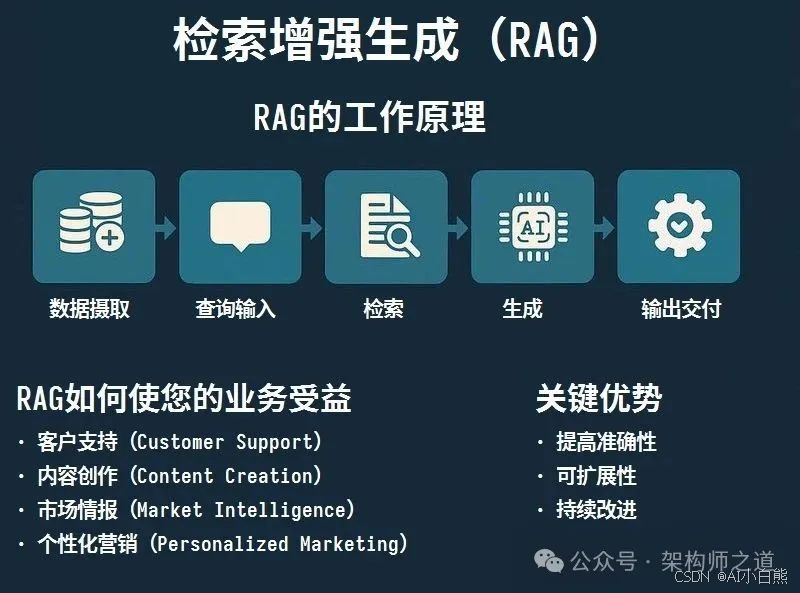
1)数据摄取(Data Ingestion)与知识库构建:从企业文档、网页抓取、API集成及定制化内容中收集并预处理多样化数据集,构建供AI调用的综合知识库。
2)查询输入(Query Input):用户通过聊天机器人、客户门户或搜索引擎等接口提交查询,RAG模型对自然语言输入进行处理以理解意图。
3)检索(Retrieval)过程:系统从知识库中检索相关文档或信息,采用语义搜索、向量搜索等先进技术确保定位最相关内容,并通过排序算法优先呈现高关联度结果。
4)内容生成(Generation):检索完成后,AI利用Qwen-3、T5等先进语言模型生成上下文精准的响应,整合检索文档中的洞见以形成清晰、相关且定制化的回答。
5)后处理环节:对生成的响应进行优化,确保内容清晰准确且符合用户意图,包括事实核查、上下文调整及语气修饰等,以匹配企业需求。
6)输出交付(Output Delivery):最终输出以自然语言文本、结构化数据或聊天机器人交互响应等所需格式交付。
2.1 RAG的核心优势
1)提高准确性(Increased Accuracy):通过从知识库中检索最相关信息,确保生成内容的高度针对性。
2)决策效率提升:实时检索与生成能力支持企业快速响应客户咨询或分析市场变化,加速决策进程。
3)可扩展性(Scalability)解决方案:随业务增长,RAG可无缝扩容以处理更大规模的查询、内容生成与分析任务,无需成比例增加人力投入。
4)持续改进(Continuous Improvement)能力:通过反馈循环机制,RAG从历史交互中学习优化,响应准确性与效率随时间持续提升。
2.2 RAG的应用场景
RAG可无缝集成到各类业务场景中,提升效率、准确性与可扩展性,以下是RAG技术在不同业务场景中的具体应用:
1)客户支持自动化
-
运作机制
:RAG从知识库、产品手册甚至客户反馈中提取最新信息,自动生成上下文感知的咨询回复。
-
实际价值
:缩短响应时间、提升客户满意度,实现高并发支持请求的无人化处理。
2)内容创作与文档生成
-
运作机制
:AI从现有文档中检索信息,按需生成结构规范的报告、博客文章、技术手册或常见问题解答。
-
实际价值
:简化内容生产流程,确保内容时效性与相关性,释放人力投入创意或策略性工作。
3)市场情报与竞争分析
-
运作机制
:RAG模型持续监控市场趋势、行业新闻及竞争对手动态,实时提取关键数据并生成分析洞见。
-
实际价值
:及时精准的市场洞察助力企业抢占先机,快速识别机会并做出数据驱动决策。
4)销售与个性化营销
-
运作机制
:RAG检索客户档案、购买历史及行为模式,据此生成定制化营销策略与销售建议。
-
实际价值
:提升转化率、实现精准营销并增强客户互动粘性。
3 RAG检索模块的技术要点
3.1 混合检索策略
混合检索策略是一种结合了关键词检索(例如BM25)和向量检索(例如HNSW/IVF-PQ)的检索方法,旨在提高检索结果的相关性和准确性。在RAG(检索增强生成)技术领域,这种混合索引架构通过整合不同类型的检索技术,可以更有效地从大量数据中检索出与查询最相关的信息。
关键词检索,如BM25,是一种基于文本内容的检索方法,它通过分析文本中关键词的频率和逆文档频率(IDF)来评估文档的相关性。而向量检索则利用向量空间模型,将文本转换为高维向量,并使用余弦相似度等度量方法来确定文档间的相似度。HNSW(Hierarchical Navigable Small World)和IVF-PQ(Inverted File with Product Quantization)是两种向量检索技术,它们通过优化数据结构和索引方法来提高检索效率和准确性。
在RAG系统中,混合检索策略可以显著提升检索系统的性能和准确性,通过整合不同检索模型的优势,能够提供更全面、更相关的搜索结果,特别是在复杂查询场景下。例如,传统的基于关键词的搜索可能会优先考虑精确的词匹配,而语义搜索模型则关注上下文相关性,能够捕捉那些在概念上相关但未必共享相同关键词的文档。每个系统单独来看都有其优势和局限性。通过汇总它们的输出,我们可以利用它们综合的优势,从而显著提高检索性能。
此外,混合搜索是一种结合两种或更多搜索算法的技术,旨在提高搜索结果的相关性。它通常指的是传统的基于关键词的搜索和现代的向量搜索的结合。在RAG管道的开发中,混合搜索是一个重要的策略。
3.2 查询重写技术
查询重写技术是RAG中提升性能的关键,尤其在与大语言模型(LLMs)结合时。查询扩展(Query Expansion)技术是查询重写的一种形式,它通过让LLM对原始查询进行多次改写,创建多个变体版本(variations),然后多次运行检索过程,以检索更多可能相关的上下文。这种方法可以优化技术,允许模型语义检索可能不共享相同关键词的相关文档,从而扩展LLM生成响应的多样性和视角。通过为模型提供更广泛的内容,有助于丰富模型的综合能力,增加获得正确答案的机会。
伪相关反馈(Pseudo-Relevance Feedback,PRF)则是另一种查询扩展方法,它使用原始查询检索到的文档作为“伪相关”文档来检索新的查询项。这种方法假设检索到的顶部文档是最相关的,然而,如果最初检索到的文档集由于查询写得不好而不够相关,这将导致结果不佳。PRF方法利用LLM生成新的查询项并将它们连接到原始查询中(q’=Concat(q,q,q,q,q, LLM(prompt q))),以扩展查询的相关关键词,从而提高获得正确答案的百分比。在所有方法中,实验表明CoT/PRF提示通常表现最佳。
3.3 细化排序模型
细化排序模型在RAG技术中扮演着重要角色,尤其是在精排阶段。精排阶段是对初步检索结果进行更精细的排序,以确保最终输出的准确性和相关性。在这一阶段,可以引入如ColBERT等跨编码器进行重排序。ColBERT是一种基于BERT的跨编码器模型,它通过延迟交互机制(late interaction architecture)结合BERT的上下文表示,实现了高效的检索和重排序。这种方法在保持高效推理的同时,能够捕捉到查询和文档之间的复杂关系。
跨编码器(Cross Encoder)使用单编码器模型来同时编码查询和文档,能够提供更精准的搜索排序结果。它并不输出查询和文档的Token所对应的向量,而是再添加一个分类器直接输出查询和文档的相似度得分。然而,由于需要在查询时对每个文档和查询共同编码,这使得排序的速度非常慢,因此Cross Encoder只能用于最终结果的重排序。而ColBERT采用双编码器策略,将查询和文档分别采用独立的编码器编码,这种分离使得文档编码可以离线处理,查询时仅针对Query编码,因此处理的速度大大高于Cross Encoder。
3.4 增量索引技术
在RAG系统中,增量索引技术是优化索引更新过程的关键。Delta Indexing(增量索引)与Full-Indexing(全量索引)是两种主要的索引更新策略,它们在效率、成本和准确性之间需要进行权衡。
Delta Indexing是一种只更新自上次索引以来发生变化的数据的策略。这种方法的优点是更新速度快,资源消耗少,因为它不需要重新索引整个数据集。然而,Delta Indexing可能在处理大量更新时变得复杂,且需要维护额外的索引结构来跟踪变化。它适用于数据更新频繁且更新量相对较小的场景,可以显著提高索引更新的效率,减少对系统资源的占用。
Full-Indexing则涉及重新索引整个数据集,无论数据是否发生变化。这种方法的优点是简单且能够保证索引的一致性和准确性,但缺点是成本高、耗时长,尤其是在处理大规模数据集时。Full-Indexing适用于数据变化不频繁或对索引准确性要求极高的场景,可以确保索引的完整性和一致性,但可能会对系统性能和资源造成较大压力。
在实际应用中,选择哪种索引策略取决于具体的业务需求、数据更新频率、系统资源限制以及对索引准确性的要求。Delta Indexing适合于需要快速响应数据变化且资源有限的环境,而Full-Indexing则适合于对数据一致性要求高且资源相对充足的环境。通过合理选择和权衡这两种策略,可以优化RAG系统的性能和效率。
4 RAG生成模块的技术要点
4.1 引入适配器机制
在RAG技术中,生成模块的优化是提高整体性能的关键。引入适配器机制,如LoRA(Low-Rank Adaptation)和P-Tuning,可以在不改变LLMs参数的情况下进行有效的微调。这些方法通过在模型中加入少量可训练的参数,实现了对模型的轻量级调整,从而适应特定的任务需求。
LoRA是一种参数高效的微调方法,它通过引入两个低秩矩阵A和B,将原始权重矩阵的更新表示为这两个矩阵的乘积(即AB),从而大大减少了可训练参数量。这种方法特别适用于资源受限的环境,如边缘计算、移动设备等。通过减少显存占用和计算复杂度,LoRA使得在这些环境下部署大型预训练模型成为可能。
P-Tuning是一种将传统的固定提示(Prompt)转换为可学习的嵌入(Embedding)层,并通过一个简单的神经网络(如MLP或LSTM)对这些嵌入进行处理的方法。这样,模型就可以根据特定任务动态地调整这些提示。P-Tuning特别适用于那些需要高度定制化提示的任务,如情感分析、文本生成等。通过动态调整提示,模型能够更准确地捕捉任务相关的语义信息。
总的来说,LoRA和P-Tuning都是通过在冻结的大型预训练模型参数的基础上,引入少量可训练参数来进行微调,从而实现对模型的优化和适应特定任务的需求。这种方法不仅减少了计算资源的消耗,还提高了模型的灵活性和适应性。
4.2 解码策略
在RAG技术的生成模块中,解码策略的选择对于生成文本的质量和多样性至关重要。以下是两种常见的解码策略——Beam Search和Nucleus Sampling:
1)Beam Search
Beam Search是一种生成策略,它在每一步解码时保留一定数量(束宽)的最可能的候选序列,并从这些候选序列中选择下一个词。这种方法的优点在于能够生成高质量的文本,因为它总是选择概率最高的词,从而保证了生成文本的准确性和连贯性。然而,Beam Search的缺点是可能会生成重复的文本,因为它倾向于选择最可能的词,这可能会限制文本的多样性。
2)Nucleus Sampling(Top-p Sampling)
Nucleus Sampling是一种基于概率的采样方法,它在每个时间步选择一个最小集合的词,这些词的累积概率至少达到预设的阈值p。这种方法的优点是能够生成更多样化的文本,因为它允许选择不那么可能但仍然合理的词,从而增加了文本的创造性和新颖性。Nucleus Sampling在保持文本连贯性的同时,能够生成更丰富的内容。
两者的适用场景:
-
Beam Search
:更适用于需要高准确性和连贯性的任务,如机器翻译、问答系统等,其中生成的文本需要严格遵循语法和语义规则。
-
Nucleus Sampling
:更适用于需要创造性和多样性的任务,如故事生成、对话系统等,其中生成的文本需要更加灵活和有趣。
4.3 事实一致性校验
在RAG生成模块中,为了确保生成内容的事实一致性,可以集成如FactScore等事实核查模块进行工程实现。FactScore是一种评估工具,它通过将生成内容分解为原子事实来验证其与知识源的匹配度。这种方法进一步考虑了同义表达,提出了进阶版D-FActScore,以更准确地评估生成内容的事实一致性。通过使用FActScore工具对比生成内容与检索结果,可以标记不一致的部分,从而提高生成内容的准确性和可靠性。
5 企业如何落地RAG
RAG技术可以通过以下步骤在企业中实现落地,以提升效率、准确性与可扩展性:
5.1 理解RAG技术
-
技术培训
:对团队进行RAG技术的培训,确保他们理解其工作原理和潜在价值。
-
需求分析
:分析企业的具体需求,确定RAG技术可以解决的问题。
5.2 选择合适的应用场景
-
客户支持
:自动化处理客户咨询,提高响应速度和客户满意度。
-
内容创作
:生成高质量的内容,如报告、博客文章等,提高内容生产的效率。
-
市场情报
:监控市场趋势和竞争对手动态,提供实时的市场洞察。
-
个性化营销
:根据客户数据生成定制化的营销策略,提高转化率。
5.3 实施RAG技术
-
系统集成
:将RAG技术集成到现有的业务流程和系统中。
-
数据准备
:收集和整理用于训练RAG模型的数据。
-
模型训练
:使用收集的数据训练RAG模型,确保其能够准确理解和生成内容。
5.4 监控与优化
-
性能监控
:持续监控RAG技术的性能,确保其满足业务需求。
-
模型优化
:根据反馈和性能监控结果,不断优化RAG模型。
5.5 实施建议
1)数据质量管控:RAG模型的性能依赖于知识库的质量与相关性,需定期更新与维护数据。
2)技术栈选型
-
语义搜索推荐使用Elasticsearch、FAISS、Pinecone等工具;
-
语言生成可选用GPT-3、T5等模型以生成高语境丰富度的响应。
3)系统集成策略:通过API将RAG集成到现有平台(如客户支持聊天机器人、CRM系统),最大限度降低对业务的干扰。
4)持续反馈优化:持续为RAG系统输入新数据与反馈,推动其随业务需求进化升级。
6 为何选择RAG?
商业自动化的未来在于能够学习、适应并提供实时上下文感知响应的AI系统,而RAG正引领这一趋势——让AI更智能、更高效精准地处理复杂工作流。无论企业希望自动化客户支持、生成个性化内容还是追踪市场动态,RAG都能成为实现目标的核心技术。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容

-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)

07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
 289


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


