


在RAG(检索增强生成,Retrieval-Augmented Generation)应用中,文本分块(Text Chunking)是连接“知识存储”与“检索-生成”的核心预处理步骤,其重要性体现在对检索效率、相关性、生成质量及系统灵活性的多维度影响。
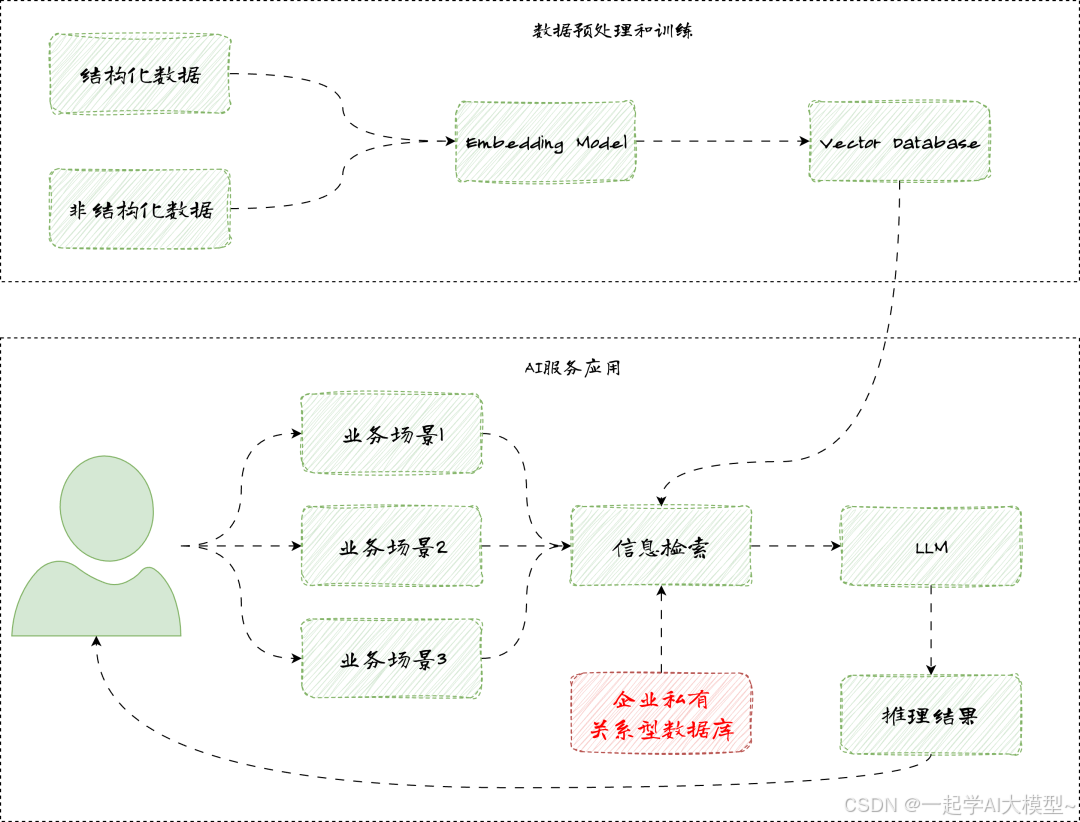
首先松哥和大家讨论第一个问题,就是为什么我们要重视文本切分。
一 为什么文本切分很重要
1.1 提升检索相关性:精准匹配用户需求
RAG 的核心是“先检索、后生成”,而检索的本质是从知识库中找到与用户查询语义最相关的信息。文本分块直接影响检索的精准度:
- 若文本未分块(或块过大),单个块可能包含多个无关主题。例如,一篇同时讨论“人工智能伦理”和“机器学习算法”的文章,若作为一个整块存储,当用户查询“人工智能伦理”时,检索结果会包含大量“算法”的冗余信息,干扰相关性判断。
- 合理分块(如按段落、主题或逻辑单元分割)可使每个块聚焦单一语义。例如,将上述文章拆分为“伦理争议”“算法原理”两个块,用户查询时能精准匹配目标块,减少无关信息干扰。
1.2 优化检索效率:降低计算成本与延迟
RAG 依赖向量数据库存储文本的向量表示(通过嵌入模型生成),检索时需计算“用户查询向量”与“文本块向量”的相似度。分块对效率的影响体现在:
- 减少冗余计算:大块文本的向量表示可能“平均化”细节信息(如长文档中某句话的关键信息被稀释),导致检索时需对比更多无效内容。分块后,每个块的向量更“聚焦”,相似度计算更高效。
- 适配数据库性能:向量数据库的检索速度与单个向量的处理成本相关。相同长度的文档,分块后单个块的字符数更少,生成向量的计算量更低,且批量检索时可通过并行处理提速(尤其对长文档,如书籍、报告等)。
1.3 保障生成质量:为LLM提供精准上下文
LLM(大语言模型)生成回答时,依赖检索到的文本块作为“事实依据”。分块质量直接影响输入 LLM 的上下文有效性:
- 减少噪声干扰:若检索到的块包含大量无关信息,LLM 可能被误导(如生成与查询无关的内容,或混淆不同主题的信息)。例如,用户问“如何预防新冠”,若检索到的块同时包含“新冠预防”和“流感治疗”,LLM 可能错误关联两者。
- 适配 LLM 上下文窗口:所有 LLM 均有最大输入长度限制(如 GPT-3.5 的 4k tokens)。若文本块过大,可能导致检索到的相关块因长度超限被截断,或挤压 LLM 的生成空间。分块后可灵活选择多个小而精的块,在窗口限制内纳入更多关键信息。
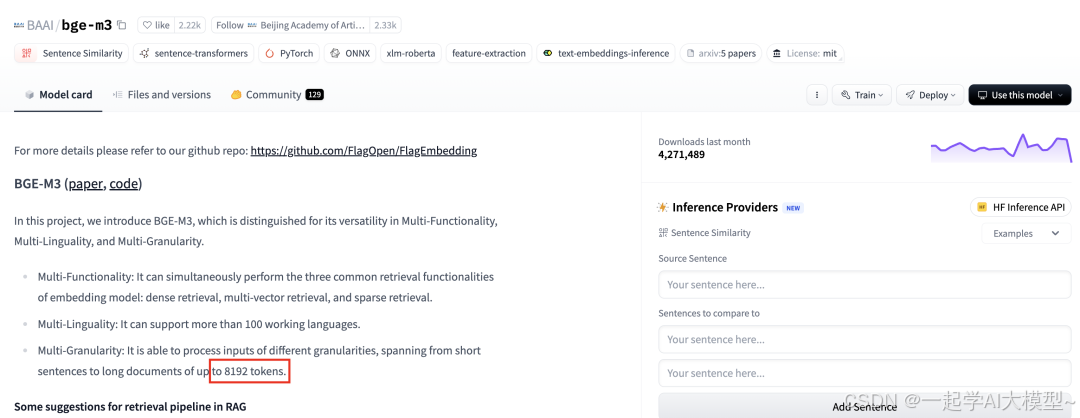
一般我们通过嵌入模型来生成嵌入向量,而嵌入向量往往也有上下文窗口大小的限制。以常见的 bge-m3 为例,我们可以在介绍文档中看到最大 token 数的限制。
当然,我们也可以直接在模型的配置文件中找到 token 上限:
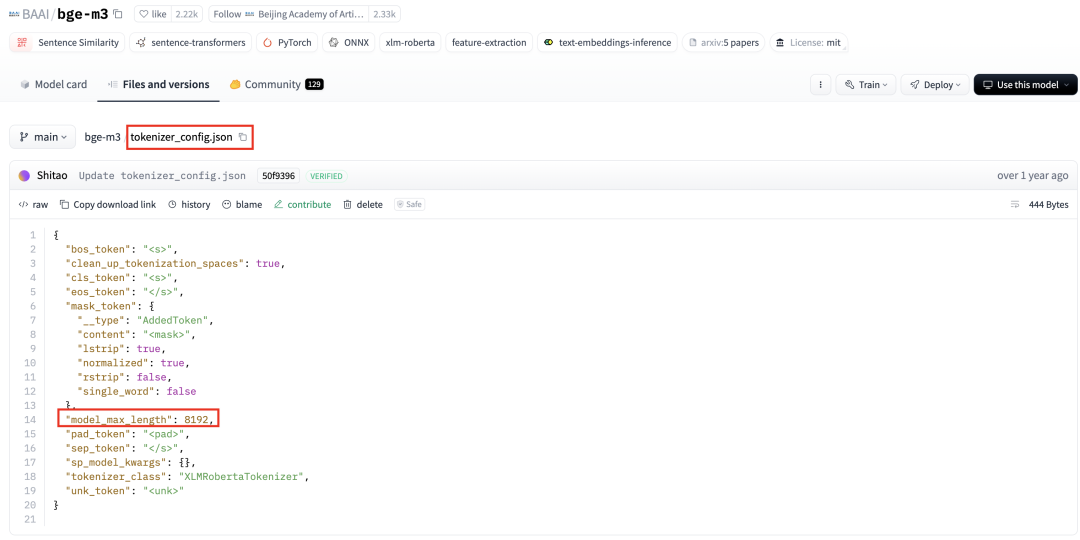
上图是在 tokenizer_config.json 文件中找到的配置,有的是在 config.json 配置文件中。
1.4 适配长文档处理:突破“上下文窗口限制”
现实中,RAG 的知识库常包含长文档(如论文、手册、法律条文等),其长度远超 LLM 的上下文窗口(例如,一本 300 页的技术手册)。文本分块是处理这类文档的核心手段:
- 拆分后“分而治之”:通过分块将长文档拆解为多个子单元,每个子单元可独立存储和检索。例如,将技术手册按“安装步骤”“故障排除”“维护指南”分块,用户查询“如何排除启动故障”时,仅需检索“故障排除”相关块,无需处理整本书。
- 保留细节信息:长文档的整体向量可能丢失局部细节(如某段关键操作步骤),而分块后每个子单元的向量能更精准地代表其细节,确保检索时不遗漏重要信息。
1.5 平衡“完整性”与“聚焦性”:避免信息割裂
分块的核心挑战是“如何划分边界”,而合理分块能在“信息完整”与“聚焦性”间找到平衡:
- 若块太小(如单句),可能割裂语义逻辑(如拆分一个完整的论证过程),导致检索到的信息碎片化,LLM 无法理解上下文关联;
- 若块太大(如整章),则回到“冗余信息”的问题。
针对这里第一小点,松哥举个例子。
假设原文是一段关于"气候变化对农业影响"的论证:
①. 全球平均气温上升会导致极端天气事件增加。
②. 干旱和洪涝频率上升会直接破坏农作物生长周期。
③. 这将导致主要粮食产区的产量下降。
④. 最终可能引发全球粮食供应紧张和价格波动。
这四句话构成一个完整的因果链论证:气温上升→极端天气→作物受损→粮食危机。
如果按单句分块存储,当用户查询"气候变化为何会导致粮食价格上涨"时:
- 系统可能只检索到第 ④ 句(直接提到价格波动)
- 但缺失了 ①②③ 句的因果铺垫,导致 LLM 无法理解"气候变化→价格上涨"的完整逻辑链条
- 生成的回答可能变得牵强(如"粮食价格上涨可能与气候变化有关"),而非基于完整论证的确定性结论(如"气候变化通过影响农作物生长,最终导致价格波动")
这种情况下,过度细碎的分块割裂了语义关联,使检索到的信息失去了上下文支撑,LLM自然无法生成逻辑完整的回答。
因此,优质分块策略(如按语义、段落、标点符号分块)需确保每个块既能独立表达完整信息,又不包含无关内容,这是 RAG 系统性能的关键前提。
二 文本该如何切分
那么文本该如何切?
虽然文本切分策略很多,但是 Java 在这块现有框架目前支持的比较少,Spring AI 中仅有一个 TokenTextSplitter,而在 Spring AI Alibaba 中则多支持了一个 SentenceSplitter。
我们来简单看看这两种切分策略。
2.1 TokenTextSplitter
在 Spring AI 中,TokenTextSplitter 是一个用于文本分割的工具类,主要功能是将长文本按照令牌(Token)数量进行拆分,适用于处理超出大语言模型(LLM)上下文窗口限制的文本内容。它是实现文本分块(Text Chunking)的重要组件,通常在构建检索增强生成(RAG)等应用时使用。
TokenTextSplitter 通常使用与 LLM 一致的令牌化逻辑(通常基于 OpenAI 的 tiktoken 库),确保分割结果与模型的令牌计数一致;并且 TokenTextSplitter 会尽量在自然边界(如句子结束处)进行分割,避免将完整语义拆分到不同文本块中。
我们来看一段简单的示例代码:
List<Document> documents = myTikaDocumentReader.loadText();
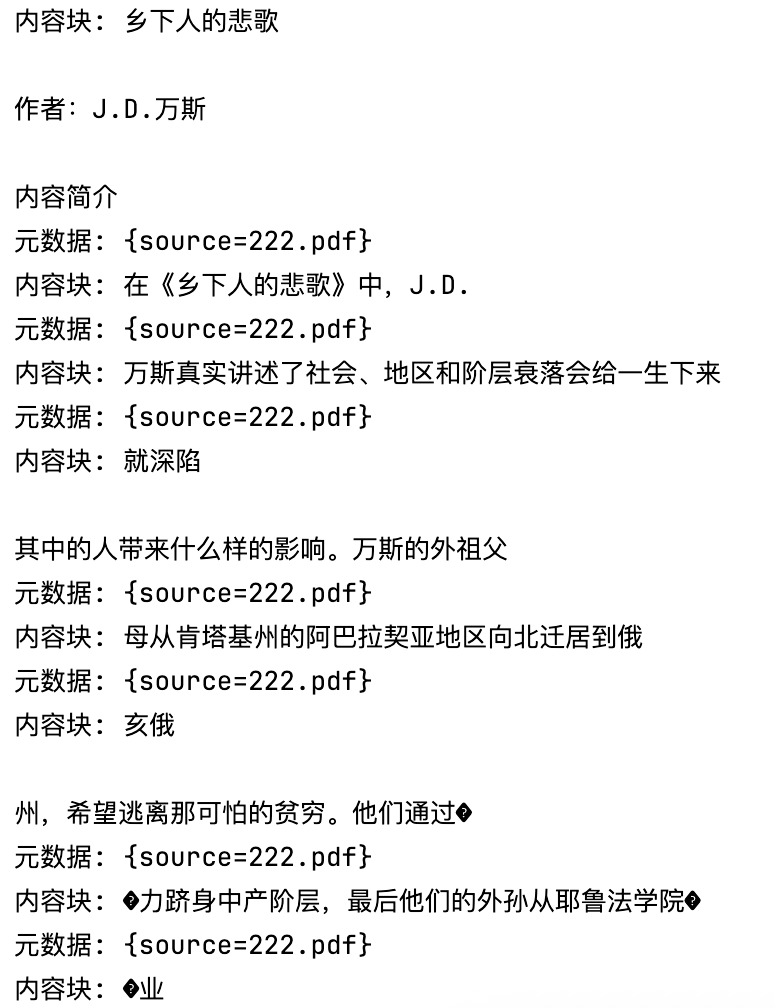
TokenTextSplitter splitter = new TokenTextSplitter(30,10,3,2000,true);
List<Document> chunks = splitter.apply(documents);
for (Document chunk : chunks) {
    System.out.println("内容块: " + chunk.getText());
    System.out.println("元数据: " + chunk.getMetadata()); // 继承原始文档元数据
}
在构建 TokenTextSplitter 的时候,有五个参数,含义分别如下:
| 参数名 | 默认值 | 功能描述 |
|---|---|---|
| defaultChunkSize | 30 | 目标块大小(令牌数) |
| minChunkSizeChars | 10 | 最小块字符数(低于此值不分割) |
| minChunkLengthToEmbed | 3 | 有效块最小长度(字符数,短于此值丢弃) |
| maxNumChunks | 2000 | 单文本最大分块数(防长文本爆炸) |
| keepSeparator | true | 是否保留分隔符(如换行符) |
TokenTextSplitter 处理流程如下:
- 编码阶段:使用 CL100K_BASE 编码将输入文本转换为令牌序列。
- 分块切割:按 defaultChunkSize 将令牌序列切割为块。
- 断点优化:对每个块尝试在 minChunkSizeChars 后寻找自然断点(句号、问号、感叹号或换行符)。找到断点则截断,否则保留原始切割点。
- 格式处理:修剪空白字符,按 keepSeparator 决定是否保留换行符。仅保留长度 ≥minChunkLengthToEmbed 的块。
- 循环处理:重复切割直至处理完所有令牌或达到 maxNumChunks 限制。
以上代码最终切块后的结果如下:
2.2 SentenceSplitter
Spring AI Alibaba 的 SentenceSplitter 是一个专为文本分块设计的组件,主要用于优化 RAG(检索增强生成) 流程中的文档预处理阶段。它通过智能拆分长文本为语义连贯的句子组,确保后续向量化处理能保留上下文完整性,从而提升大模型在问答、知识检索等任务中的准确性。
SentenceSplitter 的工作流程分为两步:
- 句子拆分:基于预训练的 OpenNLP 句子检测模型(opennlp-en-ud-ewt-sentence-1.2-2.5.0.bin),将原始文本分割为独立句子。
- 动态分块合并:根据预设的 chunkSize(默认 1024 tokens),计算每个句子的 token 数量(使用 CL100K_BASE 编码),将相邻句子合并为不超过 token 上限的文本块。
代码案例如下:
List<Document> documents = myTikaDocumentReader.loadText();
SentenceSplitter splitter = new SentenceSplitter(128);
List<Document> chunks = splitter.apply(documents);
for (Document chunk : chunks) {
    System.out.println("内容块: " + chunk.getText());
    System.out.println("元数据: " + chunk.getMetadata()); // 继承原始文档元数据
}
这是目前我们在 Java 相关框架中支持的分块方案。
还有其他一些分块思路,这里也和大家聊聊,大家可以结合自己的项目需求,自行实现。
2.3 固定长度分块(Fixed-Length Chunking)
思路
将文本按照预设的固定长度(如字符数、token 数)进行均匀拆分,不考虑文本的语义、结构或标点等信息,当剩余文本长度不足固定长度时,作为最后一个块保留。
原理
- 核心是“机械切割”,以量化的长度为唯一标准,不涉及对文本内容的理解。
- 例如:设定固定长度为 100 字符,无论文本是句子、段落还是代码,均从开头每 100 字符切分一次。
适用场景
- 文本结构简单、语义连贯性较弱的场景(如日志、长串无标点的字符)。
- 快速实现分块的初步方案,作为复杂分块策略的基础参考。
优缺点
- 优点:实现简单、效率高,分块结果可预测。
- 缺点:容易割裂完整语义(如拆分一个句子、一个论证过程),导致块内信息碎片化或跨块语义不连贯。
2.4 递归分块(Recursive Chunking)
思路
以“先大后小”的层级逻辑分块,优先按大粒度分隔符(如段落、章节)切分,若分块后仍超过预设长度,则递归使用更小粒度的分隔符(如句子、逗号)继续切割,直到所有块的长度符合要求。
原理
- 基于“自然分隔符优先级”设计,假设文本中天然存在的分隔符(如换行、句号)能体现语义停顿,优先保留这些分隔符划分的完整单元。
- 例如:预设长度为 500 字符,先按段落(换行符)切分,若某段落超过 500 字符,则按句号(句子)切分该段落;若某句子仍过长,则按逗号切分,以此类推。
适用场景
- 结构化较强、存在多层级语义分隔的文本(如文章、书籍、长文档)。
- 希望在控制块长度的同时,最大程度保留语义完整性的场景。
优缺点
- 优点:平衡了长度控制和语义连贯性,减少对完整语义单元的割裂。
- 缺点:实现较复杂,需要定义分隔符优先级;对无明显分隔符的文本效果有限。
2.5 按结构分块(Structural Chunking)
思路
根据文本的固有结构特征(如格式标记、逻辑层级)进行分块,将具有相同结构属性的内容划分为一个块。
原理
- 依赖文本的“结构性标记”,这些标记可能是显式的(如 HTML 标签、Markdown 标题、PDF 的章节标题),也可能是隐式的(如表格、代码块、列表的格式)。
- 例如:
- 对 HTML 文本,按
<h1>(一级标题)、<p>(段落)、<table>(表格)等标签分块,每个标签内的内容作为独立块。 - 对 Markdown 文本,按
#(标题)、-(列表项)、(代码块)分块。
适用场景
- 结构化文档(如网页、Markdown文档、PDF报告、带格式的Word文档)。
- 需要保留特定结构单元(如表格、代码块、章节)的场景,避免结构被破坏。
优缺点
- 优点:能精准提取结构化单元,块内信息关联性强,适合后续针对特定结构的处理(如单独解析表格、代码)。
- 缺点:依赖文本结构的规范性,对无显式结构的文本(如纯文本小说)效果差。
2.6 按标点分块(Punctuation-Based Chunking)
思路
以标点符号作为分块的主要依据,将标点符号(如句号、问号、感叹号、分号)分隔的内容划分为独立块,通常优先使用表示语义停顿较强的标点。
原理
- 假设标点符号是语义完整的边界,例如句号、问号通常标志一个完整句子的结束,分号标志句内的逻辑分隔,基于此划分的块能保留完整的短句或分句。
- 例如:按句号(.)分块,每个句子作为一个块;若句子过长,可进一步按分号(;)或逗号(,)细分。
适用场景
- 以句子为基本语义单元的文本(如散文、论文、对话记录)。
- 希望块内信息是完整短句,方便后续按句子级进行检索或处理的场景。
优缺点
- 优点:块内语义相对完整,符合人类阅读的自然停顿习惯。
- 缺点:对长句(如无标点的长段落)或标点使用不规范的文本(如大量省略标点)效果差,可能导致块过长或过短。
总结
| 分块策略 | 核心依据 | 核心目标 | 典型应用场景 |
|---|---|---|---|
| 固定长度分块 | 量化长度(字符/token) | 快速、均匀切割 | 日志、简单无结构文本 |
| 递归分块 | 分隔符优先级+长度控制 | 平衡长度与语义完整性 | 文章、书籍等长文档 |
| 按结构分块 | 文本格式/逻辑结构 | 保留结构化单元 | 网页、Markdown、PDF报告 |
| 按标点分块 | 标点符号(语义停顿) | 保留完整句子/分句 | 散文、论文、对话文本 |
| 分块策略 | 核心依据 | 核心目标 | 典型应用场景 |
|---|---|---|---|
| 固定长度分块 | 量化长度(字符/token) | 快速、均匀切割 | 日志、简单无结构文本 |
| 递归分块 | 分隔符优先级+长度控制 | 平衡长度与语义完整性 | 文章、书籍等长文档 |
| 按结构分块 | 文本格式/逻辑结构 | 保留结构化单元 | 网页、Markdown、PDF报告 |
| 按标点分块 | 标点符号(语义停顿) | 保留完整句子/分句 | 散文、论文、对话文本 |
实际应用中,常结合多种策略(如递归分块中融入标点和结构信息),以适应复杂文本的分块需求。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容

-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)

07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
 3万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


