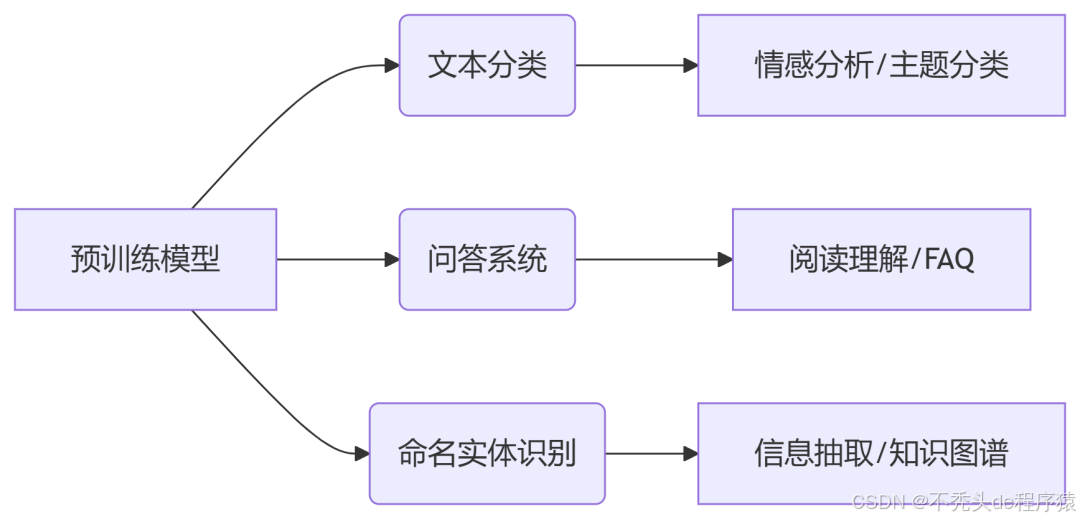
一文搞懂Transformer应用:文本分类、QA、NER全流程代码解析

一个基本的Transformer分类器的示例代码 这是一个基本的Transformer分类器的示例代码: import torch import torch.nn as nn class TransformerClassifier(nn.Module): def __init__(self, num_classes, num_tokens, hidden_size=512, num_attention_heads=8, num_layers... 阅读详情

本文将通过代码实战带你快速掌握NLP三大核心任务,使用Hugging Face Transformer库实现工业级AI应用开发。

一、环境准备

pip install transformers datasets torch tensorboard

二、文本分类实战(情感分析)

1. 数据加载与预处理
from datasets import load_datasetfrom transformers import AutoTokenizerdataset = load_dataset("imdb")tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")def tokenize_function(examples):    return tokenizer(examples["text"], padding="max_length", truncation=True)tokenized_datasets = dataset.map(tokenize_function, batched=True)
2. 模型训练
from transformers import AutoModelForSequenceClassification, TrainingArguments, Trainermodel = AutoModelForSequenceClassification.from_pretrained(    "distilbert-base-uncased", num_labels=2)training_args = TrainingArguments(    output_dir="./results",    evaluation_strategy="epoch",    learning_rate=2e-5,    per_device_train_batch_size=16,    num_train_epochs=3,)trainer = Trainer(    model=model,    args=training_args,    train_dataset=tokenized_datasets["train"],    eval_dataset=tokenized_datasets["test"],)trainer.train()
3. 推理预测
from transformers import pipelineclassifier = pipeline("text-classification", model=model, tokenizer=tokenizer)result = classifier("This movie was absolutely fantastic!")print(result)  # [{'label': 'POSITIVE', 'score': 0.999}]
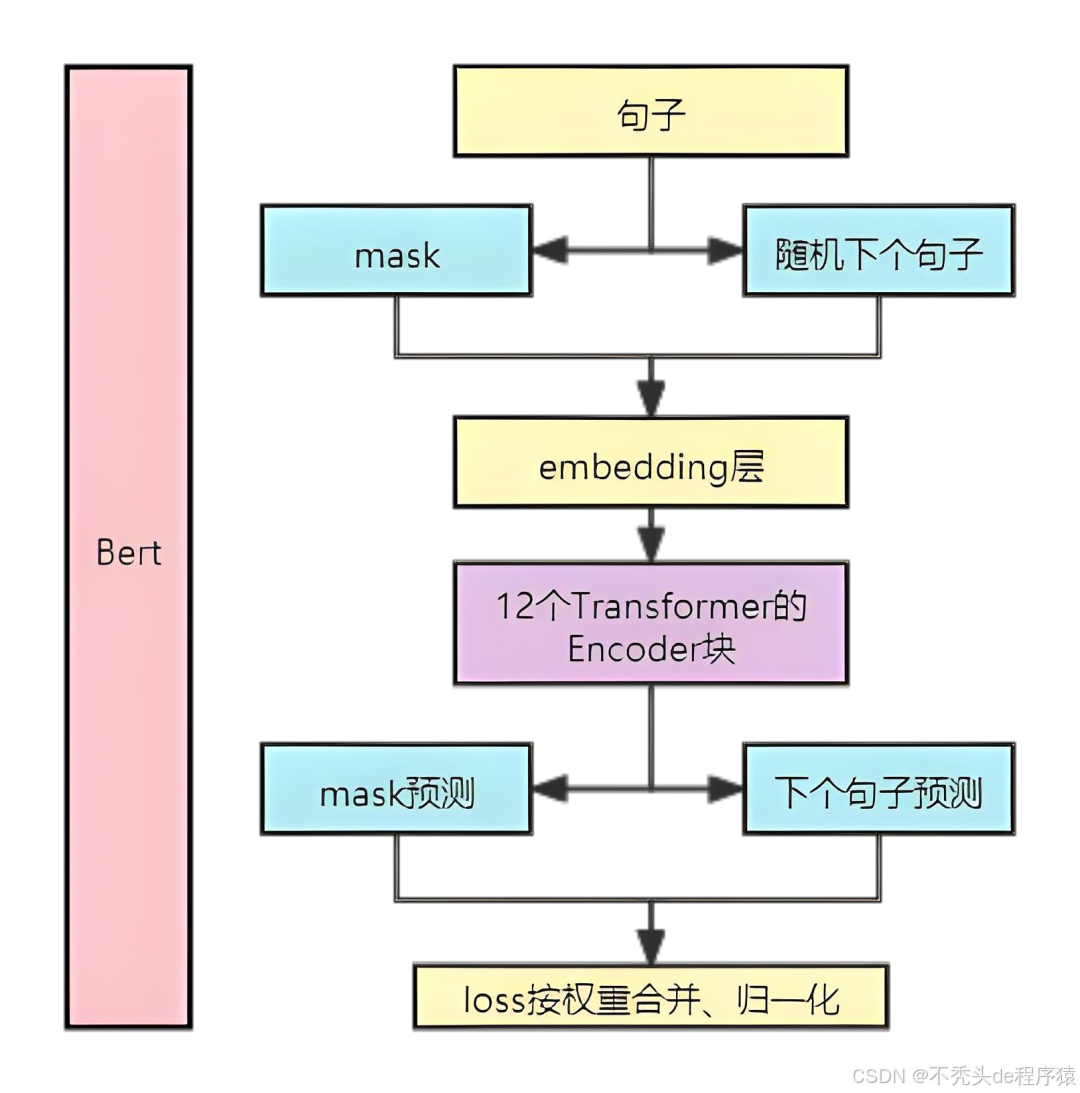
在这里插入图片描述

三、问答系统实战(SQuAD数据集)

1. 加载问答数据集
dataset = load_dataset("squad")tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")def preprocess_function(examples):    questions = [q.strip() for q in examples["question"]]    inputs = tokenizer(        questions,        examples["context"],        max_length=384,        truncation="only_second",        return_offsets_mapping=True,        padding="max_length",    )    return inputstokenized_squad = dataset.map(preprocess_function, batched=True)
2. 训练问答模型
from transformers import AutoModelForQuestionAnsweringmodel = AutoModelForQuestionAnswering.from_pretrained("distilbert-base-uncased")training_args = TrainingArguments(    output_dir="./qa_results",    evaluation_strategy="epoch",    learning_rate=3e-5,    per_device_train_batch_size=12,    num_train_epochs=2,)trainer = Trainer(    model=model,    args=training_args,    train_dataset=tokenized_squad["train"],    eval_dataset=tokenized_squad["validation"],)trainer.train()
3. 执行问答
question = "What does NLP stand for?"context = "Natural Language Processing (NLP) is a subfield of artificial intelligence."qa_pipeline = pipeline("question-answering", model=model, tokenizer=tokenizer)result = qa_pipeline(question=question, context=context)print(result)# {'score': 0.982, 'start': 0, 'end': 24, 'answer': 'Natural Language Processing'}

四、命名实体识别实战(CoNLL-2003)

1. 数据预处理
dataset = load_dataset("conll2003")tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")label_list = dataset["train"].features["ner_tags"].feature.namesdef tokenize_and_align_labels(examples):    tokenized_inputs = tokenizer(        examples["tokens"],         truncation=True,        is_split_into_words=True    )        labels = []    for i, label in enumerate(examples["ner_tags"]):        word_ids = tokenized_inputs.word_ids(batch_index=i)        previous_word_idx = None        label_ids = []        for word_idx in word_ids:            if word_idx is None:                label_ids.append(-100)            elif word_idx != previous_word_idx:                label_ids.append(label[word_idx])            else:                label_ids.append(-100)            previous_word_idx = word_idx        labels.append(label_ids)        tokenized_inputs["labels"] = labels    return tokenized_inputstokenized_dataset = dataset.map(tokenize_and_align_labels, batched=True)
2. 训练NER模型
from transformers import AutoModelForTokenClassificationmodel = AutoModelForTokenClassification.from_pretrained(    "bert-base-cased",     num_labels=len(label_list)    training_args = TrainingArguments(    output_dir="./ner_results",    evaluation_strategy="epoch",    learning_rate=2e-5,    per_device_train_batch_size=16,    num_train_epochs=3,)trainer = Trainer(    model=model,    args=training_args,    train_dataset=tokenized_dataset["train"],    eval_dataset=tokenized_dataset["validation"],)trainer.train()
3. 实体识别推理
from transformers import pipelinener_pipeline = pipeline("ner", model=model, tokenizer=tokenizer)sample_text = "Apple was founded by Steve Jobs in Cupertino, California."entities = ner_pipeline(sample_text)for entity in entities:    print(f"{entity['word']} -> {label_list[entity['entity'][-1]]}")    # Apple -> B-ORG# Steve Jobs -> B-PER# Cupertino -> B-LOC# California -> B-LOC

五、核心技巧总结

迁移学习优势:使用预训练模型可节省90%训练时间

动态填充:使用DataCollator提升训练效率

混合精度训练:添加fp16=True参数加速训练

学习率调度:采用线性衰减策略更稳定收敛

早停机制:监控验证集损失防止过拟合

六、进阶学习方向
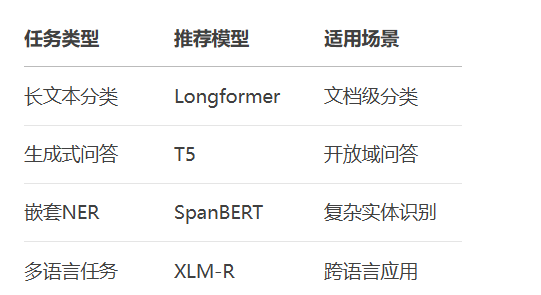
image.png

在这里插入图片描述

关键提示: 实践时注意调整超参数(batch size、学习率)以适应你的硬件配置,小显存设备建议使用distilbert等轻量模型。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
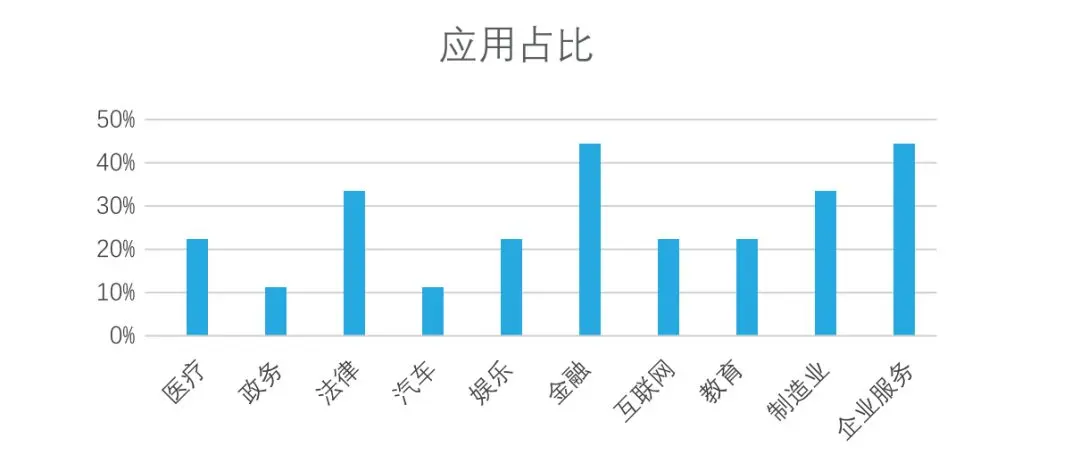
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

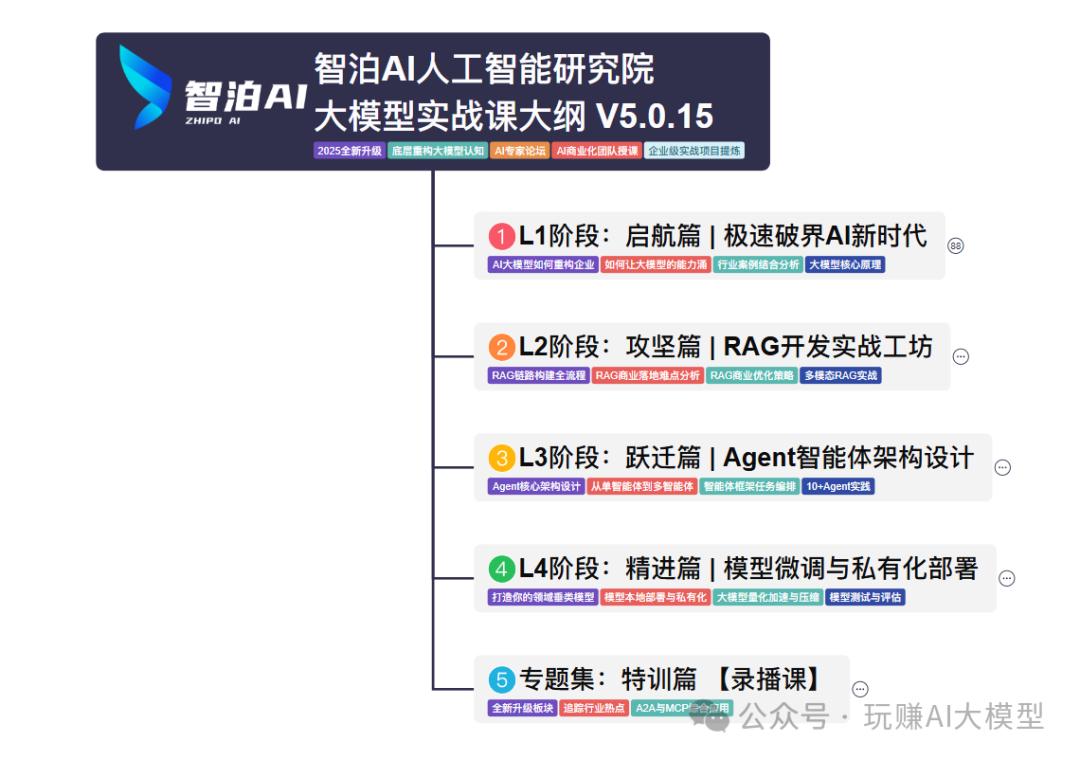
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

自然语言分类transformer代码 自然语言分类 Transformer 代码是一种用于自然语言分类任务的机器学习模型。Transformer 是一种注意力机制的神经网络架构,能够处理序列数据并进行分类。 下面是一个简单的 Transformer 代码示例,使用了 PyTorch 框架: import torch import torch.nnas nn import torch.nn.functional as F class ... 阅读详情

相关推荐

光谱transformer分类代码

光谱transformer是一种用于光谱数据分类的机器学习模型。它是一种用于处理序列数据的transformer模型的变体,通常用于自然语言处理任务。但是,它也可以用于处理其他类型的序列数据,例如光谱数据。 下面是一个简单的光谱transformer分类代码示例,假设你已经有了训练数据和测试数据: ```python import tensorflow as tf 定义模型超参数 num_clas...

weixin_42583683的博客 592

Python深度学习14——Keras实现Transformer中文文本十分类

transformer神经网络,实现中文文本的十分类。并且和其他网络对比

weixin_46277779的博客 1万+

BERT深度解析:基于Transformer的核心改进、实现方法与代码实战

本文深入解析了BERT模型的核心原理与实现细节。首先回顾Transformer编码器的基础结构,重点阐述BERT的五大关键改进:1)双向预训练(MLM)通过随机掩盖token实现上下文理解;2)句子级预训练(NSP)捕捉句子间关系;3)融合token、位置和句子信息的统一输入表示;4)加深模型架构提升表达能力;5)通用微调范式适配多任务。文章还提供了关键模块的PyTorch代码实现,包括输入表示层、多头注意力和编码器层,帮助读者深入理解BERT的底层机制。

weixin_59274058的博客 751

transformer在图像分类上的应用以及pytorch代码实现

文章目录1.对transformers的简单介绍1.1序列数据的介绍(seq2seq)1.2self-Attention1.3 transformer的完整结构2.transformers在图像分类上的pytorch代码2.1加载cifar10数据集2.2构建transformers模型2.2.1构建图像编码模块 Embeddings2.2.3构建前向传播神经网络模块2.2.4构建编码器的可重复利用Block模块2.2.5构建Encoder模块2.2.6 构建完整的transformers2.2.7构建Vi

qq_37937847的博客 5万+

Transformer实战(19)——微调Transformer语言模型进行词元分类

在本节中,我们将学习如何对语言模型进行微调,以适应词元分类任务。我们将探索命名实体识别 (NER)、词性标注 (POS) 和问答 (QA) 等任务,并了解如何针对这些任务微调特定的语言模型。我们将重点介绍 BERT 模型,学习如何微调 BERT 应用于 POS、NER 和 QA 任务,并熟悉这些任务的实现细节,包括所用数据集及执行过程。通过本节的学习,将能够使用 transformers 库执行各种词元分类任务。

盼小辉丶的博客 4465

IDM更改下载路径的详细指南

Internet Download Manager(IDM)是一款功能全面的下载加速工具,它支持多种浏览器和协议,能够显著提升下载速度,同时提供断点续传、多线程下载等实用功能。IDM的用户界面简洁明了,操作便捷,使得用户能够轻松管理下载任务。此外,IDM还支持自动分类下载文件、定时下载等高级功能,进一步提升了用户的下载体验。通过本文的介绍,相信用户已经掌握了如何在IDM中更改下载路径的方法。这一功能不仅提升了下载效率和文件管理便捷性,还满足了用户的个性化需求。

nntxthml的博客 1763

终极指南:awesome-qa项目全面解析——从基础概念到前沿技术

想要快速掌握问答系统(QA)的完整知识体系吗?😊 awesome-qa项目为你提供了从基础概念到前沿技术的全面资源集合!这个精心整理的问答系统知识库涵盖了机器学习、深度学习和自然语言处理领域的核心内容,是初学者和专业人士的绝佳学习指南。 ## 问答系统基础知识入门 🎯 **问答系统(Question Answering, QA)** 是计算机科学中的一个重要领域,它结合了信息检索和自然语言

gitblog_00100的博客 700

局部,全局(外部),static等变量详解

首先,必须明白一个程序是包含若干个源文件,每个源文件又是包含若干个函数,每个源文件、函数中又定义了若干个变量。但是每个变量都有自己的作用范围,也就是自己的作用域。只有在作用域内才可以访问变量。 变量的有效范围称为变量的作用域( scope)。归纳起来,变量有4种不同的作用域:文件作用域( file scope)、函数作用域( function scope)、块作用域(block sc...

归根结底不优秀的博客 1326

小总结:TC + QA + NER

文章目录Word2Vec 原理fastText 模型textCNN 模型DPCNN 模型textRNN 模型HAN:Hierarchical Attention NetworkTransformer(1). Transformer文本分类BERT基于医疗知识图谱的问答系统中文命名实体识别:bi-LSTM+CRF Word2Vec 原理 (无监督训练) Word2vec 使用的词向量不是我们上述提到的One-hot Representation那种词向量,而是 Distributed representat

qq_38293297的博客 933

Alphafold2/multimer本地安装避坑指南:从Conda环境配置到GPU加速实战

本文详细介绍了Alphafold2/multimer本地安装的全流程,从Conda环境配置到GPU加速实战,特别针对常见的报错处理提供了解决方案。通过硬件环境检查、依赖安装技巧、OpenMM补丁应用等步骤,帮助研究人员高效部署蛋白质结构预测工具,提升计算效率。

weixin_29309213的博客 119

保姆级教程:用海思PQTool搞定ISP图像调试,从参数读取到固件烧录全流程

本文提供海思PQTool的ISP图像调试全流程指南,从参数读取、实时调试到固件烧录,涵盖环境配置、核心功能解析、参数固化及生产部署。通过实战案例和避坑指南,帮助开发者高效提升图像质量,适用于海思开发板的ISP调试与优化。

weixin_30872337的博客 285

Transformer五大核心应用实战:30分钟上手文本分类、摘要、问答等

Transformer是现代自然语言处理的基石架构,其核心在于自注意力机制与并行化建模能力,显著提升了长程依赖建模效率与泛化性能。依托Hugging Face生态,开发者无需深入底层实现,即可通过pipeline接口快速调用预训练模型,实现文本分类、命名实体识别(NER)、文本摘要、问答系统和文本生成等主流任务。这类技术已广泛应用于电商评论分析、智能客服、法律文书处理、医疗信息抽取及自动化内容创作等真实场景。本文聚焦工程落地,结合distilbert、distilbart、T5等轻量高效模型,详解如何在Py

weixin_34128237的博客 377

中国1990-2021连续30年土地利用CLCD数据分享

CLCD(China Land Cover Dataset)数据集是由武汉大学黄昕老师基于Google Earth Engine上的335,709景Landsat数据制作的中国年度土地覆盖数据集。为了提高CLCD的时空一致性,还提出了一种包含时空滤波和逻辑推理的后处理方法。该数据集最大的优势在于每年30米的土地利用分类结果,且连续覆盖了30年时间。相比其他产品如GLC_FCS30、Global30、AGLC2000_2015、FROM-GLC10、ESA10、ESRI10等,CLCD在时间分辨率上更高。

qq_48539301的博客 1万+

3行代码搞定Transformer模型训练:Simple Transformers新手入门指南

Simple Transformers是一个强大的Python库,它让Transformer模型的训练变得前所未有的简单。无论是信息检索、文本分类、命名实体识别还是问答系统,这个库都能帮助你用最少的代码实现专业级模型训练。本文将带你快速掌握这个工具的核心用法,让AI开发不再是专家的专利! ## 🚀 为什么选择Simple Transformers? 在深度学习领域,Transformer模型

gitblog_00724的博客 402

MacBook上玩转国民技术N32G430:从零搭建ARM开发环境(VSCode + pyOCD)

本文详细介绍了在MacBook上搭建国民技术N32G430的ARM开发环境,涵盖VSCode配置、pyOCD调试及一键编译烧录全流程。通过Homebrew安装工具链、配置Python环境及VSCode插件,开发者可在MacOS高效开发嵌入式应用,特别适合国产芯片N32G430的开发者参考。

weixin_30614109的博客 437

让 ABAP Screen Variant 安稳上车:SHD0 与 SHD0_MANDT 的 Transport 全攻略

摘要: SAP项目常需优化交易码界面,通过SHD0的Transaction Variant和Screen Variant可实现字段精简、默认值预设及权限控制,避免修改标准代码。但跨系统迁移时易出现变式丢失或版本兼容问题。核心概念包括: Screen Variant:针对单个屏幕的字段属性配置(跨Client); Transaction Variant:串联多屏幕变式(分跨Client和Client-specific); 版本差异:4.70/6.x后需区分SHD0(跨Client)与SHD0_MANDT(Cl

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 230

NER-命名实体识别 序列生成方法

序列生成方法是将NER任务视为一个序列生成的过程,输入为原始文本,输出为相应的实体标签序列或者加上标签后的原文本序列,它与序列标注的方法的一大区别是它更灵活,不要求输出序列与输入序列的长度严格相同。

weixin_72032564的博客 1688

深入解析 OpenClaw(小龙虾)源码:架构设计与核心实现

OpenClaw用清晰、工程化的代码结构,将复杂的Agent交互流程变成了可管理、可扩展的流水线。无论是想深入了解Agent系统设计,还是希望二次开发定制自己的AI助理,阅读OpenClaw源码都是一次绝佳的学习旅程。希望本文能帮助你快速掌握OpenClaw的核心脉络。如果你对某个模块(如技能开发、安全机制)感兴趣,欢迎继续探讨。本文基于OpenClaw社区版本源码分析,具体实现可能随版本迭代有所调整,请以最新源码为准。

Ven%的博客 449

5个开箱即用的Transformer应用实战指南

Transformer模型是现代自然语言处理的核心架构,其核心原理在于自注意力机制与位置编码协同建模长程依赖。依托Hugging Face生态,开发者无需从零训练即可调用经过大规模验证的预训练模型,显著降低工程门槛并提升落地效率。这类默认管道(pipeline)在文本分类、文本摘要、问答系统、文本生成和命名实体识别五大高频任务中展现出优异的泛化性与部署友好性,尤其适合中小团队快速构建MVP或支撑企业级NLP服务。本文聚焦真实场景中的参数调优、边界处理与避坑实践,帮助读者绕过理论深坑,直击生产可用的落地路径。

weixin_34378969的博客 466

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

轻量级双向Transformer在NER中的高效落地实践

命名实体识别(NER)作为自然语言处理的基础任务,其核心挑战在于平衡上下文建模能力与推理效率。传统BERT类模型虽具备双向语义理解能力,但O(n²)注意力计算、固定长度填充及标签依赖断裂等问题,导致在金融、医疗、政务等真实场景中面临高延迟、显存溢出与边界识别不准等工程瓶颈。本文聚焦‘高效双向建模’这一关键技术路径,结合分层注意力裁剪、动态跨度掩码与实体感知位置编码,将计算复杂度降至O(n·log n),同时保障端到端延迟<80ms、显存<3GB、CPU回退F1>75%。面向工业级NER部署需求,内容覆盖数据

weixin_30698297的博客 331

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Transformer模型推理实践:从原理到Hugging Face应用

Transformer架构通过自注意力机制实现了序列数据的并行化处理,已成为NLP领域的核心基础设施。其推理过程本质是前向计算图执行,涉及文本向量化、位置编码和多头注意力等关键环节。Hugging Face Transformers库封装了BERT、GPT等模型的标准化推理流程,支持文本分类、实体识别等任务。通过批处理、量化(FP16/INT8)和ONNX Runtime等技术,可显著提升推理效率。典型应用场景包括智能客服系统、多语言翻译和文本摘要生成,其中温度参数和束搜索对生成质量影响显著。

weixin_34268169的博客 276

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

《精通Transformer》?ChatGPT:放弃战斗吧,向Transformer投降!

当下红得发紫的chatGPT,给了我小小的危机感,因为我是写文案的企宣,未来可能会被机器人替代吧。现在更可怕了,chatGPT背后真正的大佬 Transformer来了,会带来什么伟大的变革呢?

2401_85325557的博客 729

向Transformer投降!《精通Transformer》神书来了(附PDF)

当下红得发紫的chatGPT,给了我小小的危机感,因为我是写文案的企宣,未来可能会被机器人替代吧。现在更可怕了,chatGPT背后真正的大佬 Transformer来了,会带来什么伟大的变革呢?

DEVELOPERAA的博客 1165

Transformer大模型应用解析:Bert与GPT的对比及收藏学习攻略

本文详细解析了Transformer在大模型中的两个代表性应用:Bert和GPT。Bert采用双向Transformer编码器,擅长文本理解,通过预训练+微调的方式学习文本表示;GPT则采用单向Transformer解码器,专注于生成任务,通过因果掩码实现文本生成。文章还介绍了BERT的输入结构、预训练过程以及下游任务的微调方法,并强调了预训练的自监督特性和微调的有监督特性。

ytt0523_com的博客 929

如何用 Path of Building PoE2 快速验证伤害:天赋树与装备规划完全指南

Path of Building PoE2 是一款面向《流放之路2》(Path of Exile 2)的免费离线 build 规划器:输入技能、天赋与装备,它即时算出技能 DPS、生存总值与各项属性的推导过程,并支持天赋树可视化规划与词缀制作模拟。 ## 一个典型的反复试错场景 新版本刚开,你给角色点了满屏天赋,又连续换了三次手套和戒指,游戏里的实测伤害却一次比上次低——说不清到底是哪个节点白

gitblog_00509的博客 489

GTE-large一文详解:基于ModelScope的中文通用领域向量模型部署全流程

本文介绍了如何在星图GPU平台自动化部署GTE文本向量-中文-通用领域-large应用镜像,实现中文文本的高质量向量表示。该镜像支持命名实体识别、情感分析等自然语言处理任务,可快速应用于智能客服、内容分析等场景,显著提升中文文本理解与处理的效率。

weixin_34064233的博客 299
上一篇: 全面、系统、深度:RAG技术全景解析,AI开发者必收藏
下一篇: 如何写好AI Agent?一位开发者的10条实战经验总结(建议收藏)
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1482原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值