基于 Spring AI 的 RAG 架构设计:如何实现高效的知识检索与生成?

【Spring AI】第三弹:深入解析 RAG 核心特性、关键流程、基于 Spring AI + 知识库实现 RAG 检索增强器 深入解析 RAG 核心特性、关键流程、基于 Spring AI + 知识库实现 RAG 检索增强器 阅读详情

Spring AI RAG技术:在线检索技术深度解析

在AI技术快速发展的今天,传统大语言模型面临着一个核心挑战:知识时效性问题。模型训练完成后,其知识库就被"冻结"在训练时点,无法获取最新信息,同时也无法获取企业内部一些知识。

RAG(Retrieval-Augmented Generation,检索增强生成)技术的出现,为这一问题提供了优雅的解决方案。

本文将深入解析RAG技术中的在线检索部分,基于Spring AI Alibaba框架的实际实现,为您揭示如何构建一个高效、智能的知识检索系统。

什么是RAG在线检索?

核心概念

RAG在线检索是RAG系统的"大脑中枢",负责在用户提问时实时从知识库中找到最相关的信息。它就像一个智能图书管理员,能够:

  • 理解用户问题的真实意图
  • 快速定位相关知识片段
  • 智能排序和筛选结果
  • 为后续生成提供精准素材

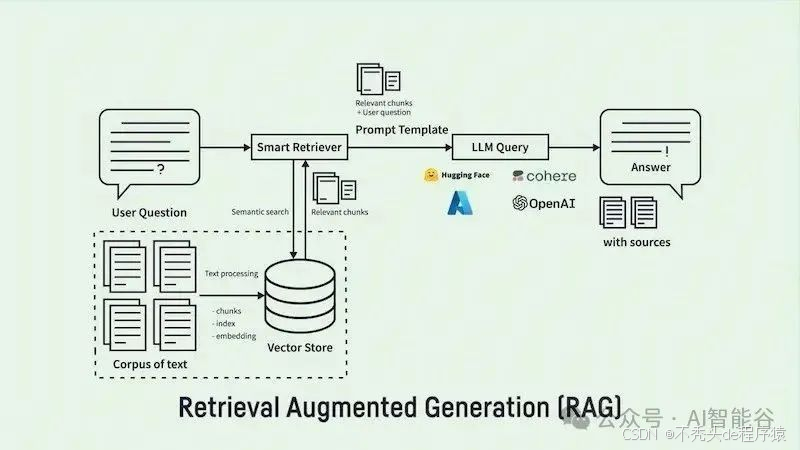
在这里插入图片描述

RAG流程图

Spring AI中的在线检索实现

基础检索配置

首先,让我们看看如何在Spring AI中配置基础的检索功能:

@Configuration
publicclass RagConfig {

@Bean
    VectorStore vectorStore(EmbeddingModel embeddingModel) {
SimpleVectorStore simpleVectorStore= SimpleVectorStore.builder(embeddingModel)
                .build();

// 添加知识文档
        List<Document> documents = List.of(
new Document("产品说明书:产品名称:智能机器人\n" +
"功能:\n" +
"1. 自动导航:机器人能够自动导航到指定位置。\n" +
"2. 自动抓取:机器人能够自动抓取物品。\n" +
"3. 自动放置:机器人能够自动放置物品。\n"));

        simpleVectorStore.add(documents);
return simpleVectorStore;
    }
}

智能检索控制器

@RestController
@RequestMapping("/ai")
public class RagController {

@Autowired
private ChatClient chatClient;

@Autowired
private VectorStore vectorStore;

@PostMapping(value = "/chat", produces = "text/plain; charset=UTF-8")
public String generation(String userInput) {
return chatClient.prompt()
                .user(userInput)
                .advisors(new QuestionAnswerAdvisor(vectorStore))
                .call()
                .content();
    }
}

基础实现的局限性

虽然上述代码实现了RAG的基本功能,但在实际应用中会遇到以下问题:

1. 检索精度不足
  • 问题表现

    :用户问"机器人的导航功能如何?"可能检索不到相关文档

  • 根本原因

    :简单的向量相似度匹配无法处理语义变化和同义词

2. 上下文理解缺失
  • 问题表现

    :多轮对话中,"它还有其他功能吗?"这类代词引用无法正确理解

  • 根本原因

    :缺乏对话历史的上下文感知机制

3. 查询表达局限
  • 问题表现

    :用户的口语化表达"这个机器人能干啥?"可能匹配效果差

  • 根本原因

    :没有查询标准化和扩展机制

4. 结果质量不稳定
  • 问题表现

    :有时返回不相关或质量较低的文档片段

  • 根本原因

    :缺乏相似度阈值控制和结果过滤

解决思路:为了解决这些问题,我们需要引入更高级的检索技术,包括查询扩展、上下文感知、智能过滤等机制。

高级检索技术详解

针对基础实现中的问题,Spring AI Alibaba提供了一系列高级检索技术。这些技术能够显著提升检索的准确性和用户体验:

技术方案解决问题核心价值
多查询扩展检索精度不足通过生成多个查询变体提高召回率
查询重写查询表达局限将模糊查询转换为明确的检索目标
上下文感知上下文理解缺失结合对话历史理解代词和隐含引用
智能过滤结果质量不稳定通过阈值和元数据过滤提升结果质量

1. 多查询扩展(Multi Query Expansion)

多查询扩展是提升检索准确性的关键技术。当用户提出简短问题时,系统会自动生成多个相关查询变体:

// 创建查询扩展器
MultiQueryExpander queryExpander= MultiQueryExpander.builder()
        .chatClientBuilder(builder)
        .includeOriginal(false)  // 不包含原始查询
        .numberOfQueries(3)      // 生成3个查询变体
        .build();

// 执行查询扩展
List<Query> queries = queryExpander.expand(
new Query("如何提升系统性能?"));

扩展效果示例:

原始查询:"如何提升系统性能?"

扩展后的查询:

  1. "系统性能优化的最佳实践有哪些?"
  2. "提高应用程序运行效率的方法"
  3. "系统响应速度慢的解决方案"

技术优势:

  • 提高召回率

    :通过多角度查询增加相关文档的检索机会

  • 语义丰富化

    :捕获查询的多种可能含义

  • 覆盖盲区

    :减少因表达方式差异导致的检索遗漏

实际效果对比:

基础实现:用户问"数据库很慢怎么办?" → 可能检索不到相关文档

多查询扩展:

  • 原始查询:"数据库很慢怎么办?"
  • 扩展查询1:"数据库查询性能优化方法"
  • 扩展查询2:"如何解决数据库响应缓慢问题"
  • 扩展查询3:"数据库性能调优的最佳实践"

通过多个查询变体,系统能够从不同角度匹配文档,大大提高了检索成功率。

2. 查询重写(Query Rewrite)

查询重写技术能够将模糊的用户问题转换为更加明确和结构化的查询:

// 创建查询重写转换器
QueryTransformer queryTransformer= RewriteQueryTransformer.builder()
        .chatClientBuilder(builder)
        .build();

// 执行查询重写
Query query=new Query("我们公司的微服务架构遇到了一些问题,请问Spring Cloud的配置中心怎么用?");
Query transformedQuery= queryTransformer.transform(query);

重写效果:

  • 原始查询:"我们公司的微服务架构遇到了一些问题,请问Spring Cloud的配置中心怎么用?"
  • 重写后:"Spring Cloud配置中心的使用方法"

解决的核心问题:

基础实现问题:

  • 用户查询:"我们项目中用的Redis缓存好像有点问题,经常出现数据不一致的情况,这个要怎么处理?"
  • 问题:查询冗长,包含背景信息,检索效果差

查询重写解决:

  • 重写后:"Redis缓存数据一致性问题解决方案"
  • 效果:去除冗余信息,聚焦核心问题,提高匹配精度

3. 上下文感知查询(Context-aware Queries)

在多轮对话中,用户的问题往往依赖于之前的对话上下文。Spring AI提供了强大的上下文感知机制:

// 构建带有历史上下文的查询
Query query= Query.builder()
        .text("那这个小区的二手房均价是多少?")
        .history(
new UserMessage("深圳市南山区的碧海湾小区在哪里?"),
new AssistantMessage("碧海湾小区位于深圳市南山区后海中心区,临近后海地铁站。")
        )
        .build();

// 使用上下文压缩转换器
QueryTransformer queryTransformer= CompressionQueryTransformer.builder()
        .chatClientBuilder(builder)
        .build();

Query transformedQuery= queryTransformer.transform(query);

上下文处理效果:

  • 模糊查询:"那这个小区的二手房均价是多少?"
  • 明确查询:"深圳市南山区碧海湾小区的二手房均价是多少?"

解决多轮对话问题:

❌ 基础实现问题:

用户:机器人有哪些功能?
AI:机器人具有自动导航、自动抓取、自动放置等功能。
用户:它的导航精度如何?  ← 基础实现无法理解"它"指什么

✅ 上下文感知解决:

用户:机器人有哪些功能?
AI:机器人具有自动导航、自动抓取、自动放置等功能。
用户:它的导航精度如何?
系统理解:查询"机器人的导航精度如何?" ← 自动补全上下文

通过上下文感知,系统能够准确理解代词引用,保持对话的连贯性。

其他RAG增强技术

虽然Spring AI目前主要支持基于向量相似度的检索方式,但RAG领域还有一些更前沿的技术值得关注:

HyDE(Hypothetical Document Embeddings)

HyDE是一种创新的检索增强技术,其核心思想是"先生成假设答案,再用答案检索文档":

传统检索流程:
用户问题 → 向量化 → 检索相似文档 → 生成答案

HyDE检索流程:
用户问题 → 生成假设答案 → 假设答案向量化 → 检索相似文档 → 生成最终答案

技术优势:

  • 语义对齐

    :假设答案与真实文档在语义空间中更接近

  • 提升召回

    :减少问题与答案之间的语义鸿沟

  • 适应性强

    :特别适合专业领域的复杂查询

混合检索(Hybrid Retrieval)

混合检索结合多种检索策略,实现优势互补:

检索方式优势局限性
向量检索语义理解强对精确匹配敏感度低
关键词检索精确匹配准确语义理解能力弱
混合检索兼具两者优势实现复杂度较高

实现思路:

HybridRetriever hybridRetriever= HybridRetriever.builder()
    .vectorRetriever(vectorStoreRetriever)     // 向量检索
    .keywordRetriever(elasticsearchRetriever)  // 关键词检索
    .fusionStrategy(RRFusion.create())         // 结果融合策略
    .build();

总结

RAG在线检索技术为AI系统提供了强大的实时知识获取能力。也可以应用在企业应用方面产生价值如

智能客服系统

在智能客服场景中,RAG在线检索能够:

  1. 实时查找产品信息

    :根据用户问题快速定位相关产品文档

  2. 多维度信息整合

    :结合产品规格、使用说明、常见问题等多源信息

  3. 个性化回答生成

    :基于检索结果生成针对性的专业回答

企业知识管理

在企业内部知识管理中:

  1. 文档智能检索

    :从海量企业文档中精准找到相关信息

  2. 跨部门知识整合

    :整合不同部门的专业知识

  3. 实时知识更新

    :支持知识库的动态更新和扩展

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

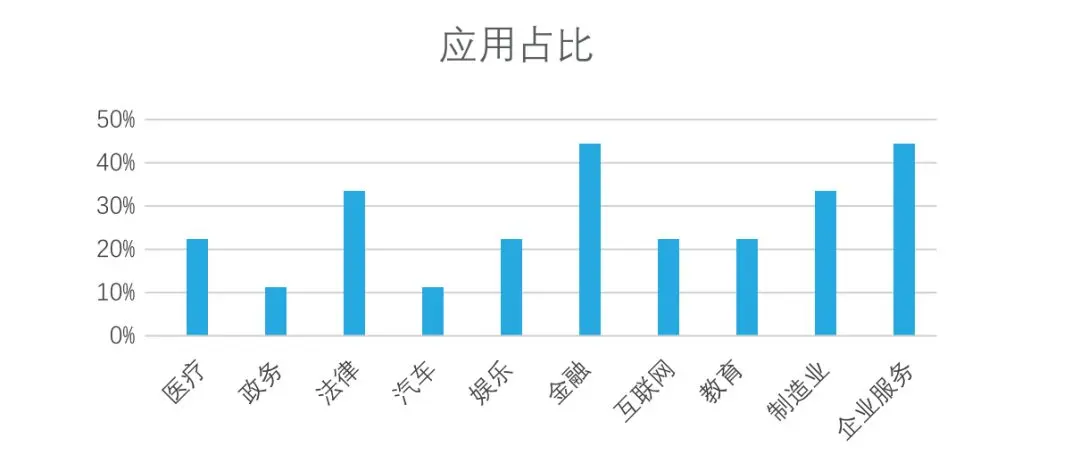
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

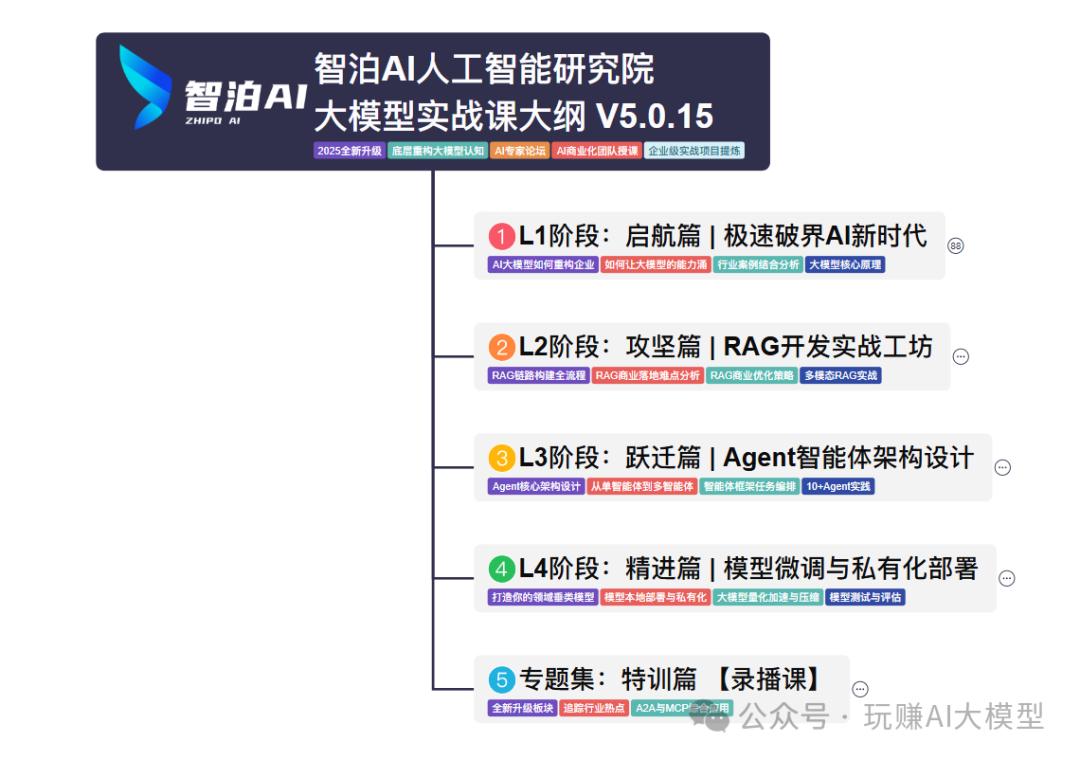
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

Spring AI:检索增强生成(RAG) SpringAI介绍了检索增强生成(RAG)技术的实现方法,包括现成的QuestionAnswerAdvisor和RetrievalAugmentationAdvisor解决方案,以及模块化自定义流程。系统支持查询转换(如重写、压缩、翻译)、多查询扩展、向量存储检索(带元数据过滤)和文档后处理等功能。通过ContextualQueryAugmenter将检索内容整合到提示中,可显著提升语言模型回答的准确性。开发者可灵活配置相似度阈值、top-K结果数量等参数,并支持静态/动态过滤器表达式。该框架采用模块化设 阅读详情

相关推荐

Spring AI之检索增强生成(Retrieval Augmented Generation, RAG)

当用户提问时,QuestionAnswerAdvisor 会从向量数据库检索与问题相关的文档,并将结果附加到用户输入中,为 AI 生成回复提供上下文。Spring AI 提供了基于模块化架构的 RetrievalAugmentationAdvisor ,支持开箱即用的常见 RAG 流程。默认情况下,若未检索到相关文档,模型将拒绝回答。功能:根据文档与查询的相关性对列表重新排序,将最相关文档置于顶部,解决中间迷失问题。功能:移除不相关或冗余文档,解决中间迷失问题 和模型上下文长度限制。

湖边工程师 1690

Spring AI 混合搜索:如何让 RAG 检索准确率达到 95%?(附 RRF 算法实现)

单一向量搜索存在语义匹配不精确、无法处理专有名词等问题。混合搜索结合关键词搜索(BM25)、向量相似度搜索、元数据过滤三种技术,显著提升检索精度和召回率。本文深入讲解混合搜索的架构设计、Spring AI 集成代码、权重调优技巧、Reciprocal Rank Fusion (RRF) 算法实现。通过实测数据对比单一搜索与混合搜索的准确率、召回率、F1 分数,展示如何在生产环境中实现 95%+ 的检索准确率。掌握这些技能,你将能够构建企业级高精度 RAG 系统。

腾讯云创作之星、华为云云享专家,深耕电商全栈高并发系统实战,分享可商用商城项目源码。 1009

Spring AI实现RAG(检索增强生成)详解与实践

支持多种文件格式的文档加载实现高效的向量存储和检索构建智能的问答系统提供可追溯的知识服务RAG技术为AI应用提供了强大的知识增强能力,使得模型能够基于实际文档生成准确、可靠的回答。

beiduofen2011的专栏 1240

基于Spring AI的业务数据NER增强混合检索RAG系统

本文提出了一种基于Spring AI的业务数据NER增强混合检索RAG系统架构。该系统采用"向量化→检索→生成"三阶段流程,核心特点包括: 采用Elasticsearch双索引设计,分别存储原始数据和向量化数据 实现多字段向量化(标题、作者、期刊名称),避免信息污染并提升检索精度 结合NER实体识别与意图理解,构建混合检索查询(精确匹配+向量检索) 使用GLM-4-Flash模型实现流式答案生成 技术栈包括Spring AI、GLM-4-Flash、Elasticsearch和MySQL

后端开发 1215

【Spring AI+Spring AI Albaba从零开始的学习之旅】之RAG(向量检索增强生成)篇

摘要:本文介绍了GPT模型的局限性(仅支持2021年9月前的数据)以及三种定制AI模型整合自有数据的技术方案:微调(FineTuning)、提示词填充(PromptStuffing)和函数调用(FunctionCalling)。重点讲解了检索增强生成(RAG)技术的原理与实现,包括离线知识库构建(数据加载、文本分割、向量嵌入)和在线交互(问题处理、相似性检索、回答生成)两阶段流程。通过SpringAI框架演示了向量生成、向量存储、ETL管道等核心组件,并以SimpleVectorStore为例展示了RAG的

m0_74808313的博客 1275

检索增强 RAG详解 :用spring ai的组件来做个问答机器人

基于RAG(检索增强生成)技术,可以使用Java开发智能客服机器人。核心思路是首先将问答QA以Word形式导入系统,并通过数据准备流程进行清洗和向量化处理。接着,利用向量化后的数据构建索引,便于快速检索。当用户提出问题时,系统先识别查询意图并改写查询,再从已建立的索引中检索相关信息。最后,根据检索结果生成回答返回给用户。这一过程充分利用了RAG能力,结合大模型如阿里云通义千问,使得Java智能问答客服机器人能够高效、准确地提供服务。

whisperzzza的博客 1838

spring ai 结合向量检索使用

本文介绍了使用Spring AI实现内存向量存储与检索的方法。首先配置内存向量存储组件VectorStore,然后演示了添加文本数据到向量库的过程。在检索环节,通过向量相似度搜索找到相关文档内容,再结合AI模型生成回答。测试结果表明,当问题匹配到存储内容时能返回准确答案,否则提示"未找到相关信息"。该方案实现了基于内存向量的简单问答系统。

weixin_52434911的博客 248

Spring AI--RAG知识库

RAG(检索增强生成)是一种结合信息检索和AI生成的技术,通过查询外部知识库提高大模型回答的准确性。其工作流程包括文档收集切割、向量转换存储、检索过滤和查询增强四个步骤,关键技术涉及Embedding模型、向量数据库和混合检索策略。文章还演示了基于SpringAI的RAG实现,包括本地知识库处理和云知识库服务对接。通过实例代码展示了文档加载、向量存储及检索增强的应用,为开发者提供了从理论到实践的完整指南。

qq_57465625的博客 916

【AI 工程化第十三篇】Spring AI Agentic RAG 混合检索与重排实战:查询改写、RRF、Reranker 与可解释引用

【AI 工程化第十三篇】Spring AI Agentic RAG 混合检索与重排实战:查询改写、RRF、Reranker 与可解释引用

木头博客 170

Spring AI 实现 RAG

Spring AI框架实现RAG(检索增强生成)技术,整合了信息检索与生成模型,用于构建智能问答系统。该方案采用Spring Boot框架,支持多种大语言模型(如OpenAI、Qwen)和向量数据库(Elasticsearch)。核心流程包括:使用Tika读取多格式文档并向量化存储,进行相似性搜索匹配问题,通过提示词模板优化LLM生成质量。配置文件中可自定义嵌入模型、向量维度和相似性算法。Spring AI的模块化设计简化了RAG实现,但需注意版本兼容性和向量维度匹配问题。

红血哥 1715

AI 超级智能体全栈项目阶段四:学术分析 AI 项目 RAG 落地指南:基于 Spring AI 的本地与阿里云知识库实践

本文以 AI 项目为背景,聚焦 RAG 技术价值。通过 Spring AI 框架,详解本地知识库(MD 文档)与阿里云知识库的 RAG 实战,含文档处理、向量存储等关键步骤,验证其在论文写作指导等场景的效果,提供技术落地方案。

Varin 3266

Spring AI Alibaba与Elasticsearch集成:增强智能体的搜索与分析能力

在企业级AI应用开发中,智能体(Agent)需要高效处理和检索海量数据。Spring AI Alibaba作为Java开发者的应用框架,通过与Elasticsearch(分布式搜索引擎)的深度集成,为智能体提供了强大的向量存储和混合搜索能力。本文将详细介绍如何通过这一集成提升智能体的信息检索效率和分析准确性。 ## 集成架构与核心价值 Spring AI Alibaba与Elasticsear...

gitblog_00276的博客 803

基于Spring-AI框架实现RAG增强检索(附源码)

通过上述步骤,我们成功地基于Spring-AI框架实现了RAG增强检索。这种方法结合了文档检索和文本生成,能够提供更加丰富和准确的回复。希望本文能够帮助开发者更好地理解和应用Spring-AI框架,开发出更加智能的应用程序。

道长的博客 3781

【spring ai】java 实现RAG检索增强,超快速入门

spring ai rag 人工智能检索增强能力提升,快速入门

whisperzzza的博客 4150

堆内存管理核心逻辑 超详细复习笔记

本文详细解析了堆内存管理的核心逻辑,包括初始化、分配和释放三个关键环节。系统通过全局堆管理结构体和链表机制实现动态内存管理:初始化时标记整块内存为空闲;分配时遍历链表查找合适空闲块并进行分割;释放时定位内存块头并重新标记为空闲,支持相邻块合并以减少碎片。文章对比了链表式管理和线性分配的优缺点,指出链表式更灵活但实现复杂,线性分配简单但无法释放。最后总结了常见错误(如指针回推错误、碎片问题)和扩展知识(不同内存管理算法)。这套机制是理解嵌入式系统和RTOS内存管理的基础。

2502_92009732的博客 1205

跨时钟域传输数据——单bit和多bit信号(总结)

总结单bit和多bit信号的跨时钟域传输

qq_42135020的博客 1万+

Spring AI:RAG 增强检索介绍

Spring AI:RAG 增强检索介绍

weixin_46619605的博客 1947

51单片机智能小车

最近学校举办了一个智能小车比赛,比赛内容为用手机蓝牙控制小车拥有5个功能,分别是超声波舵机避障,测距(显示在LCD1602上), 红外跟随,循迹还有蓝牙控制小车前进后退左转又转以及停止。 文章目录 蓝牙控制所有功能 一、蓝牙控制前进后退左转右转停止 二、舵机超声波避障加测距 三、红外跟随 四、循迹 五、代码部分 六、完整代码 前言 基于51单片机的智能小车是比较基础的小车,很适合初学者学习 提示:以下是本篇文章正文内容,下面案例可供参考 一、整体思路 这款小...

m0_55977420的博客 1万+

spring ai alibaba检索增强生成RAG技术实现企业内部知识库检索(问答)系统,not模型微调

企业内部可能有各种文档如会议纪要,产品说明,操作规程,各种规范等,如何让这些内容方便内部检索提高工作效率,以前的做法可能大多是依赖实现,AIGC的发展让我们有了更优的实现方案。基于LLM实现企业内部知识库检索常见方案有:基于(Fine-tuning)与。

MJ的博客 1527

Neo4j 智能供应链应用源代码简析

本文简析Neo4j智能供应链应用的源代码,让你也可以快速开发自己的供应链应用。

Neo4j 开发者博客 1681

时钟门控ICG单元的timing问题

本文探讨了数字IC设计中门控时钟(ICG)的时序收敛问题,重点分析了ICG单元在setup时序检查中易出现违例的原因及优化方法。文章指出,由于ICG单元不在时钟树平衡范围内,其时钟路径延迟通常小于后续寄存器,导致setup时序难以满足。提出的解决方案包括:1)将ICG尽量靠近受控寄存器放置;2)使用set_clock_gating_check命令加强时序约束;3)在布局阶段设置负时钟延迟;4)CTS阶段设置插入延迟。同时强调set_clock_gating_check命令对ICG单元同样有效,并介绍了ICG

u011075954的专栏 1113

Spring AI之RAG入门

本文介绍了RAG(检索增强生成)技术的概念、应用场景及核心流程,并详细说明了如何利用SpringAI框架实现RAG功能。

遥远 3040

MiniMaxH3+ComfyUI本地部署:一键整合包、工作流搭建与报错排查

本地部署视频生成模型时,模型权重、推理框架与自定义节点的匹配是核心挑战。MiniMaxH3作为多模态生成模型,通常依赖ComfyUI这类节点式工作流引擎实现可视化调度。一键整合包将Python环境、PyTorch算子、模型文件预置封装,大幅降低部署门槛,并通过半精度加载、显存碎片回收等机制优化推理速度。在文生视频、图生视频与批量生成场景中,清晰的节点链路和参数调优能力直接影响输出质量与显存占用。针对模型不识别、节点执行失败等高频问题,系统排查命令行日志与模型目录可快速定位故障。本文以MiniMaxH3整合包

weixin_29047545的博客 589

Spring AI系列之RAG(检索增强生成)从原理到实战指南

Spring AI与RAG技术解析 本文深入探讨了检索增强生成(RAG)技术在Spring AI生态中的应用。RAG通过结合大语言模型(LLM)与外部知识检索,有效解决了传统LLM的知识截止、幻觉问题、上下文限制和领域专业度不足等痛点。 文章详细剖析了RAG的核心架构,包括离线索引和在线检索生成两大阶段,重点讲解了Embedding技术如何将文本转换为语义向量,以及余弦相似度和欧氏距离两种关键算法。最后通过Spring AI+Milvus的实战案例,展示了如何创建向量集合、实现数据向量化存储等关键步骤,为开

Nicky's blog 2443

python提取图片中的文字写入excel文件,并打包为exe可执行文件

python提取图片中的文字写入excel文件,并打包为exe可执行文件

liqiang12689的博客 989

智元机器人开源具身仿真框架 Genie Sim 入门教程

GenieSim是AgiBot推出的具身智能仿真框架,提供完整闭环开发管道,包括轨迹生成、模型训练和基准测试。框架支持Docker容器化部署,要求Ubuntu 22.04和NVIDIA硬件环境。主要功能涵盖: 支持12种基准测试任务 提供ADER评估框架 集成UniVLA/RDT等基线模型 支持PICO/键盘遥操作 具备轨迹记录回放功能 提供完整API控制接口 开发者可通过Hugging Face获取场景资产,使用标准化ROS主题与仿真环境交互。框架特别优化了碰撞检测和抓取物理模拟,适用于从简单抓取到复杂操

2506_90492529的博客 2544
上一篇: 本地运行大模型+知识库:这款 59.4K Star 开源工具到底强在哪?
下一篇: 【3万字硬核长文】AI面试必看:Transformer 与扩散模型面试题全解析
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1479原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值