# Midjourney 重磅升级!新一代 “言出法随” AI 生图神器登场|附 10 + 实战场景演示与功能解析

Midjourney生成视频 | 一句咒语成大片 |【附教程】&【完整过程录制】| AI绘画工具图片一键生成视频|文字一键生成视频|图片生成视频工具 Midjourney生成视频 | 一句咒语成大片 |【附教程】&【完整过程录制】| AI绘画工具|图片生成视频|文字一键生成视频|midjourney妙用。本案例完整教程咒语及操作步骤的完整教程,目前均匀打包上传至百度云 ,大家可自行复现,且均已实测,见飞书文档。 阅读详情

在 AI 技术飞速发展的当下,曾经作为设计必备技能的 Photoshop,如今正面临着 “学与不学皆可” 的尴尬局面。Gemini 凭借 “言出法随” 的改图能力横空出世,用户只需简单一句话就能完成图像修改,迅速成为现象级应用;而 GPT-4o 上线的多模态生图功能同样不容小觑,其生成的吉卜力风格图片更是一夜之间刷爆网络。

面对这些新兴 AI 工具的强势崛起,老牌 AI 图像生成领域巨头 Midjourney 终于出手!近期,Midjourney 正式发布了最新版本 V7,为用户带来全新的 AI 绘图体验。

接下来,我们将为你详细梳理 Midjourney V7 新版本的核心亮点与实用功能 。
整体图像质量提高,对文字与图像提示的理解更准确,身体、手部及各种物体在细节上的一致性大幅增强。

人物肤色和面部细节更加自然清晰,材质纹理(如羽毛、衣物)质感表现精细,光影效果逼真。

能更好理解并呈现提示词描述的完整场景,元素间空间关系合理,背景与主体融合度高。

能准确表现特定视角,低角度和特写等拍摄风格表现专业。

氛围感和情感表达略弱,缺少一些戏剧性和神秘感,某些艺术风格的独特性和创意性稍显不足。

需要注意的是,V7 是首个默认启用模型个性化的版本。用户需解锁个性化设置才能使用此功能,整个过程约需 5 分钟,且可随时开关。

img

V7 的另一大亮点是「草稿模式」(Draft Mode)。该模式成本仅为标准模式的一半,图像渲染速度却提升至 10 倍。

在网页端使用时,提示栏将自动切换为「对话模式」,用户可直接通过指令调整内容,例如将猫替换为猫头鹰或将场景改为夜晚,系统会自动调整提示并生成新图像。

点击「草稿模式」并启用麦克风按钮后,用户还能进入「语音模式」,通过语音指令进行实时创作。若需明确运行草稿任务,用户可在提示后添加「–draft」参数,适用于排列组合或重复生成等场景。

img

Midjourney 官方表示,「草稿模式」是迄今为止迭代创意的最佳方式。

用户若对草稿图像满意,可点击「增强」或「改变」按钮,以完整质量重新渲染。需要注意的是,草稿模式下的图像质量低于标准模式,但其行为和美学表现高度一致,适合快速验证想法。

img

图片来自:@U79916881747113

V7 目前支持两种运行模式:Turbo 和 Relax。Turbo 模式速度更快,但成本为普通 V6 作业的 2 倍;草稿模式则成本减半。标准速度模式仍在优化中,预计不久后推出。

目前,放大、编辑和重新纹理功能将回退至 V6 模型,未来将逐步升级至 V7。情绪板和 SREF 功能已可用,后续更新将进一步提升性能。

Midjourney 团队透露,在未来 60 天内,每隔一至两周将推出新功能,其中最受期待的则是全新的 V7 角色和对象引用系统。

话不多说,先来看图。

知名博主 @nickfloats 分享了 Midjourney V6/V7版本基于同一提示词生成的的图片对比,一起来看看。

Prompt:A young Indian woman with dark hair in an open ponytail and a black jacket stands on a university campus, looking directly at the camera. The image has a 1990s-style movie still aesthetic, with a close-up portrait on a sunny day.

(一位年轻的印度女性,黑色头发扎成松散的马尾,穿着黑色夹克,站在大学校园里,直视镜头。照片呈现出 90 年代电影剧照风格,背景是阳光明媚的一天,特写的肖像。)

img

左:V6 右:V7

新版本的光线更加自然,尤其是在人物脸部,肤色更加清晰,细节更加丰富,画面焦点更加清晰,尤其是人物的发型部分,但也因此牺牲了一些氛围和情感的表达。

Prompt:A majestic barn owl perched on an ancient, moss-covered tree branch, surrounded by the misty forest. The scene is bathed in soft light filtering through the dense foliage, creating a magical and ethereal atmosphere. Photorealistic style with attention to detail of the feathers and textures.

(一只威严的 barn owl(仓鸮)栖息在一根古老、覆盖着苔藓的树枝上,周围是迷雾缭绕的森林。柔和的光线透过浓密的树叶洒下,营造出一种神秘而飘渺的氛围。画面风格为逼真的写实风格,细致入微地展现了羽毛和树皮的质感。)

img

左:V6 右:V7

新版本的猫头鹰羽毛纹理更加细腻,羽毛的层次感和光影效果更强,显得更加真实。猫头鹰的姿态方面,新版本更自然,身体略微倾斜,显得更有动态感,眼睛的细节也更生动,传递出一种警惕的神态。

简言之,鱼和熊掌,不可兼得,V7 在追求真实感的目标上更胜一筹;V6 则可能在追求画面冲击力和神秘感上更具优势。

Prompt:A person’s hand points towards the window of an airplane, which is seen from inside with its wing visible in profile. The sky outside shows a clear horizon at dawn or dusk. In front of them lies a vast expanse of ocean.

(一个人的手指向飞机窗外,窗外的飞机机翼从侧面可见。外面的天空清晰,天际线显示出黎明或黄昏的景象。眼前是广阔的海洋。)

img

左:V6 右:V7

同样都是从飞机舷窗向外看的情景,一只手指向窗外,V7 的进步肉眼可见,通过加入飞机机翼的元素,增加了画面的层次感和真实感,更能感受到身处飞机的视角。

Prompt:A close-up of broccoli being sautéed in oil, with the vegetable’s green florets contrasting against a dark brown sauce. A large spoon is partially visible inside a stainless steel pot filled with caramelized and shiny black glaze on top, against a white…

(一块近距离拍摄的西兰花在油中翻炒,绿意盎然的花椰菜与深棕色的酱汁形成鲜明对比。一只大汤勺部分可见,放在一个不锈钢锅中,锅里覆盖着一层焦糖色的光泽黑色酱汁,背景是白色的…)

img

左:V6 右:V7

V6 虽然通过特写镜头突出了酱汁和勺子,焦点非常明确,注意力很容易被吸引到酱汁的质感和细节上,但如果从提示词的要求出发,新版本展示整个锅内的西兰花和酱汁的搭配,呈现了一个更完整的烹饪场景,逻辑上更符合实际烹饪过程。

Prompt:Close-up of an anime woman’s face with a shocked expression, dark hair, in the anime style. Colorful animation stills, close-up intensity, soft lighting, low-angle camera view, and high detail.

(一位动漫女性的面部特写,表情震惊,黑色头发,呈现动漫风格。色彩丰富的动画画面,特写镜头强烈,柔和的光线,低角度拍摄,细节非常精致。)

img

左:V6 右:V7

光影和色彩的处理上,V7 也符合提示词中的「soft lighting」要求,脸部的高光和阴影过渡更加柔和自然,尤其是眼部和脸颊的光影分布,营造出更立体的效果。

Prompt:A dynamic film still of an epic space battle with sleek starfighters zooming past a massive space station, lasers firing, and a distant planet visible in the backdrop.

(一幅动态的电影画面,展示了一场史诗般的太空战斗,流线型的星际战斗机飞驰而过,巨大的太空站在一旁,激光四射,远处的行星清晰可见,构成了一幅震撼的画面。)

img

左:V6 右:V7

人像方面,v7 在细节的精细度和真实感(服装、皮肤、光影等)上有所提升,人物的立体感和与背景的融合度更高,但在情感传递、表情的戏剧性、动态感上有所倒退。

以下为三个具体的对比案例:

Prompt:1980s mystery film, low-angle shot of an evil-eyed French Butler sporting a black suit and grasping a candle in the hallway of a creepy Victorian mansion with musty decor. The warm candle glow evokes a spooky sense of mystery

(一张 1980 年代神秘电影风格的低角度镜头,拍摄了一位邪恶眼神的法国管家,身穿黑色西装,手中握着一支蜡烛,站在一座装饰陈旧、充满霉味的维多利亚式大厦走廊里。温暖的烛光营造出一种阴森神秘的氛围。)

img

左:V6 右:V7

Prompt:1990s medium-full street style fashion photo shot on Kodak 500T capturing a rugged 50-year-old man with curly gray hair, 5-o’clock shadow, and a stern look walking down the sidewalk on a bright spring morning in Paris. He’s wearing …

(一张 1990 年代中等全身街头风格的照片,使用 Kodak 500T 胶片拍摄,捕捉到一位五十多岁的男子,他有着卷曲的灰白色头发、胡茬和严肃的表情,正走在巴黎春日明媚的早晨人行道上。他穿着…)

img

左:V6 右:V7

Prompt:Cinematic, off-center, two-shot, 35mm film still of a 30-year-old french man, curly brown hair and a stained beige polo sweater, reading a book to his adorable 5-year-old daughter, wearing fuzzy pink pajamas, sitting in a cozy corner nook…

(一张电影感的 35 毫米胶片画面,构图偏离中心,拍摄了一位 30 岁的法国男子,卷曲的棕色头发,穿着一件弄脏的米色 polo 衫,正在给他可爱的 5 岁女儿读书。女儿穿着柔软的粉色睡衣,坐在一个温馨的角落里。)

img

左:V6 右:V7

海螺 AI+Midjourney 会是让图片动起来的王炸组合吗?网友 @ainextastro 也试了试。

img

下面由 @tanvitabs 用 v7 生成的这张照片则将 AI 图像生成的坑都踩了个遍,包括凭空多出来的第三只手,T 恤和西装着装上的混淆,以及不匹配的面部生成等。

img

最后留个课堂作业,以下是基于同一提示词生成的四张照片,你更喜欢哪个版本?请投票。

Prompt:Elegant female model standing by a large window in a sunlit room, soft morningliaht casting natural highlights and shadows on her face, wearing a flowing beigedress, relaxed pose, minimal makeup, 85mm lens depth of field, lifestyle fashioneditorial, cinematic tones, airy atmosphere

(一位优雅的女性模特站在阳光洒进的房间大窗旁,柔和的晨光在她的脸上投下自然的高光与阴影,身穿一袭飘逸的米色长裙,姿势放松,妆容简约。使用 85mm 镜头拍摄,背景有着浅景深,营造出生活方式时尚编辑感,画面呈现电影般的色调,空气感十足。)

img

你更喜欢哪张图片: 单选

Midjourney v7

Google Imagen 3

ChatGPT 4o

Reeve

投票

过去几年,AI 图像生成的主旋律是追求真实、无油腻感。

去年,Flux 因生成超真实人像而一举破圈,声名大噪,现在,Midjourney V7 接过接力棒,以更丰富的细节、更有层次感的光影、更自然的肤质纹理,再次将「真实」推向新的高度。

但追求真实,是一切的终点吗?

最近,随着 GPT-4o 多模态生图功能的发布,吉卜力风格的图片几乎在一夜之间点燃了网络,也像一阵春风吹进了 AI 图像生成的世界。

技术选择的可能性多了,创作的玩法也跟着变了。用更通俗的话来说,现在就好比站在厨房里,你是想做顿踏实的饭,还是想整点黑暗料理的,全然在你。

关于AI绘画技术储备

学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!

对于0基础小白入门:

如果你是零基础小白,想快速入门AI绘画是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。

二方面是可以找到适合自己的学习方案

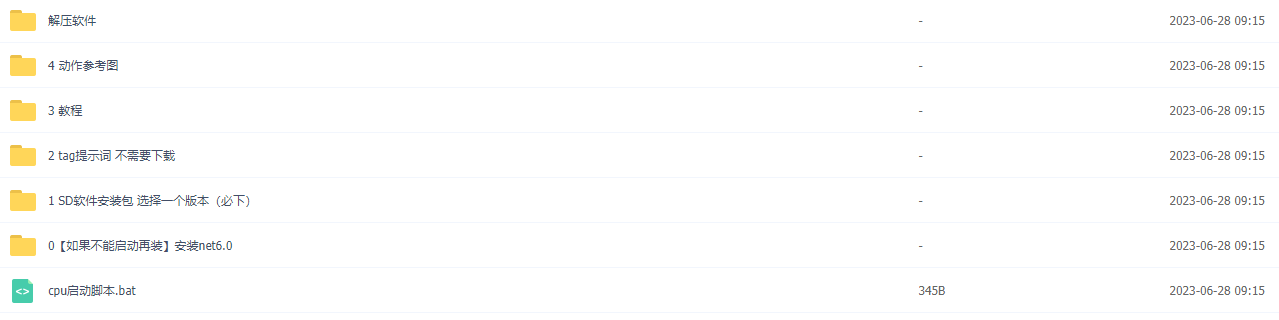
包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!

需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
1.stable diffusion安装包 (全套教程文末领取哈)

随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。

最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
在这里插入图片描述

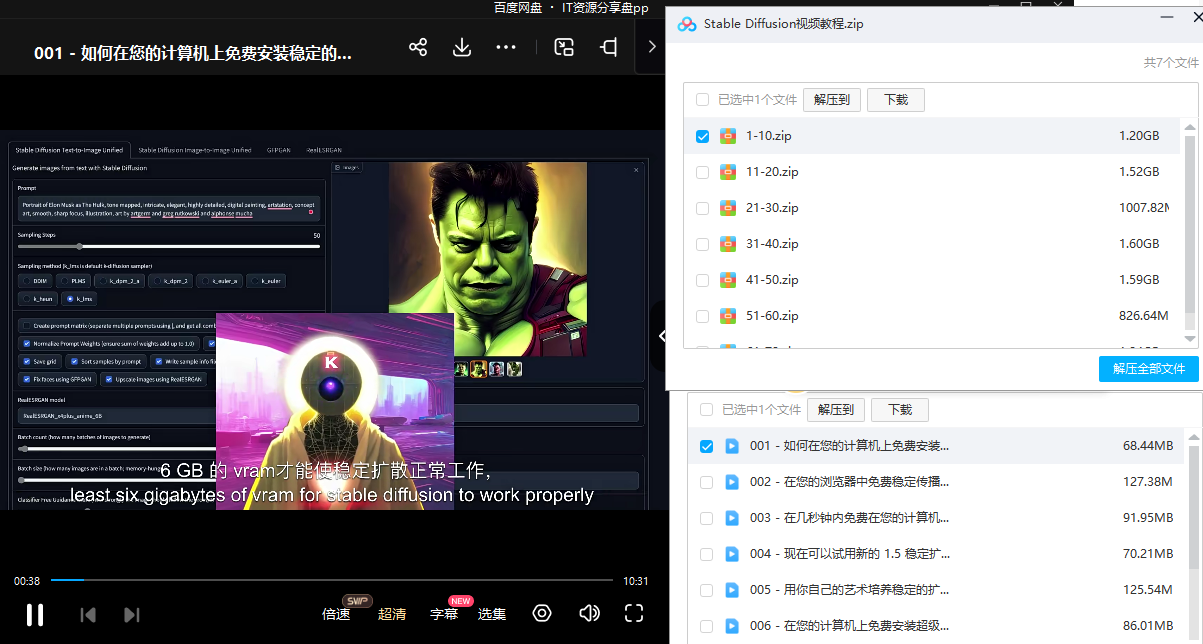
2.stable diffusion视频合集

我们在学习的时候,往往书籍代码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入门stable diffusion,科学有趣才能更方便的学习下去。
在这里插入图片描述

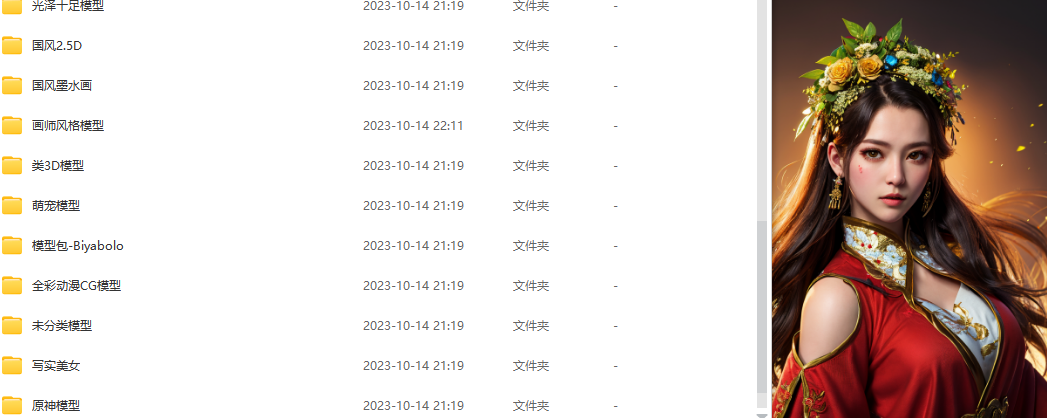
3.stable diffusion模型下载

stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
在这里插入图片描述

4.stable diffusion提示词

提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
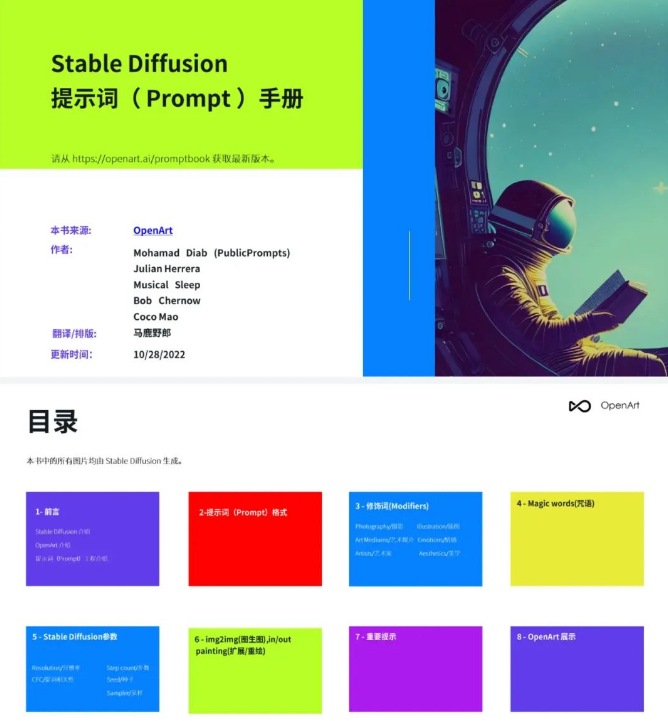
在这里插入图片描述

5.AIGC视频教程合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
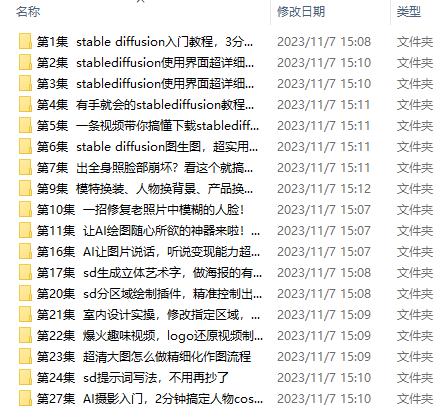
在这里插入图片描述

实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
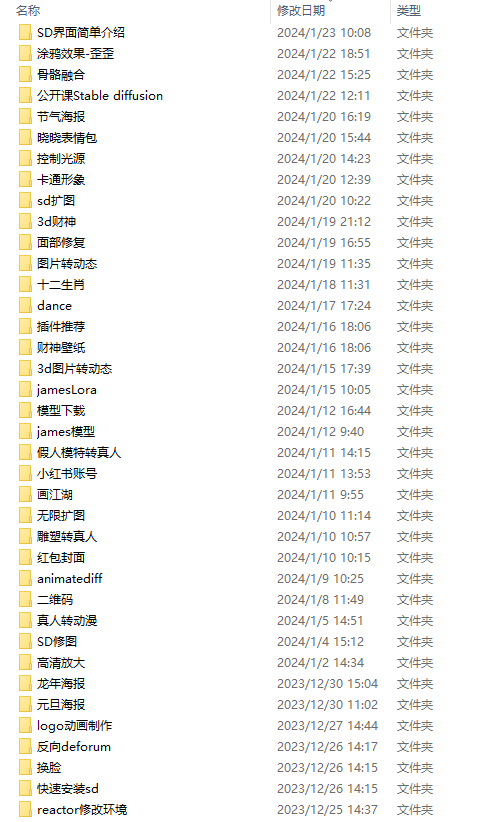
在这里插入图片描述

这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

Midjourney-V7:支持参考图片头像或背景生成新保真图 Midjourney最新发布的V7版本引入了革命性的OmniReference功能,这一升级旨在提升图像生成的精准度和个性化。OmniReference允许用户通过参考图像中的特定元素(如人物、物体或场景)来创作新图像,支持风格化处理和情绪板整合,确保视觉元素在新图像中得到忠实再现。用户可以通过网页端或Discord平台使用此功能,并通过参数调节精确控制参考图像的影响力。此外,V7版本还提供了多种使用途径,包括官网、Discord社区和套壳网站,使得操作更加便捷。从实测效果来看,V7版本在生成高清、符合描述 阅读详情

相关推荐

Vivado图形化界面烧写MCS文件到SPI FLASH全流程(附常见报错解决方案)

本文详细介绍了使用Vivado图形化界面将MCS文件烧录至SPI FLASH的完整操作流程。内容涵盖从环境准备、MCS文件生成到硬件连接与烧写的每一步,并针对SPI总线宽度报错、FLASH型号识别失败等常见问题提供了深度解决方案,帮助用户高效完成FPGA配置,摆脱对TCL命令行的依赖。

s8t9u0v1w的博客 536

Midjourney V6更新解读与侵权风险警告;AI Agent智能体创业必读;高清图解Mixtral和MoE;2023年度AI设计实践报告 | ShowMeAI日报

日报关键词:🉑Midjourney V6;智谱AI招聘;百度AGI Hackathon;金山办公CEO专访;🉑AI Agent创业必读;🉑LLaMA模型结构图;🉑图解Mixtral&MoE;🉑年度AI设计实践报告……点击阅读全文

ShowMeAI研究中心 1903

STM32F407 CanOpen主机实战:对象字典配置与多电机CIA402协议驱动详解

本文详细介绍了基于STM32F407的CanOpen主机开发实战,重点解析了对象字典的配置流程与多电机CIA402协议驱动方法。通过使用objdictedit工具配置SDO和PDO参数,并整合CanFestival协议栈,实现了对多个伺服电机的稳定同步控制。文章提供了从硬件连接到代码调试的完整指南,帮助开发者快速掌握工业现场的多轴运动控制技术。

plant的博客 535

大升级,从V4到V5,Midjourney有了这些新突破

Midjourney v5现已可用——介绍与v4相比的变化!

u013643074的博客 588

秋叶ComfyUI整合包:一键部署AI绘画工作流,解决环境配置难题

在AI绘画和生成式AI领域,Stable Diffusion作为开源的扩散模型,为图像生成提供了强大的技术基础。其核心原理是通过学习数据分布,对随机噪声进行逐步去噪,最终生成高质量的图像。这项技术的价值在于极大地降低了专业图像创作的门槛,并推动了AIGC(人工智能生成内容)在艺术设计、游戏开发、广告营销等场景的广泛应用。然而,其典型工作流实现工具ComfyUI,在实际部署中常因Python环境、PyTorch版本与CUDA驱动之间的复杂依赖关系而受阻,尤其是面对NVIDIA 30系、40系及未来50系等不同

优快云头条 675

LoRa项目实战:手把手教你为ESP32选配和焊接天线(从PCB到信号测试)

本文详细介绍了为ESP32选配和焊接LoRa天线的全流程,包括天线选型、PCB布局设计、焊接工艺及信号测试。重点解析了PCB板载天线、导线天线和陶瓷贴片天线的适用场景与性能特点,并提供专业的焊接技巧和信号测试方案,帮助开发者优化LoRa模块的无线通信性能。

weixin_30470643的博客 397

更强的可操作性!Midjourney两大重要功能更新!

Midjourney的这次升级,无疑是AI绘图领域的又一次重要突破。外部图像编辑功能和图像重新纹理模式,将极大地拓展用户的创作边界,无论你是艺术家、设计师还是营销人员,都能从中获得启发与便利。随着AI技术的不断发展,未来的创作工具将更加智能和高效,值得我们持续关注和探索。

玩AI的小胡子-博客 1868

Arduino开发实例-EMG 肌肉信号传感器

在医学研究中,测量肌肉的活动、收缩和扩张非常重要。 EMG 肌肉传感器测量肌肉活动并产生信号以显示扩张和收缩量。 因此,输出取决于所选肌肉的活动量。 3 绿色、红色和黄色电极连接到模块,用于传输来自肌肉运动的电信号。

视觉与物联智能 1702

Midjourney 重磅更新!两个超神功能开启测试,快来体验!

Midjourney 重磅更新!两个超酷的新功能正式(测试版)上线,准备好见证科技跃迁了吗? 首先,千呼万唤始出来的**图片编辑器终**于来了! 你以为只是简单的裁剪、旋转?No No No!这可是支持我们所有高级特性的编辑器! **风格参考、角色参考、个性化模型**统统都能用!

ice829的博客 502

ATECC508A芯片开发笔记(四):自定义配置508功能,规划DataZone数据存储

ATECC508A芯片开发笔记(四):自定义配置508功能,规划DataZone数据存储 508A内部存储区介绍 Data Zone Config Zone 508A Config Zone配置(自定义) - ATECC508A芯片在使用之前,需要自定义配置ConfigZone与DataZone,并同Lock命令将两个区域锁住,否则无法正常使用功能。而一旦锁上就是永久性的,配置区不能够进行解锁

HowieXue 薛永浩的博客 2万+

内容审核与文本安全技术综述:检测、过滤与对齐

检测质量高度依赖数据。毒性/仇恨/冒犯语言检测领域形成了一批经典数据集,但它们的标签体系差异很大:例如 OLID(OffensEval)强调“是否冒犯—冒犯类型—目标对象”三层结构;HateXplain 在“hate/offensive/normal”三分类之外,还提供目标群体与人类标注的 rationale span;RealToxicityPrompts 则不做离散标签,而是用毒性分数来研究“模型续写时的毒性退化”。ACL 汇编。

nmdbbzcl的博客 1373

Midjourney 可以训练自己的模型啦! Style Tuner 功能详解!

style directions 数量(16 / 32 /64/ 128 对),你将要在风格调谐器中看到的图像对数量,数量越多,选择越丰富,但耗时多。或者 --style random-16、--style random-64 或 --style random-128 随机结果。可以使用 --style 添加到提示词中啦~在每对中选择喜欢的图片,就是你自己模型的风格倾向~如果有不喜欢的也可以选中中间的空框。输入指令:/imagine ,复制的提示和 --style 完成!

月流霜的专栏 916

YOLOv8改进策略【卷积层】| CVPR-2023 部分卷积 PConv 轻量化卷积,降低内存占用

本文记录的是利用优化的目标检测方法研究。深度可分离卷积可以减少FLOPs,但会导致更高的内存访问,引起延迟并减慢整体计算。部分卷积利用逐点卷积处理通道冗余,减少模型计算量和内存访问量。Run, Don’t Walk: Chasing Higher FLOPS for Faster Neural Networks及其改进的实现代码如下: 四、创新模块 4.1 改进点⭐ 模块改进方法:直接加入(第五节讲解添加步骤)。模块加入如下:模块改进方法:基于的(第五节讲解添加步骤)。第二种改进方法是对中的进行改进,并将

Limiiiing的博客 1018

Midjourney 重大更新!深度解析「角色一致性」命令

大家期待已久的 MJ 角色一致性功能终于来啦!全新的命令“–cref”现已推出,与之前的样式参考“–sref”功能相似,但不同的是,它不是匹配参考样式,而是试图让角色与“角色参考”图像相匹配。目前,“–cref”仅适用于 niji 6 和 v6 模型。

qq_45901459的博客 5085

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain&#39;s apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath(&#39;DeepLearnToolbox&#39;));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand(&#39;state&#39;,0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W&#39;); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand(&#39;state&#39;,0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = &#39;sigm&#39;;%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, &#39;Too big error&#39;);```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand(&#39;state&#39;,0)sae = saesetup([784 100]);sae.ae{1}.activation_function = &#39;sigm&#39;;sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)&#39;)% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = &#39;sigm&#39;;nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, &#39;Too big error&#39;);```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x&#39;,28,28,60000))/255;test_x = double(reshape(test_x&#39;,28,28,10000))/255;train_y = double(train_y&#39;);test_y = double(test_y&#39;);%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you&#39;ll get around 1.2% errorrand(&#39;state&#39;,0)cnn.layers = { struct(&#39;type&#39;, &#39;i&#39;) %input layer struct(&#39;type&#39;, &#39;c&#39;, &#39;outputmaps&#39;, 6, &#39;kernelsize&#39;, 5) %convolution layer struct(&#39;type&#39;, &#39;s&#39;, &#39;scale&#39;, 2) %sub sampling layer struct(&#39;type&#39;, &#39;c&#39;, &#39;outputmaps&#39;, 12, &#39;kernelsize&#39;, 5) %convolution layer struct(&#39;type&#39;, &#39;s&#39;, &#39;scale&#39;, 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, &#39;Too big error&#39;);```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand(&#39;state&#39;,0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, &#39;Too big error&#39;);%% ex2 neural net with L2 weight decayrand(&#39;state&#39;,0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, &#39;Too big error&#39;);%% ex3 neural net with dropoutrand(&#39;state&#39;,0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, &#39;Too big error&#39;);%% ex4 neural net with sigmoid activation functionrand(&#39;state&#39;,0)nn = nnsetup([784 100 10]);nn.activation_function = &#39;sigm&#39;; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, &#39;Too big error&#39;);%% ex5 plotting functionalityrand(&#39;state&#39;,0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = &#39;softmax&#39;; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, &#39;Too big error&#39;);%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand(&#39;state&#39;,0)nn = nnsetup([784 20 10]); nn.output = &#39;softmax&#39;; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, &#39;Too big error&#39;);```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

Midjourney 官方用户端更新 · 基础介绍 · 多重个性化配置文件与情绪版

MidJourney 又更新了,更新了啥呐?官方称之为“**多重个性化配置文件与情绪板**”,在我写这个开头的时候,已经测试了一下午,一直考虑要不要写这篇,这个对新手不友好,且这个个性化基础架构还是早期版本...

ice829的博客 1483

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

一觉醒来Midjourney又更新了!这生成的图片“一言难尽”

今天给大家介绍一下Midjourney最新出的一个功能,风格随机。使用这个功能我们能够探索更多有趣的风格和视觉效果,更加充分的发挥出我们的脑洞和灵感。

m0_59236602的博客 1295

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

商品图/模特图/AI生图/AI修图案例展示,带你打造爆款图片

通过各个模块的案例演示,带您深入了解:图生生能做什么?

y_y_liang的博客 1122

Midjourney 即将离开 Discord ?Midjourney炸裂更新,能够编辑自己上传的图了!

前几天,Midjourney 发布了一个重磅更新——用户终于可以直接上传自己的图片进行编辑了!如果还没体验过,强烈建议去试试。MJ 似乎正在逐步摆脱 Discord 平台,逐渐独立,如果迁移到网页,之前账号怎么办?今天和大家聊聊。

m0_59236602的博客 1123

两大升级要点!Midjourney-v7版本强在哪里?

毕竟V6的画面质量就已经很高了。但现在,V7可以轻松还原你脑中的画面,而且生成的图片是高清的,纹理、姿态、表情都有细致表现,几乎可以媲美实拍。举个例子:我直接说一句话(是语音),“生成一张照片,内容是一个时尚的女人站在上海街道微笑看向镜头,背景是虚化的东方明珠塔。GPT-4o强,Midjourney V7 也强,各自发挥各自的优势,只会让我们这些创作者有更多、更好用的工具可选。所以,不用焦虑、不用担心白学,我们真正该关心的是如何用合适的AI工具给我们创造真正的价值,保持自己清晰的认知与判断。

玩AI的小胡子-博客 1994

教你用Midjourney+Pika玩转AI视频制作

初创公司Pika labs的出现着实给AI圈又添了一把火,这次我将展示如何用AI绘图工具Midjourney生成图像+Pika来制作视频。本次采用6张图片生成16秒的短片,来看具体操作。

2401_82571103的博客 2847

效果贼好!Midjourney最新更新,直接让你实现梗图自由!

专注于AI与CG的视觉呈现。内容涵盖前沿的AI与CG资讯、作品欣赏,行业流程、赛事,用技术与艺术描绘未来影像,为您开启全新的视觉体验。

ice_99的博客 946

最新midjourney一键安装,永久使用!midjourney安装包,midjourney下载安装教程!

Midjourney是一款功能强大的AI绘画工具,Midjourney可以帮助艺术家和设计师以全新的方式创作令人惊叹的艺术品。这个Midjourney教程会教你从最基本的开始,怎么用Midjourney创造自己想要的作品。今天给大家介绍一个 Midjourney 的安装教程。首先在浏览器前面搜索 discard 这个网页,在网页里边寻找第一个进行安装,寻找自己相对应的版本,比如你是 Windows 版本还是 Mac 版本进行安装,然后在下载文件里边显示下载内容,在文件夹显示里边我们双击就可以自行安装。

xxue345678的博客 1万+

Midjourney 升级了!揭秘个性化微调功能:一篇文章带你深入了解

例如,发送“California Poppies --ar 3:4 --sref random”后,返回的风格代码可能是 --sref 170339948,再次发送返回的可能是 --sref 2709899611。② 完成上述步骤后,将 --p 参数加在提示词后发送,生成的图像将展示你的专属风格,与默认模型明显不同。需求排行榜展示当前排名最高的用户需求,如生成同一角色的多个角度、改善手和手指的生成效果等,排名越高的功能越有可能被实现,因此值得大家积极参与投票。存在数十亿种不同的风格可供使用。

qq_22717943的博客 1843

[AI绘画]MidJourney重大更新:到底有多重大?

与常规版本发布惯例不同,Midjourney没有将新模型发布为V6.5。相反,他们选择分两个阶段推出:V6.1和V6.2。根据Midjourney创始人David Holz的说法,他们需要在下个月左右发布V6.2模型之前,尽可能多地收集用户使用V6.1的数据。Midjourney V6.1有哪些新特性?1.图像更加连贯:改进了手臂、腿、手、身体、植物和动物的渲染。2.提升图像质量:减少了像素瑕疵,改善了纹理效果,包括皮肤和8位复古风格。3.细节更加精细:小型图像特征(如眼睛、小脸和远处的手)更加精确准确。

2401_84760527的博客 1205
上一篇: # AI 绘画大师速成:一键实现提示词全自动生成
下一篇: # WebUI 太复杂?三步出图,零基础入门指南
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1482原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值