


对于Stable Diffusion部分参数的测试与理解
采样迭代与采样方式
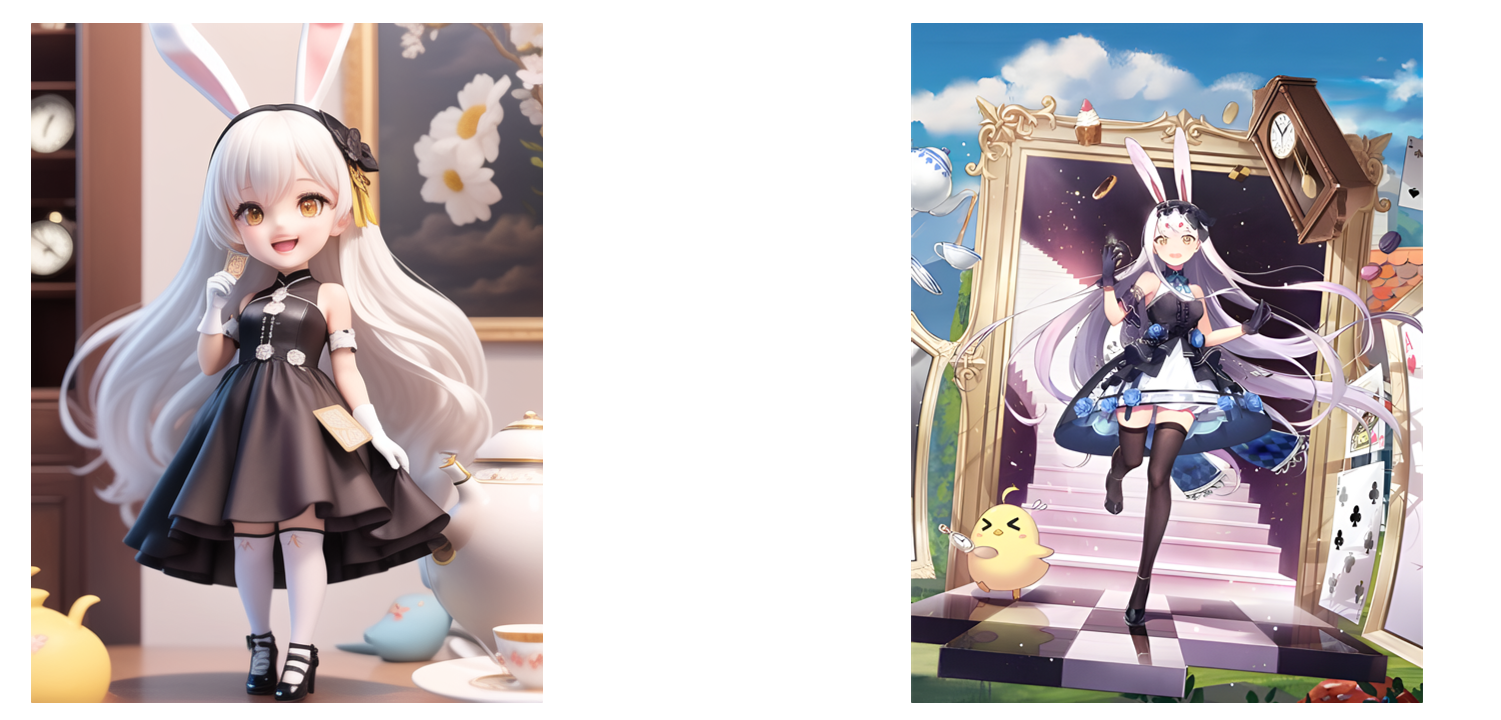
正向关键词是采用我之前做的一个二次元风格的内容碧蓝航线的岛风,在尽可能的避免出现畸形错误变型的情况下采用了大佬们的反向关键词。整体测试尽在改变采样迭代步数(Steps)与采样方法(Sampler)的情况进行。模型并未采用SD默认模型并且加入了LORA模型,测试内容可能会略有失准。所以仅供参考!!!
以下是默认参考参数,红色内容是测试内容:
Stable
Diffusion模型(ckpt)revAnimated_v11采样迭代步数(Steps)28随机种子(seed)917113818模型的VAE(SD
VAE)animevae采样方式(Sampler)Eulera a提示词关联性(CFG Scale)7Clip
跳过层2面部修复否宽度512Lorablindbox_V1Mix可平铺(Tilling)否高度680高清修复否放大算法无放大倍率无高清修复采样次数无重绘幅度(Denoising)无特殊关键词(必须)chibi
关键词
正向关键词
中文
(杰作),(最好的质量),(超详细),(全身:1.3),1个女孩,赤壁,可爱的,动物耳朵,手套,兔子耳朵,高抬腿,长发,无袖的,裙子,manjuu(碧蓝航线),茶碗,怀表,卡片,无袖连衣裙,黄眼睛,白色的头发,杯子,黑手套,茶壶,张开嘴,独奏,天空,全身,花,微笑,保持,看着观众,黑色鞋履,手表,黑色长筒袜,常设,云,裸露的肩膀,黑裙子,纸牌,很长的头发,鞋,钟,茶,光线追踪,(美丽细致的脸),(美丽细致的眼睛)
英文
(masterpiece),(best quality),(ultra-detailed), (full body:1.3),
1girl,chibi,Cute,animal ears, gloves, rabbit ears, thighhighs, long hair,
sleeveless, dress, manjuu (azur lane), teacup, pocket watch, card, sleeveless
dress, yellow eyes, white hair, cup, black gloves, teapot, open mouth, solo,
sky, flower, smile, holding, looking at viewer, black footwear, watch, black
thighhighs, standing, cloud, bare shoulders, black dress, playing card, very
long hair, shoes, clock, tea,Ray Tracing,(beautiful detailed face),(beautiful
detailed eyes),
lora:blindbox_V1Mix:1.2
采样方式与采样值
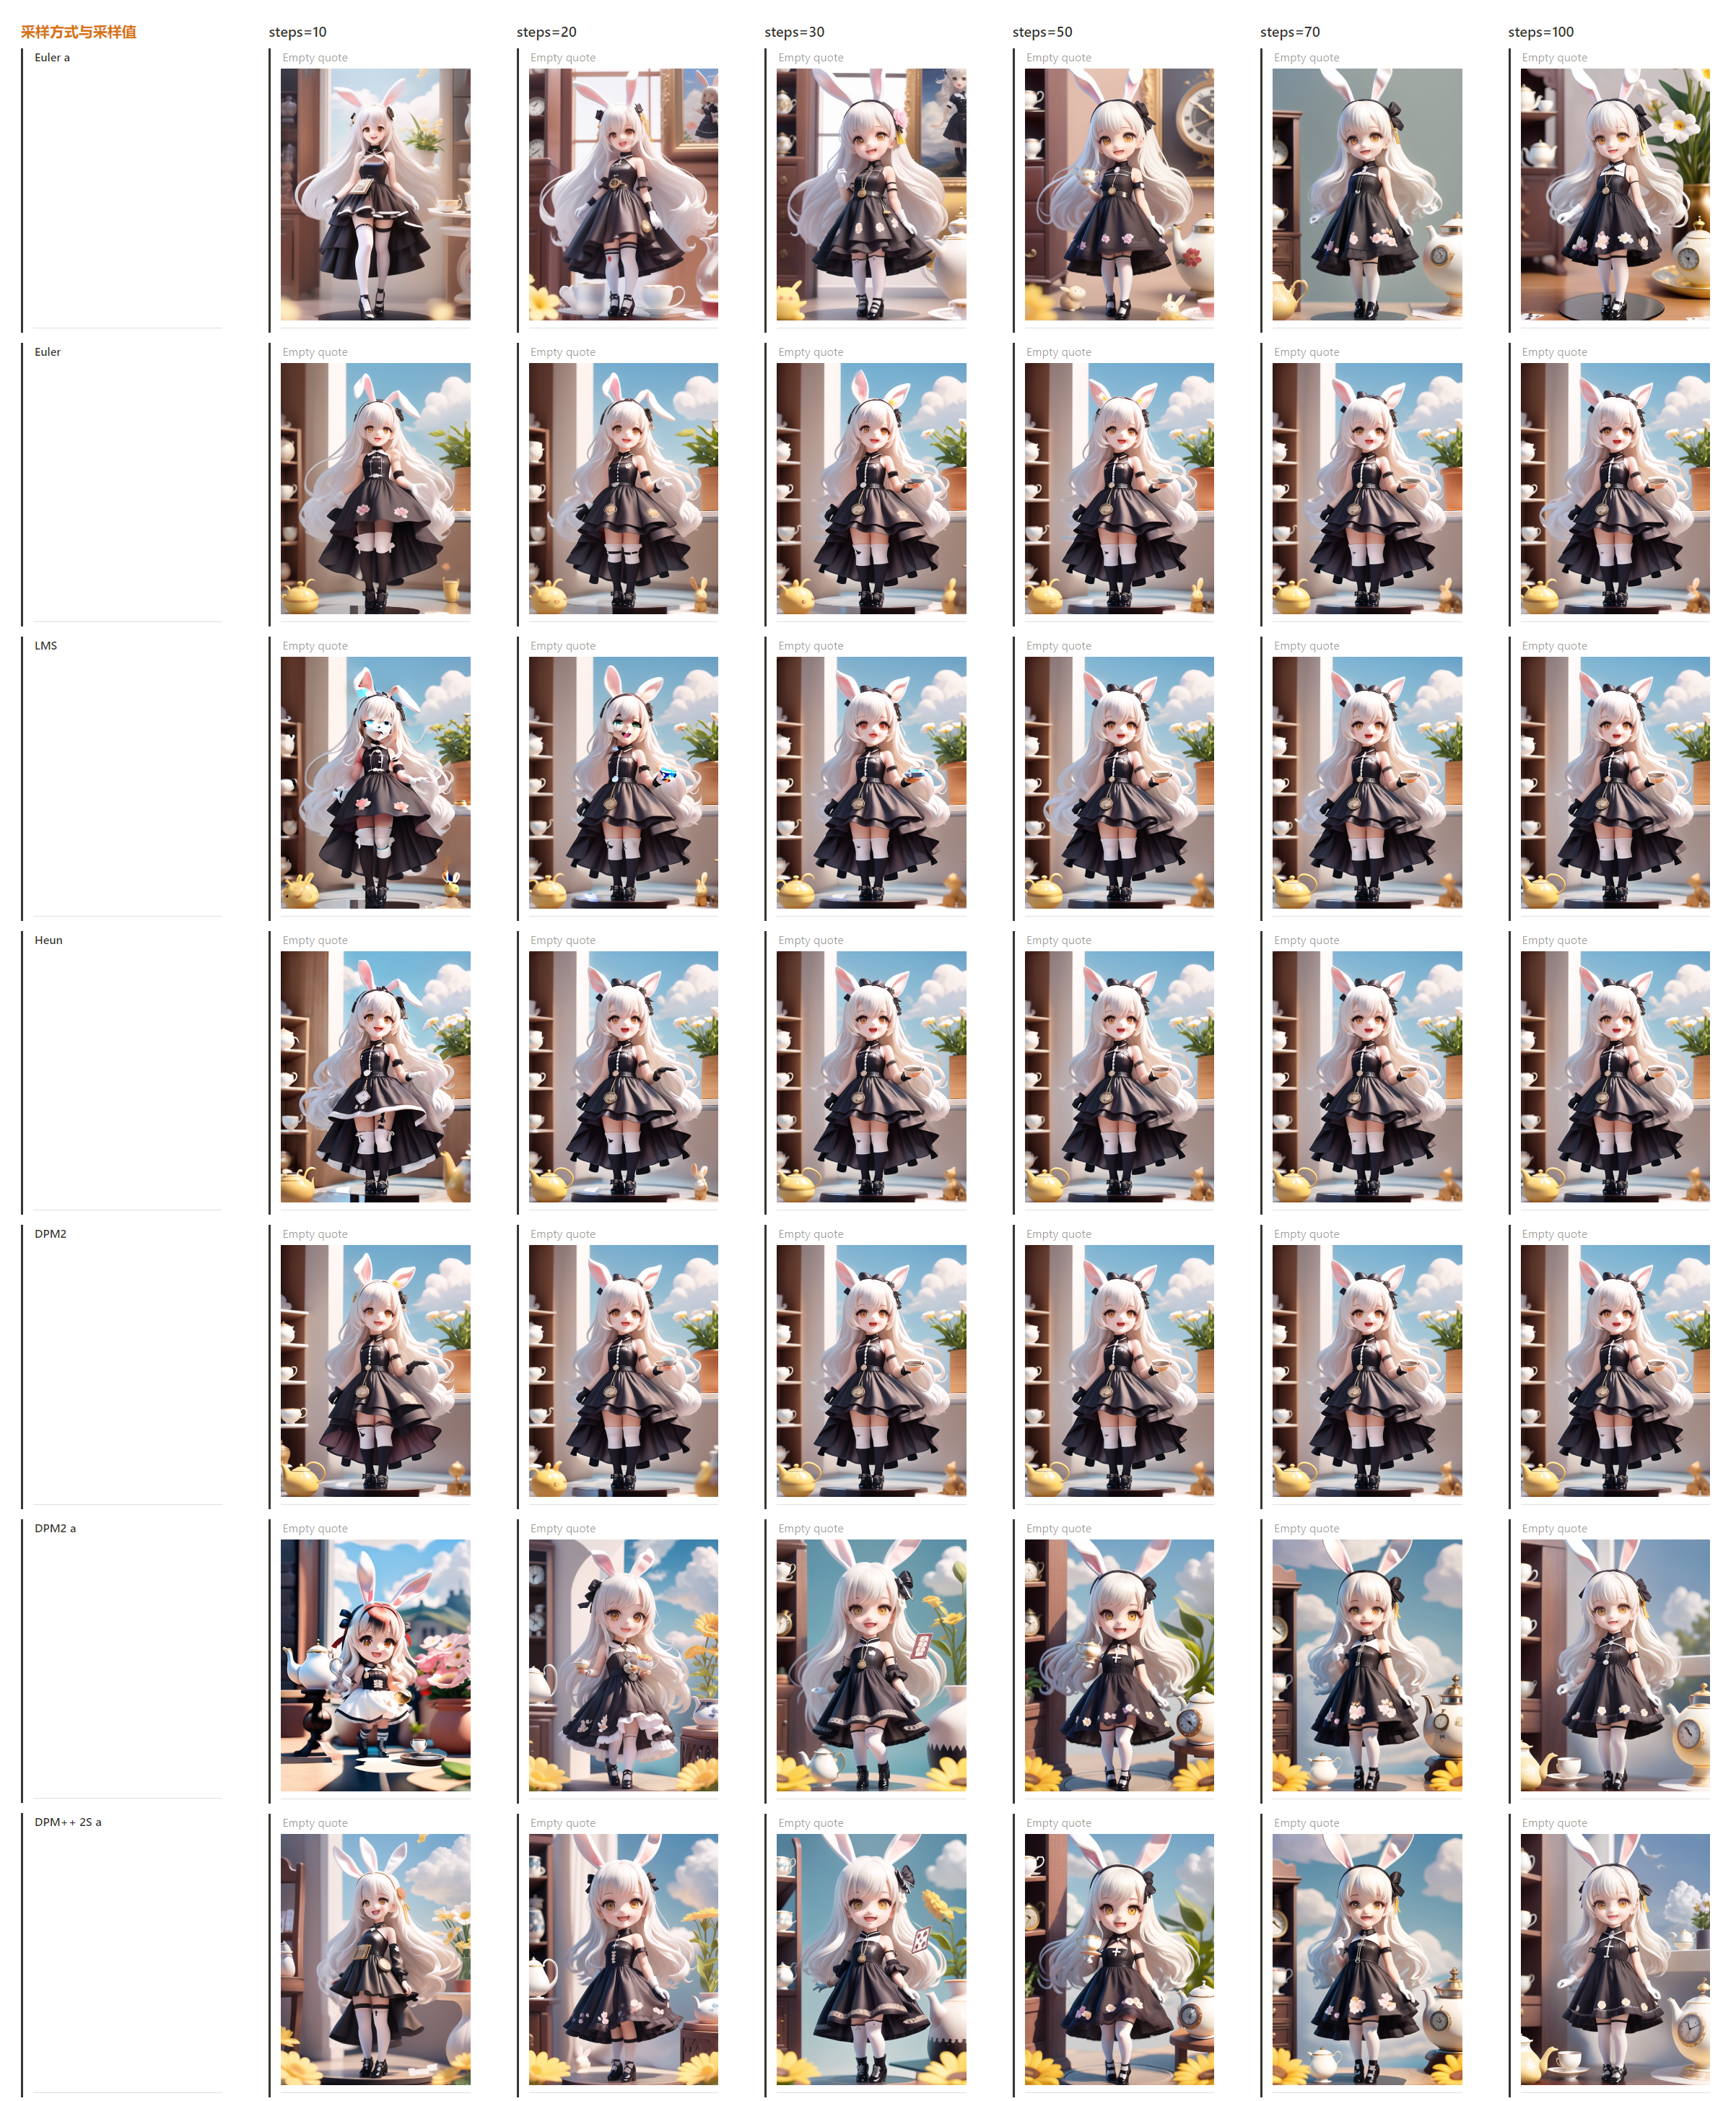
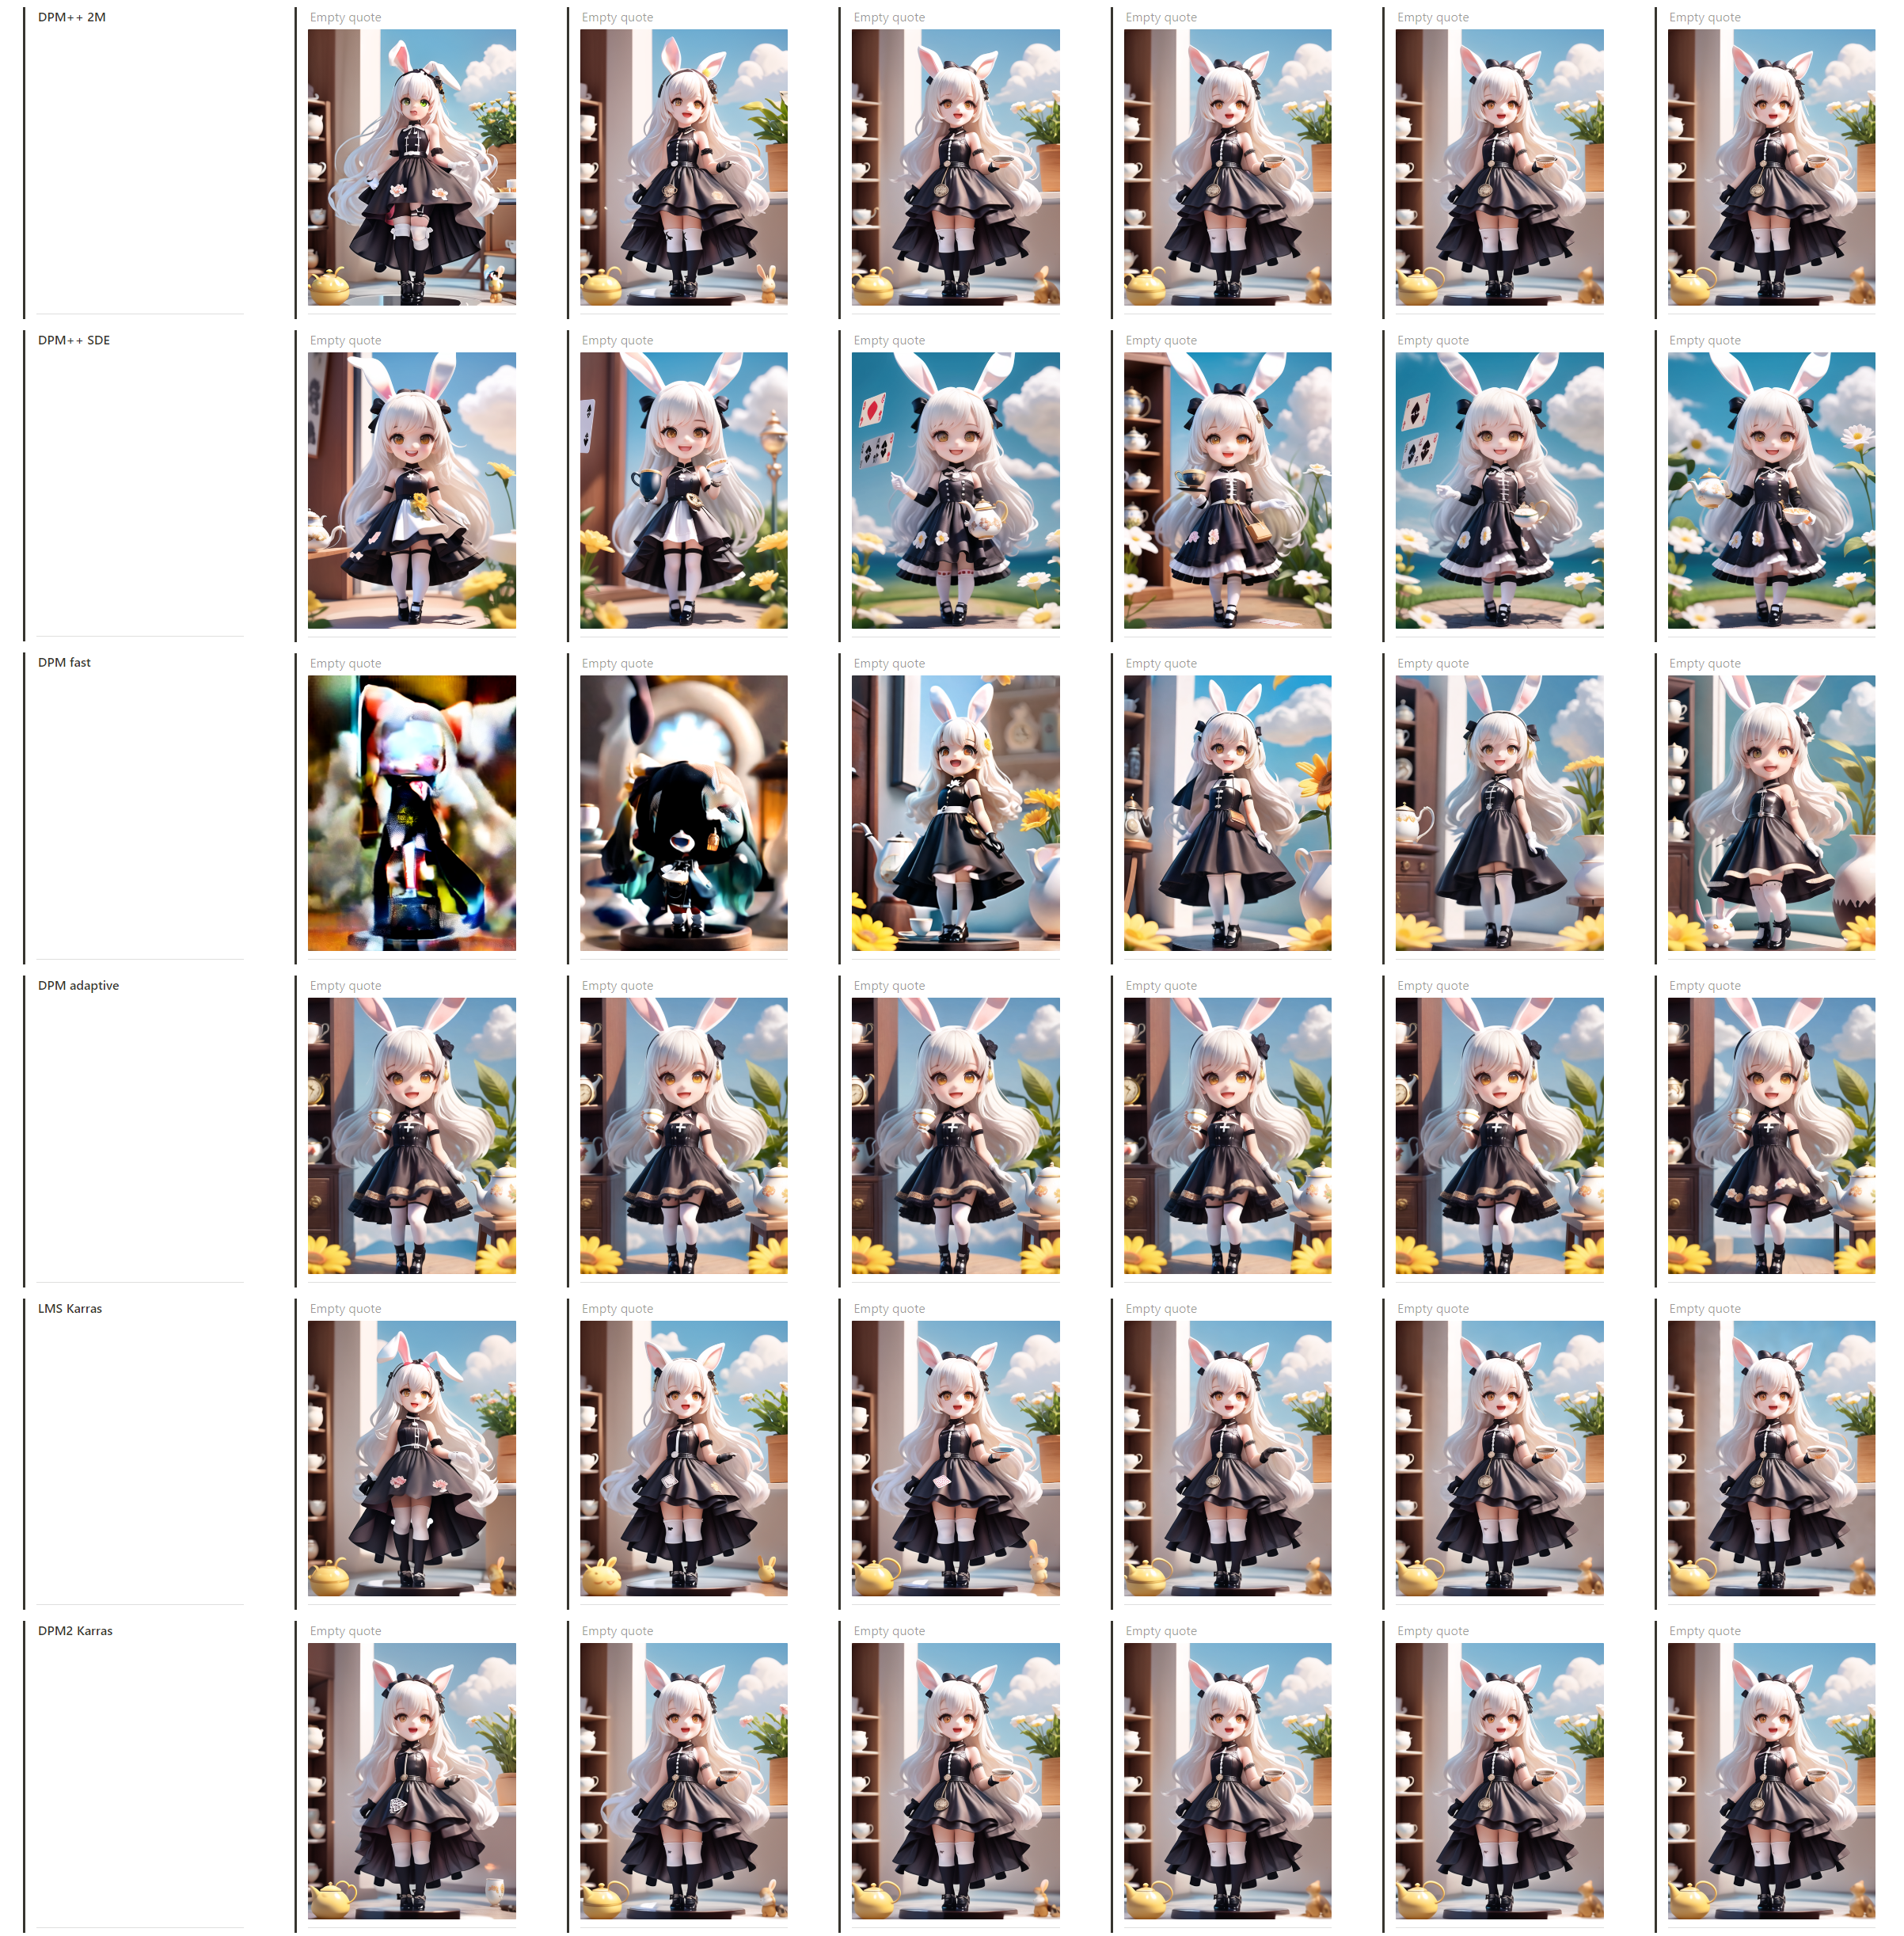
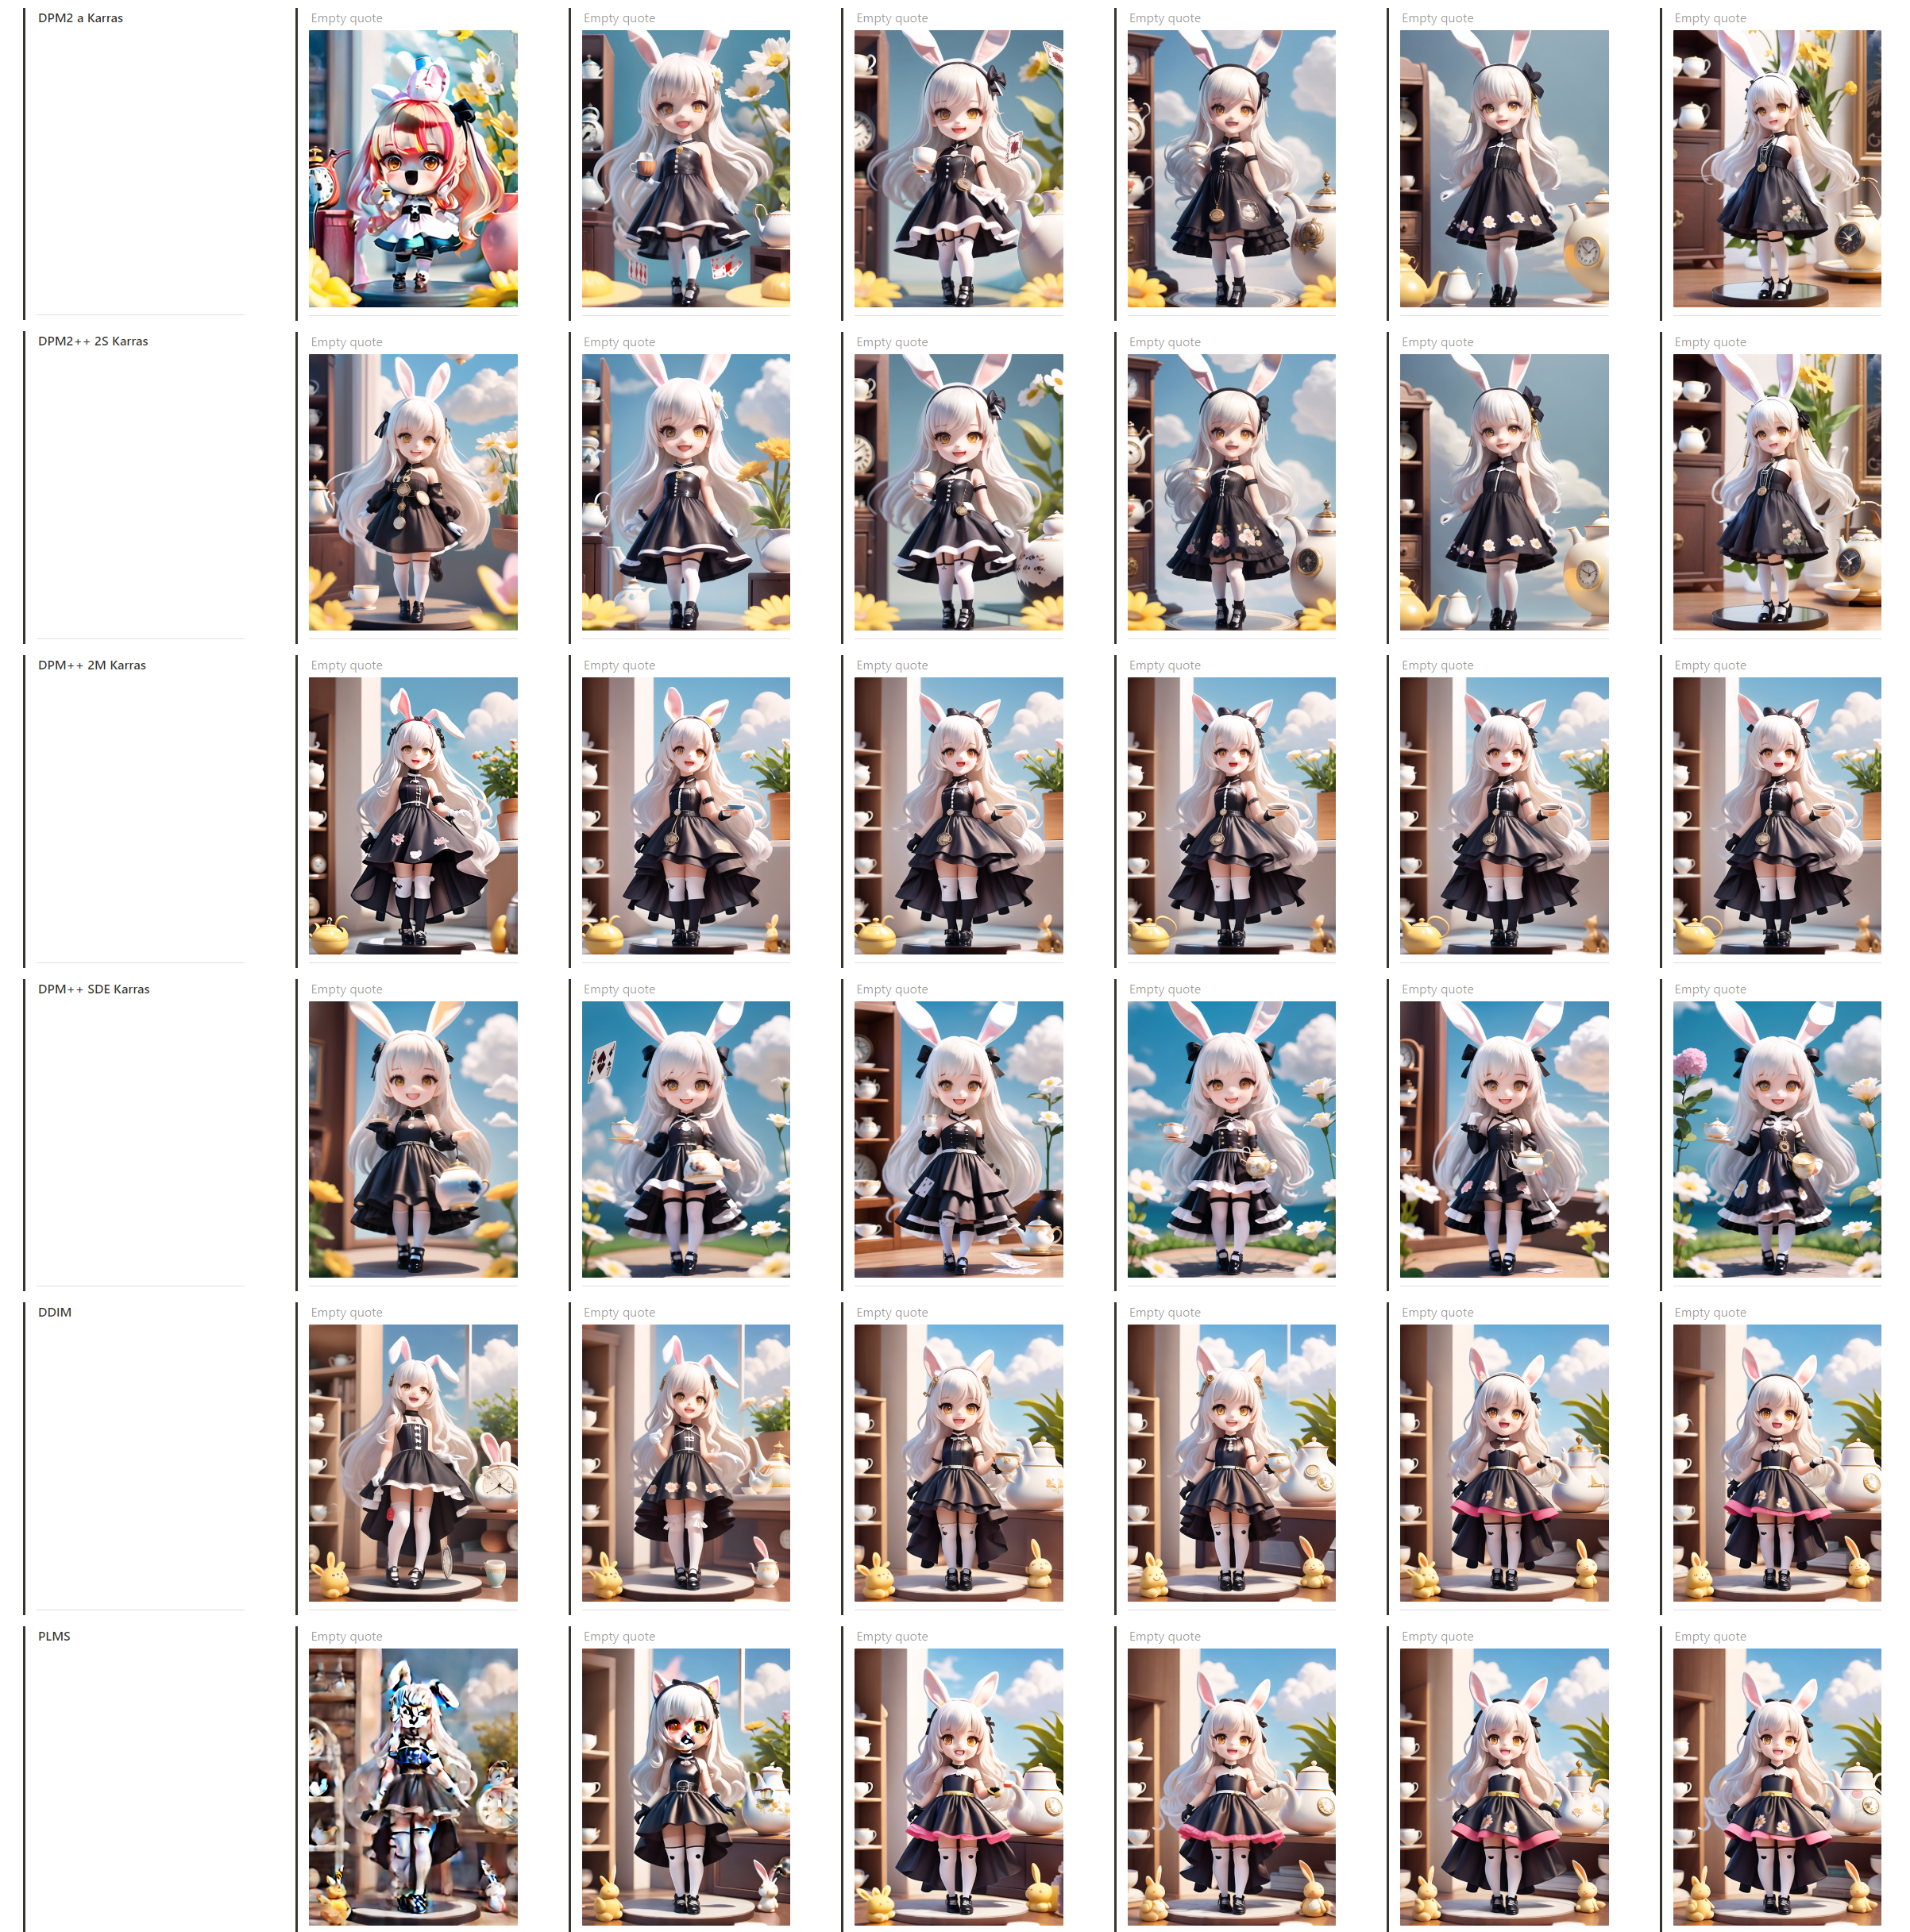
从采样数值这个维度来看。首先随着采样数值等增加,绝大部分模型会从主模型风格逐渐转变为LORA风格,并且当采样超过50后并未有过明显的变化。
从采样方式这个维度来看,当采样超过20后表现都不错。 但是其中,DPM2++ 2S Karras、DPM++ 2M Karras、DPM++ SDE
Karras 在主模型与LORA模型的结合更良好,并且在低采样10-20时表现也相当不错,而Euler
a与Euler虽然也是常用采样方式,但是当使用低采样10-20时更贴近主模型风格,不便于快速抽卡。
整体来看。在前期抽卡阶段,可以使用:DPM2++ 2S Karras、DPM++ 2M Karras、DPM++ SDE
Karras低采样10-20进行批量抽卡或调整关键词,确定种子后我们可以提高采样到30-50之间,进行更精准的调整。
Clip跳过层
WebUI种看的跳过层是1-12。通过下图可以看出,数值越小其越贴近模型表现。
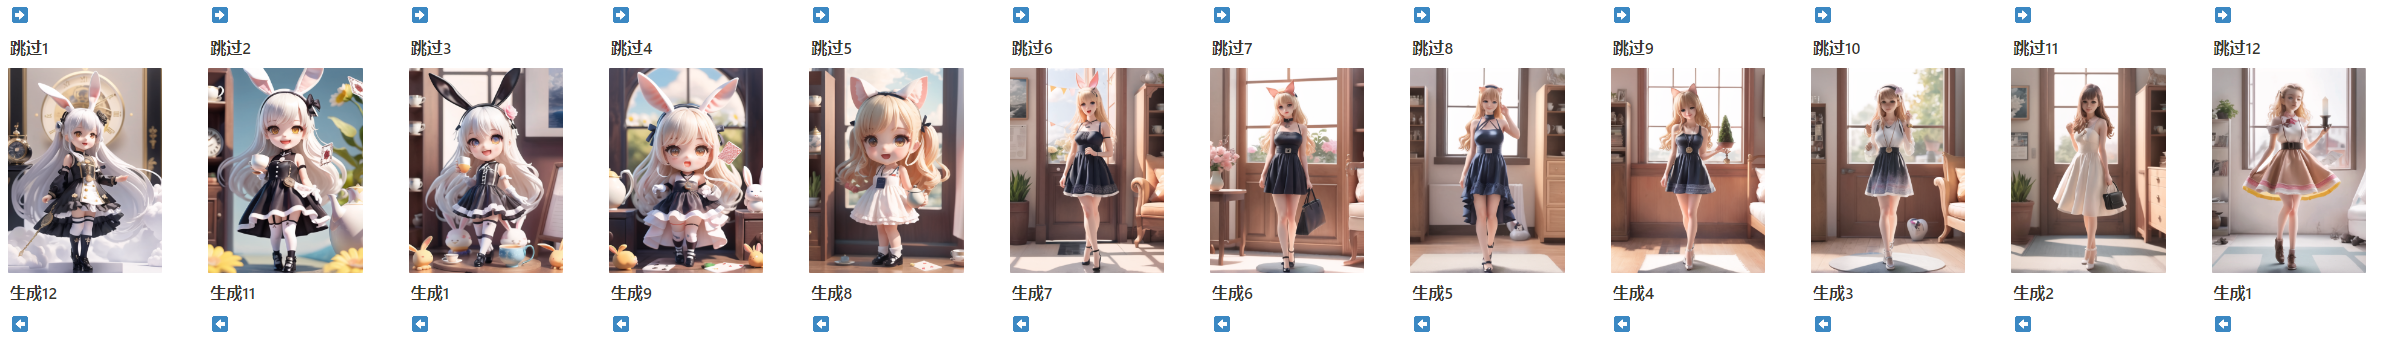
而如果咱们反向观看,其实就是AI从跳过层12开始生成信息,每次生成会获取并继承前一次生成的信息,然后重新绘制一副新的画面。
根据AI生成信息的逻辑,其实可以将WebUI种的Clip跳过层参数理解为,当AI生成到倒数第几次的时候停止并输出信息。所以如果将Clip跳过层参数调整的越大,那么AI生成的信息的速度则越快,同时也会越偏离模型。
目前大部分模型都是在采用的Clip2的参数进行训练,所以这个参数大多数情况下无需调整。如果有的模型有特殊设置,那么只需要将Clip设置成模型指定的参数即可。
高清修复
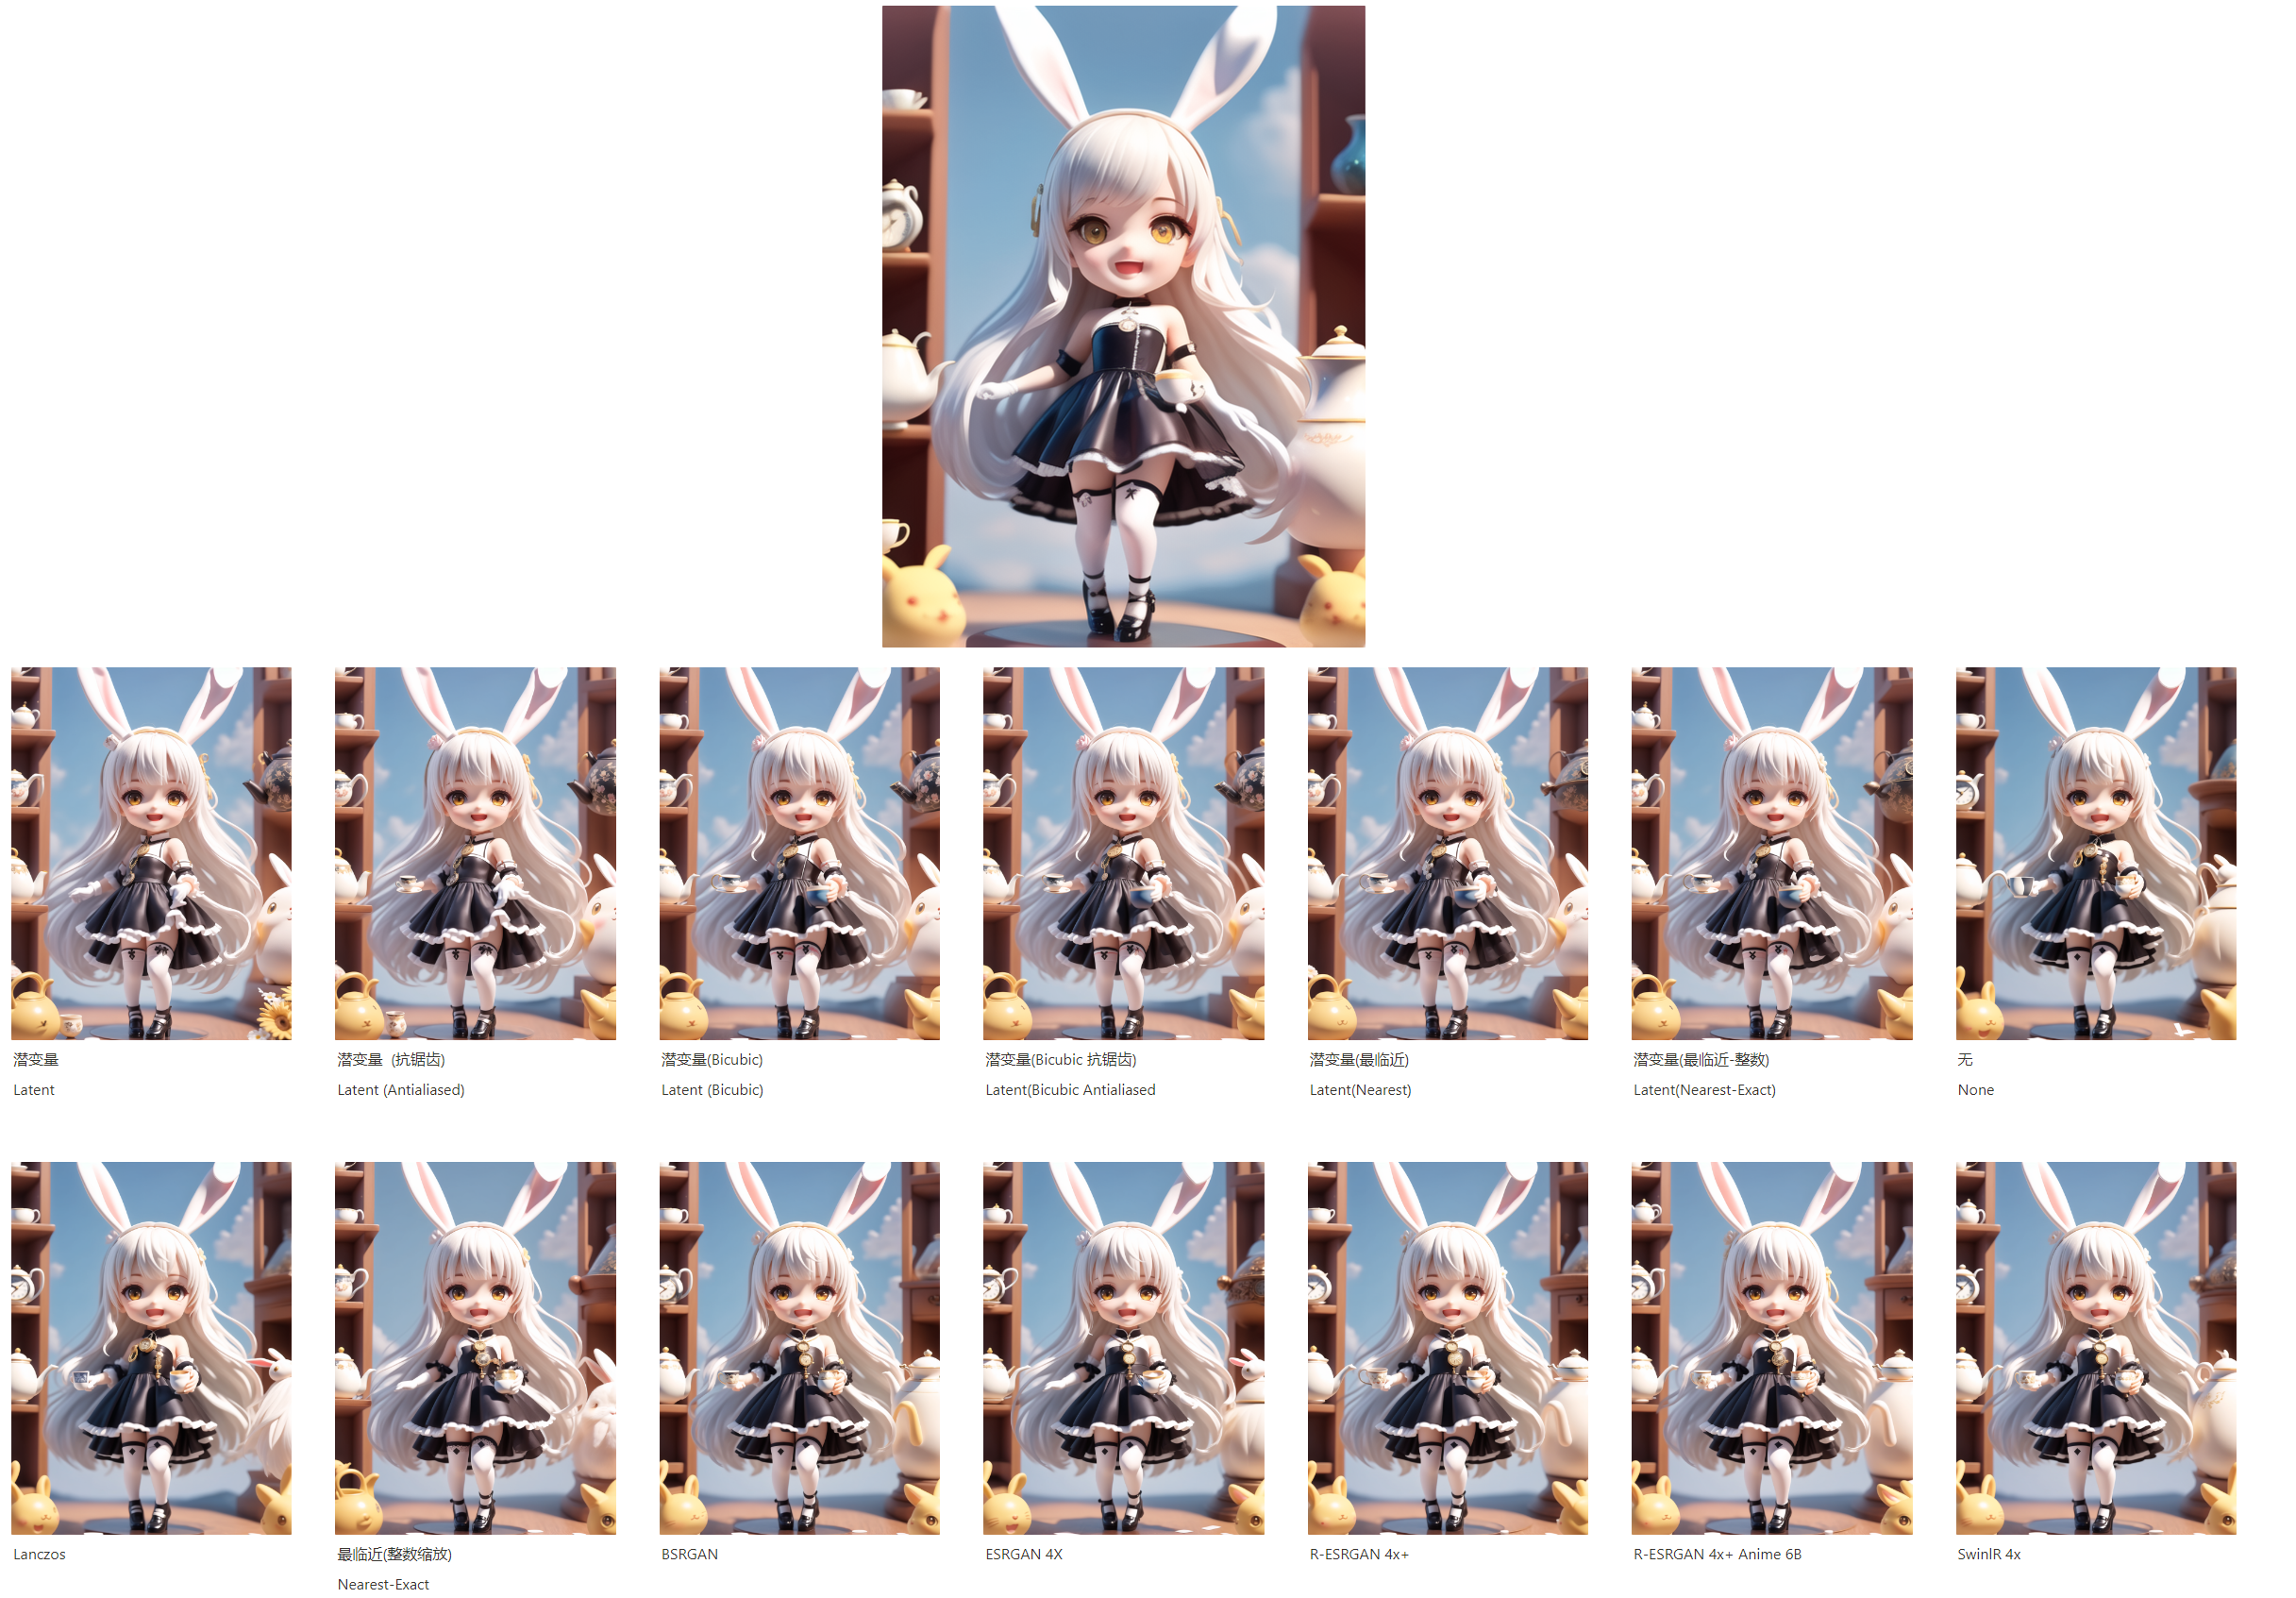
高清修复功能有点图生图的感觉,就是在原有低分辨率的图像基础放大重新生成一副新的图像。
测试使用的“高清数”是“0”,重绘幅度“0.7”,放大倍率“2”。整体来看每种方法的表现都还不错。结合大佬们的推荐,可以无脑选择R-ESRGAN
4x+与R-ESRGAN 4x+ Anime 6B。如果是写实风格择选择R-ESRGAN 4x+,二次元动漫类的可以选择R-ESRGAN 4x+ Anime
6B。
重绘幅度很好理解,就是放大后图片细节放大的变化幅度大小。如果不想让图片发生任何改变只需放大,那可以将参数调整为”0“。
需要注意的是“高清数”这个参数。通过简单测试发现,“高清数”与“采样迭代步数”实则一个功能。“采样迭代步数”最小数值为“1”,而“高清数”最小数值为”0“。由此可以理解为”高清数“是以图生图的方式重新定义一次”采样迭代步数“。一般情况下默认为”0“即可,如果需要设置那么就需要将参数调整到不低于”采样迭代步数“的数值,否则大很概率会出现错误问题。
个人推荐在文生图阶段,尽可能的使用低分辨率。来快速抽卡调整关键词和参数。在确定无误后可以使用附加功能进行放大。如果需要4K或8K的图像,推荐使用图生图中的SD放大脚本。

 2372


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


